なぜ税務シーズンのデータ入力は
いまだに自動化されていないのか
W-2フォームが標準化されたのは1978年。その年、平均的なアメリカのオフィスではタイプライター、書類キャビネット、カーボン紙が使われていました。IBM PCが登場するのは3年後のことです。それから47年が経ち、現在では毎年約2億4500万枚のW-2が米国経済を流れていますが、それぞれにデジタル以前の世界向けに設計された20の番号付きボックスと6つの英字識別フィールドが今も使われています。そして毎年1月、全国の税務申告事務所では、いまだに人間が1枚ずつ手に取り、数字を読み取り、画面に入力しているのです。
この記事は、その入力をより良く行う方法についてではありません。なぜ入力が今も存在するのか——5十年にわたるコンピューティングの進歩の中で、W-2および1099のデータ入力を頑なに手作業のままにしてきた構造的・規制的・技術的な理由についてです。最後まで読めば、この問題が現実であるだけでなく、これまでの解決策がすべて同じ見えない壁にぶつかってきた理由も理解できるでしょう。
重要ポイント
- W-2の6部構成の設計は、カーボン紙とタイプライターのために1978年に作られました。現在も年間2億4500万枚のフォームが、パソコンが存在する前に構築されたシステムを通っており、各部は人間が読んだ内容をタイプすることを前提としています。
- SSAは雇用主の電子申告により各W-2をすでにデジタルで保持していますが、税理士用のCopy Bは人間の目向けに設計されており、機械読み取り用ではありません。税務シーズンごとに66時間が、政府のデータベースにあるデータを再入力するために失われ、IRSの罰金は誤入力された桁1つにつき$60から始まります。
- テンプレートベースのOCR(光学文字認識 — ページ上の位置によって印刷されたテキストを読み取る技術)は、トレーニングサンプルに現れた正確なピクセル座標でBox 1を探すため、PaychexのW-2やスマホの写真がADPのレイアウトに取って代わるとすぐに機能しなくなります。同じフィールドが給与計算プロバイダーごとに異なる位置に表示されるからです。
- ImageToTable.aiは、各フィールドラベルの意味に基づいてW-2を読み取り、ページ上の位置には依存しません。「Wages, tips, other compensation」がどこに現れても見つけ出します。そのため、ADP、Paychex、Gusto、スキャンコピー、スマホの写真がすべて1つのバッチで処理できます。ツールがフォームに適応するのであって、フォームがテンプレートに一致することを要求しないからです。
W-2はカーボン紙用に設計されたもので、コンピューター用ではない
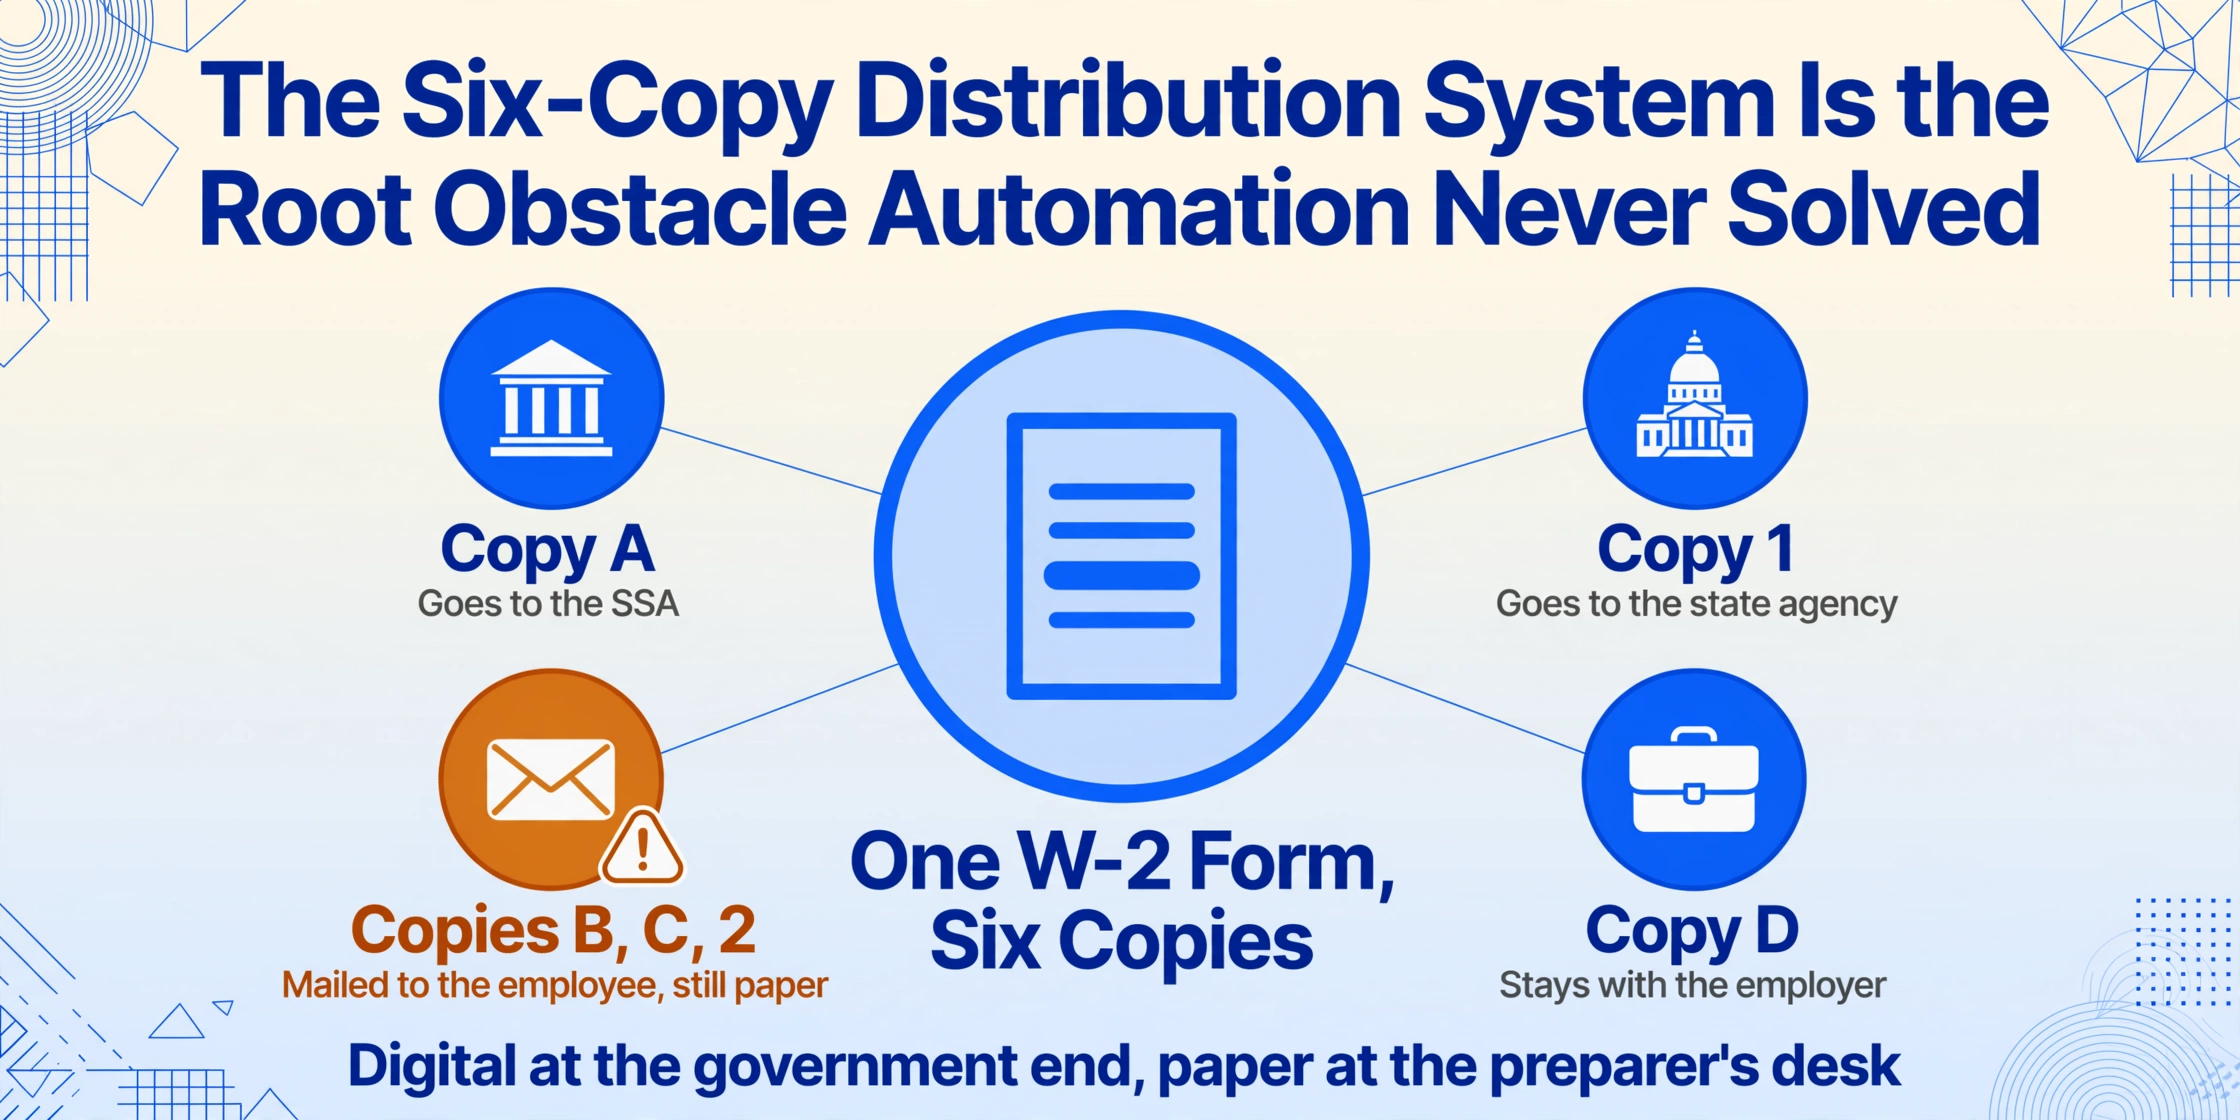
W-2の6部複写の配布システムは、IRSが忘れている遺物ではありません。これは、このフォームの定義的な構造です。Copy Aは社会保障庁に送られ、SSAの光学スキャナーが読み取れるように特別な赤色のドロップアウトインクで印刷されます。Copy 1は州税当局に送られます。Copy B、C、2は従業員に渡ります。連邦申告用、州申告用、従業員の記録用の3部です。Copy Dは雇用主が保管します。6部、1つの目的、そしてそのすべてが紙として始まります。
この構造は、賃金データを政府に届ける唯一の方法が紙を物理的に郵送することだった1978年には理にかなっていました。しかし、それはまた、恒久的な構造的依存も生み出しました。従業員が紙のW-2を受け取る限り、その連鎖の中の誰か(従業員、税理士、会計士)が、その紙をデジタルデータに戻さなければならないのです。SSAはその後、EFW2形式のW-2を受け付ける電子申告システムであるBusiness Services Online (BSO)を構築し、IRSは情報申告書が10件以上の場合、電子申告を義務付けています。しかし、税理士の机に届く従業員用のコピーは、今も紙のままです。デジタル橋は、従業員から申告作成者へのパイプラインの端ではなく、雇用主から政府へのパイプラインの端に建設されました。フォーム自体が、そのギャップを埋めるように再設計されることはありませんでした。
その結果、現代の税務申告準備の中心にある構造的矛盾が生じています。政府は雇用主の電子申告を通じてW-2データをデジタルで受け取りますが、納税者の代理人(実際に申告書を提出する申告作成者)は、1月に納税者に郵送された紙で同じデータを受け取ったのです。同じフォームのための2つの並行するデータフロー、1つはデジタル、もう1つは物理的。そして毎年1月、紙のフォームを手にし、空の画面を見つめる税理士の机の上で、それらは衝突します。
6部複写システムこそが、自動化が決して解決できなかった根本的な障害
全米税務専門家協会 (NATP) の報告によると、会員23,000以上の事務所の総収入の65%が税務シーズン中に稼がれています。1月から4月までのこの4ヶ月間が、この業界全体の収入源です。その中でも1月がボトルネックとなります。W-2は1月31日までに従業員へ交付し、同じく1月31日までにSSAへ提出し、その後4月15日の申告期限に間に合うように税務申告ソフトウェアへ入力する必要があるからです。2月1日に50人のクライアントからW-2の入った靴箱を受け取った準備者は、すべてのフォームのすべての欄を画面上に入力するまでにちょうど73日しかありません。しかも、それは申告書の確認、エラーのチェック、クライアントとの結果の話し合いを行う前の話です。
6部複写システムのせいで、税理士が扱う原本は、雇用主がSSAに提出した元のデジタルファイルであることはほぼありません。それはコピーB、つまり郵送で届き、折り曲げられ、コピーされ、落書きされ、スマートフォンで撮影されてテキスト送信された可能性もある従業員用コピーです。この紙のコピーを変換するための人件費は現実的で、十分に文書化されています。慎重な手入力で1枚あたり8分かかるとして、シーズン中に500枚のW-2を処理する事務所は、フォームを読んでキーを押すだけの作業に66時間以上を費やします。これは、申告書に分析的価値を一切加えない活動に消費される、ほぼ2週間分の請求可能時間です。完全なW-2および1099抽出ワークフローは、この時間をアップロードと確認の1回のパスに置き換えます。
同じW-2でも、給与計算プロバイダーが違えば3つの異なる書類になる
すべてのW-2が同じに見えたら — 同じフォント、同じボックス位置、同じページ形状 — 自動抽出は何十年も前に解決されていたでしょう。しかし、1人のクライアントが、2つの異なる給与計算システムを使う2つの雇用主からの2枚のW-2と、3つ目のシステムを使う契約先クライアントからの1099-NECを抱えてやってくることもあります。ADPはBox 1(賃金)をPaychexとは異なる座標に配置し、PaychexはGustoとは異なる位置に配置し、GustoはQuickBooksからレーザープリンターで印刷し、一部を手書きで記入した地元の簿記係とは異なる位置に配置します。IRSが標準化するのはフォームに何を記載すべきかであって、ページ上でのレイアウト方法ではありません。
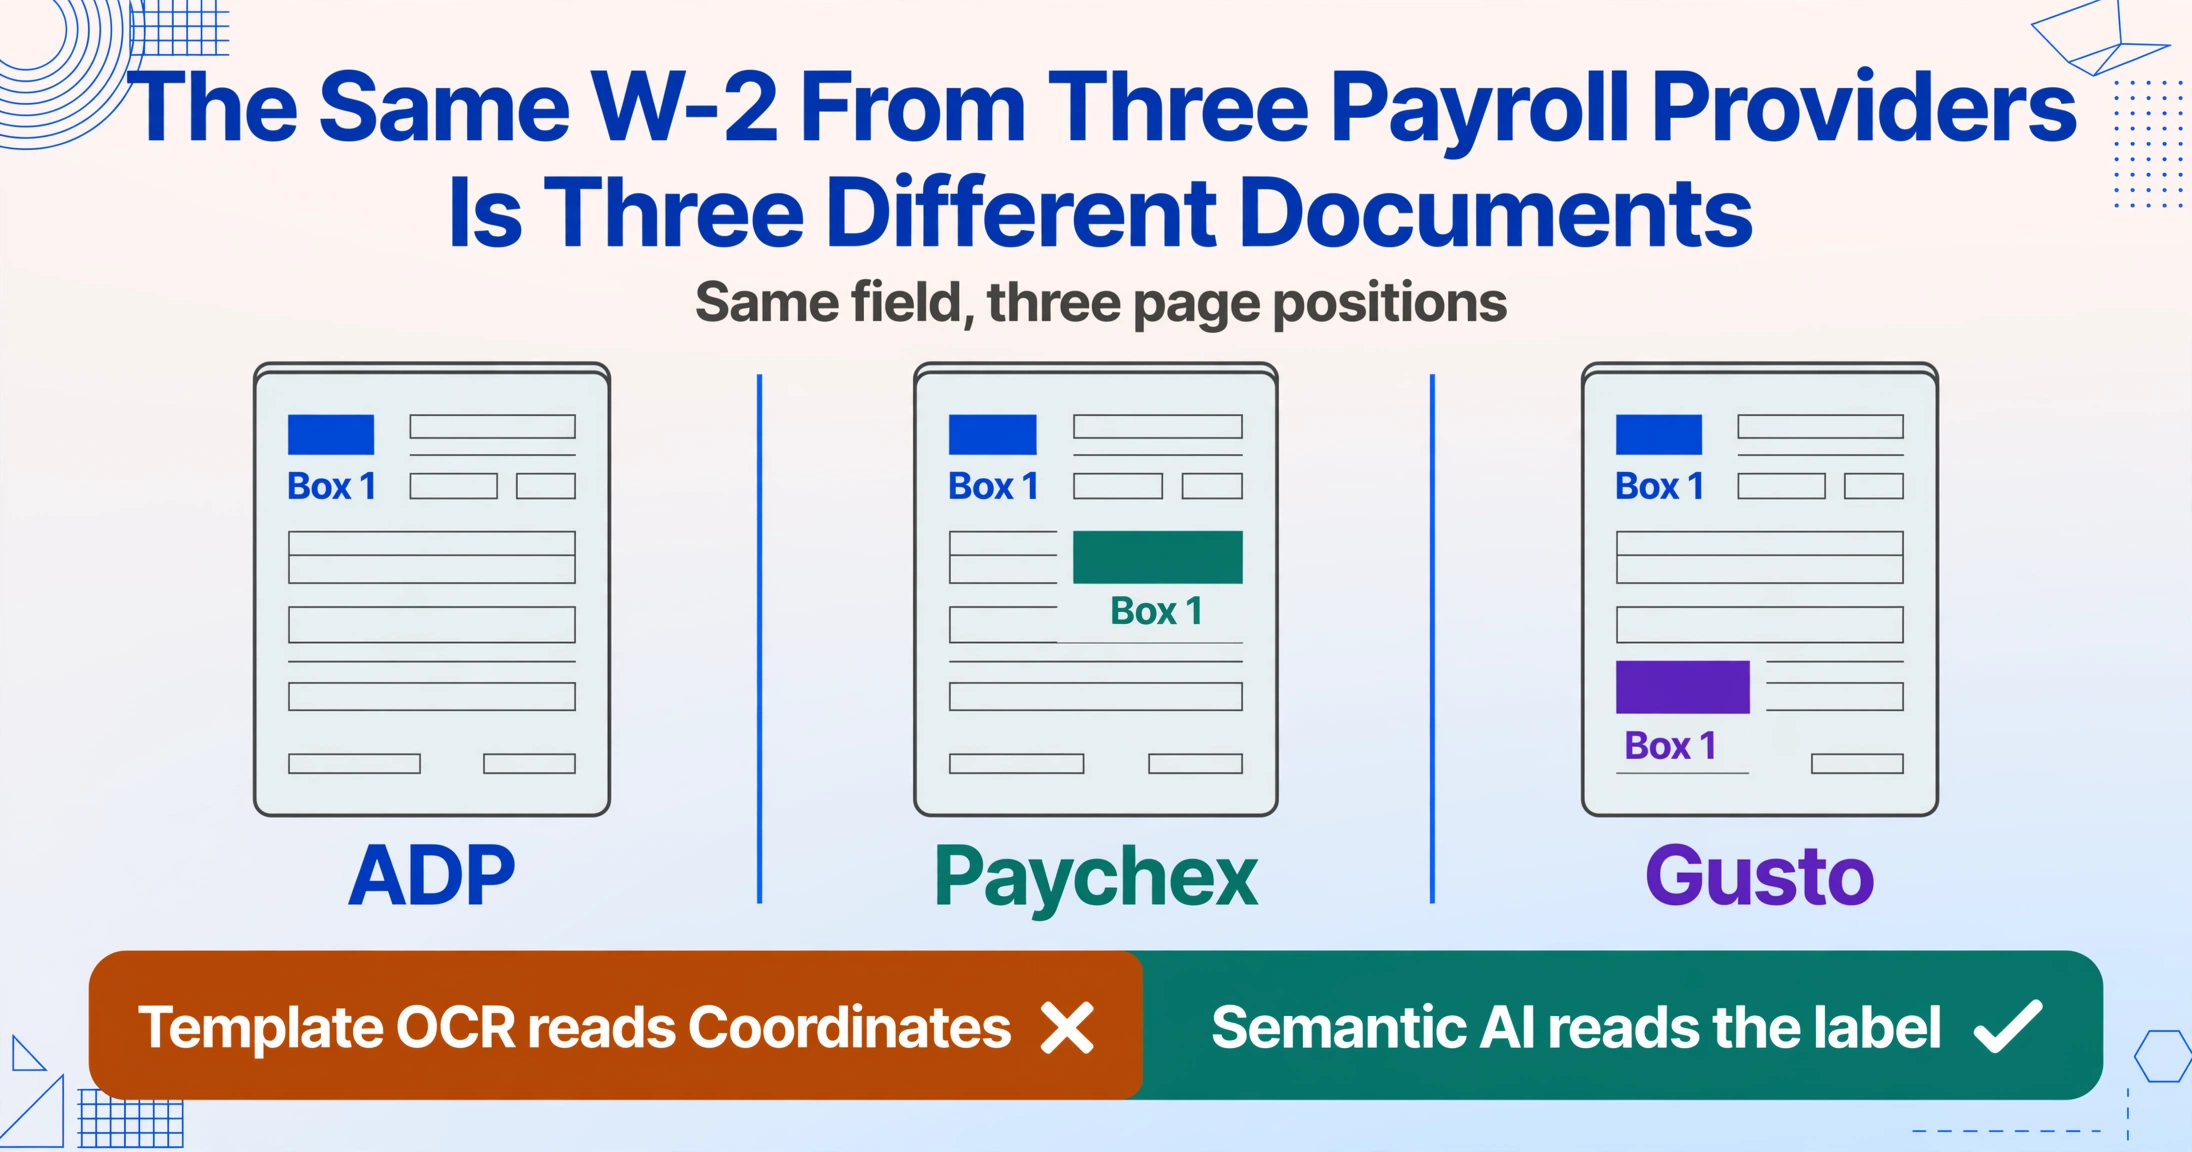
この断片化こそ、あらゆる自動化アプローチが最初に直面する壁です。給与計算業界は主要プロバイダー数社に集約されてきました — ADPだけでも、およそ米国の従業員6人に1人の給与を処理しています — しかし、その集約によってレイアウトの標準化は実現されていません。各プロバイダーは独自のプロプライエタリ形式でW-2を生成し、独自のフォント、独自のボックス配置、独自のページ寸法を使用しています。その結果、中規模雇用主からの50枚のW-2のバッチには、4つの異なる給与計算システムからのフォームが含まれている可能性があり、それぞれに異なる抽出テンプレートが必要になる — あるいは、より一般的には、人間がそれらを読んで入力する必要がある、ということになります。
そして、断片化はプロバイダー間だけの問題ではありません。同じ申告年度内で、同じ従業員に対して発生することもあります。3月に転職した人は、雇用主A(ADP)と雇用主B(Paychex)からW-2を受け取ります。W-2の仕事をしながら1099の副業を持っていた人は、雇用主からW-2を、クライアントから1099-NECを受け取ります。各フォームは異なる形式で、異なる経路を通って、異なる時期に届きます。多様性はエッジケースではなく、税務申告シーズン準備の標準的な状態なのです。
IRSはいまだに紙の処理パイプラインを維持している——それが紙を存続させている
T.D. 9972に基づき、情報申告書のe-file義務は10枚から適用されます。W-2が9枚以下の場合は、引き続き紙でSSAに郵送できます。IRS自身のForm W-2に関する指示書もこの基準を認めています。全国で、従業員6人のレストラン、8人の建設会社、5人の歯科医院など、何百万もの小規模雇用主がこの基準を下回っています。各事業者はW-2の束を印刷し、(時には手書きで)記入してSSAに郵送し、従業員には紙のコピーを渡しています。
これは規制上の見落としではありません。意図的な配慮です。IRSは、2人だけの造園会社にSSAのBSO電子申告システム——EFW2形式仕様、AccuWage検証ソフトウェア、SSN検証要件——を操作させることは、不合理なコンプライアンス負担になると認識しています。そのため、紙のパイプラインは開かれたままです。そして、e-file基準を下回って作成された紙のW-2はすべて、最終的に税理士の手に渡り、転記が必要になります。
IRSの罰則スケジュールにより、これは単なる不便さ以上のものになっています。内国歳入法§§ 6721および6722に基づき、遅延または不正確な情報申告書は1枚ごとに罰則の対象となり、そのスケジュールは修正のタイミングと意図に応じて$60から$680まで段階的に上がります。Box 1の数字を1桁誤って入力し、不正確な申告書を提出した税理士は、雇用主ではなく、税理士自身の転記ミスに遡って責任を問われる可能性があります。シーズンを通じて1枚あたりの罰則と転記ミスが事務所にどれだけのコストをもたらすかの完全な内訳については、手動によるW-2および1099入力のコスト分析をご覧ください。
Box 3の鉛筆書きが、あらゆる自動化パイプラインを壊す理由
税務申告の専門家から最も一貫して聞かれるのは、クライアントから届くW-2がきれいな状態であることはほとんどない、ということです。印刷された金額の上に、修正された社会保障賃金額が手書きで記入されている。EINが取り消し線で消され、書き直されている。Box 13のチェックボックスには、元のプリンターインクではなくペンで印が付けられている。コーヒーの染みが州ID番号を覆い隠している。フォームはビジネス用封筒に入れるために三つ折りにされ、その後広げられた——賃金欄に折り目が残っている。これらはどれも珍しいことではありません。実際の納税者が提出する紙の税務書類の標準的な状態です。
テンプレートベースのOCRシステムにとって、これらのバリエーションはそれぞれが失敗ポイントです。印刷された文字に重なった手書きの数字は、文字認識を混乱させます。数字フィールドを横切る折り目は、数字のセグメンテーションを壊します。Xの代わりに丸、塗りつぶした四角の代わりにチェック——間違ったマークタイプで付けられたチェックボックスは、選択があるべき場所にnull値を返します。きれいなフラットベッドスキャンされたPDFと、印刷したばかりのフォームでトレーニングされたシステムには、米国郵便公社を経由し、キッチンのカウンターに2週間置かれ、Box 12のコードDDの意味が分からない誰かによってボールペンで記入されたW-2の物理的な状態を想定するモデルがありません。
最も痛烈な皮肉は、人間の準備担当者がこの劣化した文書をほぼ瞬時に処理できることです。取り消し線が引かれたBox 3と手書きの置き換えを一目見ただけで、準備担当者は「元の数字が間違っていたので、手書きのものを使おう」と判断します。テンプレートベースのシステムは、同じフィールドに2つの競合する数字を見て、どちらも返さない——あるいは、さらに悪いことに、間違った方を返します。訓練された準備担当者が半秒で適用する判断は、まさに自動化システムに欠けているものであり、まさに人間がW-2転記ループの中心に留まり続けてきた理由です。
税務申告ソフトはデータを送信できる — クライアントの紙を読み取ることはできない
業界の主要な税務申告プラットフォーム — Drake、UltraTax、Lacerte、ProSeries、ATX — はすべてW-2データのインポートに対応しています。CSVから。前年度の申告書から。給与計算プロバイダーのデジタルエクスポートから。しかし、どれもできないのは、クライアントが机を挟んで税理士に手渡した紙のW-2 Copy Bを読み取ることです。インポーターは構造化されたデジタル入力を期待しますが、元の文書は非構造化された物理的な紙です。税理士が変換レイヤーとなるのです。
W-2データがSSAに電子申告された後でも、税理士はSSAのデータベースからDrakeに直接取り込むことはできません。SSAのBusiness Services Onlineシステムは、コンプライアンス照合のために賃金データをIRSに提供するものであり、申告書作成のために税理士に提供するものではありません。税理士がアクセスできるWage and Income Transcript — IRSのTranscript Delivery System (TDS)を通じて — は、署名済みのForm 8821またはPower of Attorneyを持つ税務専門家が利用できますが、それは編集された要約として届き、構造化されたフィールドレベルのデータとしては届きません。そのため、税理士は、片手にクライアントの紙のW-2、もう片方の手にDrakeの入力画面を置き、それでも入力し続けるのです。
米国労働統計局は、会計士・監査人の2024年5月時点の時給中央値を$39.27としています。福利厚生、給与税、事務所経費、ソフトウェアライセンスをすべて含めると、スタッフ会計士1人あたりの事務所コストは1時間あたり$55〜65に近くなります。その会計士がW-2フィールドの転記に費やす1時間ごと — 分析的判断を一切必要としない作業 — は、申告書のレビュー、節税機会の特定、クライアントへのコンサルティングに費やされない時間です。データ入力自体のコストは、中規模事務所で税務シーズンあたり$4,000〜$6,000と定量化されています。機会費用 — タイピングによって置き換えられた請求可能な作業 — は測定が難しいものの、ほぼ確実にそれよりも大きいでしょう。
テンプレートベースのOCRがW-2で失敗する理由は、常に同じ構造的な理由です:レイアウトのばらつき
20年にわたり、文書データ抽出の主流アプローチはテンプレートベースのOCRでした。テンプレートを作成し、「Box 1はこのADP生成のW-2の座標(x1, y1, x2, y2)にある」と指定すると、システムはその矩形内にあるテキストを読み取ります。これは、固定された予測可能なレイアウトの文書にはうまく機能します。特定のベンダーからの特定の請求書、常に同じERPシステムで生成され、常に同じレイアウトで出力されるような文書です。しかしW-2ではうまく機能しません。同じフィールド(Box 1)が、給与プロバイダーごとに異なる位置に表示され、スキャンされた紙のコピーごとに異なる位置に表示されるからです。
根本的な問題は、テンプレートベースのOCRが文書を位置で読み取ることであり、意味で読み取るのではないということです。それは、Box 1がトレーニングサンプルであった場所を知っているだけで、現在の文書でBox 1が何であるかを知っているわけではありません。この違い — 位置と意味の違い — が、W-2のデータ入力が自動化に抵抗してきた中心的な理由です。フォームの仕様は、どの情報が含まれるか(賃金、源泉徴収税、SSN、EIN)を保証しますが、その情報が物理的またはデジタルページのどこにあるかは保証しません。「どこ」に依存して「何」を判断するシステムは、トレーニングされていない給与プロバイダーのW-2に遭遇した瞬間に機能しなくなります。
テンプレートツールは、複数ソースの問題でも失敗します。「ADP W-2、2024年フォーマット」用に構築されたテンプレートは、「Paychex W-2、2024年フォーマット」からデータを抽出できません。ましてや「小規模雇用主からの紙のW-2の写真、2024年フォーマット、手書きのBox 3修正あり」からは抽出できません。税理士は、各クライアントの雇用主が使用するすべての給与プロバイダー向けのテンプレートライブラリを維持し、各プロバイダーがフォームレイアウトを変更するたびに毎年更新する必要があります。メンテナンスの負担だけで、現実的な規模ではこのアプローチは非現実的です。セマンティック抽出がこれらのレイアウト全体で各ボックスをどのように読み取るか、そしてどこでまだつまずくかについてのステップバイステップの解説は、W-2および1099抽出の完全ガイドをご覧ください。
意味の理解が位置に取って代わる — それが自動化の可能性を変える
テンプレートベースの抽出に代わる方法は、セマンティックな文書理解です。これは、人間と同じようにW-2を読むAIモデルで、各フィールドがどこにあるかではなく、何を意味するかを認識します。W-2に「Wages, tips, other compensation(賃金、チップ、その他の報酬)」とあれば、それがADPのPDFの左上にあるか、PaychexのPDFの右上にあるか、紙のフォームの電話写真の中央にあるかに関係なく、それがBox 1であるとわかります。セマンティックAIも同じ判断を下します。「Wages, tips, other compensation」を概念として識別し、その隣の金額を抽出します。その金額が印刷されていようと、手書きであろうと、取り消し線で修正されていようと関係ありません。
この転換 — 座標ベースの抽出から概念ベースの抽出へ — こそが、W-2自動化を初めて技術的に実現可能にするものです。特定のテンプレート上でBox 1がどこにあるかを定義する代わりに、システムにこう指示します:「Wages, tips, other compensationというラベルの付いた金額を抽出してください。」 システムはフォーム全体を読み取り、そのラベルがどこにあっても見つけ出し、その隣の値を返します。このアプローチは、列名抽出と呼ばれることもあり、ページの座標ではなくセマンティックな名前で必要なフィールドを定義するもので、3つの給与計算プロバイダー、手書きの修正、電話写真をすべて一度の処理で扱えます。なぜなら、何がどこにあるかを事前に知る必要がまったくないからです。
これはまた、W-2データをPDFから構造化されたスプレッドシートに抽出することが大規模に可能になる点でもあります。準備者は列名 — 「Box 1 Wages」「Box 2 Federal Tax Withheld」「Box b EIN」「Employee SSN」— を定義し、セマンティックモデルは、どの給与計算プロバイダーがどのフォームを生成したかに関係なく、バッチ内のすべてのW-2から各値を見つけ出します。出力は、従業員ごとに1行の単一のExcelシートで、DrakeやUltraTaxへのインポート準備が整い、フィールドを手動で入力する必要は一切ありません。
エンドツーエンドのW-2自動化に必要なもの — そして3つの要素がようやく揃った理由
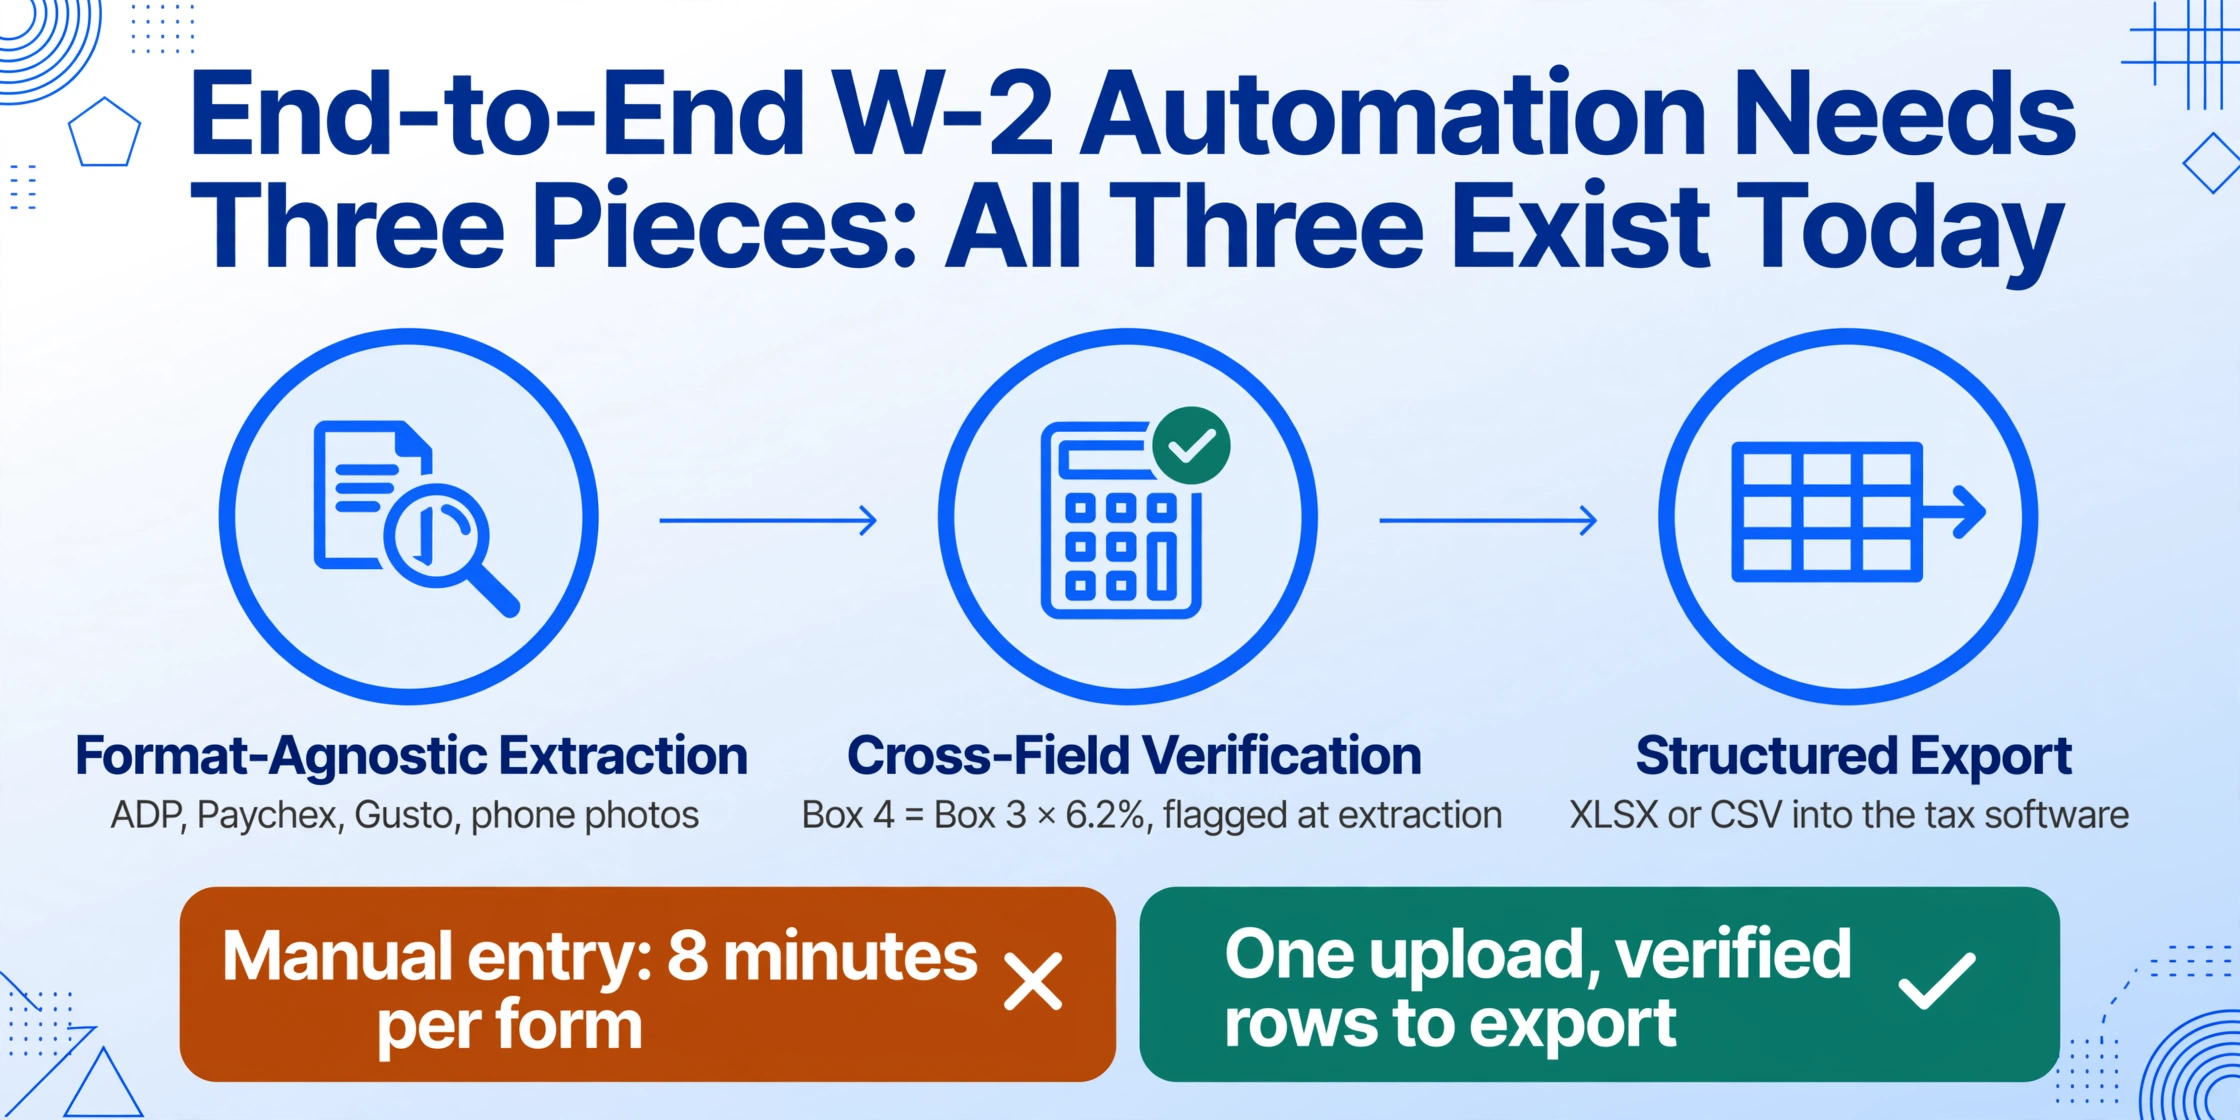
W-2データ入力の完全自動化 — クライアントの書類受領から税務ソフトへのインポートまで — には、これまで別々のシステムに存在していた3つの機能が必要です:
- フォーマット非依存のフィールド抽出 — ADP、Paychex、Gusto、スキャンした紙のコピー、スマホ写真の間で、プロバイダー別テンプレートなしに同じフィールドを正確に読み取ること。
- クロスフィールド検証 — Box 4(社会保障税)がBox 3 × 6.2%と等しいか、Box 2(連邦所得税の源泉徴収)がBox 1の賃金に対して妥当か、SSNの形式が有効かを自動的にチェックすること。これは準備者の判断ステップであり、後のレビューではなく抽出時に行う必要があります。
- 構造化エクスポート — 抽出・検証済みのデータを税務申告ソフトが直接取り込める形式(XLSX、CSV)で提供し、再入力の手間を完全に排除すること。
最初の要素 — フォーマット非依存の抽出 — は、セマンティックAIが可能にするものです。2番目の要素 — クロスフィールド検証 — は、計算列がワークフローに追加するものです:抽出時に「Box 4 = Box 3 × 0.062を検証する」といった計算を定義し、データがスプレッドシートに到達する前に不一致をフラグ付けする能力です。3番目の要素 — 構造化エクスポート — は、準備者の書類スタックと税務ソフトのインポート画面をつなぐ最終的な橋渡しです。これら3つの要素はそれぞれ今日すでに存在しています。欠けていたのは、それらを1つにまとめる単一のツールでした。
W-2データ入力の問題が47年間続いてきたのは、それを解決する技術が存在しなかったからではなく、アプローチが間違っていたからです。テンプレートベースのシステムは、W-2を自社の抽出モデルに適合させようとしました。セマンティックシステムは、W-2が実際に届く形 — 多様で、物理的で、不完全な形 — のまま読み取り、それでもデータを抽出します。その違い — フォームをツールに適合させるのではなく、ツールをフォームに適合させること — こそが、ついに自動化を可能にする構造的転換なのです。
よくある質問
紙のW-2の写真からデータを抽出できますか、それともクリーンなPDFである必要がありますか?
セマンティックAIモデルは、紙のW-2の写真をクリーンなデジタルPDFと同じ方法で処理します。テンプレートに一致させるのではなく、各フィールドラベルの意味を読み取ります。クライアントが撮影してテキストで送ってきたCopy Bのスマートフォン写真も有効な入力です。写真の品質は重要です(適度に明るく、ピントが合っていること)が、形式は問いません。JPG、PNG、PDFのすべてに対応しています。
異なる給与プロバイダーからのW-2が50枚ある場合、それらをすべて一度に処理できますか?
はい。バッチ処理は、複数の提供元が混在するW-2バッチ用に特別に設計されています。50ファイルすべてを1回のセッションでアップロードします(ADPのPDF、PaychexのPDF、紙のフォームの電話写真など)。必要な出力列を一度定義するだけで(Box 1の賃金、Box 2の連邦税、Box 4の社会保障、従業員名、従業員のSSN、雇用主のEIN)、システムは従業員ごとに1行の単一のExcelスプレッドシートを返します。抽出はファイルテンプレートではなくフィールドの意味に基づいて行われるため、異なる給与プロバイダーのレイアウトごとに個別の設定は必要ありません。
W-2フォームの手書きの修正はどうですか — AIはそれを読み取れますか?
手書き認識でトレーニングされたセマンティックAIモデルは、同じフィールドの印刷テキストと手書きの修正を区別できます。Box 3で印刷された数字が取り消し線で消され、手書きの置き換えがある場合、通常は手書きの値として読み取られます — システムは修正を認識します。ただし、ひどく損傷したり、にじんだ手書きは精度を低下させる可能性があります。そのような場合、抽出された出力はソース画像と照合してスポットチェックする必要があります。これは、抽出方法に関係なく標準的な品質管理ステップです。
IRSは電子申告目的でAIツールによって抽出されたW-2データを受け入れますか?
IRSは税理士がクライアントのソース文書をデジタル化する方法を規制していません — 申告された納税申告書の正確性を規制しています。税理士は、税務ソフトウェアに入力されたデータ(手動入力、給与エクスポートからのインポート、AIによる抽出のいずれであっても)がソースW-2と一致することを検証する責任を負います。AI抽出はデータ取り込みステップであり、税理士の検証と専門的判断がコンプライアンスステップのままです。
テンプレートベースのOCRとW-2抽出用セマンティックAIの違いは何ですか?
テンプレートベースのOCRは位置に基づいてデータを抽出します。「この四角形の中に表示されているテキストを読み取る」という方式です。給与計算プロバイダーごとのW-2フォーマットに個別のテンプレートが必要で、明示的にトレーニングされていないフォームでは失敗します。セマンティックAIは意味に基づいてデータを抽出します。「『賃金、チップ、その他の報酬』というラベルのフィールドを見つけ、その隣の金額を返す」という方式です。ADP、Paychex、Gusto、スキャンした紙、スマホの写真など、あらゆるW-2レイアウトで機能します。ラベルがページのどこにあるかは関係ないからです。列名抽出を座標ベースのテンプレートの代わりに使用すると、同じ設定でバッチ内のすべてのW-2をソースに関係なく処理できます。
抽出したW-2データを自動的に照合できますか?たとえば、源泉徴収された社会保障税が賃金の6.2%に等しいかどうかを検証するなどです。
はい。計算列を使用すると、抽出中に検証式を定義できます。Box 3 × 6.2%を計算し、抽出されたBox 4の値と比較して、不一致をフラグする列を追加できます。また、Box 1の賃金がBox 3の社会保障賃金とBox 5のメディケア賃金の合計を非現実的な方法で超えていないかを検証することもできます。これらのクロスチェック(税理士が手作業で行うものと同じ)は抽出時に実行されるため、データが税務ソフトウェアの入力画面に到達する前に差異が明らかになります。
手動入力が終わり、自動化が始まるところ
W-2は自動化を想定して設計されていません。6部構成の配布、紙優先のアーキテクチャ、手書き修正の受け入れなど、フォームの構造的特徴はすべて、人間が読むことを前提としています。47年間、テクノロジー企業はW-2を他の構造化文書と同じように扱ってこの問題を解決しようと試みてきました。テンプレートを作成し、座標を照合し、テキストを抽出する方法です。このアプローチは、W-2がテンプレートに必要な方法で構造化されていないため失敗しました。W-2は、共通のフィールドの意味を共有する、視覚的に異なるドキュメントのファミリーであり、それらに対して機能する唯一の抽出アプローチは、位置ではなく意味を読み取るものです。
セマンティック抽出は、作業単位を「1つのフォーム、1つのテンプレート、1人のタイピスト」から「1つのバッチ、1つの列定義、1回のクリック」に変えます。税理士は依然として結果を検証します。それは専門的判断であり、なくなることはありません。しかし、紙から数字を読み取って画面に転記するのに費やしていた時間(1978年のフォームデザインが2026年の税務シーズンに残した遺産)には、代わりとなるものがあります。