Pourquoi la saisie de données en période de déclaration fiscale
n’a toujours pas été automatisée
Le formulaire W-2 a été normalisé en 1978. Cette année-là, le bureau américain moyen utilisait des machines à écrire, des classeurs et du papier carbone. L’IBM PC n’arriverait que trois ans plus tard. Quarante-sept ans après, environ 245 millions de W-2 circulent chaque année dans l’économie américaine, chacun portant les mêmes 20 cases numérotées et six champs d’identification à lettres conçus pour un monde pré-numérique. Et chaque janvier, dans les cabinets de préparation de déclarations fiscales à travers le pays, un être humain ramasse encore chacun d’eux, lit les chiffres et les tape sur un écran.
Cet article ne porte pas sur une meilleure façon de faire cette saisie. Il porte sur pourquoi la saisie existe encore — les raisons structurelles, réglementaires et techniques qui ont maintenu la saisie de données des W-2 et 1099 obstinément manuelle à travers cinq décennies de progrès informatique. À la fin, vous comprendrez non seulement que le problème est réel, mais aussi pourquoi chaque tentative précédente de le résoudre s’est heurtée aux mêmes murs invisibles.
Points clés à retenir
- L'architecture à six copies du W-2 a été conçue en 1978 pour le papier carbone et les machines à écrire — 245 millions de formulaires par an transitent encore par un système créé avant l'existence de l'ordinateur personnel, et chaque copie suppose qu'un humain saisira ce qu'il lit.
- La SSA détient déjà chaque W-2 sous forme numérique grâce à la transmission électronique des employeurs, mais la Copy B du préparateur fiscal a été conçue pour des yeux humains, pas pour une lecture machine — 66 heures par saison fiscale sont perdues à ressaisir des données qui se trouvent dans une base de données gouvernementale, avec des pénalités de l'IRS à partir de 60 $ par chiffre mal saisi.
- L'OCR basé sur des modèles (reconnaissance optique de caractères — lecture du texte imprimé selon son emplacement sur la page) cherche la Box 1 aux coordonnées de pixels exactes où elle apparaissait sur un échantillon d'entraînement, c'est pourquoi il s'effondre dès qu'un W-2 Paychex ou une photo de téléphone remplace la mise en page ADP — le même champ apparaît à des positions différentes sur les sorties de chaque fournisseur de paie.
- ImageToTable.ai lit les W-2 selon la signification de chaque libellé de champ plutôt que selon son emplacement sur la page, trouvant « Wages, tips, other compensation » où qu'il apparaisse — ainsi ADP, Paychex, Gusto, les copies scannées et les photos de téléphone sont tous traités en un seul lot, car l'outil s'adapte au formulaire au lieu d'exiger que le formulaire corresponde à un modèle.
Le W-2 a été conçu pour le papier carbone, pas pour les ordinateurs
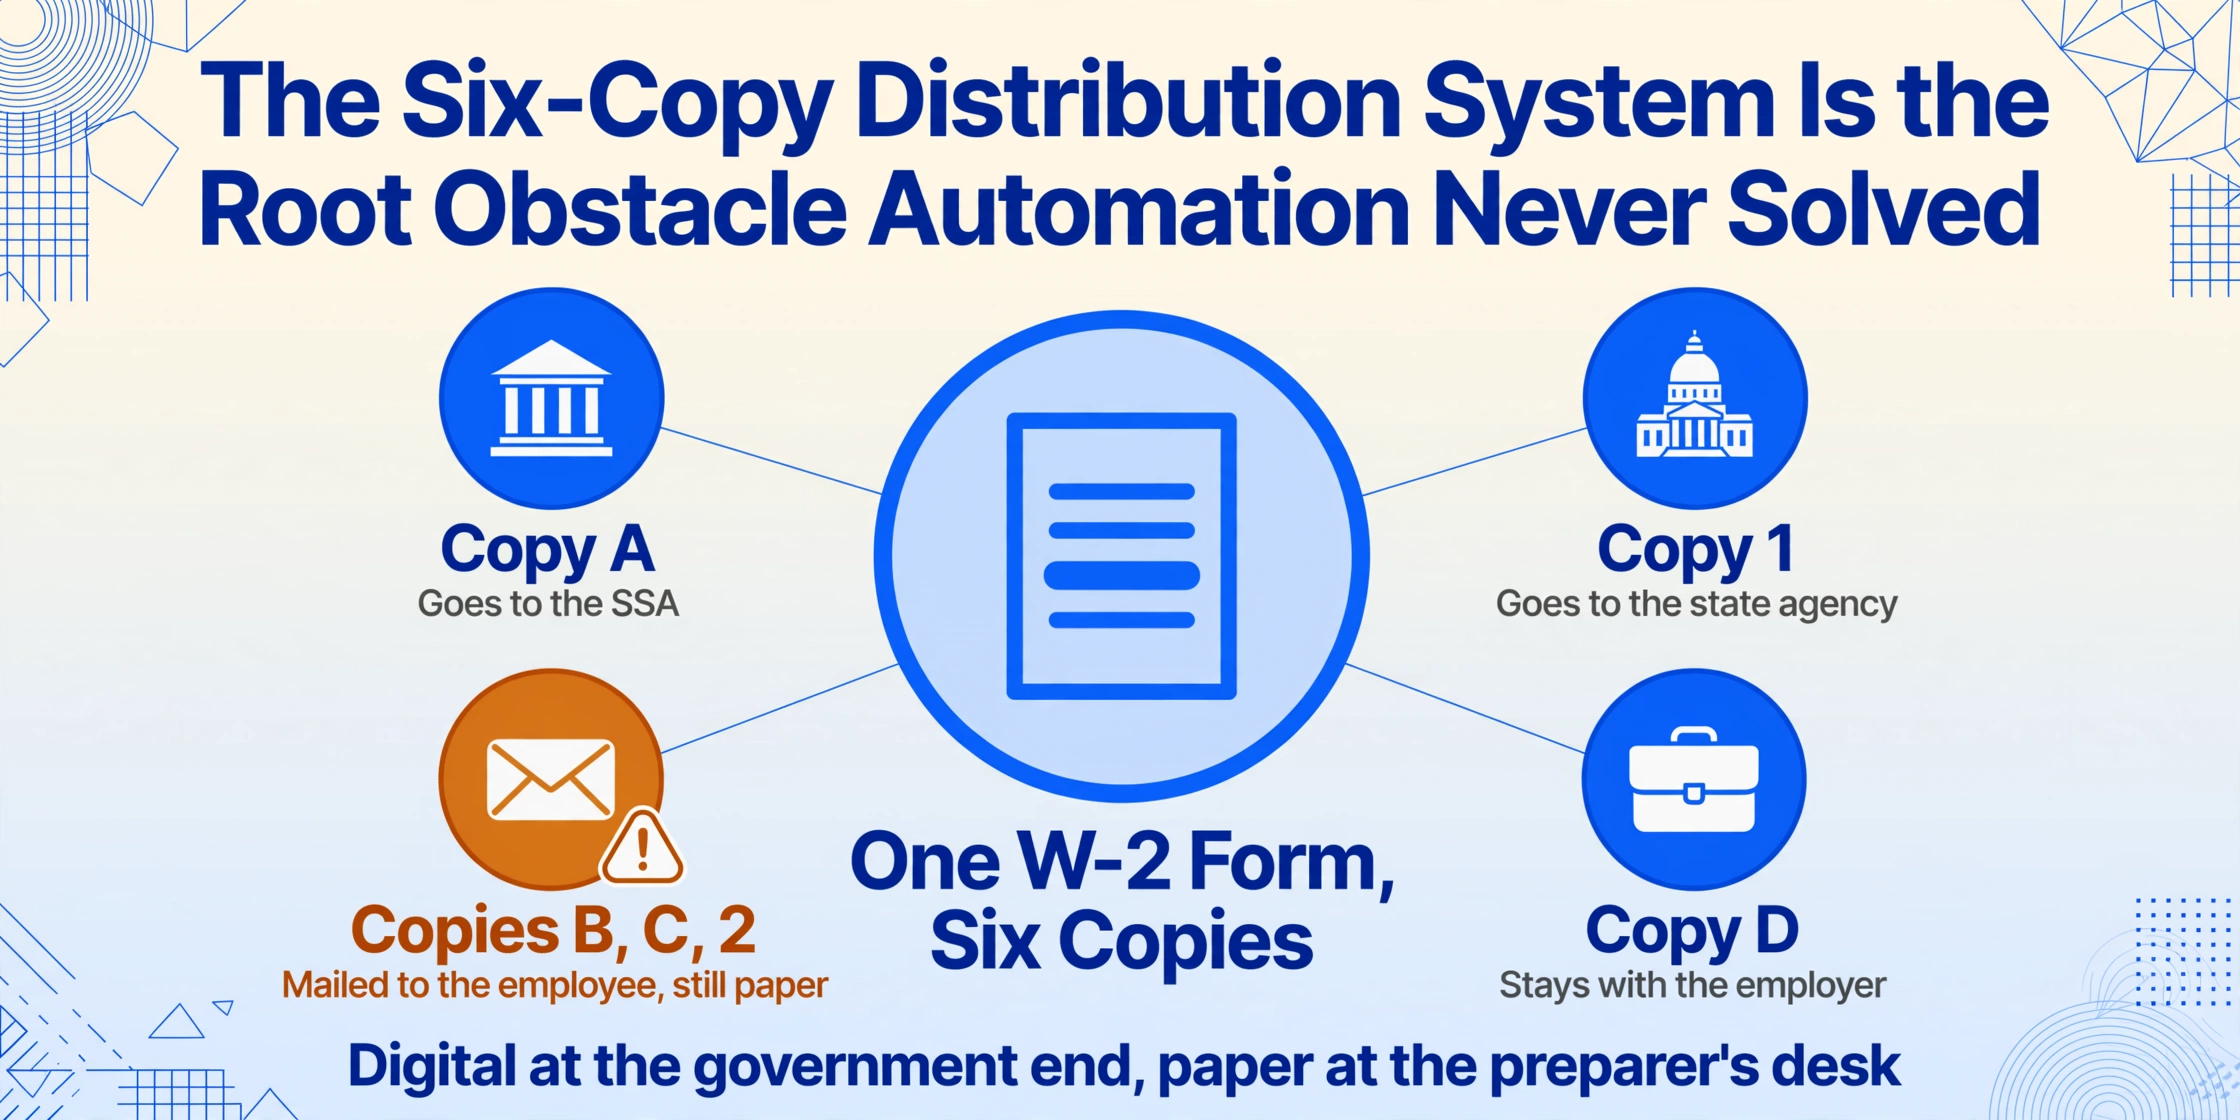
Le système de distribution en six exemplaires du W-2 n’est pas une relique oubliée par l’IRS — c’est l’architecture fondatrice du formulaire. L’exemplaire A va à la Social Security Administration, imprimé avec une encre rouge spéciale anti-reflet pour que les scanners optiques de la SSA puissent le lire. L’exemplaire 1 va à l’agence fiscale de l’État. Les exemplaires B, C et 2 vont à l’employé — un pour la déclaration fédérale, un pour la déclaration d’État, et un pour les archives de l’employé. L’exemplaire D reste chez l’employeur. Six exemplaires, un seul objectif, et chacun d’eux commence comme une feuille de papier.
Cette architecture avait du sens en 1978, quand le seul moyen de transmettre les données salariales au gouvernement était d’envoyer physiquement une feuille de papier. Mais elle a aussi créé une dépendance structurelle permanente : tant que les employés reçoivent des W-2 papier, quelqu’un dans la chaîne — l’employé, le préparateur de déclarations, le comptable — doit reconvertir ce papier en données numériques. La SSA a depuis créé Business Services Online (BSO), un système de dépôt électronique qui accepte les W-2 au format EFW2, et l’IRS impose le dépôt électronique à partir de 10 déclarations d’information ou plus. Mais l’exemplaire de l’employé — celui qui atterrit sur le bureau d’un préparateur de déclarations — est toujours en papier. Le pont numérique a été construit à l’extrémité employeur-vers-gouvernement du pipeline, pas à l’extrémité employé-vers-préparateur. Le formulaire lui-même n’a jamais été repensé pour combler cet écart.
La conséquence est une contradiction structurelle au cœur de la préparation moderne des déclarations fiscales : le gouvernement reçoit les données du W-2 numériquement via le dépôt électronique de l’employeur, mais le représentant du contribuable — le préparateur qui dépose réellement la déclaration — a reçu les mêmes données sur une feuille de papier envoyée au contribuable en janvier. Deux flux de données parallèles pour le même formulaire, l’un numérique, l’autre physique, et chaque janvier ils se heurtent sur le bureau d’un préparateur de déclarations tenant un formulaire papier et regardant un écran vide.
Le système de distribution en six exemplaires est l’obstacle de fond que l’automatisation n’a jamais résolu
La National Association of Tax Professionals (NATP) rapporte que 65 % du chiffre d’affaires brut de ses 23 000+ cabinets membres est réalisé pendant la saison des impôts. Cette fenêtre de quatre mois — environ de janvier à avril — est la période où toute la profession gagne sa vie. Dans cette fenêtre, janvier est le goulot d’étranglement : les W-2 doivent être fournis aux employés avant le 31 janvier, déposés auprès de la SSA avant le 31 janvier, puis saisis dans le logiciel de préparation des déclarations à temps pour la date limite de dépôt du 15 avril. Un préparateur qui reçoit une boîte à chaussures de W-2 de 50 clients le 1er février a exactement 73 jours pour taper chaque champ de chaque formulaire dans un écran — et c’est avant d’examiner la déclaration, de vérifier les erreurs et de discuter du résultat avec le client.
Le système à six exemplaires signifie que le document source du préparateur n’est presque jamais le fichier numérique original que l’employeur a soumis à la SSA. C’est l’exemplaire B — la copie employé arrivée par courrier, peut-être pliée, peut-être photocopiée, peut-être griffonnée, peut-être photographiée avec un smartphone et envoyée par texto. Le coût de main-d’œuvre de la conversion de cette copie papier est réel et bien documenté — à 8 minutes par formulaire pour une saisie manuelle soignée, un cabinet traitant 500 W-2 sur la saison passe plus de 66 heures à ne faire que lire des formulaires et appuyer sur des touches. Cela représente près de deux semaines complètes d’heures facturables consommées par une activité qui n’ajoute aucune valeur analytique à la déclaration — des heures qu’un flux de travail complet d’extraction W-2 et 1099 remplace par une seule étape de téléversement et de vérification.
Le même W-2 provenant de trois fournisseurs de paie est trois documents différents
Si chaque W-2 était identique — même police, mêmes positions des cases, même géométrie de page — l'extraction automatisée aurait été résolue il y a des décennies. Mais un seul client peut arriver avec deux W-2 de deux employeurs utilisant deux systèmes de paie, plus un 1099-NEC d'un client contractuel utilisant un troisième. ADP positionne la Box 1 (salaires) à un ensemble de coordonnées différent de Paychex, qui la positionne différemment de Gusto, qui la positionne différemment du comptable local qui a imprimé un W-2 depuis QuickBooks sur une imprimante laser et l'a partiellement rempli à la main. L'IRS normalise ce qui doit apparaître sur le formulaire, pas la manière dont il doit être disposé sur la page.
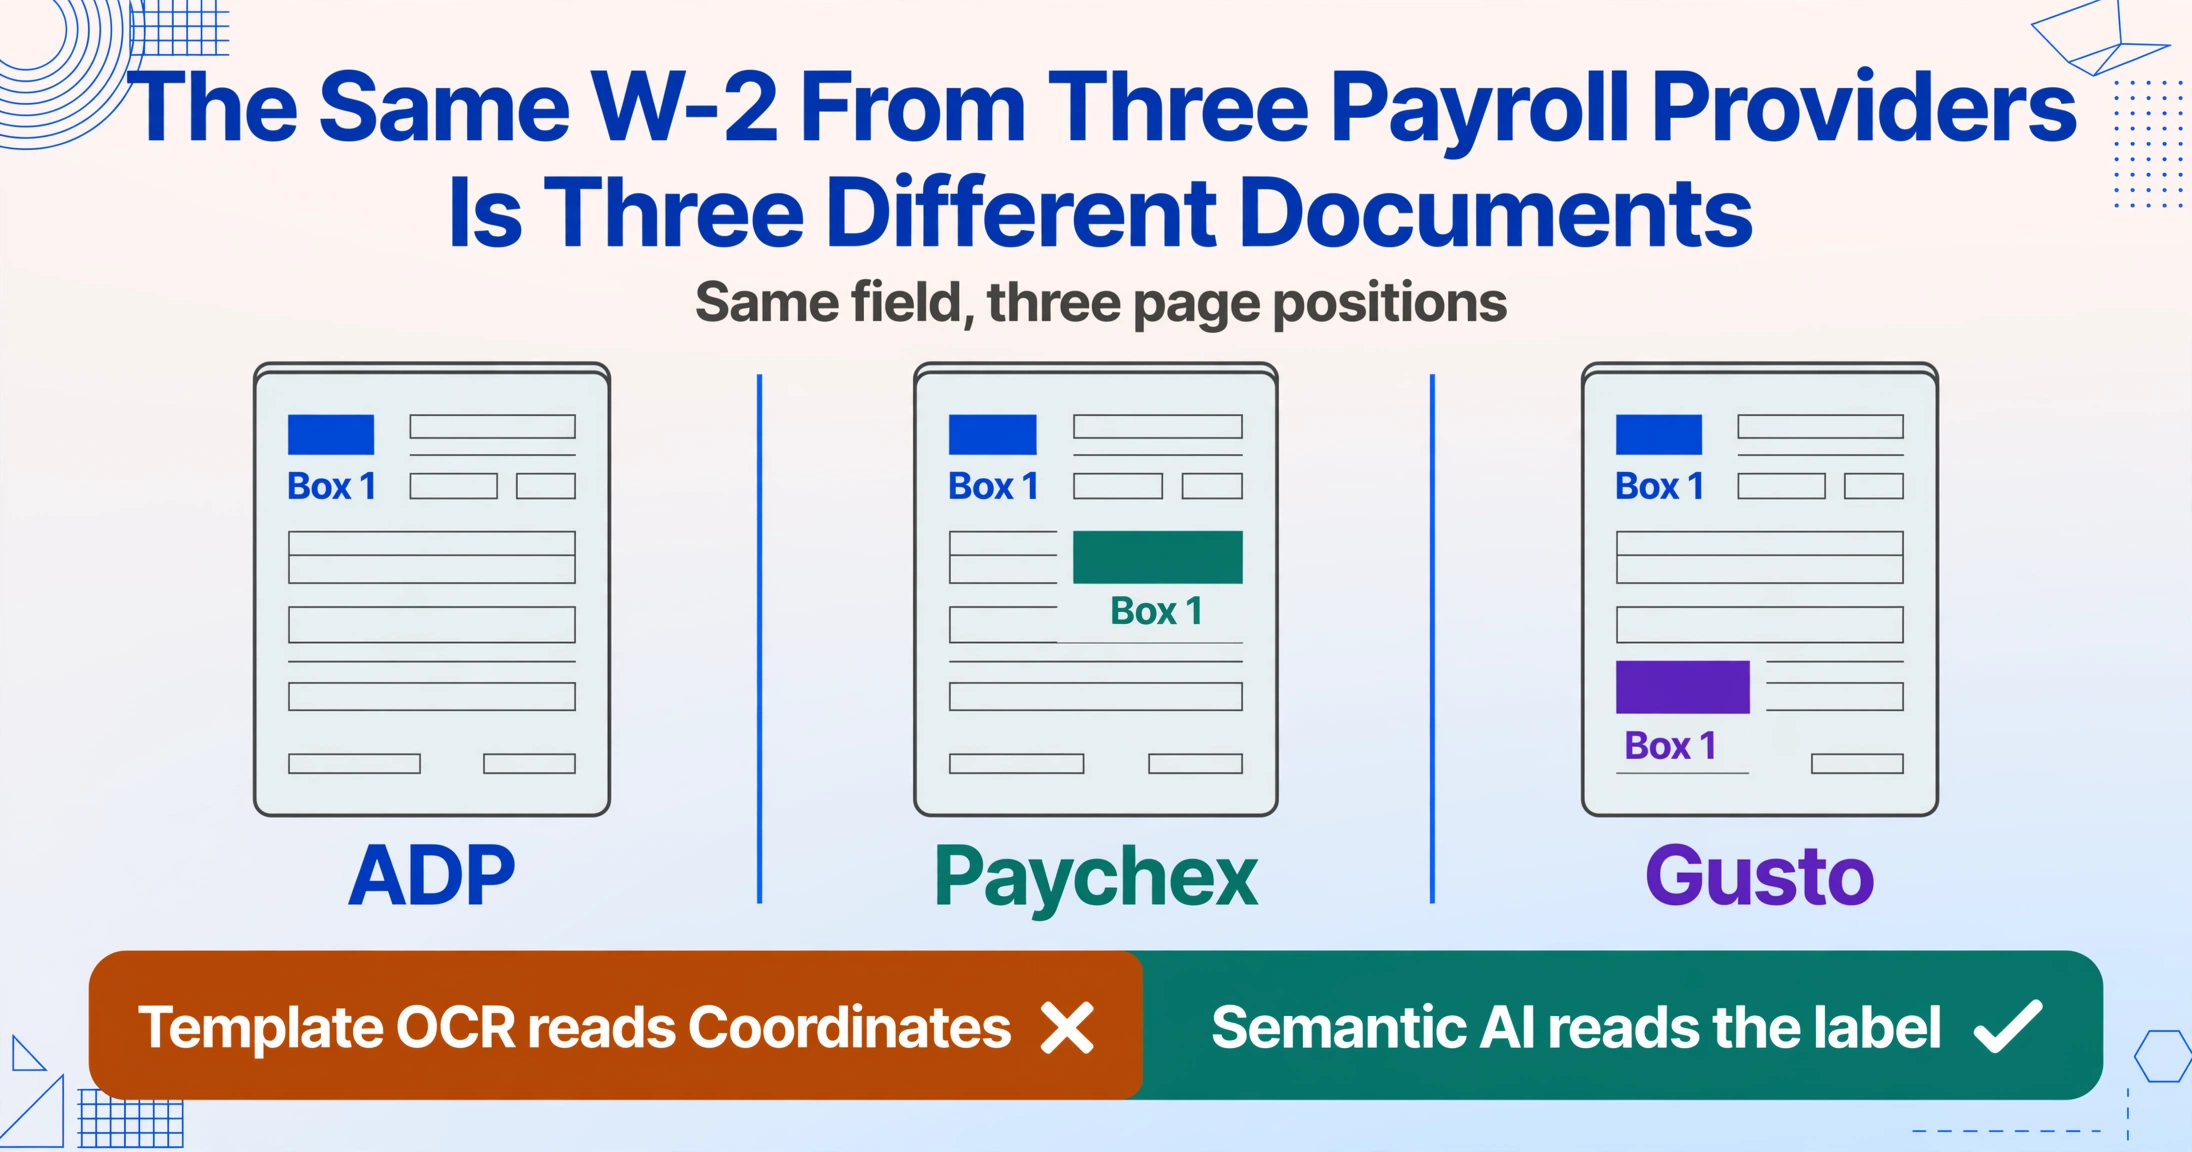
Cette fragmentation est le premier obstacle que rencontre toute approche d'automatisation. Le secteur de la paie s'est consolidé autour d'une poignée de grands fournisseurs — ADP traite à lui seul la paie d'environ un employé américain sur six — mais cette consolidation n'a pas produit de standardisation de la mise en page. Chaque fournisseur génère des W-2 dans son propre format propriétaire, avec ses propres choix de polices, son propre positionnement des cases, ses propres dimensions de page. Le résultat est qu'un lot de 50 W-2 provenant d'un employeur de taille moyenne peut contenir des formulaires de quatre systèmes de paie différents, chacun nécessitant un modèle d'extraction différent — ou, plus couramment, nécessitant qu'un humain les lise et les saisisse.
Et la fragmentation ne se limite pas aux différents fournisseurs. Elle peut survenir au sein d'une même année de déclaration pour un même employé. Une personne qui a changé d'emploi en mars reçoit un W-2 de l'Employeur A et un de l'Employeur B (Paychex). Une personne qui a occupé un emploi avec W-2 et avait une activité secondaire avec 1099 reçoit un W-2 de son employeur et un 1099-NEC du client. Chaque formulaire arrive dans un format différent, par un canal différent, à un moment différent. La diversité n'est pas un cas limite — c'est l'état par défaut de la préparation de la saison des impôts.
L’IRS conserve toujours un pipeline de traitement papier — et c’est ce qui maintient le papier en vie
En vertu du T.D. 9972, l’obligation de dépôt électronique pour les déclarations d’information s’applique à partir de 10 formulaires. Si vous déposez 9 W-2 ou moins, vous pouvez toujours les envoyer par courrier à la SSA sur papier. Les instructions de l’IRS pour le formulaire W-2 reconnaissent ce seuil. À l’échelle nationale, des millions de petits employeurs — restaurants avec six employés, entreprises de construction avec huit, cabinets dentaires avec cinq — se situent sous cette limite. Chacun imprime une pile de W-2, les remplit (parfois à la main), et les envoie par courrier à la SSA tout en remettant des copies papier aux employés.
Ce n’est pas un oubli réglementaire. C’est une accommodation délibérée. L’IRS sait qu’exiger de chaque entreprise d’aménagement paysager à deux personnes qu’elle navigue dans le système de dépôt électronique BSO de la SSA — avec ses spécifications de format EFW2, son logiciel de validation AccuWage et ses exigences de vérification SSN — représenterait une charge de conformité déraisonnable. Le pipeline papier reste donc ouvert. Et chaque W-2 papier créé sous le seuil de dépôt électronique est un W-2 qui finira éventuellement entre les mains d’un préparateur fiscal, nécessitant d’être transcrit.
Le barème des pénalités de l’IRS rend cela plus qu’une simple gêne. En vertu des §§ 6721 et 6722 du Code des impôts internes, les déclarations d’information en retard ou incorrectes sont pénalisées par formulaire — le barème va de 60 $ à 680 $ selon le moment de la correction et l’intention. Un préparateur qui fait une erreur de frappe sur un seul chiffre dans la Box 1 et dépose une déclaration incorrecte a créé une responsabilité — non pas pour l’employeur, mais potentiellement imputable à l’erreur de transcription du préparateur. Pour une analyse complète de ce que ces pénalités par formulaire et ces erreurs de transcription coûtent à un cabinet sur une saison, consultez notre analyse des coûts de la saisie manuelle des W-2 et 1099.
La marque de stylo dans la Box 3 qui fait échouer toutes les chaînes d’automatisation
L’un des constats les plus récurrents chez les professionnels de la préparation fiscale est que les W-2 reçus des clients sont rarement impeccables. Un montant de salaire corrigé pour la Social Security est écrit à la main au-dessus du chiffre imprimé. Un EIN est barré puis ressaisi. Les cases de la Box 13 sont cochées au stylo au lieu de l’encre d’origine de l’imprimante. Une tache de café masque le numéro d’identification de l’État. Le formulaire a été plié en trois pour une enveloppe commerciale puis déplié — laissant des lignes de pliure à travers les champs de salaire. Rien de tout cela n’est inhabituel. C’est l’état de base des documents fiscaux papier soumis par de vrais contribuables.
Pour les systèmes OCR basés sur des modèles, chacune de ces variations est un point de défaillance. Les chiffres manuscrits superposés au texte imprimé perturbent la reconnaissance des caractères. Les lignes de pliure traversant les champs numériques brisent la segmentation des chiffres. Les cases cochées avec le mauvais type de marque — un cercle au lieu d’un X, une coche au lieu d’un carré rempli — renvoient des valeurs nulles là où une sélection devrait exister. Un système entraîné sur des PDF propres numérisés à plat de formulaires fraîchement imprimés n’a aucun modèle pour l’état physique d’un W-2 qui a transité par le service postal américain, est resté deux semaines sur un plan de cuisine, et a été rempli au stylo à bille par quelqu’un qui n’était pas sûr de ce que signifiait le code DD de la Box 12.
L’ironie la plus douloureuse, c’est qu’un préparateur humain peut traiter ce document dégradé presque instantanément. Un coup d’œil à une Box 3 barrée avec une correction manuscrite indique au préparateur : « le chiffre d’origine était faux, utilisez celui écrit à la main. » Un système basé sur des modèles voit deux chiffres concurrents dans le même champ et n’en renvoie aucun — ou pire, renvoie le mauvais. Le jugement qu’un préparateur expérimenté applique en une demi-seconde est exactement ce qui manque aux systèmes d’automatisation, et exactement ce qui a maintenu l’humain au centre de la boucle de transcription des W-2.
Les logiciels de préparation fiscale peuvent transmettre des données — ils ne peuvent pas lire le document papier de votre client
Les principales plateformes de préparation fiscale de la profession — Drake, UltraTax, Lacerte, ProSeries, ATX — prennent toutes en charge l'importation des données W-2. À partir d'un CSV. À partir d'une déclaration de l'année précédente. À partir d'un export numérique d'un fournisseur de paie. Ce qu'aucune d'entre elles ne peut faire, c'est lire un formulaire W-2 papier (copie B) qu'un client a remis au préparateur par-dessus un bureau. L'importateur attend une saisie numérique structurée, et le document source est du papier physique non structuré. Le préparateur constitue la couche de conversion.
Même lorsque les données W-2 ont été transmises par voie électronique à la SSA, le préparateur ne peut pas simplement les extraire de la base de données de la SSA vers Drake. Le système Business Services Online de la SSA fournit les données salariales à l'IRS pour le contrôle de conformité, et non aux préparateurs fiscaux pour la préparation des déclarations. La transcription des salaires et revenus (Wage and Income Transcript) — que le préparateur peut consulter via le système de délivrance de transcriptions de l'IRS (TDS) — est accessible aux professionnels de la fiscalité munis d'un formulaire 8821 signé ou d'une procuration (Power of Attorney), mais elle arrive sous forme de résumé expurgé, et non de données structurées au niveau des champs. Le préparateur, avec le formulaire W-2 papier d'un client dans une main et un écran de saisie Drake sur l'autre, tape donc toujours.
Le Bureau of Labor Statistics des États-Unis a estimé le salaire horaire médian des comptables et auditeurs à 39,27 $ en mai 2024. En incluant les avantages sociaux, les charges sociales, les frais généraux de bureau et les licences logicielles, le coût d'un comptable salarié pour le cabinet se rapproche de 55 à 65 $ de l'heure. Chaque heure que ce comptable consacre à la transcription des champs W-2 — une tâche qui n'apporte aucun jugement analytique — est une heure non consacrée à l'examen de la déclaration, à l'identification d'opportunités d'économies d'impôt ou à la consultation du client. Le coût de la saisie des données elle-même a été chiffré entre 4 000 et 6 000 $ par saison fiscale pour un cabinet de taille moyenne. Le coût d'opportunité — le travail facturable supplanté par la frappe — est plus difficile à mesurer, mais presque certainement plus élevé.
L'OCR basé sur des modèles échoue sur les W-2 pour la même raison structurelle qui le fait toujours échouer : la variation de mise en page
Pendant deux décennies, l'approche dominante de l'extraction de données documentaires a été l'OCR basé sur des modèles. Vous créez un modèle qui dit « Box 1 se trouve aux coordonnées (x1, y1, x2, y2) sur ce W-2 généré par ADP » et le système lit le texte qui tombe dans ce rectangle. Cela fonctionne très bien pour les documents aux mises en page fixes et prévisibles — une facture spécifique d'un fournisseur spécifique, toujours générée par le même système ERP, toujours présentée de la même façon. Cela fonctionne très mal pour les W-2, où le même champ (Box 1) apparaît à des positions différentes sur la sortie de chaque fournisseur de paie et sur chaque copie papier numérisée.
Le problème sous-jacent est que l'OCR basé sur des modèles lit les documents par position, et non par signification. Il sait où Box 1 se trouvait sur l'échantillon d'entraînement, pas ce que Box 1 est sur le document actuel. Cette distinction — position vs. signification — est la raison centrale pour laquelle la saisie de données W-2 a résisté à l'automatisation. La spécification du formulaire garantit quelles informations apparaissent (salaires, impôt retenu, SSN, EIN), mais pas où ces informations se situent sur la page physique ou numérique. Tout système qui s'appuie sur le « où » pour déterminer le « quoi » s'effondrera dès qu'il rencontrera un W-2 d'un fournisseur de paie sur lequel il n'a pas été entraîné.
Les outils à modèle échouent aussi sur le problème multi-source. Un modèle conçu pour « ADP W-2, format 2024 » ne peut pas extraire de données d'un « Paychex W-2, format 2024 » — et encore moins d'une « photo d'un W-2 papier d'un petit employeur, format 2024, avec une correction manuscrite dans la Box 3. » Le préparateur devrait maintenir une bibliothèque de modèles pour chaque fournisseur de paie utilisé par l'employeur de chaque client, mise à jour chaque année à mesure que chaque fournisseur modifie sa mise en page de formulaire. La charge de maintenance à elle seule rend l'approche impraticable à toute échelle réelle. Pour un aperçu étape par étape de la façon dont l'extraction sémantique lit chaque case à travers ces mises en page — et où elle trébuche encore — voir le guide complet de l'extraction W-2 et 1099.
La compréhension sémantique remplace la position par le sens — et cela change ce que l'automatisation peut faire
L'alternative à l'extraction basée sur des modèles est la compréhension sémantique des documents : un modèle d'IA qui lit un W-2 comme le ferait un humain — en reconnaissant ce que chaque champ signifie, et non où il se trouve. Lorsque vous voyez “Wages, tips, other compensation” sur un W-2, vous savez qu'il s'agit de la Box 1, qu'elle apparaisse en haut à gauche sur un PDF ADP, en haut à droite sur un PDF Paychex, ou au milieu d'une photo de formulaire papier prise avec un téléphone. L'IA sémantique porte le même jugement : elle identifie “Wages, tips, other compensation” comme un concept et extrait le montant en dollars qui l'accompagne, que ce montant soit imprimé, manuscrit ou corrigé par un barré.
Ce changement — passer d'une extraction par coordonnées à une extraction par concepts — est ce qui rend l'automatisation des W-2 techniquement réalisable pour la première fois. Au lieu de définir où se trouve la Box 1 sur un modèle spécifique, vous indiquez au système : “Extrayez le montant en dollars étiqueté Wages, tips, other compensation.” Le système lit l'intégralité du formulaire, trouve cette étiquette où qu'elle apparaisse, et renvoie la valeur qui l'accompagne. Cette approche — parfois appelée extraction par nom de colonne, où vous définissez les champs souhaités par leurs noms sémantiques plutôt que par leurs coordonnées sur la page — gère les trois fournisseurs de paie, la correction manuscrite et la photo prise au téléphone en une seule passe, car elle ne dépend jamais de la connaissance préalable de l'emplacement des éléments.
C'est également là que l'extraction des données W-2 des PDF vers des feuilles de calcul structurées devient possible à grande échelle. Un préparateur définit les noms de colonnes — “Box 1 Wages,” “Box 2 Federal Tax Withheld,” “Box b EIN,” “Employee SSN” — et le modèle sémantique trouve chaque valeur dans tous les W-2 du lot, quel que soit le fournisseur de paie ayant généré chaque formulaire. Le résultat est une seule feuille Excel avec une ligne par employé, prête à être importée dans Drake ou UltraTax, sans qu'aucun champ ne soit saisi manuellement.
Ce que l’automatisation de bout en bout des W-2 exigerait — et pourquoi trois éléments sont enfin en place
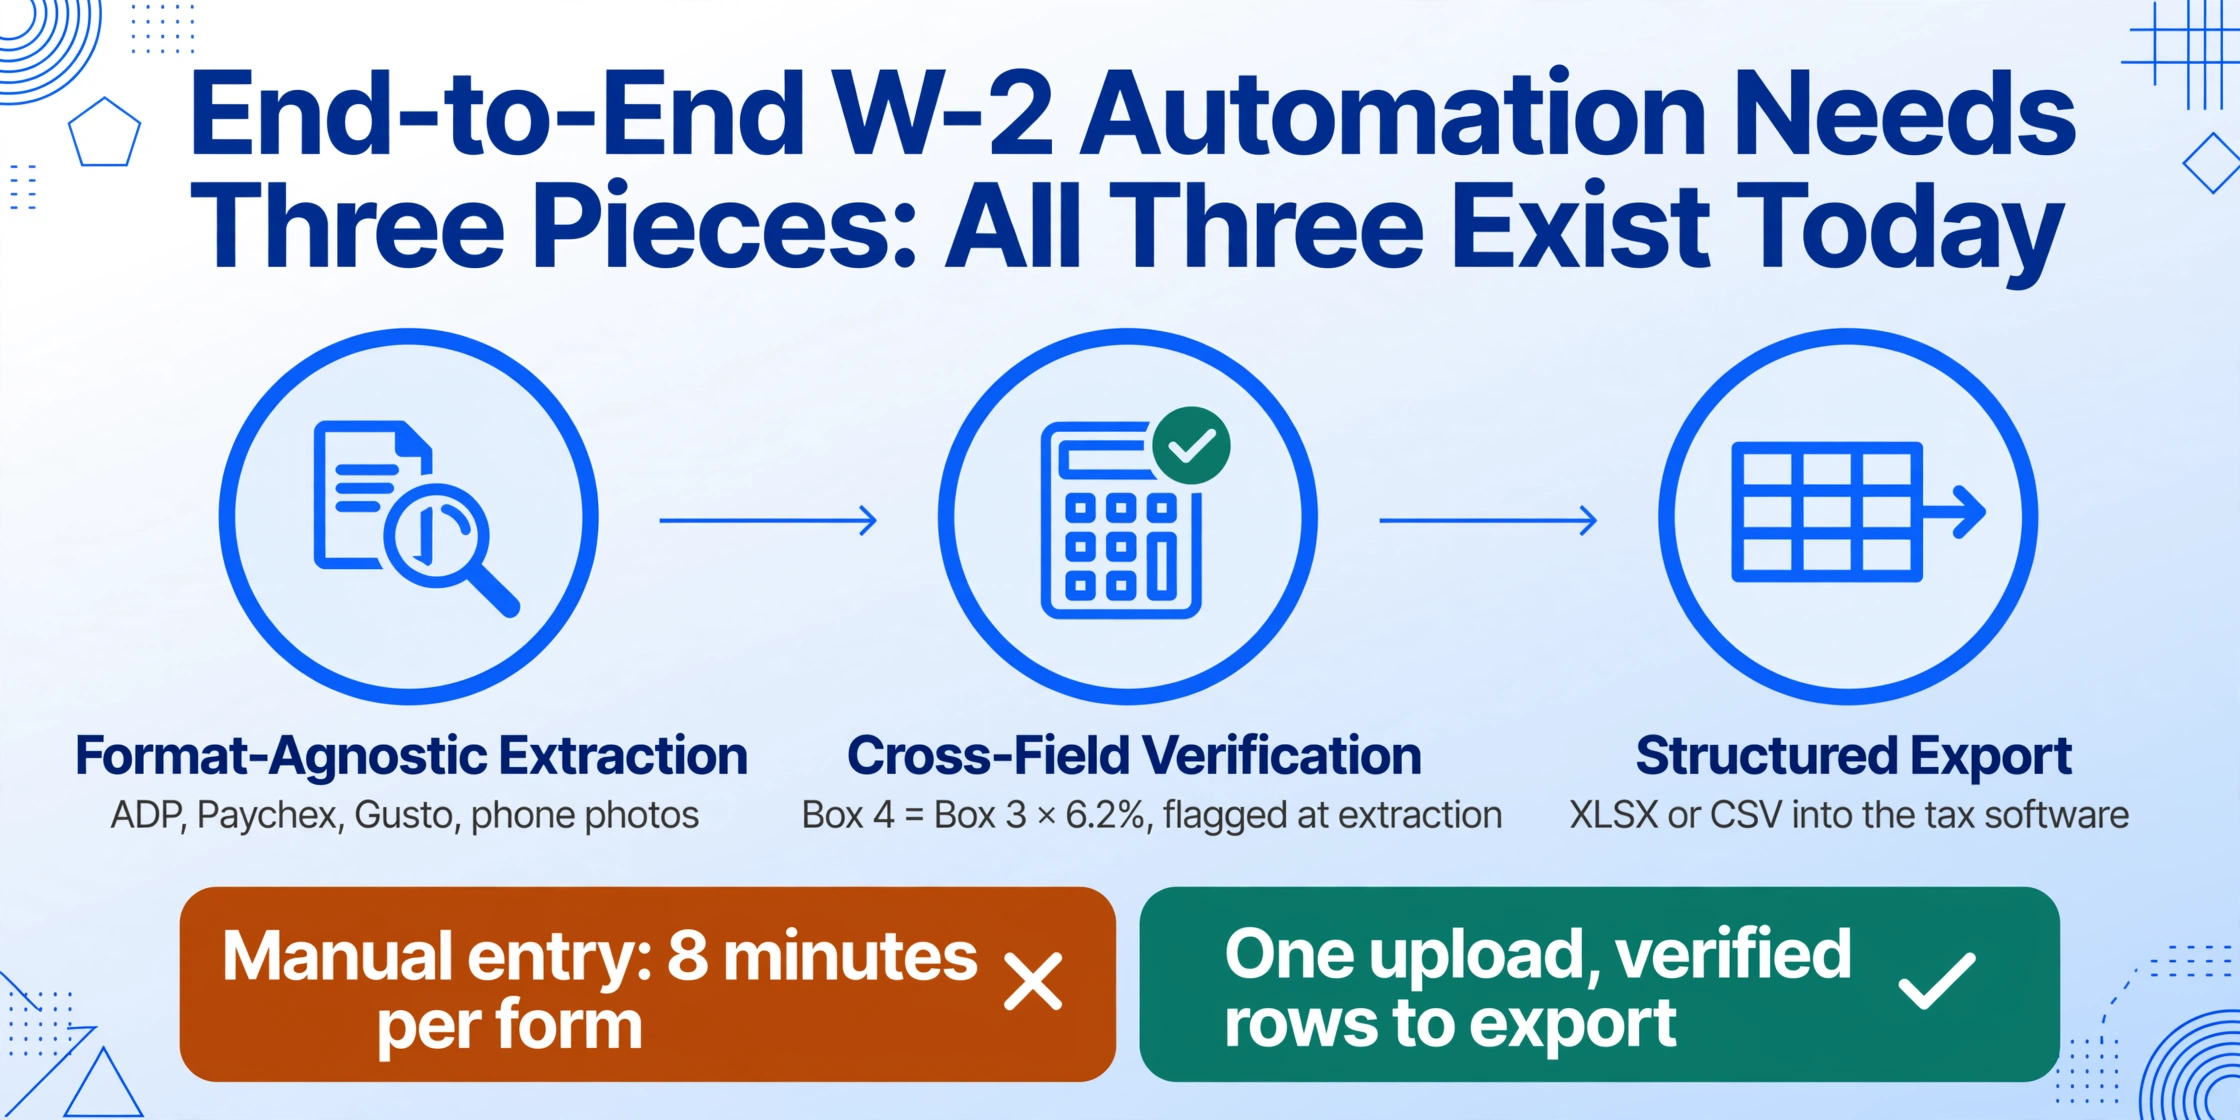
L’automatisation complète de la saisie des données W-2 — de la réception des documents clients à l’importation dans le logiciel fiscal — exige trois capacités qui ont historiquement existé dans des systèmes séparés :
- Extraction de champs indépendante du format — lire correctement le même champ sur ADP, Paychex, Gusto, des copies papier scannées et des photos de téléphone, sans modèles par fournisseur.
- Vérification croisée des champs — vérifier automatiquement que la Box 4 (taxe de sécurité sociale) est égale à la Box 3 × 6,2 %, que la Box 2 (retenue fédérale) est plausible par rapport aux salaires de la Box 1, et que le format du SSN est valide. C’est l’étape de jugement du préparateur — et elle doit se produire au moment de l’extraction, pas lors d’une révision ultérieure.
- Export structuré — livrer les données extraites et vérifiées dans un format que le logiciel de préparation fiscale peut consommer directement (XLSX, CSV), éliminant entièrement l’étape de ressaisie.
Le premier élément — l’extraction indépendante du format — est ce que l’IA sémantique permet. Le deuxième élément — la vérification croisée des champs — est ce que les colonnes calculées apportent au flux de travail : la capacité de définir, au moment de l’extraction, des calculs comme « vérifier que la Box 4 = Box 3 × 0,062 » et de signaler les écarts avant que les données n’atteignent la feuille de calcul. Le troisième élément — l’export structuré — est le pont final entre la pile de documents du préparateur et l’écran d’importation du logiciel fiscal. Chacun de ces trois éléments existe aujourd’hui. Ce qui manquait, c’était un outil unique qui les réunit.
Le problème de la saisie des données W-2 persiste depuis 47 ans, non pas parce que la technologie pour le résoudre n’existait pas, mais parce que l’approche était erronée. Les systèmes basés sur des modèles tentaient de faire correspondre les W-2 à leur modèle d’extraction. Les systèmes sémantiques lisent les W-2 tels qu’ils arrivent réellement — variés, physiques, imparfaits — et extraient les données quand même. Cette différence — faire en sorte que l’outil s’adapte au formulaire au lieu d’exiger que le formulaire s’adapte à l’outil — est le changement structurel qui rend enfin l’automatisation possible.
Questions fréquentes
Puis-je extraire des données d'une photo d'un W-2 papier, ou faut-il un PDF propre ?
Les modèles d'IA sémantique traitent les photos de W-2 papier de la même manière que les PDF numériques propres — en lisant la signification de chaque libellé de champ, et non en faisant correspondre un modèle. Une photo de Copy B prise par votre client et envoyée par texto est une entrée valide. La qualité de la photo compte — raisonnablement bien éclairée et nette — mais pas le format. JPG, PNG et PDF sont tous pris en charge.
Si j'ai 50 W-2 provenant de différents fournisseurs de paie, puis-je tous les traiter en une seule fois ?
Oui. Le traitement par lots est conçu spécifiquement pour les lots de W-2 provenant de sources mixtes. Vous téléversez les 50 fichiers en une seule session — PDF ADP, PDF Paychex, photos de formulaires papier prises au téléphone — définissez une fois vos colonnes de sortie souhaitées (Box 1 salaires, Box 2 impôt fédéral, Box 4 Social Security, nom de l'employé, SSN de l'employé, EIN de l'employeur), et le système renvoie une seule feuille de calcul Excel avec une ligne par employé. L'extraction se fait par la signification des champs, et non par le modèle de fichier, donc les mises en page des différents fournisseurs de paie ne nécessitent pas de configurations séparées.
Qu'en est-il des corrections manuscrites sur les formulaires W-2 — l'IA peut-elle les lire ?
Les modèles d'IA sémantique entraînés à la reconnaissance de l'écriture manuscrite peuvent distinguer le texte imprimé des corrections manuscrites sur le même champ. Une valeur imprimée barrée avec un remplacement manuscrit dans la Box 3 sera généralement lue comme la valeur manuscrite — le système reconnaît la correction. Cependant, une écriture fortement endommagée ou maculée peut réduire la précision. Dans ces cas, la sortie extraite doit être vérifiée ponctuellement par rapport à l'image source, ce qui est une étape standard de contrôle qualité, quelle que soit la méthode d'extraction.
L'IRS accepte-t-il les données W-2 extraites par des outils d'IA pour le dépôt électronique ?
L'IRS ne réglemente pas la façon dont les préparateurs numérisent les documents sources des clients — il réglemente l'exactitude de la déclaration déposée. Les préparateurs restent responsables de vérifier que les données saisies dans le logiciel fiscal (qu'elles soient tapées manuellement, importées depuis un export de paie ou extraites par IA) correspondent au W-2 source. L'extraction par IA est l'étape de saisie des données ; la vérification du préparateur et son jugement professionnel restent l'étape de conformité.
Quelle est la différence entre l’OCR basé sur des modèles et l’IA sémantique pour l’extraction de W-2 ?
L’OCR basé sur des modèles extrait les données par position : « lisez le texte qui apparaît dans ce rectangle. » Il nécessite un modèle distinct pour chaque format de W-2 de chaque fournisseur de paie et échoue sur tout formulaire pour lequel il n’a pas été explicitement entraîné. L’IA sémantique extrait les données par le sens : « trouvez le champ intitulé ‘Salaires, pourboires, autres rémunérations’ et renvoyez le montant en dollars à côté. » Elle fonctionne avec n’importe quelle mise en page de W-2 — ADP, Paychex, Gusto, papier scanné, photo de téléphone — car elle ne se soucie pas de l’endroit où l’étiquette apparaît sur la page. Lorsque vous utilisez l’extraction par nom de colonne au lieu de modèles basés sur les coordonnées, la même configuration traite chaque W-2 de votre lot, quelle que soit la source.
Puis-je recouper automatiquement les données W-2 extraites — par exemple, vérifier que la taxe de sécurité sociale retenue équivaut à 6,2 % des salaires ?
Oui. Les colonnes calculées vous permettent de définir des formules de vérification lors de l’extraction. Vous pouvez ajouter une colonne qui calcule Box 3 × 6,2 % et la compare à la valeur extraite de Box 4, signalant toute divergence. Vous pouvez également vérifier que les salaires de Box 1 ne dépassent pas les salaires de sécurité sociale de Box 3 plus les salaires Medicare de Box 5 de manière impossible. Ces recoupements — les mêmes qu’un préparateur effectue manuellement — se produisent au moment de l’extraction, de sorte que les écarts sont signalés avant que les données n’atteignent l’écran de saisie du logiciel fiscal.
Là où la saisie manuelle se termine et où l’automatisation commence
Le W-2 n’a pas été conçu pour être automatisé. Sa distribution en six exemplaires, son architecture papier d’abord, son acceptation des corrections manuscrites — chaque caractéristique structurelle du formulaire suppose qu’un être humain le lira. Pendant 47 ans, les entreprises technologiques ont tenté de résoudre ce problème en traitant les W-2 comme tout autre document structuré : créer un modèle, faire correspondre les coordonnées, extraire le texte. Cette approche a échoué parce que les W-2 ne sont pas structurés de la manière exigée par les modèles. Ils constituent une famille de documents visuellement différents partageant un ensemble commun de significations de champs — et la seule approche d’extraction qui fonctionne sur eux est celle qui lit le sens, pas la position.
L’extraction sémantique change l’unité de travail de « un formulaire, un modèle, une dactylo » à « un lot, une définition de colonne, un clic. » Le préparateur vérifie toujours le résultat — c’est un jugement professionnel, et cela ne va pas disparaître. Mais les heures passées à lire des chiffres sur une feuille de papier et à les transférer sur un écran — l’héritage d’une conception de formulaire de 1978 dans une saison fiscale de 2026 — ces heures ont un remplaçant.