Still Hasn’t Been Automated
The W-2 form was standardized in 1978. That year, the average American office used typewriters, filing cabinets, and carbon paper. The IBM PC was three years in the future. Forty-seven years later, approximately 245 million W-2s flow through the U.S. economy each year, each one wearing the same 20 numbered boxes and six lettered identifier fields that were designed for a pre-digital world. And every January, in tax preparation offices across the country, a human being still picks up each one, reads the numbers, and types them into a screen.
This article is not about a better way to do that typing. It is about why the typing still exists — the structural, regulatory, and technical reasons that have kept W-2 and 1099 data entry stubbornly manual across five decades of computing progress. By the end, you will understand not just that the problem is real, but why every previous attempt to solve it has hit the same invisible walls.
Principais Conclusões
- A arquitetura de seis cópias do W-2 foi projetada em 1978 para papel carbono e máquinas de escrever — 245 milhões de formulários por ano ainda passam por um sistema criado antes do computador pessoal existir, e cada cópia pressupõe que um humano vai digitar o que lê.
- A SSA já possui cada W-2 digitalmente a partir do e-filing do empregador, mas a Copy B do preparador de impostos foi feita para olhos humanos, não para leitura por máquina — 66 horas por temporada de impostos desaparecem redigitando dados que estão em um banco de dados do governo, com penalidades do IRS a partir de $60 por dígito digitado errado.
- O OCR baseado em modelo (reconhecimento óptico de caracteres — leitura de texto impresso pela sua localização na página) procura o Box 1 nas coordenadas exatas de pixels onde ele apareceu em uma amostra de treinamento, e é por isso que ele falha no momento em que um W-2 da Paychex ou uma foto de celular substitui o layout da ADP — o mesmo campo aparece em posições diferentes na saída de cada provedor de folha de pagamento.
- O ImageToTable.ai lê W-2s pelo que cada rótulo de campo significa, em vez de onde ele está na página, encontrando "Wages, tips, other compensation" onde quer que apareça — então ADP, Paychex, Gusto, cópias digitalizadas e fotos de celular são processados em um único lote porque a ferramenta se adapta ao formulário em vez de exigir que o formulário corresponda a um modelo.
O W-2 Foi Projetado para Papel Carbono, Não para Computadores
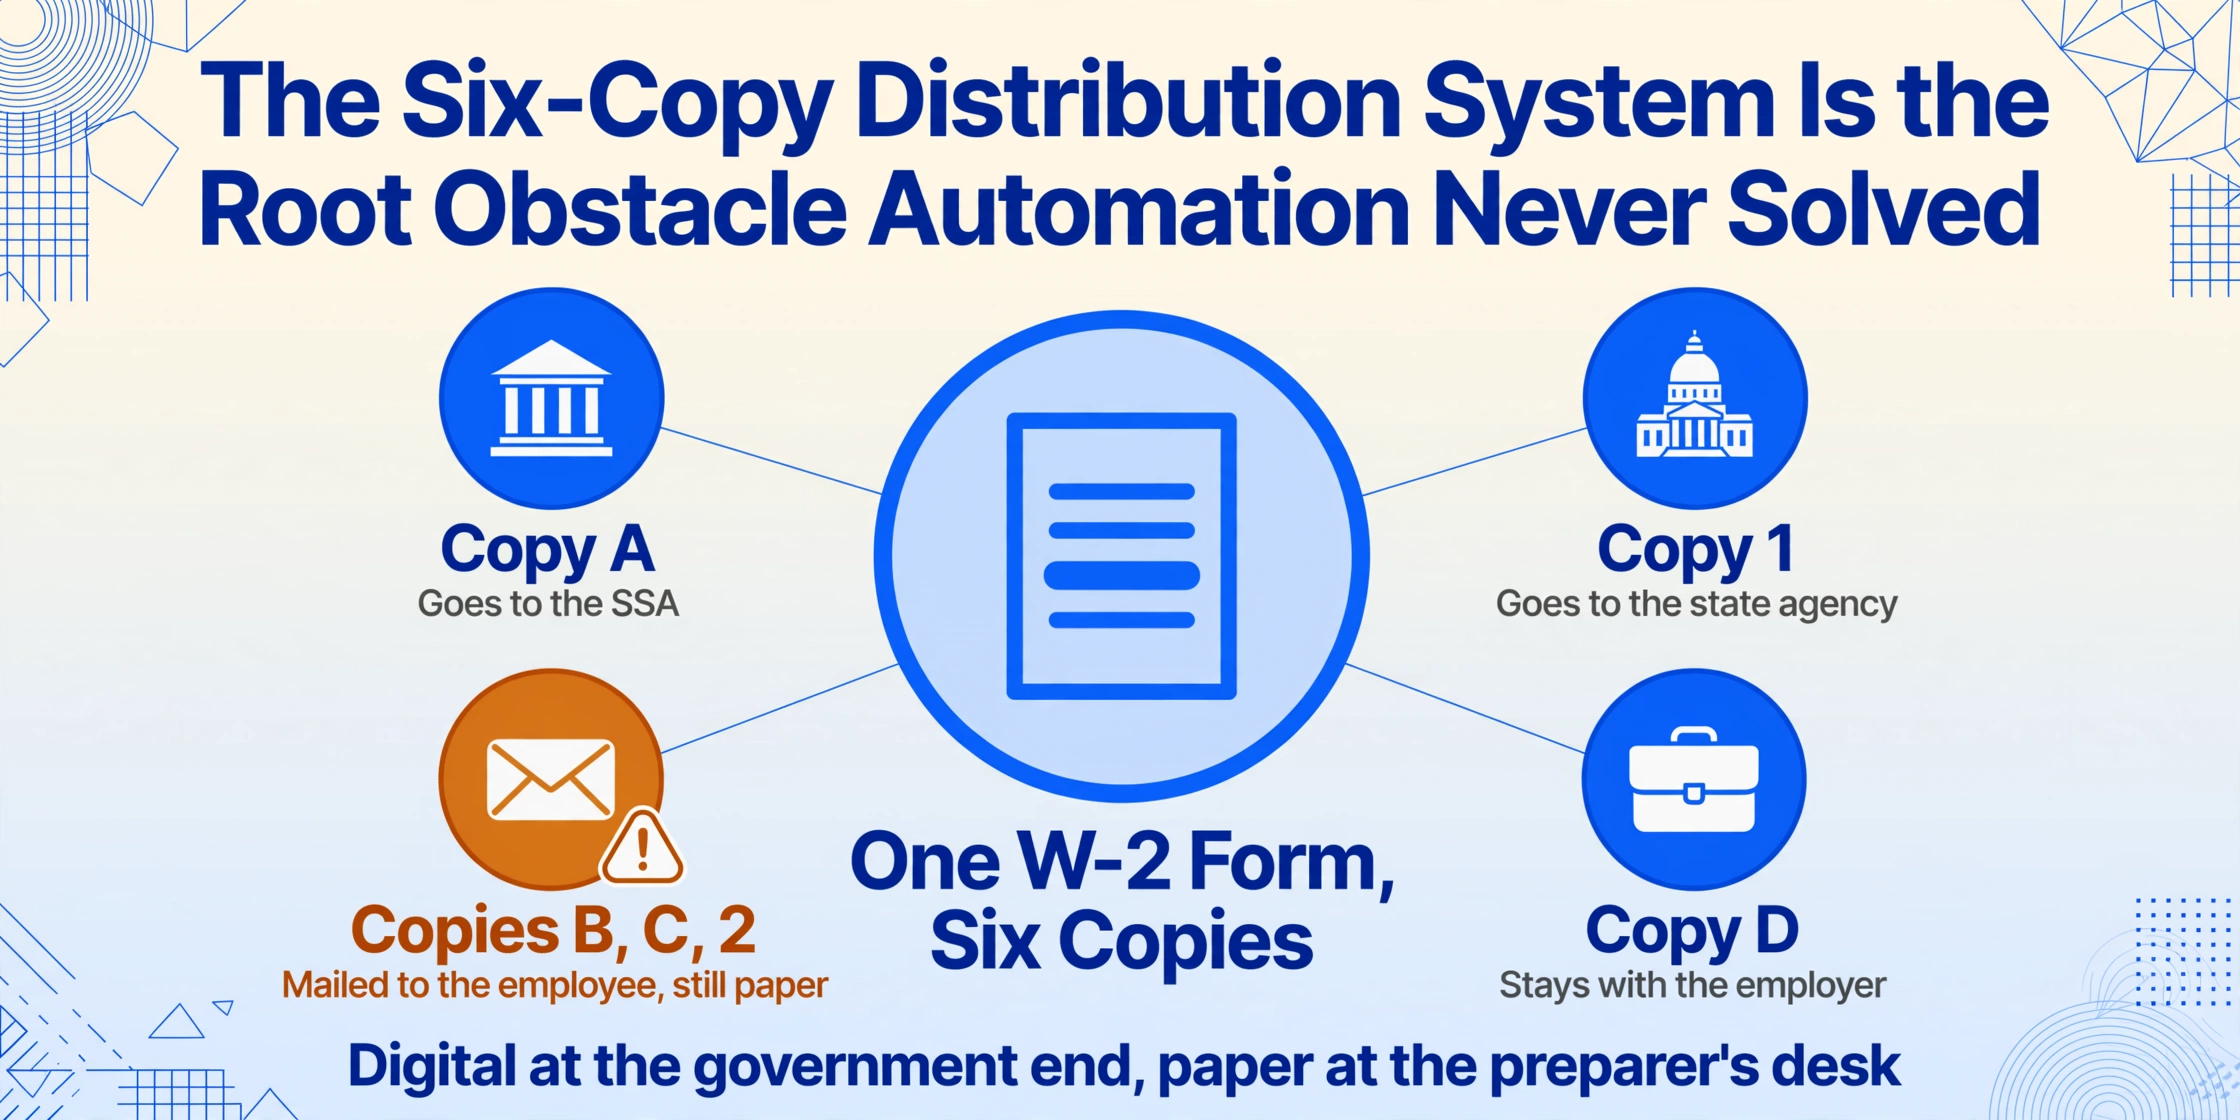
O sistema de distribuição em seis vias do W-2 não é uma relíquia que o IRS esqueceu — é a arquitetura definidora do formulário. A Copy A vai para a Administração da Previdência Social, impressa em tinta vermelha especial de leitura óptica para que os scanners da SSA possam lê-la. A Copy 1 vai para a agência tributária estadual. As Copies B, C e 2 vão para o funcionário — uma para a declaração federal, uma para a estadual e uma para os arquivos do funcionário. A Copy D fica com o empregador. Seis vias, um propósito, e cada uma delas começa como uma folha de papel.
Essa arquitetura fazia sentido em 1978, quando a única forma de enviar dados salariais ao governo era enviar fisicamente uma folha de papel pelo correio. Mas também criou uma dependência estrutural permanente: enquanto os funcionários receberem W-2 em papel, alguém na cadeia — o funcionário, o preparador de impostos, o contador — precisa converter esse papel de volta em dados digitais. A SSA criou desde então o Business Services Online (BSO), um sistema de arquivamento eletrônico que aceita W-2 no formato EFW2, e o IRS exige o arquivamento eletrônico para 10 ou mais declarações informativas. Mas a via do funcionário — a que chega à mesa do preparador de impostos — ainda é papel. A ponte digital foi construída na ponta empregador-governo do fluxo, não na ponta funcionário-preparador. O formulário em si nunca foi redesenhado para fechar essa lacuna.
A consequência é uma contradição estrutural no coração da preparação moderna de impostos: o governo recebe os dados do W-2 digitalmente por meio do arquivamento eletrônico do empregador, mas o representante do contribuinte — o preparador que de fato arquiva a declaração — recebeu os mesmos dados em uma folha de papel enviada ao contribuinte em janeiro. Dois fluxos de dados paralelos para o mesmo formulário, um digital, um físico, e todo janeiro eles colidem na mesa de um preparador de impostos segurando um formulário em papel e olhando para uma tela vazia.
O Sistema de Distribuição em Seis Vias é o Obstáculo Raiz que a Automação Nunca Resolveu
A National Association of Tax Professionals (NATP) relata que 65% da receita bruta de suas mais de 23.000 empresas associadas é obtida durante a temporada de impostos. Essa janela de quatro meses — aproximadamente de janeiro a abril — é quando toda a profissão ganha a vida. Dentro dessa janela, janeiro é o gargalo: os W-2s devem ser fornecidos aos funcionários até 31 de janeiro, arquivados na SSA até 31 de janeiro e, em seguida, inseridos no software de preparação de impostos a tempo para o prazo de arquivamento de 15 de abril. Um preparador que recebe uma caixa de W-2s de 50 clientes em 1º de fevereiro tem exatamente 73 dias para digitar cada campo de cada formulário em uma tela — e isso antes de revisar a declaração, verificar erros e discutir o resultado com o cliente.
O sistema de seis vias significa que o documento-fonte do preparador de impostos quase nunca é o arquivo digital original que o empregador enviou à SSA. É a Copy B — a via do funcionário que veio pelo correio, possivelmente dobrada, possivelmente fotocopiada, possivelmente rabiscada, possivelmente fotografada com um smartphone e enviada por mensagem de texto. O custo de mão de obra para converter essa cópia em papel é real e bem documentado — a 8 minutos por formulário para entrada manual cuidadosa, uma empresa que processa 500 W-2s durante a temporada gasta mais de 66 horas apenas lendo formulários e pressionando teclas. Isso é quase duas semanas inteiras de horas faturáveis consumidas por uma atividade que não adiciona nenhum valor analítico à declaração — horas que um fluxo de trabalho completo de extração de W-2 e 1099 substitui por uma única etapa de upload e revisão.
O Mesmo W-2 de Três Provedores de Folha de Pagamento São Três Documentos Diferentes
Se todo W-2 fosse idêntico — mesma fonte, mesmas posições dos campos, mesma geometria de página — a extração automatizada teria sido resolvida há décadas. Mas um único cliente pode chegar com dois W-2s de dois empregadores usando dois sistemas de folha de pagamento, além de um 1099-NEC de um cliente contratante usando um terceiro. A ADP posiciona o Box 1 (salários) em um conjunto de coordenadas diferente do Paychex, que o posiciona de forma diferente do Gusto, que o posiciona de forma diferente do contador local que imprimiu um W-2 do QuickBooks em uma impressora a laser e o preencheu parcialmente à mão. O IRS padroniza o que deve aparecer no formulário, não como ele deve ser disposto na página.
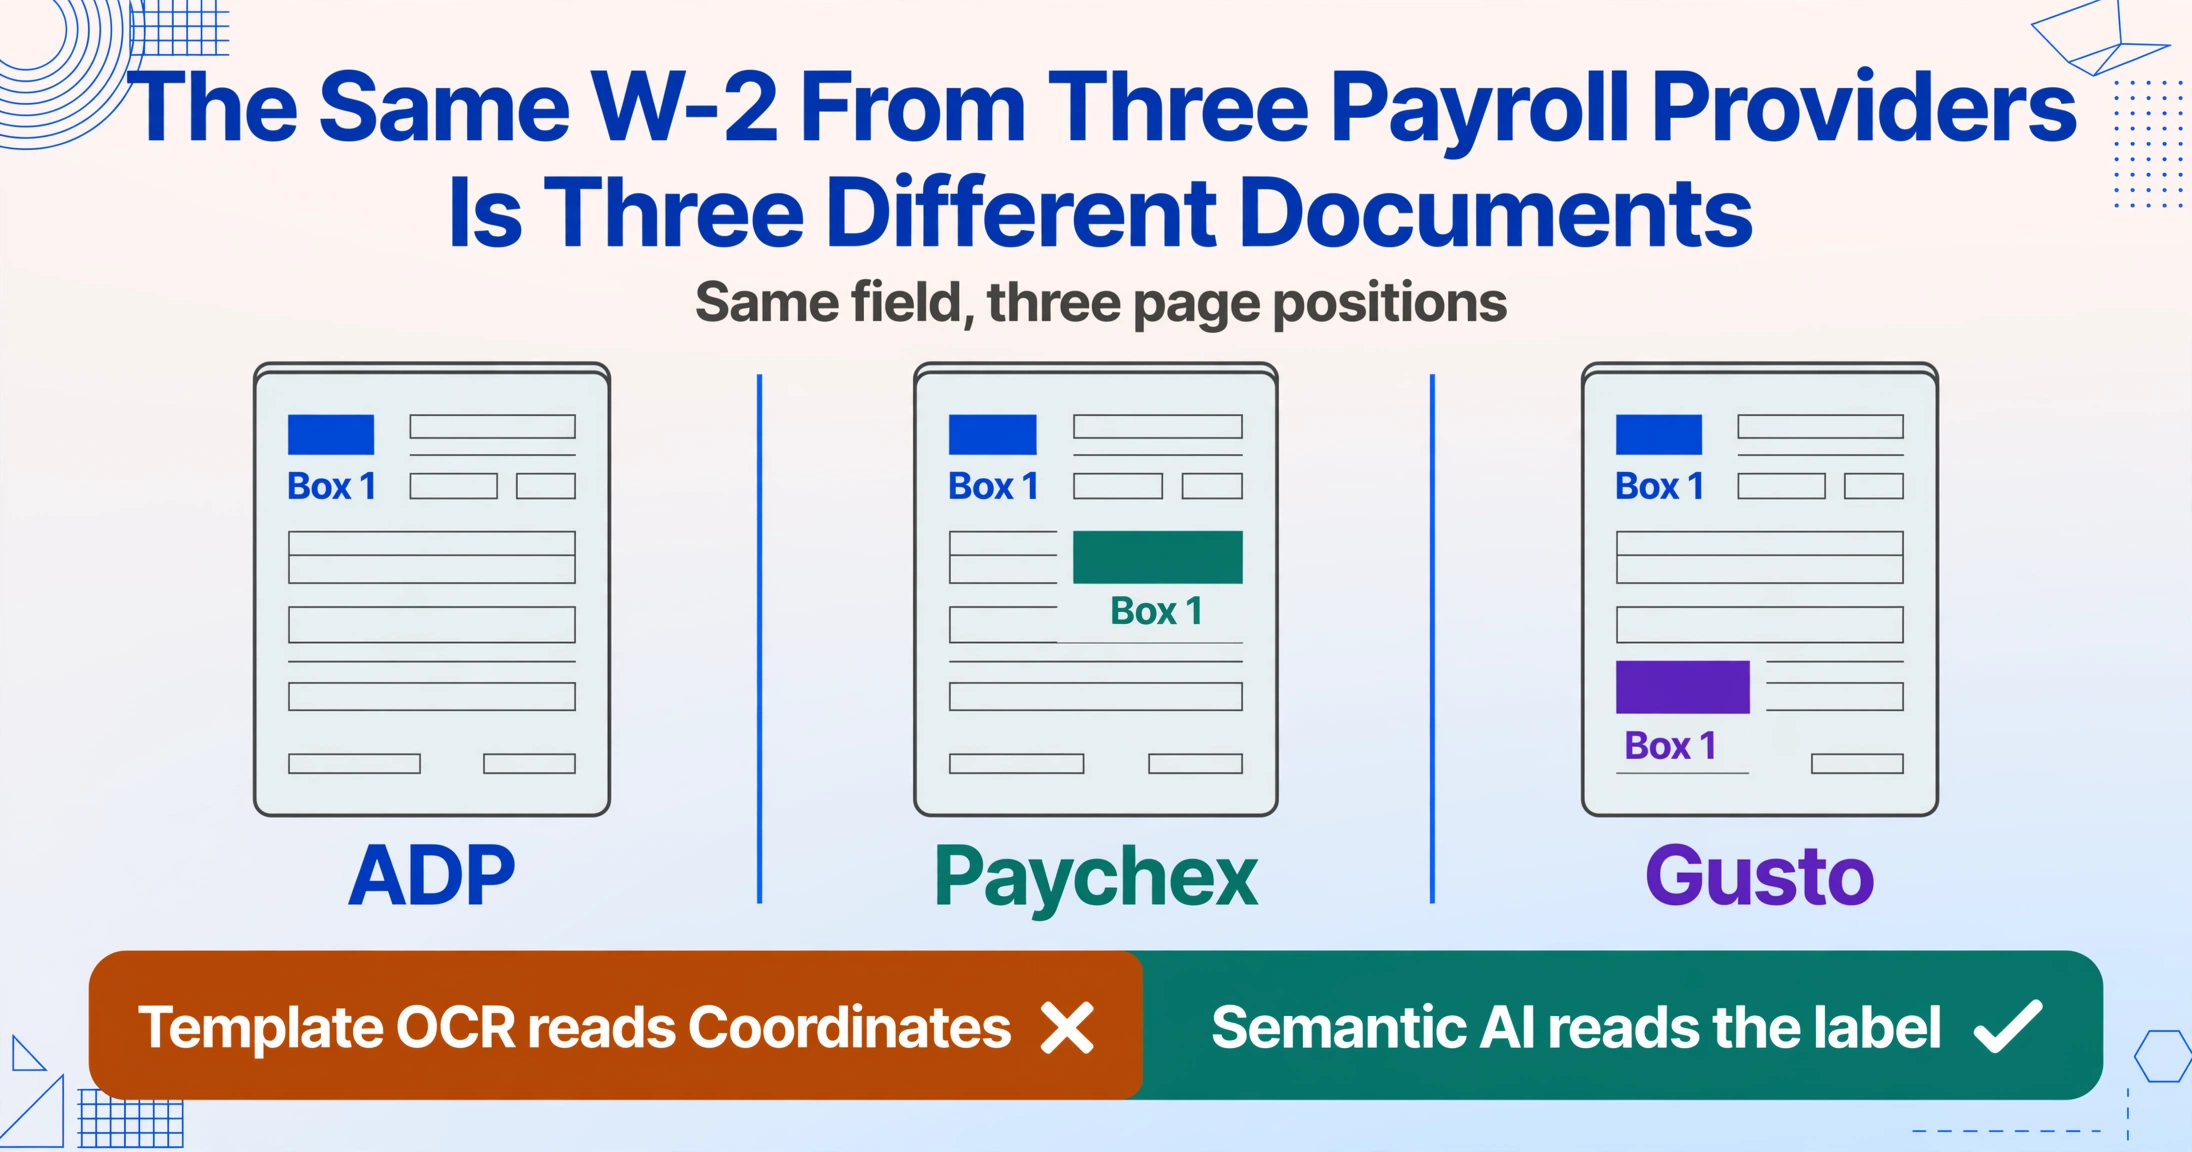
Essa fragmentação é o primeiro obstáculo que toda abordagem de automação encontra. A indústria de folha de pagamento se consolidou em torno de um punhado de grandes provedores — só a ADP processa a folha de aproximadamente um em cada seis funcionários nos EUA — mas essa consolidação não produziu padronização de layout. Cada provedor gera W-2s em seu próprio formato proprietário, com suas próprias escolhas de fonte, seu próprio posicionamento de campos, suas próprias dimensões de página. O resultado é que um lote de 50 W-2s de um empregador de médio porte pode conter formulários de quatro sistemas de folha de pagamento diferentes, cada um exigindo um template de extração diferente — ou, mais comumente, exigindo que um humano apenas os leia e digite.
E a fragmentação não é apenas entre provedores. Ela pode acontecer dentro de um único ano fiscal para um único funcionário. Alguém que mudou de emprego em março recebe um W-2 do Empregador A e um W-2 do Empregador B (Paychex). Alguém que teve um emprego com W-2 e um trabalho paralelo com 1099 recebe um W-2 do empregador e um 1099-NEC do cliente. Cada formulário chega em um formato diferente, por um canal diferente, em um momento diferente. A diversidade não é um caso extremo — é o estado padrão da preparação para a temporada de impostos.
O IRS Ainda Mantiene um Pipeline de Processamento em Papel — e Isso Mantiene o Papel Vivo
Sob T.D. 9972, o mandato de e-file para declarações de informações entra em vigor a partir de 10 formulários. Se você apresenta 9 ou menos W-2s, ainda pode enviá-los por correo ao SSA em papel. As próprias instruções do IRS para Form W-2 reconhecem esse limite. Em todo o país, milhões de pequenos empregadores — restaurantes com seis empregados, empresas de construção com oito, consultorios dentales com cinco — ficam abaixo do limite. Cada um imprime uma pilha de W-2s, os preenche (às vezes à mano), e os envia por correo ao SSA enquanto entrega cópias em papel aos empregados.
Isso não é uma supervisão regulatória. É uma acomodação deliberada. O IRS sabe que exigir que toda empresa de paisajismo com duas pessoas navegue o sistema de arquivamento eletrónico BSO do SSA — com suas especificações de formato EFW2, software de validação AccuWage e requisitos de verificação de SSN — seria uma carga de conformidade irrazonable. Então o pipeline de papel permanece aberto. E cada W-2 em papel criado abaixo do limite de e-file é um W-2 que eventualmente acabará nas manos de um preparador de impostos, precisando ser transcrito.
O cronograma de penalidades do IRS torna isso mais que um inconveniente. Sob o Código de Impuestos Internos §§ 6721 e 6722, declarações de informações tardías ou incorretas são penalizadas por formulário — o cronograma escala de $60 a $680 dependendo do momento da correção e da intenção. Um preparador que digita mal um único dígito no Box 1 e apresenta uma declaração incorreta criou uma responsabilidade — não para o empregador, mas potencialmente rastreável até o erro de transcrição do preparador. Para um desglose completo de quanto essas penalidades por formulário e erros de transcrição custan a uma firma durante uma temporada, veja nossa análise de costos de entrada manual de W-2 e 1099.
A Marca de Lápis na Box 3 Que Quebra Todo Pipeline de Automação
Uma das descobertas mais consistentes dos profissionais de preparação de impostos é que W-2s recebidos de clientes raramente estão impecáveis. Um valor corrigido de salário para a Previdência Social é escrito à mão acima do valor impresso. Um EIN é riscado e reescrito. As caixas de seleção da Box 13 são marcadas com caneta em vez da tinta original da impressora. Uma mancha de café obscurece o número de identificação estadual. O formulário foi dobrado em três partes para um envelope comercial e depois desdobrado — deixando linhas de vinco sobre os campos de salário. Nenhuma dessas situações é incomum. Elas são a condição básica dos documentos fiscais em papel enviados por contribuintes reais.
Para sistemas de OCR baseados em modelos, cada uma dessas variações é um ponto de falha. Dígitos manuscritos sobrepostos a texto impresso confundem o reconhecimento de caracteres. Linhas de vinco através dos campos numéricos quebram a segmentação de dígitos. Caixas de seleção marcadas com o tipo errado de marca — um círculo em vez de um X, um visto em vez de um quadrado preenchido — retornam valores nulos onde deveria haver uma seleção. Um sistema treinado em PDFs limpos, digitalizados em scanner de mesa, de formulários recém-impressos não tem modelo para o estado físico de um W-2 que passou pelo Serviço Postal dos EUA, ficou sobre uma bancada de cozinha por duas semanas e foi preenchido com caneta esferográfica por alguém que não tinha certeza do que o código DD da Box 12 significava.
A ironia mais dolorosa é que um preparador humano consegue processar esse documento degradado quase instantaneamente. Uma olhada em uma Box 3 riscada com uma substituição manuscrita diz ao preparador: “o valor original estava errado, use o manuscrito.” Um sistema baseado em modelos vê dois números concorrentes no mesmo campo e não retorna nenhum — ou pior, retorna o errado. O julgamento que um preparador treinado aplica em meio segundo é exatamente o que falta aos sistemas de automação, e exatamente o que manteve o humano no centro do ciclo de transcrição de W-2.
Softwares de Preparação de Impostos Podem Transmitir Dados — Mas Não Conseguem Ler o Documento em Papel do Seu Cliente
As principais plataformas de preparação de impostos da profissão — Drake, UltraTax, Lacerte, ProSeries, ATX — todas suportam a importação de dados W-2. De um CSV. De uma declaração do ano anterior. De uma exportação digital do provedor de folha de pagamento. O que nenhuma delas consegue fazer é ler um W-2 Copy B em papel que um cliente entregou ao preparador do outro lado da mesa. O importador espera uma entrada digital estruturada, e o documento de origem é papel físico não estruturado. O preparador é a camada de conversão.
Mesmo quando os dados do W-2 foram enviados eletronicamente à SSA, o preparador não pode simplesmente puxá-los do banco de dados da SSA para o Drake. O sistema Business Services Online da SSA fornece dados salariais ao IRS para correspondência de conformidade, não a preparadores de impostos para a preparação de declarações. O Wage and Income Transcript — que o preparador pode acessar pelo Transcript Delivery System (TDS) do IRS — está disponível para profissionais de impostos com um Form 8821 assinado ou Power of Attorney, mas chega como um resumo editado, não como dados estruturados em nível de campo. Então o preparador, sentado com o W-2 em papel do cliente em uma mão e uma tela de entrada do Drake na outra, ainda digita.
O U.S. Bureau of Labor Statistics estimou o salário médio por hora para contadores e auditores em $39.27 em maio de 2024. Com benefícios, impostos sobre folha de pagamento, despesas gerais de escritório e licenças de software, o custo de um contador para a firma fica mais próximo de $55–65 por hora. Cada hora que esse contador gasta transcrevendo campos do W-2 — uma tarefa que adiciona zero julgamento analítico — é uma hora não gasta revisando a declaração, identificando oportunidades de economia de impostos ou consultando o cliente. O custo da entrada de dados em si foi quantificado em $4.000–$6.000 por temporada de impostos para uma firma de médio porte. O custo de oportunidade — o trabalho faturável deslocado pela digitação — é mais difícil de medir, mas quase certamente maior.
O OCR baseado em modelos falha nos W-2 pela mesma razão estrutural de sempre: variação de layout
Durante duas décadas, a abordagem dominante para extração de dados de documentos tem sido o OCR baseado em modelos. Você cria um modelo que diz “Box 1 está nas coordenadas (x1, y1, x2, y2) neste W-2 gerado por ADP” e o sistema lê qualquer texto que caia nesse retângulo. Isso funciona perfeitamente para documentos com layouts fixos e previsibles — uma fatura específica de um fornecedor específico, sempre gerada pelo mesmo sistema ERP, sempre disposta da mesma maneira. Funciona terrível para W-2s, onde o mesmo campo (Box 1) aparece em posições diferentes na saída de cada provedor de nómina e em cada copia em papel escaneada.
O problema subjacente é que o OCR baseado em modelos lê documentos por posición, não por significado. Sabe onde Box 1 estaba na muestra de treinamento, não o que Box 1 es no documento atual. Esta distinción — posición vs. significado — é a razão central pela qual a entrada de dados de W-2 resistiu à automação. A especificação do formulário garante que informação aparece (salários, imposto retenido, SSN, EIN), mas não onde nessa página física ou digital essa informação está. Qualquer sistema que dependa de “onde” para determinar “qué” colapsará no momento em que encontre um W-2 de um provedor de nómina com o qual não foi treinado.
As ferramentas de modelo também falham no problema de múltiples fuentes. Um modelo construído para “ADP W-2, formato 2024” não pode extraer datos de “Paychex W-2, formato 2024” — e menos ainda de “foto de um W-2 em papel de um pequeno empregador, formato 2024, com uma correção manuscrita no Box 3.” O preparador precisaría manter uma biblioteca de modelos para cada provedor de nómina que cada empregador de cada cliente usa, atualizada anualmente conforme cada provedor ajusta o layout do formulário. Só a carga de manutenção já torna a abordagem impraticable em qualquer escala real. Para uma análise passo a passo de como a extracción semántica lê cada box através desses layouts — e onde ainda tropeza — veja o guía completo de extracción de W-2 e 1099.
Compreensão Semântica Substitui Posição por Significado — E Isso Muda o Que a Automação Pode Fazer
A alternativa à extração baseada em modelo é a compreensão semântica de documentos: um modelo de IA que lê um W-2 da mesma forma que um humano — reconhecendo o que cada campo significa, não onde ele está. Quando você vê “Wages, tips, other compensation” em um W-2, sabe que isso é o Box 1, independentemente de aparecer no canto superior esquerdo de um PDF da ADP, no canto superior direito de um PDF da Paychex ou no meio de uma foto de celular de um formulário em papel. A IA semântica faz o mesmo julgamento: identifica “Wages, tips, other compensation” como um conceito e extrai o valor em dólares ao lado, seja esse valor impresso, manuscrito ou corrigido com um risco.
Essa mudança — de extração baseada em coordenadas para extração baseada em conceitos — é o que torna a automação de W-2 tecnicamente viável pela primeira vez. Em vez de definir onde o Box 1 fica em um modelo específico, você diz ao sistema: “Extraia o valor em dólares rotulado como Wages, tips, other compensation.” O sistema lê o formulário inteiro, encontra esse rótulo onde quer que apareça e retorna o valor ao lado dele. Essa abordagem — às vezes chamada de extração por nome de coluna, em que você define os campos desejados pelos nomes semânticos em vez das coordenadas da página — lida com os três provedores de folha de pagamento, a correção manuscrita e a foto de celular em uma única passada, porque nunca depende de saber antecipadamente onde algo está.
É também aqui que extrair dados de W-2 de PDFs para planilhas estruturadas se torna possível em escala. Um preparador define os nomes das colunas — “Box 1 Wages,” “Box 2 Federal Tax Withheld,” “Box b EIN,” “Employee SSN” — e o modelo semântico encontra cada valor em todos os W-2 do lote, independentemente de qual provedor de folha de pagamento gerou qual formulário. O resultado é uma única planilha Excel com uma linha por funcionário, pronta para importação no Drake ou UltraTax, sem que um único campo seja digitado manualmente.
O Que a Automação Completa de W-2 Exigiria — E Por Que Três Peças Finalmente Estão no Lugar
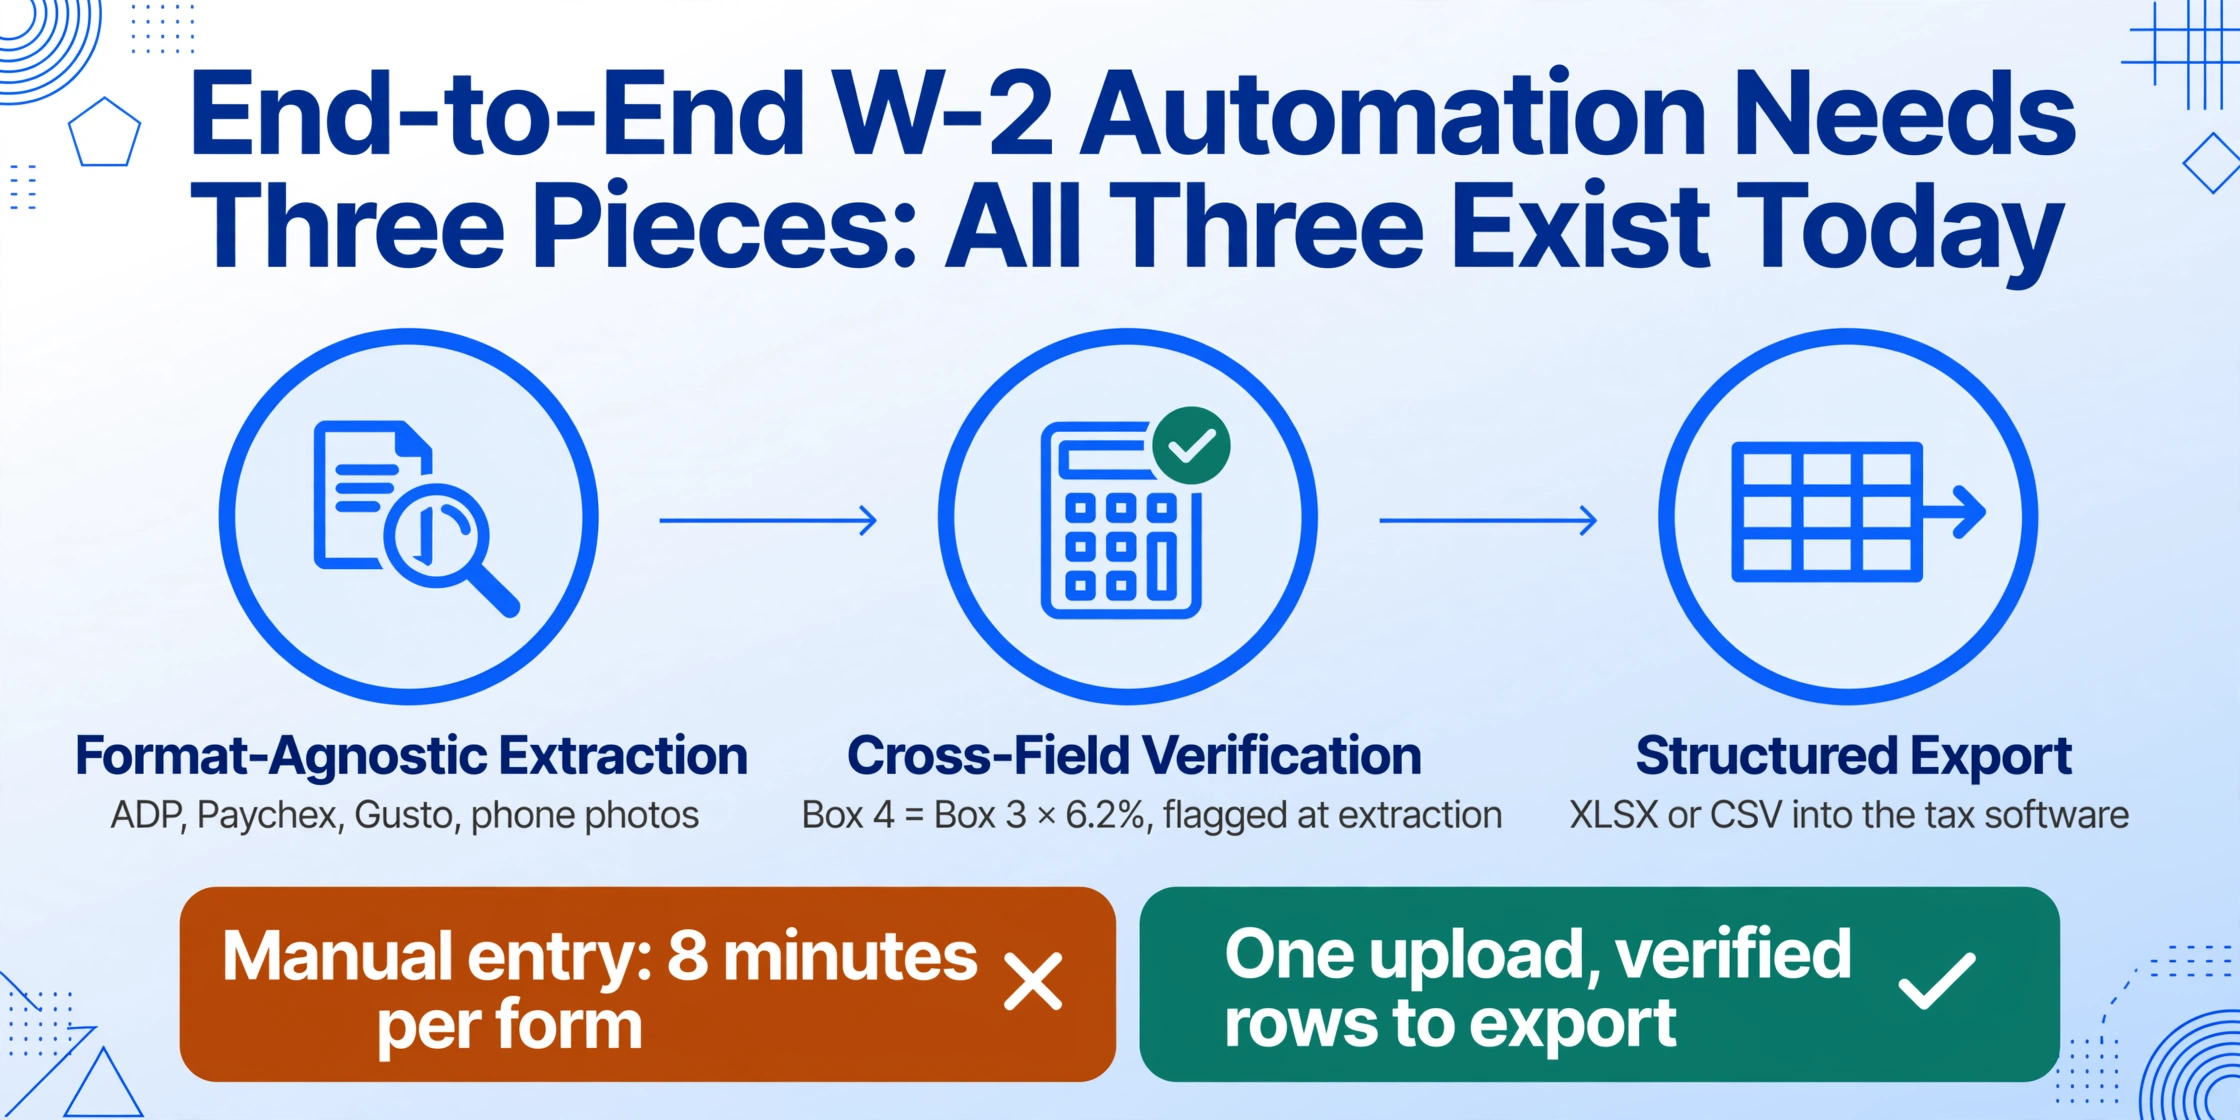
A automação completa da entrada de dados de W-2 — desde o recebimento de documentos do cliente até a importação no software de impostos — exige três capacidades que historicamente existiram em sistemas separados:
- Extração de campos independente de formato — ler o mesmo campo corretamente em ADP, Paychex, Gusto, cópias impressas digitalizadas e fotos de celular, sem modelos por provedor.
- Verificação cruzada de campos — verificar automaticamente se o Box 4 (imposto da Previdência Social) é igual a Box 3 × 6,2%, se o Box 2 (retenção federal) é plausível em relação aos salários do Box 1 e se o formato do SSN é válido. Este é o passo de julgamento do preparador — e precisa acontecer no momento da extração, não durante a revisão posterior.
- Exportação estruturada — entregar os dados extraídos e verificados em um formato que o software de preparação de impostos possa consumir diretamente (XLSX, CSV), eliminando totalmente a redigitação.
A primeira peça — extração independente de formato — é o que a IA semântica permite. A segunda peça — verificação cruzada de campos — é o que as colunas calculadas adicionam ao fluxo de trabalho: a capacidade de definir, no momento da extração, cálculos como “verificar Box 4 = Box 3 × 0,062” e sinalizar discrepâncias antes que os dados cheguem à planilha. A terceira peça — exportação estruturada — é a ponte final entre a pilha de documentos do preparador e a tela de importação do software de impostos. Cada uma dessas três peças existe hoje. O que faltava era uma única ferramenta que as reunisse.
O problema da entrada de dados de W-2 persiste há 47 anos não porque a tecnologia para resolvê-lo não existisse, mas porque a abordagem estava errada. Sistemas baseados em modelos tentavam fazer os W-2s se conformarem ao seu modelo de extração. Sistemas semânticos leem os W-2s como eles realmente chegam — variados, físicos, imperfeitos — e extraem os dados mesmo assim. Essa diferença — fazer a ferramenta se adaptar ao formulário em vez de exigir que o formulário se adapte à ferramenta — é a mudança estrutural que finalmente torna a automação possível.
Perguntas Frequentes
Posso extrair dados de uma foto de um W-2 em papel, ou precisa ser um PDF limpo?
Os modelos de IA semântica processam fotos de W-2 em papel da mesma forma que processam PDFs digitais limpos — lendo o significado de cada rótulo de campo, não combinando com um modelo. Uma foto do Copy B tirada pelo seu cliente e enviada por mensagem de texto é uma entrada válida. A qualidade da foto importa — razoavelmente bem iluminada e focada — mas o formato não. JPG, PNG e PDF são todos suportados.
Se eu tiver 50 W-2s de diferentes provedores de folha de pagamento, posso processá-los todos de uma vez?
Sim. O processamento em lote é projetado especificamente para lotes de W-2 de fontes mistas. Você envia todos os 50 arquivos em uma única sessão — PDFs da ADP, PDFs da Paychex, fotos de formulários em papel tiradas pelo celular — define as colunas de saída desejadas uma vez (Box 1 salários, Box 2 imposto federal, Box 4 Previdência Social, nome do funcionário, SSN do funcionário, EIN do empregador), e o sistema retorna uma única planilha Excel com uma linha por funcionário. A extração é pelo significado do campo, não pelo modelo do arquivo, então os layouts dos diferentes provedores de folha de pagamento não exigem configurações separadas.
E quanto a correções manuscritas em formulários W-2 — a IA consegue ler isso?
Modelos de IA semântica treinados em reconhecimento de escrita manual podem distinguir entre texto impresso e correções manuscritas no mesmo campo. Um valor impresso riscado com uma substituição manuscrita na Box 3 normalmente será lido como o valor manuscrito — o sistema reconhece a correção. No entanto, escrita manual muito danificada ou borrada pode reduzir a precisão. Nesses casos, a saída extraída deve ser verificada contra a imagem de origem, que é uma etapa padrão de controle de qualidade, independentemente do método de extração.
O IRS aceita dados de W-2 extraídos por ferramentas de IA para fins de declaração eletrônica?
O IRS não regula como os preparadores de impostos digitalizam documentos-fonte dos clientes — ele regula a precisão da declaração apresentada. Os preparadores continuam responsáveis por verificar se os dados inseridos no software de impostos (sejam digitados manualmente, importados de uma exportação da folha de pagamento ou extraídos por IA) correspondem ao W-2 de origem. A extração por IA é a etapa de entrada de dados; a verificação do preparador e o julgamento profissional continuam sendo a etapa de conformidade.
Qual é a diferença entre OCR baseado em modelo e IA semântica para extração de W-2?
O OCR baseado em modelo extrai dados por posição: “leia qualquer texto que apareça neste retângulo.” Ele exige um modelo separado para cada formato de W-2 de cada provedor de folha de pagamento e falha em qualquer formulário para o qual não foi explicitamente treinado. A IA semântica extrai dados por significado: “encontre o campo rotulado como ‘Salários, gorjetas, outras compensações’ e retorne o valor em dólares ao lado dele.” Ela funciona em qualquer layout de W-2 — ADP, Paychex, Gusto, papel escaneado, foto de celular — porque não se importa com onde o rótulo aparece na página. Quando você usa extração por nome de coluna em vez de modelos baseados em coordenadas, a mesma configuração processa todos os W-2 do seu lote, independentemente da origem.
Posso verificar automaticamente os dados extraídos do W-2 — por exemplo, confirmar que o imposto da Previdência Social retido é igual a 6,2% dos salários?
Sim. coluna calculada permite definir fórmulas de verificação durante a extração. Você pode adicionar uma coluna que calcula Box 3 × 6,2% e a compara com o valor extraído no Box 4, sinalizando qualquer divergência. Você também pode verificar se os salários do Box 1 não excedem os salários da Previdência Social do Box 3 mais os salários do Medicare do Box 5 de maneiras impossíveis. Essas verificações cruzadas — as mesmas que um preparador realiza manualmente — acontecem no momento da extração, então as discrepâncias são reveladas antes que os dados cheguem à tela de entrada do software de impostos.
Onde a Entrada Manual Termina e a Automação Começa
O W-2 não foi projetado para ser automatizado. Sua distribuição em seis vias, sua arquitetura baseada em papel, sua aceitação de correções manuscritas — cada característica estrutural do formulário pressupõe que um ser humano o lerá. Por 47 anos, empresas de tecnologia tentaram resolver isso tratando W-2s como qualquer outro documento estruturado: criar um modelo, combinar coordenadas, extrair texto. Essa abordagem falhou porque W-2s não são estruturados da maneira que os modelos exigem. Eles são uma família de documentos visualmente diferentes que compartilham um conjunto comum de significados de campos — e a única abordagem de extração que funciona neles é aquela que lê significado, não posição.
A extração semântica muda a unidade de trabalho de “um formulário, um modelo, um digitador” para “um lote, uma definição de coluna, um clique.” O preparador ainda verifica o resultado — isso é julgamento profissional, e não vai desaparecer. Mas as horas gastas lendo números de um pedaço de papel e transferindo-os para uma tela — o legado de um design de formulário de 1978 em uma temporada de impostos de 2026 — essas horas têm um substituto.