Warum die Dateneingabe in der Steuersaison
immer noch nicht automatisiert ist
Das W-2-Formular wurde 1978 standardisiert. In diesem Jahr nutzte das durchschnittliche amerikanische Büro Schreibmaschinen, Aktenschränke und Kohlepapier. Der IBM PC lag drei Jahre in der Zukunft. Siebenundvierzig Jahre später fließen jährlich etwa 245 Millionen W-2-Formulare durch die US-Wirtschaft, jedes mit denselben 20 nummerierten Boxen und sechs Buchstaben-Kennzeichnungsfeldern, die für eine vordigitale Welt entworfen wurden. Und jeden Januar nimmt in Steuerkanzleien im ganzen Land immer noch ein Mensch jedes Formular in die Hand, liest die Zahlen und tippt sie in einen Bildschirm.
Dieser Artikel handelt nicht von einem besseren Weg, diese Tipparbeit zu erledigen. Es geht darum, warum das Tippen immer noch existiert — die strukturellen, regulatorischen und technischen Gründe, die die W-2- und 1099-Dateneingabe über fünf Jahrzehnte Computerfortschritt hartnäckig manuell gehalten haben. Am Ende werden Sie nicht nur verstehen, dass das Problem real ist, sondern auch, warum jeder frühere Lösungsversuch an denselben unsichtbaren Wänden gescheitert ist.
Wichtige Erkenntnisse
- Die Sechs-Kopien-Architektur des W-2 wurde 1978 für Kohlepapier und Schreibmaschinen entworfen – 245 Millionen Formulare pro Jahr fließen noch immer durch ein System, das vor der Erfindung des Personalcomputers gebaut wurde, und jede Kopie setzt voraus, dass ein Mensch abtippt, was er liest.
- Die SSA verfügt bereits digital über jede W-2 durch die elektronische Übermittlung des Arbeitgebers, doch die Kopie B des Steuerberaters wurde für menschliche Augen entworfen, nicht für maschinelles Lesen – 66 Stunden pro Steuersaison gehen für das erneute Abtippen von Daten verloren, die in einer Regierungsdatenbank liegen, wobei IRS-Strafen ab 60 $ pro falsch getippter Ziffer beginnen.
- Template-basierte OCR (optische Zeichenerkennung – das Lesen von gedrucktem Text anhand seiner Position auf der Seite) sucht Box 1 an den exakten Pixelkoordinaten, an denen es auf einem Trainingsbeispiel erschien. Deshalb scheitert sie, sobald eine Paychex-W-2 oder ein Handyfoto das ADP-Layout ersetzt – dasselbe Feld erscheint bei jedem Lohnabrechnungsanbieter an unterschiedlichen Positionen.
- ImageToTable.ai liest W-2-Formulare danach, was jede Feldbeschriftung bedeutet, statt wo sie auf der Seite steht, und findet „Löhne, Trinkgelder, sonstige Vergütung“, wo immer sie erscheint – so verarbeitet ADP, Paychex, Gusto, gescannte Kopien und Handyfotos in einem einzigen Batch, weil sich das Tool an das Formular anpasst, statt zu verlangen, dass das Formular einer Vorlage entspricht.
Der W-2 wurde für Kohlepapier entworfen, nicht für Computer
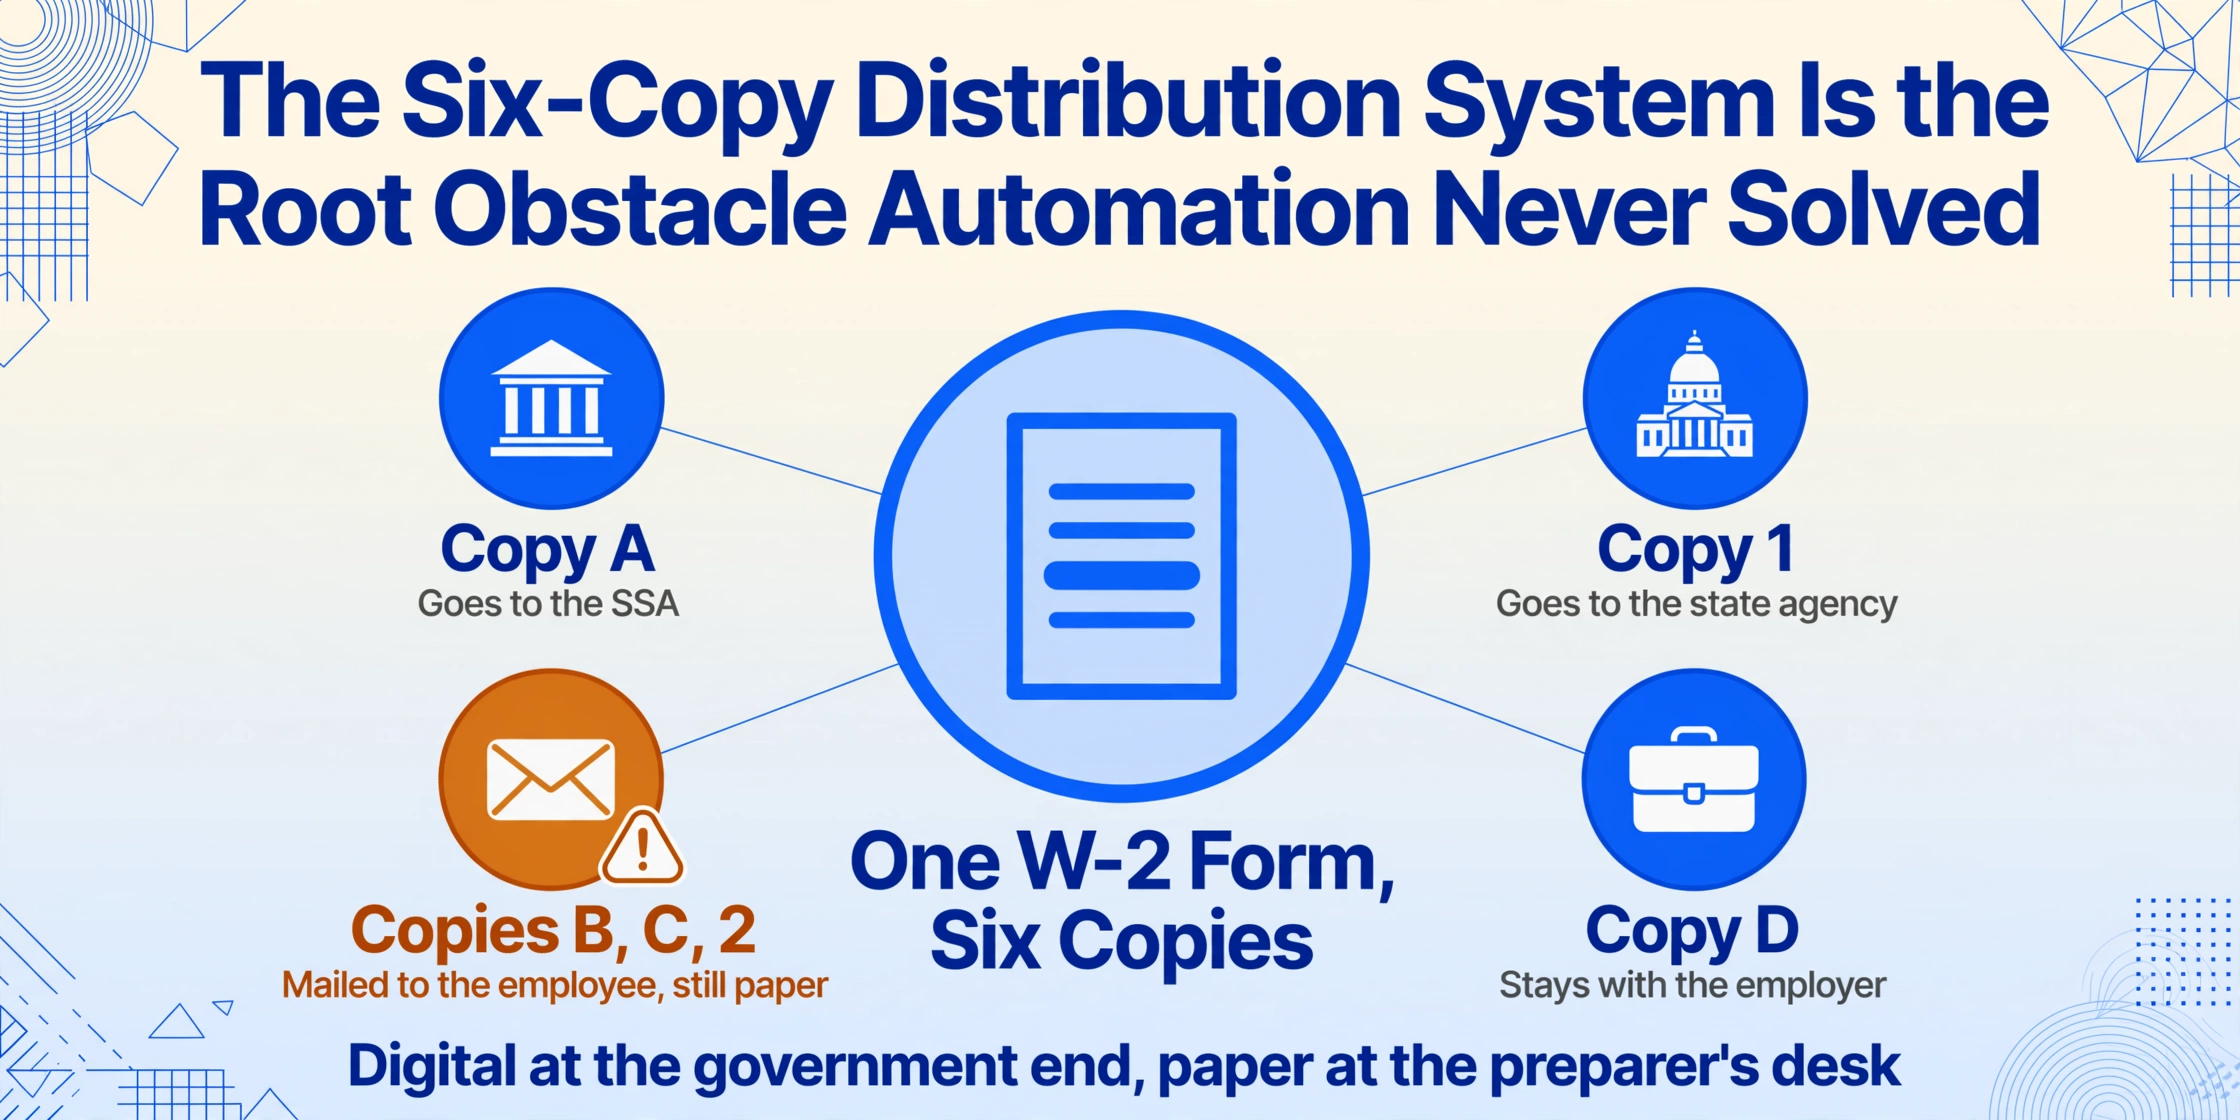
Das Sechs-Kopien-Verteilungssystem des W-2 ist kein Relikt, das die IRS vergessen hat – es ist die prägende Architektur des Formulars. Copy A geht an die Social Security Administration, gedruckt in spezieller roter Drop-out-Tinte, damit die optischen Scanner der SSA sie lesen können. Copy 1 geht an die staatliche Steuerbehörde. Copy B, C und 2 gehen an den Arbeitnehmer – eine für die Bundessteuererklärung, eine für die Landessteuererklärung und eine für die Unterlagen des Arbeitnehmers. Copy D verbleibt beim Arbeitgeber. Sechs Kopien, ein Zweck, und jede einzelne beginnt als Stück Papier.
Diese Architektur ergab 1978 Sinn, als der einzige Weg, Lohndaten in die Hände der Regierung zu bringen, darin bestand, ein Stück Papier physisch zu versenden. Aber sie schuf auch eine dauerhafte, strukturelle Abhängigkeit: Solange Arbeitnehmer Papier-W-2 erhalten, muss jemand in der Kette – der Arbeitnehmer, der Steuerberater, der Buchhalter – dieses Papier wieder in digitale Daten umwandeln. Die SSA hat inzwischen Business Services Online (BSO) aufgebaut, ein elektronisches Einreichungssystem, das W-2 im EFW2-Format akzeptiert, und die IRS schreibt die elektronische Einreichung bei 10 oder mehr Informationserklärungen vor. Aber die Arbeitnehmerkopie – das Stück, das auf dem Schreibtisch eines Steuerberaters landet – ist immer noch Papier. Die digitale Brücke wurde am Arbeitgeber-zu-Regierung-Ende der Pipeline gebaut, nicht am Arbeitnehmer-zu-Berater-Ende. Das Formular selbst wurde nie neu gestaltet, um diese Lücke zu schließen.
Die Folge ist ein struktureller Widerspruch im Herzen der modernen Steuervorbereitung: Die Regierung erhält W-2-Daten digital durch die elektronische Einreichung des Arbeitgebers, aber der Vertreter des Steuerzahlers – der Berater, der die Erklärung tatsächlich einreicht – erhielt dieselben Daten auf einem Stück Papier, das im Januar an den Steuerzahler geschickt wurde. Zwei parallele Datenströme für dasselbe Formular, einer digital, einer physisch, und jeden Januar kollidieren sie auf dem Schreibtisch eines Steuerberaters, der ein Papierformular in der Hand hält und auf einen leeren Bildschirm starrt.
Das Sechs-Kopien-Verteilungssystem ist das Kernhindernis, das die Automatisierung nie gelöst hat
Die National Association of Tax Professionals (NATP) berichtet, dass 65 % des Bruttoumsatzes ihrer über 23.000 Mitgliedskanzleien während der Steuersaison erwirtschaftet werden. In diesem viermonatigen Zeitraum – ungefähr von Januar bis April – verdient der gesamte Berufsstand seinen Lebensunterhalt. Innerhalb dieses Zeitfensters ist der Januar der Engpass: W-2-Formulare müssen bis zum 31. Januar an die Arbeitnehmer ausgehändigt, bis zum 31. Januar bei der SSA eingereicht und dann rechtzeitig zur Abgabefrist am 15. April in die Steuersoftware eingegeben werden. Ein Steuerberater, der am 1. Februar einen Schuhkarton mit W-2-Formularen von 50 Mandanten erhält, hat genau 73 Tage Zeit, um jedes Feld jedes Formulars in eine Maske zu tippen – und das, bevor die Steuererklärung geprüft, auf Fehler kontrolliert und das Ergebnis mit dem Mandanten besprochen wird.
Das Sechs-Kopien-System bedeutet, dass das Quelldokument des Steuerberaters fast nie die ursprüngliche digitale Datei ist, die der Arbeitgeber bei der SSA eingereicht hat. Es ist Copy B – die Arbeitnehmerkopie, die per Post kam, möglicherweise gefaltet, möglicherweise fotokopiert, möglicherweise bekritzelt, möglicherweise mit einem Smartphone fotografiert und per SMS verschickt wurde. Die Arbeitskosten für die Umwandlung dieser Papierkopie sind real und gut dokumentiert – bei 8 Minuten pro Formular für sorgfältige manuelle Eingabe verbringt eine Kanzlei, die in der Saison 500 W-2-Formulare verarbeitet, über 66 Stunden damit, nur Formulare zu lesen und Tasten zu drücken. Das sind fast zwei volle Wochen abrechenbarer Stunden, die für eine Tätigkeit aufgewendet werden, die dem Steuerbescheid keinerlei analytischen Mehrwert bringt – Stunden, die ein vollständiger W-2- und 1099-Extraktionsworkflow durch einen einzigen Upload- und Prüfungsdurchgang ersetzt.
Dieselbe W-2 von drei Lohnabrechnungsanbietern ist ein anderes Dokument
Wenn jede W-2 identisch aussehen würde – gleiche Schriftart, gleiche Box-Positionen, gleiche Seitengeometrie – wäre die automatisierte Extraktion schon vor Jahrzehnten gelöst worden. Aber ein einzelner Kunde kann mit zwei W-2s von zwei Arbeitgebern ankommen, die zwei Lohnabrechnungssysteme nutzen, plus einer 1099-NEC von einem Auftraggeber, der ein drittes System verwendet. ADP positioniert Box 1 (Lohn) bei einem anderen Koordinatensatz als Paychex, das sie wiederum anders positioniert als Gusto, das sie wiederum anders positioniert als der lokale Buchhalter, der eine W-2 aus QuickBooks auf einem Laserdrucker gedruckt und teilweise von Hand ausgefüllt hat. Der IRS standardisiert, was auf dem Formular erscheinen muss, nicht, wie es auf der Seite angeordnet sein muss.
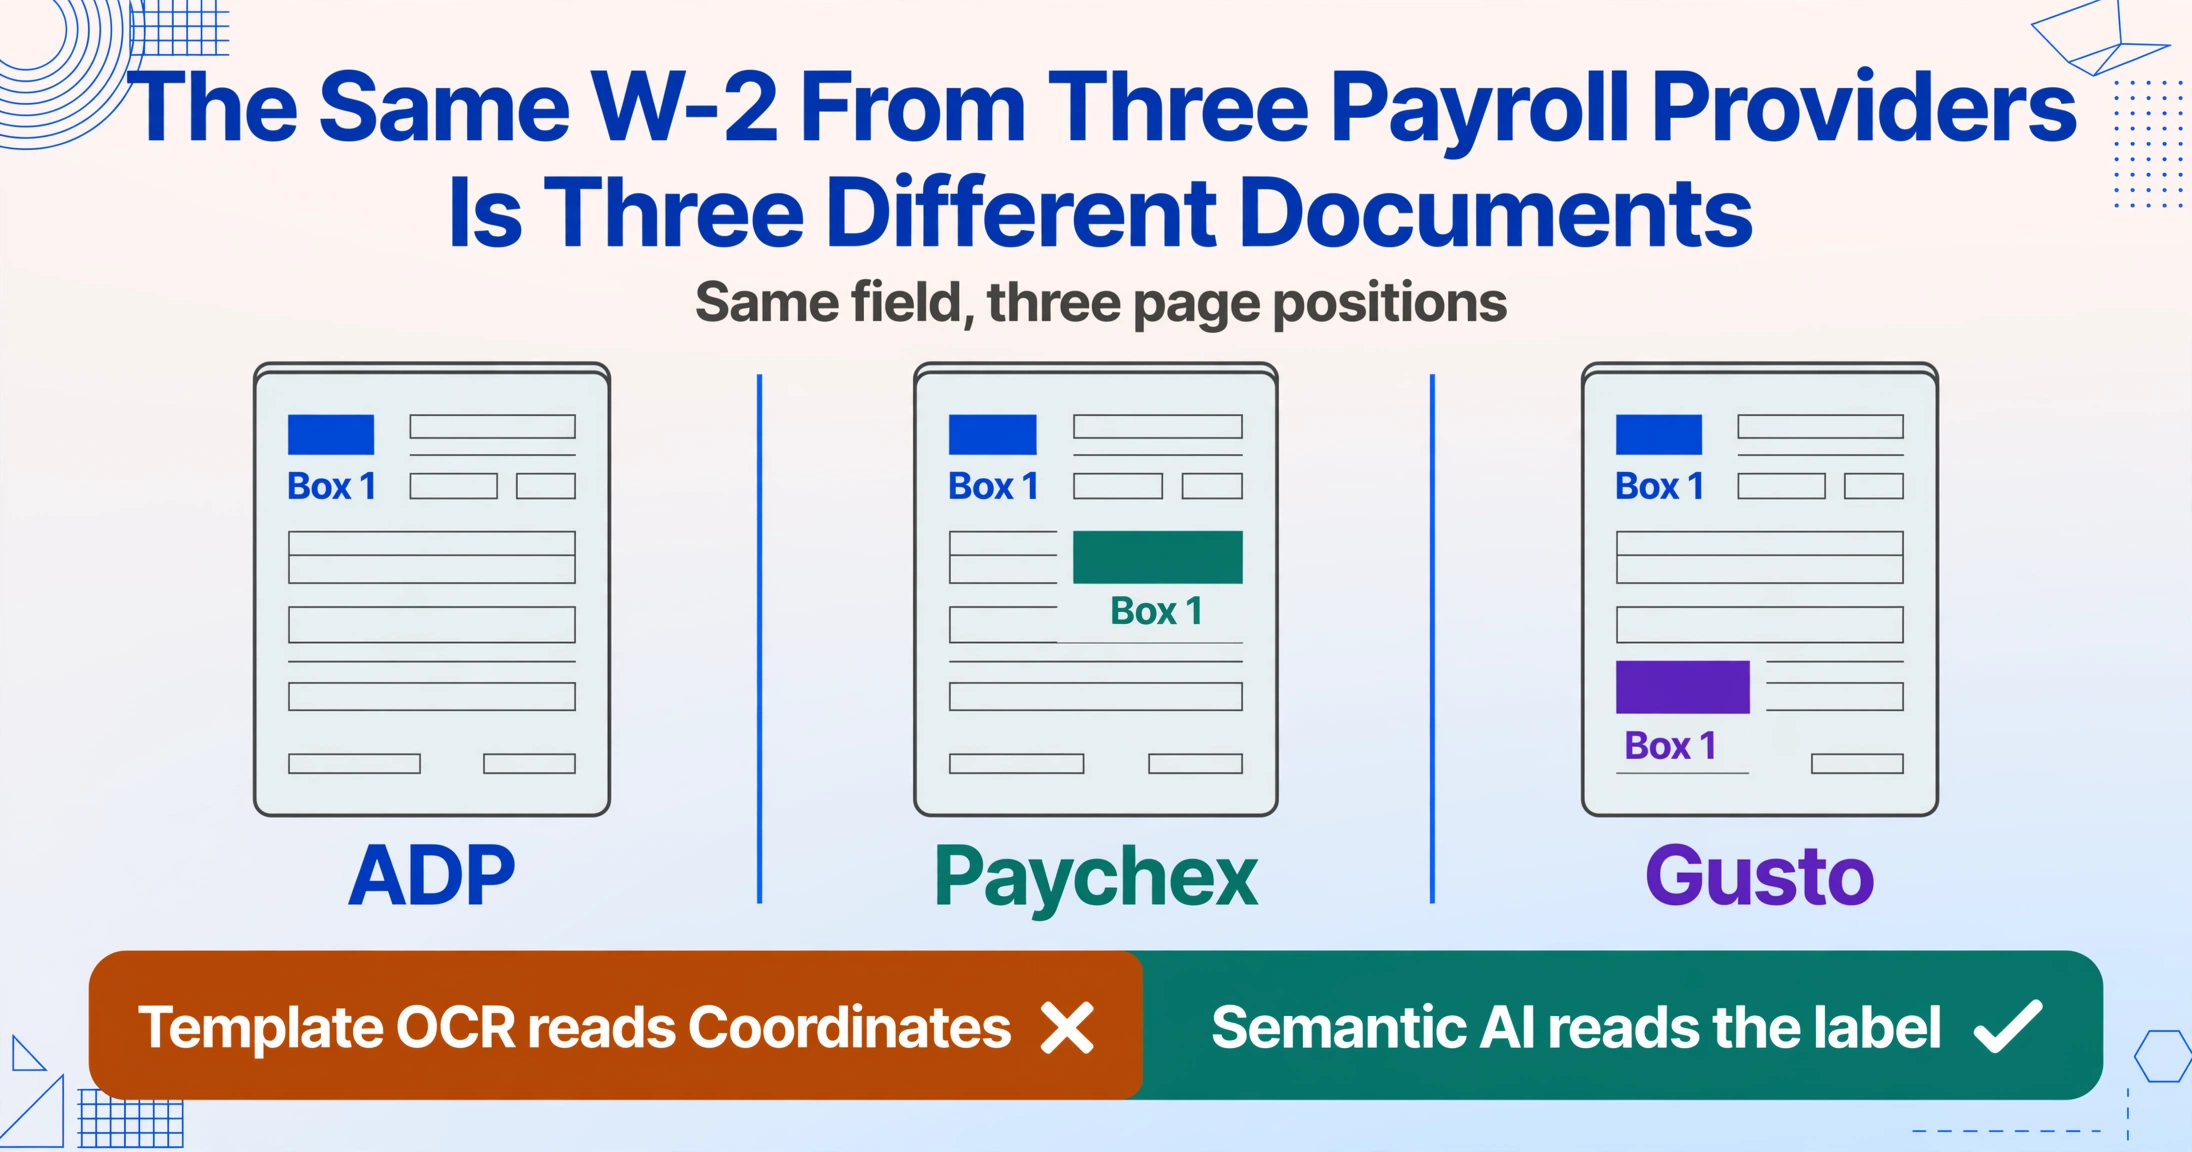
Diese Fragmentierung ist die erste Hürde, auf die jeder Automatisierungsansatz stößt. Die Lohnabrechnungsbranche hat sich auf eine Handvoll großer Anbieter konsolidiert – ADP allein verarbeitet Löhne für etwa einen von sechs US-Arbeitnehmern – aber diese Konsolidierung hat keine Layout-Standardisierung hervorgebracht. Jeder Anbieter erzeugt W-2s in seinem eigenen proprietären Format, mit eigenen Schriftarten, eigener Box-Positionierung, eigenen Seitenmaßen. Das Ergebnis ist, dass ein Stapel von 50 W-2s eines mittelgroßen Arbeitgebers Formulare aus vier verschiedenen Lohnabrechnungssystemen enthalten kann, die jeweils eine andere Extraktionsvorlage erfordern – oder, was häufiger vorkommt, einen Menschen, der sie einfach liest und abtippt.
Und die Fragmentierung betrifft nicht nur verschiedene Anbieter. Sie kann innerhalb eines einzigen Steuerjahres für einen einzelnen Arbeitnehmer auftreten. Jemand, der im März den Job gewechselt hat, erhält eine W-2 von Arbeitgeber A und Arbeitgeber B (Paychex). Jemand, der einen W-2-Job hatte und einen 1099-Nebenjob, erhält eine W-2 vom Arbeitgeber und eine 1099-NEC vom Auftraggeber. Jedes Formular kommt in einem anderen Format, über einen anderen Kanal, zu einem anderen Zeitpunkt an. Die Vielfalt ist kein Randfall – sie ist der Normalzustand der Steuersaison-Vorbereitung.
Die IRS unterhält weiterhin eine Papierverarbeitungspipeline – und das hält Papier am Leben
Gemäß T.D. 9972 greift die E-File-Pflicht für Informationserklärungen ab 10 Formularen. Reichen Sie 9 oder weniger W-2 ein, können Sie diese weiterhin in Papierform an die SSA senden. Die eigenen Anweisungen der IRS für Form W-2 erkennen diese Schwelle an. Bundesweit fallen Millionen kleiner Arbeitgeber – Restaurants mit sechs Angestellten, Baufirmen mit acht, Zahnarztpraxen mit fünf – unter diese Grenze. Jeder druckt einen Stapel W-2-Formulare, füllt sie aus (manchmal von Hand) und sendet sie an die SSA, während Papierkopien an die Mitarbeiter ausgehändigt werden.
Dies ist kein regulatorisches Versehen. Es ist eine bewusste Entgegenkommung. Die IRS weiß, dass es für jedes Zwei-Personen-Gartenbauunternehmen eine unzumutbare Compliance-Belastung wäre, sich durch das BSO-Einreichungssystem der SSA zu navigieren – mit seinen EFW2-Formatspezifikationen, der AccuWage-Validierungssoftware und den SSN-Verifizierungsanforderungen. Daher bleibt die Papierpipeline geöffnet. Und jedes Papier-W-2, das unterhalb der E-File-Schwelle erstellt wird, ist ein W-2, das letztendlich in den Händen eines Steuerberaters landet und transkribiert werden muss.
Der Strafenkatalog der IRS macht dies zu mehr als einer Unannehmlichkeit. Gemäß Internal Revenue Code §§ 6721 und 6722 werden verspätete oder fehlerhafte Informationserklärungen pro Formular bestraft – die Staffelung reicht von $60 bis $680, je nach Korrekturzeitpunkt und Absicht. Ein Steuerberater, der eine einzelne Ziffer in Box 1 falsch eingibt und eine fehlerhafte Erklärung einreicht, hat eine Haftung geschaffen – nicht für den Arbeitgeber, sondern möglicherweise zurückzuführen auf den Transkriptionsfehler des Beraters. Eine vollständige Aufschlüsselung der Kosten, die diese Pro-Formular-Strafen und Transkriptionsfehler einer Kanzlei über eine Saison verursachen, finden Sie in unserer Kostenanalyse zur manuellen W-2- und 1099-Erfassung.
Der Bleistiftstrich in Box 3, der jede Automatisierungspipeline zum Scheitern bringt
Eines der beständigsten Ergebnisse aus der Steuerberatungspraxis ist, dass W-2-Formulare, die von Mandanten eintreffen, selten makellos sind. Ein korrigierter Social-Security-Lohnbetrag ist handschriftlich über der gedruckten Zahl notiert. Eine EIN ist durchgestrichen und neu eingetragen. Die Kontrollkästchen in Box 13 sind mit einem Kugelschreiber markiert statt mit der ursprünglichen Druckertinte. Ein Kaffeefleck verdeckt die staatliche ID-Nummer. Das Formular wurde für einen Geschäftsumschlag in Drittel gefaltet und dann wieder entfaltet – mit Knickfalten quer über den Lohnfeldern. Nichts davon ist ungewöhnlich. Das ist der Normalzustand von Papiersteuerdokumenten, die von echten Steuerzahlern eingereicht werden.
Für template-basierte OCR-Systeme ist jede dieser Abweichungen ein Fehlerpunkt. Handschriftliche Ziffern, die über gedruckten Zahlen liegen, verwirren die Zeichenerkennung. Knickfalten durch Zahlenfelder unterbrechen die Ziffernsegmentierung. Kontrollkästchen, die mit dem falschen Markierungstyp versehen sind – ein Kreis statt eines X, ein Häkchen statt eines ausgefüllten Quadrats – liefern Nullwerte, wo eine Auswahl stehen sollte. Ein System, das auf sauberen, mit dem Flachbettscanner erfassten PDFs frisch gedruckter Formulare trainiert wurde, hat kein Modell für den physischen Zustand eines W-2, das durch die U.S. Postal Service gereist ist, zwei Wochen auf einer Küchenarbeitsplatte lag und von jemandem mit einem Kugelschreiber ausgefüllt wurde, der nicht sicher war, was der Code DD in Box 12 bedeutet.
Die schmerzhafteste Ironie ist, dass ein menschlicher Bearbeiter dieses beschädigte Dokument fast augenblicklich verarbeiten kann. Ein Blick auf eine durchgestrichene Box 3 mit handschriftlichem Ersatz sagt dem Bearbeiter: „Der ursprüngliche Betrag war falsch, verwenden Sie den handschriftlichen.“ Ein template-basiertes System sieht zwei konkurrierende Zahlen im selben Feld und liefert keine von beiden – oder schlimmer noch, die falsche. Das Urteilsvermögen, das ein geschulter Bearbeiter in einer halben Sekunde anwendet, fehlt Automatisierungssystemen genau dort, und genau das hat den Menschen im Mittelpunkt der W-2-Transkriptionsschleife gehalten.
Steuersoftware kann Daten übertragen – aber sie kann das Papier Ihres Mandanten nicht lesen
Die wichtigsten Steuererklärungsplattformen der Branche – Drake, UltraTax, Lacerte, ProSeries, ATX – unterstützen alle den Import von W-2-Daten. Aus einer CSV-Datei. Aus einer Vorjahreserklärung. Aus dem digitalen Export eines Lohnabrechnungsanbieters. Was keine von ihnen kann, ist das Lesen einer papierbasierten W-2 Copy B, die ein Mandant dem Steuerberater über den Schreibtisch gereicht hat. Der Import erwartet strukturierte digitale Eingaben, und das Quelldokument ist unstrukturiertes physisches Papier. Der Steuerberater ist die Konvertierungsebene.
Selbst wenn W-2-Daten elektronisch an die SSA übermittelt wurden, kann der Steuerberater sie nicht einfach aus der SSA-Datenbank in Drake abrufen. Das Business Services Online-System der SSA stellt Lohndaten für den Abgleich zur Einhaltung von Vorschriften an den IRS bereit, nicht an Steuerberater für die Erstellung von Steuererklärungen. Das Wage and Income Transcript – auf das der Steuerberater zugreifen kann über das Transcript Delivery System (TDS) des IRS – steht Steuerfachleuten mit einem unterzeichneten Form 8821 oder einer Power of Attorney zur Verfügung, kommt jedoch als geschwärzte Zusammenfassung an, nicht als strukturierte Daten auf Feldebene. Der Steuerberater, der mit der papierbasierten W-2 des Mandanten in der einen Hand und einem Drake-Eingabebildschirm auf dem Monitor sitzt, tippt also weiterhin.
Das U.S. Bureau of Labor Statistics bezifferte den mittleren Stundenlohn für Buchhalter und Wirtschaftsprüfer auf $39.27 (Stand Mai 2024). Inklusive Zusatzleistungen, Lohnnebenkosten, Büro-Overhead und Softwarelizenzen kostet ein angestellter Buchhalter die Kanzlei eher $55–65 pro Stunde. Jede Stunde, die dieser Buchhalter mit der Übertragung von W-2-Feldern verbringt – eine Aufgabe, die keinerlei analytisches Urteilsvermögen erfordert –, ist eine Stunde, die nicht für die Prüfung der Steuererklärung, die Identifizierung von Steuersparmöglichkeiten oder die Beratung des Mandanten aufgewendet wird. Die Kosten der Dateneingabe selbst wurden für eine mittelgroße Kanzlei auf $4,000–$6,000 pro Steuersaison beziffert. Die Opportunitätskosten – die abrechenbare Arbeit, die durch das Tippen verdrängt wird – sind schwerer zu messen, aber mit ziemlicher Sicherheit höher.
Vorlagenbasierte OCR scheitert bei W-2-Formularen aus demselben strukturellen Grund, aus dem sie immer scheitert: Layout-Variation
Seit zwei Jahrzehnten ist der dominierende Ansatz zur Datenextraktion aus Dokumenten die vorlagenbasierte OCR. Sie erstellen eine Vorlage, die besagt: “Box 1 befindet sich an den Koordinaten (x1, y1, x2, y2) auf diesem ADP-generierten W-2” – und das System liest den Text, der in dieses Rechteck fällt. Das funktioniert hervorragend bei Dokumenten mit festen, vorhersehbaren Layouts – einer bestimmten Rechnung von einem bestimmten Anbieter, die immer vom selben ERP-System erzeugt und immer gleich gestaltet wird. Bei W-2-Formularen funktioniert es jedoch miserabel, da dasselbe Feld (Box 1) in unterschiedlichen Positionen auf den Ausgaben jedes Lohnabrechnungsanbieters und auf jeder gescannten Papierkopie erscheint.
Das zugrunde liegende Problem ist, dass vorlagenbasierte OCR Dokumente nach Position liest, nicht nach Bedeutung. Sie weiß, wo Box 1 war – auf dem Trainingsbeispiel –, nicht, was Box 1 ist – im aktuellen Dokument. Diese Unterscheidung – Position vs. Bedeutung – ist der zentrale Grund, warum sich die W-2-Dateneingabe der Automatisierung widersetzt hat. Die Formspezifikation garantiert, welche Informationen erscheinen (Löhne, einbehaltene Steuern, SSN, EIN), aber nicht, wo auf der physischen oder digitalen Seite diese Informationen platziert sind. Jedes System, das sich auf “wo” verlässt, um “was” zu bestimmen, wird in dem Moment zusammenbrechen, in dem es auf ein W-2 von einem Lohnabrechnungsanbieter trifft, mit dem es nicht trainiert wurde.
Vorlagen-Tools scheitern auch am Multi-Quellen-Problem. Eine Vorlage, die für “ADP W-2, Format 2024” erstellt wurde, kann keine Daten aus “Paychex W-2, Format 2024” extrahieren – ganz zu schweigen von “Foto eines Papier-W-2 von einem kleinen Arbeitgeber, Format 2024, mit handschriftlicher Korrektur in Box 3.” Der Steuerberater müsste eine Bibliothek mit Vorlagen für jeden Lohnabrechnungsanbieter pflegen, den die Arbeitgeber seiner Mandanten nutzen, jährlich aktualisiert, da jeder Anbieter sein Formularlayout anpasst. Allein der Wartungsaufwand macht den Ansatz in jedem realistischen Maßstab unpraktikabel. Für einen detaillierten Blick darauf, wie die semantische Extraktion jede Box über diese Layouts hinweg liest – und wo sie dennoch ins Stocken gerät – siehe den vollständigen Leitfaden zur W-2- und 1099-Extraktion.
Semantisches Verständnis ersetzt Position durch Bedeutung – und das verändert, was Automatisierung leisten kann
Die Alternative zur vorlagenbasierten Extraktion ist das semantische Dokumentverständnis: ein KI-Modell, das ein W-2 so liest, wie es ein Mensch tut – indem es erkennt, was jedes Feld bedeutet, nicht wo es steht. Wenn Sie auf einem W-2 „Wages, tips, other compensation“ sehen, wissen Sie, dass das Box 1 ist, unabhängig davon, ob es oben links in einem ADP-PDF, oben rechts in einem Paychex-PDF oder in der Mitte eines Handyfotos eines Papierformulars erscheint. Semantische KI trifft dasselbe Urteil: Sie identifiziert „Wages, tips, other compensation“ als Konzept und extrahiert den Dollar-Betrag daneben, egal ob dieser Betrag gedruckt, handschriftlich oder durchgestrichen korrigiert ist.
Dieser Wandel – von der koordinatenbasierten zur konzeptbasierten Extraktion – macht die W-2-Automatisierung erstmals technisch machbar. Statt zu definieren, wo Box 1 auf einer bestimmten Vorlage liegt, sagen Sie dem System: „Extrahieren Sie den Dollar-Betrag, der mit Wages, tips, other compensation beschriftet ist.“ Das System liest das gesamte Formular, findet dieses Label, wo immer es erscheint, und liefert den Wert daneben zurück. Dieser Ansatz – manchmal auch Spaltennamensextraktion genannt, bei der Sie die gewünschten Felder über ihre semantischen Namen statt über ihre Seitenkoordinaten definieren – verarbeitet alle drei Lohnabrechnungsanbieter, die handschriftliche Korrektur und das Handyfoto in einem einzigen Durchgang, weil er nie davon abhängt, im Voraus zu wissen, wo etwas ist.
Hier wird auch das Extrahieren von W-2-Daten aus PDFs in strukturierte Tabellenkalkulationen im großen Maßstab möglich. Ein Ersteller definiert die Spaltennamen – „Box 1 Wages“, „Box 2 Federal Tax Withheld“, „Box b EIN“, „Employee SSN“ – und das semantische Modell findet jeden Wert in jedem W-2 des Batches, unabhängig davon, welcher Lohnabrechnungsanbieter welches Formular erstellt hat. Das Ergebnis ist ein einziges Excel-Blatt mit einer Zeile pro Mitarbeiter, bereit für den Import in Drake oder UltraTax, ohne dass ein einziges Feld manuell eingegeben wird.
Was End-to-End-W-2-Automatisierung erfordern würde – und warum drei Bausteine endlich vorhanden sind
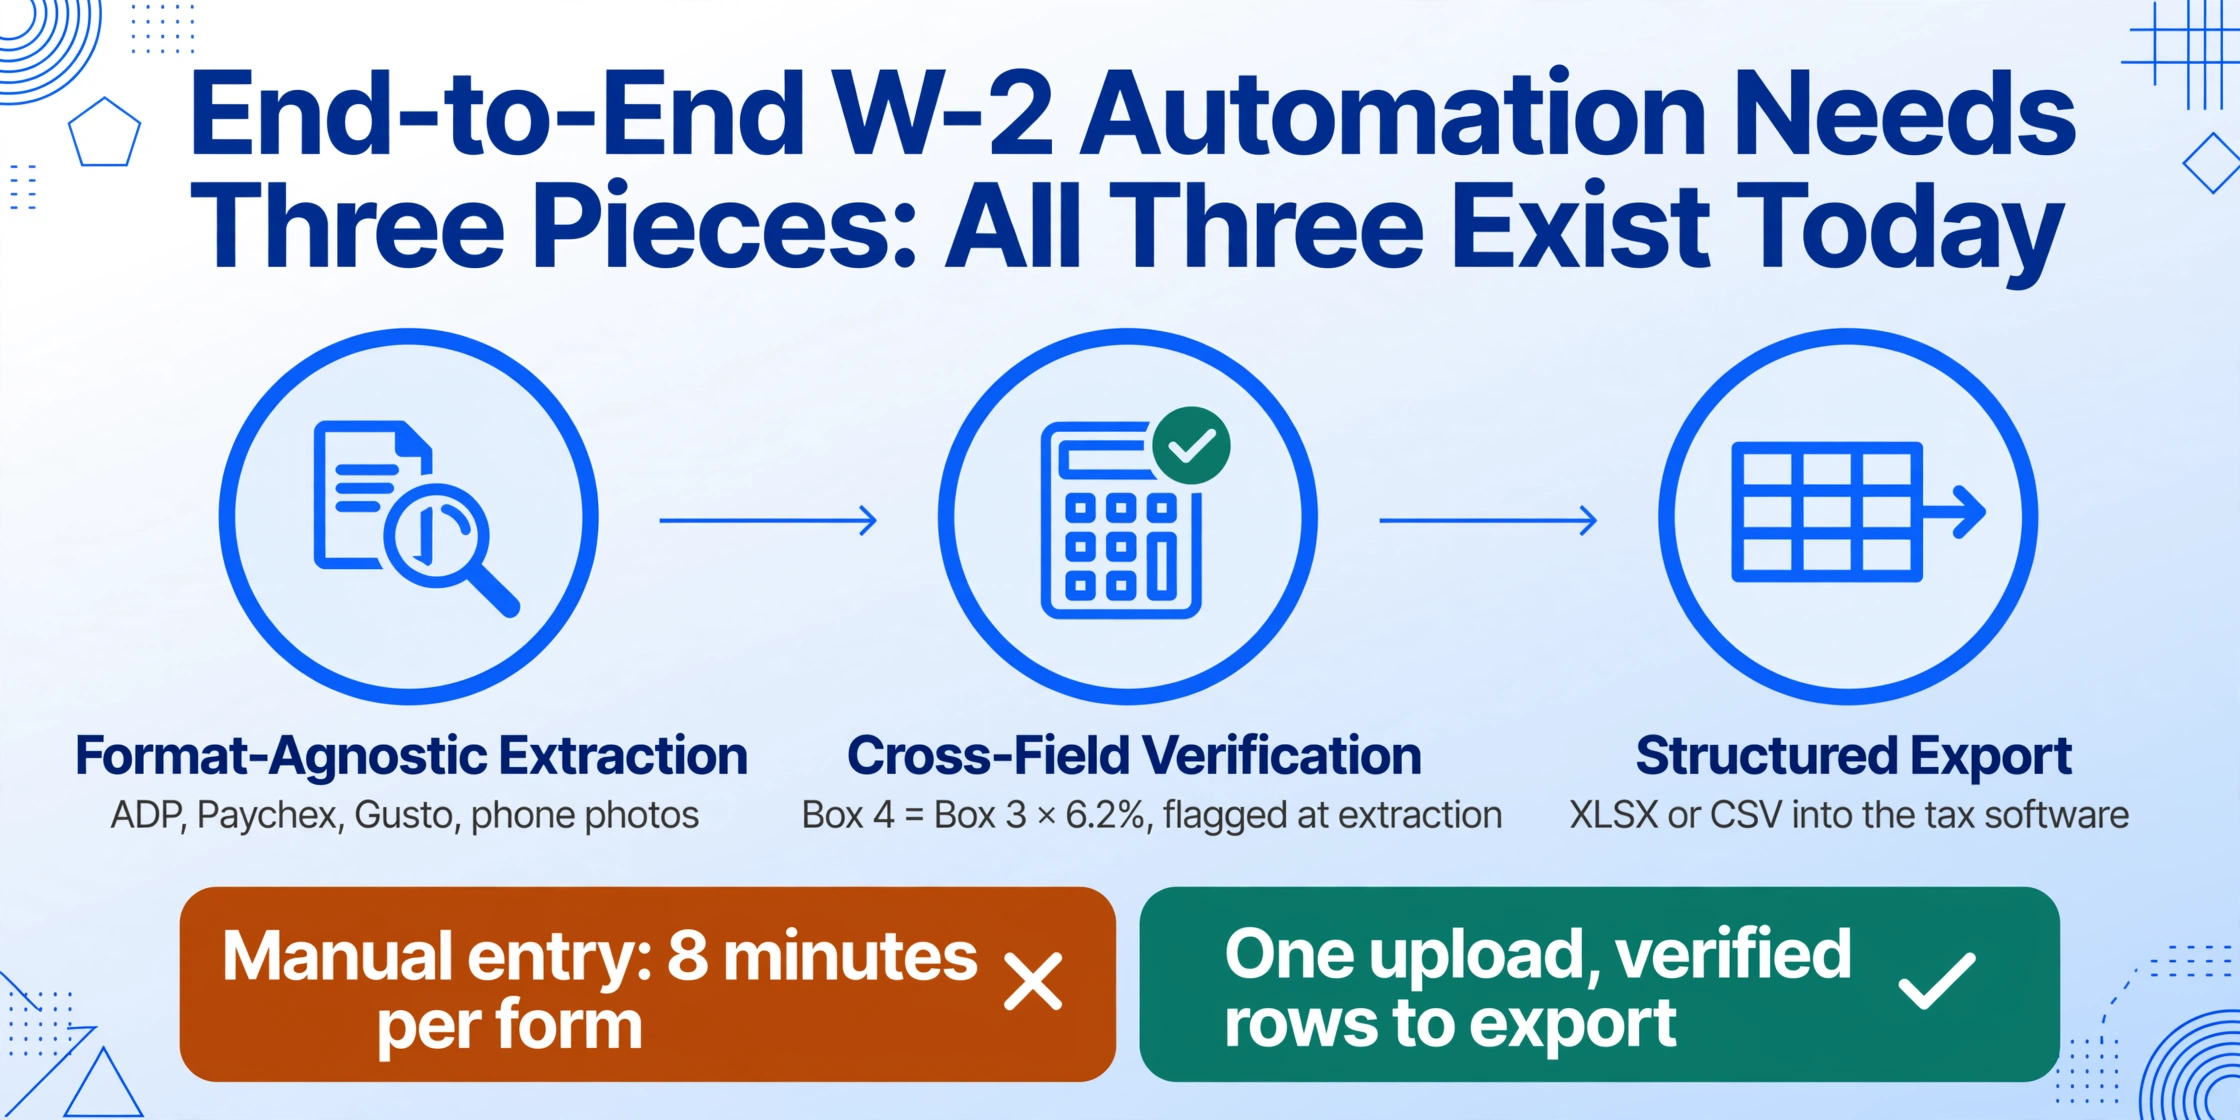
Die vollständige Automatisierung der W-2-Dateneingabe – vom Eingang der Kundendokumente bis zum Import in die Steuersoftware – erfordert drei Fähigkeiten, die historisch in getrennten Systemen existierten:
- Formatunabhängige Feldextraktion – dasselbe Feld korrekt über ADP, Paychex, Gusto, gescannte Papierkopien und Handyfotos hinweg lesen, ohne anbieterabhängige Vorlagen.
- Feldübergreifende Prüfung – automatisch prüfen, dass Box 4 (Social-Security-Steuer) Box 3 × 6,2 % entspricht, dass Box 2 (Bundessteuereinbehalt) im Verhältnis zu Box-1-Löhnen plausibel ist und dass das SSN-Format gültig ist. Dies ist der Beurteilungsschritt des Erstellers – und er muss zum Zeitpunkt der Extraktion erfolgen, nicht erst bei der späteren Prüfung.
- Strukturierter Export – die extrahierten und geprüften Daten in einem Format liefern, das die Steuersoftware direkt verarbeiten kann (XLSX, CSV), wodurch der erneute Eingabeschritt vollständig entfällt.
Der erste Baustein – formatunabhängige Extraktion – ist das, was semantische KI ermöglicht. Der zweite Baustein – feldübergreifende Prüfung – ist das, was berechnete Spalten zum Workflow hinzufügen: die Möglichkeit, zum Zeitpunkt der Extraktion Berechnungen wie „Box 4 = Box 3 × 0,062 prüfen“ zu definieren und Abweichungen zu kennzeichnen, bevor die Daten jemals die Tabelle erreichen. Der dritte Baustein – strukturierter Export – ist die letzte Brücke zwischen dem Dokumentenstapel des Erstellers und dem Importbildschirm der Steuersoftware. Jeder dieser drei Bausteine existiert heute. Was gefehlt hat, ist ein einziges Tool, das sie zusammenführt.
Das Problem der W-2-Dateneingabe besteht seit 47 Jahren nicht, weil die Technologie zur Lösung nicht existierte, sondern weil der Ansatz falsch war. Vorlagenbasierte Systeme versuchten, W-2-Formulare an ihr Extraktionsmodell anzupassen. Semantische Systeme lesen W-2-Formulare so, wie sie tatsächlich ankommen – vielfältig, physisch, unvollkommen – und extrahieren die Daten trotzdem. Dieser Unterschied – das Tool an das Formular anzupassen, statt zu verlangen, dass sich das Formular dem Tool anpasst – ist der strukturelle Wandel, der Automatisierung endlich möglich macht.
Häufig gestellte Fragen
Kann ich Daten aus einem Foto eines Papier-W-2 extrahieren, oder muss es eine saubere PDF sein?
Semantische KI-Modelle verarbeiten Fotos von Papier-W-2s genauso wie saubere digitale PDFs – indem sie die Bedeutung jedes Feldlabels lesen, nicht durch Abgleich mit einer Vorlage. Ein Smartphone-Foto von Copy B, das Ihr Kunde aufgenommen und Ihnen geschickt hat, ist ein gültiges Eingabedokument. Die Qualität des Fotos ist wichtig – einigermaßen gut beleuchtet und scharf –, aber das Format spielt keine Rolle. JPG, PNG und PDF werden alle unterstützt.
Wenn ich 50 W-2s von verschiedenen Lohnabrechnungsanbietern habe, kann ich sie alle auf einmal verarbeiten?
Ja. Die Batch-Verarbeitung ist speziell für W-2-Batches aus gemischten Quellen konzipiert. Sie laden alle 50 Dateien in einer einzigen Sitzung hoch – ADP-PDFs, Paychex-PDFs, Handyfotos von Papierformularen – definieren Ihre gewünschten Ausgabespalten einmal (Box 1 Löhne, Box 2 Bundessteuer, Box 4 Social Security, Mitarbeitername, Mitarbeiter-SSN, Arbeitgeber-EIN), und das System liefert eine einzige Excel-Tabelle mit einer Zeile pro Mitarbeiter. Die Extraktion erfolgt nach Feldbedeutung, nicht nach Dateivorlage, sodass die unterschiedlichen Layouts der Lohnabrechnungsanbieter keine separaten Einrichtungen erfordern.
Was ist mit handschriftlichen Korrekturen auf W-2-Formularen – kann KI diese lesen?
Semantische KI-Modelle, die auf Handschrifterkennung trainiert sind, können gedruckten Text von handschriftlichen Korrekturen im selben Feld unterscheiden. Ein durchgestrichener gedruckter Wert mit einer handschriftlichen Ersetzung in Box 3 wird in der Regel als der handschriftliche Wert gelesen – das System erkennt die Korrektur. Stark beschädigte oder verschmierte Handschrift kann die Genauigkeit jedoch verringern. In solchen Fällen sollte das extrahierte Ergebnis stichprobenartig mit dem Quellbild abgeglichen werden, was unabhängig von der Extraktionsmethode ein standardmäßiger Qualitätskontrollschritt ist.
Akzeptiert das IRS von KI-Tools extrahierte W-2-Daten für die elektronische Einreichung?
Das IRS reguliert nicht, wie Steuerberater Quelldokumente von Kunden digitalisieren – es reguliert die Genauigkeit der eingereichten Steuererklärung. Die Berater bleiben dafür verantwortlich, zu überprüfen, dass die in die Steuersoftware eingegebenen Daten (ob manuell getippt, aus einem Lohnabrechnungsexport importiert oder durch KI extrahiert) mit dem Quell-W-2 übereinstimmen. KI-Extraktion ist der Datenerfassungsschritt; die Überprüfung und das professionelle Urteil des Beraters bleiben der Compliance-Schritt.
Was ist der Unterschied zwischen vorlagenbasierter OCR und semantischer KI für die W-2-Erfassung?
Vorlagenbasierte OCR erfasst Daten nach Position: „Lies den Text, der in diesem Rechteck erscheint.“ Sie erfordert eine separate Vorlage für jedes Lohnabrechnungssystem-Format der W-2 und scheitert bei jedem Formular, für das sie nicht explizit trainiert wurde. Semantische KI erfasst Daten nach Bedeutung: „Finde das Feld mit der Bezeichnung ‚Löhne, Trinkgelder, sonstige Vergütung‘ und gib den Dollar-Betrag daneben zurück.“ Sie funktioniert mit jedem W-2-Layout — ADP, Paychex, Gusto, gescanntes Papier, Handyfoto — weil es ihr egal ist, wo die Bezeichnung auf der Seite steht. Wenn Sie Spaltennamensextraktion anstelle von koordinatenbasierten Vorlagen verwenden, verarbeitet dasselbe Setup jede W-2 in Ihrem Batch, unabhängig von der Quelle.
Kann ich extrahierte W-2-Daten automatisch gegenprüfen — zum Beispiel verifizieren, dass die einbehaltene Social-Security-Steuer 6,2 % des Lohns entspricht?
Ja. Berechnete Spalten ermöglichen es Ihnen, Verifizierungsformeln während der Extraktion zu definieren. Sie können eine Spalte hinzufügen, die Box 3 × 6,2 % berechnet und mit dem extrahierten Wert aus Box 4 vergleicht, und dabei jede Abweichung kennzeichnen. Sie können auch verifizieren, dass die Löhne in Box 1 die Social-Security-Löhne in Box 3 plus die Medicare-Löhne in Box 5 nicht auf unmögliche Weise überschreiten. Diese Querchecks — dieselben, die ein Steuerberater manuell durchführt — erfolgen zum Zeitpunkt der Extraktion, sodass Unstimmigkeiten aufgedeckt werden, bevor die Daten die Eingabemaske der Steuersoftware erreichen.
Wo die manuelle Eingabe endet und die Automatisierung beginnt
Die W-2 wurde nicht für die Automatisierung entwickelt. Ihre Verteilung in sechs Kopien, ihre papierbasierte Architektur, ihre Akzeptanz handschriftlicher Korrekturen — jedes strukturelle Merkmal des Formulars setzt voraus, dass ein Mensch es liest. 47 Jahre lang versuchten Technologieunternehmen, dies zu lösen, indem sie W-2-Formulare wie jedes andere strukturierte Dokument behandelten: Vorlage erstellen, Koordinaten abgleichen, Text extrahieren. Dieser Ansatz scheiterte, weil W-2-Formulare nicht so strukturiert sind, wie es Vorlagen erfordern. Sie sind eine Familie visuell unterschiedlicher Dokumente, die eine gemeinsame Menge an Feld-Bedeutungen teilen — und der einzige Extraktionsansatz, der bei ihnen funktioniert, ist der, der Bedeutung liest, nicht Position.
Semantische Extraktion verändert die Arbeitseinheit von „ein Formular, eine Vorlage, ein Datentypist“ zu „ein Batch, eine Spaltendefinition, ein Klick.“ Der Steuerberater überprüft das Ergebnis weiterhin — das ist professionelles Ermessen, und das wird sich nicht ändern. Aber die Stunden, die damit verbracht wurden, Zahlen von einem Blatt Papier zu lesen und auf einen Bildschirm zu übertragen — das Erbe eines Formulardesigns von 1978 in einer Steuersaison 2026 — diese Stunden haben einen Ersatz.