Extraction de relevés de carte de crédit :
ce que la plupart des outils ratent
Les consommateurs américains ont effectué en moyenne 48 paiements par mois en 2024 — les cartes de crédit représentant 35 % de toutes les transactions, plus que tout autre moyen de paiement. Chacun de ces achats génère une ligne sur un relevé. Pour un dirigeant de petite entreprise avec une seule carte d'entreprise, cela fait 50 à 150 transactions par mois. Chacune de ces lignes doit finir dans un tableur pour le rapprochement, la catégorisation et la préparation fiscale.
Le problème n'est pas de trouver un outil qui prétend extraire les relevés de carte de crédit. C'est que la plupart produisent un résultat qu'il te faut encore nettoyer — lignes désalignées, montants au crédit mélangés aux débits, sous-totaux pris pour des transactions, noms de commerçants tronqués. Le vrai enjeu de l'extraction n'est pas de savoir si l'outil peut lire du texte, mais s'il comprend ce qu'il lit.
Points clés
- La plupart des outils d'extraction de relevés de carte de crédit te laissent encore nettoyer un résultat brouillon — lignes désalignées, sous-totaux lus comme des transactions, noms de commerçants coupés entre les colonnes — et ce nettoyage prend 30 minutes par relevé.
- Le goulot d'étranglement n'est pas la précision de l'OCR — c'est que l'extraction traditionnelle lit chaque page comme un flux de texte plat, sans notion de zone Purchases, de zone Payments ou de zone Fees, et les assemble donc en une seule liste inutilisable.
- L'extraction sémantique lit un relevé de carte de crédit comme le ferait un humain — en reconnaissant les zones par leur sens, pas par des coordonnées de pixels — et ImageToTable.ai te permet de définir tes colonnes une fois, puis de catégoriser automatiquement chaque transaction avec les colonnes inférées, pour obtenir un Excel propre en quelques secondes par page.
Pourquoi ton relevé de carte de crédit fait échouer l'OCR traditionnel
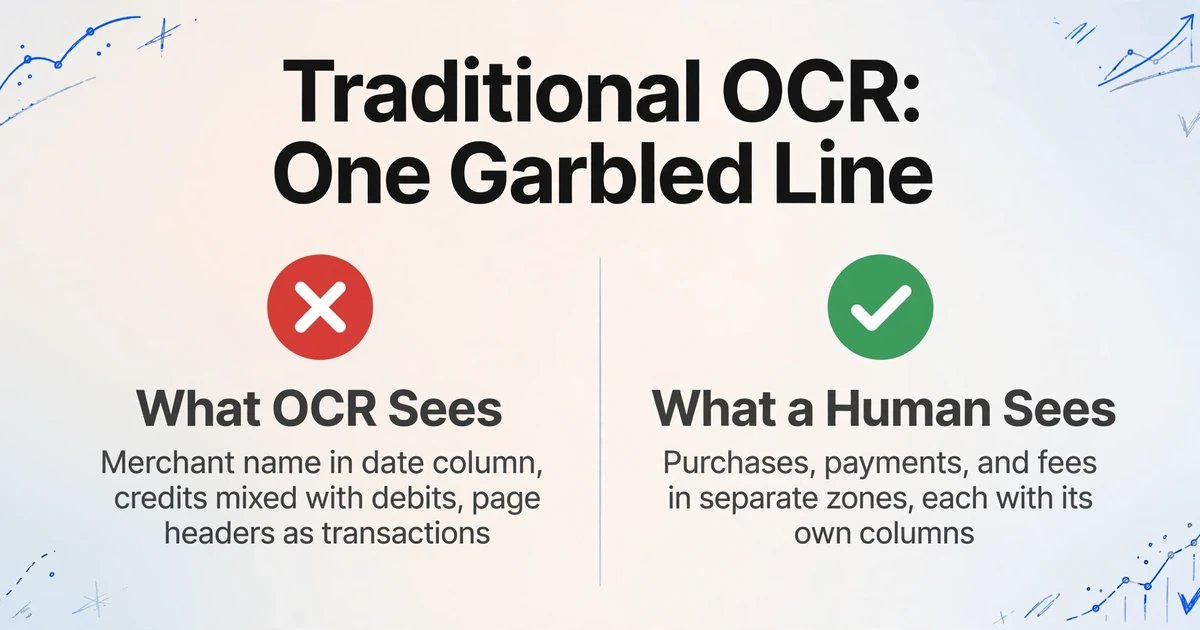
Un relevé de carte de crédit n'est pas un tableau plat. Ouvre n'importe quel relevé Chase, Amex ou Capital One et tu verras au moins trois zones de données distinctes sur la même page : une section Purchases avec des colonnes date, marchand et montant ; une section Payments & Credits avec sa propre structure de colonnes ; une section Fees & Interest, souvent avec une mise en page encore différente. Certains émetteurs séparent les debits et les credits dans des colonnes côte à côte. D'autres empilent tout dans une seule colonne Amount et utilisent des signes. Certains placent les numéros de référence après le nom du marchand. D'autres utilisent une colonne distincte.
L'OCR traditionnel ne voit pas les zones. Il lit de gauche à droite, de haut en bas, en traitant toute la page comme un flux de texte continu. Quand une ligne de paiement a trois colonnes mais qu'une ligne d'achat en a quatre, l'OCR les fusionne en une seule ligne illisible. Le sous-total courant après chaque série de 15 transactions — imprimé en gras et centré différemment — est lu comme une transaction sans description et avec un montant absurde. L'en-tête du relevé (numéro de carte, période de facturation, date d'échéance du paiement) déborde sur la première ligne de transaction.
Sur un fil r/Bookkeeping sur la conversion de PDF de cartes de crédit vers Excel, un comptable a décrit le résultat typique : « La sortie OCR met la moitié du nom du marchand dans la colonne date, mélange credits et debits, et inclut chaque en-tête "continued on next page" comme une transaction. Le temps que je nettoie tout ça, j'aurais pu le taper à la main. » Voilà le problème de l'OCR en pratique — non pas qu'il ne sache pas lire, mais qu'il ne sache pas organiser.
Il y a une deuxième couche au problème : la continuité multipage. Un relevé mensuel avec 80 transactions réparties sur quatre pages signifie que l'OCR produit quatre blocs de texte séparés. Les soldes courants se coupent entre les pages. L'en-tête « continued from previous page » en page deux est analysé comme une ligne de données. Le sous-total en pied de page un et le report en en-tête de page deux sont tous deux extraits, créant des entrées en double.
Et une troisième couche : les relevés scannés. Même en 2026, environ 15 à 20 % des petites institutions financières génèrent encore des PDF image plutôt que des PDF numériques avec texte sélectionnable, selon les benchmarks du secteur suivis par StatementDesk. Si ta credit union t'envoie un PDF scanné ou si tu travailles à partir d'une photo d'un relevé papier, la précision de l'OCR traditionnel chute de 30 à 50 % immédiatement — et les trois problèmes ci-dessus s'aggravent.
Comment l'extraction sémantique lit ce que l'OCR ne peut pas
Le problème de fond n'est pas la reconnaissance des caractères. C'est que l'OCR s'arrête au niveau du caractère. Il sait qu'il y a du texte à la position (x,y) sur la page, mais il ne sait pas que cette position (x,y) appartient à la zone « Purchases », que cette zone comporte quatre colonnes définies par sa ligne d'en-tête, et que le montant de la quatrième colonne de la ligne 7 représente un Debit, pas un Credit. Cette connaissance organisationnelle — celle qui permet à un humain de jeter un œil à un relevé et de le décoder instantanément — c'est ce qui manque.
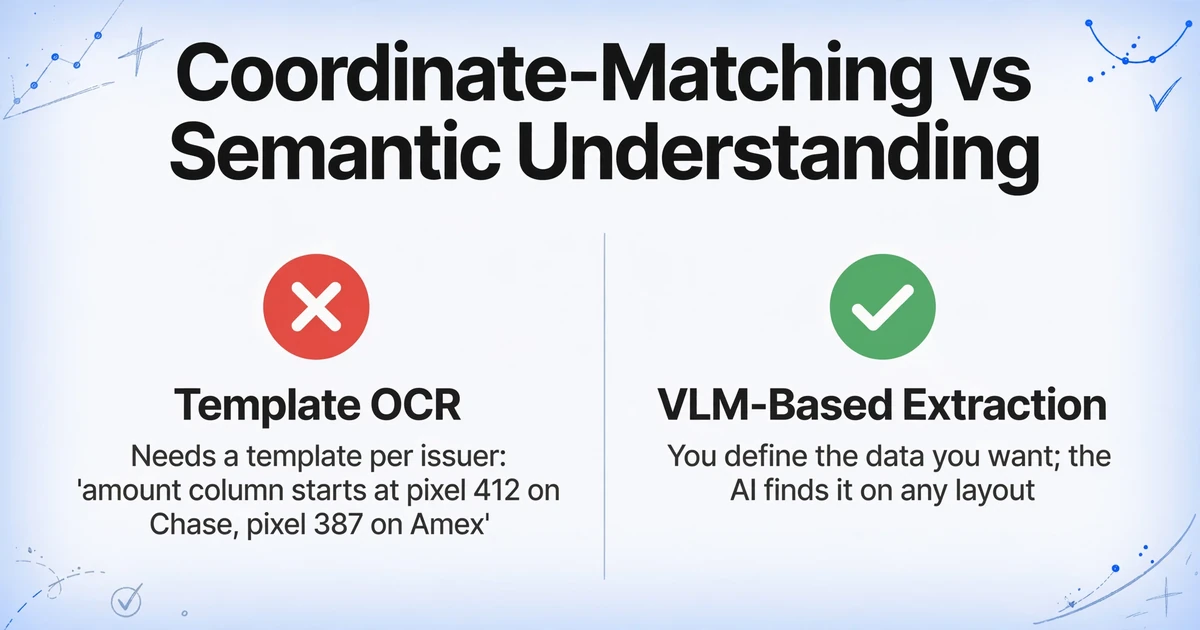
Les Vision Large Models (VLM) comblent cette lacune. Contrairement à l'OCR à modèle qui fait correspondre des coordonnées, un VLM lit un relevé de carte de crédit comme le ferait une personne : il voit la mise en page, comprend que « Payments & Credits » est une section différente de « Purchases », reconnaît que la colonne tout à droite de la zone Purchases correspond au montant de la transaction, et préserve la structure des lignes d'une page à l'autre. Le modèle n'a pas besoin de modèle pour Chase ou Amex, car il ne cherche pas des coordonnées — il cherche du sens.
Ce passage de la correspondance de coordonnées à la compréhension sémantique change ce qui est possible. Au lieu de dire à l'outil « la colonne des montants commence au pixel 412 sur les relevés Chase et au pixel 387 sur les relevés Amex », tu lui dis quelles données tu veux. L'IA détermine où elles se trouvent sur chaque page spécifique.
C'est là qu'intervient l'Extraction de colonnes personnalisées — un mécanisme qui fonctionne différemment de ce que proposent la plupart des outils d'extraction. Au lieu de préconfigurer un modèle pour chaque émetteur de carte ou de dessiner manuellement des zones autour des champs de données, tu saisis simplement les noms de colonnes souhaités dans ton tableur final : « Transaction Date », « Merchant Name », « Amount ». L'IA lit le document, comprend quelles données correspondent à chaque nom de colonne par leur sens sémantique (et non par leur position en pixels), et remplit les lignes. Les noms de colonnes que tu saisis deviennent les en-têtes de ton tableau de sortie — aucun entraînement de modèle, aucune cartographie de coordonnées, aucune configuration par banque.
Étape par étape : extraire les transactions avec l'Extraction de colonnes personnalisées
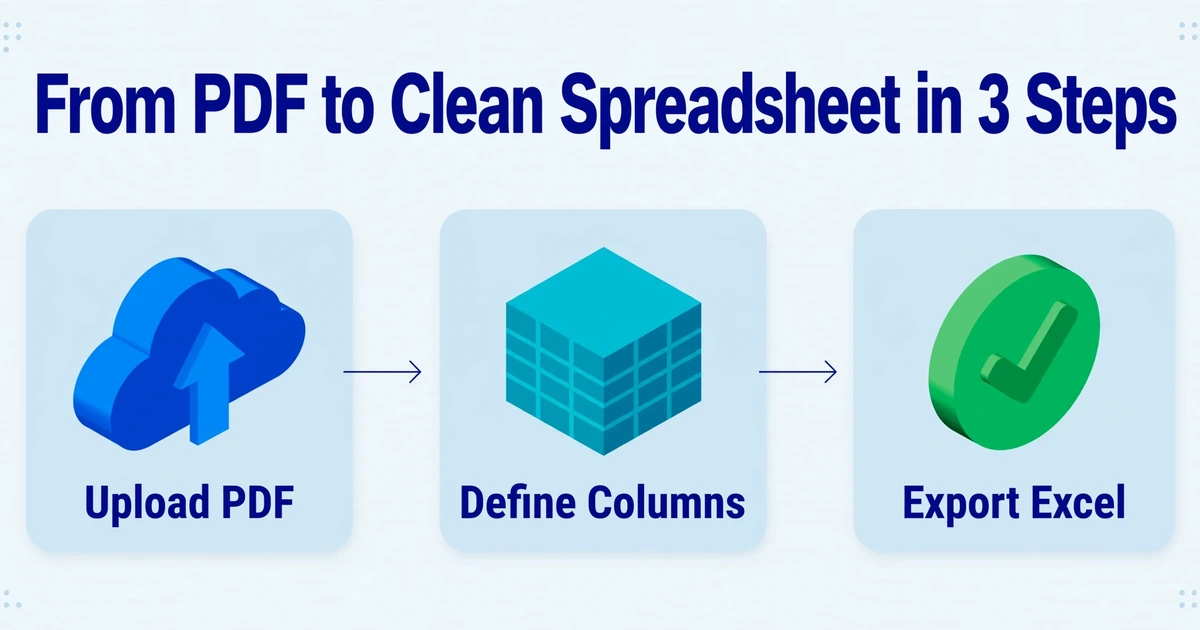
Voici le workflow, du relevé PDF au tableur Excel propre, avec l'Extraction de colonnes personnalisées pour définir exactement les données que tu veux — ni plus, ni moins.
Étape 1 : importe ton relevé. L'outil accepte les PDF (numériques ou scannés), JPG, PNG et WebP. Si tu as un relevé de plusieurs pages — par exemple un relevé mensuel de 4 pages de Chase — tu peux importer le fichier entier d'un coup. Les documents multipages sont traités comme un seul jeu de données continu ; les transactions des pages 1, 2, 3 et 4 arrivent toutes dans le même tableau de sortie, dans l'ordre. Si tu as des relevés de plusieurs cartes (une Amex professionnelle et une Visa personnelle, par exemple), importe-les ensemble en un lot et obtiens un seul tableur fusionné.
Étape 2 : définis tes colonnes. Au lieu de configurer des zones d'extraction ou d'entraîner un modèle, tu saisis les noms des colonnes à extraire. Pour un journal de transactions complet, les colonnes typiques incluent :
Tu peux aussi inclure des champs au niveau du relevé — Statement Period Start, Statement Period End, Payment Due Date, Minimum Payment Due — que l'IA extrait une fois depuis l'en-tête du relevé et répète sur chaque ligne de transaction pour référence. C'est utile quand tu traites plusieurs mois à la fois et que tu veux que chaque ligne soit associée à sa période de facturation.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Étape 3 : Exporte vers Excel. Une fois que l'IA a terminé l'extraction — généralement 5 à 10 secondes par page — tu télécharges un fichier Excel (XLSX) structuré. Chaque colonne que tu as définie devient une colonne du tableur. Chaque transaction devient une ligne. Les données sont déjà normalisées : dates dans un format cohérent, montants sous forme de nombres propres (aucun symbole monétaire intégré dans la cellule), noms de marchands débarrassés des codes internes de la banque. L'export CSV et JSON est aussi disponible si tu importes dans un logiciel comptable qui préfère ces formats. Pour aller plus loin dans les capacités d'extraction complètes — y compris la gestion des devises étrangères, l'analyse multi-zones sur différents formats d'émetteurs et le traitement par lots sur plusieurs mois — consulte la page de conversion relevé de carte de crédit vers Excel. Si tu préfères que les lignes arrivent directement dans Google Sheets sans l'étape de téléchargement et d'import, notre article sur l'extraction de relevés de carte de crédit vers Google Sheets couvre le workflow de l'extension latérale pour les mêmes relevés.
Catégorisez automatiquement vos transactions avec les colonnes inférées
Extraire les données de transactions d'un PDF résout le problème d'extraction. Mais pour le rapprochement et la préparation fiscale, l'extraction n'est que la première étape. Chaque transaction doit encore être catégorisée — cet achat sur Amazon est-il des fournitures de bureau, de l'équipement ou une dépense personnelle ? C'est cette étape de classification qui consomme l'essentiel du temps de rapprochement manuel.
C'est là que les colonnes inférées entrent en jeu. Contrairement à une colonne classique qui extrait des données explicitement imprimées sur le document, une colonne inférée demande à l'IA de déterminer quelque chose que le document ne dit pas directement — en analysant ce qu'il dit. Vous définissez une colonne appelée Category (options: Office Supplies/Equipment/Travel/Meals/Software/Utilities/Other), et pour chaque ligne de transaction, l'IA lit le nom du marchand et le contexte de la transaction, puis sélectionne la catégorie la plus appropriée.
Un débit de 42 USD chez « Staples » est classé en « Office Supplies ». « Delta Airlines » à 389 USD devient « Travel ». « Adobe Creative Cloud » à 59,99 USD devient « Software ». L'IA ne fait pas de correspondance par mots-clés — elle utilise la même compréhension sémantique qui lui permet de déchiffrer la mise en page du relevé. Elle sait que « Staples » est un fournisseur de fournitures de bureau, que « Delta » est une compagnie aérienne, et qu'un débit de 3,50 USD chez « Blue Bottle Coffee » est un repas, pas de l'équipement.
Ce qui rend cette fonctionnalité puissante pour le rapprochement de cartes de crédit, c'est que l'extraction et la catégorisation se font en une seule passe. Vous n'extrayez pas les transactions vers Excel pour passer ensuite une heure à ajouter une colonne Category manuellement. L'IA remplit les deux colonnes simultanément. Et comme les colonnes inférées fonctionnent sur les envois par lots — des relevés de plusieurs cartes ou de plusieurs mois traités ensemble — vous obtenez une seule feuille de calcul où chaque transaction, quelle qu'en soit la source, est déjà catégorisée.
Relevé de carte de crédit vs. relevé bancaire : les différences d'extraction
On pourrait penser qu'un relevé de carte de crédit et un relevé bancaire posent le même problème d'extraction — les deux contiennent des tableaux de transactions avec dates, descriptions et montants. En pratique, ils présentent des défis différents, et un outil optimisé pour l'un échoue souvent sur l'autre.
| Fonctionnalité | Relevé de carte de crédit | Relevé bancaire |
|---|---|---|
| Zones de transactions | Plusieurs zones par page (Purchases, Payments, Fees, Interest) — chacune avec des mises en page de colonnes différentes | Généralement un seul tableau de transactions par page avec des colonnes cohérentes |
| Traitement Debit/Credit | Mixte : une seule colonne Amount avec signes, ou des colonnes Debit/Credit séparées, ou des conventions selon la zone | Habituellement des colonnes Debit et Credit séparées, ou une convention cohérente sur une seule colonne |
| Sous-totaux & lignes de synthèse | Fréquents : sous-totaux par zone, totaux par page, totaux de synthèse du relevé — risque élevé de fausses lignes de transaction | La colonne de solde courant sert de validation intégrée ; les sous-totaux sont moins courants |
| Noms des marchands | Incohérents : le même marchand apparaît comme « AMZN », « Amazon.com », « AMAZON MKTPLACE » selon les émetteurs | Plus standardisés : les noms des bénéficiaires suivent le format interne de la banque de manière cohérente |
| Métadonnées du relevé | Date d'échéance du paiement, paiement minimum, limite de crédit, détails du TAEG — pertinents pour la planification financière | Solde du compte, intérêts gagnés, informations sur les découverts — un ensemble de métadonnées différent |
Pour l'extraction de relevés bancaires en particulier — qui fait face à ses propres défis autour de la validation du solde courant et de l'analyse des numéros de chèques — l'extraction de relevés bancaires pour les petites entreprises couvre le processus en détail. Le point clé pour les relevés de carte de crédit est que la conscience des zones est non négociable. Tout outil qui traite la page entière comme un seul tableau plat mélangera les achats, les paiements et les frais dans une liste unique inutilisable. L'extraction sémantique résout ce problème en reconnaissant le texte d'en-tête — « Purchases », « Payments and Credits », « Interest Charged » — et en appliquant des règles d'analyse différentes par zone, de la même manière que tes yeux le font en lisant le relevé.
De la réconciliation mensuelle à la préparation fiscale de fin d'année
Automatiser l'extraction des relevés de carte de crédit ne sert pas seulement à gagner une heure ce mois-ci. Il s'agit de ce qui se passe quand tu multiplies cette heure par les mois, les cartes et les exigences de fin d'année.
Le flux de travail typique de tenue de livres d'une petite entreprise implique trois cycles de réconciliation : mensuel (faire correspondre les transactions du relevé de carte de crédit aux reçus et aux écritures du General Ledger (GL)), trimestriel (compiler les dépenses catégorisées pour les paiements d'impôts estimés), et annuel (agréger les données de transactions de l'année complète pour l'examen du CPA et la déclaration fiscale). À chaque niveau, la qualité des données de transactions sous-jacentes détermine la quantité de travail que le niveau suivant va créer. Des données désordonnées au stade mensuel signifient un CPA facturant 200 $/heure ou plus pour les démêler en fin d'année.
La réconciliation mensuelle est l'endroit où l'extraction automatisée a l'impact le plus immédiat. Au lieu d'ouvrir le PDF du relevé côte à côte avec Excel et de saisir chaque ligne, tu télécharges le relevé, tu définis tes colonnes une fois, et tu obtiens une feuille de calcul propre en quelques secondes. Si tu traites trois cartes par mois, c'est un gain de temps récurrent qui se cumule.
Pour les calculs d'impôts estimés trimestriels, des données de transactions catégorisées sont essentielles. L'IRS exige une base raisonnable pour les déductions de dépenses selon la Publication 535 (Dépenses professionnelles) — ce qui signifie que tu dois savoir non seulement ce que tu as dépensé, mais aussi dans quelle catégorie chaque dépense tombe. Avec les colonnes inférées qui gèrent la catégorisation au moment de l'extraction, ton résumé des dépenses trimestrielles est déjà organisé : total des déplacements, total des fournitures de bureau, total des abonnements logiciels, chacun comme une ligne dans une feuille de calcul prête pour les tableaux croisés dynamiques.
En fin d'année, la différence est plus marquée. La plupart des petites entreprises paient entre 500 $ et 1 000 $ par mois pour une tenue de livres externalisée — et la tenue de livres de rattrapage ou de nettoyage pour des dossiers désorganisés peut coûter de 800 $ à 2 500 $ pour 6 à 12 mois d'arriérés. Si des données de transactions propres et catégorisées de chaque mois sont déjà exportées et organisées, le travail du comptable passe de la saisie de données à l'examen et à l'analyse — un engagement plus rapide et moins coûteux. Pour la saison des impôts spécifiquement, la couverture d'articles connexes sur pourquoi la saisie manuelle des données fiscales crée un problème d'automatisation et l'organisation des données de la saison des impôts applique la même logique aux formulaires W-2 et 1099 — le même principe d'extraction structurée en amont réduisant le travail de reprise en aval s'applique à tous les types de documents.
FAQ
Est-ce que l'IA peut gérer les relevés de carte de crédit de n'importe quel émetteur — Chase, Amex, Capital One, les coopératives de crédit locales ?
Oui. Comme l'extraction sémantique lit la mise en page par le sens plutôt que par la correspondance de coordonnées, elle fonctionne avec tous les émetteurs sans configuration par banque. Un relevé Chase avec des colonnes Debit et Credit séparées, un relevé Amex avec une seule colonne Amount, et un PDF scanné d'une coopérative de crédit sont tous analysés avec les mêmes définitions de colonnes que tu fournis. L'IA s'adapte à chaque mise en page plutôt que de t'obliger à créer un modèle pour chacune.
Et si mon relevé est une image scannée, pas un PDF numérique ?
Le Vision Large Model traite les documents scannés et les photos de la même façon que les PDF numériques — en comprenant visuellement la mise en page. Contrairement à l'OCR traditionnel qui se dégrade nettement sur les scans, l'extraction basée sur VLM maintient une haute précision sur les entrées image car elle ne dépend pas d'un rendu de texte propre. Une photo de relevé papier prise au téléphone, un PDF scanné d'une coopérative de crédit et un PDF numérique Chase passent tous par le même pipeline. Cela dit, les scans de très mauvaise qualité (fortement inclinés, très sombres ou en basse résolution) réduiront la précision — poser le relevé à plat avec un éclairage uniforme donne les meilleurs résultats.
L'IA distingue-t-elle automatiquement les achats, les paiements, les remboursements et les frais ?
Oui — mais il est important d'être précis sur la façon dont elle le fait. L'IA n'a pas de « détecteur de type » magique. Ce qu'elle fait, c'est reconnaître la zone sémantique à laquelle chaque transaction appartient (Purchases, Payments & Credits, Fees & Interest) en se basant sur les en-têtes de section du relevé, et classer en conséquence. Comme l'IA lit la mise en page comme le ferait un humain — en comprenant que « Payments and Credits » est une section distincte — la classification repose sur le contexte structurel, pas sur des suppositions. C'est pourquoi l'extraction par zones est importante : un outil qui ne peut pas distinguer les zones ne peut pas classer les types de transactions de manière fiable.
Puis-je traiter des relevés de plusieurs mois ou de plusieurs cartes à la fois ?
Oui. Tu peux téléverser plusieurs fichiers PDF — des relevés de différents mois, de différentes cartes, ou les deux — en un seul lot. L'IA traite chaque fichier indépendamment et fusionne toutes les transactions extraites dans un seul tableur de sortie. Chaque ligne conserve les informations du fichier source pour que tu puisses retracer toute transaction jusqu'à son relevé. C'est particulièrement utile pour la consolidation de fin d'année : téléverse 12 relevés mensuels de deux cartes (24 fichiers), définis tes colonnes une fois, et télécharge un tableur avec toutes les transactions de l'année entière, déjà structurées et catégorisées.
Qu'en est-il des transactions en devises étrangères sur mon relevé ?
De nombreux relevés de carte bancaire incluent à la fois un montant en devise étrangère et un montant converti en USD pour les transactions internationales. Tu peux définir des colonnes pour les deux : « Foreign Currency Amount » et « USD Amount » comme cibles d'extraction séparées. L'IA lit les deux valeurs de la ligne du relevé — quelle que soit la convention de colonnes utilisée par ton émetteur — et remplit les deux champs. Si ton relevé n'affiche pas le montant en devise d'origine (certains émetteurs ne montrent que le montant converti en USD), seules les données disponibles sont extraites.
Est-ce la même chose que l'importation des flux bancaires dans QuickBooks ou Xero ?
Non — cela sert un objectif différent. Les flux bancaires importent automatiquement les transactions de vos comptes connectés dans le logiciel comptable en quasi-temps réel, ce qui est utile pour la tenue de livres courante. Mais les flux bancaires nécessitent une connexion au compte (toutes les institutions ne la prennent pas en charge), peuvent manquer les transactions plus anciennes hors de la fenêtre du flux, et ne gèrent pas les relevés scannés ou papier. L'extraction de relevés fonctionne sur le PDF lui-même — elle ne nécessite pas d'accès au compte, fonctionne sur les relevés historiques remontant à des années, et peut traiter les relevés scannés ou photographiés. Les deux approches sont complémentaires, pas concurrentes : l'extraction gère ce que les flux ne peuvent pas atteindre.
L'heure que tu économises sur la saisie de données ce mois-ci est l'heure que ton CPA ne te facturera pas en mars prochain.
Aucune inscription requise · Traitez votre premier relevé gratuitement