Extracción de extractos de tarjetas de crédito:
Lo que la mayoría de las herramientas hace mal
Los consumidores estadounidenses realizaron un promedio de 48 pagos al mes en 2024 — y las tarjetas de crédito representaron el 35% de todas las transacciones, más que cualquier otro método de pago. Cada uno de esos cargos genera una línea en un extracto. Para el dueño de un pequeño negocio con una sola tarjeta corporativa, eso son 50–150 transacciones al mes. Cada una de esas líneas debe terminar en una hoja de cálculo para conciliación, categorización y preparación de impuestos.
El problema no es encontrar una herramienta que diga extraer extractos de tarjetas de crédito. Es que la mayoría produce resultados que igual tienes que limpiar: filas desalineadas, montos de crédito mezclados con débitos, subtotales confundidos con transacciones, nombres de comercios truncados. La brecha de extracción no se trata de si la herramienta puede leer texto. Se trata de si entiende lo que está leyendo.
Puntos clave
- La mayoría de las herramientas de extracción de extractos de tarjetas de crédito todavía te dejan limpiando resultados distorsionados — filas desalineadas, subtotales leídos como transacciones, nombres de comercios divididos entre columnas — y la limpieza consume 30 minutos por extracto.
- El cuello de botella no es la precisión del OCR — es que la extracción tradicional lee cada página como un flujo de texto plano y no tiene concepto de la zona de Purchases, la zona de Payments ni la zona de Fees, así que las une en una sola lista inutilizable.
- La extracción semántica lee un extracto de tarjeta de crédito como lo haría una persona — reconociendo zonas por su significado, no por coordenadas de píxeles — y ImageToTable.ai te permite definir tus columnas una vez y luego autocategorizar cada transacción con columna inferida para obtener un Excel limpio en unos segundos por página.
Por qué tu extracto de tarjeta de crédito rompe el OCR tradicional
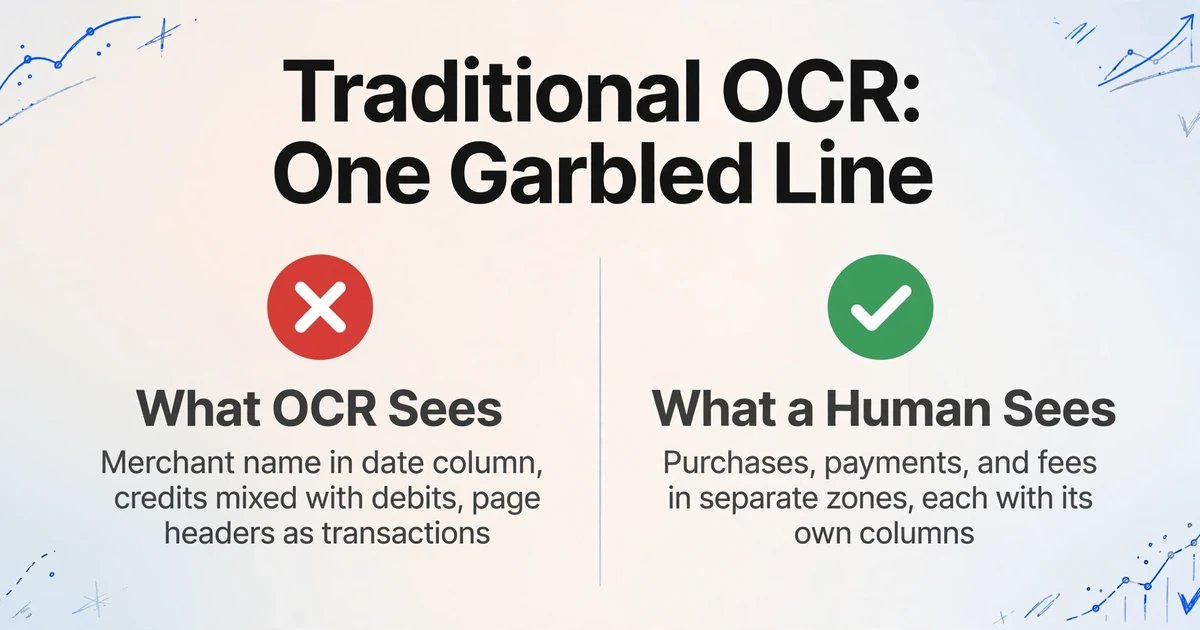
Un extracto de tarjeta de crédito no es una tabla plana. Abre cualquier extracto de Chase, Amex o Capital One y verás al menos tres zonas de datos distintas en la misma página: una sección Purchases con columnas de fecha, comercio e importe; una sección Payments & Credits con su propia estructura de columnas; una sección Fees & Interest, a menudo con otro diseño diferente. Algunos emisores separan los Debit y los Credit en columnas paralelas. Otros apilan todo en una sola columna Amount y usan signos. Algunos colocan números de referencia después del nombre del comercio. Otros usan una columna aparte.
El OCR tradicional no ve zonas. Lee de izquierda a derecha, de arriba abajo, tratando toda la página como un único flujo continuo de texto. Cuando una fila de pago tiene tres columnas pero una fila de compra tiene cuatro, el OCR las une en una sola línea ilegible. El subtotal acumulado cada 15 transacciones —impreso en negrita y centrado de forma distinta— se lee como una transacción sin descripción y con un importe sin sentido. El encabezado del extracto (número de tarjeta, periodo de facturación, fecha de vencimiento del pago) se cuela en la primera fila de transacción.
En un hilo de r/Bookkeeping sobre cómo convertir PDF de tarjetas de crédito a Excel, un contable describió el resultado típico: «La salida del OCR pone la mitad del nombre del comercio en la columna de fecha, mezcla Credit y Debit, e incluye cada encabezado de "continúa en la página siguiente" como una transacción. Para cuando lo limpio, podría haberlo escrito a mano». Ese es el problema del OCR en la práctica: no que no sepa leer, sino que no sabe organizar.
Hay una segunda capa del problema: la continuidad entre varias páginas. Un extracto mensual con 80 transacciones repartidas en cuatro páginas significa que el OCR produce cuatro bloques de texto separados. Los saldos acumulados se rompen entre páginas. El encabezado «continúa desde la página anterior» de la página dos se analiza como una fila de datos. El subtotal del pie de la página uno y el arrastre del encabezado de la página dos se extraen ambos, creando entradas duplicadas.
Y una tercera capa: los extractos escaneados. Incluso en 2026, aproximadamente el 15–20% de las instituciones financieras más pequeñas siguen generando PDF basados en imágenes en lugar de PDF digitales con texto seleccionable, según los benchmarks del sector que sigue StatementDesk. Si tu cooperativa de crédito envía un PDF escaneado o trabajas desde una foto de un extracto en papel, la precisión del OCR tradicional cae un 30–50% de inmediato, y los tres problemas anteriores empeoran.
Cómo la extracción semántica lee lo que el OCR no puede
El problema de fondo no es el reconocimiento de caracteres. Es que el OCR se detiene en el nivel del carácter. Sabe que hay texto en la posición (x,y) de la página, pero no sabe que esa posición (x,y) pertenece a la zona «Purchases», que esa zona tiene cuatro columnas definidas por su fila de encabezado, y que el importe de la cuarta columna de la fila 7 representa un Debit, no un Credit. Ese conocimiento organizativo —lo que permite a una persona echar un vistazo a un extracto y analizarlo al instante— es lo que falta.
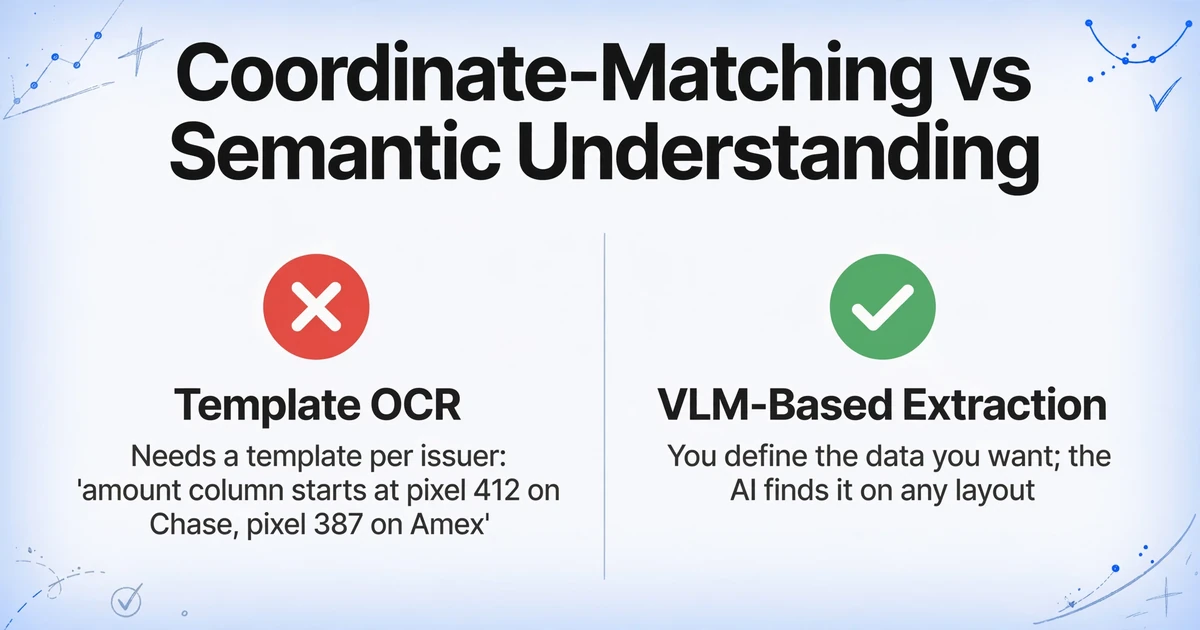
Los Vision Large Model (VLM) cubren esa carencia. A diferencia del OCR basado en plantillas que hace coincidir coordenadas, un VLM lee un extracto de tarjeta de crédito como lo haría una persona: ve la disposición, entiende que «Payments & Credits» es una sección distinta de «Purchases», reconoce que la columna del extremo derecho de la zona Purchases es el importe de la transacción y conserva la estructura de filas a lo largo de los saltos de página. El modelo no necesita una plantilla para Chase o Amex porque no busca coordenadas: busca significado.
Ese cambio de la coincidencia de coordenadas a la comprensión semántica transforma lo que es posible. En lugar de decirle a la herramienta «la columna de importe empieza en el píxel 412 en los extractos de Chase y en el píxel 387 en los de Amex», le dices qué datos quieres. La IA averigua dónde se encuentran en cada página concreta.
Aquí es donde entra en juego la Extracción de Columnas Personalizadas, un mecanismo que funciona de forma distinta a lo que ofrecen la mayoría de las herramientas de extracción. En lugar de preconfigurar una plantilla para cada emisor de tarjeta o dibujar manualmente cuadros alrededor de los campos de datos, simplemente escribes los nombres de columna que quieres en tu hoja de cálculo final: «Transaction Date», «Merchant Name», «Amount». La IA lee el documento, entiende qué datos corresponden a cada nombre de columna por su significado semántico (no por su posición en píxeles) y rellena las filas. Los nombres de columna que escribes se convierten en los encabezados de tu tabla de salida: sin entrenamiento de plantillas, sin mapeo de coordenadas, sin configuración por banco.
Paso a paso: extrae transacciones con Extracción de Columnas Personalizadas
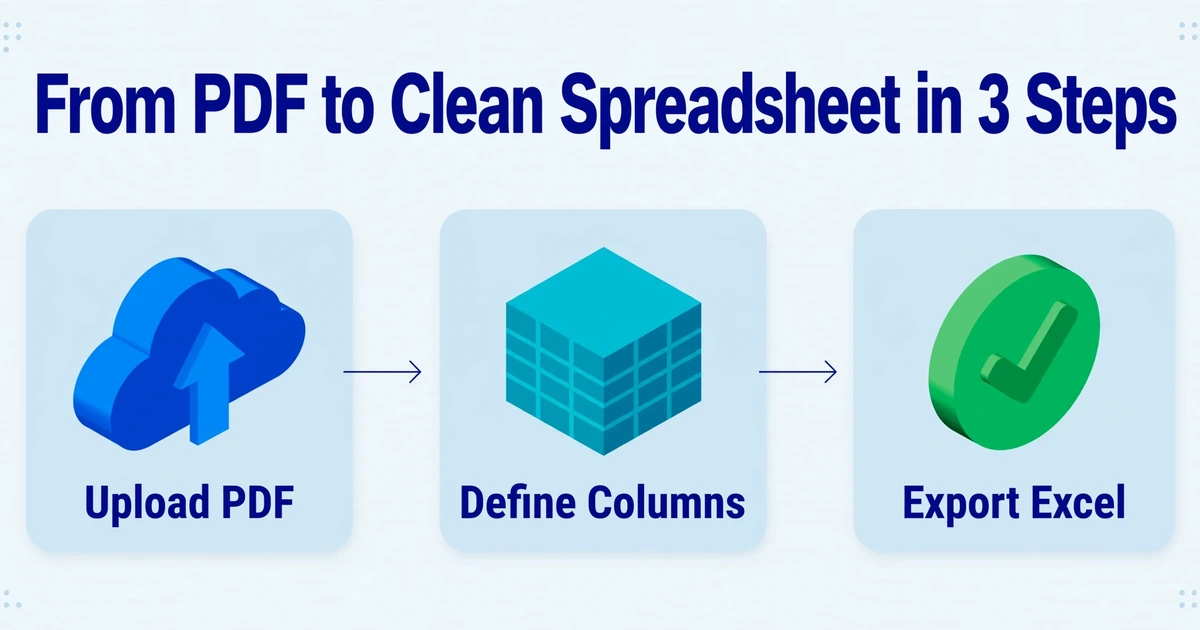
Este es el flujo de trabajo desde el estado de cuenta en PDF hasta una hoja de cálculo Excel limpia, usando Extracción de Columnas Personalizadas para definir exactamente qué datos quieres: ni más, ni menos.
Paso 1: Sube tu estado de cuenta. La herramienta acepta PDF (digitales o escaneados), JPG, PNG y WebP. Si tienes un estado de cuenta de varias páginas — por ejemplo, un estado mensual de 4 páginas de Chase — puedes subir el archivo completo de una vez. Los documentos de varias páginas se procesan como un único conjunto de datos continuo; las transacciones de las páginas 1, 2, 3 y 4 llegan a la misma tabla de salida, en orden. Si tienes estados de cuenta de varias tarjetas (una Amex de empresa y una Visa personal, por ejemplo), súbelos juntos como un lote y obtén una sola hoja de cálculo fusionada.
Paso 2: Define tus columnas. En lugar de configurar zonas de extracción o entrenar un modelo, escribes los nombres de las columnas que quieres extraer. Para un libro de transacciones completo, las columnas típicas incluyen:
También puedes incluir campos a nivel de estado de cuenta — Statement Period Start, Statement Period End, Payment Due Date, Minimum Payment Due — que la IA extrae una vez del encabezado del estado de cuenta y repite en cada fila de transacción como referencia. Esto es útil cuando procesas varios meses a la vez y necesitas que cada fila esté etiquetada con su periodo de facturación.
Los archivos se procesan de forma segura y no se almacenan.
Paso 3: Exporta a Excel. Cuando la IA termina la extracción — normalmente de 5 a 10 segundos por página — descargas un archivo Excel (XLSX) estructurado. Cada columna que definiste se convierte en una columna de la hoja de cálculo. Cada transacción se convierte en una fila. Los datos ya están estandarizados: fechas en formato consistente, importes como números limpios (sin símbolos de moneda incrustados en la celda), nombres de comercios limpios de códigos internos del banco. La exportación a CSV y JSON también está disponible si los importas a un software de contabilidad que prefiera esos formatos. Para profundizar en todas las capacidades de extracción — incluido el manejo de divisas, el análisis multizona entre distintos formatos de emisor y el procesamiento por lotes de varios meses — consulta la página de conversión de estados de cuenta de tarjeta de crédito a Excel. Si prefieres que las filas lleguen directamente a Google Sheets sin el paso de descargar e importar, nuestro artículo sobre extraer estados de cuenta de tarjeta de crédito a Google Sheets cubre el flujo de trabajo del complemento de barra lateral para los mismos estados de cuenta.
Categoriza transacciones automáticamente con columnas inferidas
Extraer datos de transacciones de un PDF resuelve el problema de la extracción. Pero para la conciliación y la preparación de impuestos, la extracción es solo el primer paso. Cada transacción todavía necesita una categoría: ¿esa compra de Amazon es material de oficina, equipo o un gasto personal? Ese paso de clasificación es donde se va la mayor parte del tiempo de conciliación manual.
Aquí es donde entran las columnas inferidas. A diferencia de una columna normal que extrae datos impresos explícitamente en el documento, una columna inferida le pide a la IA que determine algo que el documento no indica directamente, analizando lo que sí dice. Tú defines una columna llamada Category (options: Office Supplies/Equipment/Travel/Meals/Software/Utilities/Other) y, para cada fila de transacción, la IA lee el nombre del comercio y el contexto de la transacción, y luego selecciona la categoría más adecuada.
Un cargo de "Staples" por $42 se asigna a "Office Supplies". "Delta Airlines" por $389 se convierte en "Travel". "Adobe Creative Cloud" por $59.99 se convierte en "Software". La IA no está haciendo coincidencia de palabras clave: está usando la misma comprensión semántica que le permite interpretar el diseño del estado de cuenta. Sabe que "Staples" es un minorista de material de oficina, que "Delta" es una aerolínea y que un cargo de $3.50 de "Blue Bottle Coffee" es una comida, no equipo.
Lo que hace que esto sea potente para la conciliación de tarjetas de crédito es que la extracción y la categorización ocurren en la misma pasada. No extraes transacciones a Excel y luego dedicas otra hora a añadir una columna de categoría manualmente. La IA llena ambas columnas simultáneamente. Y como las columnas inferidas funcionan en cargas por lotes — estados de cuenta de varias tarjetas o varios meses procesados juntos — obtienes una sola hoja de cálculo donde cada transacción, de cualquier fuente, ya está categorizada.
Estado de cuenta de tarjeta de crédito vs. Estado de cuenta bancario: diferencias en la extracción
Es fácil suponer que un estado de cuenta de tarjeta de crédito y un estado de cuenta bancario son el mismo problema de extracción — ambos contienen tablas de transacciones con fechas, descripciones y montos. En la práctica, presentan desafíos diferentes, y una herramienta optimizada para uno a menudo falla con el otro.
| Característica | Estado de cuenta de tarjeta de crédito | Estado de cuenta bancario |
|---|---|---|
| Zonas de transacciones | Múltiples zonas por página (Purchases, Payments, Fees, Interest) — cada una con diseños de columnas diferentes | Normalmente una tabla de transacciones por página con columnas consistentes en todo el documento |
| Tratamiento de Debit/Credit | Mixto: una sola columna de Amount con signos, o columnas separadas de Debit/Credit, o convenciones según la zona | Generalmente columnas separadas de Debit y Credit, o una convención consistente de una sola columna |
| Subtotales y filas de resumen | Frecuentes: subtotales por zona, totales por página, totales de resumen del estado de cuenta — alto riesgo de filas de transacción falsas | La columna de saldo corriente actúa como validación integrada; los subtotales son menos comunes |
| Nombres de comercios | Inconsistentes: el mismo comercio aparece como «AMZN», «Amazon.com», «AMAZON MKTPLACE» según el emisor | Más estandarizados: los nombres de beneficiarios siguen el formato interno del banco de forma consistente |
| Metadatos del estado de cuenta | Fecha de pago, pago mínimo, límite de crédito, detalles de APR — relevantes para la planificación financiera | Saldo de la cuenta, intereses ganados, información de sobregiro — un conjunto de metadatos diferente |
Para la extracción de estados de cuenta bancarios específicamente — que enfrenta su propio conjunto de desafíos en torno a la validación del saldo corriente y el análisis de números de cheque — extracción de estados de cuenta bancarios para pequeñas empresas cubre el flujo de trabajo en detalle. La idea clave para los estados de cuenta de tarjeta de crédito es que el reconocimiento de zonas no es negociable. Cualquier herramienta que trate la página completa como una sola tabla plana mezclará compras, pagos y cargos en una lista única e inutilizable. La extracción semántica resuelve esto reconociendo el texto del encabezado — «Purchases», «Payments and Credits», «Interest Charged» — y aplicando reglas de análisis diferentes por zona, de la misma manera que tus ojos lo hacen al leer el estado de cuenta.
De la Conciliación Mensual a la Preparación de Impuestos de Fin de Año
La razón para automatizar la extracción de estados de cuenta de tarjetas de crédito no es solo ahorrar una hora este mes. Se trata de lo que sucede cuando multiplicas esa hora a lo largo de meses, tarjetas y las exigencias de fin de año.
El flujo de trabajo típico de contabilidad para una pequeña empresa implica tres ciclos de conciliación: mensual (coincidir las transacciones del estado de cuenta de la tarjeta de crédito con recibos y asientos del General Ledger (GL)), trimestral (compilar gastos categorizados para pagos de impuestos estimados) y anual (agregar los datos de transacciones de todo el año para la revisión del CPA y la declaración de impuestos). En cada nivel, la calidad de los datos subyacentes de las transacciones determina cuánto trabajo crea el siguiente nivel. Datos desordenados en la etapa mensual significan un CPA que cobra $200+/hora para desenredarlos a fin de año.
La conciliación mensual es donde la extracción automatizada tiene el impacto más inmediato. En lugar de abrir el PDF del estado de cuenta junto a Excel y escribir cada fila, subes el estado de cuenta, defines tus columnas una vez y obtienes una hoja de cálculo limpia en segundos. Si procesas tres tarjetas al mes, eso es un ahorro de tiempo recurrente que se acumula.
Para los cálculos de impuestos estimados trimestrales, los datos de transacciones categorizados son esenciales. El IRS requiere una base razonable para las deducciones de gastos según la Publication 535 (Gastos de Negocio) — lo que significa que necesitas saber no solo en qué gastaste, sino en qué categoría cae cada gasto. Con la columna inferida manejando la categorización en el momento de la extracción, tu resumen de gastos trimestral ya está organizado: total en viajes, total en suministros de oficina, total en suscripciones de software, cada uno como una línea en una hoja de cálculo lista para tablas dinámicas.
A fin de año, la diferencia es más marcada. La mayoría de las pequeñas empresas pagan entre $500 y $1,000 al mes por contabilidad subcontratada — y la contabilidad de puesta al día o limpieza para registros desorganizados puede costar de $800 a $2,500 por 6–12 meses de atraso. Si los datos de transacciones limpios y categorizados de cada mes ya están exportados y organizados, el trabajo del contador pasa de entrada de datos a revisión y análisis — un servicio más rápido y económico. Para la temporada de impuestos específicamente, la cobertura de artículos relacionados sobre por qué la entrada manual de datos fiscales crea un problema de automatización y organizar los datos de la temporada de impuestos aplica la misma lógica a los formularios W-2 y 1099 — el mismo principio de extracción estructurada inicial que reduce el retrabajo posterior se aplica a todos los tipos de documentos.
Preguntas frecuentes
¿Puede la IA manejar estados de cuenta de tarjetas de crédito de cualquier emisor — Chase, Amex, Capital One, cooperativas de crédito locales?
Sí. Como la extracción semántica lee el diseño por significado en lugar de por coincidencia de coordenadas, funciona con todos los emisores sin necesidad de configuración por banco. Un estado de cuenta de Chase con columnas separadas de Debit y Credit, uno de Amex con una sola columna de Amount y un PDF escaneado de una cooperativa de crédito se procesan con las mismas definiciones de columnas que tú proporcionas. La IA se adapta a cada diseño en lugar de exigirte crear una plantilla para cada uno.
¿Qué pasa si mi estado de cuenta es una imagen escaneada, no un PDF digital?
El Vision Large Model procesa documentos escaneados y fotos de la misma manera que procesa PDF digitales: comprendiendo visualmente el diseño de la página. A diferencia del OCR tradicional, que se degrada significativamente con escaneos, la extracción basada en VLM mantiene una alta precisión en entradas basadas en imágenes porque no depende de un texto limpio. Una foto de un estado de cuenta en papel, un PDF escaneado de una cooperativa de crédito y un PDF digital de Chase pasan por el mismo proceso. Dicho esto, los escaneos de muy baja calidad (muy inclinados, muy oscuros o de baja resolución) reducirán la precisión — colocar el estado de cuenta plano con iluminación uniforme produce los mejores resultados.
¿La IA distingue automáticamente entre compras, pagos, reembolsos y comisiones?
Sí — pero es importante ser precisos sobre cómo. La IA no tiene un "detector de tipos" mágico. Lo que hace es reconocer la zona semántica a la que pertenece cada transacción (Purchases, Payments & Credits, Fees & Interest) según los encabezados de sección del estado de cuenta, y clasificar en consecuencia. Como la IA lee el diseño como lo haría una persona — entendiendo que "Payments and Credits" es una sección distinta — la clasificación se basa en el contexto estructural, no en suposiciones. Por eso la extracción por zonas es importante: una herramienta que no distingue zonas no puede clasificar tipos de transacción de forma fiable.
¿Puedo procesar estados de cuenta de varios meses o varias tarjetas a la vez?
Sí. Puedes subir varios archivos PDF — estados de cuenta de diferentes meses, diferentes tarjetas, o ambos — en un solo lote. La IA procesa cada archivo de forma independiente y combina todas las transacciones extraídas en una sola hoja de cálculo de salida. Cada fila conserva la información del archivo de origen para que puedas rastrear cualquier transacción hasta su estado de cuenta. Esto es especialmente útil para la consolidación de fin de año: sube 12 estados de cuenta mensuales de dos tarjetas (24 archivos), define tus columnas una vez y descarga una hoja de cálculo con todas las transacciones del año completo, ya estructuradas y categorizadas.
¿Qué pasa con las transacciones en moneda extranjera en mi estado de cuenta?
Muchos estados de cuenta de tarjetas de crédito incluyen tanto el monto en moneda extranjera como el monto convertido en USD para transacciones internacionales. Puedes definir columnas para ambos: "Foreign Currency Amount" y "USD Amount" como objetivos de extracción separados. La IA lee ambos valores de la fila del estado de cuenta — según la convención de columnas que use tu emisor — y completa ambos campos. Si tu estado de cuenta no muestra el monto en la moneda original (algunos emisores solo muestran la cifra convertida en USD), solo se extraen los datos disponibles.
¿Es esto lo mismo que importar feeds bancarios en QuickBooks o Xero?
No — tiene un propósito diferente. Los feeds bancarios importan automáticamente transacciones de tus cuentas conectadas al software de contabilidad casi en tiempo real, lo cual es útil para la contabilidad continua. Pero los feeds bancarios requieren conectividad de cuenta (no todas las instituciones la admiten), pueden omitir transacciones antiguas fuera del período del feed y no manejan estados de cuenta escaneados o en papel. La extracción de estados de cuenta trabaja sobre el PDF en sí — no necesita acceso a la cuenta, funciona con estados históricos de años anteriores, y puede procesar estados escaneados o fotografiados. Los dos enfoques son complementarios, no competitivos: la extracción maneja lo que los feeds no pueden alcanzar.
La hora que ahorras en entrada de datos este mes es la hora que tu CPA no te factura el próximo marzo.
No se requiere registro · Procesa tu primer estado gratis