PDFからWordへの変換でフォーマットが崩れる問題は、
ほとんどのユーザーが思っている以上に深刻です
PDFからWordへの変換では、皆さんが考えているような形でフォーマットが「失われる」わけではありません。問題は変換中にツールがエラーを起こすことではなく、Microsoft Wordが理解するようなフォーマット(段落スタイル、テーブル構造、見出し階層など)が、そもそもPDFには存在しないことです。画面上では構造化されたドキュメントに見えても、その表面の下には、個々の文字がページ上の正確なx,y座標に配置された、平坦な散布図があるにすぎません。これがなぜ重要か、そしてなぜ従来の変換ツールが必ずレイアウトを壊すのかを説明するのが、この記事の目的です。
重要なポイント
- これは変換エラーではなく、個々の文字の散布図からドキュメントを再構築しようとするソフトウェアの動作を目撃しているのです。
- 変換するテーブルごとに、5段階の推測の連鎖が発生します(グリッドの検出、列数のカウント、セルの割り当て、ヘッダーの結合、行の並べ替え)。最初のステップで1つの推測を誤ると、その後のすべてに悪影響が及びます。
- Vision AIはページ全体を視覚的なシーンとして読み取り(見出し、テーブル、段落)、編集時にリフローするネイティブなWord構造を出力します。要素を固定するのではなく、柔軟に再配置できます。
PDFはあなたが思うようなデータを保存していない
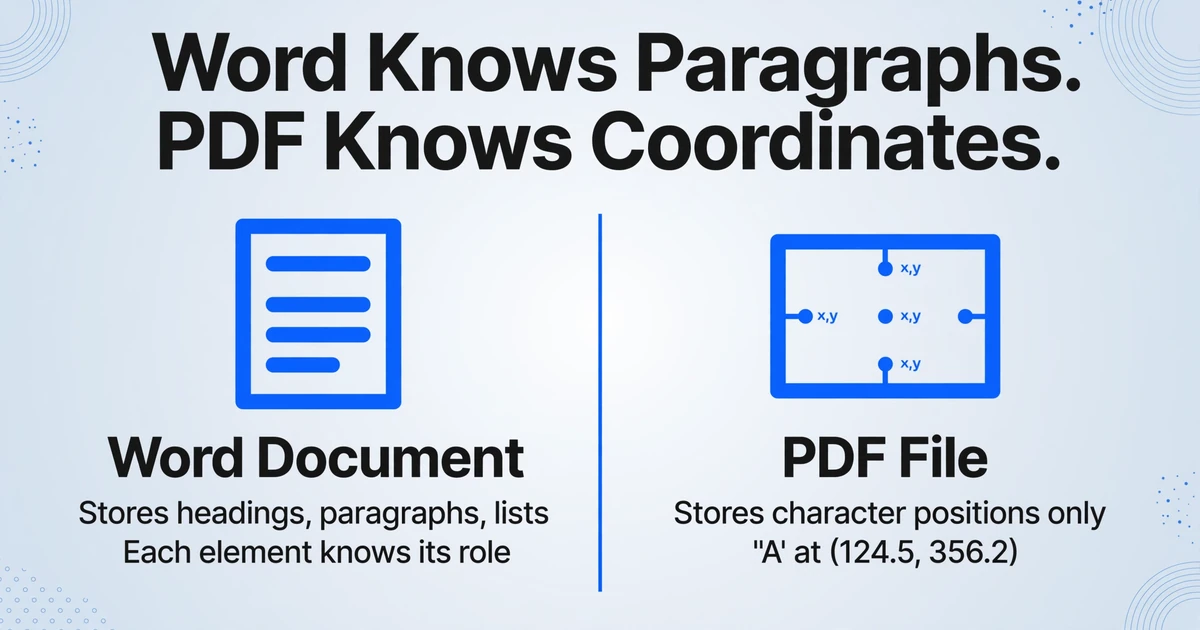
Microsoft Wordは文書を意味要素の階層として保存します。見出し、その後の段落、その後の番号付きリスト、その後の3列のテーブル、というようにです。各要素は独自の書式ルールと周囲の要素との関係を持ちます。段落に文章を追加すると、Wordは段落が何であるかを理解しているため、ページレイアウトをゼロから再計算します。
PDFにはそのような情報は一切保存されません。
PDF仕様書 — ISO 32000-1:2008、この形式を定義する国際標準 — は、ページを一連の描画命令として記述します。PDFのテキスト要素は「段落3、文2」ではありません。それは「Helvetica 10ptで座標(124.5, 356.2)に文字'A'を描画し、続いて(131.8, 356.2)に文字'c'を、続いて(137.2, 356.2)に'c'を...」というものです。各文字はページ上で独立して配置されます。PDFには、どの文字がどの単語に属するか、どの単語がどの行を構成するか、どの行が段落を形成するか、どの段落が見出しかという情報は一切保存されません。
広く引用されているPDF技術入門書はこれを率直に述べています。「PDFは段落、書式、ヘッダー、フッター、インデント、分割された単語(改行)を認識しません。テキストは単一文字ほど小さな断片に分割されますが、1行を超えることはありません。」
論理構造(見出しレベル、段落境界、テーブルセマンティクス)をPDFファイルに埋め込むことができるオプションの拡張機能、Tagged PDF(ISO 32000の条項14.8で定義)が存在します。しかし、Tagged PDFは主にアクセシビリティ機能であり、流通しているPDFの大部分はこれを使用して作成されていません。Adobe自身のサポートフォーラムでも、変換品質は「PDFの構造ツリーがどの程度適切に形成されているか」に依存すると専門家が説明しており、ほとんどのPDFには構造ツリーが存在しないことを示唆しています。
これは、ほとんどのPDFからWordへの変換ツールベンダーが教えてくれない最初の事実です:画面に表示されている文書構造はファイル内に存在しません。すべての変換ツールは、散在する個々の文字の(x,y)座標のみを使用して、ゼロからそれを再構築する必要があります。そして、その再構築は3段階の推測の連鎖であり、各段階で前の段階のエラーが累積されます。
すべての変換を壊す3つのエラーチェーン
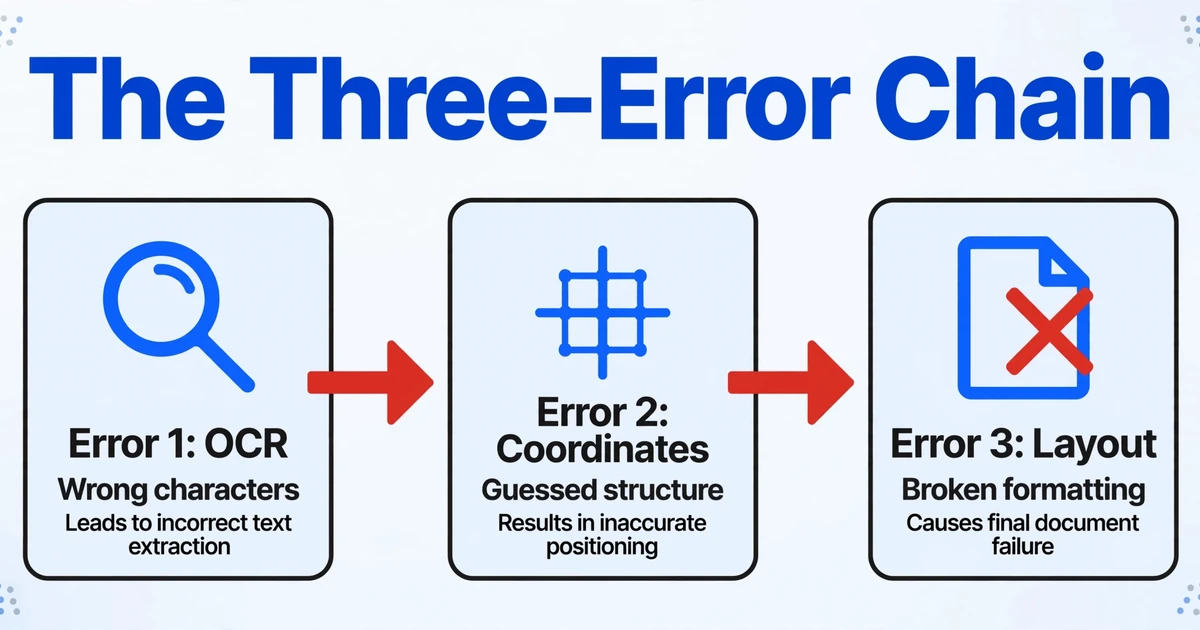
PDFを編集可能なWord文書に変換するには、3つの連続した再構築ステップが必要です。各ステップで、ソフトウェアは不完全な情報に基づいて判断を下します。誤った判断は次のステップに連鎖し、元の文書から徐々に乖離した出力を生み出します。
エラー1: 文字レベルのOCR — 誤った文字の取得
スキャンまたは画像ベースのPDF(テキストが選択可能な文字ではなくピクセルとして存在する場合)では、最初のステップは光学文字認識(OCR)です。これは、ページ画像の各微小領域を調べ、そこに含まれる文字を識別しようとするソフトウェアです。OCRは一度に1文字ずつ処理します。3,000文字のページは、3,000回の独立した認識判断を行います。
高品質のOCRエンジンでもエラーは発生します。スキャナーガラス上の小さなゴミがピリオドをカンマに変えます。コントラストの低いテキスト部分では「rn」が「m」と読み取られます。珍しいフォントでは「I」(大文字のアイ)と「l」(小文字のエル)と「1」(数字のイチ)が区別できなくなります。OCRエンジンが99%の文字精度を達成した場合(これは優れた精度と見なされます)、3,000文字のページで30文字の誤りが発生します。
しかし、文字の誤読は目に見える問題です。より深い問題は、OCRがすべての文字を正しく認識した場合でも発生します。それは、各文字のページ上の位置を記録するだけで、それ以外の情報は記録しないことです。この位置データは、次の再構築ステップに直接渡されます。
エラー2:座標の再構築 — 何が何に対応するかの推測
コンバーターが文字とその(x,y)座標のリストを取得したら、データに明確な答えがない一連の質問に答えなければなりません:
- どの文字が単語を形成するか? 物理的に近い文字はおそらく同じ単語に属します — しかし、単語間の間隔が大きく異なる均等割り付けテキストはどうでしょうか? ピリオドが前の数字よりも次の数字に近い小数はどうでしょうか?
- どの単語が行を形成するか? ほぼ同じy座標にある単語はおそらく同じ行に属します — しかし、属する行の上の行と同じy位置にある上付き脚注マーカーはどうでしょうか?
- どの行が段落を形成するか? 似た左マージンと垂直方向の近接性を持つ行はおそらく同じ段落です — しかし、他の行より短い段落の最後の行はどうでしょうか? 列1の下部が列1の次の行よりも列2の上部に物理的に近いマルチカラムレイアウトはどうでしょうか?
これらの決定はすべて、純粋に空間的な近接性に基づいて行われます。ソフトウェアはテキストの意味を理解していません。上付き脚注引用 — 例えば「14」— は空間的に近いため段落テキストに統合されます。大きなテキストのサイドバーのプルクォートは、y座標が重なるため本文に挿入されます。コンバーターは散布図からドキュメント構造を構築しています。間違いを犯さない方がむしろ驚きです。
エラー3:レイアウトの推測 — 存在しなかった構造の発明
文字が単語に、単語が行にグループ化されると、コンバーターは最も難しいタスクに直面します:ドキュメントのレイアウトが実際に何であるかを決定することです。この大きく太字のテキストは見出しですか、それとも大きなフォントの単一行段落ですか? 画像の下にあるこのテキストブロックはキャプションですか、それとも次のセクションの始まりですか? この数字のグリッドはテーブルですか、それともたまたま列に揃っているテキストですか?
ソフトウェアは推測します。パターンを探します:定期的な間隔で繰り返される行、行と列に揃うテキスト、本文テキストと異なるフォントサイズ。しかしこれらはヒューリスティックであり、確実性ではありません。十分な余白と意図的なタイポグラフィを持つよくデザインされたページは、アルゴリズムにとって曖昧なレイアウトシグナルを生成します。コンバーターは間違った推測をします。繰り返し。
これは、ほとんどの目に見えるフォーマットの破損が発生するステップです。PDFとして完璧に見えたドキュメントが、ページ全体に散らばったテキストボックスを持つWordファイルとして現れ、それぞれが絶対位置にロックされ、編集しようとするとすぐに崩れます。これは変換の失敗ではありません — コンバーターが持っている唯一の情報で設計されたとおりに正確に動作しているのです。情報が単にタスクに対して不十分なのです。
テーブル:システム全体が崩壊する箇所
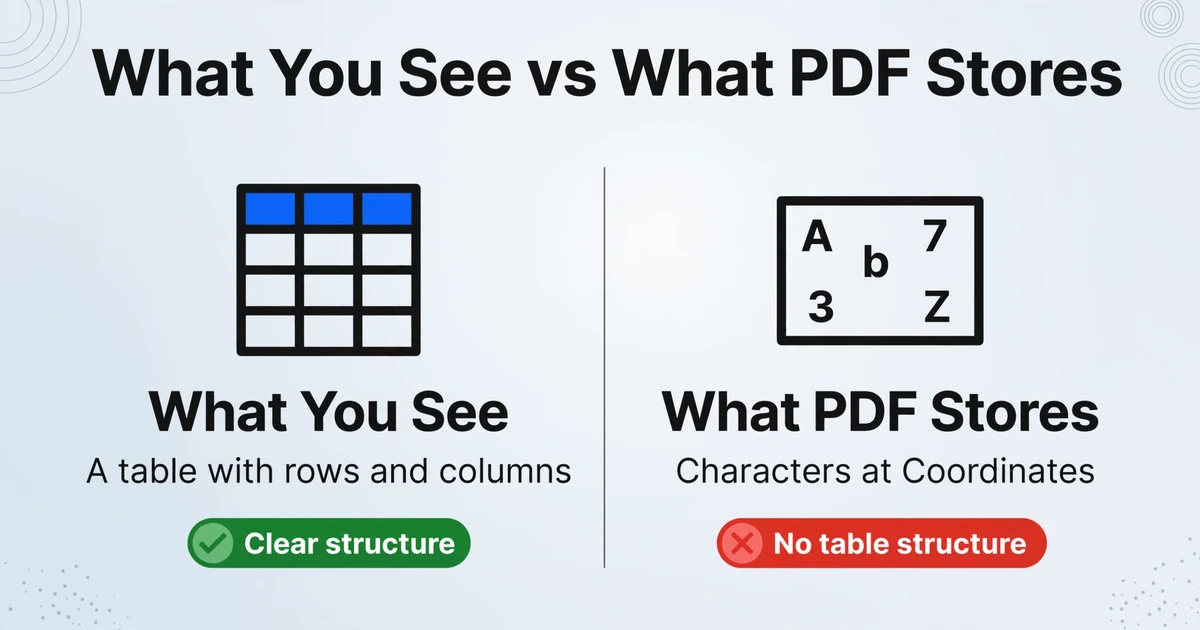
3段階のエラーチェーンがテキストレイアウトの崩壊を説明するなら、テーブルはその壊滅的な失敗モードを表します。問題は根本的なものです:PDFにはテーブルという概念が存在しません。
PDFがテーブルのように見えるもの(列ヘッダーとグリッド線を持つデータ行)を表示するとき、実際には独立した視覚要素の集合を描画しています。つまり、境界線用の水平・垂直の線分と、結果として得られるグリッドセル内に配置された個々のテキスト文字です。PDFファイルには、3行目の「Amount」列のセルと$1,247.00という値を結び付ける情報は一切含まれていません。PDFは「位置Xに'$'という文字をレンダリングし、次にX+7の位置に'1'を...」という情報と、境界線の描画命令を保存しているだけです。
つまり、変換ツールは以下を行う必要があります:
- 線分がグリッドを形成していることを検出する — 境界線が細い場合や欠落している場合は、必ずしも明らかではない
- そのグリッドに含まれる行数と列数を決定する — セルの結合や列幅のばらつきによって簡単に狂わされる
- 各文字を正しいセルに割り当てる — 1文字の位置ずれがグリッド全体に連鎖する
- 類似した内容のセルを結合すべきか推測する(2列にまたがるヘッダーなど)
- 列の読み順を決定する — 左から右?右から左?セル内で折り返し改行するのか、新しい行を開始するのか?
これは推測の上に推測を重ねる連続です。PDF解析ツールを開発する開発者たちの間でのHacker Newsの議論は、その感覚を正確に捉えています:「PDFは常に文字を順番に配置するとは限らず、個々の文字を絶対配置することもある」。ある開発者はプロセス全体を「馬鹿げている」と表現しました。
Redditでは、ユーザー体験は一貫した不満の合唱です。r/MicrosoftWordの投稿者は、PDFからDOCXへの変換結果を「奇妙なフォーマット」と表現し、あらゆる修正に抵抗しました。r/Acrobatの別のユーザーは、PDFをWordにエクスポートした後、「段落が奇妙なテキストボックスに分割され、編集しようとするとすべてがずれる」と報告しました。r/TechnologyProTipsのユーザーは、長年の集合的な経験を要約しました:「この質問を何度もされてきました。[...] フォーマットが失われるなどなど。このドキュメントをDOCに変換しようと何日も試みています」。
これらはエッジケースではありません。これらは、私たちが実行させようとしているタスクとは根本的に異なるタスクのために設計されたパイプラインの、予想される出力なのです。
「フォーマットを保持」ボタンが修正ではなくラベルである理由
どのPDFからWordへの変換ツールも「フォーマットを保持」や「ページレイアウトを維持」オプションを提供しています。Adobe Acrobatにもあります。Smallpdfにもあります。ILovePDFにもあります。その意味するところは、このチェックボックスをオンにすれば、変換後のドキュメントがオリジナルのように見えるということです。
これらのオプションが実際に何をするのかを理解することは価値があります。なぜなら、結果がなぜこれほど壊れやすいのかが明らかになるからです。Adobe Acrobatの書き出し設定で「ページレイアウトを維持」を選択すると、コンバーターはドキュメントの論理構造を魔法のように再構築するわけではありません。代わりに、すべてのテキストをWord内の絶対配置のテキストボックスに配置します—実質的にPDFの座標系をWordドキュメント内に再現しているのです。
開いたときの結果は正しく見えます。しかし、編集しようとした瞬間—単語を追加する、文を削除する、余白を調整する—レイアウト全体が崩壊します。各テキストボックスがページ上の固定位置に固定されており、周囲のコンテンツに固定されていないからです。編集可能なドキュメントを受け取ったわけではありません。テキストボックスでできたスクリーンショットを受け取ったのです。
Microsoft自身のドキュメントは、この点について異例なほど率直です。Microsoft Q&Aの公式回答にはこうあります:「PDFをWordに変換して、Wordで適切なフォーマット方法を使用させる方法はありません。それは、物事の処理方法に1対1の対応関係がないからです。」別の回答ではこう付け加えています:「異なるプログラムのファイル構造から変換されたドキュメントには、常にフォーマットの異常が含まれ、編集が非常に困難になることがよくあります。」
これはAdobeやMicrosoftがソフトウェアアップデートで修正できる制限ではありません。カテゴリレベルの制約です:ソース形式(PDF)とターゲット形式(Word)は、文書を根本的に互換性のない方法で表現しています。一方は外観を保存し、他方は構造を保存します。元の構造データなしで外観を構造に変換することは、解決できない問題です—さまざまな失敗の度合いで近似するしかありません。
当社のPDFからWordへの変換ツールの総合比較では、同じ一連のドキュメントに対して12以上のツールをテストしました。結合セルを含むテーブルでは、すべてのツールが失敗しました。マルチカラムレイアウトでも、すべてがある程度壊しました。違いはどのくらいのクリーンアップが必要かだけで、クリーンアップが必要かどうかではありませんでした。変換とデータ抽出が根本的に異なる操作である理由の詳細については、当社のドキュメント変換とデータ抽出の比較をご覧ください。
Vision AIがエラー連鎖全体を回避する仕組み
これまで説明してきたすべて — 文字レベルのOCR、空間再構築、ヒューリスティックなレイアウト推測 — は、従来のPDF変換ツールが使用するパイプラインです。これは、「個々の文字とその座標のリスト」を出発点とする場合に利用できる唯一のパイプラインです。
しかし、根本的に異なるアプローチがあります。それは、ソフトウェアが最初に注目する対象を変えることで、エラー連鎖全体を回避します。
Vision AI — 具体的には、何百万ものドキュメント画像でトレーニングされた視覚言語モデル(VLM)— は、文字ごとに読み取りません。人間と同じように、ページ全体を視覚的な単位として認識します。OCRがこれを認識するのに対し:
文字 'I' 位置 (45.2, 120.8)
文字 'n' 位置 (52.1, 120.8)
文字 'v' 位置 (57.3, 120.8)
文字 'o' 位置 (65.1, 120.8)
文字 'i' 位置 (72.9, 120.8)
文字 'c' 位置 (78.4, 120.8)
文字 'e' 位置 (85.7, 120.8)
[...さらに3000件...]
Vision AIが認識するのは:
上部中央に「請求書」というタイトルのドキュメントヘッダー。その下に2カラムレイアウト:左側にベンダー情報(会社名、住所、税ID)、右側に請求書メタデータ(請求書番号、日付、支払期限)。4つのカラム — 説明、数量、単価、金額 — を持つテーブルに6つの明細行。小計行、8.5%の税行、下部に合計$1,247.00。
その違いは決定的です。OCRは文字の位置を生成します。Vision AIはドキュメントの理解を生成します。
Vision AIは何を見ているかを理解するため、ネイティブなWord文書を生成できます — 配置されたテキストボックスの集合ではなく、実際のWord段落、実際のWord見出し、正しい行数と列数を持つ実際のWordテーブルです。出力は最初からWordで作成された文書のように動作します:段落にテキストを追加すると下のテキストが自然に流れ、テーブルの列をリサイズすると隣接する列が調整され、新しい見出しスタイルを適用するとドキュメント全体に反映されます。
これがImageToTable.aiのWordに変換モードが行うことです。従来のPDFからWordへの変換ツールとは異なり、OCR → 座標再構築 → レイアウト推測のパイプラインを一切試みません。代わりに、視覚言語モデルがページ画像全体を分析し — デジタルPDF、スキャン文書、スクリーンショット、印刷ページのスマホ写真のいずれであっても — 段落、見出し、テーブルがそのままの構造化されたWord文書を出力します。テンプレート不要、トレーニング不要、ドキュメントごとの設定も不要です。AIビジョンモデルがOCRとは異なる方法でドキュメントを処理する技術的な全体像を知りたい場合は、AIがドキュメントを読み取る仕組みのわかりやすいガイドでその仕組みを詳しく説明しています。
ファイルは安全に処理され、保存されません。
このアプローチにより、Wordに変換モードはスキャン文書とデジタルPDFを同一に扱います。どちらもビジョンモデルにとっては単なる画像です。文字認識とレイアウト理解が同時に行われるため、「まずOCR、次に変換」という別々のステップはありません。これは、モデルが文書の仕組みを理解していることに基づいています。OCR技術の進化とこの3年間の変化について詳しくは、OCR後の変化に関する分析をご覧ください。
その結果は、従来の変換ベンダーが「フォーマットを保持」ボタンで実現していると主張しながら、実際には提供できなかったものです。つまり、レイアウトをゼロから作り直すことなく、コンテンツを編集できるWord文書です。レイアウトを保持する文書変換の完全な技術的詳細(基礎となる仕組み、アプローチの比較、選択ガイドを含む)については、レイアウトを保持する文書からWordへの変換の完全ガイドをご覧ください。
よくある質問
スキャンしたPDFでも、デジタルPDFでも対応できますか?
Vision AIは両方を同じように処理します。スキャンしたPDFはページの画像であり、画面に表示されたデジタルPDFもページの画像です。ビジョンモデルは視覚的な外観を直接処理するため、スキャン文書とデジタル生成PDFの間で出力品質に違いはありません。従来の変換ツールは、レイアウト再構築とは別にOCRを先に実行する必要があるため、スキャンでは品質が大幅に低下します — 前述のエラーチェーン全体を再導入することになります。
手書き文書や注釈はどうですか?
Vision AIはフォントライブラリに対して文字の形を照合するのではなく、文脈を理解するため、OCRよりも手書きを堅牢に処理します。OCRは手書きのメモを個別に解読すべき一連の曖昧な形状として扱います。Vision AIは周囲のテキストを読み、文書の目的を理解し、その文脈を使って手書きのマークを解釈します — 人間の読者が行うのと同じ方法です。パフォーマンスは手書きの読みやすさによって異なりますが、アプローチはOCRとは根本的に異なります。
Word出力は本当に編集可能ですか?変更を加えると壊れませんか?
出力はネイティブなWordです — 配置されたテキストボックスではなく、実際の段落、見出し、テーブルです。段落にテキストを追加すると、以下のコンテンツは自然に再フローします。テーブルの列幅を調整できます。Wordスタイルを適用できます。文書はWordで作成されたかのように動作します。これがVision AI出力と従来の変換ツール出力の構造的な違いです。後者は外観を保持します(編集性を犠牲にして)、前者は構造を保持します(外観が自然に追従します)。
複数列のレポートやフォームなどの複雑なレイアウトには、Vision AIはどの程度対応できますか?
Vision AIはページを座標グリッドではなく、視覚的なシーンとして処理します。複数列レイアウト、ラベル付きフィールドのあるフォーム、チャートや画像が埋め込まれた文書 — モデルはこれらを再構築すべき空間的なアーティファクトではなく、意味的なパターンとして認識します。出力品質は文書の明瞭さと複雑さに依存しますが、このアプローチは座標再構築方法に固有の体系的な障害モード(列のインターリーブ、テキストボックスの断片化)を回避します。当社のレイアウト保持ガイドでは、エッジケースと制限事項を詳しく説明しています。