Pourquoi la perte de mise en forme lors de la conversion PDF vers Word est plus grave
que ce que la plupart des utilisateurs imaginent
La conversion PDF vers Word ne « perd » pas votre mise en forme comme vous le pensez. Le problème n'est pas qu'un outil ait commis une erreur pendant la conversion. Le problème, c'est que la mise en forme — celle que comprend Microsoft Word, avec ses styles de paragraphe, ses structures de tableau et ses hiérarchies de titres — n'a jamais existé dans le PDF. Ce qui ressemble à un document bien structuré à l'écran n'est, en réalité, qu'un nuage de points dispersés : des caractères individuels déposés sur une page à des coordonnées x,y précises. Expliquer pourquoi cela importe — et pourquoi cela garantit que tout convertisseur traditionnel cassera votre mise en page — est l'objet de cet article.
Points clés à retenir
- Vous ne subissez pas des erreurs de conversion — vous observez un logiciel tenter de reconstruire un document à partir d'un nuage de points représentant des caractères individuels.
- Chaque tableau que vous convertissez déclenche une chaîne de cinq suppositions successives — détecter la grille, compter les colonnes, assigner les cellules, fusionner les en-têtes, ordonner les lignes — et une seule supposition erronée à la première étape empoisonne tout ce qui suit.
- La Vision AI lit la page entière comme une scène visuelle — titres, tableaux, paragraphes — et produit une structure Word native qui se réorganise lorsque vous modifiez, au lieu de verrouiller chaque élément en place.
Le PDF ne stocke pas ce que vous croyez
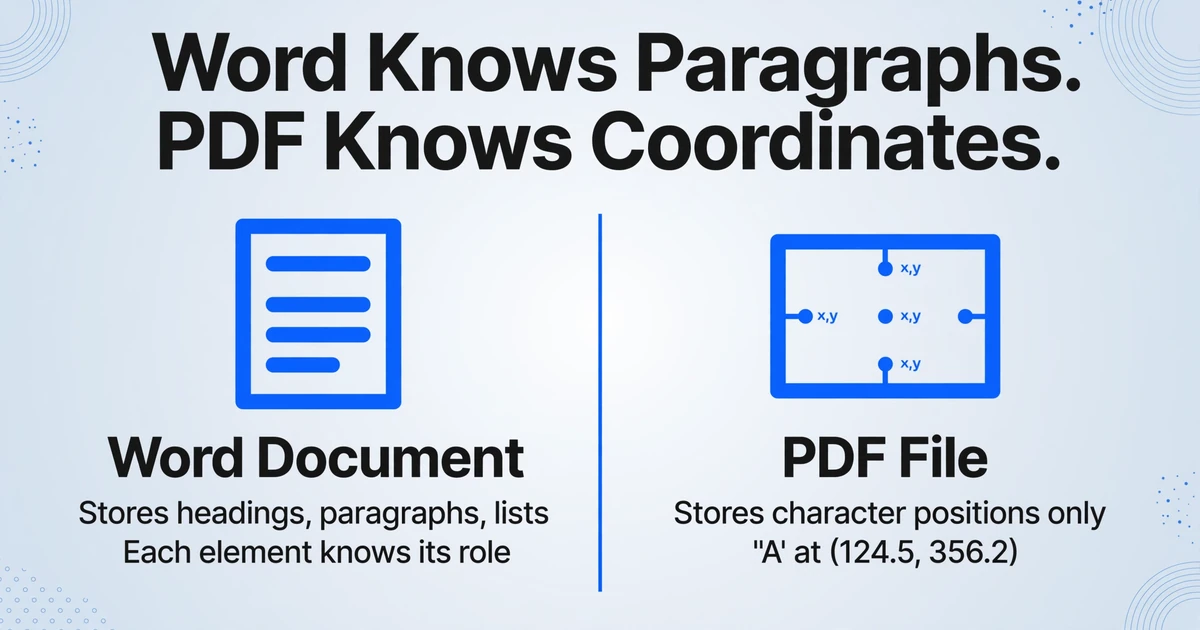
Microsoft Word stocke un document comme une hiérarchie d'éléments sémantiques : un titre, suivi d'un paragraphe, suivi d'une liste numérotée, suivi d'un tableau à trois colonnes. Chaque élément porte ses propres règles de mise en forme et ses relations avec les éléments qui l'entourent. Lorsque vous ajoutez une phrase à un paragraphe, Word recalcule la mise en page de fond en comble parce qu'il sait ce qu'est un paragraphe en soi.
Le PDF ne stocke rien de tout cela.
La spécification PDF — ISO 32000-1:2008, la norme internationale qui définit le format — décrit une page comme une séquence d'instructions de dessin. Un élément de texte dans un PDF n'est pas « paragraphe 3, phrase 2 ». C'est : « afficher le caractère 'A' aux coordonnées (124,5, 356,2) en Helvetica 10 pt, suivi du caractère 'c' à (131,8, 356,2), suivi de 'c' à (137,2, 356,2)... » Chaque caractère est positionné indépendamment sur la page. Le PDF ne stocke aucune information sur les caractères qui appartiennent à quel mot, les mots qui forment quelle ligne, les lignes qui constituent un paragraphe, ou quel paragraphe est un titre.
Un manuel technique PDF largement cité l'affirme sans détour : « Le PDF ne reconnaît pas les paragraphes, la mise en forme, les en-têtes, les pieds de page, les indentations, les mots coupés (sauts de ligne). Le texte est décomposé en fragments aussi petits que des caractères individuels, mais jamais plus d'une ligne. »
Il existe une extension facultative appelée Tagged PDF (définie dans la clause 14.8 de l'ISO 32000) qui peut intégrer une structure logique — niveaux de titres, limites de paragraphes, sémantique des tableaux — dans un fichier PDF. Mais le Tagged PDF est avant tout une fonctionnalité d'accessibilité, et la grande majorité des PDF en circulation n'ont pas été créés avec. Même le forum d'assistance d'Adobe compte des experts expliquant que la qualité de conversion dépend de « la qualité de l'arbre de structure du PDF » — sous-entendant que la plupart des PDF n'en possèdent pas.
C'est la première chose que la plupart des fournisseurs de conversion PDF vers Word ne vous diront pas : la structure de document que vous voyez à l'écran n'existe pas dans le fichier. Chaque outil de conversion doit la reconstruire de zéro, en utilisant uniquement les coordonnées (x,y) dispersées des caractères individuels. Et cette reconstruction est une chaîne de trois étapes de suppositions éclairées — chaque étape amplifiant les erreurs de la précédente.
La chaîne de trois erreurs qui brise chaque conversion
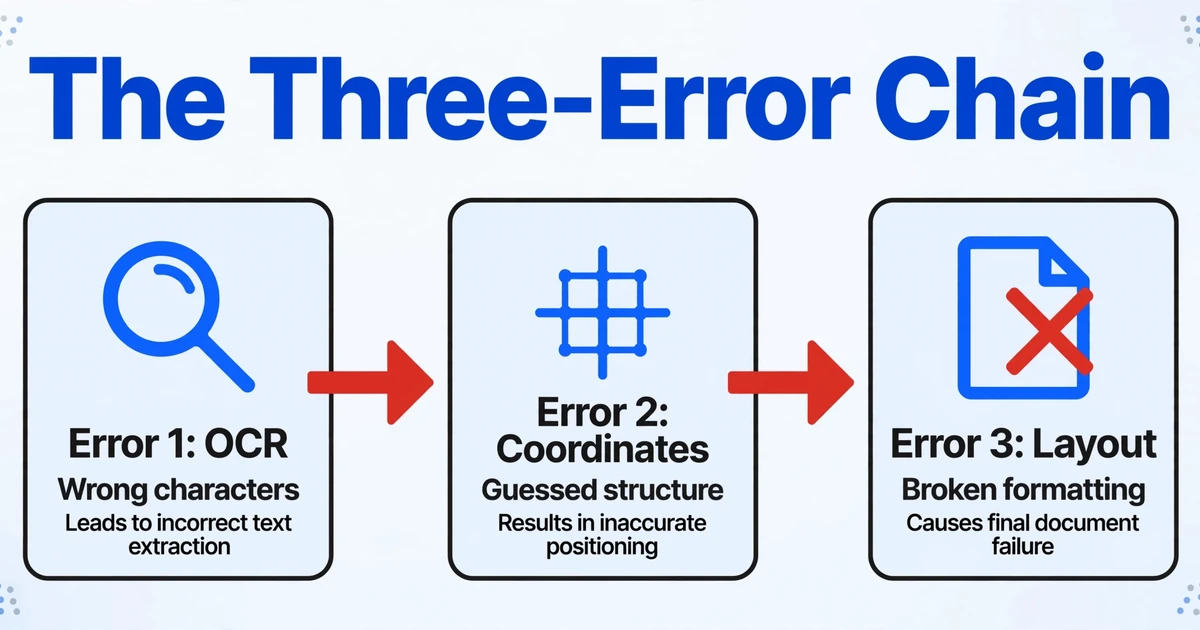
Convertir un PDF en document Word modifiable implique trois étapes de reconstruction séquentielles. À chaque étape, le logiciel prend des décisions sur la base d'informations incomplètes. Chaque décision erronée se répercute sur l'étape suivante, produisant un résultat qui s'éloigne progressivement de l'original.
Erreur 1 : OCR au niveau des caractères — obtenir les mauvais caractères
Pour les PDF numérisés ou basés sur des images (où le texte existe sous forme de pixels, pas de caractères sélectionnables), la première étape est la reconnaissance optique de caractères (OCR) — un logiciel qui examine chaque petite région de l'image de la page et tente d'identifier le caractère qu'elle contient. L'OCR fonctionne un caractère à la fois. Une page de 3 000 caractères implique 3 000 décisions de reconnaissance indépendantes.
Même les moteurs OCR de haute qualité commettent des erreurs. Une particule de poussière sur la vitre du scanner transforme un point en virgule. Une section de texte à faible contraste fait lire « rn » comme « m ». Une police inhabituelle rend « I » (i majuscule), « l » (L minuscule) et « 1 » (chiffre un) indistinguables. Si le moteur OCR atteint une précision de 99 % par caractère — ce qui est considéré comme excellent — il produit tout de même 30 caractères incorrects sur une page de 3 000 caractères.
Mais les erreurs de lecture des caractères sont le problème visible. Le problème plus profond survient même lorsque l'OCR reconnaît chaque caractère correctement : il enregistre la position de chaque caractère sur la page, et rien d'autre. Ces données de position alimentent directement l'étape de reconstruction suivante.
Erreur 2 : Reconstruction des coordonnées — deviner ce qui va avec quoi
Une fois que le convertisseur dispose d'une liste de caractères et de leurs coordonnées (x,y), il doit répondre à une série de questions sans réponse définitive dans les données :
- Quels caractères forment un mot ? Les caractères physiquement proches les uns des autres appartiennent probablement au même mot — mais qu'en est-il du texte justifié, où l'espacement entre les mots varie considérablement ? Qu'en est-il d'un nombre décimal où le point est plus proche du chiffre suivant que du précédent ?
- Quels mots forment une ligne ? Les mots situés approximativement à la même coordonnée y appartiennent probablement à la même ligne — mais qu'en est-il d'un appel de note en exposant qui se trouve à la même position y que la ligne au-dessus de celle à laquelle il appartient ?
- Quelles lignes forment un paragraphe ? Les lignes ayant des marges gauches similaires et une proximité verticale appartiennent probablement au même paragraphe — mais qu'en est-il de la dernière ligne d'un paragraphe plus courte que les autres ? Qu'en est-il d'une mise en page multi-colonnes où le bas de la colonne 1 est physiquement plus proche du haut de la colonne 2 que de la ligne suivante de la colonne 1 ?
Chacune de ces décisions repose uniquement sur la proximité spatiale. Le logiciel n'a aucune compréhension du sens du texte. Un appel de note en exposant — disons « 14 » — est fusionné dans le texte du paragraphe parce qu'il est spatialement proche. Une citation latérale avec un grand texte est intercalée dans le corps du texte parce que ses coordonnées y se chevauchent. Le convertisseur construit une structure de document à partir d'un nuage de points. Il serait étonnant qu'il ne fasse pas d'erreurs.
Erreur 3 : Deviner la mise en page — inventer une structure qui n'a jamais existé
Une fois les caractères regroupés en mots et les mots en lignes, le convertisseur est confronté à sa tâche la plus difficile : déterminer ce qu'est réellement la mise en page du document. Ce texte gros et gras est-il un titre, ou simplement un paragraphe d'une seule ligne dans une grande police ? Ce bloc de texte sous une image est-il une légende, ou le début de la section suivante ? Cette grille de nombres est-elle un tableau, ou simplement du texte qui s'aligne en colonnes par hasard ?
Le logiciel devine. Il recherche des motifs : des lignes qui se répètent à intervalles réguliers, du texte aligné en rangées et en colonnes, des tailles de police différentes de celles du corps du texte. Mais ce sont des heuristiques, pas des certitudes. Une page bien conçue avec un espace blanc généreux et une typographie intentionnelle produit des signaux de mise en page ambigus pour un algorithme. Le convertisseur se trompe. À plusieurs reprises.
C'est à cette étape que surviennent la plupart des ruptures de mise en forme visibles. Un document qui semblait impeccable en PDF ressort en fichier Word avec des zones de texte dispersées sur la page, chacune verrouillée à une position absolue qui s'effondre dès que vous tentez de la modifier. Ce n'est pas un échec de conversion — c'est le convertisseur qui fait exactement ce pour quoi il a été conçu avec les seules informations dont il dispose. Ces informations sont tout simplement insuffisantes pour la tâche.
Tableaux : là où tout le système s'effondre
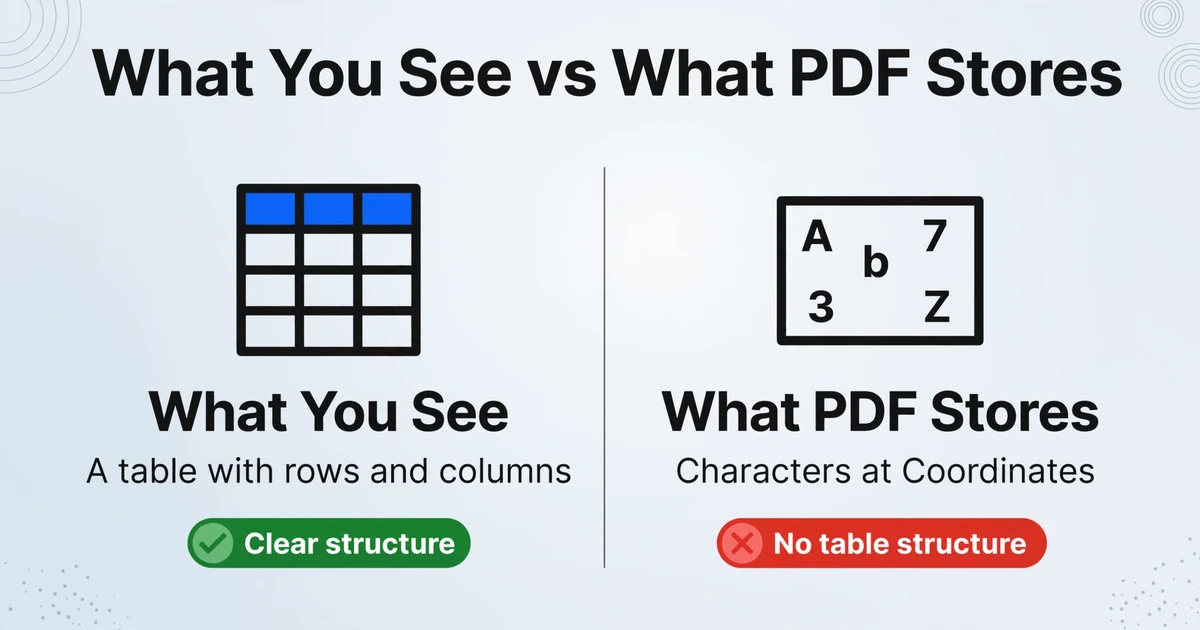
Si la chaîne d'erreurs en trois étapes explique pourquoi la mise en page du texte se brise, les tableaux en représentent le mode de défaillance catastrophique. Le problème est fondamental : le PDF n'a aucun concept de tableau.
Lorsqu'un PDF affiche ce qui ressemble à un tableau — des rangées de données avec des en-têtes de colonnes et des lignes de grille — il dessine en réalité une collection d'éléments visuels indépendants : des segments de ligne horizontaux et verticaux pour les bordures, et des caractères de texte individuels positionnés à l'intérieur des cellules de la grille résultante. Le fichier PDF ne contient aucune information reliant la cellule à la rangée 3, colonne « Montant », à la valeur $1 247,00. Il stocke uniquement « afficher le caractère '$' à la position X, puis '1' à la position X+7, puis... », ainsi que des instructions de tracé de lignes pour les bordures.
Cela signifie qu'un convertisseur doit :
- Détecter que les segments de ligne forment une grille — ce qui n'est pas toujours évident lorsque les bordures sont fines ou absentes
- Déterminer combien de rangées et de colonnes cette grille contient — facilement perturbé par les cellules fusionnées ou les largeurs de colonnes variables
- Assigner chaque caractère à la bonne cellule — où un seul caractère mal aligné fait basculer toute la grille
- Deviner si les cellules au contenu similaire doivent être fusionnées (comme un en-tête s'étendant sur deux colonnes)
- Décider de l'ordre de lecture des colonnes — de gauche à droite ? de droite à gauche ? Un retour à la ligne se produit-il dans une cellule ou commence-t-il une nouvelle rangée ?
C'est une séquence de suppositions construites sur des suppositions. Une discussion sur Hacker News parmi des développeurs qui créent des outils d'analyse PDF a parfaitement capturé le sentiment : « Les PDF ne disposent pas toujours les caractères en séquence, parfois ils ont des caractères individuels positionnés de manière absolue à la place. » Un développeur a décrit l'ensemble du processus comme « absurde ».
Sur Reddit, l'expérience utilisateur est un chœur constant de frustration. Un utilisateur sur r/MicrosoftWord a décrit un résultat de conversion PDF vers DOCX comme « mise en forme étrange » qui résistait à toute correction. Un autre sur r/Acrobat a rapporté qu'après avoir exporté un PDF vers Word, « il casse les paragraphes en d'étranges zones de texte, et tout se déplace » dès qu'une modification est tentée. Un utilisateur sur r/TechnologyProTips a résumé des années d'expérience collective : « On me l'a demandé des millions de fois. [...] la mise en forme est perdue, bla bla bla. J'ai ce document et j'essaie depuis des jours de le convertir en doc. »
Ce ne sont pas des cas limites. C'est le résultat attendu d'un pipeline conçu pour une tâche fondamentalement différente de celle que nous lui demandons d'accomplir.
Pourquoi le bouton « Conserver la mise en forme » est une étiquette, pas une solution
Chaque convertisseur PDF vers Word propose une option « conserver la mise en forme » ou « conserver la mise en page ». Adobe Acrobat l'a. Smallpdf l'a. ILovePDF l'a. L'implication est que si vous cochez cette case, votre document converti ressemblera à l'original.
Ce que ces options font réellement mérite d'être compris, car cela révèle pourquoi les résultats semblent si fragiles. Lorsque vous sélectionnez « conserver la mise en page » dans les paramètres d'exportation d'Adobe Acrobat, le convertisseur ne reconstruit pas magiquement la structure logique du document. Au lieu de cela, il place chaque morceau de texte dans une zone de texte à positionnement absolu dans Word — recréant en réalité le système de coordonnées du PDF à l'intérieur d'un document Word.
Le résultat semble correct lorsque vous l'ouvrez. Mais dès que vous essayez de modifier — ajouter un mot, supprimer une phrase, ajuster une marge — toute la mise en page s'effondre, car chaque zone de texte est ancrée à une position fixe sur la page, et non au contenu qui l'entoure. Vous n'avez pas reçu un document modifiable. Vous avez reçu une capture d'écran faite de zones de texte.
La documentation officielle de Microsoft est inhabituellement franche à ce sujet. Une réponse officielle sur Microsoft Q&A déclare : « Il n'existe aucun moyen de convertir un PDF en Word et d'obtenir les méthodes de mise en forme appropriées dans Word. Cela est dû au fait qu'il n'y a pas de correspondance de un pour un dans la manière dont les choses sont gérées. » Une autre réponse ajoute : « Les documents convertis à partir de la structure de fichiers d'un autre programme contiendront toujours des anomalies de mise en forme et sont souvent très difficiles à modifier. »
Ce n'est pas une limitation qu'Adobe ou Microsoft peuvent corriger avec une mise à jour logicielle. C'est une restriction au niveau de la catégorie : le format source et le format cible (Word) représentent les documents de manières fondamentalement incompatibles. L'un stocke l'apparence. L'autre stocke la structure. Convertir l'apparence en structure sans les données structurelles d'origine est un problème qui ne peut pas être résolu — seulement approximé, avec des degrés variables d'échec.
Notre tour d'horizon des convertisseurs PDF vers Word a testé plus d'une douzaine d'outils sur le même ensemble de documents. Chacun d'entre eux a échoué sur les tableaux avec cellules fusionnées. Chacun d'entre eux a plus ou moins déformé les mises en page multi-colonnes. Les différences résidaient dans la quantité de nettoyage requise, et non dans le fait que le nettoyage était nécessaire. Pour une explication plus approfondie de la raison pour laquelle la conversion et l'extraction de données sont des opérations fondamentalement différentes, consultez notre comparaison entre la conversion de documents et l'extraction de données.
Comment la Vision AI contourne toute la chaîne d'erreurs
Tout ce qui a été décrit jusqu'ici — l'OCR au niveau des caractères, la reconstruction spatiale, les suppositions heuristiques de mise en page — constitue le pipeline utilisé par tous les convertisseurs PDF traditionnels. C'est le seul pipeline possible lorsque votre point de départ est « une liste de caractères individuels et leurs coordonnées ».
Mais il existe une approche fondamentalement différente, qui contourne toute la chaîne d'erreurs en changeant ce que le logiciel examine en premier lieu.
Vision AI — plus précisément, les modèles de vision-langage (VLM) entraînés sur des millions d'images de documents — ne lit pas caractère par caractère. Elle voit la page entière comme une unité visuelle, à la manière d'un humain. Là où l'OCR voit ceci :
Caractère 'I' à (45.2, 120.8)
Caractère 'n' à (52.1, 120.8)
Caractère 'v' à (57.3, 120.8)
Caractère 'o' à (65.1, 120.8)
Caractère 'i' à (72.9, 120.8)
Caractère 'c' à (78.4, 120.8)
Caractère 'e' à (85.7, 120.8)
[...3000 autres entrées...]
La Vision AI voit :
Un en-tête de document avec le titre « Facture » en haut au centre. En dessous, une mise en page sur deux colonnes : les informations du fournisseur à gauche (nom de l'entreprise, adresse, numéro de TVA), les métadonnées de la facture à droite (numéro de facture, date, date d'échéance). Un tableau à 4 colonnes — Description, Quantité, Prix unitaire, Montant — contenant 6 lignes d'articles. Une ligne de sous-total, une ligne de taxe à 8,5 %, et un total dû de 1 247,00 $ en bas.
La différence est catégorique. L'OCR produit des positions de caractères. La Vision AI produit une compréhension du document.
Parce que la Vision AI comprend ce qu'elle examine, elle peut générer un document Word natif — non pas une collection de zones de texte positionnées, mais de véritables paragraphes Word, de véritables titres Word, de véritables tableaux Word avec le bon nombre de lignes et de colonnes. Le résultat se comporte comme un document créé dans Word dès le départ : vous pouvez ajouter du texte à un paragraphe et le texte en dessous s'écoule naturellement ; vous pouvez redimensionner une colonne de tableau et les colonnes adjacentes s'ajustent ; vous pouvez appliquer un nouveau style de titre et il se propage dans tout le document.
C'est ce que fait le mode Vers Word d'ImageToTable.ai. Contrairement aux convertisseurs PDF vers Word traditionnels, il ne tente pas du tout le pipeline OCR → reconstruction des coordonnées → supposition de mise en page. Au lieu de cela, un modèle de vision-langage analyse l'image de la page entière — qu'il s'agisse d'un PDF numérique, d'un document scanné, d'une capture d'écran ou d'une photo de téléphone d'une page imprimée — et produit un document Word structuré avec paragraphes, titres et tableaux intacts. Sans modèles, sans formation, sans configuration par document. Si vous souhaitez une vue d'ensemble technique complète de la façon dont les modèles de vision IA traitent les documents différemment de l'OCR, notre guide en langage clair sur la façon dont l'IA lit les documents détaille les mécanismes en profondeur.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Cette approche signifie également que le mode Vers Word traite les documents scannés et les PDF numériques de manière identique. Les deux ne sont que des images pour un modèle de vision. Il n'existe pas d'étape distincte « OCR d'abord, puis conversion », car la reconnaissance des caractères et la compréhension de la mise en page se produisent simultanément, guidées par la compréhension qu'a le modèle du fonctionnement des documents. Pour en savoir plus sur l'évolution de la technologie OCR et ce qui a changé au cours des trois dernières années, consultez notre analyse de ce qui s'est passé après l'OCR.
Le résultat est ce que les fournisseurs de convertisseurs traditionnels prétendent que leur bouton « conserver la mise en forme » fait, mais n'ont jamais réellement livré : un document Word où vous pouvez modifier le contenu sans reconstruire la mise en page de zéro. Pour une vue technique complète de la conversion de documents avec préservation de la mise en page — y compris les mécanismes sous-jacents, la comparaison des approches et le guide de sélection — consultez notre guide complet de la conversion de documents vers Word avec préservation de la mise en page.
Questions fréquemment posées
Cela fonctionne-t-il sur les PDF scannés, ou uniquement sur les PDF numériques ?
Vision AI traite les deux de manière identique. Un PDF scanné est une image de page ; un PDF numérique rendu à l'écran est également une image de page. Le modèle de vision traite directement l'apparence visuelle, il n'y a donc aucune différence de qualité de sortie entre un document scanné et un PDF généré numériquement. Les convertisseurs traditionnels se dégradent considérablement sur les scans car ils doivent d'abord exécuter l'OCR, séparément de la reconstruction de la mise en page — réintroduisant toute la chaîne d'erreurs décrite ci-dessus.
Qu'en est-il des documents manuscrits ou des annotations ?
Parce que Vision AI comprend le contexte plutôt que de comparer des formes de caractères à une bibliothèque de polices, il gère l'écriture manuscrite plus efficacement que l'OCR. L'OCR traite une note manuscrite comme une série de formes ambiguës à décoder individuellement. Vision AI lit le texte environnant, comprend l'objectif du document et utilise ce contexte pour interpréter les marques manuscrites — de la même manière qu'un lecteur humain le ferait. Les performances varient selon la lisibilité de l'écriture, mais l'approche est fondamentalement différente de celle de l'OCR.
La sortie Word est-elle vraiment modifiable, ou se casse-t-elle lorsque j'apporte des modifications ?
La sortie est un Word natif — de véritables paragraphes, titres et tableaux, et non des zones de texte positionnées. Vous pouvez ajouter du texte à un paragraphe et le contenu en dessous se réorganise naturellement. Vous pouvez ajuster la largeur des colonnes dans un tableau. Vous pouvez appliquer des styles Word. Le document se comporte comme s'il avait été créé dans Word. C'est la différence structurelle entre la sortie de Vision AI et celle des convertisseurs traditionnels : ces derniers préservent l'apparence (au détriment de la modifiabilité), tandis que le premier préserve la structure (ce qui fait que l'apparence suit naturellement).
Comment Vision AI gère-t-il les mises en page complexes comme les rapports multi-colonnes ou les formulaires ?
Vision AI traite la page comme une scène visuelle, et non comme une grille de coordonnées. Les mises en page multi-colonnes, les formulaires avec champs étiquetés, les documents contenant des graphiques et des images intégrés — le modèle reconnaît ces éléments comme des motifs sémantiques, et non comme des artefacts spatiaux à reconstruire. La qualité de la sortie dépend de la clarté et de la complexité du document, mais l'approche évite les modes de défaillance systématiques (entrelacement de colonnes, fragmentation des zones de texte) inhérents aux méthodes de reconstruction par coordonnées. Notre guide de préservation de la mise en page couvre les cas limites et les limitations en détail.