Warum der Formatierungsverlust bei PDF-zu-Word schwerwiegender ist
als die meisten Nutzer annehmen
Die PDF-zu-Word-Konvertierung „verliert" Ihre Formatierung nicht so, wie Sie denken. Das Problem ist nicht, dass ein Tool während der Konvertierung einen Fehler gemacht hat. Das Problem ist, dass die Formatierung – die Art, die Microsoft Word versteht, mit Absatzformaten, Tabellenstrukturen und Überschriftenhierarchien – im PDF von vornherein nie vorhanden war. Was auf dem Bildschirm wie ein gut strukturiertes Dokument aussieht, ist unter der Oberfläche ein flaches Streudiagramm einzelner Zeichen, die an präzisen x,y-Koordinaten auf einer Seite platziert wurden. Zu erklären, warum das wichtig ist – und warum es garantiert, dass jeder herkömmliche Konverter Ihr Layout zerstört – ist das Thema dieses Artikels.
Wichtigste Erkenntnisse
- Sie erleben keine Konvertierungsfehler – Sie beobachten, wie Software versucht, ein Dokument aus einem Streudiagramm einzelner Zeichen zu rekonstruieren.
- Jede Tabelle, die Sie konvertieren, löst eine fünfstufige Kette von Annahmen aus – Raster erkennen, Spalten zählen, Zellen zuweisen, Kopfzeilen zusammenführen, Zeilen ordnen – und eine falsche Annahme bei Schritt eins vergiftet alles Weitere.
- Vision AI liest die gesamte Seite als visuelle Szene – Überschriften, Tabellen, Absätze – und erzeugt native Word-Struktur, die sich beim Bearbeiten neu umbricht, statt jedes Element an Ort und Stelle zu fixieren.
PDF speichert nicht, was Sie denken
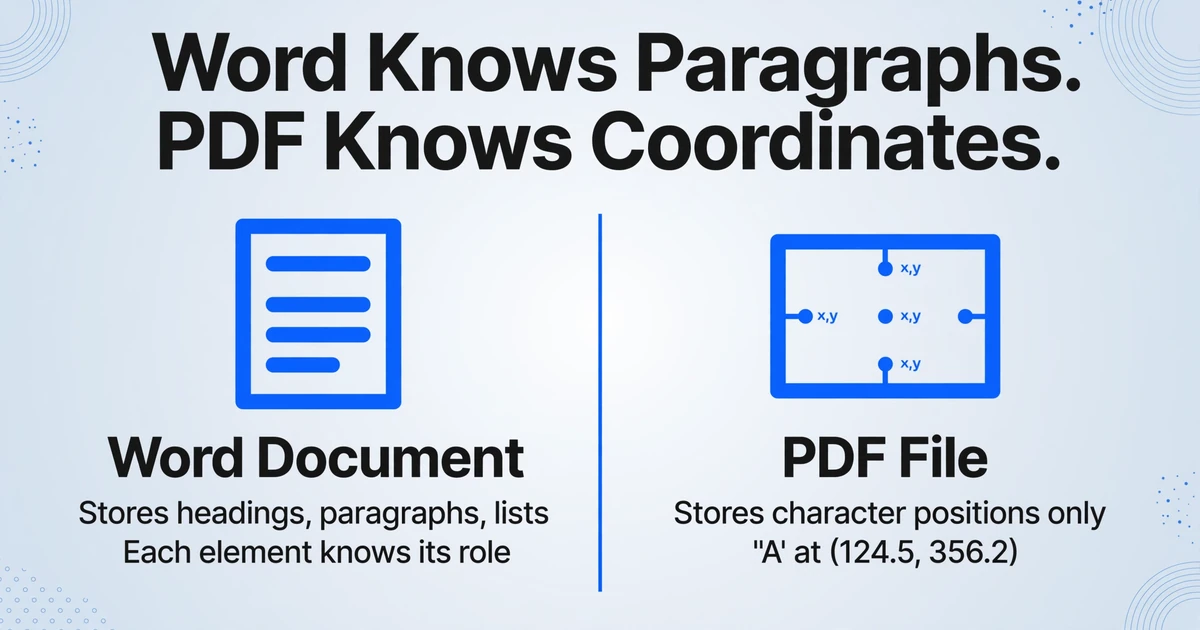
Microsoft Word speichert ein Dokument als Hierarchie semantischer Elemente: eine Überschrift, gefolgt von einem Absatz, gefolgt von einer nummerierten Liste, gefolgt von einer Tabelle mit drei Spalten. Jedes Element trägt seine eigenen Formatierungsregeln und Beziehungen zu den umgebenden Elementen. Wenn Sie einem Absatz einen Satz hinzufügen, berechnet Word das Seitenlayout von Grund auf neu, weil es weiß, was ein Absatz ist.
PDF speichert nichts davon.
Die PDF-Spezifikation — ISO 32000-1:2008, der internationale Standard, der das Format definiert — beschreibt eine Seite als eine Abfolge von Zeichenanweisungen. Ein Textelement in PDF ist nicht "Absatz 3, Satz 2." Es ist: "Rendere das Zeichen 'A' an den Koordinaten (124,5, 356,2) in Helvetica 10pt, gefolgt vom Zeichen 'c' bei (131,8, 356,2), gefolgt von 'c' bei (137,2, 356,2)..." Jedes Zeichen wird unabhängig auf der Seite positioniert. PDF speichert keine Informationen darüber, welche Zeichen zu welchem Wort gehören, welche Wörter zu welcher Zeile gehören, welche Zeilen einen Absatz bilden oder welcher Absatz eine Überschrift ist.
Ein häufig zitierter technischer PDF-Grundlagenartikel formuliert es unmissverständlich: "PDF erkennt keine Absätze, Formatierungen, Kopfzeilen, Fußzeilen, Einrückungen oder getrennte Wörter (Zeilenumbrüche). Text wird in Fragmente zerlegt, die so klein wie einzelne Zeichen, aber nicht größer als eine Zeile sein können."
Es gibt eine optionale Erweiterung namens Tagged PDF (definiert in Abschnitt 14.8 von ISO 32000), die logische Strukturen — Überschriftsebenen, Absatzgrenzen, Tabellensemantik — in eine PDF-Datei einbetten kann. Aber Tagged PDF ist in erster Linie eine Barrierefreiheitsfunktion, und die überwiegende Mehrheit der im Umlauf befindlichen PDFs wurde nicht damit erstellt. Selbst im Support-Forum von Adobe erklären Experten, dass die Konvertierungsqualität davon abhängt, "wie gut der Strukturbaum des PDFs aufgebaut ist" — mit der Implikation, dass die meisten PDFs keinen haben.
Das ist das Erste, was Ihnen die meisten Anbieter von PDF-zu-Word-Konvertierung nicht verraten: Die Dokumentstruktur, die Sie auf dem Bildschirm sehen, existiert nicht in der Datei. Jedes Konvertierungstool muss sie von Grund auf rekonstruieren, nur anhand der verstreuten (x,y)-Koordinaten einzelner Zeichen. Und diese Rekonstruktion ist eine dreistufige Kette fundierter Vermutungen — jede Stufe verstärkt die Fehler der vorherigen.
Die Drei-Fehler-Kette, die jede Konvertierung zerstört
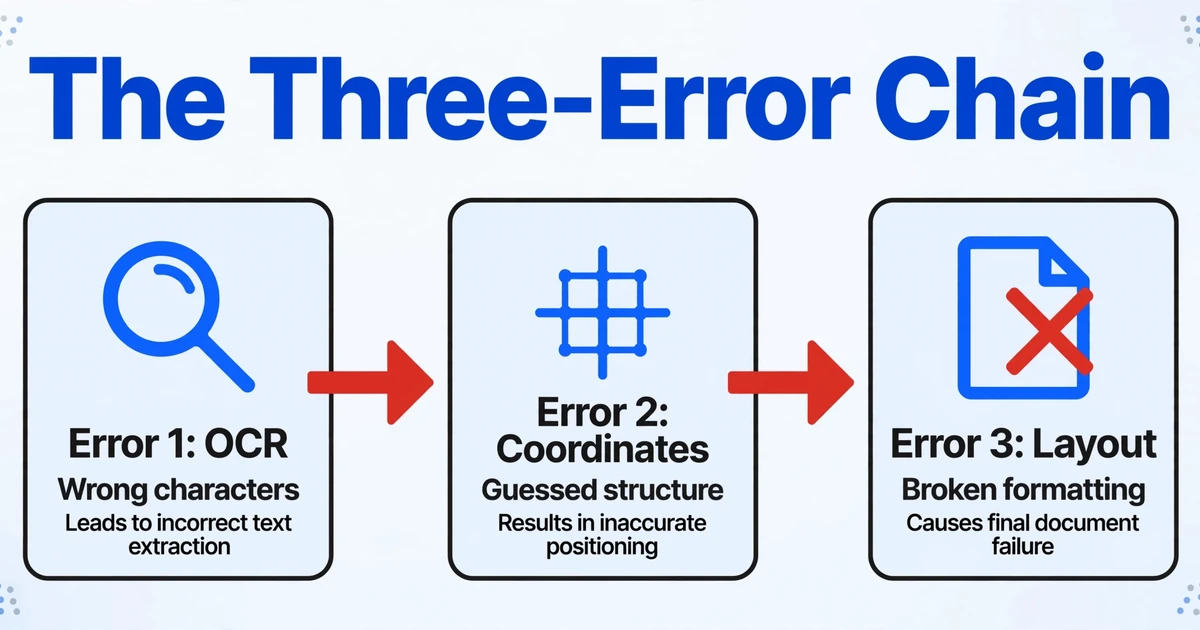
Die Konvertierung eines PDFs in ein bearbeitbares Word-Dokument umfasst drei aufeinanderfolgende Rekonstruktionsschritte. Bei jedem Schritt trifft die Software Entscheidungen auf der Grundlage unvollständiger Informationen. Jede falsche Entscheidung wirkt sich auf den nächsten Schritt aus und erzeugt ein Ergebnis, das zunehmend vom Original abweicht.
Fehler 1: Zeichenbasierte OCR — Falsche Zeichen erhalten
Bei gescannten oder bildbasierten PDFs (bei denen Text als Pixel und nicht als auswählbare Zeichen vorliegt) ist der erste Schritt die Optische Zeichenerkennung (OCR) — eine Software, die jede winzige Region des Seitenbilds untersucht und versucht zu identifizieren, welches Zeichen sie enthält. OCR arbeitet Zeichen für Zeichen. Eine Seite mit 3.000 Zeichen erfordert 3.000 unabhängige Erkennungsentscheidungen.
Selbst hochwertige OCR-Engines machen Fehler. Ein Staubkorn auf dem Scannerglas verwandelt einen Punkt in ein Komma. Ein kontrastarmer Textabschnitt führt dazu, dass 'rn' als 'm' gelesen wird. Eine ungewöhnliche Schriftart macht 'I' (großes I), 'l' (kleines L) und '1' (Ziffer Eins) ununterscheidbar. Wenn die OCR-Engine eine Genauigkeit von 99 % pro Zeichen erreicht — was als ausgezeichnet gilt — erzeugt sie dennoch 30 falsche Zeichen auf einer Seite mit 3.000 Zeichen.
Doch Fehler bei der Zeichenerkennung sind das sichtbare Problem. Das tiefere Problem entsteht selbst dann, wenn OCR jedes Zeichen korrekt erkennt: Sie zeichnet die Position jedes Zeichens auf der Seite auf und sonst nichts. Diese Positionsdaten fließen direkt in den nächsten Rekonstruktionsschritt ein.
Fehler 2: Koordinaten-Rekonstruktion — Raten, was zusammengehört
Sobald der Konverter eine Liste von Zeichen und deren (x,y)-Koordinaten hat, muss er eine Reihe von Fragen beantworten, auf die es in den Daten keine eindeutige Antwort gibt:
- Welche Zeichen bilden ein Wort? Zeichen, die physisch nahe beieinander liegen, gehören wahrscheinlich zum selben Wort — aber was ist mit Blocksatz, bei dem der Wortabstand stark variiert? Was ist mit einer Dezimalzahl, bei der der Punkt näher an der nächsten Ziffer liegt als an der vorherigen?
- Welche Wörter bilden eine Zeile? Wörter auf ungefähr derselben y-Koordinate gehören wahrscheinlich zur selben Zeile — aber was ist mit einer hochgestellten Fußnotenmarkierung, die auf derselben y-Position liegt wie die Zeile über der, zu der sie gehört?
- Welche Zeilen bilden einen Absatz? Zeilen mit ähnlichen linken Rändern und vertikaler Nähe gehören wahrscheinlich zum selben Absatz — aber was ist mit der letzten Zeile eines Absatzes, die kürzer ist als der Rest? Was ist mit einem mehrspaltigen Layout, bei dem das Ende von Spalte 1 physisch näher am Anfang von Spalte 2 liegt als an der nächsten Zeile in Spalte 1?
Jede dieser Entscheidungen wird rein auf Basis räumlicher Nähe getroffen. Die Software hat kein Verständnis dafür, was der Text bedeutet. Eine hochgestellte Fußnotenzitation — sagen wir "14" — wird in den Absatztext eingefügt, weil sie räumlich nahe liegt. Ein hervorgehobenes Zitat in der Seitenleiste mit großem Text wird in den Fließtext eingestreut, weil sich die y-Koordinaten überlappen. Der Konverter baut eine Dokumentstruktur aus einem Streudiagramm. Es wäre bemerkenswert, wenn er keine Fehler machen würde.
Fehler 3: Layout-Raten — Struktur erfinden, die nie da war
Nachdem Zeichen zu Wörtern und Wörter zu Zeilen gruppiert wurden, steht der Konverter vor seiner schwierigsten Aufgabe: zu entscheiden, was das Layout des Dokuments tatsächlich ist. Ist dieser große fette Text eine Überschrift oder nur ein einzeiliger Absatz in großer Schrift? Ist dieser Textblock unter einem Bild eine Bildunterschrift oder der Beginn des nächsten Abschnitts? Ist dieses Zahlenraster eine Tabelle oder nur Text, der zufällig in Spalten ausgerichtet ist?
Die Software rät. Sie sucht nach Mustern: Zeilen, die sich in regelmäßigen Abständen wiederholen, Text, der in Zeilen und Spalten ausgerichtet ist, Schriftgrößen, die sich vom Fließtext unterscheiden. Aber das sind Heuristiken, keine Gewissheiten. Eine gut gestaltete Seite mit großzügigem Weißraum und durchdachter Typografie erzeugt Layout-Signale, die für einen Algorithmus mehrdeutig sind. Der Konverter rät falsch. Wiederholt.
Dies ist der Schritt, bei dem die meisten sichtbaren Formatierungsfehler auftreten. Ein Dokument, das als PDF makellos aussah, erscheint als Word-Datei mit Textfeldern, die über die Seite verstreut sind, jedes an einer absoluten Position fixiert, die beim ersten Bearbeitungsversuch zerbricht. Das ist kein Konvertierungsfehler — es ist der Konverter, der genau das tut, wofür er mit den ihm vorliegenden Informationen entwickelt wurde. Die Informationen reichen für die Aufgabe schlicht nicht aus.
Tabellen: Wo das gesamte System zusammenbricht
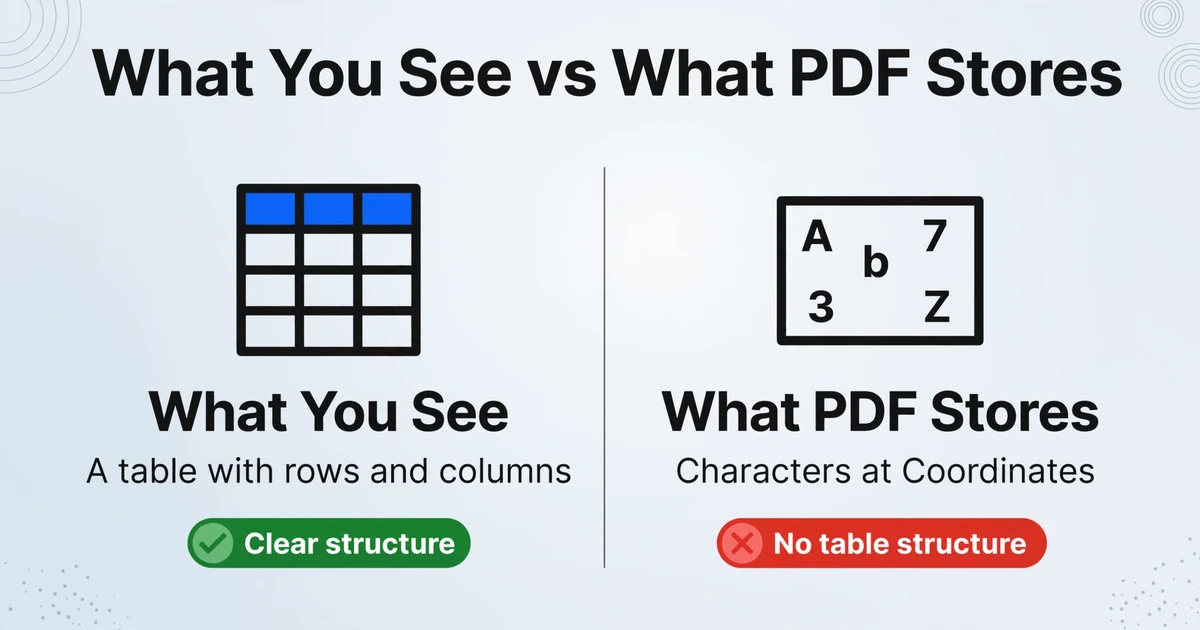
Wenn die dreistufige Fehlerkette beschreibt, warum Textlayouts brechen, stellen Tabellen deren katastrophalen Ausfallmodus dar. Das Problem ist grundlegend: PDF kennt kein Konzept einer Tabelle.
Wenn ein PDF etwas anzeigt, das wie eine Tabelle aussieht — Datenzeilen mit Spaltenüberschriften und Gitterlinien — zeichnet es tatsächlich eine Sammlung unabhängiger visueller Elemente: horizontale und vertikale Liniensegmente für Rahmen sowie einzelne Textzeichen, die innerhalb der resultierenden Gitterzellen positioniert sind. Die PDF-Datei enthält keine Informationen, die die Zelle in Zeile 3, Spalte „Betrag" mit dem Wert $1.247,00 verbinden. Sie speichert nur „Zeichne das Zeichen '$' an Position X, dann '1' an Position X+7, dann ...", zusammen mit Linienzeichnungsanweisungen für die Rahmen.
Das bedeutet, dass ein Konverter Folgendes tun muss:
- Erkennen, dass Liniensegmente ein Gitter bilden — nicht immer offensichtlich, wenn Rahmen dünn oder fehlend sind
- Bestimmen, wie viele Zeilen und Spalten dieses Gitter enthält — leicht aus dem Takt gebracht durch verbundene Zellen oder unterschiedliche Spaltenbreiten
- Jedes Zeichen der richtigen Zelle zuordnen — wobei ein einzelnes falsch ausgerichtetes Zeichen das gesamte Gitter zum Einsturz bringt
- Vermuten, ob Zellen mit ähnlichem Inhalt zusammengeführt werden sollten (wie eine Überschrift, die sich über zwei Spalten erstreckt)
- Die Lesereihenfolge der Spalten festlegen — von links nach rechts? Von rechts nach links? Bricht eine umbrechende Zeile innerhalb einer Zelle um oder beginnt eine neue Zeile?
Es ist eine Abfolge von Vermutungen, die auf Vermutungen aufbauen. Eine Hacker-News-Diskussion unter Entwicklern, die PDF-Parsing-Tools erstellen, erfasste die Stimmung präzise: „PDFs legen Zeichen nicht immer in Reihenfolge an, manchmal haben sie stattdessen absolut positionierte einzelne Zeichen." Ein Entwickler beschrieb den gesamten Prozess als „absurd".
Auf Reddit ist die Benutzererfahrung ein beständiger Chor der Frustration. Ein Poster auf r/MicrosoftWord beschrieb ein PDF-zu-DOCX-Konvertierungsergebnis als „seltsame Formatierung", die jedem Korrekturversuch widerstand. Ein anderer auf r/Acrobat berichtete, dass nach dem Export eines PDFs nach Word „Absätze in seltsame Textfelder zerlegt werden und sich alles verschiebt", sobald eine Bearbeitung versucht wird. Ein Benutzer auf r/TechnologyProTips fasste Jahre kollektiver Erfahrung zusammen: „Ich wurde das schon zigmal gefragt. [...] Formatierung ist weg, bla bla. Ich habe dieses Dokument und versuche seit Tagen, es in DOC zu konvertieren."
Das sind keine Randfälle. Sie sind das erwartete Ergebnis einer Pipeline, die für eine grundlegend andere Aufgabe entwickelt wurde als die, die wir von ihr verlangen.
Warum die Schaltfläche „Formatierung beibehalten“ ein Etikett und keine Lösung ist
Jeder PDF-zu-Word-Konverter bietet eine Option zum „Beibehalten der Formatierung“ oder „Beibehalten des Seitenlayouts“. Adobe Acrobat hat sie. Smallpdf hat sie. ILovePDF hat sie. Die Implikation ist, dass Ihr konvertiertes Dokument wie das Original aussieht, wenn Sie dieses Kontrollkästchen aktivieren.
Was diese Optionen tatsächlich bewirken, ist es wert zu verstehen, denn es zeigt, warum die Ergebnisse so fragil wirken. Wenn Sie in den Exporteinstellungen von Adobe Acrobat „Seitenlayout beibehalten“ auswählen, rekonstruiert der Konverter nicht magisch die logische Struktur des Dokuments. Stattdessen platziert er jeden Textabschnitt in einer absolut positionierten Textbox in Word — und erstellt damit effektiv das Koordinatensystem des PDFs innerhalb eines Word-Dokuments nach.
Das Ergebnis sieht beim Öffnen korrekt aus. Doch sobald Sie versuchen zu bearbeiten — ein Wort hinzufügen, einen Satz löschen, einen Rand anpassen — bricht das gesamte Layout zusammen, weil jede Textbox an einer festen Position auf der Seite verankert ist, nicht am umgebenden Inhalt. Sie haben kein bearbeitbares Dokument erhalten. Sie haben einen Screenshot aus Textboxen erhalten.
Die eigene Dokumentation von Microsoft ist in dieser Hinsicht ungewöhnlich offen. Eine offizielle Antwort auf Microsoft Q&A besagt: „Es gibt keine Möglichkeit, PDF in Word zu konvertieren und dabei die geeigneten Formatierungsmethoden in Word zu verwenden. Das liegt daran, dass es keine 1:1-Entsprechung in der Handhabung gibt.“ Eine weitere Antwort fügt hinzu: „Dokumente, die aus der Dateistruktur eines anderen Programms konvertiert wurden, enthalten immer Formatierungsanomalien und sind oft sehr schwer zu bearbeiten.“
Dies ist keine Einschränkung, die Adobe oder Microsoft mit einem Software-Update beheben können. Es ist eine Einschränkung auf Kategorieebene: Das Quellformat und das Zielformat (Word) repräsentieren Dokumente auf grundlegend inkompatible Weise. Eines speichert das Erscheinungsbild. Das andere speichert die Struktur. Die Umwandlung von Erscheinungsbild in Struktur ohne die ursprünglichen Strukturdaten ist ein Problem, das nicht gelöst werden kann — nur angenähert, mit unterschiedlichem Grad des Scheiterns.
Unser Überblick über PDF-zu-Word-Konverter hat über ein Dutzend Tools mit demselben Satz von Dokumenten getestet. Jedes einzelne scheiterte bei Tabellen mit verbundenen Zellen. Jedes einzelne verstümmelte mehrspaltige Layouts in gewissem Maße. Die Unterschiede lagen darin, wie viel Bereinigung erforderlich war, nicht ob Bereinigung erforderlich war. Für eine tiefere Erklärung, warum Konvertierung und Datenextraktion grundlegend unterschiedliche Vorgänge sind, siehe unseren Vergleich von Dokumentkonvertierung vs. Datenextraktion.
Wie Vision AI die gesamte Fehlerkette umgeht
Alles, was bisher beschrieben wurde — die zeichenweise OCR, die räumliche Rekonstruktion, das heuristische Layout-Raten — ist die Pipeline, die jeder traditionelle PDF-Konverter verwendet. Es ist die einzige verfügbare Pipeline, wenn Ihr Ausgangspunkt „eine Liste einzelner Zeichen und ihrer Koordinaten" ist.
Aber es gibt einen grundlegend anderen Ansatz, der die gesamte Fehlerkette umgeht, indem er ändert, worauf die Software zuerst blickt.
Vision AI — genauer gesagt, Vision-Language-Modelle (VLM), die mit Millionen von Dokumentbildern trainiert wurden — liest nicht Zeichen für Zeichen. Es sieht die gesamte Seite als visuelle Einheit, so wie ein Mensch es tut. Wo OCR dies sieht:
Zeichen 'I' bei (45.2, 120.8)
Zeichen 'n' bei (52.1, 120.8)
Zeichen 'v' bei (57.3, 120.8)
Zeichen 'o' bei (65.1, 120.8)
Zeichen 'i' bei (72.9, 120.8)
Zeichen 'c' bei (78.4, 120.8)
Zeichen 'e' bei (85.7, 120.8)
[...3000 weitere Einträge...]
Vision AI sieht:
Einen Dokumentkopf mit dem Titel „Rechnung" oben in der Mitte. Darunter ein zweispaltiges Layout: Lieferantendaten links (Firmenname, Adresse, Steuernummer), Rechnungsmetadaten rechts (Rechnungsnummer, Datum, Fälligkeitsdatum). Eine Tabelle mit 4 Spalten — Beschreibung, Menge, Einzelpreis, Betrag — mit 6 Positionen. Eine Zwischensummenzeile, eine Steuerzeile mit 8,5 % und eine Gesamtsumme von 1.247,00 $ unten.
Der Unterschied ist kategorial. OCR erzeugt Zeichenpositionen. Vision AI erzeugt Dokumentverständnis.
Weil Vision AI versteht, was es sieht, kann es ein natives Word-Dokument erzeugen — keine Sammlung positionierter Textfelder, sondern echte Word-Absätze, echte Word-Überschriften, echte Word-Tabellen mit der korrekten Anzahl von Zeilen und Spalten. Die Ausgabe verhält sich wie ein Dokument, das von Anfang an in Word erstellt wurde: Sie können Text zu einem Absatz hinzufügen, und der darunterliegende Text fließt natürlich nach; Sie können eine Tabellenspalte vergrößern, und die angrenzenden Spalten passen sich an; Sie können einen neuen Überschriftenstil anwenden, und er verbreitet sich im gesamten Dokument.
Das macht der Nach Word-Modus von ImageToTable.ai. Anders als traditionelle PDF-zu-Word-Konverter versucht er die Pipeline OCR → Koordinatenrekonstruktion → Layout-Raten gar nicht erst. Stattdessen analysiert ein Vision-Language-Modell das gesamte Seitenbild — ob es sich um ein digitales PDF, ein gescanntes Dokument, einen Screenshot oder ein Handyfoto einer gedruckten Seite handelt — und gibt ein strukturiertes Word-Dokument mit Absätzen, Überschriften und Tabellen aus. Keine Vorlagen, kein Training, keine dokumentbezogene Konfiguration. Wenn Sie das vollständige technische Bild davon möchten, wie KI-Vision-Modelle Dokumente anders verarbeiten als OCR, führt Sie unser verständlicher Leitfaden dazu, wie KI Dokumente liest im Detail durch die Mechanismen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Dieser Ansatz bedeutet auch, dass der Modus „Nach Word“ gescannte Dokumente und digitale PDFs identisch behandelt. Beide sind für ein Vision-Modell lediglich Bilder. Es gibt keinen separaten Schritt „zuerst OCR, dann konvertieren“, da Zeichenerkennung und Layout-Verständnis gleichzeitig erfolgen, gestützt auf das Verständnis des Modells davon, wie Dokumente funktionieren. Weitere Informationen zur Entwicklung der OCR-Technologie und was sich in den letzten drei Jahren geändert hat, finden Sie in unserer Analyse zu dem, was nach OCR geschah.
Das Ergebnis ist das, was traditionelle Konverter-Anbieter mit ihrem Button „Formatierung beibehalten“ stets behauptet, aber nie tatsächlich geliefert haben: ein Word-Dokument, in dem Sie den Inhalt bearbeiten können, ohne das Layout von Grund auf neu aufbauen zu müssen. Für das vollständige technische Bild der layout-erhaltenden Dokumentkonvertierung – einschließlich der zugrunde liegenden Mechanismen, dem Vergleich der Ansätze und einem Auswahlleitfaden – siehe unseren vollständigen Leitfaden zur layout-erhaltenden Dokument-zu-Word-Konvertierung.
Häufig gestellte Fragen
Funktioniert das bei gescannten PDFs oder nur bei digitalen?
Vision AI behandelt beide identisch. Ein gescanntes PDF ist ein Bild einer Seite; ein digitales PDF, das auf dem Bildschirm gerendert wird, ist ebenfalls ein Bild einer Seite. Das Vision-Modell verarbeitet die visuelle Erscheinung direkt, sodass es keinen Unterschied in der Ausgabequalität zwischen einem gescannten Dokument und einem digital erzeugten PDF gibt. Herkömmliche Konverter verschlechtern sich bei Scans erheblich, da sie zuerst OCR ausführen müssen, getrennt von der Layout-Rekonstruktion — wodurch die gesamte oben beschriebene Fehlerkette erneut eingeführt wird.
Was ist mit handschriftlichen Dokumenten oder Anmerkungen?
Da Vision AI den Kontext versteht und nicht Zeichenformen mit einer Schriftbibliothek abgleicht, verarbeitet es Handschrift robuster als OCR. OCR behandelt eine handschriftliche Notiz als eine Reihe mehrdeutiger Formen, die einzeln entschlüsselt werden müssen. Vision AI liest den umgebenden Text, versteht den Zweck des Dokuments und nutzt diesen Kontext, um handschriftliche Markierungen zu interpretieren — genauso wie ein menschlicher Leser es tun würde. Die Leistung variiert mit der Lesbarkeit der Handschrift, aber der Ansatz unterscheidet sich grundlegend von OCR.
Ist die Word-Ausgabe wirklich bearbeitbar oder bricht sie, wenn ich Änderungen vornehme?
Die Ausgabe ist natives Word — echte Absätze, Überschriften und Tabellen, keine positionierten Textfelder. Sie können Text zu einem Absatz hinzufügen und der darunterliegende Inhalt fließt natürlich um. Sie können Spaltenbreiten in einer Tabelle anpassen. Sie können Word-Formatvorlagen anwenden. Das Dokument verhält sich, als wäre es in Word erstellt worden. Dies ist der strukturelle Unterschied zwischen Vision AI-Ausgabe und herkömmlicher Konverter-Ausgabe: Letztere bewahrt die Darstellung (auf Kosten der Bearbeitbarkeit), während Erstere die Struktur bewahrt (wodurch die Darstellung natürlich folgt).
Wie gut verarbeitet Vision AI komplexe Layouts wie mehrspaltige Berichte oder Formulare?
Vision AI verarbeitet die Seite als visuelle Szene, nicht als Koordinatenraster. Mehrspaltige Layouts, Formulare mit beschrifteten Feldern, Dokumente mit eingebetteten Diagrammen und Bildern — das Modell erkennt diese als semantische Muster, nicht als räumliche Artefakte, die rekonstruiert werden müssen. Die Qualität der Ausgabe hängt von der Klarheit und Komplexität des Dokuments ab, aber der Ansatz vermeidet die systematischen Fehlermodi (Spaltenverschachtelung, Textfeld-Fragmentierung), die Koordinaten-Rekonstruktionsmethoden inhärent sind. Unser Leitfaden zur Layout-Erhaltung behandelt Randfälle und Einschränkungen im Detail.