なぜ文書抽出ツールは
文書が同じ見た目だと想定するのか
文書抽出業界全体は、誰も立ち止まって疑問に思わなかった前提、つまり「異なるソースからの文書は、同じ方法で処理できるほど似ているはずだ」という前提の上に構築されました。この前提に悪意はありませんでした。それは受け継がれたものだったのです。それは、標準化こそが効率への唯一の道であると教えてきた1世紀にわたる産業的思考から来ています。しかし、文書はエンジンの部品ではありません。そして現実世界は、その通達を決して受け取らなかったのです。
重要なポイント
- 文書抽出業界全体は、ヘンリー・フォードの1913年の組立ラインからアーキテクチャを借用しました。つまり、すべてのサプライヤーからのすべての文書が、効率的に処理されるためには同じように見えるべきだと想定していたのです。
- テンプレートのメンテナンスは、わずか100社のベンダーで月に5〜10時間かかります。これは人員不足のせいではなく、ツールの設計が、実際よりも世界が単純であることを期待しているからです。
- 「請求書番号」を、それがどこにあるかではなく、その意味によって読み取るツールは、処理が速いだけではありません。テンプレートのメンテナンスという作業を、あなたの職務記述書から完全に排除するのです。
組み立てラインの遺産
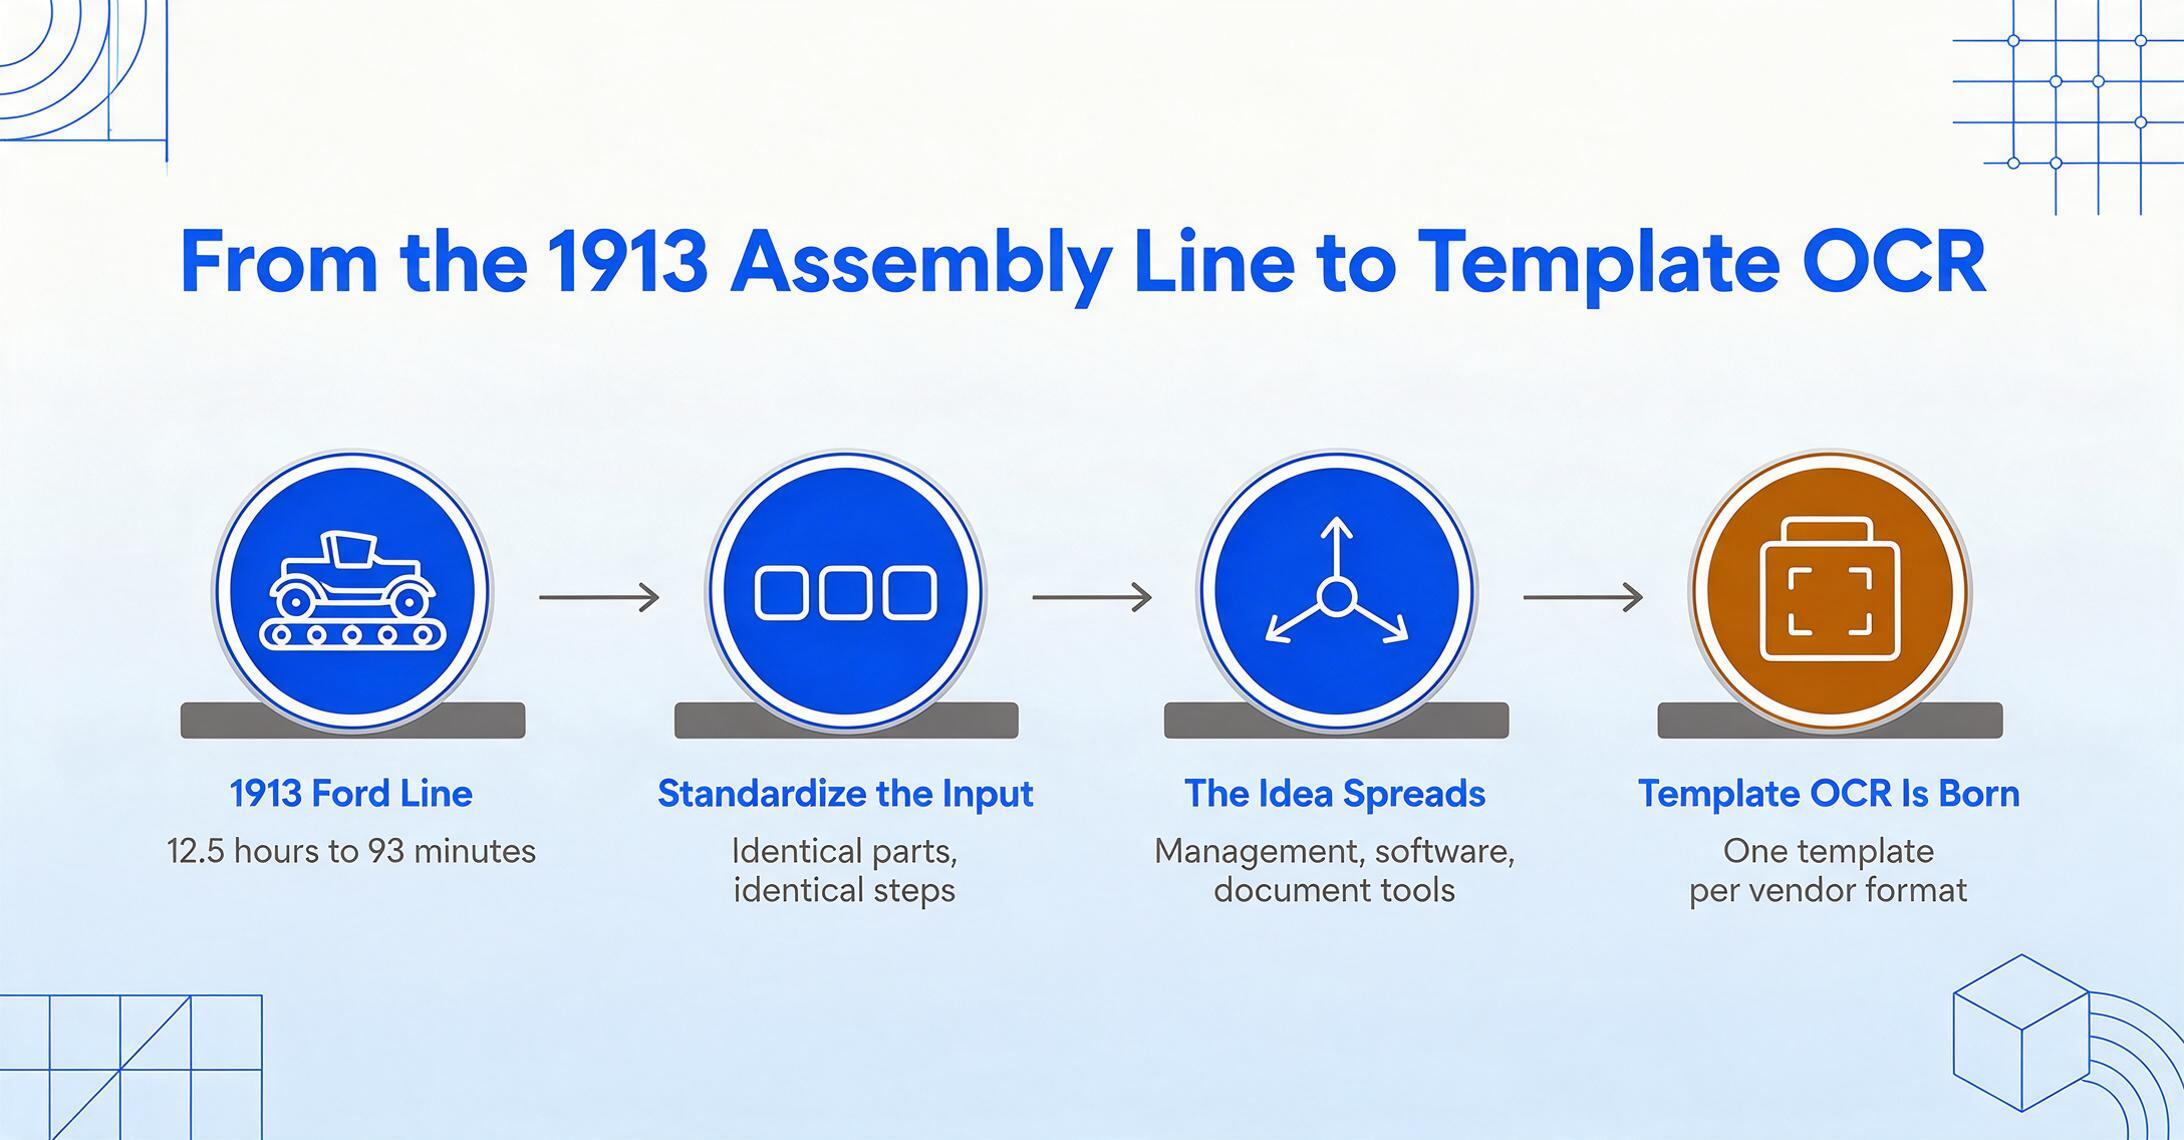
文書が同じように見えるべきだという前提は、文書処理から生まれたものではありません。製造業から来たものです。具体的には、一世紀以上にわたって産業思考を支配してきた効率性に関する一連の考え方から来ています。
1913年、ヘンリー・フォードのハイランドパーク工場は移動組み立てラインを導入し、シャーシ組み立て時間を12.5時間から93分に短縮しました。その洞察はシンプルかつ深遠でした:すべての入力が同一なら、すべての操作を最適化できる。標準化された部品が標準化されたプロセスに流れ込み、前例のない速度とコストで標準化された出力を生み出しました。この考え方は工場に限定されませんでした。経営理論(テイラーの科学的管理法)、ソフトウェア工学(ウォーターフォールモデル)、そして最終的には文書処理ツールの設計にまで浸透しました。
第一世代の文書抽出ソフトウェア(テンプレートOCR、ゾーンOCR、ルールベース解析システム)が構築されたとき、設計者たちは自然に教えられた効率性ツールキットに手を伸ばしました。その論理は完璧に見えました:各フィールドが文書上のどこにあるかを定義し、その位置をルールとしてコード化し、テンプレートに一致する後続のすべての文書を自動処理する。フォーマットごとに1つのテンプレート。テンプレートを維持する。標準化を通じてスケールする。
注目すべきは、彼らがこの前提を作ったことではありません。数十年にわたり、業界がそれを自明に正しいものとして扱ったことです——設計上の選択ではなく設計上の制約として。その前提はアーキテクチャに深く組み込まれ、ほとんどのツールはそれを制限事項として文書化すらしませんでした。それは魚が泳いでいる水のようなものでした。
現実が標準化を拒むとき
異なる送信元からの文書が、処理テンプレートを共有できるほど似通っているという前提を置くなら、実際のビジネス文書の状態は、あらゆるレベルでその前提を直接的に否定するものです。
最も単純なケースである請求書を例に挙げましょう。中規模企業では、20〜50社の異なる取引先から請求書を受け取る可能性があります。QuickBooksやXeroで生成されたデジタルPDFもありますが、構造化されているもののフィールド名はさまざまです(「Invoice No.」と「Invoice #」と「Reference」)。SAP AribaやCoupaなどのエンタープライズERPから、人間が読むために設計され機械抽出用ではないPDFとして出力されるものもあります。ページをまたいでテーブルにまたがる明細項目を含む複数ページの文書です。小規模なサプライヤーからの紙の請求書をスキャンしたものもあり、印鑑、手書きのメモ、斜めに撮影された写真が含まれています。単一企業の請求書受信箱には、OCR設計者が想定した以上のフォーマット多様性が存在します。
そして請求書はまだ簡単なケースです。発注書、納品書、検査報告書、保険証書、銀行明細書、検査室レポートなど、各文書タイプにはそれぞれ独自のフォーマットバリエーションの生態系があります。30の下請け業者と取引する建設会社は、一部からはAIA G702支払申請書を受け取り、他からは手書きの日報を受け取り、残りについては自社ERPから内部生成されたPDFを受け取ります。
Redditのr/procurementコミュニティはこの問題を徹底的に記録しています。あるスレッドは現実を正確に捉えています。「ベンダーはフォーマットに従わない。EDI連携しているサプライヤーでさえ、技術的には準拠しているが実務的には乱雑なデータを生成する。そして時間の経過とともに合意したフォーマットから『逸脱』していく」。別のスレッドではこう述べられています。「MSAの追補に請求書フォーマットを明確に記載している。サプライヤーはシステムに精通している。それでも5〜10%は使用不能な状態で届く」。
標準化を強制しようとする試み、つまりサプライヤーにテンプレートを送付し、EDI準拠を要求し、不適合文書を拒否することは、紙の書類でエントロピーと戦うようなものです。部分的に、一時的に機能し、大きな関係コストを伴います。フォーマットの多様性はシステムのバグではありません。それはシステムの自然な状態です。すべてのサプライヤーが異なる会計ソフトウェアを使用しています。すべての部門に独自の報告規則があります。すべての個人が異なる方法でフォームに記入します。これは排除すべき混乱ではなく、受け入れるべき現実です。
核心的な反論
フォーマットの多様性は、より良いプロセスで解決できる問題ではありません。それはビジネスコミュニケーションのデフォルトの状態です。フォーマットの一貫性を要求するツールは、文書の問題を解決しているのではなく、世界がツールに合わせて形を変えることを要求しているのです。
前提がソフトウェアになった経緯
テンプレートOCRアーキテクチャは、標準化の前提をコードに最も忠実に翻訳したものです。仕組みは次の通りです。そして、「機能する」という表現が大げさである理由も説明します。
テンプレートOCRシステムは、1枚の文書を処理する前に、あなたに何かをしてもらう必要があります。テンプレートを定義することです。ベンダーごとのフォーマットについて、請求書番号が表示される場所、日付がある場所、明細行が始まり終わる場所に、ゾーン(矩形)を描画します。ツールはこれらの座標を記憶します。そのベンダーから新しい文書が届くと、同じ位置のテキストを探し、見つかったものを抽出します。ベンダーがレターヘッドを更新したためにフィールドが2センチ右にずれた場合、ツールは誤ったデータを抽出するか、何も抽出しません。ベンダーが明細行テーブルに列を追加した場合、テーブル抽出全体が崩壊します。新しいベンダーが最初の請求書を送ってきた場合、テンプレートがないため、抽出も行われません。
このアーキテクチャには、失敗の名前があります。「テンプレート破損」です。業界用語自体が脆弱性を明らかにしています。テンプレートは優雅に劣化するのではなく、破損するのです。レイアウトが1つ変更されるだけで、抽出ロジックは完全に機能しなくなります。ツールは適応せず、推測もせず、フォールバックも試みません。フォーマットが一定であるという前提に基づいて設計されているため、前提が崩れると、ツールも一緒に機能しなくなります。
最も示唆に富むのは、このアーキテクチャがユーザーのツール体験をどのように形作るかです。ツールは「これらの特定のテンプレートに一致する文書を処理できます」とは提示しません。「文書を処理できます」と提示します。制限は設計によって隠蔽されます。フォーマットが変更され、抽出が失敗するまでは。ユーザーの自然な結論は、「設定を間違えたに違いない」または「このツールは機能しない」です。実際の問題はもっと深いところにあります。ツールのロジック全体が、現実が日常的に破る前提に依存しているのです。
標準化を求める隠れたコスト
テンプレートベースの抽出のコストは、ソフトウェアライセンスではありません。標準化を拒む世界でソフトウェアを機能させ続けるために、ソフトウェアの周りで発生するすべてのことです。
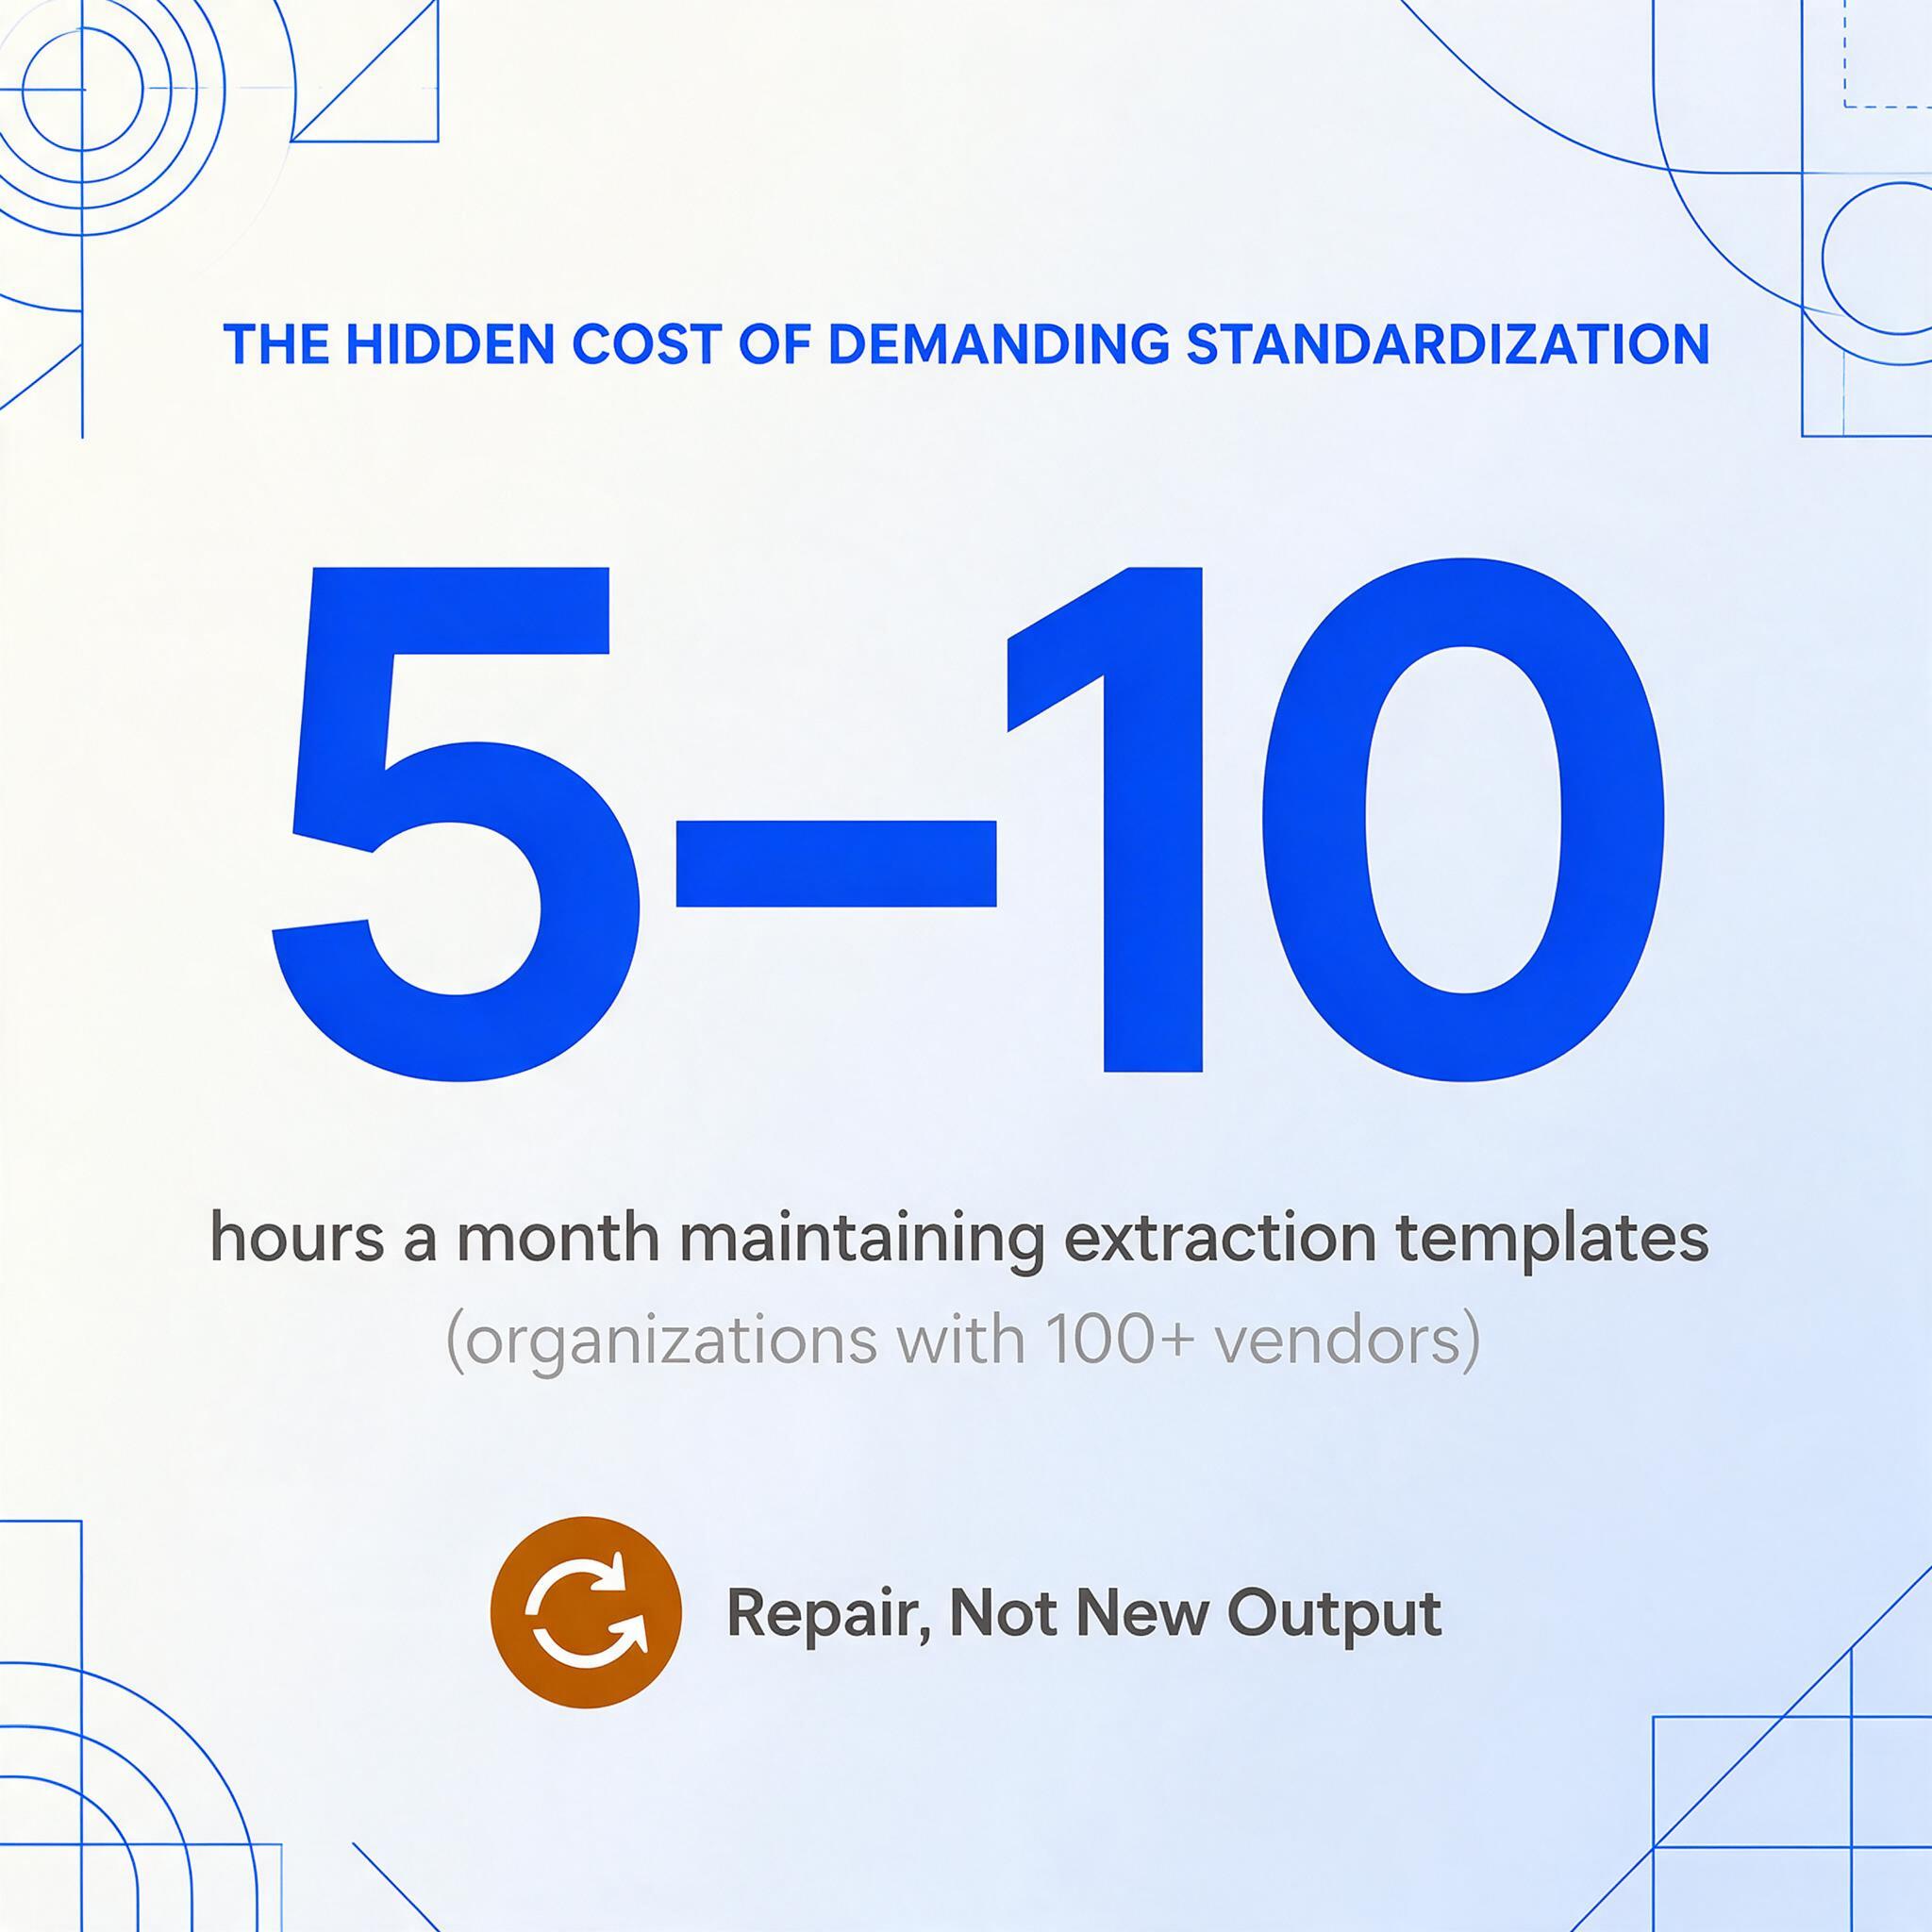
テンプレートのメンテナンスは、継続的な運用コストです。 100以上のベンダーとテンプレートベースのOCRを利用している組織は、通常、テンプレートの維持だけで月に5〜10時間を費やしています。レイアウト変更後のゾーンの再描画、新しいベンダーフォーマット用のルールの再構築、各更新後の抽出精度のテストなどです。これは、何も新しいものを生み出さない作業です。世界が実際よりも単純であることを期待して設計されたツールを修理するためだけに存在します。
新しいベンダーのオンボーディングがボトルネックになります。 新しいサプライヤーが最初の請求書を送ってきたとき、APチームには2つの選択肢があります。誰かがテンプレートを作成している間に手動で処理するか、処理前にテンプレートを待つかです。どちらにしても、テンプレート要件により、日常的な操作が設定プロジェクトに変わります。これを年間数十の新しいベンダーに拡大すると、オーバーヘッドは複合的に増大します。
サイレントエラーは下流に蓄積されます。テンプレートが部分的に壊れた場合(一部のフィールドはずれ、他はずれない)、抽出は大きなエラーとして顕在化しません。静かに失敗し、金額を誤った勘定科目に、日付を誤ったフィールドに、ベンダー名を誤ったレコードにマッピングします。これらのエラーはERPシステム、財務レポート、支払い処理へと下流に流れていきます。それらは数週間後、数ヶ月後に、照合の際に表面化し、抽出レイヤーまで遡って追跡するには、ほとんどのチームが割く余裕のない調査作業が必要になります。
サプライヤーとの関係が悪化します。APチームがフォーマット不適合で請求書を拒否したり、テンプレート修正を待つ間支払いを遅らせたりすると、サプライヤーはそれに気づきます。企業が構築に投資してきた調達関係は、サプライヤーの業績とは無関係な技術的な制限によって緊張することになります。
これらのコストはソフトウェア評価のスプレッドシートには見えません。価格比較ページには表示されません。しかし、これらは作業を減らすツールと、作業をある種類(手入力)から別の種類(テンプレート保守)に移し替えて自動化と呼ぶツールとの違いを生み出します。
前提を置かないツールとはどのようなものか
文書が常に同じように見えるという前提をやめたら、抽出アーキテクチャはどのようなものになるでしょうか。その答えは、別の問いから始まります。
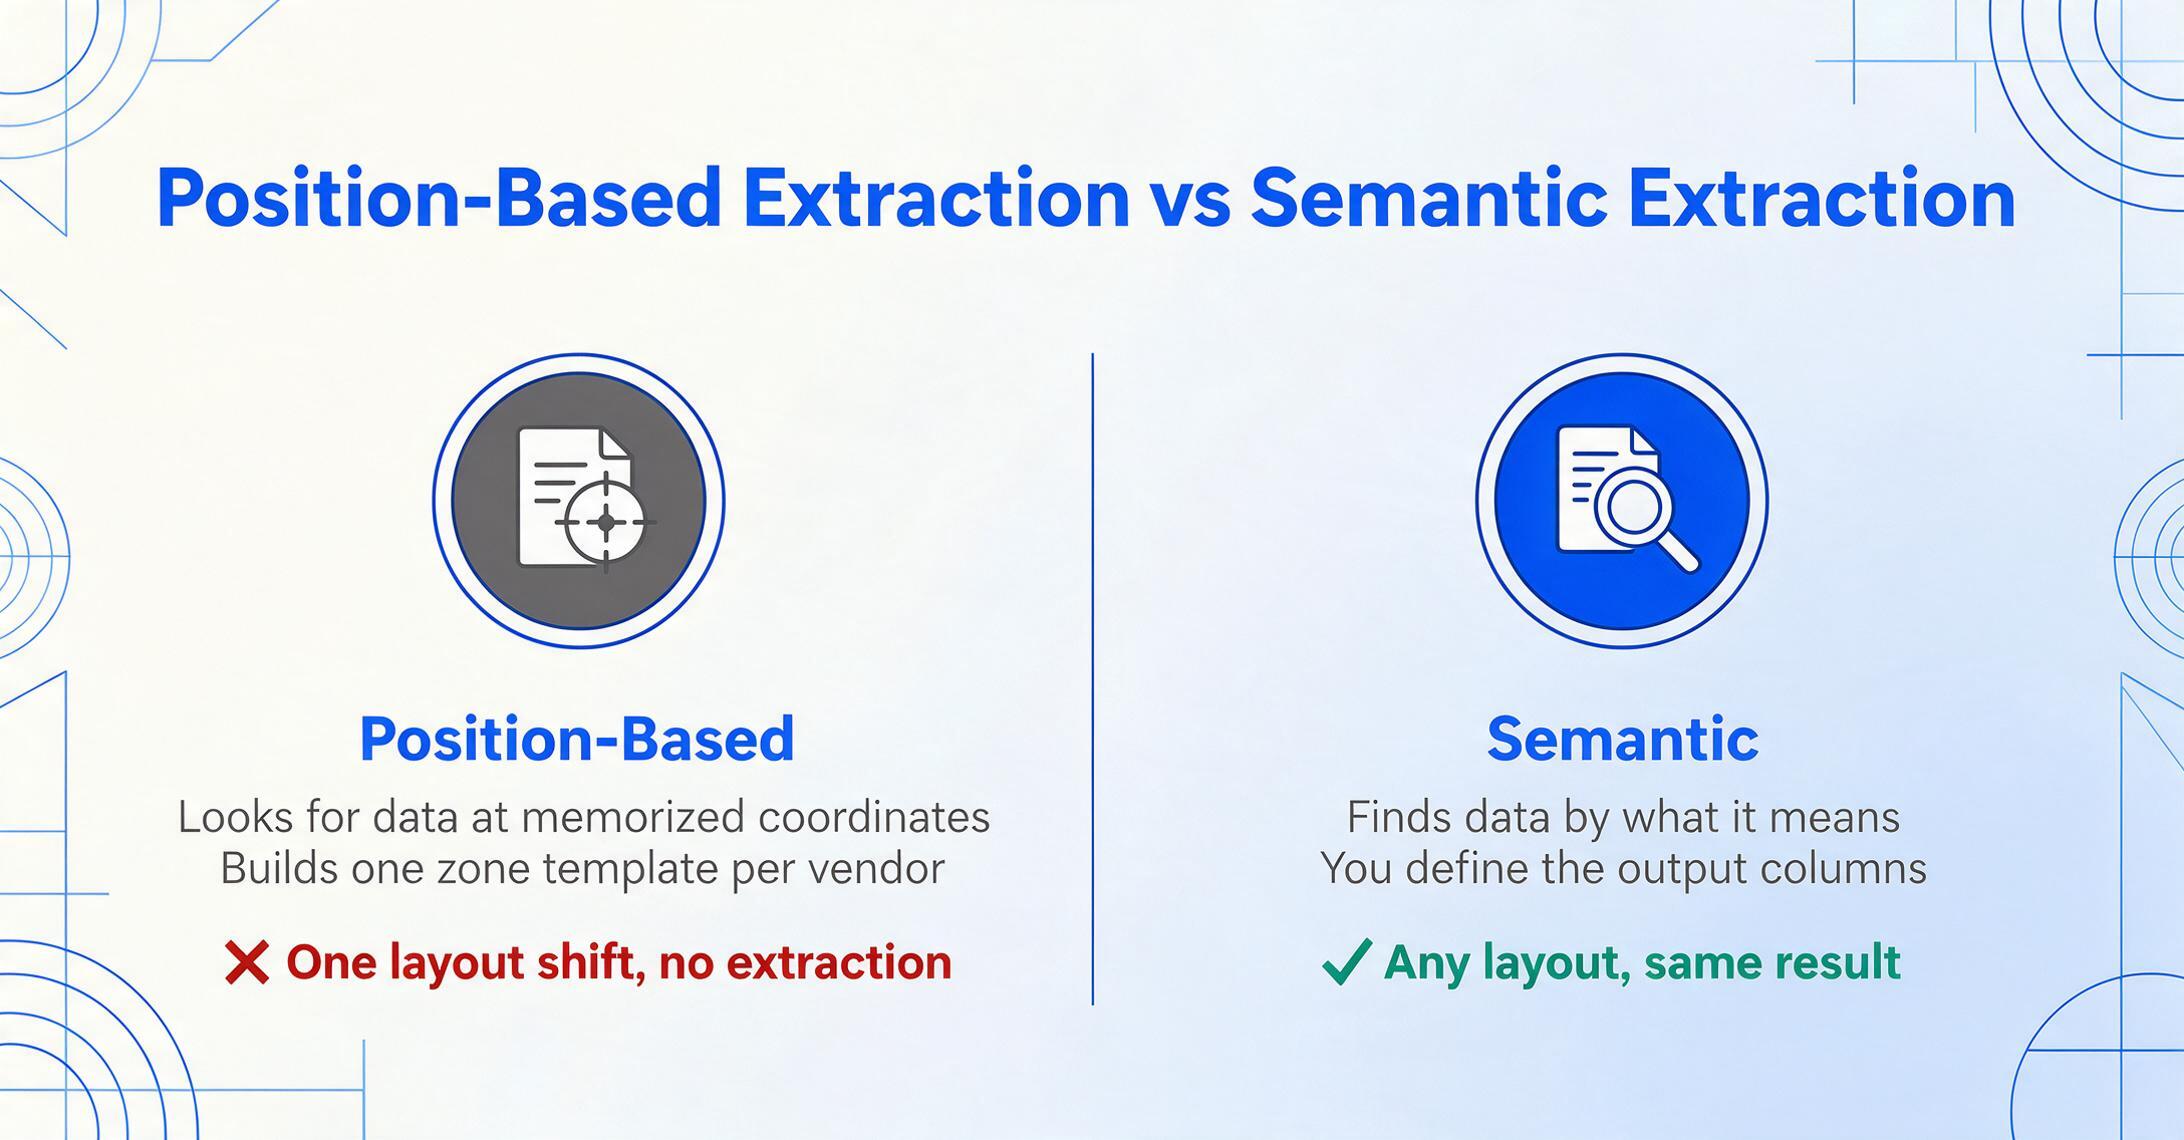
「データはページのどこにあるのか」と問う代わりに、ツールは「このデータはページ上で何を意味するのか」と問います。これが位置ベース抽出とセマンティック抽出の違いです。位置ベースのツールは、請求書番号が座標(x: 450, y: 120)にあることを知っている必要があります。セマンティックなツールは、このページのどこかに請求書番号として機能する文字列があることを知っていればよく、レイアウトを記憶するのではなく、文書の内容を理解することでそれを見つけ出せます。
この転換は下流のすべてを変えます。ベンダーごとにテンプレートを構築する必要はなく、レイアウトが変わってもゾーンを描き直す必要はなく、新しいサプライヤーのオンボーディングの遅延もありません。ツールはフォーマットの多様性をデフォルトの状態として扱います。なぜなら、セマンティックには、ベンダーが合計を右上に置こうが左下に置こうが、請求書は請求書だからです。「請求書番号」の意味は、「Invoice #」「Inv. No.」「Ref.」とラベル付けされていても、あるいはラベルなしでページ上部に目立つように配置されていても、同じです。
これがカスタム列抽出の背後にあるパラダイムです。「請求書番号」「ベンダー名」「合計」「支払期日」など、必要な出力列を定義すると、AIはデータがどこにあるかではなく、何を意味するかを理解することで、あらゆる文書のどこからでも各値を特定します。出力を定義するのはあなたです。入力を理解するのはAIです。フォーマットは関係ありません。
ファイルは安全に処理され、保存されることはありません。
異なるベンダーからの請求書を2枚アップロードしてみてください。レイアウトも、フィールドの位置も、ラベルの表記も異なります。必要な列を一度定義するだけで、AIがフォーマットごとの設定なしに両方のドキュメントから同じデータ項目を見つけ出します。これは高速なテンプレートビルダーではありません。そもそもテンプレートを必要としないツールです。より深く知りたい方は、テンプレート不要の抽出がアーキテクチャレベルでどのように機能するかをご覧ください。3世代にわたる抽出技術との比較も含め、技術的な詳細がエンジンの内部を解説しています。
誰も発表しなかったパラダイムシフト
数年にわたって文書抽出ツールを使ってきた方なら、今や時代遅れとなった一連の前提を内面化しているかもしれません。ベンダーごとにテンプレートが必要、フォーマット変更で抽出が壊れる、新しい文書タイプの導入は設定プロジェクトである、といったものです。これらは不合理な期待ではありませんでした。当時のツールの動作を正確に説明していたのです。しかし、ツールがそのように動作していたのは、ある前提があったからであり、その前提はすでに置き換えられています。
位置ベースからセマンティック抽出への移行は、漸進的な改善ではありません。パラダイムの変化です。旧パラダイムはこう言いました。入力を標準化すれば、処理できるようになる。新パラダイムはこう言います。入力は本質的に多様である。そのまま処理する。旧パラダイムはフォーマットの多様性を排除すべき問題と見なしました。新パラダイムはそれを当然の前提として受け入れます。
だからこそ、新しいアプローチを「より優れたOCR」と呼ぶのは的外れなのです。OCRは常に文字認識、つまりピクセルをテキストに変換することでした。新しいアプローチは文書理解、つまりページの内容を理解して構造化データに変換することです。OCRは読み取ります。AIは理解します。その違いは程度の問題ではありません。カテゴリーの違いです。実際のワークフローについては、異なるフォーマットの請求書からデータを抽出して単一の統合スプレッドシートにまとめる方法のハウツーガイドをご覧ください。ベンダーごとにテンプレートを作成する必要はありません。
新しい前提
異なるソースからの文書は常に異なる外観を持ちます。ツールの役割は、それらをとにかく理解することです。先に適合を要求するのではありません。それは機能ではありません。実世界の文書抽出ツールにとっての最低限の前提です。
よくある質問
なぜ全ベンダーに同じフォーマットを強制しないのですか?
あなたは彼らの唯一の顧客ではないからです。50社に請求書を送る仕入先は、50通りのフォーマット要件に直面します。仮にベンダーに自社テンプレートの使用を徹底できたとしても、購買チームは準拠の確認、不適合書類の差し戻し、テンプレート管理に時間を費やすことになり、それはビジネス価値を生みません。標準化は取引先の数に比例して拡大する調整問題です。戦術的には勝てても、サプライヤーベースが拡大するにつれて戦略的には敗北する戦いです。
EDIではフォーマット問題は解決しないのですか?
部分的に、そして大規模取引先に限ってです。EDI(電子データ交換)は標準化されたデータ形式を強制するため、レイアウトのばらつきはなくなります。しかし、EDIの導入には取引先1社あたり数千ドルのコストがかかり、継続的なマッピング保守が必要で、高頻度取引にしか現実的ではありません。r/ediコミュニティでも指摘されているように、EDI連携済みのサプライヤーでさえ「技術的には準拠しているが実務上は乱雑なデータ」を生成し、「合意フォーマットから時間とともに逸脱」します。中小規模のサプライヤーにはEDIは選択肢になりません。
AI抽出ツールは手書き文書でも機能しますか?
はい、手書きの品質に応じて精度は変動します。ビジョンモデルを用いたAI抽出は、手書き注釈付き文書で約88~95%、完全手書き文書で75~90%の精度を達成します。清書された印刷テキストでは最大99%に達します。手書きにおける精度ギャップは意味論的アプローチの限界ではなく、手書きに内在する曖昧さを反映したものです。テンプレートOCRとの決定的な違いは、AIツールが手書きに対して完全に失敗するのではなく、緩やかに精度が低下する点です。
テンプレートベースのツールは、どの時点で管理不能になりますか?
実際のAPチームのコンセンサスでは、取引先数が50~100の間でその閾値に達します。50未満であれば、専任担当者が月数時間のテンプレートメンテナンスで済みますが、100を超えるとテンプレート管理はパートタイムの仕事になります。フォーマット変更、新規取引先のオンボーディング、サイレントな抽出エラーが、一人で管理できる速度を超えて蓄積されていきます。この閾値は業界によって異なり、建設、医療、製造業など、文書フォーマットが本質的に多様な企業は、標準化されたデジタル請求書を主に受け取る企業よりも早く限界に達します。
セマンティック抽出は100%正確ですか?
いいえ。どの抽出方法も、すべての文書に対して100%正確というわけではありません。セマンティック抽出は、鮮明な印刷文書では最大99%の精度を達成しますが、品質の低いスキャン、手書き文字が多い文書、極めて複雑なレイアウトでは精度が低下します。テンプレートOCRとの違いは、完全であることではなく、フォーマットが変わっても完全に機能しなくなるわけではないことです。テンプレートツールは新しいレイアウトで壊滅的に失敗しますが、セマンティックツールは珍しいフォーマットでも精度が99%から92%に低下するかもしれませんが、それでも使用可能な出力を生成します。失敗の仕方は、精度の上限と同じくらい重要なのです。