Pourquoi chaque outil d'extraction de documents
suppose que les documents se ressemblent
Toute l'industrie de l'extraction de documents a été bâtie sur un postulat que personne n'a jamais pris le temps de remettre en question : que les documents provenant de différentes sources se ressembleraient suffisamment pour être traités de la même manière. Ce postulat n'était pas malveillant. Il était hérité. Il venait d'un siècle de pensée industrielle qui nous a appris que la standardisation est la seule voie vers l'efficacité. Mais les documents ne sont pas des pièces de moteur, et le monde réel n'a jamais reçu le mémo.
Points clés à retenir
- Toute l'industrie de l'extraction de documents a emprunté son architecture à la chaîne de montage de Henry Ford en 1913 — en supposant que chaque document de chaque fournisseur devrait se ressembler pour être traité efficacement.
- La maintenance des modèles coûte de 5 à 10 heures par mois pour seulement 100 fournisseurs — non pas parce que vous manquez d'effectifs, mais parce que la conception de l'outil s'attend à ce que le monde soit plus simple qu'il ne l'est en réalité.
- Un outil qui lit « Numéro de facture » selon ce que cela signifie plutôt que selon sa position ne traite pas seulement plus rapidement — il élimine entièrement la maintenance des modèles en tant que catégorie de travail de votre description de poste.
L'héritage de la chaîne de montage
L'hypothèse selon laquelle les documents devraient se ressembler ne vient pas du traitement documentaire. Elle vient de la fabrication. Plus précisément, d'un ensemble d'idées sur l'efficacité qui domine la pensée industrielle depuis plus d'un siècle.
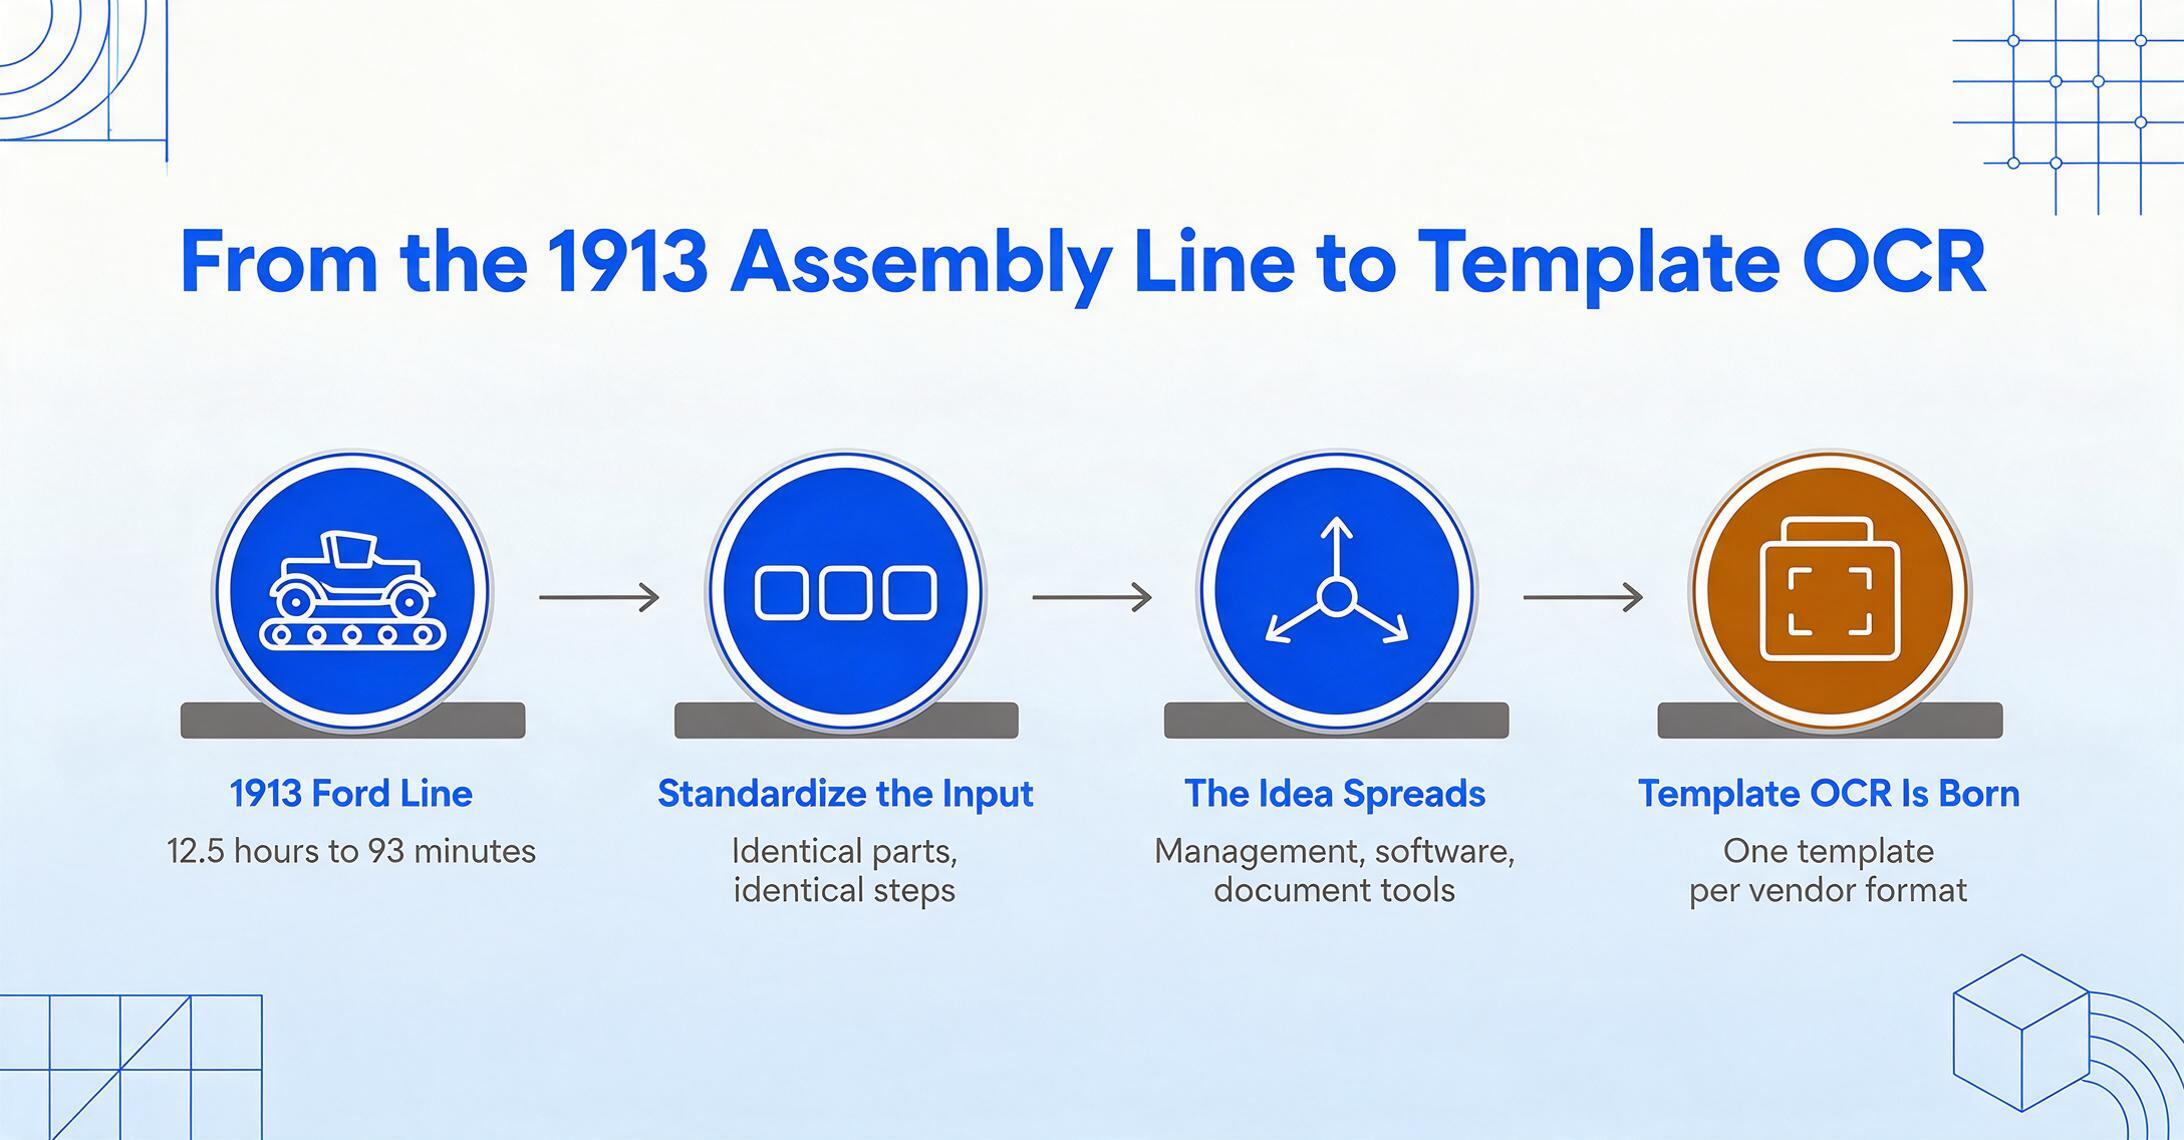
En 1913, l'usine Highland Park de Henry Ford a introduit la chaîne de montage mobile et a réduit le temps d'assemblage du châssis de 12,5 heures à 93 minutes. L'idée était simple et profonde : si chaque intrant est identique, chaque opération peut être optimisée. Des pièces standardisées alimentant des processus standardisés produisaient des résultats standardisés à une vitesse et un coût sans précédent. Cette idée ne s'est pas limitée aux usines. Elle a colonisé la théorie du management (le management scientifique de Taylor), le génie logiciel (le modèle en cascade) et, finalement, la conception des outils de traitement documentaire.
Lorsque la première génération de logiciels d'extraction documentaire a été construite — OCR par modèle, OCR zonal, systèmes d'analyse basés sur des règles — les ingénieurs qui les concevaient ont naturellement utilisé la boîte à outils d'efficacité qu'on leur avait enseignée. La logique semblait infaillible : définir où se trouve chaque champ sur un document, encoder cette position comme une règle, et chaque document ultérieur correspondant au modèle peut être traité automatiquement. Un modèle par format. Maintenir le modèle. Passer à l'échelle grâce à la standardisation.
Ce qui est remarquable, ce n'est pas qu'ils aient fait cette hypothèse. C'est que pendant des décennies, l'industrie l'a traitée comme étant évidemment correcte — une contrainte de conception plutôt qu'un choix de conception. L'hypothèse était si profondément intégrée à l'architecture que la plupart des outils ne la documentaient même pas comme une limitation. C'était l'eau dans laquelle nageait le poisson.
Quand la réalité refuse de se standardiser
Si l'on part du principe que les documents provenant de différentes sources se ressemblent suffisamment pour partager un modèle de traitement, alors l'état réel des documents professionnels contredit directement cette hypothèse à tous les niveaux.
Prenons le cas le plus simple : les factures. Une entreprise de taille moyenne peut recevoir des factures de 20 à 50 fournisseurs différents. Certaines sont des PDF numériques générés par QuickBooks ou Xero — structurés mais avec des noms de champs qui varient (« Invoice No. » vs « Invoice # » vs « Reference »). Certaines proviennent d'ERP d'entreprise comme SAP Ariba ou Coupa, exportées en PDF conçus pour la lecture humaine, pas pour l'extraction automatique — des documents multipages avec des lignes d'articles qui s'étendent sur des tableaux à travers les sauts de page. Certaines sont des scans de factures papier de petits fournisseurs, avec tampons, annotations manuscrites et photos de travers. La boîte de réception des factures d'une seule entreprise contient plus de diversité de formats que ce que les concepteurs d'OCR à modèle ont jamais prévu.
Et les factures sont le cas facile. Bons de commande, bons de livraison, rapports d'inspection, certificats d'assurance, relevés bancaires, rapports de laboratoire — chaque type de document apporte son propre écosystème de variation de format. Une entreprise de construction qui travaille avec 30 sous-traitants reçoit des demandes de paiement AIA G702 de certains, des rapports quotidiens manuscrits d'autres, et des PDF générés en interne par son propre ERP pour le reste.
La communauté Reddit r/procurement a documenté cela de manière exhaustive. Un fil capture la réalité avec précision : « Les fournisseurs ne suivent pas les formats. Même les fournisseurs liés par EDI produisent des données techniquement conformes mais pratiquement désordonnées. Et ils « dérivent » des formats convenus au fil du temps. » Un autre : « Nous indiquons clairement le format de facture dans l'avenant au MSA. Les fournisseurs connaissent les systèmes. Et pourtant, 5 à 10 % arrivent inutilisables. »
Tenter d'imposer la standardisation — envoyer un modèle aux fournisseurs, exiger la conformité EDI, rejeter les documents non conformes — c'est lutter contre l'entropie avec de la paperasse. Cela fonctionne partiellement, temporairement, et au prix d'une relation significative. La diversité des formats n'est pas un bug du système. C'est l'état naturel du système. Chaque fournisseur utilise un logiciel de comptabilité différent. Chaque service a ses propres conventions de reporting. Chaque individu remplit les formulaires différemment. Ce n'est pas un chaos à éliminer — c'est une réalité à laquelle il faut s'adapter.
La réfutation fondamentale
La diversité des formats n'est pas un problème que de meilleurs processus peuvent résoudre. C'est la condition par défaut de la communication professionnelle. Un outil qui exige une cohérence de format ne résout pas un problème de documents — il exige que le monde se reformate pour s'adapter à l'outil.
Comment l'hypothèse est devenue un logiciel
L'architecture OCR basée sur des modèles est la traduction la plus littérale de l'hypothèse de standardisation en code. Voici comment elle fonctionne — et pourquoi « fonctionne » est un bien grand mot.
Un système OCR basé sur des modèles exige que vous fassiez quelque chose avant de pouvoir traiter un seul document : définir un modèle. Pour chaque format de fournisseur, vous dessinez des zones — des rectangles autour de l'endroit où apparaît le numéro de facture, où se trouve la date, où commencent et se terminent les lignes d'articles. L'outil mémorise ces coordonnées. Lorsqu'un nouveau document arrive de ce fournisseur, il recherche du texte aux mêmes positions et extrait ce qu'il trouve. Si un champ s'est déplacé de deux centimètres vers la droite parce que le fournisseur a mis à jour son en-tête, l'outil extrait des données erronées — ou rien. Si un fournisseur ajoute une colonne à son tableau de lignes d'articles, l'extraction du tableau entier s'effondre. Si un nouveau fournisseur envoie sa première facture, il n'y a pas de modèle, donc pas d'extraction.
Cette architecture a un nom pour l'échec : « rupture de modèle ». Le langage de l'industrie lui-même révèle la fragilité — les modèles ne se dégradent pas gracieusement, ils se brisent. Un changement de mise en page et la logique d'extraction cesse de fonctionner entièrement. L'outil ne s'adapte pas, ne devine pas, n'essaie pas de solution de repli. Il a été conçu sur le principe que le format est constant. Lorsque le principe échoue, l'outil échoue avec lui.
Ce qui est le plus révélateur, c'est la manière dont cette architecture façonne l'expérience de l'utilisateur avec l'outil. L'outil ne se présente pas comme « nous pouvons traiter les documents qui correspondent à ces modèles spécifiques ». Il se présente comme « nous pouvons traiter les documents ». La limitation est masquée par la conception — jusqu'à ce que le format change et que l'extraction échoue. La conclusion naturelle de l'utilisateur est « j'ai dû mal configurer quelque chose » ou « cet outil ne fonctionne pas ». Le problème réel est plus profond : toute la logique de l'outil dépend d'un principe que la réalité viole régulièrement.
Le coût caché de l'exigence de standardisation
Le coût de l'extraction basée sur des modèles n'est pas la licence du logiciel. C'est tout ce qui se passe autour du logiciel pour le maintenir fonctionnel dans un monde qui refuse d'être standardisé.
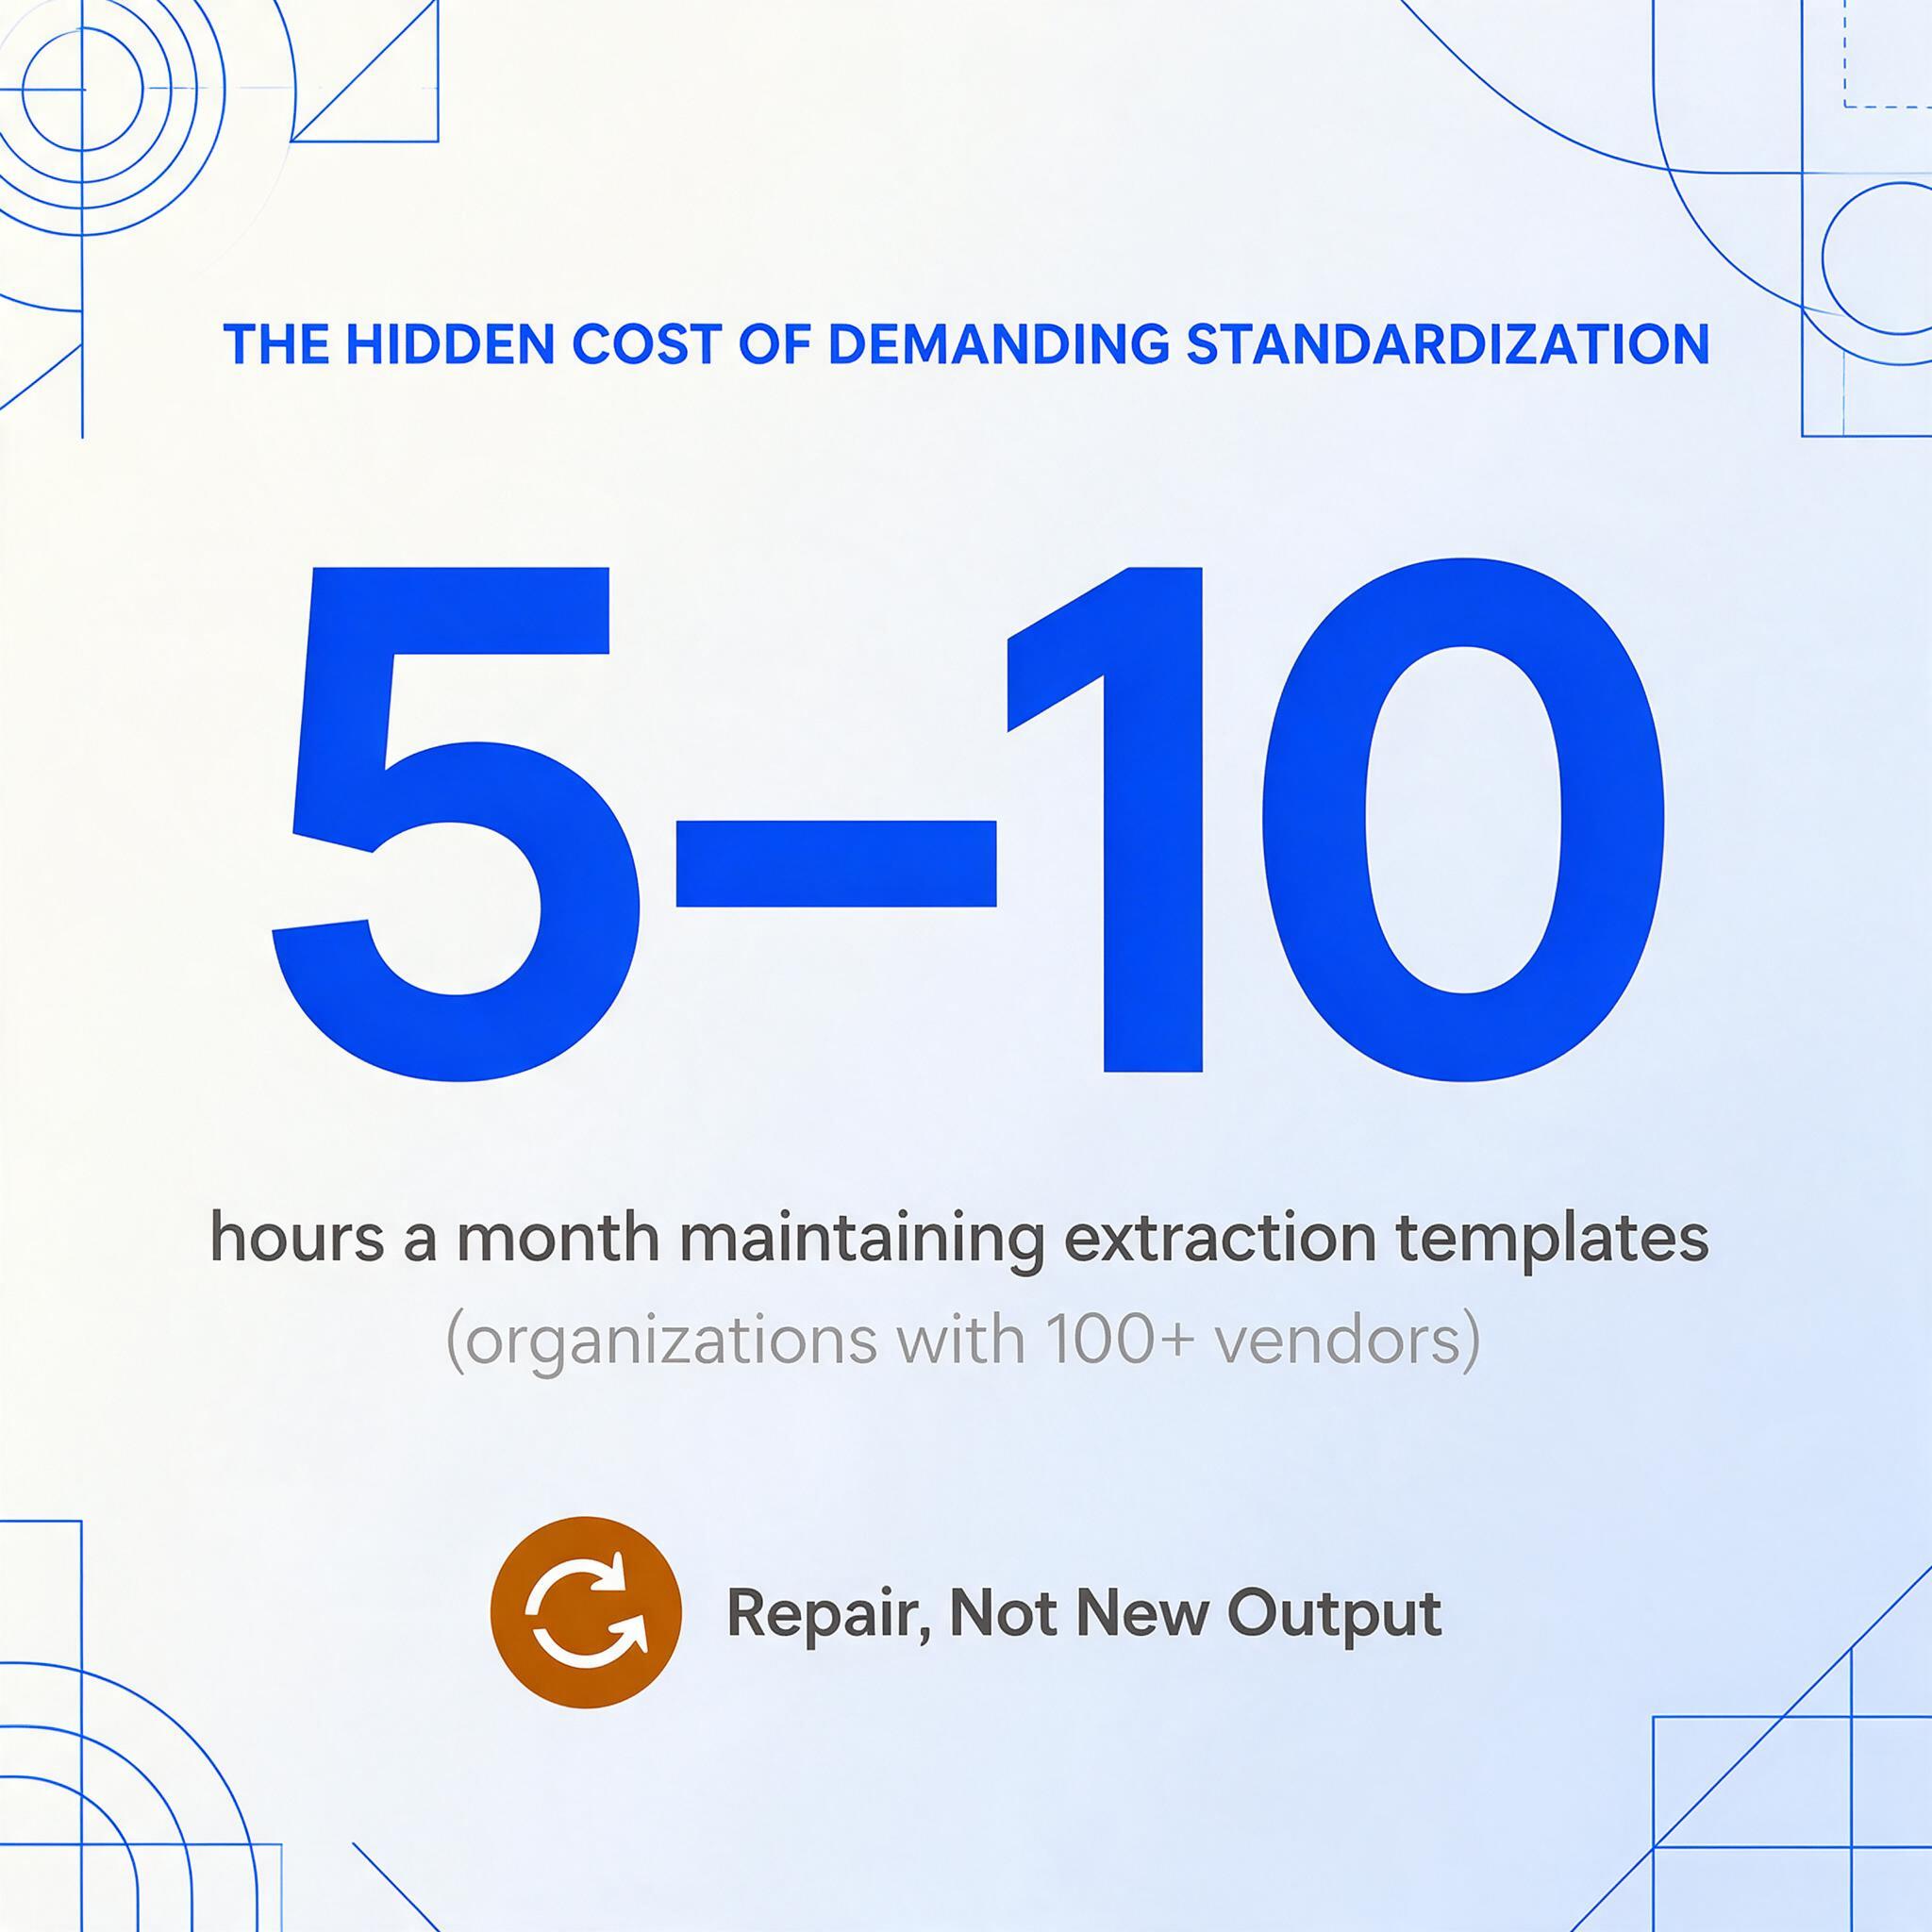
La maintenance des modèles est une dépense opérationnelle récurrente. Les organisations ayant plus de 100 fournisseurs et utilisant l'OCR basée sur des modèles consacrent généralement 5 à 10 heures par mois uniquement à la maintenance des modèles — redessiner les zones après des changements de mise en page, reconstruire les règles pour les nouveaux formats de fournisseurs, tester la précision de l'extraction après chaque mise à jour. C'est un travail qui ne produit rien de nouveau. Il existe uniquement pour réparer un outil dont la conception s'attend à ce que le monde soit plus simple qu'il ne l'est.
L'intégration de nouveaux fournisseurs devient un goulot d'étranglement. Lorsqu'un nouveau fournisseur envoie sa première facture, l'équipe AP a deux options : la traiter manuellement pendant que quelqu'un crée un modèle, ou attendre le modèle avant de la traiter. Dans les deux cas, l'exigence de modèle transforme une opération de routine en projet de configuration. Multipliez cela par des dizaines de nouveaux fournisseurs par an, et les frais généraux s'accumulent.
Les erreurs silencieuses s'accumulent en aval. Lorsqu'un modèle se casse partiellement — certains champs se décalent, d'autres non — l'extraction n'échoue pas bruyamment. Elle échoue silencieusement, en attribuant des montants à de mauvais comptes, des dates à de mauvais champs, des noms de fournisseurs à de mauvais enregistrements. Ces erreurs se propagent en aval dans les systèmes ERP, les rapports financiers et les cycles de paiement. Elles refont surface des semaines ou des mois plus tard, lors du rapprochement, quand les retracer jusqu'à la couche d'extraction exige un travail d'investigation que la plupart des équipes n'ont pas les moyens de mener.
Les relations fournisseurs se dégradent. Lorsqu'une équipe AP rejette des factures pour non-conformité de format ou retarde les paiements en attendant des correctifs de modèles, les fournisseurs le remarquent. La relation d'approvisionnement, que l'entreprise a investi à bâtir, se tend à cause d'une limitation technique qui n'a rien à voir avec la performance du fournisseur.
Ces coûts sont invisibles dans une feuille de calcul d'évaluation logicielle. Ils n'apparaissent pas dans la comparaison des pages de tarification. Mais ils font la différence entre un outil qui réduit le travail et un outil qui déplace le travail d'un type (saisie manuelle) à un autre (maintenance de modèles) — et appelle cela de l'automatisation.
À quoi ressemble un outil sans hypothèses
Si vous cessez de supposer que les documents se ressembleront, à quoi ressemble l'architecture d'extraction ? La réponse commence par une question différente.
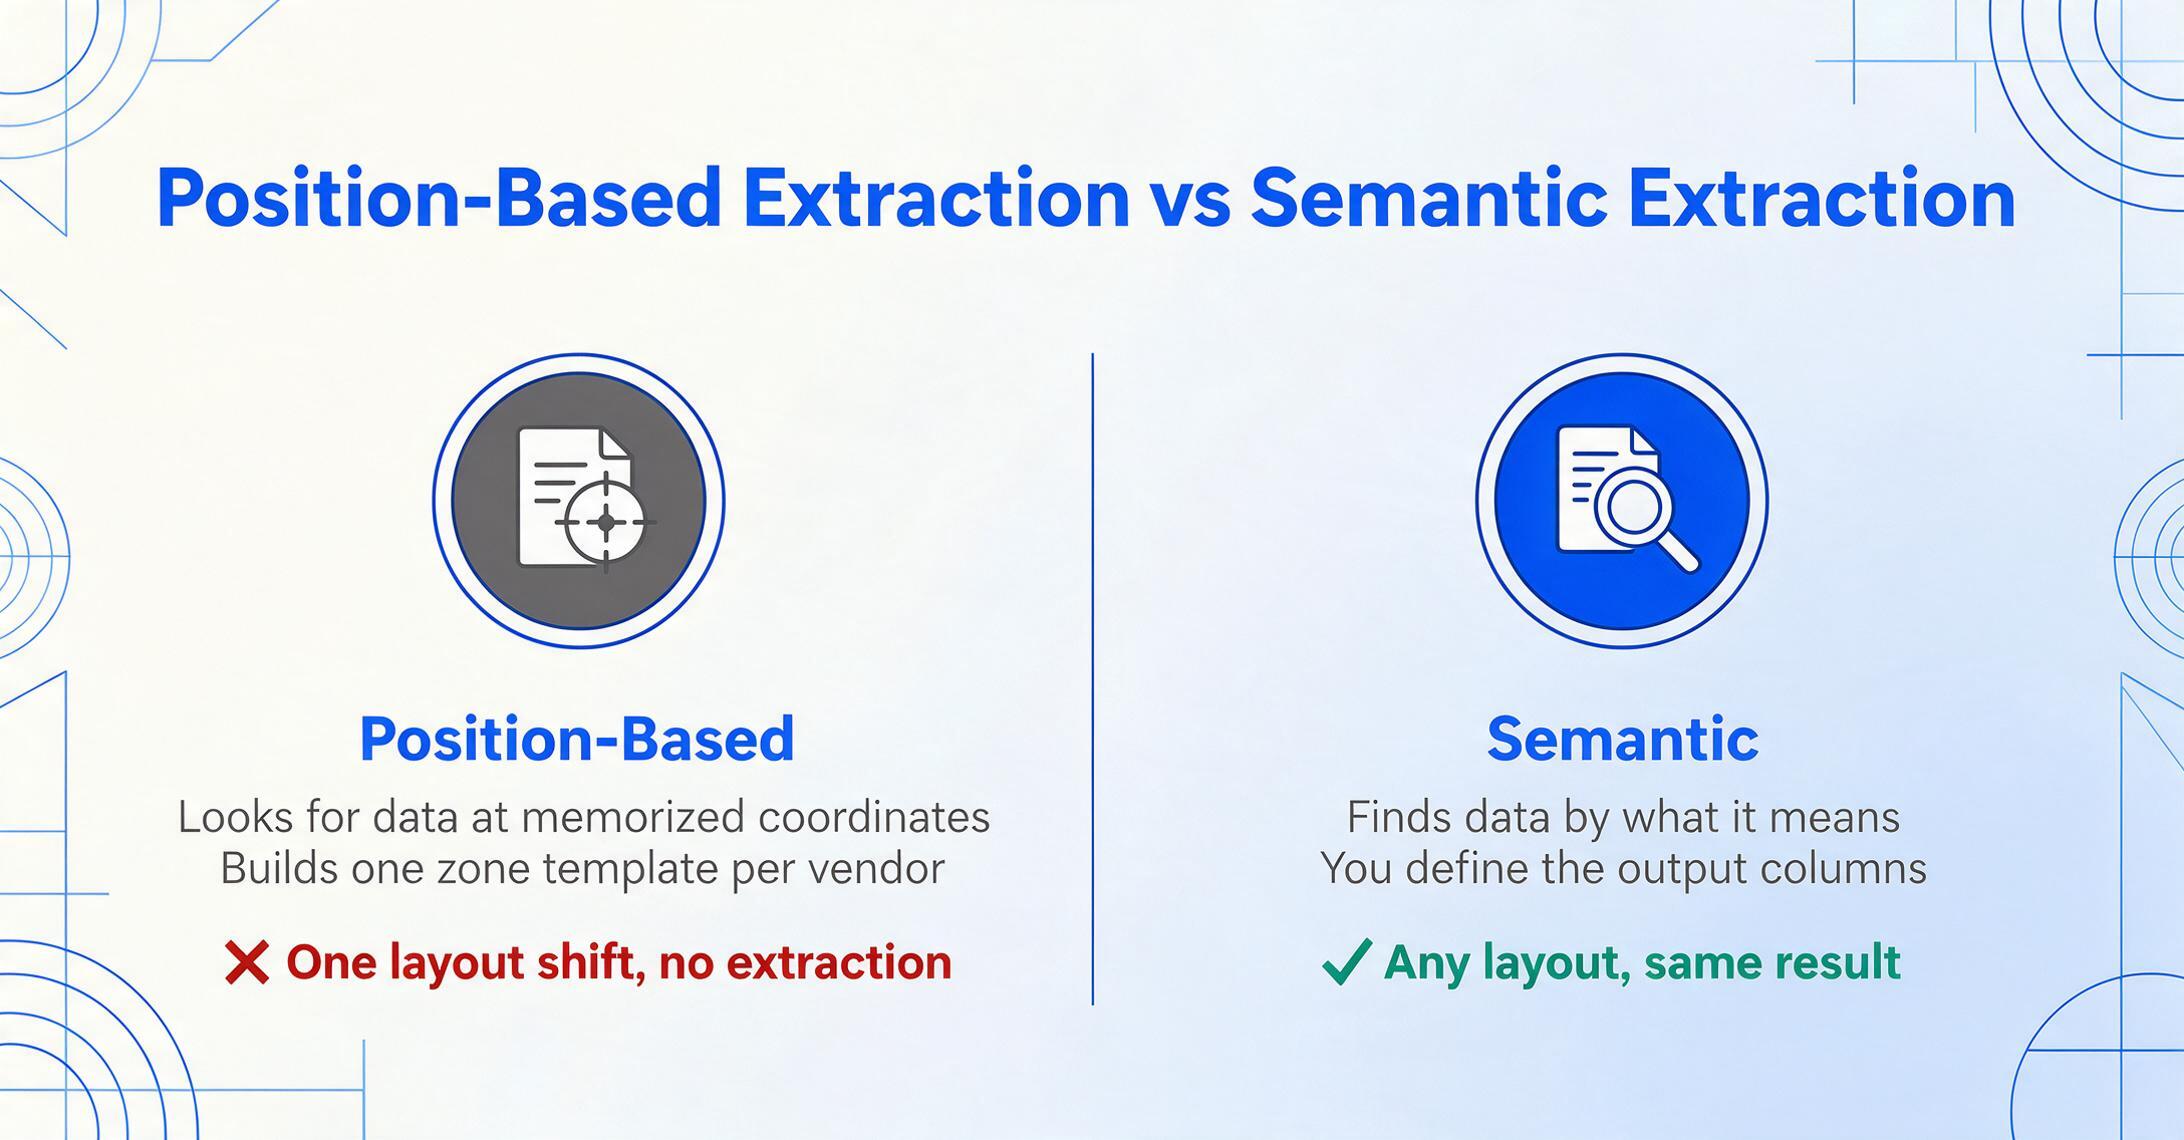
Au lieu de demander « où se trouvent les données sur la page ? », l'outil demande « que signifient ces données sur la page ? » C'est la différence entre l'extraction basée sur la position et l'extraction sémantique. Un outil basé sur la position doit savoir que le numéro de facture se trouve aux coordonnées (x : 450, y : 120). Un outil sémantique doit savoir que quelque part sur cette page, il existe une séquence de caractères qui fonctionne comme un numéro de facture — et il peut la trouver en comprenant le contenu du document, pas en mémorisant sa mise en page.
Ce changement transforme tout en aval. Pas de modèles à créer par fournisseur. Pas de zones à redessiner quand les mises en page changent. Pas de délai d'intégration pour les nouveaux fournisseurs. L'outil traite la diversité des formats comme la condition par défaut — car sémantiquement, une facture est une facture, que le fournisseur place le total en haut à droite ou en bas à gauche. La signification de « Numéro de facture » est la même, qu'il soit étiqueté « Facture n° », « N° fact. », « Réf. » ou présenté sans étiquette du tout, positionné bien en évidence en haut de la page.
C'est le paradigme derrière l'Extraction de colonnes personnalisées : vous définissez les colonnes de sortie souhaitées — « Numéro de facture », « Nom du fournisseur », « Total », « Date d'échéance » — et l'IA localise chaque valeur n'importe où sur n'importe quel document en comprenant ce qu'elle signifie, pas où elle se trouve. Vous définissez la sortie. L'IA comprend l'entrée. Le format n'a pas d'importance.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Essayez de téléverser deux factures de fournisseurs différents — des mises en page différentes, des positions de champs différentes, des conventions d'étiquetage différentes. Définissez les colonnes souhaitées une seule fois. Regardez l'IA localiser les mêmes points de données sur les deux documents sans aucune configuration par format. Ce n'est pas un créateur de modèles plus rapide. C'est un outil qui n'a jamais eu besoin de modèles en premier lieu. Pour un aperçu plus approfondi de comment fonctionne l'extraction sans modèle au niveau architectural, y compris sa comparaison à travers trois générations de technologies d'extraction, l'analyse technique détaille le moteur sous le capot.
Le changement de paradigme dont personne n'a parlé
Si vous utilisez des outils d'extraction de documents depuis quelques années, vous avez probablement intériorisé un ensemble d'attentes désormais obsolètes : qu'il vous faut un modèle par fournisseur, que les changements de format cassent l'extraction, que l'intégration d'un nouveau type de document est un projet de configuration. Ce n'étaient pas des attentes déraisonnables — elles décrivaient précisément le fonctionnement des outils. Mais ces outils fonctionnaient ainsi en raison d'une hypothèse, et cette hypothèse a été remplacée.
Le passage de l'extraction basée sur la position à l'extraction sémantique n'est pas une amélioration incrémentale. C'est un changement de paradigme. L'ancien paradigme disait : standardisez vos entrées, puis nous pourrons les traiter. Le nouveau paradigme dit : les entrées sont variées par nature — nous les traiterons telles qu'elles sont. L'ancien paradigme considérait la diversité des formats comme un problème à éliminer. Le nouveau paradigme la considère comme une donnée à prendre en compte.
C'est pourquoi qualifier la nouvelle approche de « meilleure OCR » passe à côté du sujet. L'OCR a toujours concerné la reconnaissance de caractères — transformer des pixels en texte. La nouvelle approche concerne la compréhension de documents — transformer une page en données structurées en comprenant ce qu'elle contient. L'OCR lit. L'IA comprend. La différence n'est pas une question de degré. C'est une différence de catégorie. Pour une démonstration pratique de l'extraction de données à partir de factures aux formats différents dans une seule feuille de calcul unifiée — sans créer de modèle pour chaque fournisseur — le guide pratique détaille le flux de travail réel.
Le nouveau principe
Les documents provenant de sources différentes auront toujours un aspect différent. Le rôle de l'outil est de les comprendre malgré tout — et non d'exiger qu'ils se conforment d'abord. Ce n'est pas une fonctionnalité. C'est le principe minimal viable pour un outil d'extraction de documents dans le monde réel.
FAQ
Pourquoi ne pas imposer un format unique à tous les fournisseurs ?
Parce que vous n'êtes pas leur seul client. Un fournisseur qui envoie des factures à 50 entreprises différentes doit répondre à 50 exigences de format distinctes. Même si vous parvenez à imposer votre modèle, votre équipe achats passe son temps à contrôler la conformité, rejeter les documents non conformes et maintenir la bibliothèque de modèles — un travail sans valeur ajoutée. La normalisation est un problème de coordination qui croît linéairement avec le nombre de partenaires. Vous pouvez gagner tactiquement, mais perdre stratégiquement à mesure que votre base fournisseurs s'élargit.
L'EDI ne résout-il pas le problème de diversité des formats ?
Partiellement, et seulement pour les grands partenaires. L'EDI (Échange de Données Informatisé) impose un format de données standardisé, éliminant les variations de mise en page. Mais sa mise en œuvre coûte des milliers d'euros par partenaire, nécessite une maintenance constante des correspondances, et n'est rentable que pour les relations à fort volume. Comme le souligne la communauté r/edi, même les fournisseurs connectés en EDI produisent des « données techniquement conformes mais pratiquement désordonnées » et « dérivent des formats convenus avec le temps ». Pour la longue traîne des petits et moyens fournisseurs, l'EDI n'est pas une option.
Les outils d'extraction par IA fonctionnent-ils sur les documents manuscrits ?
Oui, avec une précision variable selon la qualité de l'écriture. L'extraction par IA utilisant des modèles de vision atteint environ 88 à 95 % de précision sur les documents avec annotations manuscrites, et 75 à 90 % sur les documents entièrement manuscrits. Le texte imprimé propre atteint jusqu'à 99 %. L'écart de précision sur l'écriture manuscrite n'est pas une limite de l'approche sémantique — il reflète l'ambiguïté inhérente à l'écriture. La différence clé avec l'OCR basé sur des modèles est que les outils d'IA se dégradent progressivement sur l'écriture manuscrite plutôt que d'échouer complètement.
À partir de combien de fournisseurs les outils basés sur des modèles deviennent-ils ingérables ?
D'après les retours d'équipes AP réelles, le seuil se situe entre 50 et 100 fournisseurs. En dessous de 50, une personne dédiée peut maintenir les modèles en quelques heures par mois. Au-dessus de 100, la maintenance des modèles devient un travail à temps partiel — les changements de format, l'intégration de nouveaux fournisseurs et les erreurs silencieuses d'extraction s'accumulent plus vite qu'une seule personne ne peut les gérer. Le seuil varie selon le secteur : les entreprises de la construction, de la santé et de l'industrie — où les formats de documents sont intrinsèquement plus diversifiés — atteignent la limite plus tôt que celles qui reçoivent principalement des factures numériques standardisées.
L'extraction sémantique est-elle fiable à 100 % ?
Non. Aucune méthode d'extraction n'est fiable à 100 % sur tous les documents. L'extraction sémantique atteint jusqu'à 99 % sur les documents imprimés propres et se dégrade sur les scans de mauvaise qualité, les écritures manuscrites abondantes et les mises en page extrêmement complexes. La différence avec l'OCR par modèle n'est pas qu'elle soit parfaite — c'est qu'elle ne casse pas entièrement lorsque le format change. Un outil basé sur des modèles échoue de manière catastrophique sur une nouvelle mise en page. La précision d'un outil sémantique peut passer de 99 % à 92 % sur un format inhabituel, mais il produit toujours un résultat utilisable. Le mode de défaillance importe autant que le plafond de précision.