Por que Toda Ferramenta de Extração de Documentos
Presume que os Documentos São Iguais
Todo o setor de extração de documentos foi construído sobre uma premissa que ninguém nunca parou para questionar: que documentos de fontes diferentes serão parecidos o suficiente para serem processados da mesma forma. A premissa não era maliciosa. Era herdada. Veio de um século de pensamento industrial que nos ensinou que a padronização é o único caminho para a eficiência. Mas documentos não são peças de motor, e o mundo real nunca recebeu o aviso.
Principais Conclusões
- Todo o setor de extração de documentos emprestou sua arquitetura da linha de montagem de Henry Ford de 1913 — presumindo que todo documento de todo fornecedor deveria ser igual para ser processado com eficiência.
- A manutenção de modelos custa de 5 a 10 horas por mês com apenas 100 fornecedores — não porque você está com falta de pessoal, mas porque o design da ferramenta espera que o mundo seja mais simples do que realmente é.
- Uma ferramenta que lê "Invoice Number" pelo que significa, em vez de onde está localizado, não apenas processa mais rápido — ela elimina a manutenção de modelos como uma categoria de trabalho da sua descrição de cargo por completo.
A Herança da Linha de Montagem
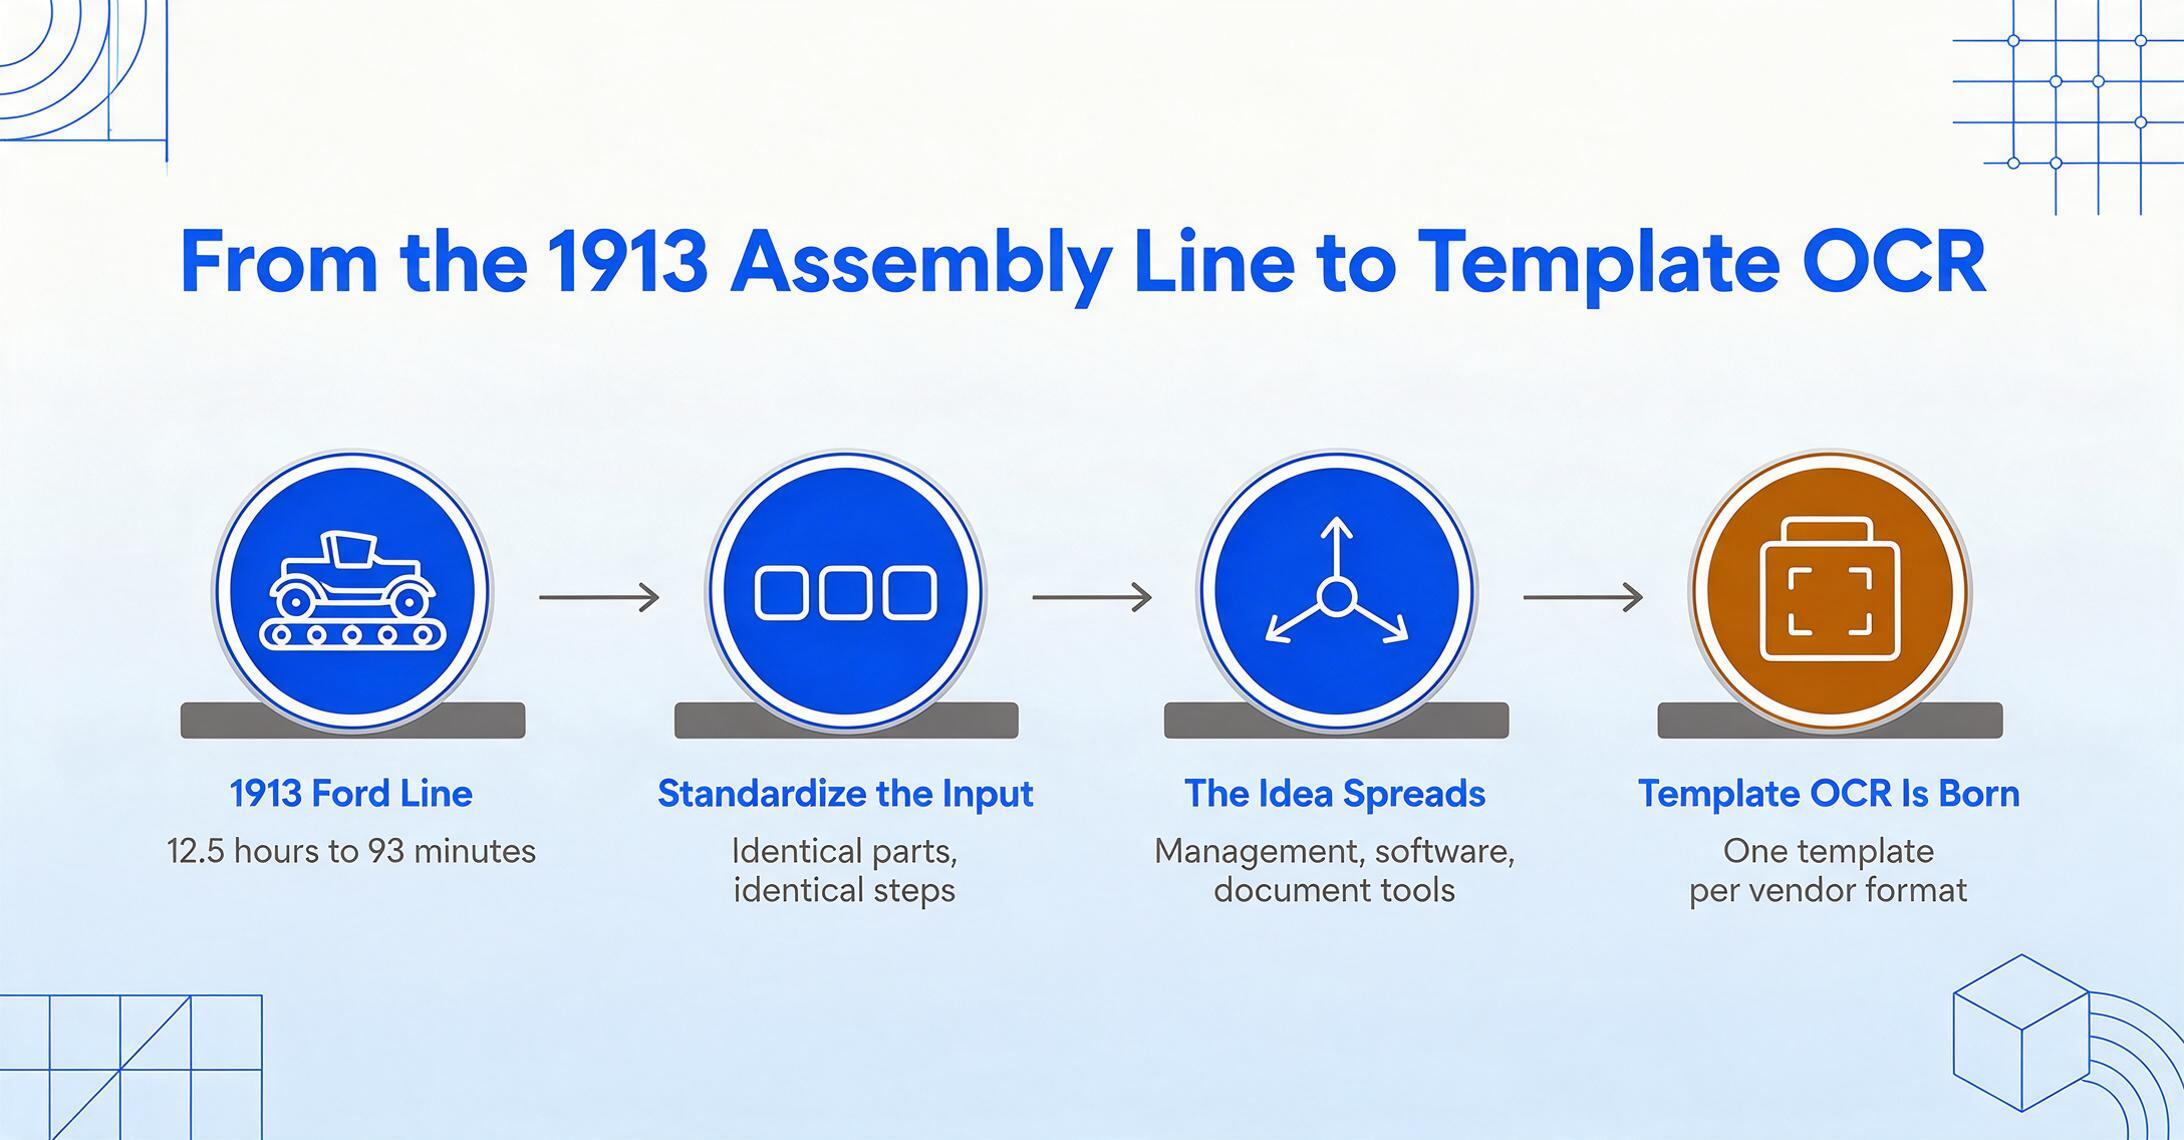
A suposição de que os documentos devem ser parecidos não veio do processamento de documentos. Veio da manufatura. Mais especificamente, de um conjunto de ideias sobre eficiência que domina o pensamento industrial há mais de um século.
Em 1913, a fábrica de Highland Park de Henry Ford introduziu a linha de montagem móvel e reduziu o tempo de montagem do chassi de 12,5 horas para 93 minutos. A percepção era simples e profunda: se toda entrada é idêntica, toda operação pode ser otimizada. Peças padronizadas alimentando processos padronizados produziam saídas padronizadas a uma velocidade e um custo sem precedentes. Essa ideia não se limitou às fábricas. Colonizou a teoria da administração (a administração científica de Taylor), a engenharia de software (o modelo cascata) e, por fim, o design das ferramentas de processamento de documentos.
Quando a primeira geração de softwares de extração de documentos foi criada — OCR por modelo, OCR zonal, sistemas de análise baseados em regras —, os engenheiros que os projetavam recorreram naturalmente ao kit de ferramentas de eficiência que lhes haviam ensinado. A lógica parecia impecável: defina onde cada campo fica em um documento, codifique essa posição como uma regra, e todo documento seguinte que corresponda ao modelo pode ser processado automaticamente. Um modelo por formato. Mantenha o modelo. Escale por meio da padronização.
O que é notável não é que eles tenham feito essa suposição. É que, por décadas, o setor a tratou como evidentemente correta — uma restrição de projeto, e não uma escolha de projeto. A suposição estava tão enraizada na arquitetura que a maioria das ferramentas nem sequer a documentava como uma limitação. Era a água em que o peixe nadava.
Quando a Realidade se Recusa a Padronizar
Se a suposição é que documentos de fontes diferentes serão parecidos o suficiente para compartilhar um modelo de processamento, então o estado real dos documentos empresariais é uma refutação direta dessa suposição em todos os níveis.
Pegue o caso mais simples: faturas. Uma empresa de médio porte pode receber faturas de 20 a 50 fornecedores diferentes. Algumas são PDFs digitais gerados pelo QuickBooks ou Xero — estruturados, mas com nomes de campos que variam ("Invoice No." vs "Invoice #" vs "Reference"). Algumas vêm de ERPs corporativos como SAP Ariba ou Coupa, exportadas como PDFs projetados para leitura humana, não para extração por máquina — documentos de várias páginas com itens de linha que atravessam tabelas entre quebras de página. Algumas são digitalizações de faturas em papel de fornecedores menores, completas com carimbos, anotações manuscritas e fotografias em ângulo. A caixa de entrada de faturas de uma única empresa contém mais diversidade de formatos do que os projetistas de OCR com modelo jamais consideraram.
E faturas são o caso fácil. Ordens de compra, notas de entrega, relatórios de inspeção, certificados de seguro, extratos bancários, laudos laboratoriais — cada tipo de documento traz seu próprio ecossistema de variação de formato. Uma construtora que lida com 30 subcontratados recebe pedidos de pagamento AIA G702 de alguns, relatórios diários manuscritos de outros e PDFs gerados internamente pelo próprio ERP para o restante.
A comunidade r/procurement do Reddit documentou isso exaustivamente. Um tópico captura a realidade com precisão: "Os fornecedores não seguem formatos. Até fornecedores vinculados por EDI produzem dados tecnicamente compatíveis, mas praticamente bagunçados. E eles 'se desviam' dos formatos acordados com o tempo." Outro: "Indicamos claramente o formato da fatura no aditivo do MSA. Os fornecedores conhecem os sistemas. E ainda assim, 5-10% chegam inutilizáveis."
Tentar impor padronização — enviar um modelo aos fornecedores, exigir conformidade com EDI, rejeitar documentos não conformes — é combater a entropia com papelada. Funciona parcialmente, temporariamente e com custo significativo para os relacionamentos. A diversidade de formatos não é um defeito do sistema. É o estado natural do sistema. Cada fornecedor usa um software de contabilidade diferente. Cada departamento tem suas próprias convenções de relatório. Cada indivíduo preenche formulários de maneira diferente. Isso não é caos a ser eliminado — é a realidade a ser acomodada.
A refutação central
A diversidade de formatos não é um problema que processos melhores possam resolver. É a condição padrão da comunicação empresarial. Uma ferramenta que exige consistência de formato não está resolvendo um problema de documentos — está exigindo que o mundo se remodele para se encaixar na ferramenta.
Como a Suposição se Tornou Software
A arquitetura de OCR com modelo é a tradução mais literal da suposição de padronização para código. Veja como funciona — e por que "funciona" é generoso.
Um sistema de OCR com modelo exige que você faça algo antes de processar um único documento: definir um modelo. Para cada formato de fornecedor, você desenha zonas — retângulos ao redor de onde aparece o número da fatura, onde fica a data, onde os itens de linha começam e terminam. A ferramenta memoriza essas coordenadas. Quando um novo documento chega desse fornecedor, ela procura texto nas mesmas posições e extrai o que encontrar. Se um campo se deslocou dois centímetros para a direita porque o fornecedor atualizou o timbre, a ferramenta extrai os dados errados — ou nada. Se um fornecedor adiciona uma coluna à sua tabela de itens de linha, toda a extração da tabela entra em colapso. Se um novo fornecedor envia sua primeira fatura, não há modelo, então não há extração.
Essa arquitetura tem um nome para a falha: "quebra de modelo". A própria linguagem do setor revela a fragilidade — os modelos não degradam gradualmente, eles quebram. Uma mudança de layout e a lógica de extração deixa de funcionar por completo. A ferramenta não se adapta, não adivinha, não tenta uma alternativa. Ela foi projetada com a premissa de que o formato é constante. Quando a premissa falha, a ferramenta falha junto.
O mais revelador é como essa arquitetura molda a experiência do usuário com a ferramenta. A ferramenta não se apresenta como "podemos processar documentos que correspondem a esses modelos específicos". Ela se apresenta como "podemos processar documentos". A limitação fica oculta pelo design — até o formato mudar e a extração falhar. A conclusão natural do usuário é "devo ter configurado algo errado" ou "esta ferramenta não funciona". O problema real é mais profundo: toda a lógica da ferramenta depende de uma premissa que a realidade viola rotineiramente.
O Custo Oculto de Exigir Padronização
O custo da extração baseada em modelo não é a licença do software. É tudo o que acontece ao redor do software para mantê-lo funcional em um mundo que se recusa a ser padronizado.
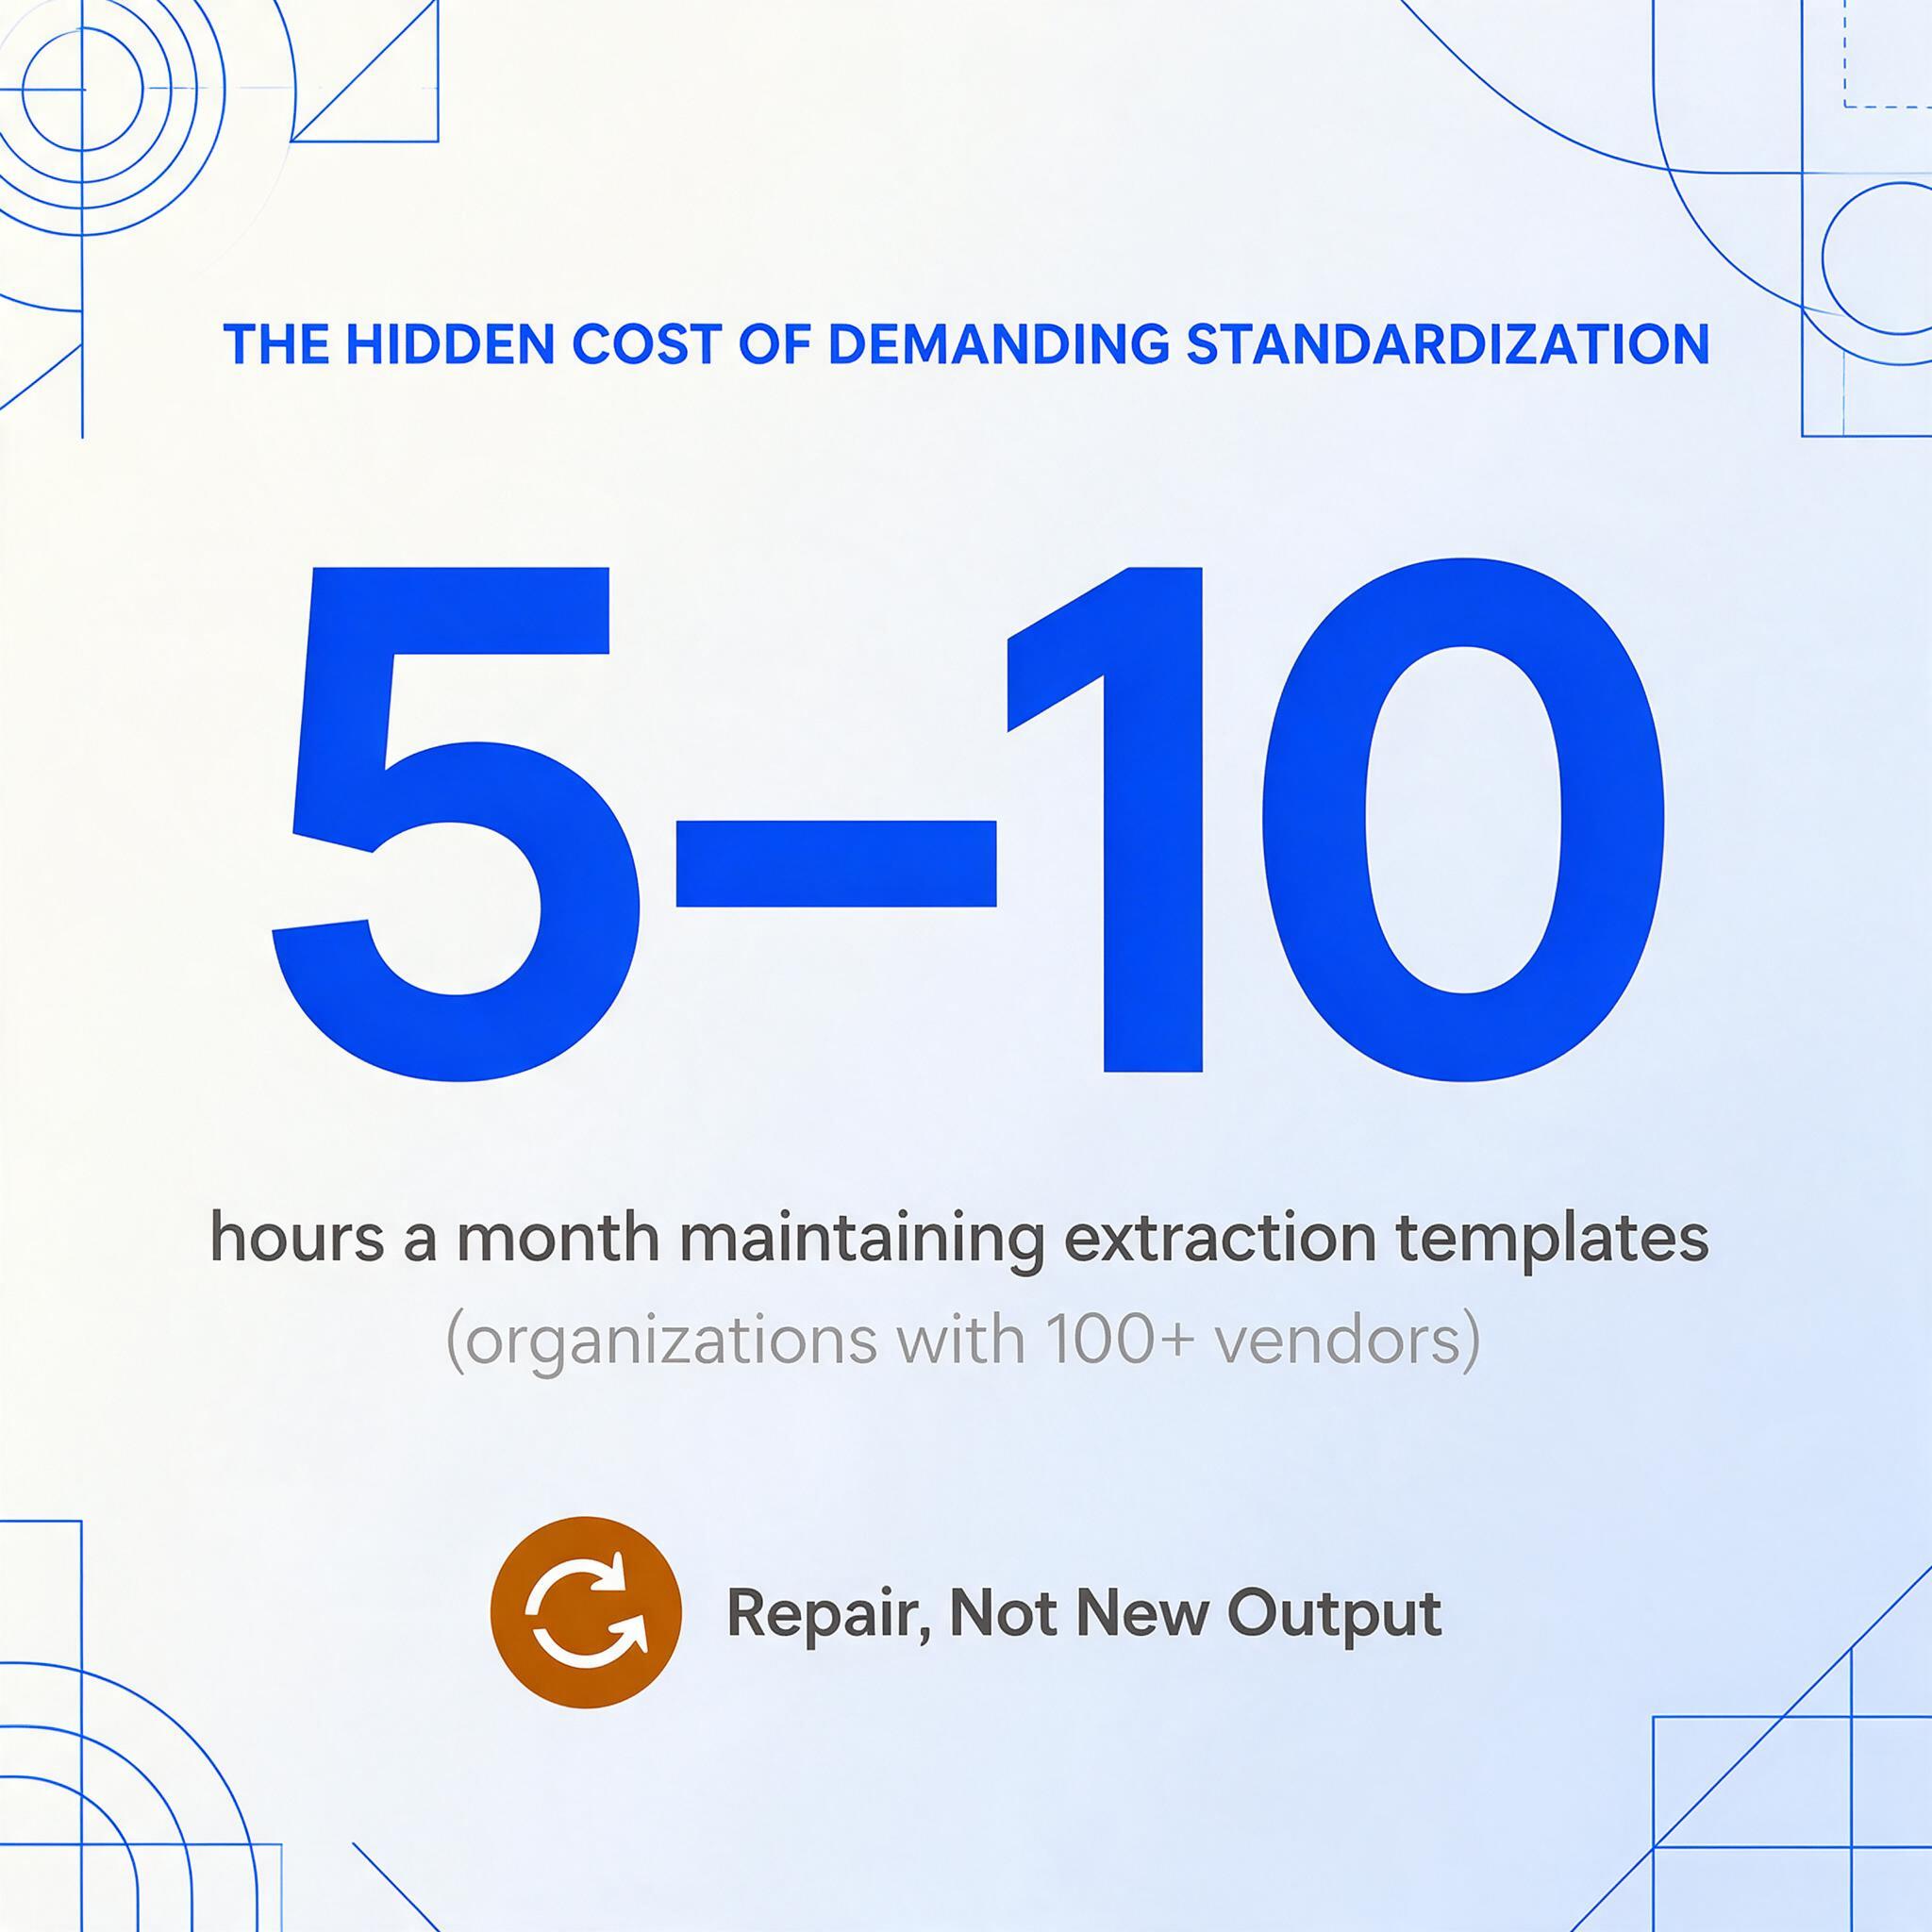
A manutenção de modelos é uma despesa operacional recorrente. Organizações com mais de 100 fornecedores e OCR baseado em modelo normalmente gastam de 5 a 10 horas por mês apenas mantendo modelos — redesenhando zonas após mudanças de layout, reconstruindo regras para novos formatos de fornecedor, testando a precisão da extração após cada atualização. É um trabalho que não produz nada novo. Ele existe apenas para reparar uma ferramenta cujo design espera que o mundo seja mais simples do que é.
O onboarding de novos fornecedores se torna um gargalo. Quando um novo fornecedor envia sua primeira fatura, a equipe de contas a pagar tem duas opções: processá-la manualmente enquanto alguém constrói um modelo, ou esperar pelo modelo antes de processar. De qualquer forma, a exigência de modelo transforma uma operação rotineira em um projeto de configuração. Multiplique isso por dezenas de novos fornecedores por ano, e a sobrecarga se acumula.
Erros silenciosos se acumulam nos processos seguintes. Quando um modelo quebra parcialmente — alguns campos se deslocam, outros não — a extração não falha de forma evidente. Ela falha silenciosamente, mapeando valores para contas erradas, datas para campos errados, nomes de fornecedores para registros errados. Esses erros seguem adiante para sistemas ERP, relatórios financeiros e execuções de pagamento. Eles aparecem semanas ou meses depois, durante a conciliação, quando rastreá-los de volta até a camada de extração exige um esforço investigativo que a maioria das equipes não tem capacidade para realizar.
As relações com fornecedores se deterioram. Quando uma equipe de Contas a Pagar rejeita faturas por não conformidade de formato ou atrasa o pagamento enquanto aguarda correções no modelo, os fornecedores percebem. A relação de compras, que a empresa investiu para construir, fica desgastada por uma limitação técnica que nada tem a ver com o desempenho do fornecedor.
Esses custos são invisíveis em uma planilha de avaliação de software. Eles não aparecem na comparação da página de preços. Mas são a diferença entre uma ferramenta que reduz o trabalho e uma ferramenta que transfere o trabalho de um tipo (digitação manual) para outro (manutenção de modelo) — e chama isso de automação.
Como é uma ferramenta pós-suposição
Se você parar de supor que os documentos terão a mesma aparência, como fica a arquitetura de extração? A resposta começa com uma pergunta diferente.
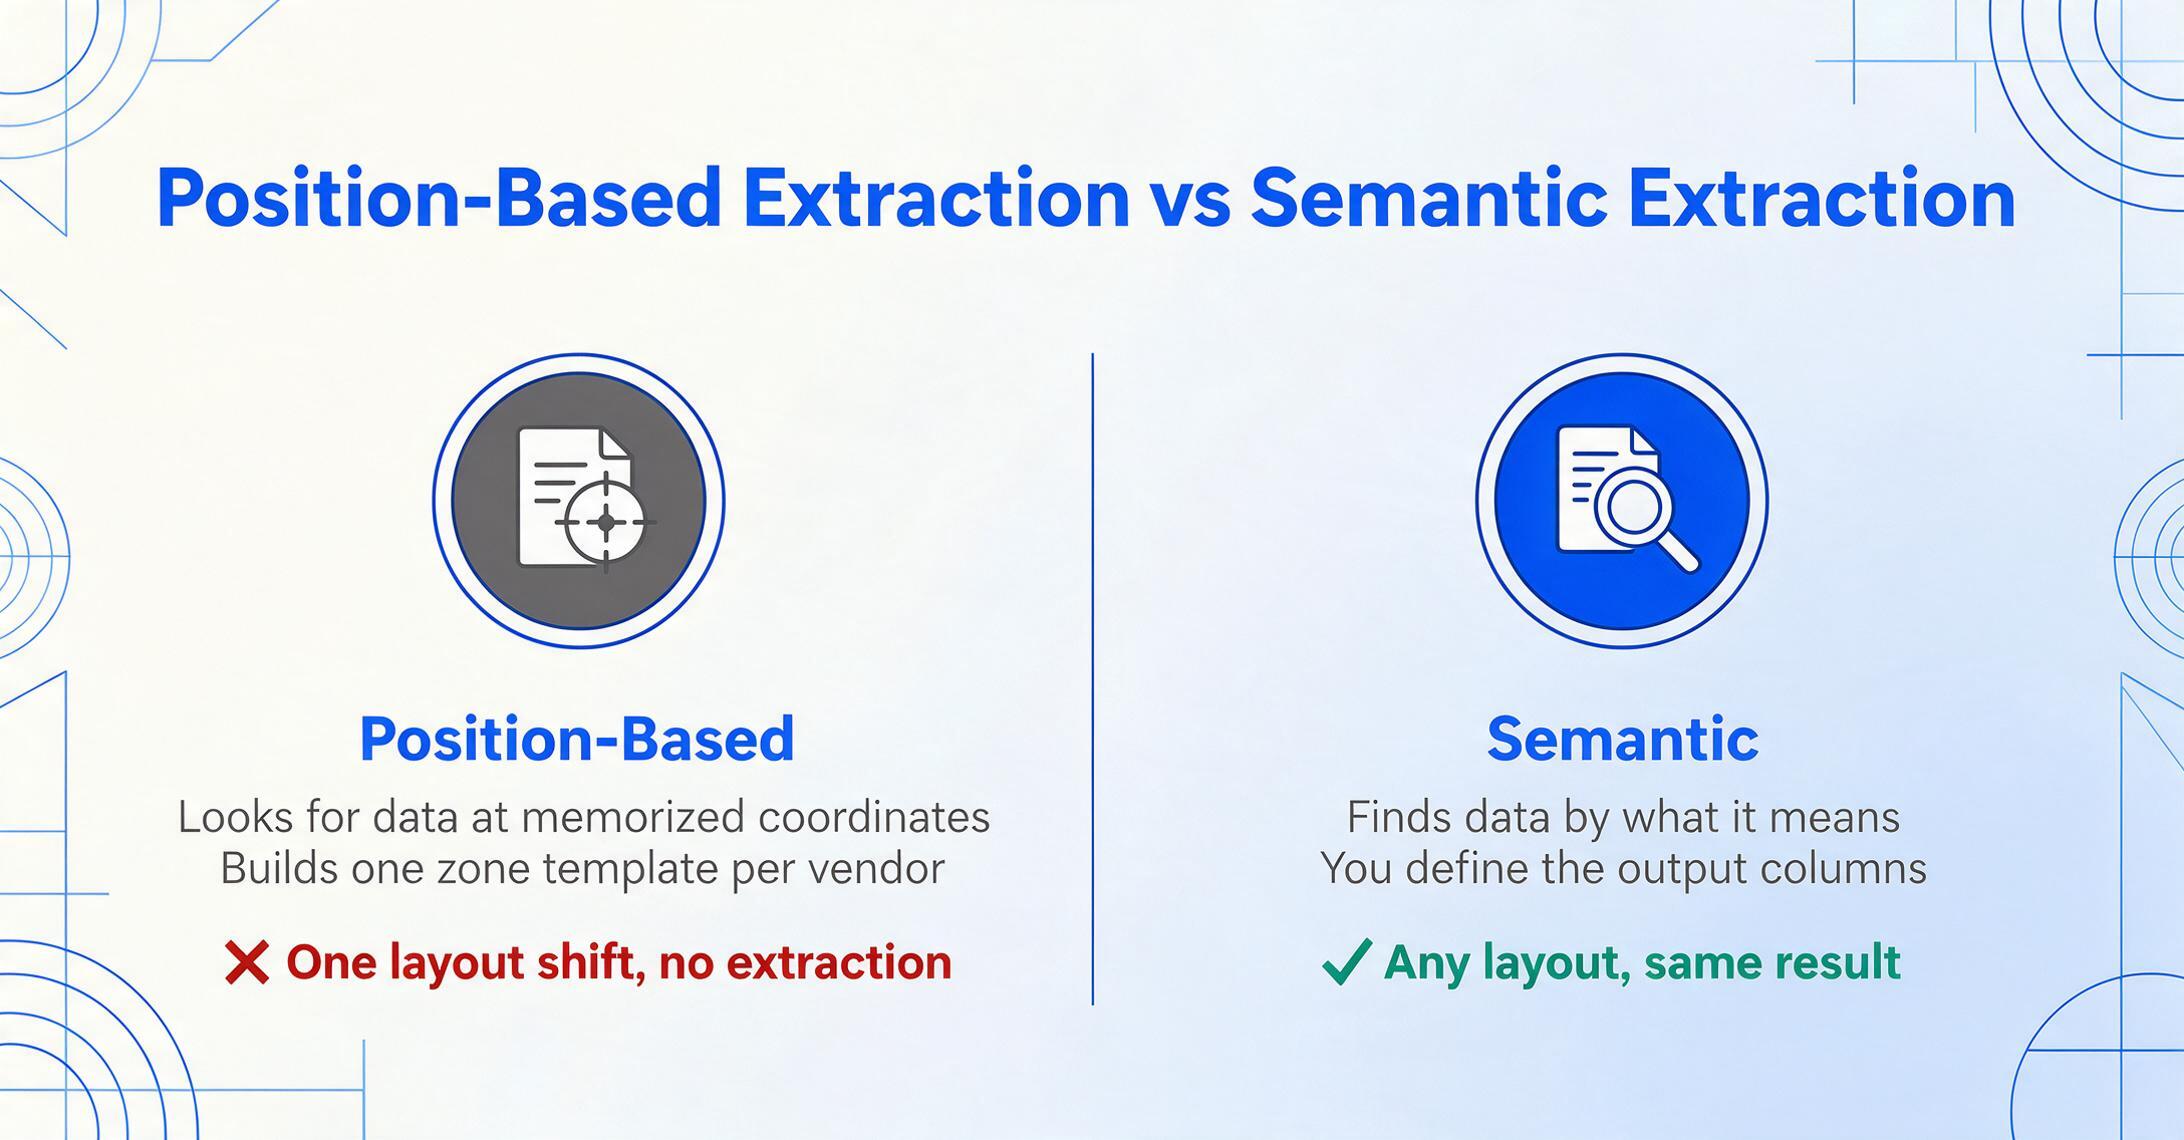
Em vez de perguntar "onde está o dado localizado na página?", a ferramenta pergunta "o que esse dado significa na página?" Essa é a diferença entre extração baseada em posição e extração semântica. Uma ferramenta baseada em posição precisa saber que o número da fatura está nas coordenadas (x: 450, y: 120). Uma ferramenta semântica precisa saber que em algum lugar desta página há uma sequência de caracteres que funciona como número de fatura — e consegue encontrá-la entendendo o conteúdo do documento, não memorizando seu layout.
Essa mudança altera tudo nos processos seguintes. Nenhum modelo para criar por fornecedor. Nenhuma zona para redesenhar quando os layouts mudam. Nenhum atraso de integração para novos fornecedores. A ferramenta trata a diversidade de formatos como a condição padrão — porque, semanticamente, uma fatura é uma fatura independentemente de o fornecedor ter colocado o total no canto superior direito ou no canto inferior esquerdo. O significado de "Número da Fatura" é o mesmo quer esteja rotulado como "Invoice #", "Inv. No.", "Ref." ou apresentado sem rótulo algum, posicionado com destaque no topo da página.
Este é o paradigma por trás da Extração de Colunas Personalizadas: você define as colunas de saída que deseja — "Número da Fatura", "Nome do Fornecedor", "Total", "Data de Vencimento" — e a IA localiza cada valor em qualquer lugar de qualquer documento entendendo o que ele significa, não onde ele está. Você define a saída. A IA entende a entrada. O formato não importa.
Os arquivos são processados com segurança e não são armazenados.
Tente enviar duas faturas de fornecedores diferentes — layouts diferentes, posições de campos diferentes, convenções de rótulos diferentes. Defina as colunas que você quer uma única vez. Veja a IA localizar os mesmos pontos de dados nos dois documentos sem nenhuma configuração por formato. Isto não é um construtor de modelos mais rápido. É uma ferramenta que nunca precisou de modelos. Para uma análise mais aprofundada de como a extração sem modelo funciona no nível arquitetural, incluindo como ela se compara ao longo de três gerações de tecnologia de extração, o detalhamento técnico cobre o motor por trás disso.
A Mudança de Paradigma Que Ninguém Anunciou
Se você usa ferramentas de extração de documentos há alguns anos, provavelmente internalizou um conjunto de expectativas que agora estão obsoletas: que você precisa de um modelo por fornecedor, que mudanças de formato quebram a extração, que integrar um novo tipo de documento é um projeto de configuração. Essas não eram expectativas irracionais — elas descreviam com precisão como as ferramentas funcionavam. Mas as ferramentas funcionavam assim por causa de uma suposição, e essa suposição foi substituída.
A mudança da extração baseada em posição para a extração semântica não é uma melhoria incremental. É uma mudança de paradigma. O paradigma antigo dizia: padronize suas entradas, e então poderemos processá-las. O novo paradigma diz: as entradas são variadas por natureza — vamos processá-las como elas são. O paradigma antigo tratava a diversidade de formatos como um problema a ser eliminado. O novo paradigma a trata como um dado a ser acomodado.
É por isso que chamar a nova abordagem de "OCR melhor" perde o ponto. O OCR sempre foi sobre reconhecimento de caracteres — transformar pixels em texto. A nova abordagem é sobre compreensão de documentos — transformar uma página em dados estruturados ao compreender o que está nela. O OCR lê. A IA entende. A diferença não é uma questão de grau. É uma diferença de categoria. Para um passo a passo prático de extrair dados de faturas com formatos diferentes em uma única planilha unificada — sem construir um modelo para cada fornecedor — o guia prático percorre o fluxo de trabalho real.
A nova premissa
Documentos de fontes diferentes sempre parecerão diferentes. O trabalho da ferramenta é entendê-los de qualquer forma — não exigir que se conformem primeiro. Isso não é um recurso. É a premissa mínima viável para uma ferramenta de extração de documentos no mundo real.
Perguntas frequentes
Por que não simplesmente fazer todos os fornecedores usarem o mesmo formato?
Porque você não é o único cliente deles. Um fornecedor que envia faturas para 50 empresas diferentes enfrenta 50 requisitos de formato distintos. Mesmo que você consiga fazer seus fornecedores usarem seu modelo, sua equipe de compras gasta tempo impondo conformidade, rejeitando documentos fora do padrão e mantendo a biblioteca de modelos — trabalho que não gera valor de negócio. A padronização é um problema de coordenação que escala linearmente com o número de parceiros comerciais. É uma batalha que você pode vencer taticamente e perder estrategicamente conforme sua base de fornecedores cresce.
O EDI não resolve o problema da diversidade de formatos?
Parcialmente, e apenas para grandes parceiros comerciais. O EDI (Electronic Data Interchange) impõe um formato de dados padronizado, o que elimina a variação de layout. Mas a implementação de EDI custa milhares de dólares por parceiro comercial, exige manutenção contínua de mapeamento e só é viável para relações de alto volume. Como observa a comunidade r/edi, até fornecedores conectados por EDI produzem "dados tecnicamente compatíveis, mas praticamente desorganizados" e "se afastam dos formatos acordados com o tempo". Para a longa cauda de fornecedores pequenos e médios, o EDI não é uma opção.
As ferramentas de extração por IA funcionam em documentos manuscritos?
Sim, com precisão que varia conforme a qualidade da caligrafia. A extração por IA usando modelos de visão alcança aproximadamente 88-95% de precisão em documentos com anotações manuscritas e 75-90% em documentos totalmente manuscritos. Texto impresso nítido chega a 99%. A diferença de precisão em manuscritos não é uma limitação da abordagem semântica — é um reflexo da ambiguidade inerente à caligrafia. A principal diferença em relação ao OCR por modelo é que as ferramentas de IA degradam de forma gradual em manuscritos, em vez de falhar completamente.
Em que ponto as ferramentas baseadas em modelo se tornam impossíveis de gerenciar?
O consenso das equipes de AP do mundo real é algo entre 50 e 100 fornecedores. Abaixo de 50, uma pessoa dedicada consegue manter os modelos com algumas horas por mês. Acima de 100, a manutenção de modelos se torna um trabalho de meio período — e mudanças de formato, integração de novos fornecedores e erros silenciosos de extração se acumulam mais rápido do que uma pessoa consegue gerenciar. O limite varia por setor: empresas de construção, saúde e manufatura — onde os formatos de documento são naturalmente mais diversos — atingem o limite mais cedo do que empresas que recebem principalmente faturas digitais padronizadas.
A extração semântica é 100% precisa?
Não. Nenhum método de extração é 100% preciso em todos os documentos. A extração semântica alcança até 99% em documentos impressos de boa qualidade e piora em digitalizações de baixa qualidade, escrita à mão intensa e layouts extremamente complexos. A diferença em relação ao OCR baseado em modelo não é que ela seja perfeita — é que ela não quebra completamente quando o formato muda. Uma ferramenta baseada em modelo falha catastroficamente em um novo layout. A precisão de uma ferramenta semântica pode cair de 99% para 92% em um formato incomum, mas ela ainda produz resultados utilizáveis. O modo de falha importa tanto quanto o teto de precisão.