Por qué toda herramienta de extracción de documentos
asume que los documentos se ven iguales
Toda la industria de extracción de documentos se construyó sobre una premisa que nadie se detuvo a cuestionar: que los documentos de diferentes fuentes se verán lo suficientemente similares como para procesarse de la misma manera. La premisa no era maliciosa. Era heredada. Provenía de un siglo de pensamiento industrial que nos enseñó que la estandarización es el único camino hacia la eficiencia. Pero los documentos no son piezas de motor, y el mundo real nunca recibió el mensaje.
Conclusiones clave
- Toda la industria de extracción de documentos tomó prestada su arquitectura de la línea de ensamblaje de Henry Ford de 1913 — asumiendo que cada documento de cada proveedor debería verse igual para procesarse de manera eficiente.
- El mantenimiento de plantillas cuesta de 5 a 10 horas al mes con solo 100 proveedores — no porque usted tenga poco personal, sino porque el diseño de la herramienta espera que el mundo sea más simple de lo que realmente es.
- Una herramienta que lee «Número de factura» por lo que significa en lugar de dónde se encuentra no solo procesa más rápido — elimina el mantenimiento de plantillas como categoría de trabajo de su descripción de puesto por completo.
La Herencia de la Línea de Ensamblaje
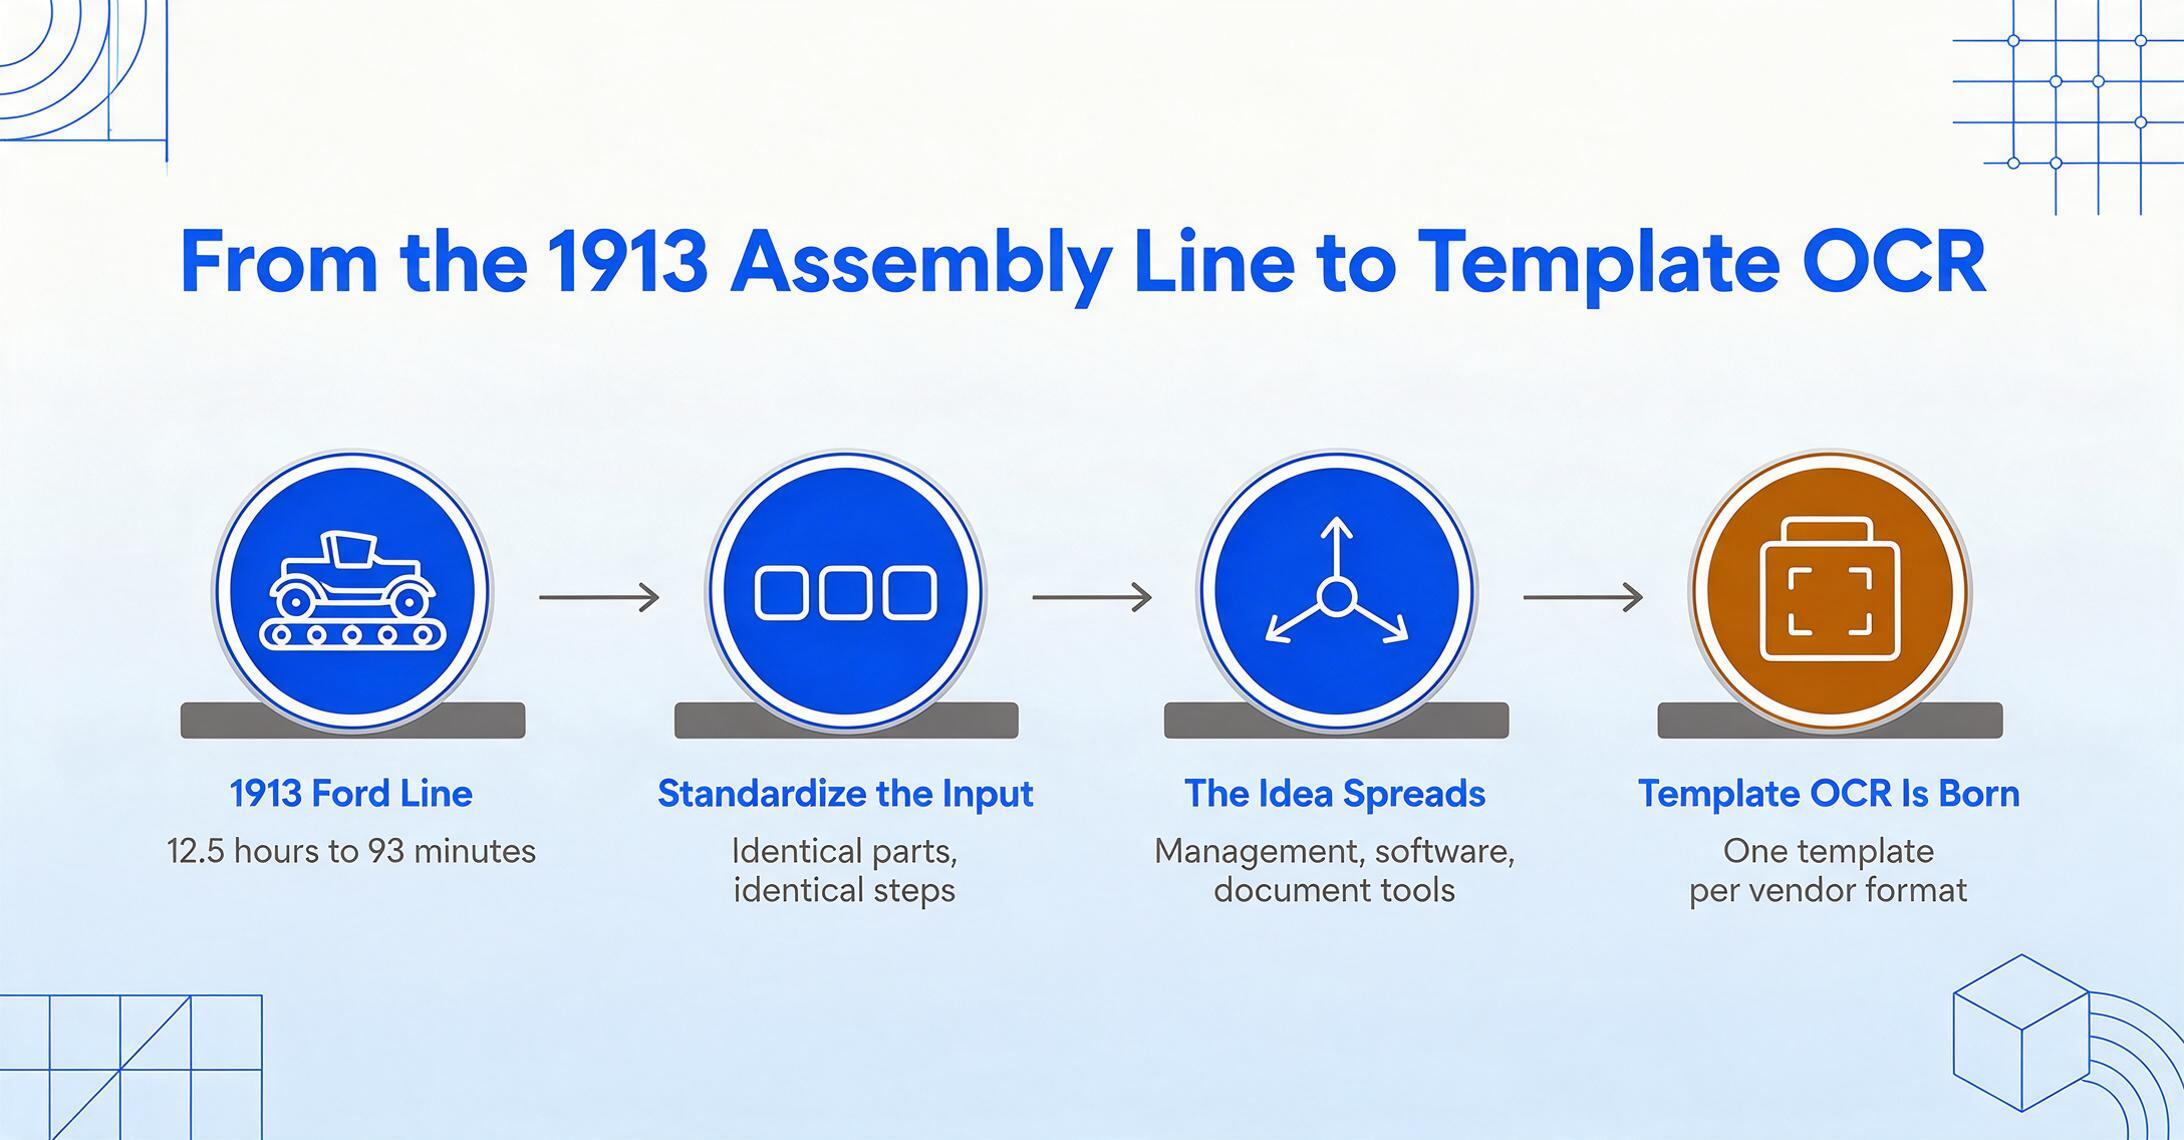
La suposición de que los documentos deberían verse iguales no provino del procesamiento de documentos. Provino de la manufactura. Específicamente, de un conjunto de ideas sobre eficiencia que ha dominado el pensamiento industrial durante más de un siglo.
En 1913, la planta de Highland Park de Henry Ford introdujo la línea de ensamblaje móvil y redujo el tiempo de ensamblaje del chasis de 12.5 horas a 93 minutos. La idea era simple y profunda: si cada insumo es idéntico, cada operación puede optimizarse. Las piezas estandarizadas que alimentaban procesos estandarizados producían resultados estandarizados a una velocidad y costo sin precedentes. Esta idea no se limitó a las fábricas. Colonizó la teoría de gestión (la gestión científica de Taylor), la ingeniería de software (el modelo en cascada) y, eventualmente, el diseño de herramientas de procesamiento de documentos.
Cuando se construyó la primera generación de software de extracción de documentos — OCR de plantillas, OCR zonal, sistemas de análisis basados en reglas — los ingenieros que los diseñaron recurrieron naturalmente al conjunto de herramientas de eficiencia que les habían enseñado. La lógica parecía infalible: definir dónde se ubica cada campo en un documento, codificar esa posición como una regla, y cada documento posterior que coincida con la plantilla puede procesarse automáticamente. Una plantilla por formato. Mantener la plantilla. Escalar mediante la estandarización.
Lo notable no es que hicieran esta suposición. Es que durante décadas, la industria la trató como evidentemente correcta — una restricción de diseño en lugar de una elección de diseño. La suposición estaba tan arraigada en la arquitectura que la mayoría de las herramientas ni siquiera la documentaban como una limitación. Era el agua en la que nadaba el pez.
Cuando la Realidad se Niega a Estandarizarse
Si la suposición es que los documentos de diferentes fuentes se verán lo suficientemente similares como para compartir una plantilla de procesamiento, entonces el estado real de los documentos comerciales es una refutación directa de esa suposición en todos los niveles.
Tomemos el caso más simple: las facturas. Una empresa mediana podría recibir facturas de 20 a 50 proveedores diferentes. Algunas son PDFs digitales generados por QuickBooks o Xero — estructurados pero con nombres de campos que varían ("Invoice No." vs "Invoice #" vs "Reference"). Algunas provienen de ERPs empresariales como SAP Ariba o Coupa, exportadas como PDFs diseñados para lectura humana, no para extracción automática — documentos de varias páginas con partidas que abarcan tablas a través de saltos de página. Algunas son escaneos de facturas en papel de proveedores más pequeños, completos con sellos, notas manuscritas y fotografía en ángulo. La bandeja de entrada de facturas de una sola empresa contiene más diversidad de formatos de la que los diseñadores de OCR de plantillas jamás contemplaron.
Y las facturas son el caso fácil. Órdenes de compra, albaranes, informes de inspección, certificados de seguro, extractos bancarios, informes de laboratorio — cada tipo de documento trae su propio ecosistema de variación de formato. Una empresa de construcción que trabaja con 30 subcontratistas recibe solicitudes de pago AIA G702 de algunos, informes diarios manuscritos de otros y PDFs generados internamente por su propio ERP para el resto.
La comunidad de Reddit r/procurement ha documentado esto exhaustivamente. Un hilo captura la realidad con precisión: "Vendors don't follow formats. Even EDI-linked suppliers produce technically compliant but practically messy data. And they 'drift' from agreed formats over time." Otro: "We clearly indicate the invoice format in the MSA addendum. Suppliers are familiar with the systems. And still, 5-10% come through unusable."
Intentar imponer la estandarización — enviar a los proveedores una plantilla, exigir cumplimiento de EDI, rechazar documentos no conformes — es luchar contra la entropía con papeleo. Funciona parcialmente, temporalmente y a un costo significativo en las relaciones. La diversidad de formatos no es un error del sistema. Es el estado natural del sistema. Cada proveedor usa un software de contabilidad diferente. Cada departamento tiene sus propias convenciones de informes. Cada individuo llena formularios de manera diferente. Esto no es caos que deba eliminarse — es realidad que debe adaptarse.
La refutación central
La diversidad de formatos no es un problema que mejores procesos puedan resolver. Es la condición predeterminada de la comunicación empresarial. Una herramienta que exige consistencia de formato no está resolviendo un problema de documentos — está exigiendo que el mundo se reforme para adaptarse a la herramienta.
Cómo la suposición se convirtió en software
La arquitectura de OCR con plantillas es la traducción más literal de la suposición de estandarización en código. Así es como funciona — y por qué "funciona" es generoso.
Un sistema de OCR con plantillas necesita que usted haga algo antes de poder procesar un solo documento: definir una plantilla. Para cada formato de proveedor, usted dibuja zonas — rectángulos alrededor de donde aparece el número de factura, donde está la fecha, donde comienzan y terminan las partidas. La herramienta recuerda estas coordenadas. Cuando llega un nuevo documento de ese proveedor, busca texto en las mismas posiciones y extrae lo que encuentra. Si un campo se ha desplazado dos centímetros a la derecha porque el proveedor actualizó su membrete, la herramienta extrae los datos incorrectos — o nada. Si un proveedor añade una columna a su tabla de partidas, la extracción de toda la tabla colapsa. Si un nuevo proveedor envía su primera factura, no hay plantilla, así que no hay extracción.
Esta arquitectura tiene un nombre para el fracaso: "rotura de plantilla". El propio lenguaje de la industria revela la fragilidad — las plantillas no se degradan con elegancia, se rompen. Un cambio de diseño y la lógica de extracción deja de funcionar por completo. La herramienta no se adapta, no adivina, no intenta un respaldo. Fue diseñada sobre la premisa de que el formato es constante. Cuando la premisa falla, la herramienta falla con ella.
Lo más revelador es cómo esta arquitectura moldea la experiencia del usuario con la herramienta. La herramienta no se presenta como "podemos procesar documentos que coinciden con estas plantillas específicas". Se presenta como "podemos procesar documentos". La limitación queda oculta por el diseño — hasta que el formato cambia y la extracción falla. La conclusión natural del usuario es "debo haber configurado algo mal" o "esta herramienta no funciona". El problema real es más profundo: toda la lógica de la herramienta depende de una premisa que la realidad viola rutinariamente.
El costo oculto de exigir estandarización
El costo de la extracción basada en plantillas no es la licencia del software. Es todo lo que ocurre alrededor del software para mantenerlo funcional en un mundo que se niega a ser estandarizado.
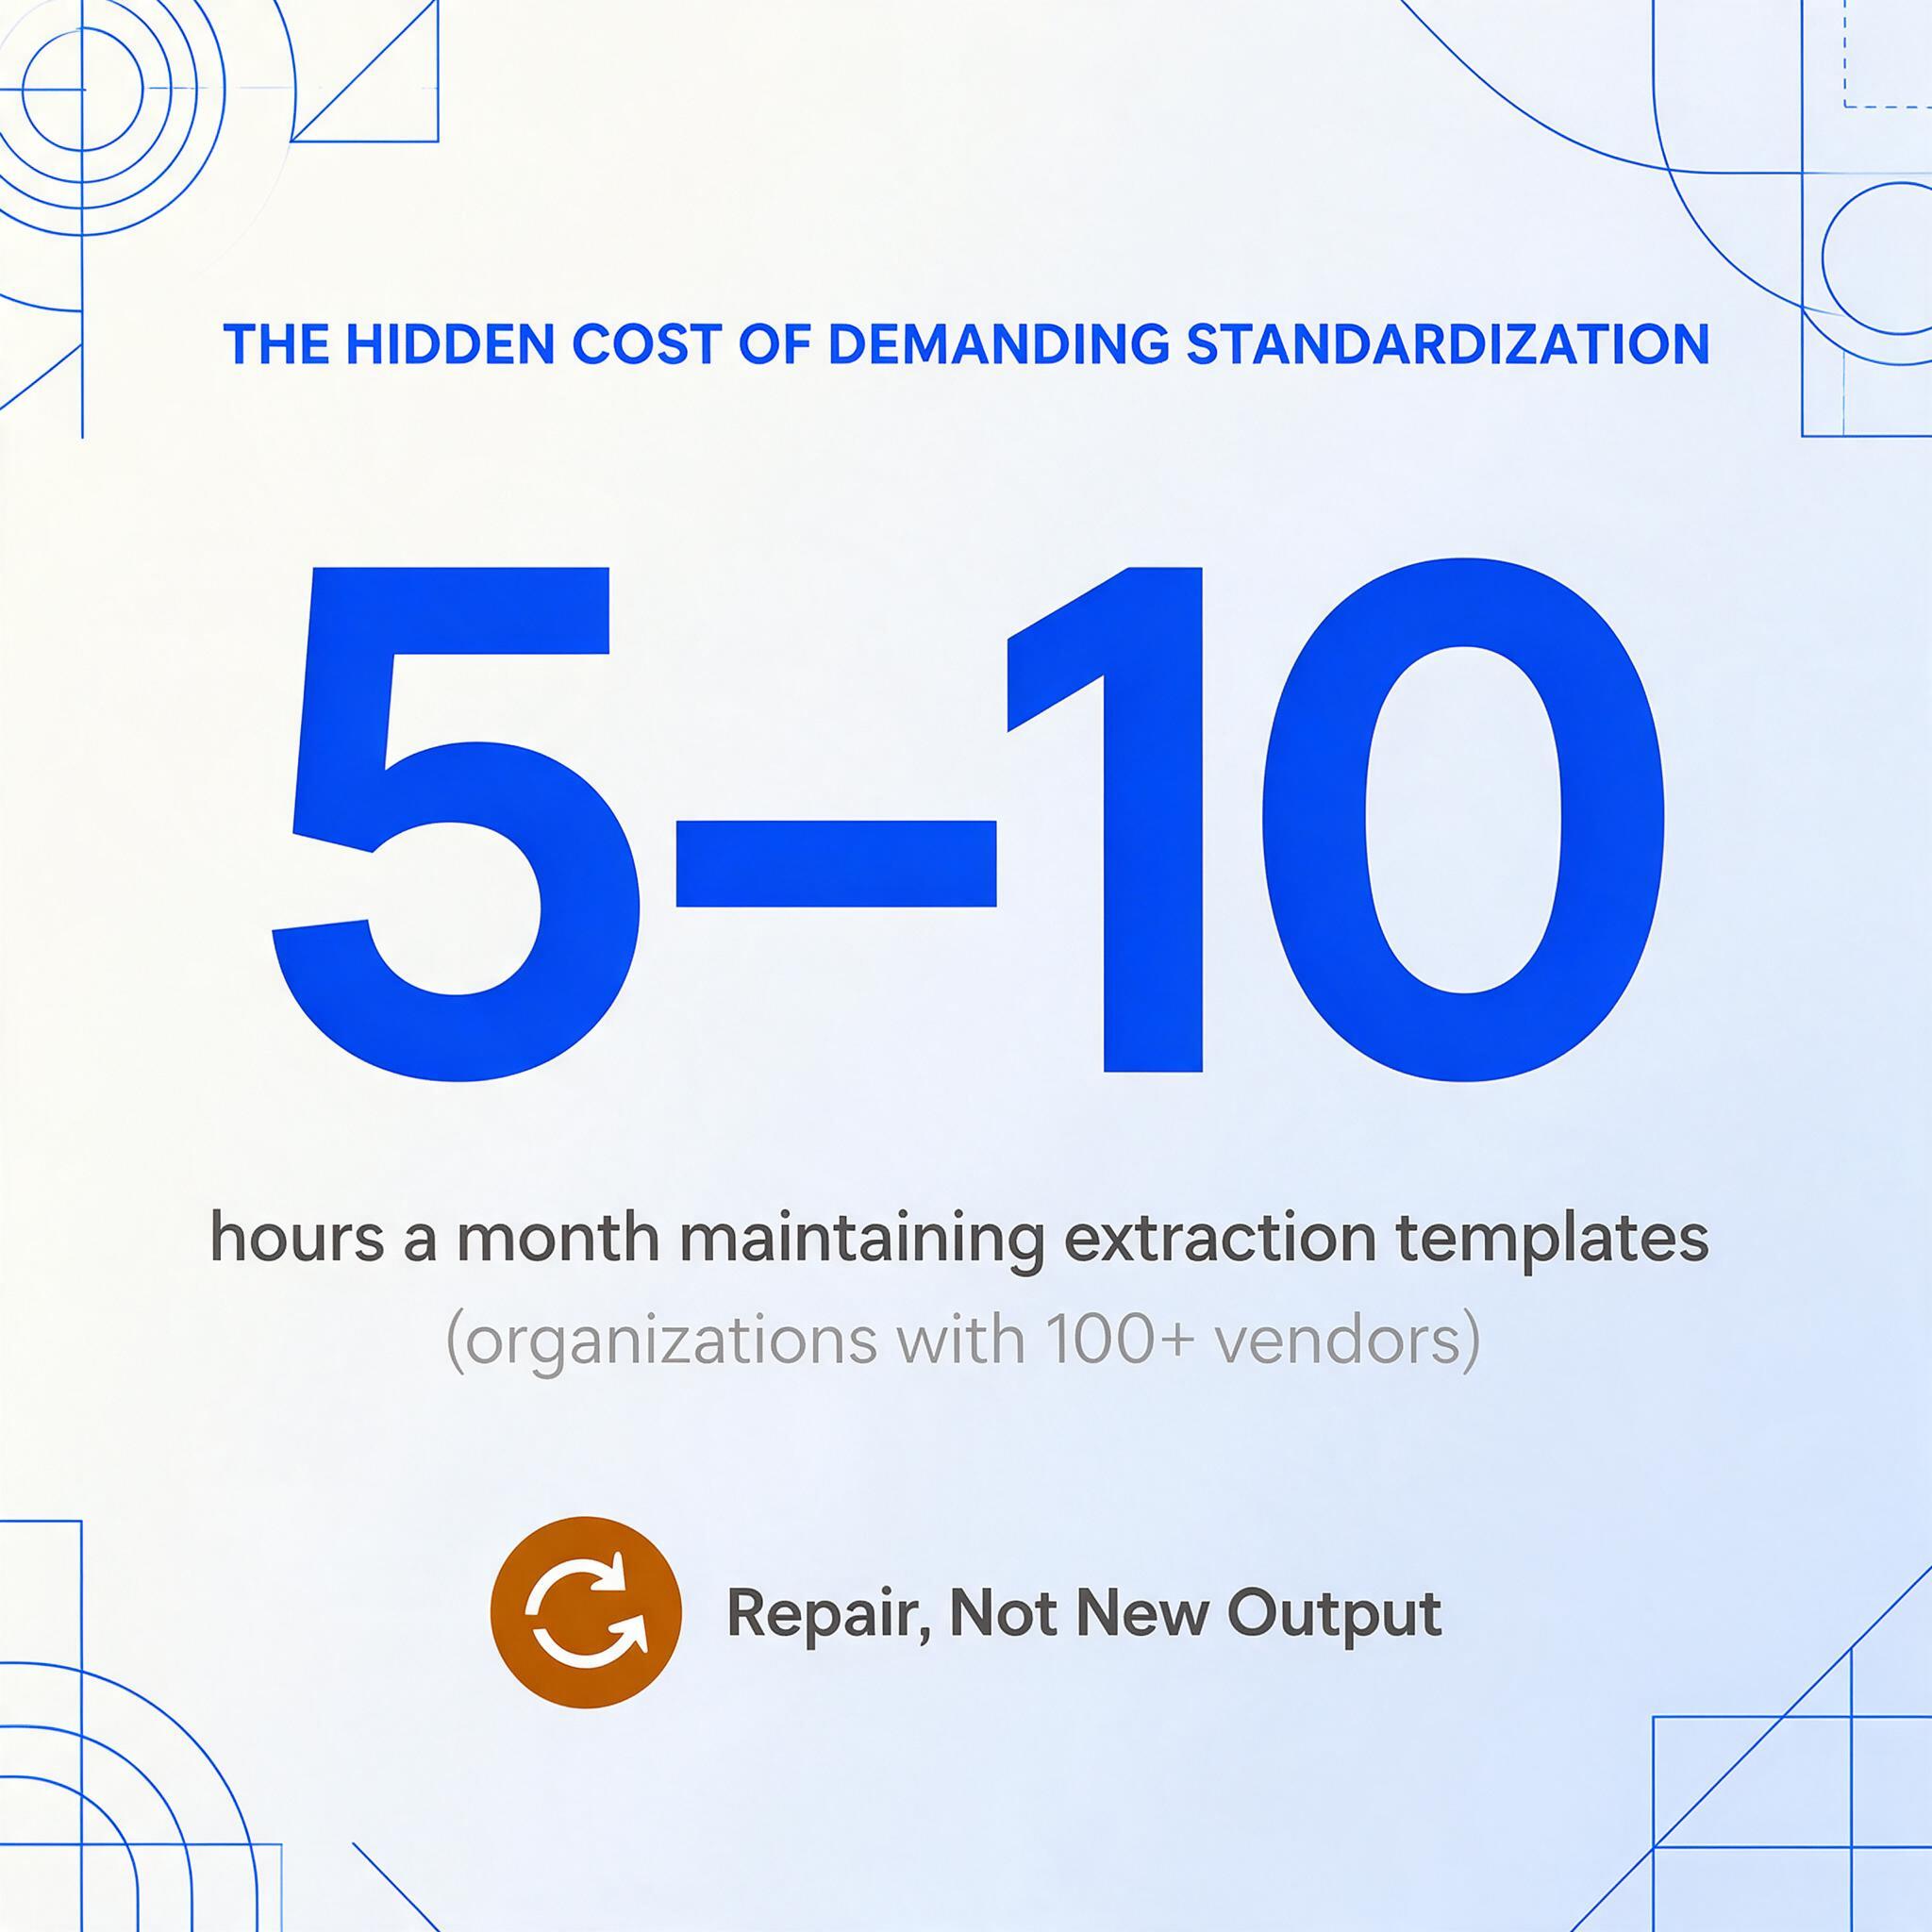
El mantenimiento de plantillas es un gasto operativo recurrente. Las organizaciones con más de 100 proveedores y OCR basado en plantillas suelen dedicar de 5 a 10 horas al mes solo al mantenimiento de plantillas — redibujando zonas tras cambios de diseño, reconstruyendo reglas para nuevos formatos de proveedores, probando la precisión de extracción después de cada actualización. Este es un trabajo que no produce nada nuevo. Existe únicamente para reparar una herramienta cuyo diseño espera que el mundo sea más simple de lo que es.
La incorporación de nuevos proveedores se convierte en un cuello de botella. Cuando un nuevo proveedor envía su primera factura, el equipo de cuentas por pagar tiene dos opciones: procesarla manualmente mientras alguien crea una plantilla, o esperar a la plantilla antes de procesar. De cualquier manera, el requisito de plantilla convierte una operación rutinaria en un proyecto de configuración. Escale eso a docenas de nuevos proveedores por año, y los gastos generales se acumulan.
Los errores silenciosos se acumulan río abajo. Cuando una plantilla se rompe parcialmente — algunos campos se desplazan, otros no — la extracción no falla de forma ruidosa. Falla silenciosamente, asignando montos a cuentas equivocadas, fechas a campos equivocados, nombres de proveedores a registros incorrectos. Estos errores viajan río abajo hacia los sistemas ERP, informes financieros y ejecuciones de pagos. Salen a la superficie semanas o meses después, durante la conciliación, cuando rastrearlos hasta la capa de extracción requiere un esfuerzo forense que la mayoría de los equipos no tiene capacidad para realizar.
Las relaciones con proveedores se deterioran. Cuando un equipo de cuentas por pagar rechaza facturas por incumplimiento de formato o retrasa los pagos mientras espera correcciones de plantillas, los proveedores lo notan. La relación de adquisición, en la que la empresa invirtió para construir, se tensa por una limitación técnica que no tiene nada que ver con el desempeño del proveedor.
Estos costos son invisibles en una hoja de cálculo de evaluación de software. No aparecen en la comparación de la página de precios. Pero son la diferencia entre una herramienta que reduce el trabajo y una que traslada el trabajo de un tipo (entrada manual) a otro (mantenimiento de plantillas) — y lo llama automatización.
Cómo Es una Herramienta Posterior a la Suposición
Si deja de suponer que los documentos se verán igual, ¿cómo se ve la arquitectura de extracción? La respuesta comienza con una pregunta diferente.
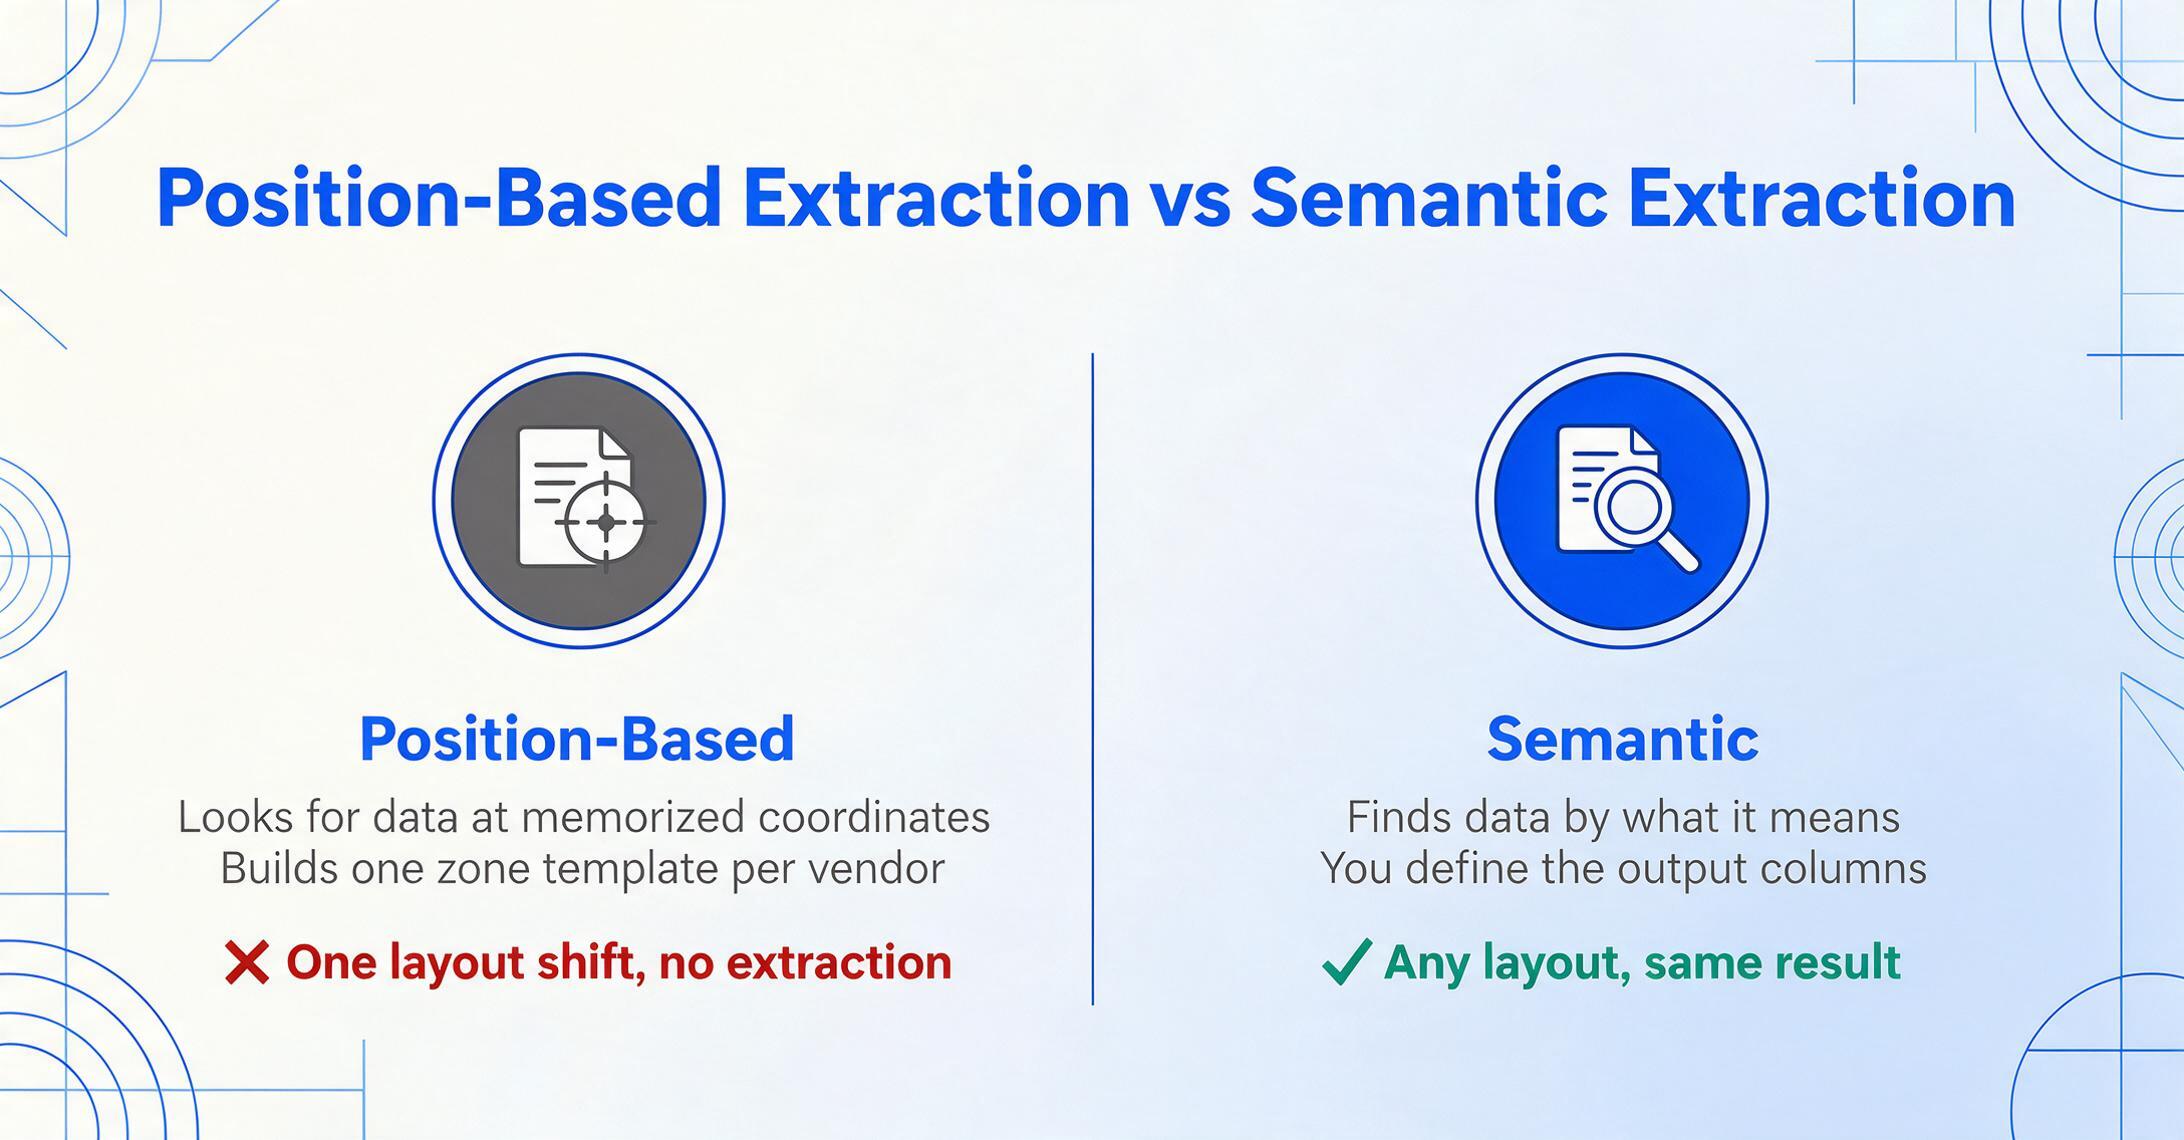
En lugar de preguntar "¿dónde están los datos en la página?", la herramienta pregunta "¿qué significan estos datos en la página?". Esta es la diferencia entre la extracción basada en posición y la extracción semántica. Una herramienta basada en posición necesita saber que el número de factura está en las coordenadas (x: 450, y: 120). Una herramienta semántica necesita saber que en algún lugar de esta página hay una secuencia de caracteres que funciona como número de factura — y puede encontrarla comprendiendo el contenido del documento, no memorizando su diseño.
Este cambio altera todo río abajo. Sin plantillas que crear por proveedor. Sin zonas que redibujar cuando cambian los diseños. Sin demora de incorporación para nuevos proveedores. La herramienta trata la diversidad de formatos como la condición predeterminada — porque semánticamente, una factura es una factura independientemente de si el proveedor puso el total en la esquina superior derecha o en la inferior izquierda. El significado de "Número de Factura" es el mismo ya sea que esté etiquetado como "Factura #," "No. de Fact.," "Ref.," o presentado sin etiqueta alguna, posicionado de manera prominente en la parte superior de la página.
Este es el paradigma detrás de la Extracción de Columnas Personalizadas: usted define las columnas de salida que desea — "Número de Factura," "Nombre del Proveedor," "Total," "Fecha de Vencimiento" — y la IA localiza cada valor en cualquier documento comprendiendo lo que significa, no dónde se encuentra. Usted define la salida. La IA comprende la entrada. El formato no importa.
Los archivos se procesan de forma segura y no se almacenan.
Pruebe a subir dos facturas de proveedores distintos: diseños diferentes, posiciones de campos diferentes, convenciones de etiquetas diferentes. Defina las columnas que desea una sola vez. Observe cómo la IA localiza los mismos datos en ambos documentos sin ninguna configuración por formato. Esto no es un creador de plantillas más rápido. Es una herramienta que nunca necesitó plantillas en primer lugar. Para un análisis más profundo de cómo funciona la extracción sin plantilla a nivel arquitectónico, incluyendo cómo se compara entre tres generaciones de tecnología de extracción, el desglose técnico cubre el motor interno.
El Cambio de Paradigma Que Nadie Anunció
Si ha estado usando herramientas de extracción de documentos durante algunos años, probablemente haya interiorizado un conjunto de expectativas que ahora están obsoletas: que necesita una plantilla por proveedor, que los cambios de formato rompen la extracción, que incorporar un nuevo tipo de documento es un proyecto de configuración. Estas no eran expectativas irrazonables: describían con precisión cómo funcionaban las herramientas. Pero las herramientas funcionaban así debido a una suposición, y esa suposición ha sido reemplazada.
El cambio de la extracción basada en posición a la extracción semántica no es una mejora incremental. Es un cambio de paradigma. El paradigma antiguo decía: estandarice sus entradas, luego podemos procesarlas. El nuevo paradigma dice: las entradas son variadas por naturaleza: las procesaremos tal como son. El paradigma antiguo trataba la diversidad de formatos como un problema a eliminar. El nuevo paradigma la trata como un hecho a tener en cuenta.
Por eso llamar al nuevo enfoque "mejor OCR" no capta el punto. El OCR siempre se ha tratado del reconocimiento de caracteres: convertir píxeles en texto. El nuevo enfoque se trata de la comprensión de documentos: convertir una página en datos estructurados comprendiendo lo que hay en ella. El OCR lee. La IA comprende. La diferencia no es una cuestión de grado. Es una diferencia de categoría. Para un recorrido práctico de extracción de datos de facturas con diferentes formatos en una única hoja de cálculo unificada, sin crear una plantilla para cada proveedor, la guía práctica explica el flujo de trabajo real.
La nueva premisa
Los documentos de diferentes fuentes siempre se verán diferentes. El trabajo de la herramienta es comprenderlos de todos modos, no exigir que se ajusten primero. Eso no es una característica. Es la premisa mínima viable para una herramienta de extracción de documentos en el mundo real.
Preguntas frecuentes
¿Por qué no obligar a todos los proveedores a usar el mismo formato?
Porque no eres su único cliente. Un proveedor que envía facturas a 50 empresas distintas se enfrenta a 50 requisitos de formato diferentes. Incluso si logras que tus proveedores usen tu plantilla, tu equipo de compras dedicará tiempo a hacer cumplir las normas, rechazar documentos no conformes y mantener la biblioteca de plantillas, un trabajo que no genera valor comercial. La estandarización es un problema de coordinación que escala linealmente con el número de socios comerciales. Es una batalla que puedes ganar tácticamente y perder estratégicamente a medida que tu base de proveedores crece.
¿El EDI no resuelve el problema de la diversidad de formatos?
Parcialmente, y solo para grandes socios comerciales. El EDI (Intercambio Electrónico de Datos) impone un formato de datos estandarizado, lo que elimina la variación de diseño. Pero su implementación cuesta miles de dólares por socio comercial, requiere mantenimiento continuo de mapeo y solo es práctico para relaciones de alto volumen. Como señala la comunidad de r/edi, incluso los proveedores vinculados por EDI producen "datos técnicamente conformes pero prácticamente desordenados" y "se desvían de los formatos acordados con el tiempo". Para la larga cola de proveedores pequeños y medianos, el EDI no es una opción.
¿Las herramientas de IA funcionan con documentos manuscritos?
Sí, con una precisión que varía según la calidad de la escritura. La extracción mediante IA con modelos de visión alcanza aproximadamente un 88-95% de precisión en documentos con anotaciones manuscritas y un 75-90% en documentos completamente manuscritos. El texto impreso limpio llega hasta el 99%. La brecha de precisión en la escritura a mano no es una limitación del enfoque semántico, sino un reflejo de la ambigüedad inherente de la escritura. La diferencia clave con el OCR basado en plantillas es que las herramientas de IA se degradan gradualmente con la escritura a mano en lugar de fallar por completo.
¿A partir de cuántos proveedores las herramientas basadas en plantillas se vuelven inmanejables?
Según el consenso de equipos de cuentas por pagar reales, el límite está entre 50 y 100 proveedores. Por debajo de 50, una persona dedicada puede mantener las plantillas con unas pocas horas al mes. Por encima de 100, el mantenimiento de plantillas se convierte en un trabajo de medio tiempo: los cambios de formato, la incorporación de nuevos proveedores y los errores silenciosos de extracción se acumulan más rápido de lo que una persona puede gestionar. El umbral varía según la industria: las empresas de construcción, salud y manufactura —donde los formatos de documentos son inherentemente más diversos— alcanzan el límite antes que las empresas que reciben facturas digitales mayormente estandarizadas.
¿La extracción semántica es 100% precisa?
No. Ningún método de extracción es 100% preciso en todos los documentos. La extracción semántica alcanza hasta el 99% en documentos impresos limpios y se degrada en escaneos de baja calidad, escritura a mano abundante y diseños extremadamente complejos. La diferencia con el OCR basado en plantillas no es que sea perfecto, sino que no falla por completo cuando cambia el formato. Una herramienta de plantillas falla catastróficamente ante un nuevo diseño. La precisión de una herramienta semántica puede bajar del 99% al 92% en un formato inusual, pero aún produce resultados utilizables. El modo de fallo importa tanto como el techo de precisión.