Warum jedes Dokumentextraktionstool
annimmt, dass Dokumente gleich aussehen
Die gesamte Branche der Dokumentextraktion wurde auf einer Prämisse aufgebaut, die niemand je hinterfragt hat: dass Dokumente aus verschiedenen Quellen ähnlich genug aussehen, um auf dieselbe Weise verarbeitet zu werden. Die Prämisse war nicht böswillig. Sie wurde übernommen. Sie stammt aus einem Jahrhundert industriellen Denkens, das uns lehrte, dass Standardisierung der einzige Weg zu Effizienz ist. Aber Dokumente sind keine Motorteile, und die reale Welt hat diese Botschaft nie erhalten.
Die wichtigsten Erkenntnisse
- Die gesamte Branche der Dokumentextraktion hat ihre Architektur vom Fließband Henry Fords aus dem Jahr 1913 übernommen – unter der Annahme, dass jedes Dokument jedes Lieferanten gleich aussehen sollte, um effizient verarbeitet zu werden.
- Die Wartung von Vorlagen kostet 5 bis 10 Stunden pro Monat bei nur 100 Lieferanten – nicht, weil Sie unterbesetzt sind, sondern weil das Design des Tools erwartet, dass die Welt einfacher ist, als sie tatsächlich ist.
- Ein Tool, das „Rechnungsnummer“ danach liest, was es bedeutet, statt wo es steht, verarbeitet nicht nur schneller – es eliminiert die Vorlagenwartung als Arbeitskategorie vollständig aus Ihrer Stellenbeschreibung.
Das Erbe des Fließbands
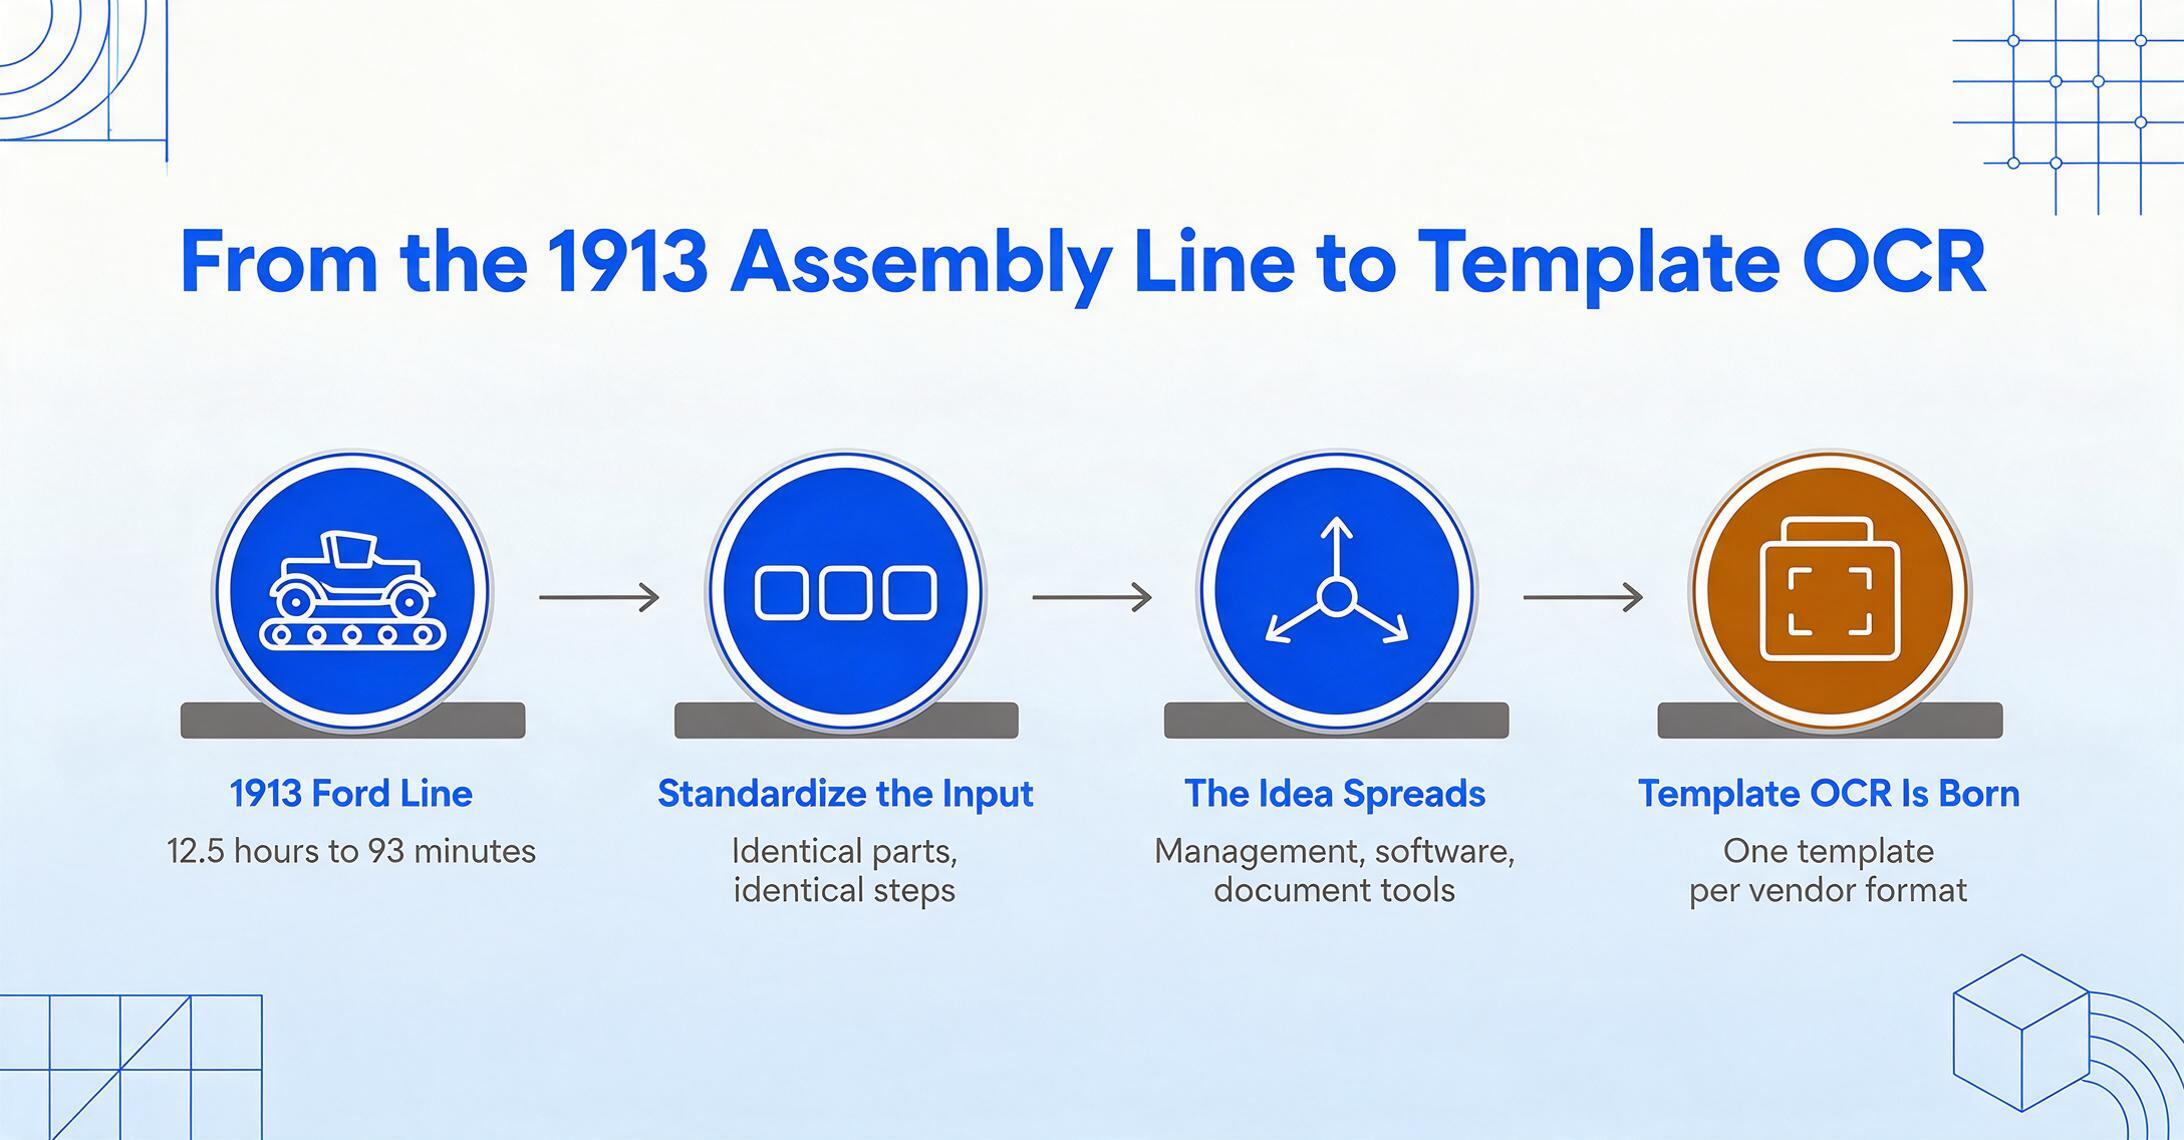
Die Annahme, dass Dokumente gleich aussehen sollten, stammt nicht aus der Dokumentenverarbeitung. Sie stammt aus der Fertigung. Genauer gesagt aus einer Reihe von Effizienzvorstellungen, die das industrielle Denken seit über einem Jahrhundert dominiert.
Im Jahr 1913 führte Henry Fords Werk in Highland Park das Fließband ein und verkürzte die Montagezeit eines Fahrgestells von 12,5 Stunden auf 93 Minuten. Die Erkenntnis war einfach und tiefgreifend: Wenn jede Eingabe identisch ist, kann jeder Vorgang optimiert werden. Standardisierte Teile, die in standardisierte Prozesse einfließen, erzeugten standardisierte Ergebnisse mit beispielloser Geschwindigkeit und zu beispiellosen Kosten. Diese Idee blieb nicht auf Fabriken beschränkt. Sie eroberte die Managementtheorie (Taylors wissenschaftliche Betriebsführung), die Softwareentwicklung (das Wasserfallmodell) und schließlich das Design von Dokumentenverarbeitungswerkzeugen.
Als die erste Generation von Software zur Dokumentextraktion entwickelt wurde – Template-OCR, zonale OCR, regelbasierte Parsingsysteme – griffen die Ingenieure bei deren Design natürlich auf das Effizienzwerkzeug zurück, das ihnen beigebracht worden war. Die Logik schien wasserdicht: Definieren Sie, wo jedes Feld auf einem Dokument sitzt, kodieren Sie diese Position als Regel, und jedes nachfolgende Dokument, das der Vorlage entspricht, kann automatisch verarbeitet werden. Eine Vorlage pro Format. Pflegen Sie die Vorlage. Skalieren Sie durch Standardisierung.
Bemerkenswert ist nicht, dass sie diese Annahme getroffen haben. Bemerkenswert ist, dass die Branche sie jahrzehntelang als selbstverständlich richtig behandelte – als Designbeschränkung und nicht als Designentscheidung. Die Annahme war so tief in der Architektur verankert, dass die meisten Tools sie nicht einmal als Einschränkung dokumentierten. Sie war das Wasser, in dem der Fisch schwamm.
Wenn die Realität sich weigert, sich zu standardisieren
Wenn man davon ausgeht, dass Dokumente aus verschiedenen Quellen ähnlich genug aussehen, um eine gemeinsame Verarbeitungsvorlage zu nutzen, dann ist der tatsächliche Zustand von Geschäftsdokumenten eine direkte Widerlegung dieser Annahme auf jeder Ebene.
Nehmen wir den einfachsten Fall: Rechnungen. Ein mittelständisches Unternehmen könnte Rechnungen von 20 bis 50 verschiedenen Lieferanten erhalten. Einige sind digitale PDFs, die von QuickBooks oder Xero erstellt wurden – strukturiert, aber mit unterschiedlichen Feldnamen („Rechnungsnr.“ vs. „Rechnung #“ vs. „Referenz“). Einige stammen aus Unternehmens-ERPs wie SAP Ariba oder Coupa und werden als PDFs exportiert, die für das menschliche Lesen konzipiert sind, nicht für die maschinelle Extraktion – mehrseitige Dokumente mit Positionen, die sich über Tabellen und Seitenumbrüche erstrecken. Einige sind Scans von Papierrechnungen kleinerer Lieferanten, komplett mit Stempeln, handschriftlichen Notizen und schräg aufgenommenen Fotos. Der Rechnungseingang eines einzigen Unternehmens enthält mehr Formatvielfalt, als die OCR-Designer von Vorlagen je berücksichtigt haben.
Und Rechnungen sind der einfache Fall. Bestellungen, Lieferscheine, Prüfberichte, Versicherungszertifikate, Kontoauszüge, Laborberichte – jeder Dokumenttyp bringt sein eigenes Ökosystem an Formatvarianten mit. Ein Bauunternehmen, das mit 30 Subunternehmern zusammenarbeitet, erhält von einigen AIA-G702-Zahlungsanträge, von anderen handschriftliche Tagesberichte und vom eigenen ERP generierte PDFs für den Rest.
Die Reddit-Community r/procurement hat dies ausführlich dokumentiert. Ein Thread erfasst die Realität präzise: „Lieferanten halten sich nicht an Formate. Selbst EDI-angebundene Lieferanten produzieren technisch konforme, aber praktisch unordentliche Daten. Und sie ‚weichen‘ im Laufe der Zeit von vereinbarten Formaten ab.“ Ein anderer: „Wir geben das Rechnungsformat klar im MSA-Anhang an. Lieferanten sind mit den Systemen vertraut. Und dennoch kommen 5–10 % unbrauchbar durch.“
Der Versuch, Standardisierung durchzusetzen – Lieferanten eine Vorlage zu schicken, EDI-Konformität zu verlangen, nicht konforme Dokumente abzulehnen – bedeutet, gegen Entropie mit Papierkram anzukämpfen. Es funktioniert teilweise, vorübergehend und unter erheblichen Beziehungskosten. Die Formatvielfalt ist kein Fehler im System. Sie ist der natürliche Zustand des Systems. Jeder Lieferant verwendet eine andere Buchhaltungssoftware. Jede Abteilung hat ihre eigenen Berichtskonventionen. Jede Person füllt Formulare anders aus. Das ist kein Chaos, das es zu beseitigen gilt – es ist eine Realität, an die man sich anpassen muss.
Die Kernwiderlegung
Formatvielfalt ist kein Problem, das bessere Prozesse lösen können. Sie ist der Standardzustand der Geschäftskommunikation. Ein Tool, das Formatkonsistenz verlangt, löst kein Dokumentproblem – es verlangt, dass sich die Welt neu formt, um zum Tool zu passen.
Wie die Annahme zur Software wurde
Die Template-OCR-Architektur ist die wörtlichste Übersetzung der Standardisierungsannahme in Code. So funktioniert sie – und warum „funktioniert" großzügig ist.
Ein Template-OCR-System verlangt von Ihnen etwas, bevor es ein einziges Dokument verarbeiten kann: ein Template definieren. Für jedes Lieferantenformat zeichnen Sie Zonen – Rechtecke um die Stelle, an der die Rechnungsnummer erscheint, wo das Datum steht, wo die Positionszeilen beginnen und enden. Das Tool merkt sich diese Koordinaten. Wenn ein neues Dokument von diesem Lieferanten eintrifft, sucht es an denselben Positionen nach Text und extrahiert, was es findet. Wenn sich ein Feld um zwei Zentimeter nach rechts verschoben hat, weil der Lieferant seinen Briefkopf aktualisiert hat, extrahiert das Tool die falschen Daten – oder gar nichts. Wenn ein Lieferant eine Spalte zu seiner Positionstabelle hinzufügt, bricht die gesamte Tabellenextraktion zusammen. Wenn ein neuer Lieferant seine erste Rechnung sendet, gibt es kein Template, also keine Extraktion.
Diese Architektur hat einen Namen für das Scheitern: „Template-Bruch". Die Sprache der Branche selbst offenbart die Fragilität – Templates degradieren nicht elegant, sie brechen. Eine Layoutänderung und die Extraktionslogik funktioniert nicht mehr. Das Tool passt sich nicht an, rät nicht, versucht keinen Fallback. Es wurde auf der Prämisse entworfen, dass das Format konstant ist. Wenn die Prämisse scheitert, scheitert das Tool mit ihr.
Am aufschlussreichsten ist, wie diese Architektur die Benutzererfahrung des Tools prägt. Das Tool präsentiert sich nicht als „wir können Dokumente verarbeiten, die diesen spezifischen Templates entsprechen". Es präsentiert sich als „wir können Dokumente verarbeiten". Die Einschränkung wird durch das Design verschleiert – bis sich das Format ändert und die Extraktion scheitert. Die natürliche Schlussfolgerung des Benutzers ist „ich muss etwas falsch konfiguriert haben" oder „dieses Tool funktioniert nicht". Das eigentliche Problem ist tiefer: Die gesamte Logik des Tools hängt von einer Prämisse ab, die die Realität routinemäßig verletzt.
Die versteckten Kosten der geforderten Standardisierung
Die Kosten der templatebasierten Extraktion sind nicht die Softwarelizenz. Es ist alles, was rund um die Software passiert, um sie in einer Welt funktionsfähig zu halten, die sich weigert, standardisiert zu werden.
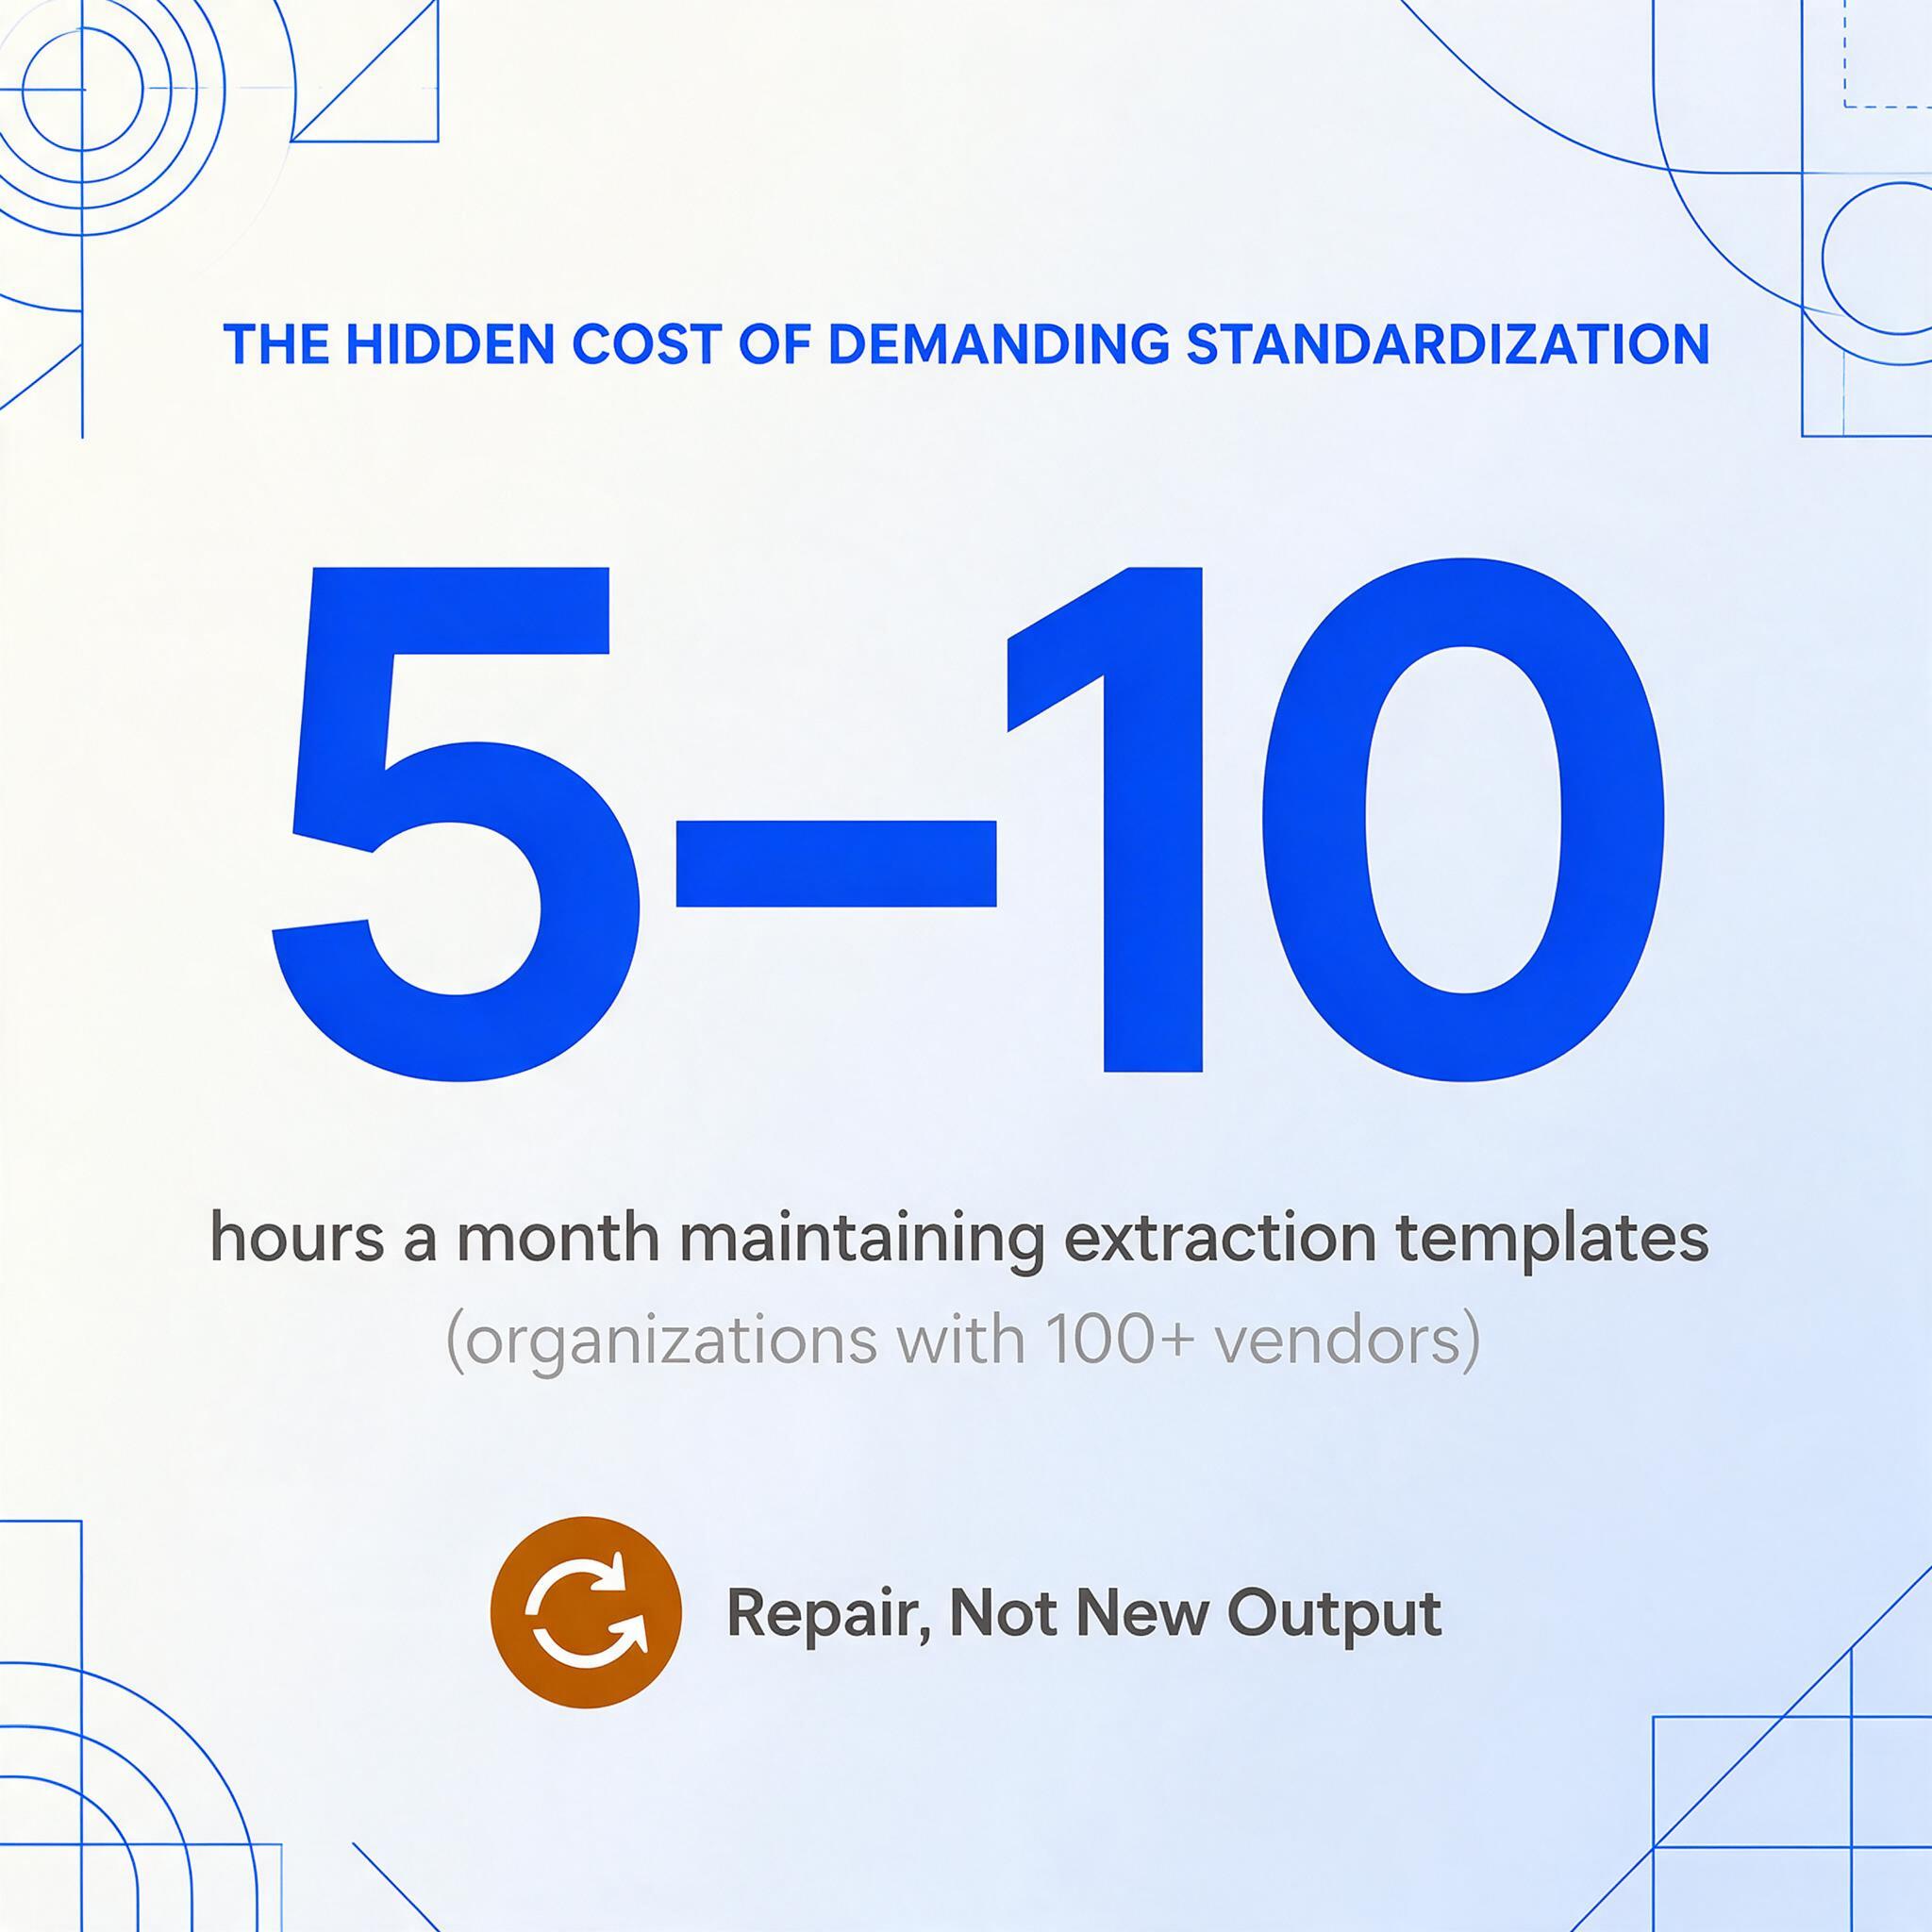
Template-Wartung ist ein wiederkehrender operativer Aufwand. Organisationen mit 100+ Lieferanten und templatebasierter OCR verbringen typischerweise 5 bis 10 Stunden pro Monat nur mit der Wartung von Templates – Zonen nach Layoutänderungen neu zeichnen, Regeln für neue Lieferantenformate neu aufbauen, Extraktionsgenauigkeit nach jedem Update testen. Das ist Arbeit, die nichts Neues hervorbringt. Sie existiert nur, um ein Tool zu reparieren, dessen Design erwartet, dass die Welt einfacher ist, als sie ist.
Die Einbindung neuer Lieferanten wird zum Engpass. Wenn ein neuer Lieferant seine erste Rechnung sendet, hat das AP-Team zwei Optionen: Es verarbeitet sie manuell, während jemand ein Template erstellt, oder es wartet auf das Template, bevor es verarbeitet. In beiden Fällen verwandelt die Template-Anforderung einen Routinevorgang in ein Konfigurationsprojekt. Skalieren Sie das über dutzende neue Lieferanten pro Jahr, und der Overhead potenziert sich.
Stille Fehler summieren sich nachgelagert. Wenn eine Vorlage teilweise bricht – einige Felder verschieben sich, andere nicht – schlägt die Extraktion nicht laut fehl. Sie schlägt leise fehl, ordnet Beträge falschen Konten zu, Daten falschen Feldern, Lieferantennamen falschen Datensätzen. Diese Fehler wandern nachgelagert in ERP-Systeme, Finanzberichte und Zahlungsläufe. Sie tauchen Wochen oder Monate später auf, während des Abgleichs, wenn die Rückverfolgung bis zur Extraktionsebene forensischen Aufwand erfordert, für den die meisten Teams keine Kapazitäten haben.
Lieferantenbeziehungen verschlechtern sich. Wenn ein Kreditorenbuchhaltungsteam Rechnungen wegen Nichteinhaltung des Formats ablehnt oder Zahlungen verzögert, während es auf Vorlagenkorrekturen wartet, bemerken Lieferanten das. Die Beschaffungsbeziehung, in deren Aufbau das Unternehmen investiert hat, wird durch eine technische Einschränkung belastet, die nichts mit der Leistung des Lieferanten zu tun hat.
Diese Kosten sind in einer Software-Bewertungstabelle unsichtbar. Sie erscheinen nicht im Preisvergleich. Aber sie machen den Unterschied zwischen einem Werkzeug, das Arbeit reduziert, und einem Werkzeug, das Arbeit von einer Art (manuelle Eingabe) auf eine andere (Vorlagenpflege) verlagert – und das als Automatisierung bezeichnet.
Wie ein Werkzeug ohne Annahmen aussieht
Wenn Sie nicht mehr davon ausgehen, dass Dokumente gleich aussehen, wie sieht dann die Extraktionsarchitektur aus? Die Antwort beginnt mit einer anderen Frage.
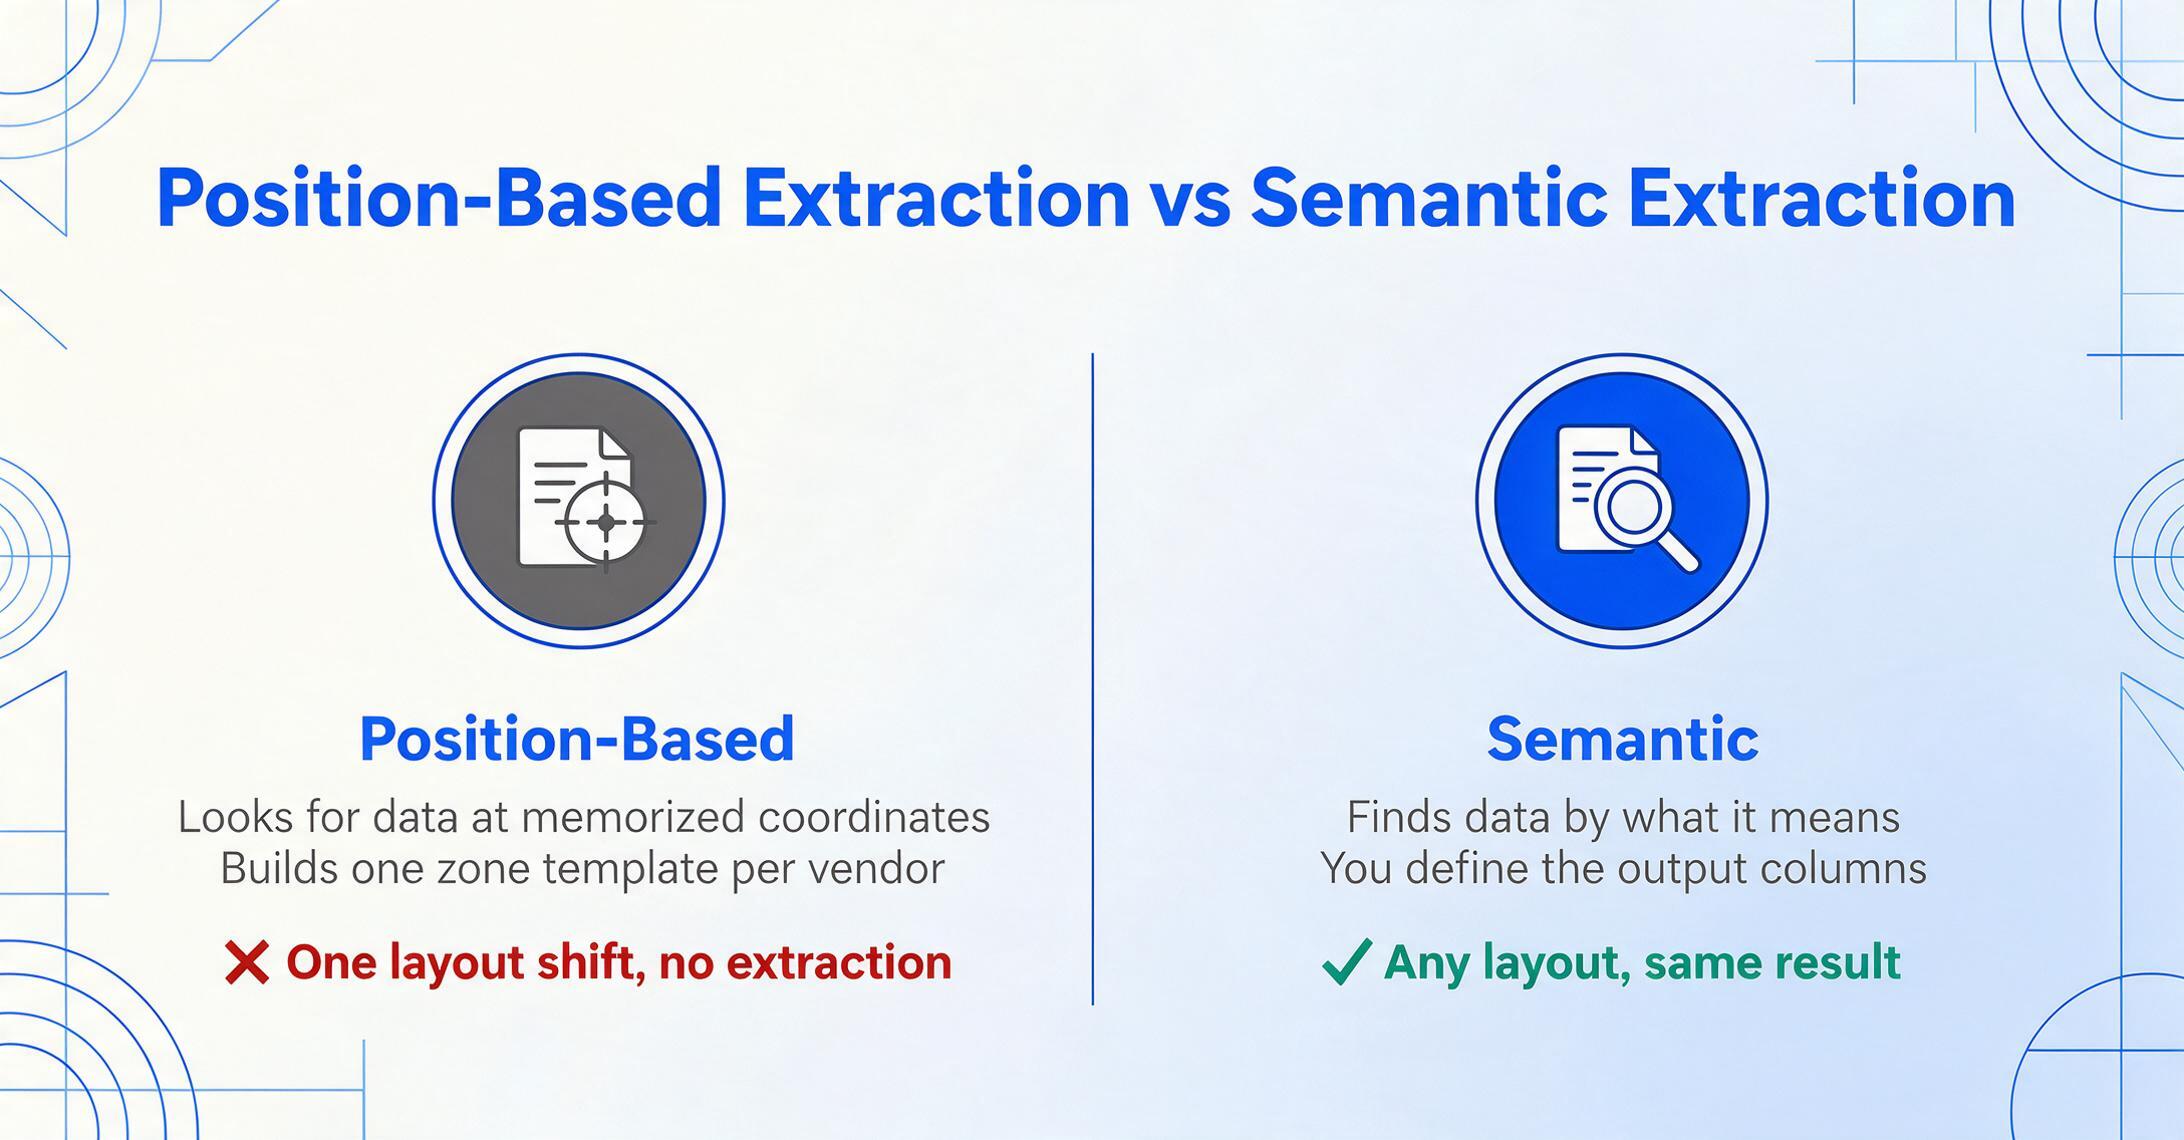
Statt zu fragen „Wo befinden sich die Daten auf der Seite?“, fragt das Werkzeug „Was bedeuten diese Daten auf der Seite?“ Das ist der Unterschied zwischen positionsbasierter Extraktion und semantischer Extraktion. Ein positionsbasiertes Werkzeug muss wissen, dass sich die Rechnungsnummer an den Koordinaten (x: 450, y: 120) befindet. Ein semantisches Werkzeug muss wissen, dass es irgendwo auf dieser Seite eine Zeichenfolge gibt, die als Rechnungsnummer fungiert – und es kann sie finden, indem es den Inhalt des Dokuments versteht, nicht indem es dessen Layout auswendig lernt.
Diese Verschiebung verändert alles nachgelagert. Keine Vorlagen pro Lieferant zu erstellen. Keine Zonen neu zu zeichnen, wenn sich Layouts ändern. Keine Onboarding-Verzögerung für neue Lieferanten. Das Werkzeug behandelt Formatvielfalt als Standardbedingung – denn semantisch ist eine Rechnung eine Rechnung, unabhängig davon, ob der Lieferant die Summe oben rechts oder unten links platziert hat. Die Bedeutung von „Rechnungsnummer“ ist dieselbe, ob sie als „Rechnung Nr.“, „Rechnungsnr.“, „Ref.“ oder ganz ohne Beschriftung, prominent oben auf der Seite platziert, erscheint.
Dies ist das Paradigma hinter der Benutzerdefinierten Spaltenextraktion: Sie definieren die gewünschten Ausgabespalten – „Rechnungsnummer“, „Lieferantenname“, „Summe“, „Fälligkeitsdatum“ – und die KI lokalisiert jeden Wert überall in jedem Dokument, indem sie versteht, was er bedeutet, nicht wo er steht. Sie definieren die Ausgabe. Die KI versteht die Eingabe. Das Format spielt keine Rolle.
Dateien werden sicher verarbeitet und nicht gespeichert.
Versuchen Sie, zwei Rechnungen von verschiedenen Anbietern hochzuladen – unterschiedliche Layouts, unterschiedliche Feldpositionen, unterschiedliche Beschriftungskonventionen. Definieren Sie die gewünschten Spalten einmal. Beobachten Sie, wie die KI dieselben Datenpunkte in beiden Dokumenten findet, ohne jegliche formatbezogene Konfiguration. Dies ist kein schnellerer Vorlagen-Builder. Es ist ein Tool, das von Anfang an nie Vorlagen benötigt hat. Für einen tieferen Einblick in die Funktionsweise der Extraktion ohne Vorlage auf architektonischer Ebene, einschließlich des Vergleichs über drei Generationen von Extraktionstechnologie, finden Sie in der technischen Aufschlüsselung Details zum Motor unter der Haube.
Der Paradigmenwechsel, den niemand angekündigt hat
Wenn Sie seit einigen Jahren Dokumentextraktions-Tools verwenden, haben Sie wahrscheinlich eine Reihe von Erwartungen verinnerlicht, die nun veraltet sind: dass Sie eine Vorlage pro Anbieter benötigen, dass Formatänderungen die Extraktion brechen, dass die Einführung eines neuen Dokumenttyps ein Konfigurationsprojekt ist. Dies waren keine unvernünftigen Erwartungen – sie beschrieben genau, wie die Tools funktionierten. Aber die Tools funktionierten so wegen einer Annahme, und diese Annahme wurde ersetzt.
Der Wandel von positionsbasierter zu semantischer Extraktion ist keine inkrementelle Verbesserung. Es ist ein Paradigmenwechsel. Das alte Paradigma besagte: Standardisieren Sie Ihre Eingaben, dann können wir sie verarbeiten. Das neue Paradigma besagt: Eingaben sind von Natur aus vielfältig – wir verarbeiten sie so, wie sie sind. Das alte Paradigma behandelte Formatvielfalt als ein Problem, das es zu beseitigen gilt. Das neue Paradigma behandelt sie als eine Gegebenheit, die es zu berücksichtigen gilt.
Deshalb verfehlt es den Punkt, den neuen Ansatz als „bessere OCR“ zu bezeichnen. Bei OCR ging es schon immer um Zeichenerkennung – die Umwandlung von Pixeln in Text. Beim neuen Ansatz geht es um Dokumentverständnis – die Umwandlung einer Seite in strukturierte Daten durch das Verstehen ihres Inhalts. OCR liest. KI versteht. Der Unterschied ist keine Frage des Grades. Es ist ein Unterschied der Kategorie. Für eine praktische Anleitung zum Extrahieren von Daten aus Rechnungen mit unterschiedlichen Formaten in eine einzige einheitliche Tabelle – ohne für jeden Anbieter eine Vorlage zu erstellen – führt Sie der Leitfaden durch den tatsächlichen Arbeitsablauf.
Die neue Prämisse
Dokumente aus verschiedenen Quellen werden immer unterschiedlich aussehen. Die Aufgabe des Tools ist es, sie trotzdem zu verstehen – nicht zu verlangen, dass sie sich zuerst anpassen. Das ist kein Feature. Es ist die minimale tragfähige Prämisse für ein Dokumentextraktions-Tool in der realen Welt.
FAQ
Warum nicht einfach alle Lieferanten auf ein einheitliches Format verpflichten?
Weil Sie nicht deren einziger Kunde sind. Ein Lieferant, der Rechnungen an 50 verschiedene Unternehmen sendet, steht vor 50 unterschiedlichen Formatvorgaben. Selbst wenn Sie Ihre Lieferanten dazu bringen, Ihre Vorlage zu verwenden, muss Ihr Einkaufsteam Zeit für die Durchsetzung der Vorgaben, die Zurückweisung nicht konformer Dokumente und die Pflege der Vorlagenbibliothek aufwenden – Arbeit ohne geschäftlichen Mehrwert. Standardisierung ist ein Koordinationsproblem, das linear mit der Anzahl der Handelspartner wächst. Sie können diese Schlacht taktisch gewinnen, aber strategisch verlieren, sobald Ihr Lieferantenstamm wächst.
Löst EDI nicht das Problem der Formatvielfalt?
Teilweise, und nur für große Handelspartner. EDI (Electronic Data Interchange) erzwingt ein standardisiertes Datenformat und beseitigt so Layout-Variationen. Aber die Implementierung von EDI kostet Tausende von Dollar pro Handelspartner, erfordert laufende Mapping-Pflege und ist nur für Beziehungen mit hohem Volumen praktikabel. Wie die r/edi-Community anmerkt, liefern selbst EDI-angebundene Lieferanten „technisch konforme, aber praktisch unordentliche Daten“ und „weichen mit der Zeit von vereinbarten Formaten ab“. Für die lange Liste kleiner und mittlerer Lieferanten ist EDI keine Option.
Funktionieren KI-Extraktionstools auch bei handschriftlichen Dokumenten?
Ja, mit einer Genauigkeit, die von der Qualität der Handschrift abhängt. KI-Extraktion mit Vision-Modellen erreicht etwa 88–95 % Genauigkeit bei Dokumenten mit handschriftlichen Anmerkungen und 75–90 % bei vollständig handschriftlichen Dokumenten. Sauberer gedruckter Text erreicht bis zu 99 %. Die Genauigkeitslücke bei Handschrift ist keine Einschränkung des semantischen Ansatzes – sie spiegelt die inhärente Mehrdeutigkeit von Handschrift wider. Der entscheidende Unterschied zur Template-OCR ist, dass KI-Tools bei Handschrift allmählich an Genauigkeit verlieren, anstatt komplett zu versagen.
Ab wann werden vorlagenbasierte Tools unüberschaubar?
Laut Erfahrungen aus der Praxis liegt die Schwelle bei 50 bis 100 Lieferanten. Unter 50 reichen ein paar Stunden pro Monat, um Vorlagen zu pflegen. Ab 100 wird die Vorlagenpflege zum Teilzeitjob – Formatänderungen, neue Lieferanten und stille Extraktionsfehler häufen sich schneller, als eine Person bewältigen kann. Die Grenze variiert je nach Branche: Unternehmen im Baugewerbe, Gesundheitswesen und in der Fertigung – wo Dokumentformate von Natur aus vielfältiger sind – erreichen die Grenze früher als Unternehmen, die meist standardisierte digitale Rechnungen erhalten.
Ist die semantische Extraktion zu 100 % genau?
Nein. Keine Extraktionsmethode ist bei allen Dokumenten zu 100 % genau. Die semantische Extraktion erreicht bei sauberen gedruckten Dokumenten bis zu 99 % und lässt bei schlechten Scans, starken handschriftlichen Notizen und extrem komplexen Layouts nach. Der Unterschied zur Vorlagen-OCR liegt nicht darin, dass sie perfekt ist – sondern darin, dass sie bei Formatänderungen nicht komplett versagt. Ein vorlagenbasiertes Tool scheitert bei einem neuen Layout katastrophal. Die Genauigkeit eines semantischen Tools kann bei einem ungewöhnlichen Format von 99 % auf 92 % fallen, liefert aber immer noch brauchbare Ergebnisse. Die Art des Fehlers ist genauso wichtig wie die maximale Genauigkeit.