Different Vendor Invoices,
One Consistent Spreadsheet
Der schwierigste Teil bei der Verarbeitung von Rechnungen verschiedener Lieferanten ist nicht das Lesen der Daten. Moderne KI-Extraktionstools kommen mit gemischten Layouts überraschend gut zurecht — ein deutsches PDF mit „1.250,00 €“, ein taiwanesischer Scan mit handschriftlichen Beträgen, eine französische Rechnung, die vollständig auf Französisch beschriftet ist. Die KI liest sie alle korrekt. Der eigentliche Engpass, der Schritt, der AP-Teams dazu bringt, Spalten noch lange nach der Einführung der Automatisierung neu zuzuordnen, ist die Erzeugung konsistenter Ausgaben mit denselben Feldern in denselben Spalten über jedes Lieferantenformat hinweg. Die Extraktion hat das Leseproblem gelöst. Das Tabellenproblem hat sie nicht gelöst.
Wichtige Erkenntnisse
- Ihre 50 Lieferanten senden Ihnen Rechnungen in 50 verschiedenen Formaten, und keiner von ihnen wird jemals sein Layout für Ihren AP-Workflow neu gestalten.
- Bei 200 Lieferanten mit einer Layoutänderung alle 18 Monate bearbeiten Sie 11 defekte Vorlagen pro Monat, bevor Sie überhaupt eine einzige Rechnung öffnen.
- Hören Sie auf, Lieferantenlayouts hinterherzujagen, und werden Sie zu einem Endpunkt, der jedes Format aufnimmt — definieren Sie Ihre Spalten einmal, und jede Rechnung landet für immer in derselben Struktur.
Warum Extraktion allein das Problem der Dateneingabe nicht löst
Die Extraktion hat funktioniert. Jedes Feld wurde korrekt erfasst — Supplier Name lautet „ABC Corp“, Invoice Date lautet „06/15/2026“, Total lautet „$1,250.00“. Dann öffnen Sie die Ausgabetabelle, und Ihr AP-Tracker erwartet „Vendor“, nicht „Supplier Name“.
An diesem Punkt scheitern die meisten Automatisierungsversprechen. Ardent Partners' AP Metrics that Matter in 2025 ergab, dass Best-in-Class-AP-Teams Rechnungen in 3,1 Tagen zu je $2,78 verarbeiten, während der Branchendurchschnitt bei 9,2 Tagen und $9,40 pro Rechnung liegt, mit einer Ausnahmequote von 22 %, die explodiert, wenn die Daten nicht dem erwarteten Format des Zielsystems entsprechen1. Die Open Standards Benchmarking-Daten von APQC setzen die mittleren Kosten sogar noch höher an, bei $21,40 pro Rechnung für durchschnittlich performende Organisationen2.
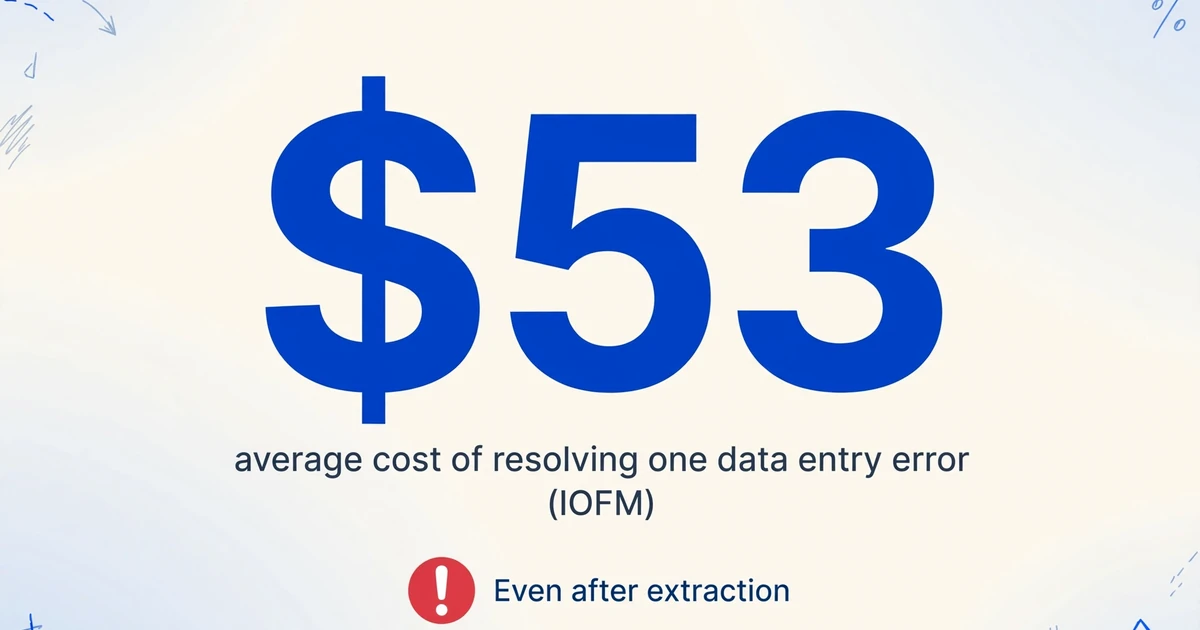
Eine einzige falsch benannte Spalte — „Supplier Name“ statt „Vendor“ — klingt nicht katastrophal. Aber multipliziert über 200 Rechnungen von 40 Lieferanten, die monatlich eintreffen, und summiert sich der Aufwand für die Neuzuordnung zu Stunden von Tabellenkalkulationsarbeit in jedem Zyklus. Das Institute of Finance & Management (IOFM) schätzt, dass die Behebung eines einzelnen Dateneingabefehlers durchschnittlich $53 an Personalzeit kostet3. Das Extraktionstool hat seine Aufgabe erfüllt. Die Tabelle braucht trotzdem einen Menschen, um sie nutzbar zu machen.
Die meisten Teams erkennen dies auf die harte Tour: Sie investieren in ein Extraktionstool, feiern, wenn der erste Batch von Rechnungen korrekt verarbeitet wird, und stellen dann — Monat für Monat — fest, dass korrekte Extraktion und nutzbare Ausgabe zwei verschiedene Dinge sind. Das Tool exportiert, wofür es entwickelt wurde. Ihre QuickBooks-Instanz importiert, wofür sie entwickelt wurde. Die Lücke zwischen diesen beiden Schemata ist der Ort, an dem AP-Teams ihre Nachmittage verbringen.
Was „unterschiedliche Lieferantenformate" tatsächlich bedeutet
Der Ausdruck „unterschiedliche Formate" verharmlost das Problem. Es geht nicht nur darum, dass Lieferant A die Rechnungsnummer oben rechts platziert und Lieferant B sie mittig in der Kopfzeile. Die Unterschiede reichen weit über die Feldplatzierung hinaus — und jeder einzelne ist ein potenzielles Problem für die Datenkonsistenz.
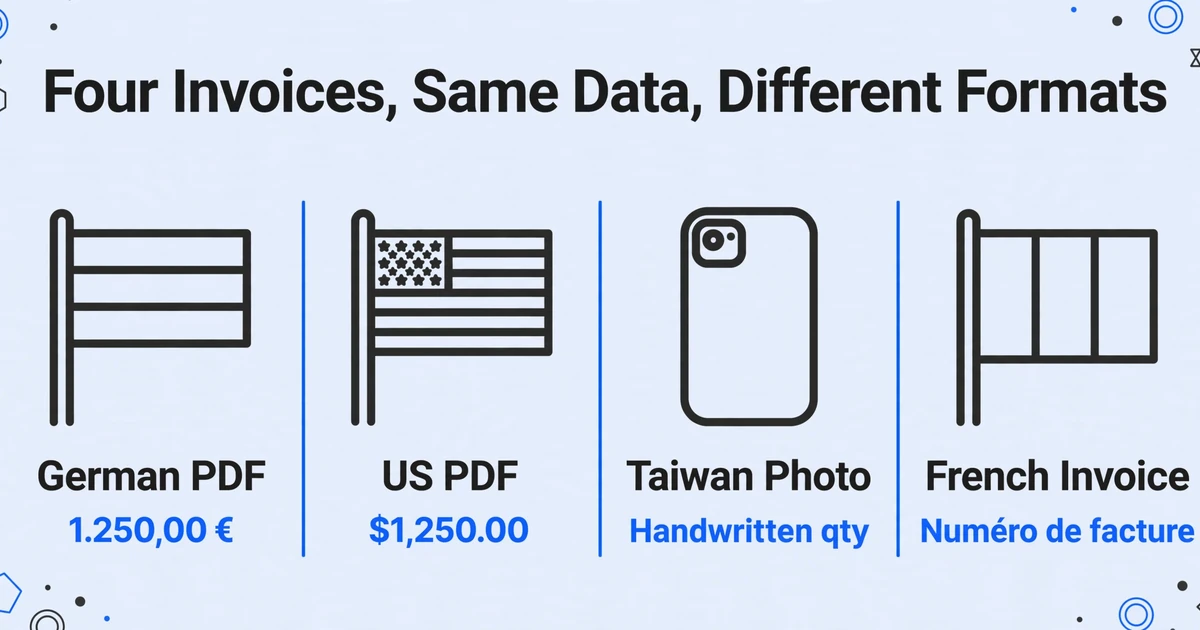
Man stelle sich einen echten AP-Posteingang an einem beliebigen Dienstag vor. Der deutsche Industrielieferant sendet eine saubere PDF mit Dezimalkommas und Punkten als Tausendertrennzeichen: „1.250,00 €." Der US-Bürobedarfslieferant sendet eine digitale PDF mit Standard-Dollar-Formatierung: „$1,250.00." Der taiwanesische Komponentenhersteller mailt ein Handyfoto einer Papierrechnung mit handschriftlichen Mengen auf einem vorgedruckten Formular. Die französische Beratungsfirma sendet eine Rechnung komplett auf Französisch — „Numéro de facture" statt „Invoice Number", „TVA" statt „VAT", „Échéance" statt „Due Date".
Alle vier Rechnungen enthalten dieselben zugrunde liegenden Geschäftsdaten. Alle vier müssen in derselben Tabelle landen, in denselben Spalten, mit derselben Formatierung. Das ist die Konsistenzherausforderung — und die lösen die meisten Extraktionstools nicht.
Auf Reddits r/Accounting beschrieb ein AP-Profi das Problem unverblümt: „Wir haben die in NetSuite integrierte OCR-Funktion ausprobiert, aber sie scheitert bei der Hälfte unserer Rechnungen, weil jede Werkstatt und jeder Rohstofflieferant sein Format anders gestaltet."4 Das ist kein seltener Sonderfall. Es ist der Alltag von AP in jedem mittelständischen Unternehmen, das bei mehr als einer Handvoll Lieferanten einkauft. Und das Problem wird schlimmer, je weiter man wächst: mehr Lieferanten, mehr Formate, mehr Variation.
In r/automation bestätigte ein weiterer Praktiker das strukturelle Problem: „Vorlagenbasierte Extraktion bricht bei Formatänderungen zusammen. Tools, die Daten an festen Koordinaten auf einer PDF-Seite suchen, versagen in dem Moment, in dem man von einem Layout auf ein anderes wechselt oder ein Lieferant sein Rechnungsdesign aktualisiert."5 Vorlagenbasierte Tools — die Art, bei der man einmal pro Lieferant „Invoice Number = oben rechts, 2 cm vom Rand" zuordnen muss — erfordern nicht nur eine anfängliche Konfiguration. Sie erfordern laufende Wartung. Ein Lieferant aktualisiert seine Buchhaltungssoftware? Die Vorlage bricht. Man nimmt einen neuen Lieferanten auf? Man baut eine neue Vorlage. Bei 200 Lieferanten mit durchschnittlich einer Layoutänderung alle 18 Monate sind das rund 11 kaputte Vorlagen pro Monat — eine strukturelle Garantie dafür, dass positionsbasierte Extraktion nie stabil werden kann.
Das Problem der Spaltenkonsistenz
Wer schon einmal ein KI-Tool zur Rechnungsextraktion verwendet hat, kennt diese Abfolge: einen Batch Rechnungen hochladen → die KI extrahiert die Daten über alle Formate hinweg korrekt → die Excel-Ausgabe herunterladen → und feststellen, dass die Spaltenüberschriften nicht zum eigenen Tracker passen.
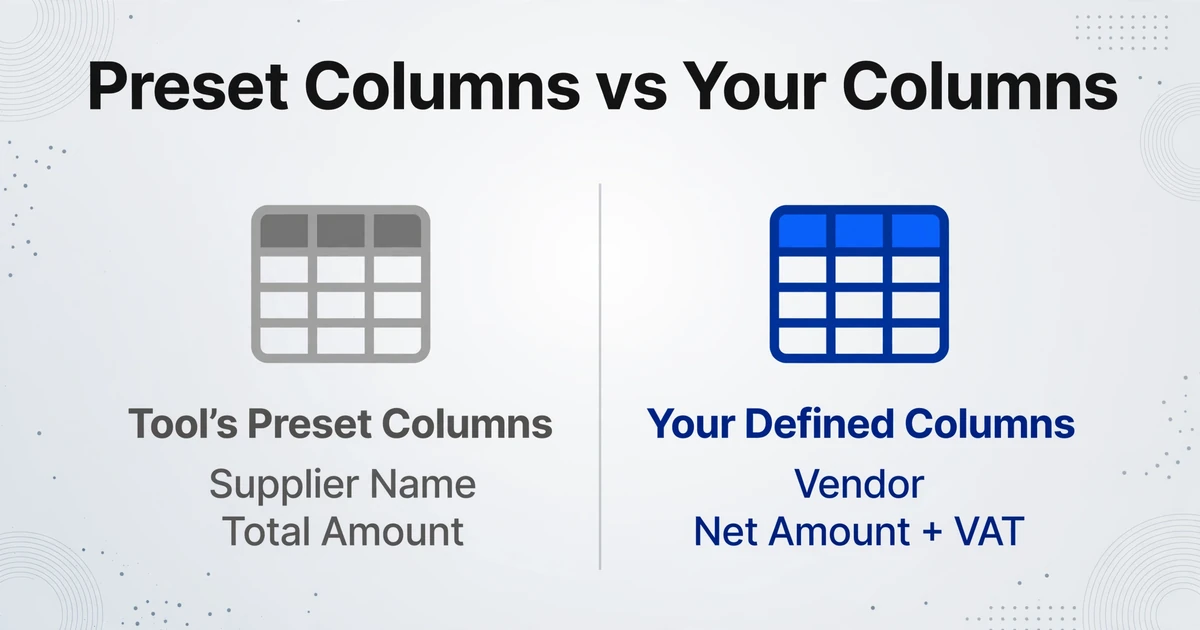
Die meisten KI-Extraktionstools liefern ein festes Ausgabeschema. Das Tool legt fest, dass die Spalten Supplier Name, Invoice Date, Invoice Number, PO Number und Total Amount heißen. Das ist die beste Vermutung des Tools, was Finanzteams üblicherweise wollen. Für viele Workflows passt das ungefähr. Aber „ungefähr“ bedeutet, dass trotzdem umgemappt werden muss: Die eigene Tracking-Tabelle verwendet „Vendor“ statt „Supplier Name“. Der Genehmigungsworkflow benötigt Net Amount und VAT getrennt, nicht einen einzigen Total Amount. Payment Terms fehlt in der voreingestellten Feldliste völlig. Jeder Batch endet mit manueller Spaltenumbenennung — dieselben Spalten, jedes Mal neu benannt.
Der Kern des Problems ist, dass Benutzerdefinierte Spaltenextraktion — eigene Spaltennamen eingeben und die KI die Daten darauf abbilden lassen — grundlegend anders ist als ein Tool, das die Spalten für einen vorgibt. Bei voreingestellten Spalten passt man den eigenen Workflow an das Ausgabeschema des Tools an. Bei benutzerdefinierten Spalten passt das Tool seine Ausgabe an den eigenen Workflow an. Eine Richtung erzeugt Reibung. Die andere nicht.
Hier wird der Unterschied zwischen „Extraktionsgenauigkeit“ und „Ausgabetauglichkeit“ konkret. Eine Extraktionspipeline kann Werte zu 99 % korrekt lesen — und trotzdem eine Ausgabe liefern, die 20 Minuten manuelle Tabellenarbeit erfordert, bevor sie in NetSuite, Xero oder den eigenen Excel-Tracker importiert werden kann. Die KI hat das schwierige Leseproblem gelöst. Am Ende bleibt trotzdem ein manueller Schritt — nur ein anderer als zuvor.
Wenn ein AP-Team Rechnungen von 50+ Lieferanten durch ein Tool mit festen Ausgabespalten schickt, kommt jeder Batch mit derselben Abweichung an: „Supplier Name“ dort, wo das ERP „Vendor“ erwartet, „Total Amount“ dort, wo der Genehmigungsworkflow „Net“ und „Tax“ getrennt benötigt. Das Ummappen ist nicht schwer — drei Spaltenumbenennungen und eine Formelaufteilung —, aber es wiederholt sich mit jedem Batch, für immer. Das ist keine Automatisierung. Das ist unterstützte manuelle Eingabe.
Wie die Extraktion ohne Vorlage konsistente Ergebnisse erzeugt
Der Wandel vollzieht sich beim Übergang von der positionsbasierten Extraktion zur semantischen Extraktion. Vorlagenbasierte Tools lesen Koordinaten: „Rechnungsnummer bei X:200, Y:45.“ KI ohne Vorlage liest die Absicht: „Finde das Feld, das die Rechnungsnummer bedeutet, wo auch immer es ist.“
Dies ist der grundlegende Mechanismus hinter der formatunabhängigen Extraktion. Da die KI versteht, was jedes Feld bedeutet, statt nur, wo es liegt, verarbeitet sie die deutsche Rechnung mit Dezimalkomma, die französischsprachige Rechnung und die US-amerikanische Rechnung in einem Durchgang — ohne Konfiguration pro Lieferant, ohne Vorlagenbibliothek, ohne Wartung, wenn ein Lieferant sein Layout ändert. Wenn ein Lieferant, der seit Monaten verarbeitet wird, plötzlich eine Rechnung mit einem völlig unbekannten Design sendet, verarbeitet die KI sie beim ersten Versuch korrekt. Sie hat sich das alte Layout nie gemerkt, also muss sie nichts verlernen.
Der Durchbruch bei der Spaltenkonsistenz entsteht durch eine einfache Umkehrung: Statt dass das Tool vorgibt, welche Spalten man erhält, gibt man dem Tool vor, welche Spalten man möchte.
Man gibt die Spaltennamen einmal ein — Vendor, Invoice #, PO Reference, Net Amount, VAT, Due Date. Die KI extrahiert passende Daten aus jeder Rechnung in genau diese Spalten, unabhängig davon, wo jeder Lieferant diese Felder platziert oder welche Bezeichnungen er verwendet. Die „Numéro de facture“ eines französischen Lieferanten wird genauso selbstverständlich der Spalte „Invoice #“ zugeordnet wie die „Invoice Number“ eines US-Lieferanten. Batch-Verarbeitung — das gemeinsame Hochladen mehrerer Rechnungen und der Erhalt einer einzigen zusammengeführten Excel-Ausgabe — wird zum Standardmodus, nicht zum nachträglichen Gedanken. Jede Zeile ist eine Rechnung, jede Spalte ist das angegebene Feld, und jeder Lieferant speist sich in dieselbe Struktur ein.
Zwei zusätzliche Funktionen erweitern dies weiter. Berechnete Spalten ermöglichen es, Berechnungen in den Extraktionsprozess einzubetten — eine Spalte als „Line Total (Qty × Unit Price)“ definieren und die KI führt die Arithmetik während der Extraktion aus, sodass berechnete Ergebnisse statt Rohwerten geliefert werden, die in Excel nachbearbeitet werden müssten. Abgeleitete Spalten ermöglichen es der KI, Informationen zu klassifizieren oder abzuleiten, die nicht explizit auf dem Dokument stehen — eine Spalte „Expense Category (options: Office/Logistics/Materials)“ definieren und die KI liest den Rechnungsinhalt, bestimmt die richtige Kategorie und füllt sie aus, wobei Extraktion und Klassifizierung in einem einzigen Schritt kombiniert werden.
Workflow: Vom gemischten Batch zur einheitlichen Tabelle
Der Prozess, der einen gemischten Eingang von 40 Rechnungen von 20 Lieferanten in eine saubere Tabelle verwandelt, umfasst vier Schritte. Keiner davon erfordert Vorlagen, Training oder Konfiguration pro Lieferant.
Batch hochladen
Alle Rechnungen zusammen hochladen – PDFs, Bilder, Scans – unabhängig von Lieferant, Format oder Sprache. Ein Batch mit 40 Rechnungen von 20 verschiedenen Lieferanten in drei Sprachen funktioniert als ein einziger Auftrag. Kein Vorsortieren, kein Trennen nach Lieferant, kein „Dieses Format wird nicht unterstützt."
Spaltennamen eingeben
Die gewünschten Felder genau in den Überschriften eingeben, die die eigene Tabelle oder das ERP verwendet: Vendor, Invoice #, PO Reference, Net Amount, VAT, Due Date. Diese werden zu den Ausgabe-Überschriften für jede Rechnung im Batch. Die Struktur bestimmt das Team – nicht das Tool.
KI gleicht jedes Feld über alle Rechnungen ab
Die KI liest jede Rechnung unabhängig und lokalisiert die angegebenen Felder anhand der Bedeutung statt der Position. „Numéro de facture", „Rechnungsnummer" und „Invoice #" werden alle der Spalte „Invoice #" zugeordnet. Die Verarbeitung dauert etwa 5–10 Sekunden pro Seite.
Eine Tabelle exportieren, eine Zeile pro Rechnung
Als Excel (XLSX), CSV oder JSON herunterladen – eine einzige Datei, ein einziges Blatt, mit den Spaltenüberschriften oben und einer Zeile pro Rechnung. Bereit für den Import in QuickBooks, NetSuite, Xero oder den bestehenden Excel-Tracker ohne Spalten-Neuzuordnung.
Für Teams, die Google Sheets als AP-Tracker nutzen, macht ein Google Sheets-Seitenleisten-Add-on sogar den Download-Schritt überflüssig – extrahierte Daten werden direkt an das aktive Blatt angehängt, mit Spaltenüberschriften, die dem bestehenden Layout entsprechen. Dies ist der logische Endpunkt der tabellenbasierten Extraktion: Die Ausgabe landet dort, wo gearbeitet wird, in der bereits verwendeten Struktur, ohne Zwischenschritte bei der Dateiverwaltung.
Dateien werden sicher verarbeitet und nicht gespeichert.
Für Szenarien, in denen Rechnungen von externen Parteien stammen — Kunden, Außendienstteams, Remote-Büros — bietet Sammellink eine teilbare Upload-Seite. Ein eindeutiger Link wird generiert, mit allen geteilt, die Rechnungen einreichen müssen, und deren Dateien landen direkt in der Verarbeitungswarteschlange. Sie benötigen kein Konto, müssen nichts installieren und sehen keine anderen Uploads. Der Link ist durch einen selbst festgelegten Verifizierungscode geschützt und kann jederzeit aktiviert oder deaktiviert werden.
Formatnormalisierung über Lieferanten hinweg: Daten, Währungen und Zahlenformate
Konsistente Spalten sind die eine Hälfte der Gleichung. Die andere Hälfte sind konsistente Werte innerhalb dieser Spalten. Fünf Lieferanten liefern möglicherweise alle ein Rechnungsdatum — aber sie geben es als „06/15/2026", „15 June 2026", „15.06.2026" und „2026-06-15" an. Drei Lieferanten liefern einen Gesamtbetrag: „$1,250.00", „1.250,00 €" und „¥125.000". Wenn das Extraktionstool diese Rohstrings in die Tabelle übernimmt, ist bei jeder Charge weiterhin eine Formatbereinigung erforderlich.
Semantische Extraktion übernimmt die Formatnormalisierung direkt bei der Extraktion, nicht als Nachbearbeitungsschritt. Die KI erkennt, dass „1.250,00 €" und „$1,250.00" dieselbe numerische Absicht darstellen, und normalisiert sie in das bevorzugte Format — ob US-Dezimalstellen, ISO-Daten oder die spezifischen Zahlenkonventionen, die das ERP erwartet. Datumsformate, Währungssymbole, Tausendertrennzeichen und Dezimalkonventionen werden automatisch über alle Lieferanten hinweg standardisiert.
Die Steueridentifikation fügt eine weitere Ebene hinzu. Ein Lieferant in Großbritannien bezeichnet sie als „VAT". Ein französischer Lieferant als „TVA". Ein deutscher Lieferant als „MwSt." Ein kanadischer Lieferant als „GST". Alle vier Rechnungen enthalten einen Steuerbetrag — und alle vier müssen in der Spalte „Tax" oder „VAT" landen. Da die KI die semantische Äquivalenz dieser Bezeichnungen versteht, anstatt wörtliche Textstrings abzugleichen, fließen alle vier Steuerbeträge in dieselbe Ausgabespalte. Der Spaltenname wurde einmal definiert. Die KI übernimmt die Bezeichnungszuordnung für jeden Lieferanten.
Für Teams, die grenzüberschreitende Rechnungen verarbeiten, kann diese Normalisierung allein Stunden manueller Währungsumrechnung und Datumsneuformatierung einsparen. Ardent Partners berichtet, dass die branchenübliche Ausnahmerate von 22 % bei Top-Teams auf 9 % sinkt — und formatbedingte Ausnahmen (Währungsabweichungen, Datumsfehlinterpretationen, Dezimalfehler) gehören zu den häufigsten Kategorien, die Automatisierung eliminiert.
Über die Konsistenz innerhalb eines einzelnen Batches hinaus sorgt die Batch-Rechnungsextraktion dafür, dass dieselbe Ausgabestruktur über separate Verarbeitungsläufe hinweg erhalten bleibt – das heißt, Rechnungen, die diese Woche verarbeitet werden, und Rechnungen, die nächsten Monat verarbeitet werden, speisen denselben Tracker mit identischen Spaltenlayouts. Es gibt keine monatliche Abweichung bei den Kopfzeilen, weil die Kopfzeilen nicht vom Tool stammen. Sie stammen von Ihnen.
Häufig gestellte Fragen
Kann ein einziges Tool wirklich Rechnungen von über 50 verschiedenen Anbietern verarbeiten, ohne Vorlagen einzurichten?
Ja – das ist der strukturelle Vorteil der semantischen Extraktion gegenüber template-basierter OCR. Template-Tools erfordern eine Zuordnung pro Anbieter, weil sie Felder anhand der Bildschirmposition identifizieren. Semantische Extraktion identifiziert Felder anhand ihrer Bedeutung, sodass die Rechnung des 50. Anbieters durch dieselbe Pipeline läuft wie die des ersten – ohne zusätzliche Konfiguration. Der Kompromiss besteht darin, dass die semantische KI-Extraktion Kosten pro Seite verursacht (kreditbasiert: 1 Kredit = 1 Seite, mit Tarifen ab einem kostenlosen Einstieg, dann 9 $/Monat Basic, 19 $/Monat Pro und 59 $/Monat Max) statt des Pauschalmodells von Template-Tools. Für Teams, die Rechnungen von vielen verschiedenen Anbietern verarbeiten, überwiegt die Einsparung von Wartungsaufwand für Vorlagen die Kosten pro Seite bei Weitem.
Was passiert, wenn ein Anbieter sein Rechnungslayout ändert, nachdem ich die Rechnungen monatelang verarbeitet habe?
Es ändert sich nichts. Template-basierte Tools scheitern, weil das Feld an eine andere Pixelposition verschoben wurde. Semantische Extraktion bezieht sich nicht auf Positionen – sie liest Inhalt und Kontext, sodass eine Layoutänderung keine Auswirkung hat. Die KI verarbeitet das neue Layout genauso wie das alte. Genau das macht die formatunabhängige Extraktion strukturell zuverlässiger im großen Maßstab: Das System baut keine fragilen Abhängigkeiten von Anbieterlayouts auf, die sich unweigerlich ändern.
Woher weiß die KI, welches Feld welches ist, wenn jeder Anbieter andere Bezeichnungen verwendet?
Die KI liest das Dokument ganzheitlich – sie versteht, dass „Numéro de facture“, „Rechnungsnummer“ und „Invoice #“ auf einer Rechnung dieselbe Funktion erfüllen. Das ist semantisches Verständnis, kein Abgleich von Bezeichnungen. Wenn ein angefragtes Feld (z. B. „VAT Rate“) auf einer bestimmten Rechnung nicht vorkommt, bleibt die Zelle leer, statt mit einer Vermutung gefüllt zu werden. Für Felder, die eine Ableitung erfordern – etwa die Klassifizierung einer Ausgabenkategorie anhand von Anbieter und Artikeln – können abgeleitete Spalten verwendet werden, bei denen die KI eine Entscheidung auf Basis des Dokumentinhalts und der angegebenen Optionen trifft.
Wie sieht es mit Positionen aus — können die vollständigen Artikeldetails aus jeder Rechnung extrahiert werden?
Ja. Positionstabellen werden extrahiert, wobei Beschreibung, Menge, Einzelpreis und Positionssumme jeder Zeile erhalten bleiben. Da die KI Tabellenstrukturen semantisch liest (Spaltenbeziehungen werden anhand von Kopfzeilen und Datenausrichtung erkannt, nicht anhand von Gitterlinien), verarbeitet sie die gesamte Bandbreite realer Tabellenformate: umrandete Raster, randlose, auf Abständen basierende Ausrichtungen, mehrseitige Fortsetzungen und gemischte Spaltenreihenfolgen. Berechnete Spalten können Positionssummen während der Extraktion zusätzlich verifizieren — Abweichungen zwischen angegebenen Positionssummen und berechnetem Menge × Einzelpreis werden erkannt, bevor die Daten in die Tabellenkalkulation gelangen.
Können PDFs, gescannte Papierrechnungen und Handyfotos in derselben Charge verarbeitet werden?
Ja. Gemischte Chargen — mit digitalen PDFs, gescannten Papierrechnungen und Handyfotos gedruckter Rechnungen — werden nativ unterstützt. Die KI verarbeitet jede Datei unabhängig vom Ursprungsformat über dieselbe visuelle Verständnispipeline. Gescannte Dokumente und Fotos durchlaufen dieselbe semantische Extraktion wie saubere digitale PDFs. Bei besonders anspruchsvollen Eingaben wie Nadeldruckausdrucken oder Faxen mit niedriger Auflösung hängen die Ergebnisse von der Lesbarkeit ab — die KI kann nicht extrahieren, was sie tatsächlich nicht lesen kann —, aber die überwiegende Mehrheit realer Rechnungsformate wird problemlos verarbeitet.
Funktioniert die Ausgabe mit QuickBooks, NetSuite, Xero, oder muss ich sie umformatieren?
Da die Ausgabespalten selbst definiert werden, liegt die exportierte Tabellenkalkulation bereits im erwarteten Format des Systems vor. Wenn das ERP-System „Vendor" und „Amount" importiert, werden diese Spalten bei der Extraktion entsprechend benannt — es gibt nichts umzuformatieren. Die Ausgabe ist eine Standard-XLSX- oder CSV-Datei, die mit allen gängigen Buchhaltungssystemen kompatibel ist, einschließlich QuickBooks, NetSuite, Xero, SAP, Microsoft Dynamics und Coupa. Der CSV-Import ist der universellste Weg; XLSX wird bevorzugt, wenn der Abstimmungsprozess vor dem Import zusätzliche Tabellenkalkulationsarbeit umfasst.
Was passiert mit Rechnungen in anderen Sprachen als Englisch?
Die KI liest Rechnungen in ihrer Originalsprache – Französisch, Deutsch, Spanisch, Japanisch, Koreanisch und weitere – und extrahiert Daten in Ihre englischen Spaltenüberschriften. „Numéro de facture“ (Französisch) und „Rechnungsnummer“ (Deutsch) werden beide Ihrer Spalte „Invoice Number“ zugeordnet. Die Ausgabe erfolgt immer in der Sprache Ihrer Spaltenüberschriften; die Eingabesprache hat keinen Einfluss auf Ausgabestruktur oder -formatierung. Mehrsprachige Unterstützung ist besonders wertvoll für Unternehmen mit internationalen Lieferketten, bei denen ein einzelner Batch Rechnungen in 3–4 Sprachen enthalten kann.
Der Unterschied liegt in der Ausgabe, nicht in der Extraktion
Tools zur Rechnungsextraktion konvergieren auf ähnliche Fähigkeiten: KI kann jedes Layout, jede Sprache, jedes Format lesen. Dieser Teil wird zur Grundausstattung. Wo sich Tools unterscheiden – und wo AP-Teams erhebliche Arbeitsstunden investieren – ist das, was nach der Extraktion passiert.
Ein Tool, das Daten in ein eigenes festes Spaltenschema extrahiert, zwingt Ihr Team jedes Mal dazu, die Lücke zwischen Tool-Ausgabe und System-Eingabe zu überbrücken. Ein Tool, das Ihnen die Definition der Ausgabespalten ermöglicht, beseitigt diese Lücke vollständig. Die Extraktionsgenauigkeit ist in beiden Fällen gleich. Der Arbeitsaufwand nach der Extraktion nicht.
Für AP-Teams, die Extraktionssoftware bewerten, ist die beste Frage während eines Tests nicht „liest es meine schwierigste Rechnung korrekt?“ – die meisten modernen KI-Tools tun das. Sondern: „Entspricht die Ausgabe meinem bestehenden Tracker ohne manuelles Neuzuordnen?“ Testen Sie mit einem echten Batch und Ihren tatsächlichen Spaltenüberschriften. Wenn die Antwort das Umbenennen von Spalten, das Aufteilen von Werten oder das Neuanordnen von Überschriften beinhaltet, bewerten Sie ein Lesetool, kein Automatisierungstool.
Spaltenkonsistenz ist kein Nice-to-have. Sie ist der Unterschied zwischen Automatisierung, die manuelle Arbeit tatsächlich ersetzt, und Automatisierung, die die manuelle Arbeit nur in einen anderen Schritt verlagert. Testen Sie mit einem Batch Ihrer eigenen Rechnungen von mehreren Lieferanten. Prüfen Sie, ob Ihre gleichen fünf Spalten jedes Mal gleich herauskommen – unabhängig davon, wer die Rechnung gesendet hat, in welcher Sprache sie verfasst ist oder wie das Layout aussieht.