ベンダーごとに異なる請求書を、
1つの統一 スプレッドシート に
異なるベンダーの請求書を処理するうえで最も難しいのは、データを読み取ることではありません。最新のAI抽出ツールは、混在したレイアウトを驚くほど的確に処理します。「1.250,00 €」と記載されたドイツ語のPDF、手書きの金額がある台湾のスキャン、すべてフランス語で書かれたフランスの請求書。AIはどれも正しく読み取ります。本当のボトルネック、つまり自動化を導入した後もAPチームが列の再マッピングを続けてしまう工程は、あらゆるベンダーのフォーマットにわたって同じフィールドを同じ列に配置した一貫した出力を生み出すことです。抽出は読み取りの問題を解決しました。しかしスプレッドシートの問題は解決していません。
主なポイント
- 50社のベンダーが50通りの異なるフォーマットで請求書を送ってきて、そのうち1社たりともAPワークフローのためにレイアウトを再設計してくれることはありません。
- 200社のベンダーがいて18か月ごとに1件のレイアウト変更が起きると、請求書を1通も開く前に毎月11件の壊れたテンプレートに対応することになります。
- ベンダーのレイアウトを追いかけるのはやめ、あらゆるフォーマットを吸収するエンドポイントになりましょう。列を一度定義すれば、すべての請求書が永遠に同じ構造に収まります。
抽出だけではデータ入力の問題は解決しない理由
抽出は成功しました。すべてのフィールドが正しく取得されています — Supplier Nameは「ABC Corp」、Invoice Dateは「06/15/2026」、Totalは「$1,250.00」と表示されています。しかし出力されたスプレッドシートを開くと、APトラッカーが期待するのは「Supplier Name」ではなく「Vendor」です。
ここで多くの自動化の約束が崩れます。Ardent Partnersの「AP Metrics that Matter in 2025」によると、最高クラスのAPチームは請求書を1件あたり$2.78、3.1日で処理している一方、業界平均は9.2日、請求書1件あたり$9.40で、例外率は22%に達し、データが転送先システムの期待する形式と一致しない場合にはさらに膨らみます1。APQCのOpen Standards Benchmarkingデータでは、中央値の組織における請求書1件あたりのコストはさらに高く、$21.40となっています2。
列名が1つ間違っているだけ — 「Vendor」ではなく「Supplier Name」 — は壊滅的に聞こえません。しかし、40社のベンダーから毎月届く200件の請求書にこれが積み重なると、再マッピングの作業はサイクルごとに何時間ものスプレッドシート作業に膨れ上がります。Institute of Finance & Management(IOFM)は、データ入力エラー1件を解決するのに平均$53の人件費がかかると推定しています3。抽出ツールは役割を果たしました。それでもスプレッドシートを実用的にするには人の手が必要です。
ほとんどのチームはこの現実に苦労して気づきます。抽出ツールに投資し、最初の請求書バッチが正しく処理されたことを喜び、そして何ヶ月も経ってから気づくのです — 正しい抽出と使える出力は別物であると。ツールは設計されたとおりのものをエクスポートします。QuickBooksインスタンスは設計されたとおりのものをインポートします。その2つのスキーマの間のギャップこそ、APチームが午後を費やす場所です。
「ベンダーごとに異なるフォーマット」の実際の意味
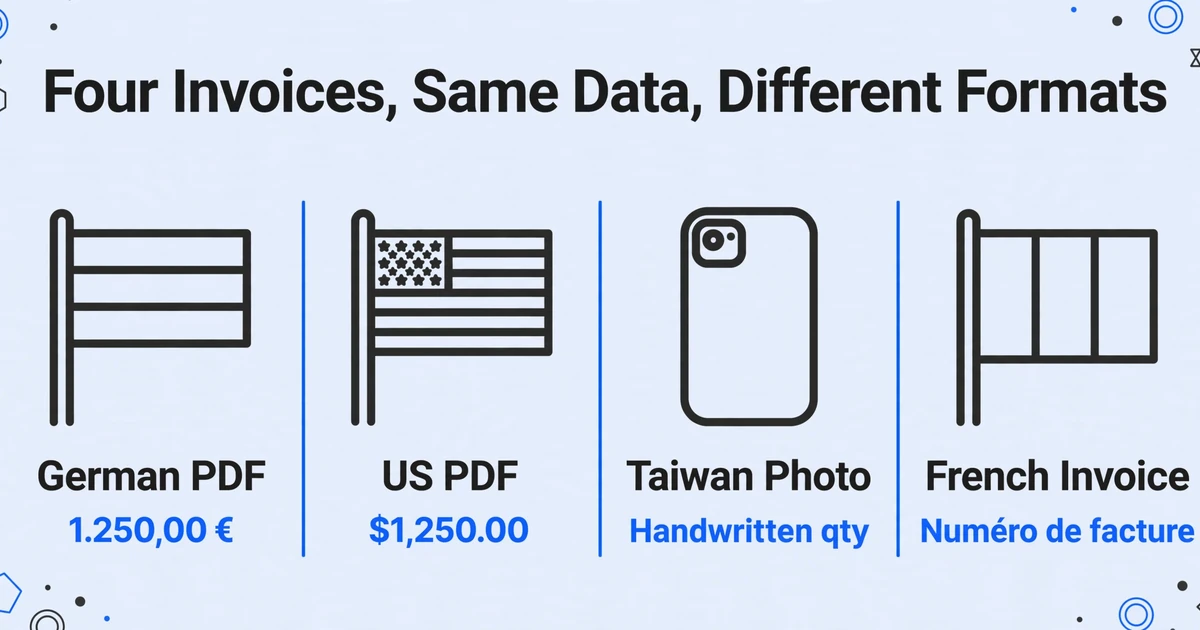
「異なるフォーマット」という表現は問題を過小評価しています。ベンダーAが請求書番号を右上隅に置き、ベンダーBがヘッダーの中央に配置するというだけの話ではありません。違いはフィールドの配置よりもはるかに深く、その一つひとつがデータ整合性の潜在的な問題となります。
ある火曜日の実際のAP受信トレイを考えてみましょう。ドイツの産業サプライヤーは小数点にカンマ、桁区切りにピリオドを使ったクリーンなPDFを送ってきます:「1.250,00 €」。米国のオフィス用品ベンダーは標準的なドル形式のデジタルPDFを送ってきます:「$1,250.00」。台湾の部品メーカーは、事前印刷されたフォームに手書きの数量が記入された紙の請求書をスマホで撮影してメールで送ってきます。フランスのコンサルティング会社は請求書を完全にフランス語で送ってきます — 「Invoice Number」ではなく「Numéro de facture」、「VAT」ではなく「TVA」、「Due Date」ではなく「Échéance」。
4つの請求書はすべて同じ基盤となるビジネスデータを含んでいます。4つすべてが、同じスプレッドシートの同じ列に同じ書式で収まる必要があります。これが整合性の課題であり、ほとんどの抽出ツールが解決できていないものです。
Redditのr/Accountingで、あるAP担当者がこの問題を率直に表現しています:「NetSuiteに組み込まれているOCRを試しましたが、うちの請求書の半分でつまずきます。町工場や原材料サプライヤーはそれぞれ違うフォーマットで送ってくるからです。」4 これは珍しい例外ケースではありません。少数以上のサプライヤーから購入している中堅企業のAPにとっては日常的な現実です。そして成長するにつれて問題は悪化します:ベンダーが増え、フォーマットが増え、ばらつきが増えるのです。
r/automationで、別の実務家が構造的な問題を確認しています:「テンプレートベースの抽出はフォーマット変更で壊れます。PDFページ上の固定座標でデータを見るツールは、あるレイアウトから別のレイアウトに切り替えた瞬間、あるいはサプライヤーが請求書デザインを更新した瞬間に失敗します。」5 テンプレートベースのツール — ベンダーごとに「Invoice Number = 右上、端から2cm」を一度マッピングする必要があるタイプ — は、事前設定だけでなく継続的なメンテナンスを必要とします。ベンダーが会計ソフトをアップグレードしたら?テンプレートが壊れます。新しいサプライヤーを追加したら?新しいテンプレートを構築することになります。200のベンダーが平均18か月ごとに1回レイアウトを変更すると、月に約11のテンプレートが壊れる計算になります — これは位置ベースの抽出が決して安定しないという構造的な保証です。
列の一貫性という問題
AI請求書抽出ツールを使ったことがあれば、おそらくこの流れを経験しているはずです。請求書をバッチでアップロード → AIがすべてのフォーマットにわたってデータを正しく抽出 → 出力されたExcelをダウンロード → すると列ヘッダーが自社のトラッカーと一致しないことに気づく。
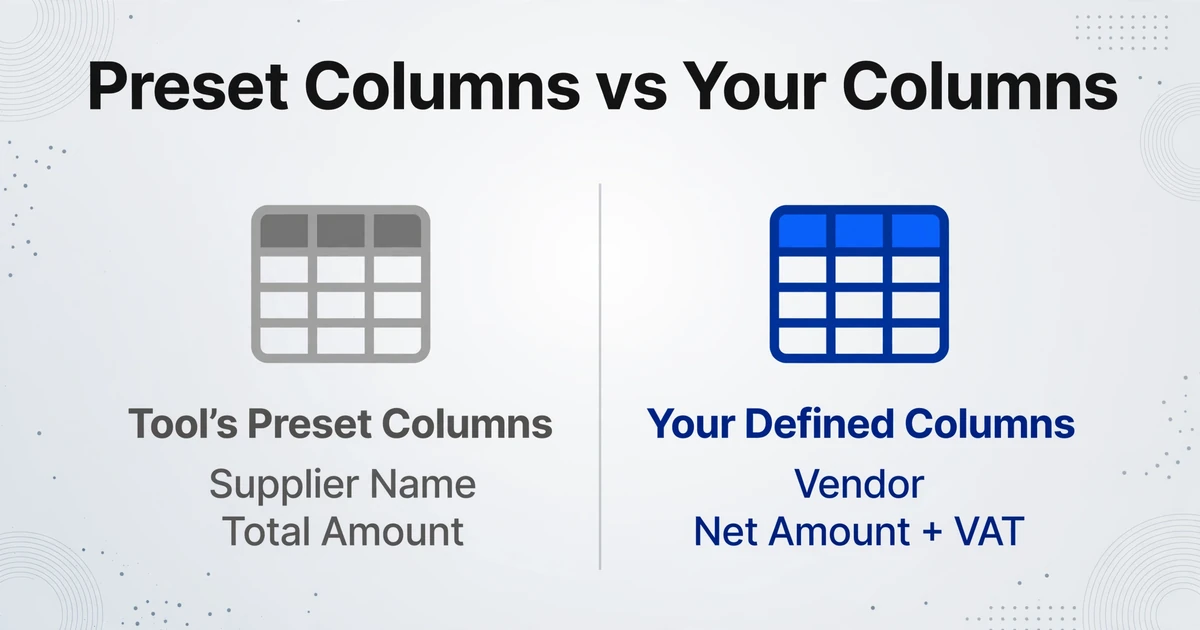
ほとんどのAI抽出ツールは固定の出力スキーマで提供されます。 ツール側が、列はSupplier Name、Invoice Date、Invoice Number、PO Number、Total Amountだと決めています。これは財務チームが一般に何を求めているかについての、ツールによる最善の推測です。多くのワークフローでは、ほぼ近い。しかし「ほぼ近い」ということは、依然として再マッピングが必要だということです。自社のトラッキングシートでは「Supplier Name」ではなく「Vendor」を使っています。承認ワークフローでは、単一のTotal Amountではなく、Net AmountとVATを分けて出力する必要があります。Payment Termsはプリセットのフィールド一覧にそもそも含まれていません。各バッチは手作業での列名変更という雑用で終わります。同じ列を、毎回名前変更するのです。
核心的な問題は、カスタム列抽出 — 自分で列名を入力し、AIにその列へデータをマッピングさせること — が、ツール側であらかじめ列を定義するツールとは根本的に異なるという点です。プリセット列では、自社のワークフローをツールの出力スキーマに合わせることになります。ユーザー定義列では、ツールがその出力を自社のワークフローに合わせます。一方の方向は摩擦を生みます。もう一方は生みません。
ここで「抽出精度」と「出力の使いやすさ」の区別が具体的になります。抽出パイプラインは値を読む精度が99%であっても、NetSuite、Xero、あるいは自社のExcelトラッカーにインポートする前に20分の手作業のスプレッドシート作業を要する出力を、依然として生み出す可能性があります。AIは難しい読み取りの問題を解決しました。それでも最後に手作業のステップが残っています。それは以前とは違う手作業のステップにすぎません。
APチームが50社以上のサプライヤーからの請求書を、固定の出力ヘッダーを持つツールで処理すると、どのバッチも同じ不一致で届きます。ERPが「Vendor」を期待する箇所に「Supplier Name」、承認ワークフローが「Net」と「Tax」を別々に必要とする箇所に「Total Amount」。再マッピングは難しくありません — 3つの列名変更と数式による分割 — しかしそれが毎回のバッチで、永遠に繰り返されます。 それは自動化ではありません。手入力の支援です。
テンプレート不要の抽出が一貫した出力を生み出す仕組み
この変化は、位置ベースの抽出から意味ベースの抽出へ移行したときに起こります。テンプレートツールは座標を読み取ります。「請求書番号はX:200、Y:45にあります」というように。テンプレート不要のAIは意図を読み取ります。「請求書番号を意味するフィールドを、それがどこにあっても見つける」というように。
これがフォーマット非依存抽出の背後にある根本的なメカニズムです。AIは各フィールドがどこにあるかだけでなく、何を意味するかを理解するため、ドイツ式の小数点カンマの請求書も、フランス語の請求書も、米国式の請求書も、1回の処理で扱えます。ベンダーごとの設定も、テンプレートライブラリも、ベンダーがレイアウトを変更したときのメンテナンスも不要です。何ヶ月も処理してきた仕入先が、まったく見慣れないデザインの請求書を突然送ってきても、AIは初回で正しく処理します。以前のレイアウトを記憶していないので、学習し直す必要もありません。
列の一貫性という飛躍的な進歩は、シンプルな逆転から生まれます。ツールが取得できる列を教えてくれるのではなく、あなたがツールに必要な列を指定するのです。
列名を一度入力するだけです — Vendor、Invoice #、PO Reference、Net Amount、VAT、Due Date。AIはすべての請求書から一致するデータをそれらの正確な列に抽出します。各ベンダーがそれらのフィールドをどこに配置していても、どのようなラベルを使用していても関係ありません。フランスの仕入先の「Numéro de facture」は、米国の仕入先の「Invoice Number」と同じように自然に「Invoice #」列にマッピングされます。バッチ処理 — 複数の請求書をまとめてアップロードし、1つの結合されたExcel出力を受け取ること — が標準モードになります。後付けではありません。各行が1つの請求書、各列が指定したフィールドであり、すべてのベンダーが同じ構造に統合されます。
さらに2つの機能がこれを拡張します。計算列を使用すると、抽出プロセスに計算を組み込めます。「Line Total (Qty × Unit Price)」として列を定義すると、AIは抽出中に算術演算を実行するため、Excelで後処理が必要な生の値ではなく、計算済みの答えを受け取れます。推論列を使用すると、AIが文書に明示的に記載されていない情報を分類または導出できます。「Expense Category (options: Office/Logistics/Materials)」という列を定義すると、AIは請求書の内容を読み取り、正しいカテゴリを判断して入力します。抽出と分類を1つのステップに組み合わせます。
ワークフロー:混在バッチから統合スプレッドシートへ
20社のベンダーからの請求書40件が混在する受信トレイを、1つのクリーンなスプレッドシートに変換するプロセスは、4つのステップで構成されます。いずれもテンプレート、トレーニング、ベンダーごとの設定は不要です。
バッチをアップロード
ベンダー、形式、言語に関係なく、すべての請求書(PDF、画像、スキャン)をまとめてドロップします。3言語・20社のベンダーからの請求書40件も、1つのジョブとして処理できます。事前の仕分け、ベンダーごとの分離、「この形式はサポートされていません」というエラーも不要です。
列名を入力
スプレッドシートやERPで使用している正確なヘッダー名で、必要なフィールドを入力します:Vendor, Invoice #, PO Reference, Net Amount, VAT, Due Date。これらがバッチ内のすべての請求書の出力ヘッダーになります。構造を定義するのはツールではなく、あなたです。
AIが各請求書の全フィールドを照合
AIは各請求書を個別に読み取り、位置ではなく意味に基づいて指定されたフィールドを特定します。「Numéro de facture」「Rechnungsnummer」「Invoice #」はすべて「Invoice #」列にマッピングされます。処理速度は1ページあたり約5〜10秒です。
1つのスプレッドシートに、請求書ごとに1行でエクスポート
Excel(XLSX)、CSV、JSONでダウンロード — 1つのファイル、1つのシートに、上部に列ヘッダー、請求書ごとに1行で出力されます。列の再マッピング不要で、QuickBooks、NetSuite、Xero、または既存のExcelトラッカーにそのままインポートできます。
Google SheetsをAPトラッカーとして使用しているチームには、Google Sheetsサイドバーアドオンがダウンロードステップさえも不要にします — 抽出されたデータは既存のレイアウトに一致する列ヘッダーで、アクティブなシートに直接追加されます。これはスプレッドシートネイティブ抽出の論理的な到達点です:出力は中間ファイルの処理なしで、作業場所に、すでに使用している構造で届きます。
ファイルは安全に処理され、保存されません。
請求書が外部の関係者(クライアント、現場チーム、リモートオフィス)から届く場合、コレクションリンクは共有可能なアップロードページを提供します。固有のリンクを生成し、請求書を提出する必要がある人と共有するだけで、ファイルは直接処理キューに届きます。相手はアカウント登録もインストールも不要で、他のアップロードを見ることもできません。リンクは設定した認証コードで保護され、いつでもオン/オフを切り替えられます。
ベンダー間のフォーマット正規化:日付、通貨、数値形式
一貫した列は方程式の半分に過ぎません。残りの半分は、列内の一貫した値です。5つのベンダーがすべて請求日を提供しても、「06/15/2026」「15 June 2026」「15.06.2026」「2026-06-15」のように表現はさまざまです。3つのベンダーが合計金額を提供する場合も、「$1,250.00」「1.250,00 €」「¥125,000」と異なります。抽出ツールがこれらの生の文字列をそのままスプレッドシートに出力するなら、毎バッチでフォーマットのクリーンアップ作業が発生します。
セマンティック抽出は、後処理ステップではなく抽出時点でフォーマット正規化を処理します。AIは「1.250,00 €」と「$1,250.00」が同じ数値的意図を表すことを認識し、希望する形式(米国式の小数、ISO日付、ERPが期待する特定の数値規則など)に正規化します。日付形式、通貨記号、桁区切り、小数規則は、全ベンダーにわたって自動的に標準化されます。
税識別番号ももう一つのレイヤーを追加します。英国のベンダーは「VAT」、フランスのベンダーは「TVA」、ドイツのベンダーは「MwSt」、カナダのベンダーは「GST」と表示します。4つの請求書すべてに税額が含まれており、すべて「Tax」または「VAT」列に格納される必要があります。AIは文字列の完全一致ではなく、これらのラベルの意味的等価性を理解するため、4つの税額すべてが同じ出力列に流れ込みます。列名は一度定義するだけです。AIが全ベンダーにわたるラベルマッピングを処理します。
越境請求書を処理するチームにとって、この正規化だけで手動の通貨換算と日付再フォーマットの時間を大幅に削減できます。Ardent Partnersは、業界平均の例外率22%が、ベストインクラスのチームでは9%に低下すると報告しています。フォーマット起因の例外(通貨の不一致、日付の誤解釈、小数エラー)は、自動化が排除する最も一般的なカテゴリの一つです。
単一バッチの一貫性を超えて、バッチ請求書抽出は、別々の処理ジョブ間でも同じ出力構造を維持します。つまり、今週処理した請求書も来月処理する請求書も、同じトラッカーに同じ列レイアウトで取り込まれます。ヘッダーはツールから来るものではないため、月ごとのずれは発生しません。ヘッダーはあなたが定義するものだからです。
よくある質問
1つのツールで、テンプレートを一切設定せずに50社以上の異なるベンダーの請求書を本当に処理できますか?
はい、それがテンプレートベースのOCRに対するセマンティック抽出の構造的な利点です。テンプレートツールは画面上の位置でフィールドを識別するため、ベンダーごとのマッピングが必要です。セマンティック抽出はフィールドの意味で識別するため、50社目のベンダーの請求書も1社目と同じパイプラインで、追加設定なしで処理されます。トレードオフとして、セマンティックAI抽出はページごとのコストがかかります(クレジット制:1クレジット=1ページ。無料プランから始まり、Basic月額$9、Pro月額$19、Max月額$59)。テンプレートツールの定額制とは異なります。多様なベンダーの請求書を処理するチームにとって、テンプレート保守の手間がなくなることは、ページごとのコストを十分に上回る価値があります。
数か月間処理を続けた後、ベンダーが請求書のレイアウトを変更したらどうなりますか?
何も変わりません。テンプレートベースのツールは、フィールドが別のピクセル位置に移動すると機能しなくなります。セマンティック抽出は位置を参照せず、内容と文脈を読み取るため、レイアウトの変更は影響しません。AIは新しいレイアウトを以前と同じように処理します。これこそが、フォーマット非依存の抽出が大規模運用で構造的により信頼できる理由です。システムは、いずれ必ず変更されるベンダーのレイアウトに対する脆弱な依存関係を蓄積しないからです。
ベンダーごとにラベルが異なる場合、AIはどのフィールドが何かをどうやって判断するのですか?
AIは文書を全体として読み取ります。「Numéro de facture」「Rechnungsnummer」「Invoice #」がすべて請求書上で同じ機能を果たすことを理解します。これはラベルの照合ではなく、セマンティックな理解です。リクエストしたフィールド(例:「VAT Rate」)が特定の請求書に存在しない場合、推測で埋めるのではなく、セルは空白のままにされます。ベンダーと品目に基づいて経費カテゴリを分類するなど、推論が必要なフィールドには、推論列を使用できます。AIが文書の内容と指定されたオプションに基づいて判断を下します。
明細項目はどうですか — 各請求書から製品レベルの詳細をすべて抽出できますか?
はい。明細テーブルは、各行の説明、数量、単価、行合計が保持された状態で抽出されます。AIがテーブル構造を意味的に読み取るため(グリッド線ではなく、ヘッダーとデータの配置から列の関係を認識)、罫線のあるグリッド、罫線のないスペースベースの配置、複数ページにわたる続き、列の順序が混在するものなど、実世界のあらゆるテーブル形式に対応します。計算列を使用すると、抽出時に明細合計を検証でき、記載された明細合計と計算上の数量×単価の差異を、データがスプレッドシートに届く前にフラグ付けできます。
PDF、スキャンした紙の請求書、スマホの写真を同じバッチで処理できますか?
はい。デジタルPDF、スキャンした紙の請求書、印刷された請求書のスマホ写真を組み合わせた混合形式バッチにネイティブ対応しています。AIは、元の形式に関係なく、各ファイルを同じ視覚的理解パイプラインで処理します。スキャン文書や写真も、クリーンなデジタルPDFと同じ意味的抽出が行われます。ドットマトリックス印刷や低解像度のファックスなど特に難しい入力の場合、結果は可読性に依存します — AIは実際に読めないものは抽出できません — しかし、実世界の請求書形式の大半は問題なく処理されます。
出力はQuickBooks、NetSuite、Xeroで使えますか、それとも再フォーマットが必要ですか?
出力列を自分で定義するため、エクスポートされるスプレッドシートはすでにシステムの期待する形式になっています。ERPが「Vendor」と「Amount」をインポートする場合、抽出時にそれらの列を「Vendor」と「Amount」と名付けるだけです — 再フォーマットの必要はありません。出力は標準のXLSXまたはCSVファイルで、QuickBooks、NetSuite、Xero、SAP、Microsoft Dynamics、Coupaなど、主要な会計システムすべてと互換性があります。CSVインポートが最も汎用的な方法です。インポート前の照合プロセスで追加のスプレッドシート作業が必要な場合は、XLSXが推奨されます。
英語以外の言語の請求書はどうなりますか?
AIは請求書を元の言語(フランス語、ドイツ語、スペイン語、日本語、韓国語など)で読み取り、データを英語の列ヘッダーに抽出します。「Numéro de facture」(フランス語)と「Rechnungsnummer」(ドイツ語)はどちらも「Invoice Number」列にマッピングされます。出力は常に列ヘッダーの言語になります。入力言語は出力構造や書式に影響しません。多言語対応は、国際的なサプライチェーンを持つ企業にとって特に価値があります。単一のバッチに3〜4言語の請求書が含まれる場合があるからです。
違いは抽出ではなく出力にある
請求書抽出ツールは同様の機能に収束しています。AIはあらゆるレイアウト、あらゆる言語、あらゆる形式を読み取れます。その部分は当たり前になりつつあります。ツールが分岐する点、そしてAPチームが人件費で実際にコストを費やす点は、抽出後の処理にあります。
データを自社の固定列スキーマに抽出するツールでは、チームは毎回ツールの出力と自社システムの入力の間のギャップを埋める必要があります。出力列を定義できるツールなら、そのギャップは完全に解消されます。抽出精度はどちらの場合も同じです。抽出後の作業量は異なります。
抽出ソフトウェアを評価するAPチームにとって、トライアル中に尋ねるべき最良の質問は「最も難しい請求書を正しく読み取れるか」ではありません。最新のAIツールのほとんどはそれができます。重要なのは「出力が手動での再マッピングなしで既存のトラッカーに一致するか」です。実際のバッチを実際の列ヘッダーでテストしてください。列の名前変更、値の分割、ヘッダーの並べ替えが必要な場合は、自動化ツールではなく読み取りツールを評価していることになります。
列の一貫性は付加機能ではありません。手作業を実際に置き換える自動化と、手作業を別のステップに移すだけの自動化の違いです。複数のベンダーからの自社の請求書のバッチでテストしてください。送信者が誰であれ、言語が何であれ、レイアウトがどうであれ、同じ5つの列が毎回同じように出力されるか確認してください。