Factures fournisseurs différentes,
un seul tableau cohérent
Le plus difficile dans le traitement des factures de différents fournisseurs n'est pas de lire les données. Les outils d'extraction IA modernes gèrent étonnamment bien les mises en page mixtes — un PDF allemand avec « 1.250,00 € », un scan taïwanais avec des montants manuscrits, une facture française entièrement libellée en français. L'IA les lit toutes correctement. Le véritable goulot d'étranglement, l'étape qui pousse les équipes AP à remapper les colonnes longtemps après avoir adopté l'automatisation, est de produire une sortie cohérente avec les mêmes champs dans les mêmes colonnes pour chaque format fournisseur. L'extraction a résolu le problème de la lecture. Elle n'a pas résolu le problème du tableur.
Points clés
- Vos 50 fournisseurs vous envoient des factures dans 50 formats différents et aucun d'entre eux ne redessinera jamais sa mise en page pour votre flux de travail AP.
- Avec 200 fournisseurs et un changement de mise en page tous les 18 mois, vous gérez 11 modèles cassés par mois avant même d'ouvrir une seule facture.
- Cessez de courir après les mises en page des fournisseurs et devenez un point de terminaison qui absorbe tout format — définissez vos colonnes une fois et chaque facture atterrit dans la même structure pour toujours.
Pourquoi l'extraction seule ne résout pas le problème de la saisie de données
L'extraction a fonctionné. Chaque champ a été capturé correctement — Supplier Name affiche « ABC Corp », Invoice Date affiche « 06/15/2026 », Total affiche « $1,250.00 ». Puis vous ouvrez le tableur de sortie et votre suivi AP attend « Vendor », pas « Supplier Name ».
C'est le moment où la plupart des promesses d'automatisation s'effondrent. L'étude AP Metrics that Matter in 2025 d'Ardent Partners révèle que si les meilleures équipes AP traitent les factures en 3,1 jours à $2,78 chacune, la moyenne du secteur se situe à 9,2 jours et $9,40 par facture, avec un taux d'exception de 22 % qui explose lorsque les données ne correspondent pas au format attendu par le système de destination1. Les données d'Open Standards Benchmarking d'APQC situent le coût médian encore plus haut, à $21,40 par facture pour les organisations à performance médiane2.
Une seule colonne mal nommée — « Supplier Name » au lieu de « Vendor » — ne semble pas catastrophique. Mais multipliez-la sur 200 factures de 40 fournisseurs, chacune arrivant mensuellement, et l'effort de remappage se transforme en heures de travail sur tableur à chaque cycle. L'Institute of Finance & Management (IOFM) estime que la résolution d'une seule erreur de saisie coûte en moyenne $53 en temps de personnel3. L'outil d'extraction a fait son travail. Le tableur a encore besoin d'un humain pour être exploitable.
La plupart des équipes arrivent à cette conclusion à leurs dépens : elles investissent dans un outil d'extraction, se réjouissent lorsque le premier lot de factures est traité correctement, puis découvrent — mois après mois — que l'extraction correcte et une sortie exploitable sont deux choses différentes. L'outil exporte ce pour quoi il a été conçu. Votre instance QuickBooks importe ce pour quoi elle a été conçue. L'écart entre ces deux schémas, c'est là que les équipes AP passent leurs après-midis.
Ce que « formats de fournisseurs différents » signifie réellement
L'expression « formats différents » minimise le problème. Il ne s'agit pas simplement du fait que le fournisseur A place le numéro de facture dans le coin supérieur droit et que le fournisseur B le centre dans l'en-tête. Les différences sont bien plus profondes que l'emplacement des champs — et chacune constitue un risque potentiel d'incohérence des données.
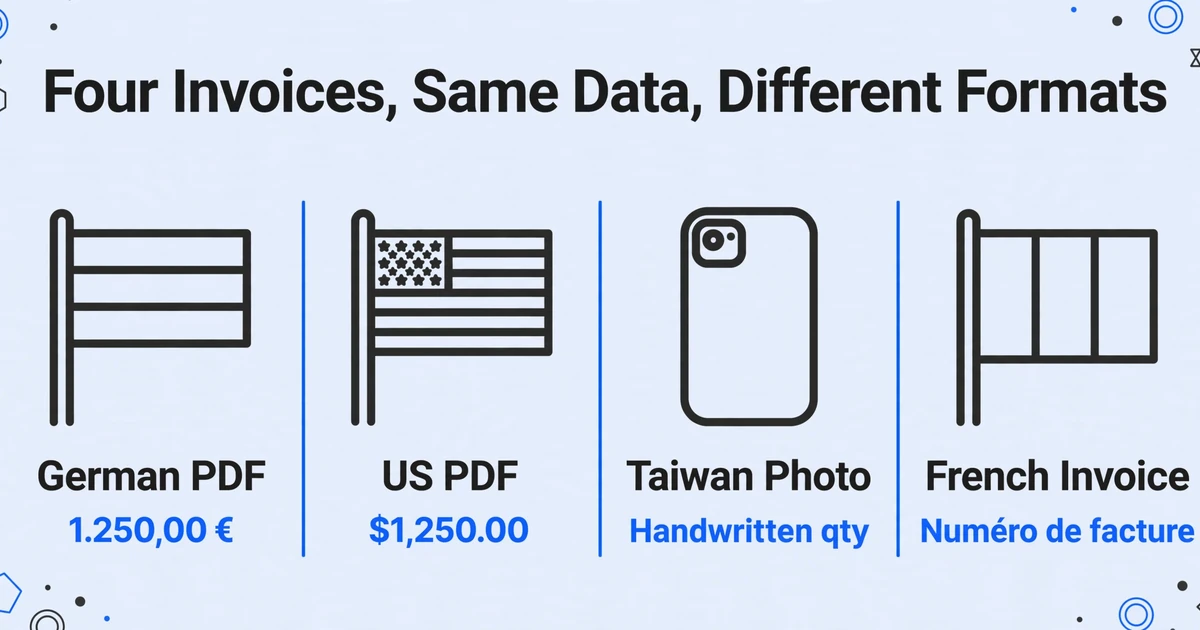
Prenons une boîte de réception AP réelle un mardi ordinaire. Le fournisseur industriel allemand envoie un PDF propre avec des virgules décimales et des points comme séparateurs de milliers : « 1.250,00 € ». Le fournisseur américain de fournitures de bureau envoie un PDF numérique au format dollar standard : « $1,250.00 ». Le fabricant taïwanais de composants envoie par e-mail la photo prise au téléphone d'une facture papier avec des quantités manuscrites sur un formulaire préimprimé. Le cabinet de conseil français envoie une facture entièrement en français — « Numéro de facture » au lieu de « Invoice Number », « TVA » au lieu de « VAT », « Échéance » au lieu de « Due Date ».
Les quatre factures contiennent les mêmes données commerciales sous-jacentes. Les quatre doivent aboutir dans le même tableur, dans les mêmes colonnes, avec le même formatage. C'est là le défi de la cohérence — et c'est celui que la plupart des outils d'extraction ne résolvent pas.
Sur r/Accounting de Reddit, un professionnel AP a décrit le problème sans détour : « Nous avons essayé l'OCR intégré à NetSuite, mais il bloque sur la moitié de nos factures parce que chaque atelier d'usinage et chaque fournisseur de matières premières formate les siennes différemment. »4 Ce n'est pas un cas isolé. C'est la réalité quotidienne des équipes AP dans toute entreprise de taille intermédiaire qui achète auprès de plus d'une poignée de fournisseurs. Et le problème s'aggrave à mesure que l'entreprise grandit : plus de fournisseurs, plus de formats, plus de variation.
Sur r/automation, un autre praticien a confirmé le problème structurel : « L'extraction basée sur des modèles casse dès que le format change. Les outils qui examinent les données à des coordonnées fixes sur une page PDF échouent dès que l'on passe d'une mise en page à une autre, ou lorsqu'un fournisseur modifie la conception de sa facture. »5 Les outils basés sur des modèles — ceux qui exigent de définir « Invoice Number = en haut à droite, à 2 cm du bord » une fois par fournisseur — n'exigent pas seulement une configuration initiale. Ils exigent une maintenance continue. Un fournisseur met à jour son logiciel comptable ? Votre modèle casse. Vous intégrez un nouveau fournisseur ? Vous créez un nouveau modèle. Avec 200 fournisseurs et une modification de mise en page tous les 18 mois en moyenne, cela représente environ 11 modèles cassés par mois — une garantie structurelle que l'extraction positionnelle ne pourra jamais se stabiliser.
Le problème de la cohérence des colonnes
Si vous avez déjà utilisé un outil d'extraction de factures par IA, vous avez probablement vécu cette séquence : importer un lot de factures → l'IA extrait correctement les données de tous les formats → vous téléchargez l'Excel de sortie → et vous découvrez que les en-têtes de colonnes ne correspondent pas à votre suivi.
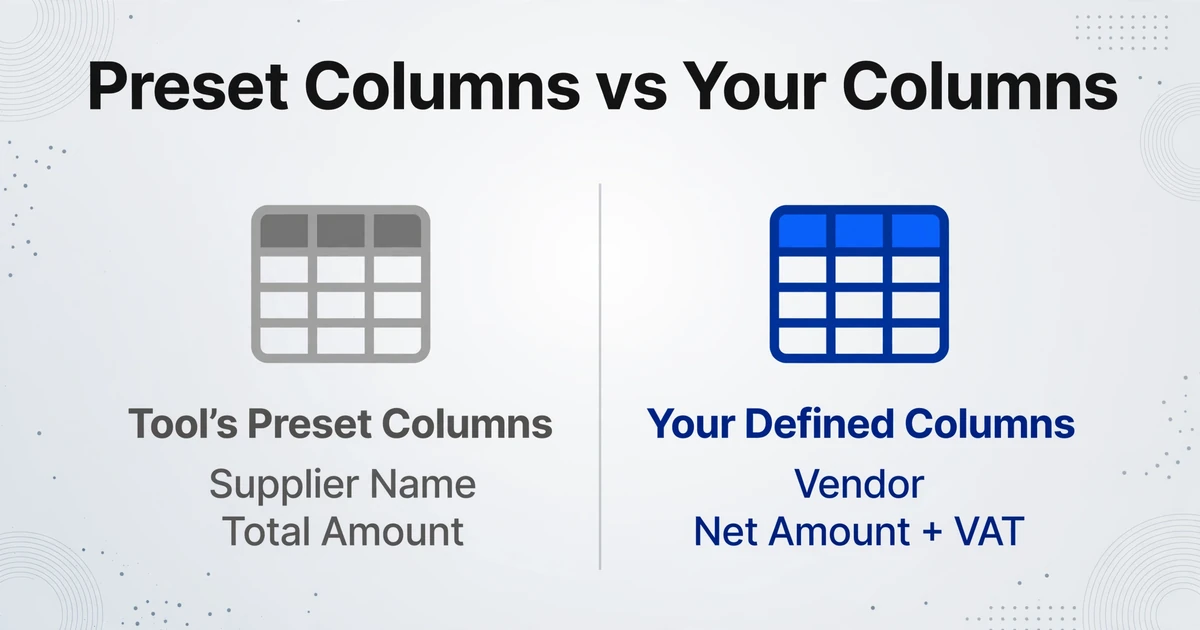
La plupart des outils d'extraction par IA proposent un schéma de sortie figé. L'outil décide que vos colonnes s'appellent Supplier Name, Invoice Date, Invoice Number, PO Number et Total Amount. C'est la meilleure estimation de l'outil quant à ce que veulent généralement les équipes financières. Pour de nombreux flux de travail, c'est proche. Mais « proche » signifie qu'il faut quand même tout remapper : votre feuille de suivi utilise « Vendor » et non « Supplier Name ». Votre flux d'approbation a besoin de Net Amount et VAT séparés, pas d'un seul Total Amount. Payment Terms n'est même pas dans la liste des champs prédéfinis. Chaque lot se termine par une corvée manuelle de renommage des colonnes — les mêmes colonnes, renommées à chaque fois.
Le problème de fond, c'est que Extraction de colonnes personnalisées — saisir vos propres noms de colonnes et laisser l'IA y mapper les données — est fondamentalement différent d'un outil qui prédéfinit les colonnes pour vous. Avec des colonnes prédéfinies, vous adaptez votre flux de travail au schéma de sortie de l'outil. Avec des colonnes définies par l'utilisateur, l'outil adapte sa sortie à votre flux de travail. Une direction crée des frictions. L'autre non.
C'est ici que la distinction entre « précision d'extraction » et « exploitabilité de la sortie » devient concrète. Un pipeline d'extraction peut être précis à 99 % dans la lecture des valeurs — et produire malgré tout une sortie qui exige 20 minutes de travail manuel sur tableur avant de pouvoir être importée dans NetSuite, Xero ou votre suivi Excel. L'IA a résolu le problème difficile de la lecture. Vous effectuez toujours une étape manuelle à la fin — c'est simplement une étape manuelle différente de celle d'avant.
Quand une équipe AP traite des factures de plus de 50 fournisseurs via un outil aux en-têtes de sortie figés, chaque lot arrive avec le même décalage : « Supplier Name » là où l'ERP attend « Vendor », « Total Amount » là où le flux d'approbation a besoin de « Net » et « Tax » séparément. Le remappage n'est pas difficile — trois renommages de colonnes et une formule de séparation — mais il se répète à chaque lot, indéfiniment. Ce n'est pas de l'automatisation. C'est de la saisie manuelle assistée.
Comment l'extraction sans modèle crée une sortie cohérente
Le changement se produit lorsque vous passez de l'extraction basée sur la position à l'extraction basée sur la sémantique. Les outils basés sur des modèles lisent les coordonnées : « Le numéro de facture se trouve à X:200, Y:45. » L'IA sans modèle lit l'intention : « Trouvez le champ qui signifie numéro de facture, où qu'il se trouve. »
C'est le mécanisme fondamental derrière l'extraction indépendante du format. Parce que l'IA comprend ce que chaque champ signifie plutôt que simplement où il se trouve, elle traite la facture allemande à virgule décimale, la facture en français et la facture de style américain en une seule passe — sans configuration par fournisseur, sans bibliothèque de modèles, sans maintenance lorsqu'un fournisseur modifie sa mise en page. Lorsqu'un fournisseur que vous traitez depuis des mois envoie soudainement une facture avec un design entièrement inconnu, l'IA la traite correctement dès la première tentative. Elle n'a jamais mémorisé l'ancienne mise en page, elle n'a donc rien à désapprendre.
La percée de la cohérence des colonnes vient d'une simple inversion : au lieu que l'outil vous dise quelles colonnes vous obtenez, vous dites à l'outil quelles colonnes vous voulez.
Vous saisissez vos noms de colonnes — Vendor, Invoice #, PO Reference, Net Amount, VAT, Due Date — une seule fois. L'IA extrait les données correspondantes de chaque facture dans ces colonnes exactes, quel que soit l'endroit où chaque fournisseur place ces champs ou les étiquettes qu'il utilise. Le « Numéro de facture » d'un fournisseur français correspond à votre colonne « Invoice # » aussi naturellement que le « Invoice Number » d'un fournisseur américain. Le traitement par lots — téléverser plusieurs factures ensemble et recevoir un seul fichier Excel fusionné — devient le mode par défaut, et non une réflexion après coup. Chaque ligne est une facture, chaque colonne est le champ que vous avez spécifié, et chaque fournisseur alimente la même structure.
Deux capacités supplémentaires vont plus loin. Les colonnes calculées vous permettent d'intégrer des calculs dans le processus d'extraction — définissez une colonne comme « Line Total (Qty × Unit Price) » et l'IA effectue l'arithmétique pendant l'extraction, afin que vous receviez des réponses calculées plutôt que des valeurs brutes nécessitant un post-traitement dans Excel. Les colonnes inférées permettent à l'IA de classer ou de dériver des informations non explicitement écrites sur le document — définissez une colonne « Expense Category (options: Office/Logistics/Materials) » et l'IA lit le contenu de la facture, détermine la catégorie correcte et la remplit, combinant extraction et classification en une seule étape.
Workflow : du lot mixte à la feuille de calcul unifiée
Le processus qui transforme une boîte de réception mixte de 40 factures provenant de 20 fournisseurs en une feuille de calcul propre suit quatre étapes. Aucune d'elles n'implique de modèles, de formation ou de configuration par fournisseur.
Téléversez votre lot
Déposez toutes les factures ensemble — PDF, images, scans — quel que soit le fournisseur, le format ou la langue. Un lot de 40 factures provenant de 20 fournisseurs différents en trois langues fonctionne comme une seule tâche. Pas de pré-tri, pas de séparation par fournisseur, pas de « ce format n'est pas pris en charge ».
Saisissez vos noms de colonnes
Saisissez les champs souhaités dans les en-têtes exacts utilisés par votre feuille de calcul ou votre ERP : Vendor, Invoice #, PO Reference, Net Amount, VAT, Due Date. Ceux-ci deviennent les en-têtes de sortie pour chaque facture du lot. Vous définissez la structure — pas l'outil.
L'IA fait correspondre chaque champ sur chaque facture
L'IA lit chaque facture indépendamment, localisant vos champs spécifiés par le sens plutôt que par la position. « Numéro de facture », « Rechnungsnummer » et « Invoice # » correspondent tous à votre colonne « Invoice # ». Le traitement s'effectue à environ 5 à 10 secondes par page.
Exportez une feuille de calcul, une ligne par facture
Téléchargez en Excel (XLSX), CSV ou JSON — un seul fichier, une seule feuille, avec vos en-têtes de colonnes en haut et une ligne par facture. Prêt à importer dans QuickBooks, NetSuite, Xero ou votre suivi Excel existant sans aucun remappage de colonnes.
Pour les équipes qui utilisent Google Sheets comme outil de suivi AP, un module complémentaire de barre latérale Google Sheets élimine même l'étape de téléchargement — les données extraites s'ajoutent directement à la feuille active, avec des en-têtes de colonnes correspondant à votre disposition existante. C'est le point d'aboutissement logique de l'extraction native pour les feuilles de calcul : la sortie arrive là où vous travaillez, dans la structure que vous utilisez déjà, sans gestion intermédiaire de fichiers.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Pour les scénarios où les factures proviennent de parties externes — clients, équipes terrain, bureaux distants — Lien de collecte fournit une page de téléversement partageable. Vous générez un lien unique, vous le partagez avec les personnes qui doivent soumettre des factures, et leurs fichiers arrivent directement dans votre file de traitement. Ils n'ont pas besoin de compte, n'ont rien à installer et ne voient pas vos autres téléversements. Le lien est protégé par un code de vérification que vous définissez, et vous pouvez l'activer ou le désactiver à tout moment.
Normalisation du format entre fournisseurs : dates, devises et formats numériques
Des colonnes cohérentes ne représentent que la moitié de l'équation. L'autre moitié, ce sont des valeurs cohérentes dans ces colonnes. Cinq fournisseurs peuvent tous fournir une date de facture — mais ils l'exprimeront comme « 06/15/2026 », « 15 June 2026 », « 15.06.2026 » et « 2026-06-15 ». Trois fournisseurs fournissent un montant total : « $1,250.00 », « 1.250,00 € » et « ¥125,000 ». Si l'outil d'extraction déverse ces chaînes brutes dans votre feuille de calcul, vous devrez encore nettoyer le formatage à chaque lot.
L'extraction sémantique gère la normalisation du format au moment de l'extraction, et non comme une étape de post-traitement. L'IA reconnaît que « 1.250,00 € » et « $1,250.00 » représentent la même intention numérique et les normalise dans votre format préféré — qu'il s'agisse de décimales à l'américaine, de dates ISO ou des conventions numériques spécifiques attendues par votre ERP. Les formats de date, les symboles de devise, les séparateurs de milliers et les conventions décimales sont standardisés automatiquement pour tous les fournisseurs.
L'identification fiscale ajoute une autre couche. Un fournisseur au Royaume-Uni l'appelle « VAT ». Un fournisseur français l'appelle « TVA ». Un fournisseur allemand l'appelle « MwSt ». Un fournisseur canadien l'appelle « GST ». Les quatre factures incluent un montant de taxe — et les quatre doivent aboutir dans votre colonne « Tax » ou « VAT ». Parce que l'IA comprend l'équivalence sémantique de ces libellés plutôt que de faire correspondre des chaînes de texte littérales, les quatre montants de taxe aboutissent dans la même colonne de sortie. Vous avez défini le nom de la colonne une seule fois. L'IA gère la correspondance des libellés pour chaque fournisseur.
Pour les équipes qui traitent des factures transfrontalières, cette normalisation peut à elle seule éliminer des heures de conversion manuelle de devises et de reformatage de dates. Ardent Partners rapporte que le taux d'exception moyen du secteur, de 22 %, tombe à 9 % pour les équipes les plus performantes — et les exceptions liées au format (écarts de devises, erreurs d'interprétation de dates, erreurs décimales) comptent parmi les catégories les plus courantes que l'automatisation élimine.
Au-delà de la cohérence au sein d'un même lot, l'extraction de factures par lots conserve la même structure de sortie entre les différents traitements — ce qui signifie que les factures traitées cette semaine et celles traitées le mois prochain alimentent toutes le même suivi avec des mises en page de colonnes identiques. Il n'y a pas de dérive d'un mois à l'autre dans les en-têtes, car les en-têtes ne proviennent pas de l'outil. Ils proviennent de vous.
Questions fréquentes
Un seul outil peut-il vraiment traiter des factures de plus de 50 fournisseurs différents sans configurer de modèles ?
Oui — c'est l'avantage structurel de l'extraction sémantique par rapport à l'OCR basée sur des modèles. Les outils à modèles exigent un mappage par fournisseur car ils identifient les champs par leur position à l'écran. L'extraction sémantique identifie les champs par leur signification, de sorte que la facture du 50e fournisseur passe par le même pipeline que la première, sans configuration supplémentaire. La contrepartie est que l'extraction IA sémantique a un coût par page (basé sur des crédits : 1 crédit = 1 page, avec des formules allant d'un niveau gratuit, puis $9/mois Basic, $19/mois Pro et $59/mois Max) plutôt que le modèle à tarif forfaitaire des outils à modèles. Pour les équipes qui traitent des factures de nombreux fournisseurs différents, la suppression du travail de maintenance des modèles compense largement le coût par page.
Que se passe-t-il si un fournisseur modifie la mise en page de ses factures après des mois de traitement ?
Rien ne change. Les outils basés sur des modèles échouent parce que le champ a été déplacé vers une position de pixel différente. L'extraction sémantique ne se réfère pas aux positions — elle lit le contenu et le contexte, donc un changement de mise en page n'a aucun effet. L'IA traite la nouvelle mise en page exactement comme elle traitait l'ancienne. C'est ce qui rend l'extraction indépendante du format structurellement plus fiable à grande échelle : le système n'accumule pas de dépendances fragiles aux mises en page des fournisseurs, qui changeront inévitablement.
Comment l'IA sait-elle quel champ est lequel quand chaque fournisseur utilise des libellés différents ?
L'IA lit le document dans son ensemble — elle comprend que « Numéro de facture », « Rechnungsnummer » et « Invoice # » remplissent tous la même fonction sur une facture. C'est une compréhension sémantique, pas une correspondance de libellés. Si un champ que vous avez demandé (par exemple, « VAT Rate ») n'apparaît pas sur une facture donnée, la cellule reste vide plutôt que d'être remplie avec une supposition. Pour les champs qui nécessitent une inférence — comme la classification d'une catégorie de dépense en fonction du fournisseur et des articles — vous pouvez utiliser les colonnes inférées, où l'IA porte un jugement basé sur le contenu du document et vos options spécifiées.
Et pour les lignes de détail — peut-il extraire l'intégralité des informations au niveau produit de chaque facture ?
Oui. Les tableaux de lignes de détail sont extraits avec la description, la quantité, le prix unitaire et le total de ligne de chaque ligne, préservés. Comme l'IA lit les structures de tableaux de manière sémantique (en reconnaissant les relations entre colonnes à partir des en-têtes et de l'alignement des données, et non des lignes de grille), elle gère toute la gamme des formats de tableaux réels : grilles avec bordures, alignement sans bordures basé sur l'espacement, continuations sur plusieurs pages et ordres de colonnes mixtes. Les colonnes calculées peuvent en outre vérifier les totaux de ligne pendant l'extraction — signalant les écarts entre les totaux de ligne déclarés et le calcul Quantité × Prix unitaire avant que les données n'atteignent votre feuille de calcul.
Puis-je traiter des PDF, des factures papier scannées et des photos prises au téléphone dans le même lot ?
Oui. Les lots de formats mixtes — combinant des PDF numériques, des factures papier scannées et des photos de factures imprimées prises au téléphone — sont pris en charge nativement. L'IA traite chaque fichier via le même pipeline de compréhension visuelle, quel que soit son format d'origine. Les documents scannés et les photos passent par la même extraction sémantique que les PDF numériques propres. Pour les entrées particulièrement difficiles comme les impressions matricielles ou les fax basse résolution, les résultats dépendent de la lisibilité — l'IA ne peut pas extraire ce qu'elle ne peut pas réellement lire — mais la grande majorité des formats de factures réels sont traités sans problème.
La sortie fonctionne-t-elle avec QuickBooks, NetSuite, Xero, ou dois-je reformater ?
Comme vous définissez les colonnes de sortie, la feuille de calcul que vous exportez est déjà au format attendu par votre système. Si votre ERP importe « Vendor » et « Amount », vous nommez ces colonnes « Vendor » et « Amount » au moment de l'extraction — il n'y a rien à reformater. La sortie est un fichier XLSX ou CSV standard compatible avec tous les principaux systèmes comptables, y compris QuickBooks, NetSuite, Xero, SAP, Microsoft Dynamics et Coupa. L'import CSV est la voie la plus universelle ; XLSX est préféré lorsque votre processus de rapprochement implique un travail supplémentaire sur la feuille de calcul avant l'import.
Que se passe-t-il pour les factures dans d'autres langues que l'anglais ?
L'IA lit les factures dans leur langue d'origine — français, allemand, espagnol, japonais, coréen, et d'autres — et extrait les données dans vos en-têtes de colonnes en anglais. « Numéro de facture » (français) et « Rechnungsnummer » (allemand) correspondent tous deux à votre colonne « Invoice Number ». La sortie est toujours dans la langue de vos en-têtes de colonnes ; la langue d'entrée n'affecte ni la structure ni le format de la sortie. La prise en charge multilingue est particulièrement précieuse pour les entreprises ayant des chaînes d'approvisionnement internationales, où un seul lot peut contenir des factures dans 3 à 4 langues.
La différence réside dans la sortie, pas dans l'extraction
Les outils d'extraction de factures convergent vers une capacité similaire : l'IA peut lire n'importe quelle mise en page, n'importe quelle langue, n'importe quel format. Cela devient un prérequis. Là où les outils divergent — et où les équipes AP dépensent du temps de travail réel — c'est dans ce qui se passe après l'extraction.
Un outil qui extrait les données dans son propre schéma de colonnes fixe oblige votre équipe à combler l'écart entre la sortie de l'outil et l'entrée de votre système à chaque fois. Un outil qui vous permet de définir les colonnes de sortie élimine entièrement cet écart. La précision d'extraction est la même dans les deux cas. Le travail après extraction ne l'est pas.
Pour les équipes AP évaluant un logiciel d'extraction, la meilleure question à poser lors d'un essai n'est pas « lit-il correctement ma facture la plus difficile ? » — la plupart des outils d'IA modernes le feront. C'est « la sortie correspond-elle à mon suivi existant sans remappage manuel ? » Testez avec un lot réel, avec vos véritables en-têtes de colonnes. Si la réponse implique de renommer des colonnes, de diviser des valeurs ou de réorganiser les en-têtes, vous évaluez un outil de lecture, pas un outil d'automatisation.
La cohérence des colonnes n'est pas un luxe. C'est la différence entre une automatisation qui remplace réellement le travail manuel et une automatisation qui déplace simplement le travail manuel vers une autre étape. Testez sur un lot de vos propres factures provenant de plusieurs fournisseurs. Vérifiez si vos cinq mêmes colonnes ressortent de la même manière à chaque fois — quel que soit l'expéditeur de la facture, sa langue ou sa mise en page.