AI手書き文字認識:
2026年完全ガイド:実際に機能する方法
2023年当時、AIが手書き文字を確実にテキストへ変換できるかと尋ねられたら、正直な答えは「ある程度:文字がきれいで、ブロック体で、スキャンが鮮明で、読み取った内容の多くを修正しても構わないなら」でした。3年後、その答えは変わりました。2024年後半から2025年半ばにかけて、AI手書き文字認識はほとんどの人が追いつけないほど向上しました。技術は今や実際に機能しますが、特定のドキュメントに適した方法を選ぶ必要があります。このガイドは、ベンダーが信じさせたい姿ではなく、2026年の実際の状況を解説します。
2023年以降、手書き文字認識で実際に変わったこと
3つの変化が起き、その速さから、人々が手書き文字認識について抱く前提のほとんどは2年前の情報のままです。
第一に、LLMのブレークスルー。 2023年後半にGPT-4Vが登場したとき、汎用AIモデルが草書体の手書き文字をある程度の信頼性で読めるようになったのは初めてのことでした。完璧ではありませんでした——幻覚率は高く、構造化データを出力できませんでした。しかし、根本的なことを証明しました:手書き文字認識は文字照合の問題である必要はないということです。言語を意味的に理解するモデルは、人間と同じように——曖昧な文字を文脈から推測して——読みにくい手書き文字を読むことができます。
2025年半ばまでに、GPT-5とGemini 3 Proはこの能力を実用レベルに引き上げました。AIMultipleの2026年1月の草書体手書き文字ベンチマーク——10人の筆記者による100の手書きサンプルを用いた管理テスト——では、GPT-5、Gemini 3 Pro Preview、olmOCR-2-7Bが草書体テキストの意味的類似性でトップとなり、AzureやGoogle Document AIなどの専用OCR APIを上回りました(AIMultiple、2026年1月)。重要な発見は、LLMが手書き文字認識で従来のOCRを上回ったことではなく——それは予想通りでした——どの程度上回ったかです。従来のOCRエンジンが混在する草書体で45〜60%の単語精度だったのに対し、VLMベースのシステムは80〜90%を達成しました。
第二に、専門の手書き文字エンジンが成熟しました。 LLMが注目を集める一方で、専用の手書き文字OCRツールは特定のユースケースで実用レベルの精度に達しました。HandwritingOCRは、独立したベンチマークで標準的な手書き英語散文に対して0.9%の単語誤り率(99.1%の精度)を達成しました(handwritingocr.com、2026年)。ABBYY FineReader 16は、ベンダー間比較で草書体91.7%、手書き活字体95.2%を記録しました。これらは2023年には存在しなかった数字です。
第三に、市場インフラが追いつきました。 世界のOCR/ICR市場は2024年に139.5億〜162.6億ドルに達し、2030〜2033年までに420億〜460億ドルに達すると予測されており、年間成長率は13〜17%です(ArticSledge、2026年)。これは単に「市場が成長している」というだけでなく——2024〜2026年の技術改善曲線が、2027〜2028年に来るものと比べて遅く見えるほど、この分野に十分な資本が流入していることを意味します。
これら3つの変化の実用的な結果:手書き文字認識はもはや「そもそも機能するのか」という問題ではありません。「どの技術トラックが、あなたの文書、精度要件、出力形式に合うのか」という問題です。
3つの技術トラック — それぞれは代替できない
2026年に市場に出ている手書き文字認識ツールは、すべて3つの技術トラックのいずれかに分類される。これらは精度だけでなく、扱える入力の種類、生成する出力の種類、構造化データを抽出できるかどうかが異なる。間違ったトラックを選ぶと、ベンダーがデモで見せた精度は、自社のドキュメントでは通用しないだろう。
トラック1: 従来型OCR(Tesseract、ABBYY、クラウドAPI)
仕組み: 文字単位のパターンマッチング。エンジンは各ピクセル領域を既知の文字形状のライブラリと比較し、最も近い一致を出力する。テキストを視覚的パターン認識の問題として扱い、「この形状は何に見えるか?」という問いに対し、言語、文脈、意味の理解はない。
得意なこと: 標準フォントの印刷テキストの、クリーンで高解像度のスキャン。300 DPIでスキャンしたレーザー印刷ドキュメントでは、従来型OCRは95〜99%の精度を達成する。Azure Document IntelligenceとAWS Textractは、クリーンな印刷フォームで約99%に達する。
限界: 手書き文字が登場した瞬間に機能しなくなる。従来型OCRは各文字が分離可能な境界ボックスを占めると想定している。筆記体はこの想定を完全に覆す — 文字は明確な境界なしに互いに流れ込む。エンジンは複数の文字を1つのブロブに統合するか(「clear」を「dear」と読む)、1つの文字を複数のボックスに分割する(「m」を「rn」と読む)。
実運用では: 最も広く導入されているオープンソースOCRエンジンであるTesseractは、一般的な筆記体で単語精度45〜50%を返す。Azure Document Intelligenceは、きれいなブロック体で約95%を達成するが、筆記体の文章コメントでは約45%に低下する。Google Document AIは手書きコメント欄で約50%に達する。これらの数値は、独立したベンチマークとRedditのr/computervisionでの実務者レポートに基づいており、ベンダーのマーケティングページからのものではない。
結論: 従来型OCRは印刷テキスト向けである。ドキュメントに手書き文字 — どんな手書き文字でも — が含まれる瞬間、別のトラックが必要になる。
トラック2: ICR / HTR(手書き文字特化型ニューラルネットワーク)
仕組み:インテリジェント文字認識(ICR)と手書き文字認識(HTR)は、手書き文字データセットで特別に訓練された畳み込みニューラルネットワーク(CNN)と再帰型ニューラルネットワーク(RNN)を使用します。OCRのパターンマッチングとは異なり、これらのネットワークは手書きの基礎的な特徴(ストロークパターン、接続点、文字のバリエーション)を学習し、書き手を超えて汎化できます。ICRは通常、手書きの活字体(個別に書かれたブロック文字)を処理し、HTRは筆記体や連結した書き方にまで対応します。一部のツールは同じエンジンで両方を組み合わせています。
得意なこと:手書き欄のある構造化フォーム、特に手書きが比較的明瞭なブロック文字の場合。ABBYY FineReaderは筆記体で91.7%、手書き活字体で95.2%の精度を達成しています。HandwritingOCRは良質な手書き英語散文で99.1%の単語精度(WER 0.9%)に達します。インスブルック大学の学術用HTRプラットフォームであるTranskribusは、数百ページにわたる一人の書き手の手書き文字でカスタムモデルを訓練でき、歴史的アーカイブや単一著者のコレクションに有用です。
限界:ICR/HTRは依然として手書きを視覚的な問題として扱います。形を読むのであって、意味を読むのではありません。文字が曖昧な場合(「o」に見える雑な「a」など)、エンジンは文脈ではなく視覚的な類似性に基づいて推測します。人間の読者は「apples cost $5」が「opples cost $5」よりも可能性が高いと判断できますが、文字の形だけで訓練されたニューラルネットワークにはそれができません。これが、筆記体や乱雑な手書きに対するICRの精度が従来のOCRよりは優れているものの、依然として大きな誤差のギャップを残す理由です。
さらに、ほとんどのICR/HTRツールは文字起こし(プレーンテキスト)を出力し、構造化抽出(テーブル内のフィールドと値のペア)は行いません。手書きフォームのテキストを読むことと、「日付」「金額」「顧客名」を別々のExcel列に抽出することは別問題であり、ほとんどのICRツールは後者を実行しません。
結論:ICR/HTRは手書きテキストの文字起こし(歴史的な手紙、日記、自由形式のメモ)に適したトラックです。手書きフォームから構造化データを抽出するには、視覚認識と意味理解を橋渡しするものが必要です。
トラック3: VLM/AIによる意味的データ抽出
仕組み: GPT-5、Gemini 3 Pro、Claude SonnetなどのVision-Language Models(VLM)は、文書を完全な画像として処理し、その内容を意味的に理解します。文字の形を照合したり、筆跡パターンを認識したりするのではなく、人間と同じように文書を「読み」ます。ページ全体を見て、各フィールドが何を意味するかを理解し、位置ではなく意味によって情報を抽出します。モデルが曖昧な手書き文字に遭遇した場合、人間の読者と同じように文脈を通じて曖昧さを解決します。
得意なこと: 1ページ上のすべてを同時に処理できます。VLMは、同じフォーム上の印刷テキスト、筆記体、ブロック体を1回のパスで読むことができます。チェックボックス(チェック、丸、×)の識別、署名や印鑑の位置特定、そして一般的な実世界の文書(空欄に手書きが入った印刷フォーム)を処理できます。AIMultiple 2026ベンチマークでは、VLMベースのシステムが、従来のOCRではまったく処理できなかった筆記体テキストに対して高い意味的類似性スコアを達成しました。
さらに重要なのは、VLMベースの抽出が構造化出力を生成できることです。「請求書番号」「日付」「合計金額」「手書きメモ」など、必要な列を定義すると、モデルは各値をページ上のどこにあっても、その意味を理解して特定します。これが最初の2つのトラックと3つ目を分ける重要な能力です。「このページを読める」から「ここにスプレッドシートがある」へと移行できる能力です。
限界: 正直な3つの制限があります。速度: VLM推論は従来のOCRよりも計算負荷が高く、処理に1ページあたり5〜10秒かかります(従来は1秒未満)。幻覚リスク: VLMは、特に極端に劣化した入力や曖昧な入力に対して、テキストをでっち上げることがあります。これは改善されています(GPT-5はGPT-4Vよりも幻覚が大幅に少ない)が、ゼロではありません。幻覚と他の7つの一般的な障害パターンを網羅した診断フレームワークについては、手書き文字抽出の障害モードガイドを参照してください。コスト: ページあたりのAPIコストは従来のOCRよりも高く、1ページあたり約$0.01〜0.05(従来は$0.001〜0.005)。これが重要かどうかは、エラー修正のコストによって異なります(以下のコストセクションを参照)。
結論: これは手書きデータ抽出を大規模に実用化するトラックです。手書きテキストの文字起こしだけでなく、手書きデータをスプレッドシートに入れることが目的なら、これが求めるアーキテクチャです。
| 項目 | Traditional OCR | ICR / HTR | VLM/AI Semantic |
|---|---|---|---|
| 印刷テキスト精度 | 95–99% | 90–95% | 95–99% |
| ブロック体手書き精度 | 70–85% | 85–95% | 85–93% |
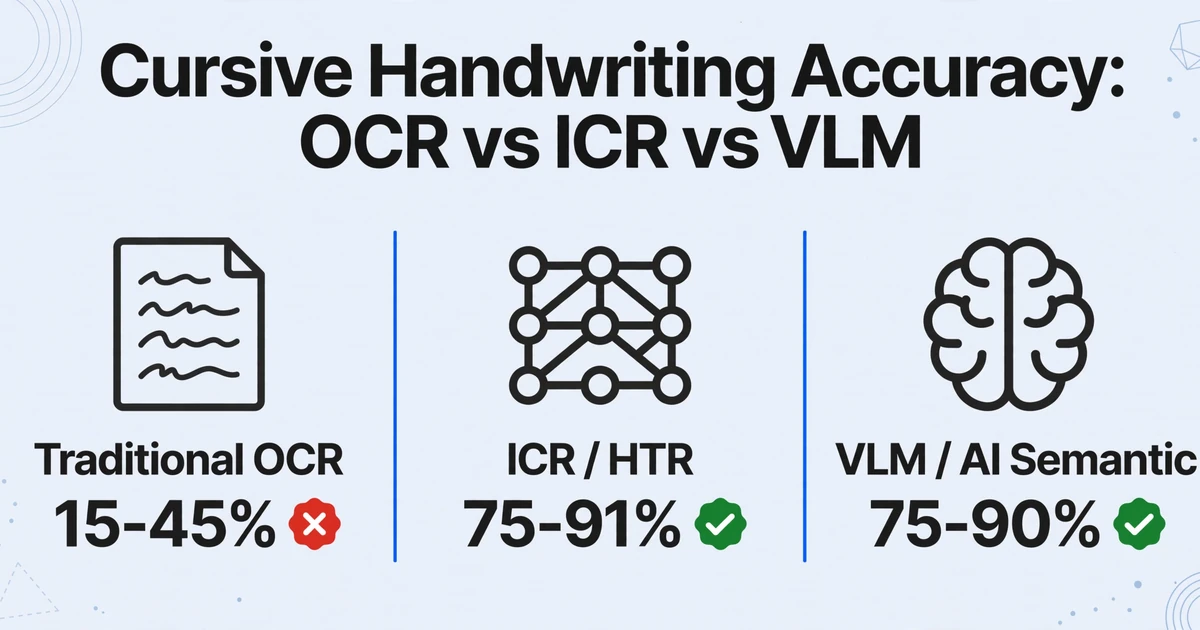
| 筆記体精度 | 15–45% | 75–91% | 75–90% |
| 印刷+手書き混在 | ❌ 破綻 | ⚡ 部分的 | ✅ 同時に読取 |
| 構造化データ出力 | ❌ テキストのみ | ❌ ほぼテキスト | ✅ Excel/JSON |
| 文脈理解 | ❌ なし | ❌ 限定的 | ✅ 意味的 |
| ページあたりコスト | $0.001–0.005 | $0.005–0.02 | $0.01–0.05 |
| トレーニング要件 | 不要 | 場合による | 不要 |
精度の実態:数値が実際に意味すること
手書き文字認識ベンダーは誰もが精度の数値を公表している。しかし、その数値が何を対象に、どのような条件下で測定され、条件が理想的でない場合に同じシステムがどのような結果を出すのかを説明するベンダーはほとんどいない。このセクションでは、シナリオ別に実際に必要な数値を示す。
2025年から2026年にかけての複数の独立したベンチマークから浮かび上がるパターンは一貫している。印刷テキストでは、3つのトラックはほぼ同じ範囲に収まり、差はわずか数ポイントだ。しかし手書きになると、その差は大きく開く。
| ドキュメントのシナリオ | Traditional OCR | ICR/HTR | VLM/AI | 実環境での差 |
|---|---|---|---|---|
| 鮮明な印刷フォーム(300 DPIスキャン) | 92–98% | 90–95% | 95–99% | 小 |
| 枠内の整ったブロック体の手書き | 70–85% | 85–95% | 85–93% | 中 |
| フォーム上の筆記体と印刷ラベルの混在 | 45–60% | 65–85% | 80–90% | 大 |
| 完全な筆記体の文章 | 15–30% | 75–91% | 75–88% | OCRとの差は極大 |
| 手書き文書のスマホ撮影(照明不良) | <20% | 40–60% | 65–80% | 極大 |
| 歴史的資料(インクの褪色、黄変紙) | <15% | 50–70% | 60–80% | 極大 |
出典:AIMultiple 2026 Handwriting Recognition Benchmark、Suparse 2026 Best Handwriting OCR Tools Comparison、handwritingocr.comベンチマーク、Reddit r/computervisionの実運用レポート。すべての数値は独立した測定結果であり、ベンダーの主張ではない。
この表から2つのことが明確になる。第一に、精度低下のパターンは非対称である。Traditional OCRは手書きが現れた時点で急激に性能が落ち、印刷テキストでの90%台前半から筆記体では3分の1以下にまで低下する。これは緩やかな低下ではなく、システムの機能不全だ。VLMも低下するが、より緩やかで、印刷テキストから現場での写真撮影まで実用可能な範囲を維持する。
第二に、「手書き文字認識精度」を単一の数値で表すことは無意味である。制約のあるフォーム欄の整ったブロック体で95%を達成するツールでも、同じフォームの筆記体のコメント欄では45%しか達成できないかもしれない。文書に両方が含まれる場合(実際の文書のほとんどがそうである)、総合的な精度はベンダーの宣伝文句ではなく、文書の構成によって決まる。
ツールを評価する唯一の信頼できる方法は、ベンダーが提供するきれいなサンプルではなく、実際の文書でテストすることだ。自社のファイルでのテストを許可しないベンダーは、疑ってかかるべきである。
文字起こしとデータ抽出:ほとんどのガイドが見落としている違い
文字起こしとデータ抽出は同じ作業として扱われることがあります。しかし実際は異なり、その違いによって、プロジェクトの成果がスプレッドシートになるか、テキストの羅列になるかが決まります。
文字起こしは、手書きをデジタルテキストに変換するステップです。出力は段落やテキストのブロックです。「患者は3日間の腹痛を訴え、吐き気は否定している」— これが文字起こしです。検索、アーカイブ、閲覧には有用ですが、分析、会計、またはデータを列に入れる必要があるワークフローには役立ちません。
データ抽出は、手書き文書から特定のデータポイントを構造化されたフィールドに取り出すことを意味します。出力はテーブルの行です。日付 = 2026-06-15、金額 = $342.50、顧客 = Acme Corp、備考 = 「至急注文 — 金曜日までに納品」。これがデータ抽出です。スプレッドシート、ERP、会計システムが実際に必要とするのはこちらです。
ほとんどの手書き文字認識ツール — ほぼすべての従来型OCRおよびICRソリューションを含む — は文字起こししかできません。テキストの羅列は得られますが、どの数字が請求書の合計で、どれが税額かを教えてはくれません。文書を読み取り、その内容を構造化するという分離ステップは、従来は人手がワークフローに入る箇所であり、多くの自動化プロジェクトが頓挫するポイントでもあります。
データ抽出ができるツール、特にVLMベースのシステムは、文書を意味的に読み取ることでこのギャップを埋めます。必要な列を定義すると、AIはページ上の各値を、事前定義されたゾーンでテキストをスキャンするのではなく、その意味を理解することで特定します。手書きの請求書から「合計金額 = $342.50」を抽出できるツールは、その数字がページのどこにあるかを知る必要はありません。「合計金額」がラベルであり、「$342.50」がそれに関連付けられた値であることを理解すればよいのです。たとえ改行、手書きの矢印、またはまったく異なる筆跡で区切られていてもです。
これが人々がカスタム列抽出と呼ぶものです。フィールド名を「請求書番号」「日付」「合計」などの平易な言葉で一度定義すれば、その同じ列リストが、フォームがどれほど異なって見えても、アップロードするすべての文書に適用されます。サプライヤーごとにテンプレートを構築する必要も、フォームが変わったときに再トレーニングする必要もありません。セットアップの何もページ上の位置に依存していないからです。
ワークフローがデータをスプレッドシートに入れることで終わるなら、必要なのは文字起こしではなくデータ抽出です。評価中のツールが、前者だけでなく後者もできることを確認してください。
実際のコスト計算:ページ単価が誤った指標である理由
手書き文字認識ツールの価格に関する議論は、常にページ単価から始まります。従来のOCR:1ページあたり0.001〜0.005ドル。VLMベース:1ページあたり0.01〜0.05ドル。単純計算では、OCRの方が5〜10倍安い。これで決着、と思われがちです。
しかし、実際はそうではありません。重要なコストはページあたりの抽出価格ではなく、正しい結果を生み出すコストです。そしてそれには、エラーを修正するために費やす時間と労力が含まれます。
実際の計算式は次のとおりです:
真のコスト =(ページあたりの抽出価格 × ページ数)+(エラーあたりの修正時間 × エラー数 × 人件費率)
エラー率が低い場合(印刷テキスト、従来のOCR)、修正項は小さくなります。エラー率が高い場合(筆記体の手書き文字、従来のOCR)、修正項が方程式全体を支配します。
具体的に見てみましょう。ある建設会社は、週に100件の手書きの日報を処理しています。各報告書には、日付、労働時間、使用材料、機器稼働時間、現場監督のメモなど、約25のデータ項目が含まれています。つまり、週に2,500項目、年間130,000項目になります。
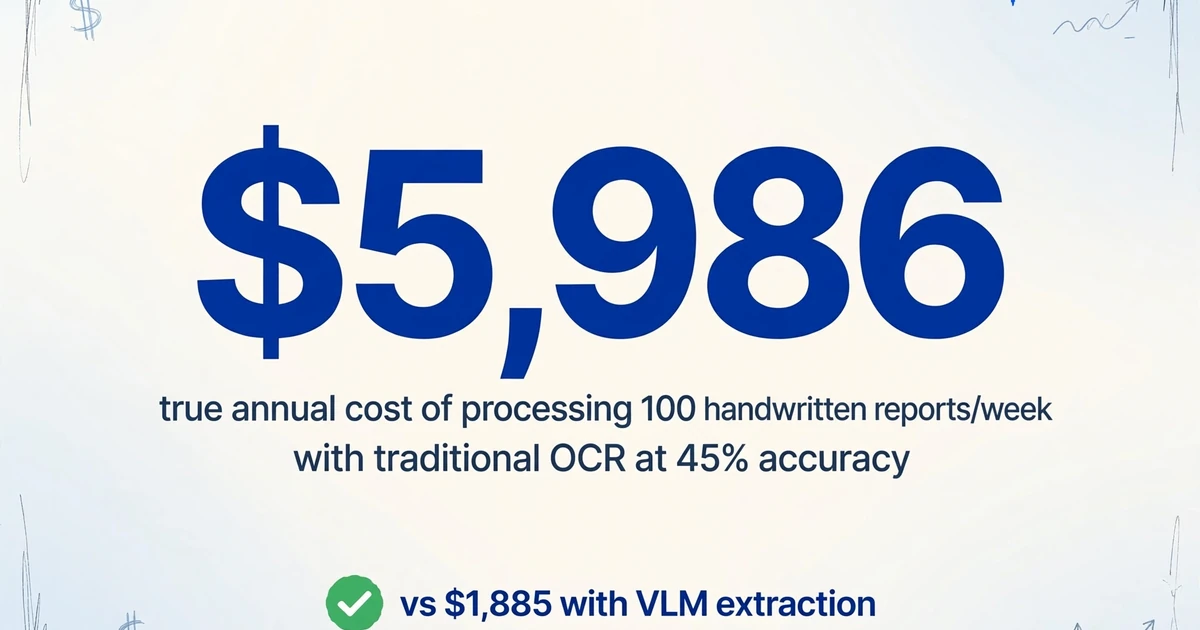
従来のOCRの場合(筆記体メモの精度45%):年間71,500項目の手動修正が必要です。1件あたり15秒の修正時間として、年間298時間の手作業が必要となり、時給20ドルで年間約5,960ドルになります。ページあたりのOCRコストは無視できるほど小さく(年間約26ドル)、年間の真のコストは約5,986ドルです。
VLMベースの抽出の場合(筆記体の精度85%):年間19,500項目の手動修正が必要です。1件あたり15秒の修正時間として、81時間(年間約1,625ドル)になります。ページあたりのVLMコストは高くなりますが(年間約260ドル)、年間の真のコストは約1,885ドルです。
VLMアプローチはページあたり3倍のコストがかかりますが、修正作業を含めた総コストは3分の1以下です。この計算は、手書き文字がコンテンツのかなりの割合を占めるあらゆる文書タイプに当てはまります。本番環境で150,000ページ以上を処理したRedditユーザーは、このパターンを確認しています:「従来のOCRプラットフォームは費用対効果が高いように見えますが(1ページあたり約0.001〜0.005ドル)、手書き文字の精度が低い(約45〜50%)ため、手書きコンテンツが多いビジネスワークフローでは実用に耐えません。エラーを手動で修正する時間を考慮すると、真のコストは専用ソリューションよりもはるかに高くなります」(r/computervision、2025年)。
ページ単価の比較は罠です。重要なのは、正しい結果あたりのコストだけです。手書き文字がコンテンツのかなりの割合を占める場合、従来のOCRが必要とする人的修正作業を含めると、VLMベースの抽出の方が総コストが安くなる傾向があり、多くの場合、その差は劇的です。
アプリケーション別:どのトラックがあなたのドキュメントに最適か
どの技術トラックが一方的に優れているわけではありません。最適なものはドキュメント次第です。実際の導入事例とベンチマークデータに基づく、それぞれの適合状況は以下の通りです:
医療記録と臨床メモ
医療現場の手書き文字は有名なほど読みにくく、臨床文書のかなりの部分が今も紙またはスキャンされたファイルで始まります。その重要性は高く、薬剤名や投与量の読み間違いは患者の安全に関わる重大事故であり、HIPAA準拠には監査可能な正確性が求められます。手書きの臨床記録のデジタル化に関する2025年の研究では、「汎用OCRシステムは信頼性の高い臨床データ抽出には現時点では不十分」であり、その理由は「手書き医療記録の複雑さとばらつき」にあると指摘されています(SciTePress、2025年)。
推奨トラック: VLMベースのセマンティック抽出と、重要なフィールド(薬剤名、投与量、診断名)に対するヒューマン・イン・ザ・ループのレビューステップを組み合わせます。Omega Healthcareでは、AI支援の文書処理により文書化時間が40%削減され、毎月15,000時間以上の従業員時間を節約し、プロセス精度は99.5%を達成しました(Business Insider、2025年)。これを実現するアーキテクチャは、信頼度しきい値を用いたAI抽出です。しきい値以上のフィールドはそのまま通過し、しきい値未満のフィールドは人間のレビュー用にフラグが立てられます。
注意点: HIPAA準拠。クラウドベースのVLMを使用する場合は、ベンダーのBAA(ビジネスアソシエイト契約)とデータ取り扱い慣行を確認してください。特定の機関ではオンプレミス展開が必要になる場合があります。
建設現場の日報と現場ログ
建設現場の監督は日報を手書きで記入します。多くの場合、現場で、悪天候の中、インクが切れかけのペンで。これらの報告書には、安全上の観察事項、労働時間、機器の使用状況、材料の納品、インシデントメモが含まれます。これらは法的に重要であり(米国のDavis-Bacon認定給与要件は特定の記録保持を義務付けています)、業務上も重要です(請求の遅延はキャッシュフローの遅延を意味します)。
推奨トラック: バッチ処理を備えたVLMベースの抽出。典型的な建設会社は毎週20〜100件の日報を処理し、それぞれ異なる監督の異なる手書き文字で書かれています。バッチ処理機能(すべての報告書を一度にアップロードし、単一の統合スプレッドシートを取得する機能)は、実際に使用するツールとトレーニングビデオの中に眠るツールを分ける運用上の違いです。
注意点: 混合コンテンツ。建設フォームはほぼ常に印刷されたラベル(「日付」「ジョブ番号」「監督者」)と手書きの記入事項が混在しています。従来のOCRはこの混在に弱いです。選択したアプローチが両方を1回のパスで処理できることを確認してください。
歴史文書とアーカイブ
図書館、政府機関、系譜学団体は、何世紀にもわたる手書き記録(出生証明書、結婚登録簿、国勢調査票、軍歴記録)のデジタル化を進めています。ノースカロライナ大学ウィルソン図書館は、クラウドソーシングによる人間の検証を組み合わせたAI支援HTRを使用して、ジム・クロウ時代の手書き法的文書を文字起こししています。政府のアーカイブも同じ道をたどり、100年以上前の市民登録簿をスキャンしてHTRを実行し、モデルが自信を持って読み取れない項目は人間のレビュアーが解決しています。
推奨トラック: カスタムモデルトレーニング+人間によるレビューを伴うHTR。1人の筆跡が何百ページにもわたる場合(特定の教区司祭の登録簿、特定の書記の台帳)、カスタムトレーニングされたHTRモデル(Transkribusなど)は、汎用モデルが到達できない精度を達成できます。多くの異なる筆記者がいるコレクションの場合、VLMベースの抽出はトレーニングなしで強力なベースラインを提供しますが、人間によるレビューは依然として不可欠です。UVA図書館の2026年の一次資料文書に対するAI文字起こしの評価では、「これらは最も扱いにくい一次資料の一部でした。手書きの手紙、複雑な台帳、交差線のある文書」であり、AIの精度は文書の種類と状態によって劇的に異なると結論付けられました。
注意点: 画像品質。かすんだインク、黄変した紙、裏面からの透け、非標準の書体(フラクトゥール、ジュッターリン、セクレタリーハンド)はすべて精度に劇的な影響を与えます。前処理(傾き補正、コントラスト強調、背景クリーニング)は、認識エンジン自体と同じくらい重要であることがよくあります。
金融・会計:手書きの台帳と領収書
中小企業、レストラン、現場サービス業務では、今でも手書きの領収書、配達確認書、手書きの台帳記入が生成されています。レストランは、余白に手書きの数量と価格が記された仕入先請求書を受け取ります。配達ドライバーは手書きの配達証明書を受け取ります。整備士は紙の作業指示書に修理内容を記入します。このデータの手動入力には、人件費、エラー修正、管理オーバーヘッドを考慮すると、1文書あたり推定15〜40ドルのコストがかかります(Constrafor、2025年)。
推奨トラック: VLMベースの構造化抽出。出力は会計ソフトウェア(QuickBooks、Xero、Sage)に入力する必要があるため、抽出は単なる文字起こしテキストではなく構造化データを生成する必要があります。出力列を一度定義し、同じスキーマに対して複数の手書き文書を処理できる機能こそが、手書き抽出を好奇心から運用コスト削減へと変えるものです。
注意点: 計算値。手書きの領収書に「数量:3、単価:$12.50、合計:$37.50」と表示されている場合があります。AIが3つすべてを抽出できれば良いのですが、手書きの合計に算術エラーが含まれている場合、検証なしの抽出はその間違いを増幅させます。最良の抽出パイプラインでは、AIが抽出中に計算する計算列(例:「行合計=数量×単価」)を定義でき、手書きの合計に対するクロスチェックを提供します。
物流・現場サービス
配達ドライバーは、署名・タイムスタンプ・例外メモ(「裏口に置きました」など)を記入した手書きの配達伝票を作成します。現場技術者は、チェックボックスと記述コメントを含む手書きの点検報告書を作成します。保険調査員は、事故現場で手書きの損害査定書を作成します。これらの文書は現場で生成され、多くはカーボンコピー式の帳票であり、バックオフィスシステムに迅速に取り込む必要があります。
推奨トラック: モバイルアップロードによるVLMベースのデータ抽出。スマートフォンで手書きフォームを撮影するだけで—スキャンも傾き補正も不要で—構造化データが得られることは、現場チームにとって業務上の画期的な進歩です。独立したベンチマークによると、VLMベースのシステムは手書き文書のスマホ写真に対して65〜80%の精度を達成しており(従来のOCRは20%未満)、モバイルファーストのワークフローが初めて実用的になっています。
注意点: チェックボックスと署名の検出。現場フォームは、手書きテキストにチェック済みボックス、丸印の選択肢、署名が組み合わさっていることがよくあります。抽出システムがどのボックスにチェックが入ったか、署名欄が存在するかを識別できない場合、部分的な手動レビューが依然として必要です。
手書き抽出ツールの評価方法:6つの観点
文書抽出ツールの評価フレームワークのほとんどは、印刷テキスト向けに作られています。手書きは評価基準を変えます。実際に重要な点は以下の通りです。
読者の文書での精度(ベンダーのサンプルではなく)
どのベンダーもきれいなサンプルを選り好みできます。実際の文書でテストするよう要求しましょう。乱雑なもの、筆記体のもの、暗い場所でスマホで撮影したものなどです。ベンダーが自社ファイルでのテストを許可しないなら、その場を離れましょう。
文字起こしだけでなく、構造化された出力
そのツールは、定義した列を持つスプレッドシートを生成しますか、それとも後で解析する必要のあるテキストブロックを生成しますか?前者はデータ入力を置き換えますが、後者は文字起こしを置き換えるだけで、データ入力はそのまま残ります。
混在コンテンツの処理
実際の文書のほとんどは、印刷されたラベルと手書きの記入が混在しています。ツールは1回の処理で両方を読み取れますか、それとも印刷テキストと手書きで別々の処理ステップが必要ですか?後者はプロセスの複雑さを増し、導入を妨げます。
バッチ処理機能
手書き文書を1つ処理するのはデモです。50件を一度に処理して、1つの統合スプレッドシートを得るのはワークフローです。バッチ機能(複数ファイルのアップロード、同じ列定義での処理、1つの出力テーブルの取得)が、評価と導入を分けるものです。
トレーニングやセットアップが不要
ツールが機能する前に手書きサンプルの収集、フィールドの注釈付け、モデルのトレーニングを要求する場合、その所要時間と、文書ソースの変更に伴って持続可能かどうかを尋ねてください。一部のツール(Nanonets、一部のICRエンジン)は、文書タイプごとに10件以上の注釈付きサンプルを必要とします。初回使用で機能するテンプレート不要のツールは、このステップを完全にスキップします。
ページ単価ではなく、総コスト
完全な計算式を立てましょう:抽出コスト+実際のエラー率での修正作業。30%の手動修正が必要な$0.001/ページのツールは、5%の修正で済む$0.03/ページのツールよりもコストがかかります。価格を比較する前に、自社のボリュームで計算してください。
FAQ: 手書き文字認識に関するよくある質問
AIは同じページの筆記体とブロック体の両方を処理できますか?
はい、処理できます。これはまさにVLMベースのシステムが従来のOCRやICRより優れている点です。印刷されたセクション見出し、筆記体の本文、ブロック体の欄外メモが混在するページでも、VLMは意味を理解しながら読むため、1回の処理で全体を読み取れます。従来のOCRやICRは、印刷文字と筆記体を別々の認識タスクとして扱い、異なるエンジンが必要です。この機能の詳細については、AI手書き文字認識と従来のOCRの直接比較をご覧ください。
筆記体で現実的に期待できる精度はどのくらいですか?
300 DPIでスキャンされた鮮明で読みやすい筆記体の場合:専用のICR/HTRツールで85〜91%、VLMベースの抽出で75〜90%。乱雑で急いで書かれた筆記体の場合:最良のツールでも65〜80%が期待値です。低品質のスマートフォン写真に写った筆記体の場合:60〜75%。実環境で筆記体に対して99%の精度を達成できるツールはありません——それを主張する人は、選りすぐりのサンプルで測定しているにすぎません。実用的なアプローチは、構造化フィールド(AIが最も得意とする領域)に抽出を使用し、精度が重要な叙述テキスト部分は人間によるレビューを残すことです。
かすれたインクの歴史的文書でも手書き文字認識は機能しますか?
はい、機能しますが、認識エンジンよりも処理フローの方が重要です。歴史的文書での成功は以下に依存します:(1) 高解像度スキャン(300ではなく600 DPI推奨)、(2) 前処理——コントラスト強調、傾き補正、背景ノイズ除去、(3) 認識エンジンの選択——コレクション内で筆跡が一貫している場合は類似スクリプトでカスタム学習したHTR、多数の異なる筆記者がいる場合はVLMベースの抽出。政府機関や学術機関のデジタル化プロジェクトでは、歴史的文書には人間参加型のレビューが不可欠であると一貫して報告されています——AIが作業の大部分を処理し、人間が重要なフィールドを検証します。UVA Libraryの2026年の評価では「AIの精度は文書の種類と状態によって大きく異なる」とされ、歴史的文書が最も困難なカテゴリであることが確認されています。
自分の筆跡でAIを学習させる必要がありますか?
VLMベースの抽出の場合:いいえ。これらのシステムは、あらゆる筆跡スタイルで初回使用から機能するように設計されています——学習サンプルとの照合ではなく、意味的に読み取ります。ICR/HTRツールの場合:場合によっては必要です。Transkribusなどのツールはカスタムモデルの学習をサポートしており、同じ筆記者のページが数百枚ある場合は精度を高められます。従来のOCRの場合:いいえ。学習しても効果がないためです——これらのエンジンはそもそも手書き文字を処理できません。トレードオフとして、カスタム学習したHTRモデルは特定の筆記者に対して高い精度を達成できますが、事前の学習作業が必要です。一方、VLMベースのシステムはどの筆記者でも即座に機能しますが、筆記体では約90%が上限です。1つの一貫した筆跡スタイルを大量に処理するのか、それとも多様なスタイルを処理するのかに基づいて選択してください。
AIは手書きフォームからExcelへデータ抽出できるのか、それとも単に手書きをテキストに変換するだけか?
これは完全にツール次第です。ほとんどの手書きOCRツールはテキストを生成するだけです。手書きフォームを文字起こししても、「日付:6月15日」を日付列に、「金額:$342」を金額列に分離することはありません。VLMベースの抽出ツール(ImageToTable.aiなど)は、構造化されたスプレッドシート出力を生成するように特別に設計されています。「日付」「金額」「顧客名」「メモ」など、必要な列を定義すると、AIが各ドキュメントから対応する値をそれらの列に抽出し、各行が1つのドキュメント、各列が1つのフィールドであるテーブルを生成します。これは文字起こしではなくデータ抽出であり、会計、物流、運用ワークフローで手書きデータ自動化を実用的にする機能です。実践的なガイドについては、手書きデータをExcelに直接抽出する方法をご覧ください。
無料のOCR(Tesseract、Google Keep)は手書き文字に十分対応できるか?
迅速で重要度の低い用途(買い物リストや短いメモの取り込み)では、無料ツールは明瞭なブロック体で十分に機能します。筆記体、乱雑な書き文字、または精度が重要な業務アプリケーションでは、答えはノーです。Tesseractは筆記体で約45%の単語精度を達成します。Google Keepは、筆記体よりも明瞭な活字体の手書き文字をはるかによく処理します。無料ツールと有料ソリューションのギャップは、手書き文字認識において他のどのOCRカテゴリよりも大きいです。なぜなら、手書き文字専用のAIモデルには、無料ツールが経済的に提供できない相当なトレーニングデータと計算能力が必要だからです。ユースケースが「手書きメモの中から単語を見つけたい」というものであれば、無料ツールで十分かもしれません。「100枚の手書きフォームから50フィールドを5%未満のエラー率でスプレッドシートに抽出したい」という場合は、有料ソリューションが必要です。
次の展望:2027〜2028年の地平線
2023〜2026年の手書き文字認識の変革は、LLMが意味的に読解することを学んだことで実現しました。次のシフト(研究ではすでに見られるが、本番ツールにはまだ登場していない)は、3つの発展によって推進されるでしょう。
抽出・検証・推論を1回で行うマルチモーダルモデル。現在のツールは抽出(「このページには何が書いてあるか?」)と検証(「これは理にかなっているか?」)を分離しています。新興モデルは両方を同時に実行します。請求書の明細項目を抽出しながら、明細合計がヘッダー合計と一致するかを確認し、別途検証ステップなしで不一致をフラグします。これにより、日常的なドキュメントでは抽出とレビューのパイプラインが1ステップに集約されます。
規制産業向けの説明可能な手書き文字認識。医療、法務、政府のユーザーは、AIが特定のフィールドを「$500」と読み取った理由(特に手書きが曖昧な場合に「$600」ではなく)を知る必要があります。ドキュメント処理向けの説明可能なAIの研究は進んでおり、文書レベルではなく文字レベルの信頼度スコアリングが本番利用に近づいています。これにより、現在100%人間によるレビューを必要とするコンプライアンスワークフローで、AI抽出が監査可能になります。
現場利用向けのオンデバイス処理。クラウドアップロードなし、接続要件なし、即時結果で、スマートフォン上で手書き文字認識をローカル実行することは、より小型の量子化モデルで技術的に実現可能です。精度と速度/レイテンシのトレードオフは縮小しています。現場サービス、建設、物流チームが現場を離れる前に抽出結果を必要とする場合、オンデバイス処理はクラウド依存ツールではサポートできないワークフローを解放します。
方向性は明確です。手書き文字認識は、一般的なドキュメントタイプからの構造化抽出では解決済みの問題になりつつあり、最も困難なカテゴリ(歴史的ドキュメント、大幅に劣化した入力)では「レビュー付きで十分」の領域に近づいています。技術投資サイクルはまだ初期の加速段階にあります。2028年に利用可能なツールは、今日の最高のツールを、現在のTesseractが私たちに見えるように見せるでしょう。
2026年に手書きデータ抽出を評価する人への結論:
従来のOCRでの過去の失敗体験が、現在の可能性への期待を歪めないようにしましょう。3つの技術トラック — Traditional OCR、ICR/HTR、VLMベースの意味的抽出 — は、根本的に異なるアプローチであり、精度の上限、出力形式、コスト構造がそれぞれ異なります。適切なトラックは、あなたの文書によって決まります。間違ったトラック — 手書きを含む文書ではほぼ常にTraditional OCRが該当します — は、適切なトラックよりも、お金と時間の両方でコストがかかります。実際の文書でテストし、修正作業を含む全コストを計算し、選択するツールが文字起こしテキストだけでなく構造化出力を生成することを確認してください。
手書き文書をアップロード — 必要な列を入力 — 数秒で構造化スプレッドシートを取得。トレーニングもテンプレートも不要です。