KI-Handschrift-zu-Text:
Der vollständige 2026-Leitfaden zu dem, was funktioniert
Im Jahr 2023 wäre die ehrliche Antwort auf die Frage, ob KI zuverlässig Handschrift in Text umwandeln kann, gewesen: „So ungefähr: wenn die Schrift sauber ist, wenn es Druckschrift ist, wenn der Scan klar ist, und wenn es Ihnen nichts ausmacht, vieles von dem zu korrigieren, was sie zurückliest." Drei Jahre später hat sich diese Antwort geändert. Die KI-Handschriftenerkennung hat sich zwischen Ende 2024 und Mitte 2025 so stark verbessert, dass die meisten Menschen nicht Schritt gehalten haben: Die Technologie funktioniert jetzt tatsächlich, aber nur, wenn Sie den richtigen Ansatz für Ihre spezifischen Dokumente wählen. Dieser Leitfaden zeigt die Landschaft, wie sie 2026 tatsächlich ist, nicht wie Anbieter sie Ihnen glauben machen wollen.
Was sich seit 2023 bei der Handschriftenerkennung tatsächlich geändert hat
Drei Dinge sind passiert, und zwar so schnell, dass die meisten Annahmen, die Menschen über Handschriftenerkennung mit sich herumtragen, zwei Jahre veraltet sind.
Erstens: der LLM-Durchbruch. Als GPT-4V Ende 2023 auf den Markt kam, war es das erste Mal, dass ein allgemeines KI-Modell kursives Schreiben mit einiger Zuverlässigkeit lesen konnte. Es war nicht großartig – die Halluzinationsraten waren hoch, und es konnte keine strukturierten Daten ausgeben. Aber es bewies etwas Grundlegendes: Handschriftenerkennung muss kein Problem der Zeichenzuordnung sein. Ein Modell, das Sprache semantisch versteht, kann unleserliche Handschrift so lesen wie ein Mensch – indem es mehrdeutige Zeichen aus dem Kontext ableitet.
Bis Mitte 2025 hatten GPT-5 und Gemini 3 Pro diese Fähigkeit in den Produktionsbereich gebracht. Der cursive-Handschrift-Benchmark von AIMultiple vom Januar 2026 – ein kontrollierter Test mit 100 Handschriftproben von 10 Schreibern – platzierte GPT-5, Gemini 3 Pro Preview und olmOCR-2-7B bei der semantischen Ähnlichkeit bei kursivem Text an der Spitze und übertraf damit spezialisierte OCR-APIs wie Azure und Google Document AI (AIMultiple, Januar 2026). Die wichtigste Erkenntnis war nicht, dass LLMs traditionelle OCR bei Handschrift schlagen – das war erwartet worden. Es war wie deutlich sie sie schlugen. Während traditionelle OCR-Engines bei gemischter Kursivschrift eine Wortgenauigkeit von 45–60 % erzielten, erreichten VLM-basierte Systeme 80–90 %.
Zweitens: Spezialisierte Handschrift-Engines sind ausgereift. Während LLMs Schlagzeilen machten, erreichten dedizierte Handschrift-OCR-Tools bei bestimmten Anwendungsfällen Produktionsgenauigkeit. HandwritingOCR erreichte in unabhängigen Benchmarks eine Wortfehlerrate von 0,9 % (99,1 % Genauigkeit) bei standardmäßiger englischer Handschriftprosa (handwritingocr.com, 2026). ABBYY FineReader 16 erreichte in einem herstellerübergreifenden Vergleich 91,7 % bei Kursivschrift und 95,2 % bei handgeschriebener Druckschrift. Das sind nicht die Art von Zahlen, die es 2023 gab.
Drittens: Die Marktinfrastruktur hat aufgeholt. Der globale OCR/ICR-Markt erreichte 2024 ein Volumen von 13,95–16,26 Milliarden US-Dollar und soll bis 2030–2033 auf 42–46 Milliarden US-Dollar wachsen, bei einer CAGR von 13–17 % (ArticSledge, 2026). Das ist nicht nur „der Markt wächst“ – es bedeutet, dass genug Kapital in den Bereich fließt, sodass die technologische Verbesserungskurve von 2024–2026 im Vergleich zu dem, was 2027–2028 kommt, langsam wirken wird.
Die praktische Konsequenz dieser drei Veränderungen: Handschriftenerkennung ist keine Frage von „funktioniert es überhaupt“ mehr. Es ist eine Frage von „welcher Technologiepfad passt zu Ihren Dokumenten, Ihren Genauigkeitsanforderungen und Ihrem Ausgabeformat“.
Die drei Technologiepfade – und warum sie nicht austauschbar sind
Jedes Handschriftenerkennungs-Tool auf dem Markt im Jahr 2026 fällt in einen von drei Technologiepfaden. Sie unterscheiden sich nicht nur in der Genauigkeit, sondern auch darin, welche Art von Eingaben sie verarbeiten können, welche Art von Ausgaben sie erzeugen und ob sie überhaupt strukturierte Daten extrahieren können. Wählen Sie den falschen Pfad und die Genauigkeit, die ein Anbieter Ihnen in einer Demo gezeigt hat, wird den Kontakt mit Ihren eigenen Dokumenten nicht überstehen.
Pfad 1: Traditionelle OCR (Tesseract, ABBYY, Cloud-APIs)
So funktioniert es: Zeichen-für-Zeichen-Musterabgleich. Die Engine vergleicht jede Pixelregion mit einer Bibliothek bekannter Zeichenformen und gibt die nächstliegende Übereinstimmung aus. Sie behandelt Text als visuelles Mustererkennungsproblem – „Wie sieht diese Form aus?“ – ohne Verständnis für Sprache, Kontext oder Bedeutung.
Wofür es gut ist: Saubere, hochauflösende Scans von gedrucktem Text in Standard-Schriftarten. Bei 300-DPI-Scans von lasergedruckten Dokumenten erreicht traditionelle OCR eine Genauigkeit von 95–99 %. Azure Document Intelligence und AWS Textract erreichen beide ~99 % bei sauberen gedruckten Formularen.
Wo es scheitert: Sobald Handschrift ins Spiel kommt. Traditionelle OCR setzt voraus, dass jedes Zeichen eine trennbare Begrenzungsbox einnimmt. Kursivschrift verletzt diese Annahme vollständig – Buchstaben fließen ineinander ohne klare Grenze. Die Engine führt entweder mehrere Buchstaben zu einem Klumpen zusammen (liest „clear“ als „dear“) oder teilt einen einzelnen Buchstaben über Boxen auf (liest „m“ als „rn“).
In der Praxis: Tesseract, die am weitesten verbreitete Open-Source-OCR-Engine, erreicht 45–50 % Wortgenauigkeit bei allgemeiner Kursivschrift. Azure Document Intelligence erreicht ~95 % bei sauberer Druckschrift, fällt aber auf ~45 % bei kursiven Freitextkommentaren. Google Document AI erreicht ~50 % bei handschriftlichen Kommentarabschnitten. Diese Zahlen stammen aus unabhängigen Benchmarks und Praktikerberichten auf Reddits r/computervision, nicht von Marketingseiten der Anbieter.
Fazit: Traditionelle OCR ist für gedruckten Text. Sobald Ihre Dokumente Handschrift enthalten – irgendeine Handschrift – benötigen Sie einen anderen Pfad.
Track 2: ICR / HTR (Handschriftenspezifische neuronale Netze)
So funktioniert es: Intelligent Character Recognition (ICR) und Handwritten Text Recognition (HTR) verwenden Convolutional Neural Networks (CNNs) und Recurrent Neural Networks (RNNs), die speziell mit handschriftlichen Textdatensätzen trainiert wurden. Im Gegensatz zum Musterabgleich von OCR lernen diese Netze die zugrunde liegenden Merkmale der Handschrift — Strichmuster, Verbindungspunkte, Buchstabenvarianten — und können sich über verschiedene Schreiber hinweg verallgemeinern. ICR verarbeitet typischerweise handgedruckte Zeichen (einzeln geschriebene Blockschrift), während HTR sich auf Schreibschrift und verbundene Schrift erstreckt. Einige Tools kombinieren beides in derselben Engine.
Wofür es geeignet ist: Strukturierte Formulare mit handschriftlichen Feldern, insbesondere wenn die Handschrift einigermaßen klare Blockschrift ist. ABBYY FineReader erreicht 91,7 % bei Schreibschrift und 95,2 % bei handschriftlicher Blockschrift. HandwritingOCR erreicht 99,1 % Wortgenauigkeit (0,9 % WER) bei gut lesbarer handschriftlicher englischer Prosa. Transkribus, die akademische HTR-Plattform der Universität Innsbruck, ermöglicht das Training benutzerdefinierter Modelle auf der Handschrift eines einzelnen Schreibers über Hunderte von Seiten — nützlich für historische Archive und Sammlungen einzelner Autoren.
Wo es scheitert: ICR/HTR behandelt Handschrift weiterhin als visuelles Problem. Es liest Formen, nicht Bedeutung. Wenn ein Zeichen mehrdeutig ist — ein schlampiges „a", das wie ein „o" aussieht — rät die Engine basierend auf visueller Ähnlichkeit, nicht auf Kontext. Ein menschlicher Leser weiß, dass „apples cost $5" wahrscheinlicher ist als „opples cost $5"; ein neuronales Netz, das nur auf Zeichenformen trainiert wurde, weiß das nicht. Deshalb bleibt die ICR-Genauigkeit bei Schreibschrift und unordentlicher Schrift, obwohl sie besser als herkömmliche OCR ist, immer noch mit einer erheblichen Fehlerlücke behaftet.
Darüber hinaus geben die meisten ICR/HTR-Tools Transkription (Klartext) aus, nicht strukturierte Extraktion (Feld-Wert-Paare in einer Tabelle). Den Text eines handschriftlichen Formulars zu lesen ist eine Sache; „Datum", „Betrag" und „Kundenname" in separate Excel-Spalten zu ziehen, ist eine andere — und die meisten ICR-Tools erledigen das Zweite nicht.
Fazit: ICR/HTR ist der richtige Track für die Transkription handschriftlicher Texte — historische Briefe, Tagebucheinträge, Freiform-Notizen. Für die Extraktion strukturierter Daten aus handschriftlichen Formularen benötigen Sie etwas, das visuelle Erkennung und semantisches Verständnis verbindet.
Track 3: VLM/AI-gestützte semantische Extraktion
So funktioniert es: Vision-Language-Modelle (VLMs) wie GPT-5, Gemini 3 Pro und Claude Sonnet verarbeiten Dokumente als vollständige Bilder und verstehen deren Inhalt semantisch. Sie gleichen keine Zeichenformen ab oder erkennen Strichmuster – sie „lesen" das Dokument so, wie es ein Mensch tut: Sie betrachten die gesamte Seite, verstehen, was jedes Feld bedeutet, und extrahieren Informationen nach Bedeutung statt nach Position. Wenn das Modell auf ein unklares handschriftliches Zeichen stößt, löst es die Mehrdeutigkeit über den Kontext – genau wie ein menschlicher Leser.
Wofür es geeignet ist: Alles auf einer einzelnen Seite, gleichzeitig. Ein VLM kann gedruckten Text, Schreibschrift und Blockschrift auf demselben Formular in einem Durchgang lesen. Es kann Kontrollkästchen erkennen (angekreuzt, eingekreist, durchgestrichen), Unterschriften und Stempel lokalisieren und das typische reale Dokument verarbeiten: ein gedrucktes Formular mit handschriftlichen Einträgen in den leeren Feldern. Der AIMultiple 2026-Benchmark zeigte, dass VLM-basierte Systeme bei kursivem Text hohe semantische Ähnlichkeitswerte erzielten, die herkömmliche OCR überhaupt nicht verarbeiten konnte.
Noch wichtiger: VLM-basierte Extraktion kann strukturierte Ausgabe erzeugen. Sie definieren, welche Spalten Sie möchten – „Rechnungsnummer", „Datum", „Gesamtbetrag", „Handschriftliche Notizen" – und das Modell findet jeden Wert überall auf der Seite, indem es versteht, was er bedeutet, nicht wo er steht. Dies ist die entscheidende Fähigkeit, die die ersten beiden Tracks vom dritten unterscheidet: die Fähigkeit, von „Ich kann diese Seite lesen" zu „hier ist Ihre Tabelle" zu gelangen.
Wo es scheitert: Drei ehrliche Einschränkungen. Geschwindigkeit: VLM-Inferenz ist rechenintensiver als herkömmliche OCR – die Verarbeitung dauert 5–10 Sekunden pro Seite statt unter einer Sekunde. Halluzinationsrisiko: VLMs können gelegentlich Text erfinden, insbesondere bei extrem degradierten oder mehrdeutigen Eingaben. Das verbessert sich (GPT-5 halluziniert deutlich weniger als GPT-4V), aber es ist nicht null – für einen Diagnose-Rahmen, der Halluzination und die anderen sieben häufigen Fehlermuster abdeckt, siehe unseren Leitfaden zu Fehlermodi bei der Handschrift-Extraktion. Kosten: Die API-Kosten pro Seite sind höher als bei herkömmlicher OCR – etwa $0,01–0,05 pro Seite gegenüber $0,001–0,005. Ob das wichtig ist, hängt von den Kosten für die Korrektur von Fehlern ab (siehe Kostenabschnitt unten).
Fazit: Dies ist der Track, der die Extraktion von Handschriftdaten in großem Maßstab praktikabel macht. Wenn Ihr Ziel darin besteht, handschriftliche Daten in eine Tabelle zu bringen – nicht nur handschriftlichen Text zu transkribieren –, ist dies die Architektur, die Sie suchen.
| Dimension | Traditionelle OCR | ICR / HTR | VLM/AI-Semantik |
|---|---|---|---|
| Genauigkeit bei gedrucktem Text | 95–99% | 90–95% | 95–99% |
| Genauigkeit bei Blockschrift | 70–85% | 85–95% | 85–93% |
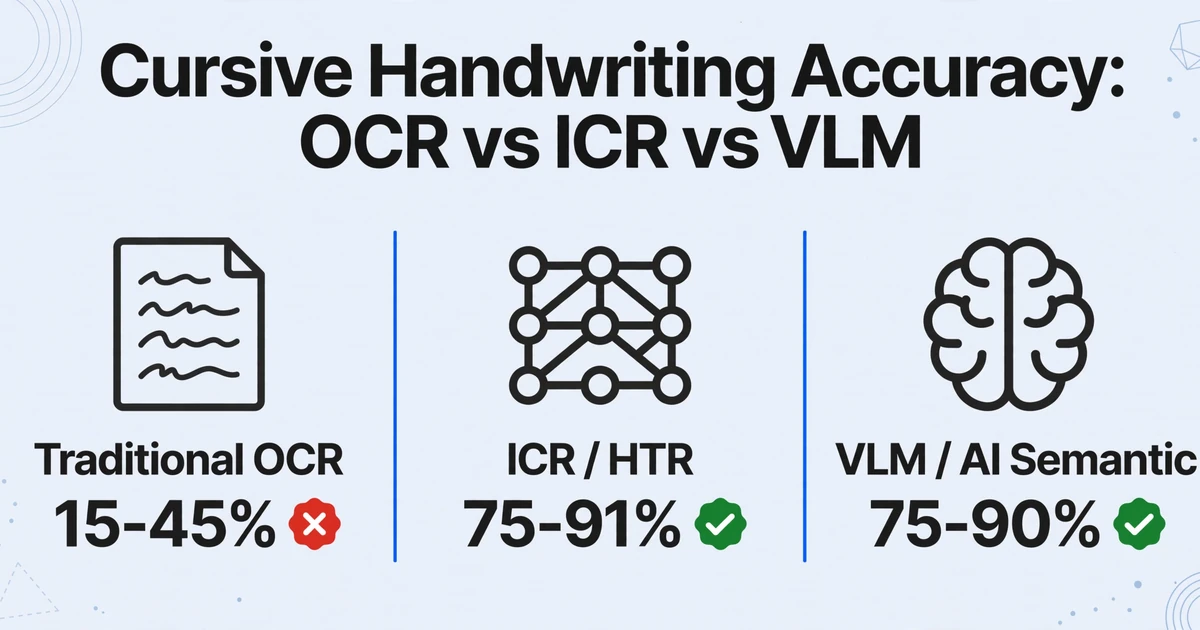
| Genauigkeit bei Schreibschrift | 15–45% | 75–91% | 75–90% |
| Gemischter Druck + Handschrift | ❌ Scheitert | ⚡ Teilweise | ✅ Liest zusammen |
| Strukturierte Datenausgabe | ❌ Nur Text | ❌ Meist Text | ✅ Excel/JSON |
| Kontextuelles Verständnis | ❌ Keines | ❌ Begrenzt | ✅ Semantisch |
| Kosten pro Seite | $0,001–0,005 | $0,005–0,02 | $0,01–0,05 |
| Training erforderlich | Keines | Manchmal | Keines |
Genauigkeits-Check: Was die Zahlen tatsächlich bedeuten
Jeder Anbieter von Handschriftenerkennung veröffentlicht eine Genauigkeitszahl. Nur wenige erklären, woran diese Zahl gemessen wurde, unter welchen Bedingungen und was dasselbe System liefert, wenn die Bedingungen nicht ideal sind. Dieser Abschnitt liefert Ihnen die Zahlen, die Sie tatsächlich benötigen, aufgeschlüsselt nach Szenario.
Das Muster, das sich aus mehreren unabhängigen Benchmarks in den Jahren 2025–2026 ergibt, ist konsistent. Bei gedrucktem Text liegen die drei Technologie-Tracks im selben Bereich, nur wenige Prozentpunkte auseinander. Bei Handschrift driften sie auseinander.
| Dokument-Szenario | Traditional OCR | ICR/HTR | VLM/AI | Real-World-Lücke |
|---|---|---|---|---|
| Sauberes gedrucktes Formular (300-DPI-Scan) | 92–98 % | 90–95 % | 95–99 % | Gering |
| Saubere Druckschrift in Kästchen | 70–85 % | 85–95 % | 85–93 % | Mäßig |
| Gemischte Schreibschrift + gedruckte Beschriftungen auf Formular | 45–60 % | 65–85 % | 80–90 % | Groß |
| Durchgehender Schreibschrift-Text | 15–30 % | 75–91 % | 75–88 % | Massiv vs. OCR |
| Handyfoto eines handschriftlichen Dokuments (schlechte Beleuchtung) | <20 % | 40–60 % | 65–80 % | Massiv |
| Historisches Dokument (verblasste Tinte, vergilbtes Papier) | <15 % | 50–70 % | 60–80 % | Massiv |
Quellen: AIMultiple 2026 Handwriting Recognition Benchmark, Suparse 2026 Best Handwriting OCR Tools Comparison, handwritingocr.com-Benchmark, Reddit r/computervision-Produktionsberichte. Alle Zahlen sind unabhängige Messungen, keine Herstellerangaben.
Zwei Dinge fallen bei dieser Tabelle auf. Erstens: Das Degradationsmuster ist asymmetrisch. Traditional OCR stürzt beim ersten Anzeichen von Handschrift ab – von den niedrigen 90ern bei gedrucktem Text auf unter ein Drittel bei Schreibschrift. Das ist kein allmählicher Rückgang, sondern ein Systemversagen. Auch VLMs degradieren, aber sanfter, und bleiben von gedrucktem Text bis zu Feldaufnahmen in einem nutzbaren Bereich.
Zweitens: „Genauigkeit der Handschriftenerkennung" als einzelne Zahl ist bedeutungslos. Ein Tool, das bei sauberen Druckbuchstaben in begrenzten Formularfeldern 95 % erreicht, könnte bei den Schreibschrift-Kommentaren auf demselben Formular nur 45 % erreichen. Wenn Ihre Dokumente beides enthalten (und die meisten realen Dokumente tun das), hängt die Gesamtgenauigkeit von Ihrer Dokumentmischung ab – nicht von der Schlagzeilenzahl des Anbieters.
Der einzige zuverlässige Weg, ein Tool zu bewerten, ist der Test mit Ihren tatsächlichen Dokumenten – nicht mit sauberen Beispielen, die der Anbieter bereitstellt. Jeder Anbieter, der Ihnen nicht erlaubt, mit Ihren eigenen Dateien zu testen, sollte mit Skepsis betrachtet werden.
Transkription vs. Extraktion: Der Unterschied, den die meisten Anleitungen übersehen
Transkription und Extraktion werden oft als dieselbe Aufgabe behandelt. Das sind sie nicht, und der Unterschied entscheidet, ob Ihr Projekt eine Tabelle oder einen Textblock hervorbringt.
Transkription ist der Schritt von handschriftlichem zu digitalem Text. Das Ergebnis ist ein Absatz oder ein Textblock: „Patient berichtet seit drei Tagen über Bauchschmerzen, verneint Übelkeit." Das ist Transkription. Sie ist nützlich für Suche, Archivierung und Lesen, aber nicht für Analysen, Buchhaltung oder Workflows, die Daten in Spalten benötigen.
Extraktion bedeutet, bestimmte Datenpunkte aus einem handschriftlichen Dokument in strukturierte Felder zu überführen. Das Ergebnis ist eine Tabellenzeile: Datum = 2026-06-15, Betrag = $342.50, Kunde = Acme Corp, Notizen = „Eilauftrag — bis Freitag liefern." Das ist Extraktion. Das ist es, was Ihre Tabellenkalkulation, Ihr ERP oder Ihr Buchhaltungssystem tatsächlich benötigt.
Die meisten Handschriftenerkennungs-Tools — einschließlich fast aller traditionellen OCR- und ICR-Lösungen — bieten nur Transkription. Sie liefern einen Textblock. Sie sagen Ihnen nicht, welche Zahl der Rechnungsbetrag und welche die Steuer ist. Dieser Trennungsschritt — das Lesen des Dokuments und dann das Strukturieren des Gelesenen — ist der Punkt, an dem traditionell menschliche Arbeit in den Workflow einfließt, und dort scheitern die meisten Automatisierungsprojekte.
Die Tools, die Extraktion durchführen, insbesondere VLM-basierte Systeme, überbrücken diese Lücke, indem sie Dokumente semantisch lesen. Sie definieren die gewünschten Spalten, und die KI lokalisiert jeden Wert auf der Seite, indem sie versteht, was er bedeutet, statt in vordefinierten Zonen nach Text zu suchen. Ein Tool, das „Gesamtbetrag = $342.50" aus einer handschriftlichen Rechnung extrahieren kann, muss nicht wissen, wo auf der Seite diese Zahl erscheint. Es muss verstehen, dass „Gesamtbetrag" ein Label und „$342.50" der zugehörige Wert ist, selbst wenn sie durch einen Zeilenumbruch, einen handschriftlichen Pfeil oder einen völlig anderen Schreibstil getrennt sind.
Das ist es, was mit Benutzerdefinierte Spaltenextraktion gemeint ist. Sie benennen die Felder einmal, in einfachen Worten wie „Rechnungsnummer", „Datum" oder „Gesamt", und dieselbe Spaltenliste wird auf jedes hochgeladene Dokument angewendet, egal wie unterschiedlich die Formulare aussehen. Es gibt keine Vorlage, die für jeden Lieferanten erstellt werden muss, und nichts, was neu trainiert werden müsste, wenn sich ein Formular ändert, da nichts in der Einrichtung an eine Position auf der Seite gebunden ist.
Wenn Ihr Workflow damit endet, dass Daten in eine Tabellenkalkulation fließen, benötigen Sie Extraktion, nicht Transkription. Stellen Sie sicher, dass das von Ihnen geprüfte Tool das Zweite kann, nicht nur das Erste.
Die wahre Kostenformel: Warum der Seitenpreis die falsche Kennzahl ist
Die Preisdiskussion rund um Handschriftenerkennungs-Tools beginnt immer mit den Kosten pro Seite. Traditionelles OCR: 0,001–0,005 $ pro Seite. VLM-basiert: 0,01–0,05 $ pro Seite. Einfache Rechnung: OCR ist 5–10x günstiger. Fall abgeschlossen.
Außer, dass es das nicht ist. Die Kosten, die zählen, sind nicht der Extraktionspreis pro Seite – sondern die Kosten für ein korrektes Ergebnis. Und das beinhaltet die Zeit und Arbeit, die für die Korrektur von Fehlern aufgewendet wird.
Die wahre Formel lautet:
Wahre Kosten = (Extraktionspreis pro Seite × Seitenanzahl) + (Korrekturzeit pro Fehler × Fehleranzahl × Stundensatz)
Wenn die Fehlerrate niedrig ist (gedruckter Text, traditionelles OCR), ist der Korrekturterm klein. Wenn sie hoch ist (Schreibschrift, traditionelles OCR), dominiert der Korrekturterm die Gleichung vollständig.
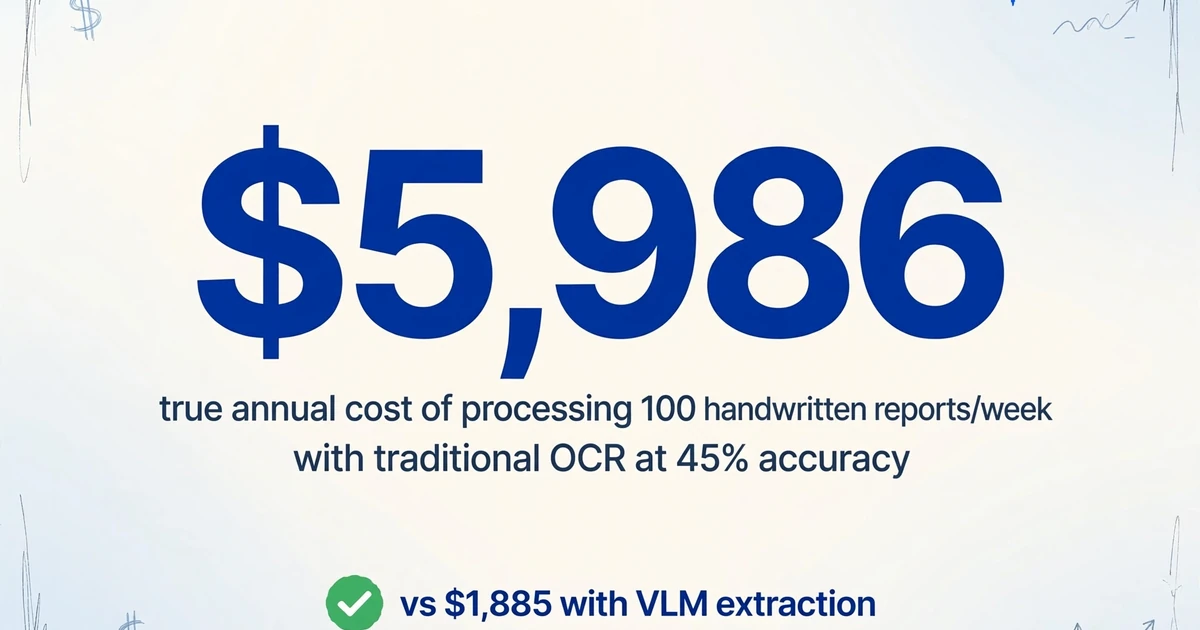
Machen wir das konkret. Ein Bauunternehmen verarbeitet 100 handschriftliche Tagesberichte pro Woche. Jeder Bericht enthält etwa 25 Datenfelder – Daten, Arbeitsstunden, verwendete Materialien, Gerätestunden, Notizen des Vorarbeiters. Das sind 2.500 Felder pro Woche, 130.000 Felder pro Jahr.
Mit traditionellem OCR (45 % Genauigkeit bei handschriftlichen Notizen): 71.500 Felder müssen pro Jahr manuell korrigiert werden. Bei 15 Sekunden pro Korrektur sind das 298 Stunden manuelle Arbeit – etwa 5.960 $ pro Jahr bei 20 $/Stunde. Die OCR-Kosten pro Seite sind vernachlässigbar (~26 $/Jahr). Wahre jährliche Kosten: ~5.986 $.
Mit VLM-basierter Extraktion (85 % Genauigkeit bei Schreibschrift): 19.500 Felder müssen pro Jahr manuell korrigiert werden. Bei 15 Sekunden pro Korrektur sind das 81 Stunden – etwa 1.625 $ pro Jahr. Die VLM-Kosten pro Seite sind höher (~260 $/Jahr). Wahre jährliche Kosten: ~1.885 $.
Der VLM-Ansatz kostet 3x mehr pro Seite – und insgesamt 3x weniger, wenn man die Korrekturarbeit einbezieht. Diese Rechnung gilt für jeden Dokumenttyp, bei dem Handschrift einen wesentlichen Teil des Inhalts ausmacht. Ein Reddit-Nutzer, der über 150.000+ Seiten in der Produktion verarbeitet hat, bestätigte dieses Muster: „Traditionelle OCR-Plattformen erscheinen kosteneffektiv (~0,001–0,005 $ pro Seite), aber ihre schlechte Handschriftgenauigkeit (~45–50 %) macht sie für Geschäftsworkflows mit erheblichen handschriftlichen Inhalten unbrauchbar. Die Zeit, die für manuelle Fehlerkorrekturen aufgewendet wird, macht die wahren Kosten weit höher als bei spezialisierten Lösungen" (r/computervision, 2025).
Der Kostenvergleich pro Seite ist eine Falle. Die einzigen Kosten, die zählen, sind die Kosten pro korrektem Ergebnis. Wenn Handschrift einen bedeutenden Anteil des Inhalts ausmacht, ist die VLM-basierte Extraktion in der Summe tendenziell günstiger, oft sogar deutlich, sobald man die menschliche Korrekturarbeit einbezieht, die traditionelles OCR erfordert.
Anwendung für Anwendung: Welcher Track passt zu Ihren Dokumenten
Kein Technologie-Track ist grundsätzlich besser; der richtige hängt von Ihren Dokumenten ab. Was wohin passt, basierend auf realen Bereitstellungen und Benchmark-Daten:
Medizinische Unterlagen und klinische Notizen
Medizinische Handschrift ist bekanntermaßen schlecht, und ein großer Teil der klinischen Dokumentation beginnt noch immer auf Papier oder in gescannten Dateien. Die Risiken sind hoch: Ein falsch gelesener Medikamentenname oder eine falsche Dosierung ist ein Patientensicherheitsvorfall, und die HIPAA-Konformität erfordert nachvollziehbare Genauigkeit. Eine Studie aus dem Jahr 2025 zur Digitalisierung handschriftlicher klinischer Aufzeichnungen ergab, dass „allgemeine OCR-Systeme derzeit für eine zuverlässige klinische Datenextraktion unzureichend sind", aufgrund der „Komplexität und Variabilität handschriftlicher medizinischer Aufzeichnungen" (SciTePress, 2025).
Empfohlener Track: VLM-basierte semantische Extraktion, mit einem Human-in-the-Loop-Überprüfungsschritt für kritische Felder (Medikamentennamen, Dosierungen, Diagnosen). Bei Omega Healthcare reduzierte die KI-gestützte Dokumentenverarbeitung die Dokumentationszeit um 40% und sparte mehr als 15.000 Mitarbeiterstunden pro Monat bei 99,5% Prozessgenauigkeit (Business Insider, 2025). Die Architektur, die dies ermöglicht, ist KI-Extraktion mit einem Konfidenzschwellenwert: Felder über dem Schwellenwert gehen direkt durch; Felder darunter werden zur menschlichen Überprüfung markiert.
Worauf Sie achten sollten: HIPAA-Konformität. Wenn Sie ein cloudbasiertes VLM verwenden, bestätigen Sie die BAA (Business Associate Agreement) des Anbieters und die Datenverarbeitungspraktiken. Für bestimmte Einrichtungen kann eine lokale Bereitstellung erforderlich sein.
Bautagesberichte und Feldprotokolle
Bauleiter füllen Tagesberichte von Hand aus – oft vor Ort, bei schlechtem Wetter, mit einem Stift, dem die Tinte ausgeht. Diese Berichte enthalten Sicherheitsbeobachtungen, Arbeitsstunden, Gerätenutzung, Materiallieferungen und Vorfallnotizen. Sie sind rechtlich bedeutsam (die Davis-Bacon-zertifizierten Lohnanforderungen in den USA schreiben eine bestimmte Aufzeichnungspflicht vor) und betrieblich kritisch (verzögerte Abrechnung bedeutet verzögerten Cashflow).
Empfohlener Track: VLM-basierte Extraktion mit Batch-Verarbeitung. Ein typisches Bauunternehmen verarbeitet 20–100 Tagesberichte pro Woche, jeweils von verschiedenen Bauleitern mit unterschiedlicher Handschrift. Die Batch-Verarbeitungsfähigkeit – alle Berichte auf einmal hochladen und eine einzige konsolidierte Tabelle erhalten – ist der betriebliche Unterschied zwischen einem Werkzeug, das Sie tatsächlich nutzen, und einem, das in einem Schulungsvideo verstaubt.
Worauf Sie achten sollten: Gemischte Inhalte. Bauformulare mischen fast immer gedruckte Beschriftungen („Datum", „Auftragsnr.", „Bauleiter") mit handschriftlichen Einträgen. Traditionelle OCR scheitert an dieser Mischung. Stellen Sie sicher, dass Ihr gewählter Ansatz beides in einem Durchgang verarbeitet.
Historische Dokumente und Archive
Bibliotheken, Regierungsbehörden und genealogische Organisationen digitalisieren Jahrhunderte handschriftlicher Aufzeichnungen — Geburtsurkunden, Heiratsregister, Volkszählungsformulare, Militärdienstakten. Die Wilson Library der University of North Carolina nutzt KI-gestützte HTR mit Crowdsourcing-basierter menschlicher Validierung, um handschriftliche Rechtsdokumente aus der Jim-Crow-Ära zu transkribieren. Auch staatliche Archive haben diesen Weg eingeschlagen: Sie scannen Zivilregister, die mehr als ein Jahrhundert zurückreichen, und wenden HTR darauf an, wobei menschliche Prüfer die Einträge auflösen, die das Modell nicht sicher lesen kann.
Empfohlener Track: HTR mit benutzerdefiniertem Modelltraining + menschlicher Prüfung. Wenn Sie es mit der Handschrift eines einzigen Schreibers über Hunderte von Seiten zu tun haben (das Register eines einzelnen Gemeindepfarrers, die Journale eines bestimmten Beamten), können individuell trainierte HTR-Modelle (wie Transkribus) Genauigkeitsniveaus erreichen, die allgemeine Modelle nicht bieten können. Bei Sammlungen mit vielen verschiedenen Schreibern bietet die VLM-basierte Extraktion eine solide Grundlage ohne Training, aber die menschliche Prüfung bleibt unerlässlich — die Evaluierung der UVA Library aus dem Jahr 2026 zur KI-Transkription von Primärquellen kam zu dem Schluss, dass „dies einige unserer kniffligsten Primärquellen waren: handschriftliche Briefe, komplizierte Journale, kreuzweise beschriebene Dokumente" und dass die KI-Genauigkeit je nach Dokumenttyp und -zustand stark variierte.
Worauf Sie achten sollten: Bildqualität. Verblasste Tinte, vergilbtes Papier, Durchscheinen von der Rückseite und nicht standardisierte Schriften (Fraktur, Sütterlin, Kurrentschrift) beeinträchtigen die Genauigkeit erheblich. Die Vorverarbeitung — Entzerrung, Kontrastverbesserung, Hintergrundbereinigung — ist oft genauso wichtig wie die Erkennungsengine selbst.
Finanzen und Buchhaltung: Handschriftliche Journale und Belege
Kleinunternehmen, Restaurants und Außendienstbetriebe erstellen weiterhin handschriftliche Belege, Lieferbestätigungen und manuelle Journaleinträge. Ein Restaurant erhält Lieferantenrechnungen mit handschriftlichen Mengen und Preisen am Rand. Ein Fahrer sammelt handschriftliche Zustellnachweise. Ein Mechaniker notiert Reparaturdetails auf einem Papierauftrag. Die manuelle Erfassung dieser Daten kostet schätzungsweise 15–40 $ pro Dokument, wenn man Arbeitsaufwand, Fehlerkorrektur und Verwaltungsgemeinkosten berücksichtigt (Constrafor, 2025).
Empfohlener Track: VLM-basierte strukturierte Extraktion. Die Ergebnisse müssen in Buchhaltungssoftware (QuickBooks, Xero, Sage) fließen, was bedeutet, dass die Extraktion strukturierte Daten liefern muss — nicht nur transkribierten Text. Die Möglichkeit, Ausgabespalten einmal zu definieren und mehrere handschriftliche Dokumente gegen dasselbe Schema zu verarbeiten, ist das, was Handschriftenerkennung von einer Spielerei zu einer Senkung der Betriebskosten macht.
Worauf Sie achten sollten: berechnete Spalte. Ein handschriftlicher Beleg könnte „Menge: 3, Einzelpreis: 12,50 $, Gesamt: 37,50 $" zeigen. Wenn die KI alle drei Werte extrahiert, ist das gut — aber wenn die handschriftliche Summe einen Rechenfehler enthält, überträgt die Extraktion ohne Validierung den Fehler. Die besten Extraktionspipelines ermöglichen es Ihnen, berechnete Spalten zu definieren (z. B. „Zeilensumme = Menge × Einzelpreis"), die die KI während der Extraktion berechnet und so eine Gegenprüfung zur handschriftlichen Summe bietet.
Logistik und Außendienst
Zustellfahrer füllen handschriftliche Liefernotizen mit Unterschriften, Zeitstempeln und Ausnahmenotizen aus („an der Hintertür hinterlassen“). Außendiensttechniker erstellen handschriftliche Inspektionsberichte mit Kontrollkästchen und Kommentaren. Versicherungssachbearbeiter verfassen handschriftliche Schadensbewertungen an Unfallorten. Diese Dokumente werden vor Ort erstellt, oft auf Durchschreibformularen, und müssen schnell in Back-Office-Systeme gelangen.
Empfohlener Track: VLM-basierte Extraktion mit Mobile-Upload. Die Möglichkeit, ein handschriftliches Formular mit einem Telefon zu fotografieren – ohne Scannen, ohne Entzerren – und strukturierte Daten zurückzuerhalten, ist der operative Durchbruch für Außendienstteams. Unabhängige Benchmarks zeigen, dass VLM-basierte Systeme eine Genauigkeit von 65–80 % bei Handyfotos handschriftlicher Dokumente erreichen (gegenüber <20 % bei herkömmlicher OCR), was Mobile-First-Workflows erstmals praktikabel macht.
Worauf zu achten ist: Erkennung von Kontrollkästchen und Unterschriften. Feldformulare kombinieren oft handschriftlichen Text mit angekreuzten Kästchen, eingekreisten Optionen und Unterschriften. Wenn das Extraktionssystem nicht erkennen kann, welches Kästchen angekreuzt wurde oder ob ein Unterschriftenfeld vorhanden ist, ist weiterhin eine teilweise manuelle Prüfung erforderlich.
So bewerten Sie ein Handschrift-Extraktionstool: 6 Dimensionen
Die meisten Bewertungsrahmen für Dokumentextraktionstools wurden für gedruckten Text entwickelt. Handschrift verändert die Bewertungskriterien. Hier ist, worauf es wirklich ankommt.
Genauigkeit bei Ihren Dokumenten, nicht bei Beispielen des Anbieters
Jeder Anbieter kann sich saubere Beispiele herauspicken. Verlangen Sie, dass Sie mit Ihren tatsächlichen Dokumenten testen können – mit den unordentlichen, den kursiven, den mit dem Handy bei schlechtem Licht aufgenommenen. Wenn der Anbieter Ihnen das Testen mit Ihren eigenen Dateien nicht erlaubt, gehen Sie.
Strukturierte Ausgabe, nicht nur Transkription
Erzeugt das Tool eine Tabelle mit von Ihnen definierten Spalten oder einen Textblock, den Sie anschließend selbst parsen müssen? Ersteres ersetzt die Dateneingabe; Letzteres ersetzt die Transkription, lässt die Dateneingabe aber unangetastet.
Verarbeitung gemischter Inhalte
Die meisten realen Dokumente mischen gedruckte Beschriftungen mit handschriftlichen Einträgen. Kann das Tool beides in einem Durchgang lesen oder sind separate Verarbeitungsschritte für Druckschrift und Handschrift erforderlich? Letzteres erhöht die Prozesskomplexität und untergräbt die Akzeptanz.
Stapelverarbeitungsfähigkeit
Ein handschriftliches Dokument zu verarbeiten ist eine Demo. 50 auf einmal zu verarbeiten und eine einzige konsolidierte Tabelle zu erhalten, ist ein Workflow. Stapelfähigkeit – mehrere Dateien hochladen, mit denselben Spaltendefinitionen verarbeiten, eine Ausgabetabelle erhalten – unterscheidet die Evaluierung von der Übernahme.
Kein Training oder Setup erforderlich
Wenn das Tool verlangt, dass Sie Handschriftproben sammeln, Felder annotieren oder ein Modell trainieren, bevor es funktioniert, fragen Sie, wie viel Zeit das kostet und ob das nachhaltig ist, wenn sich Ihre Dokumentquellen ändern. Einige Tools (Nanonets, einige ICR-Engines) benötigen 10+ annotierte Proben pro Dokumenttyp. Tools ohne Vorlage, die beim ersten Gebrauch funktionieren, überspringen diesen Schritt vollständig.
Gesamtkosten, nicht Kosten pro Seite
Berechnen Sie die vollständige Gleichung: Extraktionskosten + Korrekturaufwand bei Ihrer tatsächlichen Fehlerquote. Ein Tool für $0,001/Seite, das 30 % manuelle Korrektur benötigt, kostet mehr als ein Tool für $0,03/Seite, das 5 % Korrektur benötigt. Rechnen Sie mit Ihren Volumina, bevor Sie Preise vergleichen.
FAQ: Fragen zur Handschriftenerkennung, die wirklich gestellt werden
Kann KI Schreibschrift und Druckschrift auf derselben Seite verarbeiten?
Ja – und genau hier übertreffen VLM-basierte Systeme traditionelle OCR und ICR. Eine Seite mit gedruckten Abschnittsüberschriften, Schreibschrift im Fließtext und Randnotizen in Druckschrift wird von einem VLM in einem Durchgang gelesen, da das Modell semantisch liest (durch Verständnis der Bedeutung) statt Zeichenformen abzugleichen. Traditionelle OCR und ICR behandeln Druckschrift und Schreibschrift als separate Erkennungsaufgaben, die unterschiedliche Engines erfordern. Für einen tieferen Einblick in diese Fähigkeit, siehe unseren direkten Vergleich von KI-Handschriftenerkennung versus traditioneller OCR.
Welche Genauigkeit kann ich bei Schreibschrift realistisch erwarten?
Bei sauberer, lesbarer Schreibschrift, gescannt mit 300 DPI: 85–91 % mit spezialisierten ICR/HTR-Tools, 75–90 % mit VLM-basierter Extraktion. Bei unordentlicher, hastiger Schreibschrift: 65–80 % mit den besten Tools. Bei Schreibschrift in minderwertigen Handyfotos: 60–75 %. Kein Tool erreicht 99 % bei Schreibschrift unter realen Bedingungen – wer etwas anderes behauptet, misst an handverlesenen Stichproben. Der praktische Ansatz ist, Extraktion für strukturierte Felder zu nutzen (wo KI am besten abschneidet) und menschliche Prüfung für narrative Textabschnitte vorzubehalten, wo Genauigkeit entscheidend ist.
Kann Handschriftenerkennung bei historischen Dokumenten mit verblasster Tinte funktionieren?
Ja, aber der Workflow ist wichtiger als die Erkennungs-Engine. Der Erfolg bei historischen Dokumenten hängt ab von: (1) hochauflösendem Scannen (600 DPI empfohlen, nicht 300), (2) Vorverarbeitung – Kontrastverbesserung, Entzerrung, Entfernung von Hintergrundrauschen, (3) Wahl der Erkennungs-Engine – HTR mit individuellem Training auf ähnlichen Schriften, wenn die Sammlung eine konsistente Handschrift aufweist, VLM-basierte Extraktion bei vielen verschiedenen Schreibern. Staatliche und akademische Digitalisierungsprojekte berichten durchweg, dass eine Mensch-im-Loop-Prüfung bei historischen Dokumenten unerlässlich ist – KI übernimmt die Hauptarbeit, Menschen verifizieren kritische Felder. Die Evaluierung der UVA Library aus dem Jahr 2026 ergab, dass „die KI-Genauigkeit je nach Dokumenttyp und -zustand stark variierte", was bestätigt, dass historische Dokumente die schwierigste Kategorie bleiben.
Muss ich die KI auf meine Handschrift trainieren?
Für VLM-basierte Extraktion: nein. Diese Systeme sind dafür ausgelegt, ab der ersten Nutzung mit jedem Handschriftstil zu funktionieren – sie lesen semantisch, nicht durch Abgleich mit Trainingsbeispielen. Für ICR/HTR-Tools: manchmal. Tools wie Transkribus ermöglichen das Training individueller Modelle, was die Genauigkeit erhöhen kann, wenn Sie Hunderte von Seiten von einem Schreiber haben. Für traditionelle OCR: nein, denn Training hilft nicht – diese Engines können Handschrift grundsätzlich nicht verarbeiten. Der Kompromiss: Individuell trainierte HTR-Modelle können bei einem bestimmten Schreiber höhere Genauigkeit erzielen, erfordern aber anfänglichen Trainingsaufwand, während VLM-basierte Systeme sofort bei jedem Schreiber funktionieren, aber bei Schreibschrift bei etwa 90 % deckeln. Wählen Sie danach, ob Sie einen konsistenten Handschriftstil in großem Umfang oder viele verschiedene Stile verarbeiten.
Kann KI Daten aus handschriftlichen Formularen in Excel extrahieren – oder nur Handschrift in Text umwandeln?
Das hängt vollständig vom Tool ab. Die meisten Handschrift-OCR-Tools erzeugen nur Text – sie transkribieren ein handschriftliches Formular, trennen aber nicht „Datum: 15. Juni" in eine Datums-Spalte und „Betrag: 342 $" in eine Betrags-Spalte. VLM-basierte Extraktionstools (wie ImageToTable.ai) sind speziell dafür entwickelt, strukturierte Tabellenausgaben zu erzeugen. Sie definieren die gewünschten Spalten – „Datum", „Betrag", „Kundenname", „Notizen" – und die KI extrahiert die entsprechenden Werte aus jedem Dokument in diese Spalten, sodass eine Tabelle entsteht, in der jede Zeile ein Dokument und jede Spalte ein Feld ist. Das ist Extraktion, nicht Transkription – und genau diese Fähigkeit macht die Automatisierung von Handschriftdaten für Buchhaltungs-, Logistik- und Betriebsabläufe praktikabel. Für die praktische Anleitung siehe wie Sie handschriftliche Daten direkt in Excel extrahieren.
Ist kostenlose OCR (Tesseract, Google Keep) für Handschrift gut genug?
Für schnelle, unkritische Zwecke – etwa das Erfassen einer Einkaufsliste oder einer kurzen Notiz – funktionieren kostenlose Tools bei klaren Druckbuchstaben ausreichend. Für jede geschäftliche Anwendung mit Schreibschrift, unleserlicher Schrift oder wenn Genauigkeit entscheidend ist: nein. Tesseract erreicht bei Schreibschrift eine Wortgenauigkeit von ca. 45 %. Google Keep verarbeitet klare Druckschrift deutlich besser als Schreibschrift. Die Kluft zwischen kostenlosen Tools und kostenpflichtigen Lösungen ist bei der Handschriftenerkennung größer als in jeder anderen OCR-Kategorie, da handschriftspezifische KI-Modelle erhebliche Trainingsdaten und Rechenleistung erfordern, die kostenlose Tools wirtschaftlich nicht bereitstellen können. Wenn Ihr Anwendungsfall lautet: „Ich muss ein Wort in meinen handschriftlichen Notizen finden", könnten kostenlose Tools ausreichen. Wenn es heißt: „Ich muss 50 Felder aus 100 handschriftlichen Formularen mit einer Fehlerquote unter 5 % in eine Tabelle extrahieren", benötigen Sie eine kostenpflichtige Lösung.
Was als Nächstes kommt: Der Horizont 2027–2028
Die Transformation der Handschriftenerkennung von 2023 bis 2026 wurde durch LLMs vorangetrieben, die semantisches Lesen lernten. Der nächste Wandel – bereits in der Forschung sichtbar, aber noch nicht in Produktionstools – wird durch drei Entwicklungen angetrieben:
Multimodale Modelle, die in einem Durchgang extrahieren, validieren und schlussfolgern. Aktuelle Tools trennen die Extraktion („Was sagt diese Seite?") von der Validierung („Ergibt das Sinn?"). Neue Modelle werden beides gleichzeitig tun – Rechnungspositionen extrahieren und dabei prüfen, ob die Summe der Positionssummen der Kopfsumme entspricht, und Abweichungen ohne separaten Validierungsschritt kennzeichnen. Dies reduziert die Extraktions-Plus-Überprüfungs-Pipeline für Routine-Dokumente auf einen einzigen Schritt.
Erklärbare Handschriftenerkennung für regulierte Branchen. Nutzer im Gesundheitswesen, im Rechtswesen und in der Regierung müssen wissen, warum die KI ein bestimmtes Feld als „$500" und nicht als „$600" gelesen hat – besonders wenn die Handschrift mehrdeutig ist. Die Forschung zu erklärbarer KI für die Dokumentenverarbeitung schreitet voran, wobei die Konfidenzbewertung auf Zeichenebene (statt auf Dokumentebene) näher an die Produktionsreife rückt. Dies wird die KI-Extraktion prüfbar genug machen für Compliance-Workflows, die derzeit eine 100%ige menschliche Überprüfung erfordern.
On-Device-Verarbeitung für den Feldeinsatz. Die lokale Ausführung der Handschriftenerkennung auf einem Telefon – kein Cloud-Upload, keine Konnektivitätsanforderung, sofortige Ergebnisse – ist mit kleineren quantisierten Modellen technisch machbar. Der Kompromiss zwischen Genauigkeit und Geschwindigkeit/Latenz wird kleiner. Für Außendienst-, Bau- und Logistikteams, die Extraktionsergebnisse benötigen, bevor sie die Baustelle verlassen, wird die On-Device-Verarbeitung Workflows ermöglichen, die cloudabhängige Tools nicht unterstützen können.
Die Richtung ist klar: Die Handschriftenerkennung wird zu einem gelösten Problem für die strukturierte Extraktion aus gängigen Dokumenttypen und nähert sich für die schwierigsten Kategorien (historische Dokumente, stark degradierte Eingaben) dem Bereich „gut genug mit Überprüfung" an. Der Technologie-Investitionszyklus befindet sich noch in seiner frühen Beschleunigungsphase. Die 2028 verfügbaren Tools werden die heutigen besten Tools so aussehen lassen, wie Tesseract für uns heute aussieht.
Das Fazit für alle, die 2026 die Handschriftenerkennung bewerten:
Lassen Sie sich von früheren Enttäuschungen mit herkömmlicher OCR nicht davon abhalten, Ihre Erwartungen an das heute Mögliche zu stellen. Die drei Technologie-Tracks – herkömmliche OCR, ICR/HTR und VLM-basierte semantische Extraktion – sind grundlegend verschiedene Ansätze mit unterschiedlichen Genauigkeitsgrenzen, unterschiedlichen Ausgabeformaten und unterschiedlichen Kostenprofilen. Der richtige Track hängt von Ihren Dokumenten ab. Der falsche Track – bei Dokumenten mit Handschrift fast immer die herkömmliche OCR – kostet mehr als der richtige, sowohl an Geld als auch an Zeit. Testen Sie mit Ihren tatsächlichen Dokumenten, kalkulieren Sie die Gesamtkosten inklusive Korrekturaufwand und stellen Sie sicher, dass das von Ihnen gewählte Tool strukturierte Ausgaben erzeugt, nicht nur transkribierten Text.
Laden Sie ein handschriftliches Dokument hoch – geben Sie die benötigten Spalten ein – und erhalten Sie in Sekunden eine strukturierte Tabellenkalkulation. Kein Training, keine Vorlagen.