AI 손글씨-텍스트 변환:
실제로 작동하는 2026년 완벽 가이드
2023년에 AI가 손글씨를 텍스트로 안정적으로 변환할 수 있는지 묻는다면, 솔직한 답은 "어느 정도: 글씨가 또렷하고, 인쇄체이고, 스캔이 깨끗하고, 읽은 내용을 많이 수정해도 괜찮다면"이었습니다. 3년이 지난 지금, 그 답은 바뀌었습니다. AI 손글씨 인식 기술은 2024년 말과 2025년 중반 사이에 크게 발전하여 대부분의 사람들이 아직 따라잡지 못했습니다. 이제 기술은 실제로 작동하지만, 특정 문서에 맞는 올바른 접근 방식을 선택해야만 합니다. 이 가이드는 공급업체가 믿게 하려는 방식이 아닌, 2026년의 실제 현황을 안내합니다.
2023년 이후 손글씨 인식에서 실제로 달라진 점
세 가지 변화가 있었고, 그 속도가 빨라서 대부분의 사람들이 손글씨 인식에 대해 갖고 있는 가정은 이미 2년은 지난 것입니다.
첫째, LLM의 돌파구. 2023년 말 GPT-4V가 출시되었을 때, 일반 목적의 AI 모델이 필기체를 어느 정도 신뢰성 있게 읽을 수 있게 된 것은 처음이었습니다. 완벽하지는 않았습니다 — 환각률이 높았고 구조화된 데이터를 출력할 수 없었습니다. 그러나 근본적인 사실을 증명했습니다: 손글씨 인식은 문자 매칭 문제일 필요가 없다는 것입니다. 언어를 의미적으로 이해하는 모델은 사람처럼 지저분한 손글씨를 읽을 수 있습니다 — 문맥에서 모호한 문자를 추론하는 방식입니다.
2025년 중반까지 GPT-5와 Gemini 3 Pro는 이 기능을 프로덕션 수준으로 끌어올렸습니다. AIMultiple의 2026년 1월 필기체 벤치마크 — 10명의 필자가 쓴 100개의 손글씨 샘플을 사용한 통제된 테스트 — 에서 GPT-5, Gemini 3 Pro Preview, olmOCR-2-7B가 필기체 텍스트의 의미적 유사성에서 최상위를 차지했으며, Azure 및 Google Document AI와 같은 전용 OCR API를 능가했습니다 (AIMultiple, 2026년 1월). 핵심 발견은 LLM이 손글씨에서 기존 OCR을 이겼다는 것이 아니라 — 그것은 예상된 결과였습니다 — 얼마나 크게 이겼는지였습니다. 기존 OCR 엔진이 혼합 필기체에서 45–60%의 단어 정확도를 보인 반면, VLM 기반 시스템은 80–90%를 기록했습니다.
둘째, 전문 손글씨 엔진의 성숙. LLM이 주목을 받는 동안, 전용 손글씨 OCR 도구는 특정 사용 사례에서 프로덕션 수준의 정확도에 도달했습니다. HandwritingOCR은 독립 벤치마크에서 표준 필기체 영어 산문에 대해 0.9%의 단어 오류율(99.1% 정확도)을 달성했습니다 (handwritingocr.com, 2026). ABBYY FineReader 16은 교차 공급업체 비교에서 필기체 91.7%, 손글씨 인쇄체 95.2%를 기록했습니다. 이러한 수치는 2023년에는 존재하지 않았던 것입니다.
셋째, 시장 인프라의 성장. 글로벌 OCR/ICR 시장은 2024년 139.5억~162.6억 달러에 도달했으며 2030~2033년까지 420억~460억 달러에 이를 것으로 전망되며, 연평균 13~17% 성장률을 보이고 있습니다 (ArticSledge, 2026). 이는 단순히 "시장이 성장하고 있다"는 의미가 아니라 — 2024~2026년의 기술 개선 곡선이 2027~2028년에 다가올 것에 비해 느려 보일 정도로 충분한 자본이 이 분야에 유입되고 있다는 뜻입니다.
이 세 가지 변화의 실질적 결과: 손글씨 인식은 더 이상 "작동하기는 하는가"의 문제가 아닙니다. "어떤 기술 트랙이 문서, 정확도 요구 사항, 출력 형식에 맞는가"의 문제입니다.
세 가지 기술 트랙 — 서로 대체할 수 없는 이유
2026년 시장에 나와 있는 모든 손글씨 인식 도구는 세 가지 기술 트랙 중 하나에 속합니다. 이들은 정확도뿐 아니라 처리할 수 있는 입력 유형, 생성하는 출력 유형, 구조화된 데이터를 추출할 수 있는지 여부에서도 차이가 있습니다. 잘못된 트랙을 선택하면 데모에서 보여준 정확도는 실제 문서에서는 기대에 미치지 못할 것입니다.
트랙 1: Traditional OCR (Tesseract, ABBYY, Cloud APIs)
작동 방식: 문자 단위 패턴 매칭. 엔진은 각 픽셀 영역을 알려진 문자 모양 라이브러리와 비교하여 가장 가까운 일치 항목을 출력합니다. 텍스트를 시각적 패턴 인식 문제("이 모양은 무엇처럼 보이는가?")로 취급하며 언어, 문맥, 의미에 대한 이해는 없습니다.
강점: 표준 글꼴로 인쇄된 깨끗하고 고해상도의 스캔. 레이저 인쇄 문서의 300 DPI 스캔에서 Traditional OCR은 95~99%의 정확도를 달성합니다. Azure Document Intelligence와 AWS Textract는 깨끗한 인쇄 양식에서 약 99%의 정확도를 보입니다.
한계: 손글씨가 등장하는 순간부터 문제가 시작됩니다. Traditional OCR은 각 문자가 분리 가능한 경계 상자를 차지한다고 가정합니다. 필기체는 이 가정을 완전히 위반합니다 — 글자가 서로 이어져 명확한 경계가 없습니다. 엔진은 여러 글자를 하나의 덩어리로 병합하거나("clear"를 "dear"로 읽음) 단일 글자를 여러 상자로 분할합니다("m"을 "rn"으로 읽음).
실제 환경에서: 가장 널리 배포된 오픈소스 OCR 엔진인 Tesseract는 일반 필기체에서 단어 정확도 45~50%를 보입니다. Azure Document Intelligence는 또박또박 쓴 인쇄체에서 약 95%를 달성하지만 필기체 서술형 주석에서는 약 45%로 떨어집니다. Google Document AI는 손글씨 주석 섹션에서 약 50%의 정확도를 보입니다. 이러한 수치는 벤더 마케팅 자료가 아닌 독립적인 벤치마크와 Reddit의 r/computervision에 게시된 실무자 보고서에서 비롯된 것입니다.
결론: Traditional OCR은 인쇄된 텍스트용입니다. 문서에 손글씨가 포함되는 순간 — 어떤 손글씨든 — 다른 트랙이 필요합니다.
트랙 2: ICR / HTR (손글씨 특화 신경망)
작동 방식: 지능형 문자 인식(ICR)과 손글씨 텍스트 인식(HTR)은 손글씨 텍스트 데이터 세트로 특별히 훈련된 합성곱 신경망(CNN)과 순환 신경망(RNN)을 사용합니다. OCR의 패턴 매칭과 달리, 이러한 신경망은 손글씨의 기본 특징(획 패턴, 연결 지점, 글자 변형)을 학습하여 필체가 다른 작성자에게도 일반화할 수 있습니다. ICR은 일반적으로 손으로 인쇄된 문자(따로 쓰는 블록체)를 처리하는 반면, HTR은 필기체와 연결된 쓰기까지 확장합니다. 일부 도구는 두 기능을 동일한 엔진에서 결합합니다.
강점: 손글씨 필드가 있는 구조화된 양식, 특히 손글씨가 비교적 또렷한 블록체인 경우에 강합니다. ABBYY FineReader는 필기체에서 91.7%, 손으로 쓴 블록 인쇄체에서 95.2%의 정확도를 달성합니다. HandwritingOCR은 품질이 좋은 손글씨 영어 산문에서 99.1%의 단어 정확도(0.9% WER)에 도달합니다. 인스브루크 대학교의 학술 HTR 플랫폼인 Transkribus는 수백 페이지에 걸쳐 한 작성자의 필체로 맞춤 모델을 훈련할 수 있어 역사 기록 보관소와 단일 저자 컬렉션에 유용합니다.
한계: ICR/HTR은 여전히 손글씨를 시각적 문제로 취급합니다. 모양을 읽을 뿐 의미를 읽지 못합니다. 문자가 모호한 경우(예: "o"처럼 보이는 흘려 쓴 "a") 엔진은 문맥이 아닌 시각적 유사성에 기반해 추측합니다. 인간 독자는 "apples cost $5"가 "opples cost $5"보다 더 그럴듯하다는 것을 알지만, 문자 모양만으로 훈련된 신경망은 그렇지 않습니다. 이것이 필기체와 지저분한 필기에 대한 ICR 정확도가 기존 OCR보다는 낫지만 여전히 상당한 오류 격차를 남기는 이유입니다.
또한 대부분의 ICR/HTR 도구는 전사(일반 텍스트)를 출력할 뿐 구조화된 추출(테이블의 필드-값 쌍)은 제공하지 않습니다. 손글씨 양식의 텍스트를 읽는 것과 "날짜", "금액", "고객 이름"을 별도의 Excel 열로 추출하는 것은 다른 문제이며, 대부분의 ICR 도구는 후자를 수행하지 못합니다.
결론: ICR/HTR은 손글씨 텍스트 전사(역사 편지, 일기 항목, 자유 형식 메모)에 적합한 트랙입니다. 손글씨 양식에서 구조화된 데이터를 추출하려면 시각적 인식과 의미적 이해를 연결하는 도구가 필요합니다.
트랙 3: VLM/AI 기반 의미 추출
작동 방식: GPT-5, Gemini 3 Pro, Claude Sonnet과 같은 비전-언어 모델(VLM)은 문서를 완전한 이미지로 처리하고 내용을 의미적으로 이해합니다. 문자 모양을 대조하거나 획 패턴을 인식하지 않습니다. 사람처럼 문서를 "읽습니다": 전체 페이지를 보고 각 필드가 의미하는 바를 이해하며, 위치가 아닌 의미를 기준으로 정보를 추출합니다. 모델이 모호한 손글씨 문자를 만나면 사람 독자처럼 문맥을 통해 모호성을 해결합니다.
강점: 한 페이지의 모든 것을 동시에 처리합니다. VLM은 한 번의 처리로 같은 양식의 인쇄 텍스트, 필기체, 블록체를 모두 읽을 수 있습니다. 체크박스(체크, 동그라미, X 표시)를 식별하고, 서명과 도장을 찾아내며, 빈칸에 손글씨가 적힌 인쇄 양식 같은 실제 문서를 처리합니다. AIMultiple 2026 벤치마크에서 VLM 기반 시스템은 기존 OCR이 전혀 처리하지 못한 필기체 텍스트에서 높은 의미 유사도 점수를 달성했습니다.
더 중요한 것은, VLM 기반 추출은 구조화된 출력을 생성할 수 있다는 점입니다. "송장 번호", "날짜", "총액", "수기 메모" 등 원하는 열을 정의하면 모델이 위치가 아닌 의미를 이해하여 페이지 어디서든 각 값을 찾아냅니다. 이것이 처음 두 트랙과 세 번째 트랙을 구분 짓는 핵심 기능입니다: "이 페이지를 읽을 수 있다"에서 "여기 스프레드시트가 있습니다"로 넘어가는 능력입니다.
한계점: 솔직한 세 가지 제약이 있습니다. 속도: VLM 추론은 기존 OCR보다 계산량이 많아 페이지당 5~10초가 소요되며, 기존 OCR은 1초 미만입니다. 환각 위험: VLM은 특히 극도로 손상되었거나 모호한 입력에서 텍스트를 만들어낼 수 있습니다. 이는 개선되고 있지만(GPT-5는 GPT-4V보다 환각이 현저히 적음), 완전히 제로는 아닙니다. 환각 및 기타 7가지 일반적인 실패 패턴을 다루는 진단 프레임워크는 손글씨 추출 실패 모드 가이드를 참조하세요. 비용: 페이지당 API 비용이 기존 OCR보다 높습니다 — 페이지당 약 $0.01–0.05 대비 $0.001–0.005. 이것이 중요한지 여부는 오류 수정 비용에 따라 달라집니다(아래 비용 섹션 참조).
결론: 이 트랙이 손글씨 데이터 추출을 규모 있게 실용적으로 만듭니다. 목표가 손글씨 텍스트를 단순히 전사하는 것이 아니라 손글씨 데이터를 스프레드시트에 넣는 것이라면, 이것이 바로 찾고 있는 아키텍처입니다.
| 차원 | 기존 OCR | ICR / HTR | VLM/AI 의미 |
|---|---|---|---|
| 인쇄 텍스트 정확도 | 95–99% | 90–95% | 95–99% |
| 블록체 손글씨 정확도 | 70–85% | 85–95% | 85–93% |
| 필기체 정확도 | 15–45% | 75–91% | 75–90% |
| 인쇄 + 손글씨 혼합 | ❌ 실패 | ⚡ 부분적 | ✅ 함께 읽음 |
| 구조화된 데이터 출력 | ❌ 텍스트만 | ❌ 대부분 텍스트 | ✅ Excel/JSON |
| 문맥 이해 | ❌ 없음 | ❌ 제한적 | ✅ 의미적 |
| 페이지당 비용 | $0.001–0.005 | $0.005–0.02 | $0.01–0.05 |
| 학습 필요 여부 | 없음 | 때때로 | 없음 |
정확도 현실 점검: 숫자가 실제로 의미하는 바
모든 손글씨 인식 업체는 정확도 수치를 공개합니다. 그러나 그 수치가 어떤 조건에서, 무엇을 대상으로 측정되었는지, 그리고 조건이 이상적이지 않을 때 동일한 시스템이 어떤 성능을 내는지 설명하는 업체는 거의 없습니다. 이 섹션에서는 시나리오별로 실제로 필요한 수치를 제공합니다.
2025~2026년 여러 독립 벤치마크에서 나타난 패턴은 일관적입니다. 인쇄 텍스트의 경우 세 가지 트랙이 몇 포인트 차이로 비슷한 범위에 머무릅니다. 그러나 손글씨에서는 격차가 벌어집니다.
| 문서 시나리오 | Traditional OCR | ICR/HTR | VLM/AI | 실제 격차 |
|---|---|---|---|---|
| 깨끗한 인쇄 양식(300 DPI 스캔) | 92–98% | 90–95% | 95–99% | 작음 |
| 박스 안에 또박또박 쓴 손글씨 | 70–85% | 85–95% | 85–93% | 보통 |
| 필기체 + 인쇄 라벨 혼합 양식 | 45–60% | 65–85% | 80–90% | 큼 |
| 전체 필기체 서술형 텍스트 | 15–30% | 75–91% | 75–88% | OCR 대비 매우 큼 |
| 손글씨 문서의 휴대폰 촬영(조명 불량) | <20% | 40–60% | 65–80% | 매우 큼 |
| 역사 문서(퇴색된 잉크, 누런 종이) | <15% | 50–70% | 60–80% | 매우 큼 |
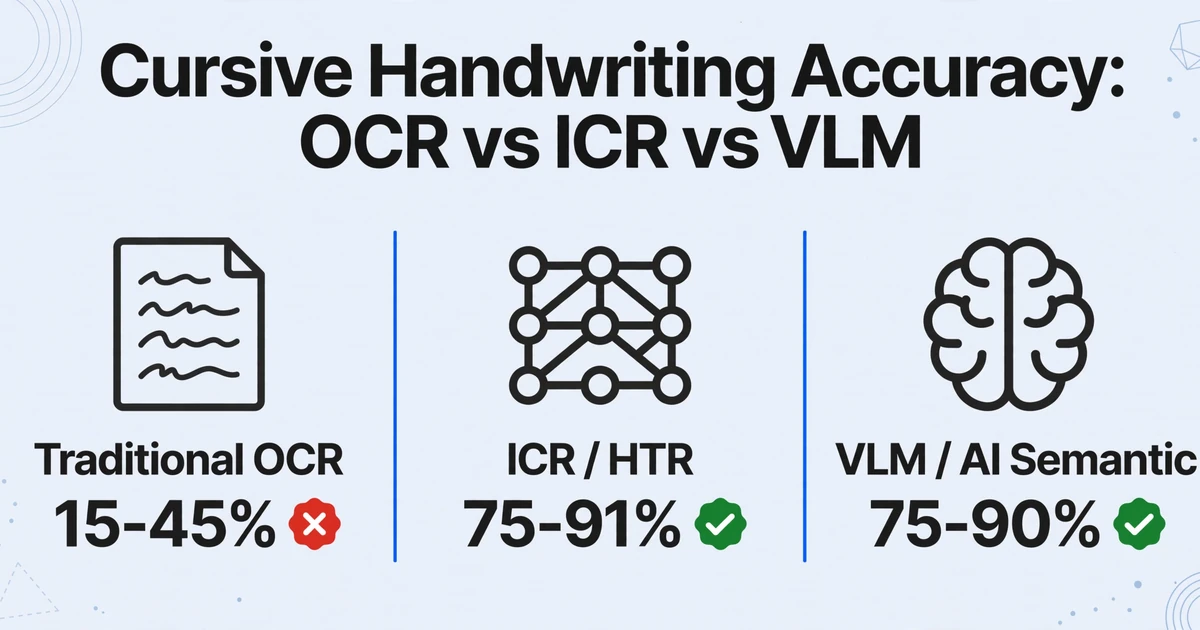
출처: AIMultiple 2026 손글씨 인식 벤치마크, Suparse 2026 최고의 손글씨 OCR 도구 비교, handwritingocr.com 벤치마크, Reddit r/computervision 실무 보고. 모든 수치는 업체 주장이 아닌 독립 측정 결과입니다.
이 표에서 두 가지가 두드러집니다. 첫째, 성능 저하 패턴은 비대칭적입니다. Traditional OCR은 손글씨가 조금만 섞여도 성능이 급락하여 인쇄 텍스트의 90%대 초반에서 필기체 기준 3분의 1 미만으로 떨어집니다. 이는 점진적인 저하가 아니라 시스템 실패입니다. VLM도 성능이 저하되지만 비교적 완만하게, 인쇄 텍스트부터 현장 촬영 사진까지 사용 가능한 범위를 유지합니다.
둘째, 단일 수치로서의 "손글씨 인식 정확도"는 의미가 없습니다. 제한된 양식 필드의 또박또박 쓴 손글씨에서 95%를 달성하는 도구가 동일한 양식의 필기체 서술형 코멘트에서는 45%에 그칠 수 있습니다. 문서에 두 가지가 모두 포함되어 있다면(대부분의 실제 문서가 그렇습니다), 혼합 정확도는 업체의 대표 수치가 아닌 문서 구성에 따라 달라집니다.
도구를 평가하는 유일한 신뢰할 수 있는 방법은 업체가 제공하는 깨끗한 샘플이 아닌 실제 문서로 테스트하는 것입니다. 자체 파일로 테스트하는 것을 허용하지 않는 업체는 신중하게 대처해야 합니다.
전사와 추출: 대부분의 가이드가 놓치는 차이점
전사와 추출은 같은 작업으로 취급됩니다. 하지만 둘은 다르며, 이 차이가 프로젝트 결과물을 스프레드시트로 만들지, 텍스트 벽으로 만들지를 결정합니다.
전사는 손글씨를 디지털 텍스트로 변환하는 단계입니다. 결과물은 문단 또는 텍스트 블록입니다. "환자가 3일 동안 복통을 호소하며, 메스꺼움은 부인함." 이것이 전사입니다. 검색, 보관, 읽기에 유용하지만, 데이터를 열에 넣어야 하는 분석, 회계 또는 모든 워크플로우에는 유용하지 않습니다.
추출은 손글씨 문서에서 특정 데이터 포인트를 구조화된 필드로 끌어내는 것을 의미합니다. 결과물은 테이블 행입니다: 날짜 = 2026-06-15, 금액 = $342.50, 고객 = Acme Corp, 메모 = "급주문 — 금요일까지 배송." 이것이 추출입니다. 스프레드시트, ERP 또는 회계 시스템이 실제로 필요로 하는 것입니다.
대부분의 손글씨 인식 도구 — 거의 모든 전통적인 OCR 및 ICR 솔루션을 포함하여 — 전사만 수행합니다. 텍스트 벽을 제공할 뿐입니다. 어떤 숫자가 송장 합계이고 어떤 것이 세액인지 알려주지 않습니다. 문서를 읽고, 읽은 내용을 구조화하는 분리 단계는 전통적으로 인력이 워크플로우에 투입되는 지점이며, 대부분의 자동화 프로젝트가 정체되는 지점입니다.
추출을 수행하는 도구, 특히 VLM 기반 시스템은 문서를 의미적으로 읽어 이 격차를 메웁니다. 원하는 열을 정의하면 AI가 페이지에서 각 값을 찾아내는데, 미리 정의된 영역에서 텍스트를 스캔하는 것이 아니라 의미를 이해하여 찾습니다. 손글씨 송장에서 "총액 = $342.50"을 추출할 수 있는 도구는 해당 숫자가 페이지의 어디에 나타나는지 알 필요가 없습니다. "총액"이 레이블이고 "$342.50"이 그와 연관된 값임을 이해해야 하며, 줄 바꿈, 손글씨 화살표 또는 완전히 다른 필체로 분리되어 있어도 말입니다.
이것이 사람들이 맞춤 열 추출이라고 부르는 것입니다. "송장 번호," "날짜," 또는 "총액"과 같은 일반적인 단어로 필드를 한 번 정의하면, 동일한 열 목록이 업로드하는 모든 문서에 적용되며, 양식이 아무리 달라도 상관없습니다. 공급업체별로 구축할 템플릿이 없고, 양식이 변경될 때 재학습할 것도 없습니다. 설정의 어떤 것도 페이지의 위치에 묶여 있지 않기 때문입니다.
워크플로우가 데이터를 스프레드시트에 넣는 것으로 끝난다면, 전사가 아닌 추출이 필요합니다. 평가 중인 도구가 첫 번째뿐만 아니라 두 번째도 수행할 수 있는지 확인하세요.
실제 비용 방정식: 페이지당 가격이 잘못된 지표인 이유
손글씨 인식 도구에 대한 가격 논의는 항상 페이지당 비용에서 시작합니다. 전통적인 OCR: 페이지당 $0.001–0.005. VLM 기반: 페이지당 $0.01–0.05. 단순 계산: OCR이 5–10배 저렴합니다. 논쟁 종료.
하지만 그렇지 않습니다. 중요한 비용은 페이지당 추출 가격이 아니라 올바른 결과를 만드는 비용입니다. 여기에는 오류를 수정하는 데 드는 시간과 노동이 포함됩니다.
실제 방정식은 다음과 같습니다:
실제 비용 = (페이지당 추출 가격 × 페이지 수) + (오류당 수정 시간 × 오류 수 × 노동 단가)
오류율이 낮을 때(인쇄된 텍스트, 전통적인 OCR) 수정 항목은 작습니다. 오류율이 높을 때(필기체, 전통적인 OCR) 수정 항목이 방정식을 완전히 지배합니다.
구체적으로 살펴보겠습니다. 한 건설 회사가 매주 손글씨 일일 보고서 100장을 처리합니다. 각 보고서에는 날짜, 근무 시간, 사용 자재, 장비 가동 시간, 현장 감독 메모 등 약 25개의 데이터 필드가 포함됩니다. 주당 2,500개 필드, 연간 130,000개 필드입니다.
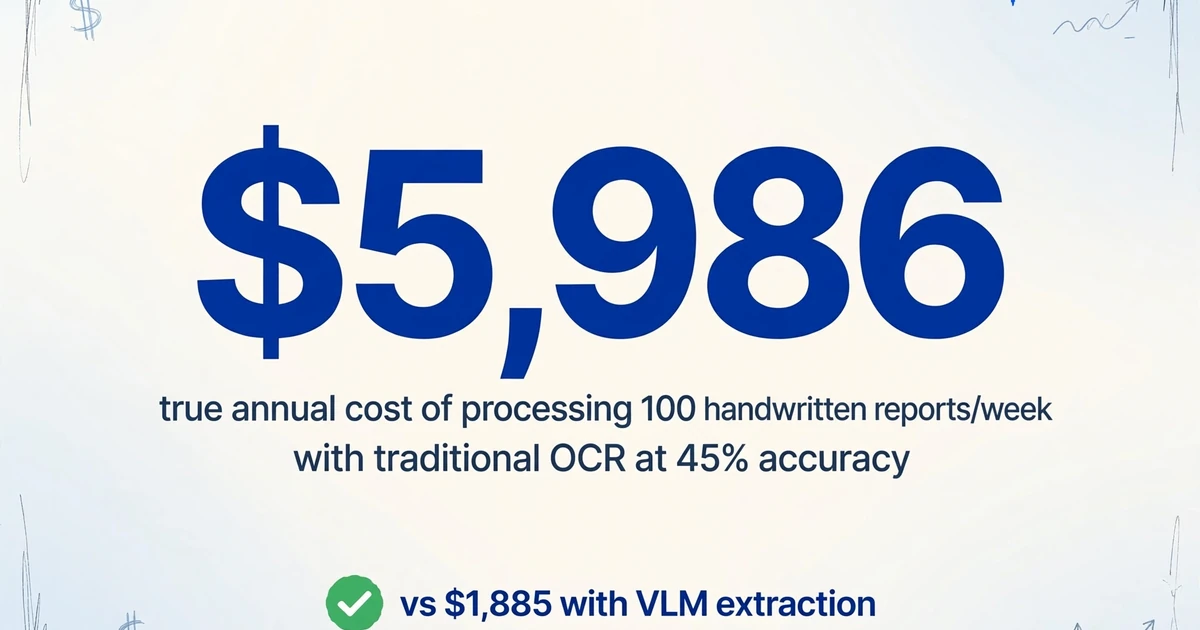
전통적인 OCR 사용 시(필기체 메모 정확도 45%): 연간 71,500개 필드를 수동으로 수정해야 합니다. 수정당 15초 기준, 연간 298시간의 수동 노동 — 시간당 $20 기준 약 $5,960. 페이지당 OCR 비용은 무시할 수준입니다(연간 약 $26). 실제 연간 비용: 약 $5,986.
VLM 기반 추출 사용 시(필기체 정확도 85%): 연간 19,500개 필드를 수동으로 수정해야 합니다. 수정당 15초 기준, 연간 81시간 — 약 $1,625. 페이지당 VLM 비용은 더 높습니다(연간 약 $260). 실제 연간 비용: 약 $1,885.
VLM 방식은 페이지당 3배 더 비싸지만, 수정 노동을 포함한 총비용은 3배 더 저렴합니다. 이 계산은 손글씨가 콘텐츠의 상당 부분을 차지하는 모든 문서 유형에 적용됩니다. 프로덕션에서 150,000페이지 이상을 처리한 Reddit 사용자가 이 패턴을 확인했습니다: "전통적인 OCR 플랫폼은 비용 효율적으로 보이지만(페이지당 약 $0.001–0.005) 손글씨 정확도가 낮아(약 45–50%) 손글씨 콘텐츠가 많은 비즈니스 워크플로우에는 사용할 수 없습니다. 오류를 수동으로 수정하는 데 드는 시간 때문에 실제 비용은 전문 솔루션보다 훨씬 높습니다" (r/computervision, 2025).
페이지당 비용 비교는 함정입니다. 중요한 유일한 비용은 올바른 결과당 비용입니다. 손글씨가 콘텐츠에서 의미 있는 비중을 차지하는 경우, 전통적인 OCR이 요구하는 인간의 수정 노동을 포함하면 VLM 기반 추출이 총비용에서 더 저렴한 경우가 많으며, 때로는 그 차이가 상당합니다.
용도별 가이드: 문서 유형에 맞는 기술 트랙 선택
어떤 기술 트랙이 절대적으로 우월하다고 말할 수는 없습니다. 올바른 선택은 문서의 특성에 따라 달라집니다. 실제 배포 사례와 벤치마크 데이터를 바탕으로 어떤 트랙이 어떤 상황에 적합한지 살펴보겠습니다:
의료 기록 및 임상 문서
의료 분야의 손글씨는 악필로 유명하며, 상당수의 임상 문서는 여전히 종이 또는 스캔 파일로 시작됩니다. 잘못 읽은 약물 이름이나 용량은 환자 안전 사고로 이어질 수 있고, HIPAA 규정 준수를 위해서는 감사 가능한 정확성이 요구됩니다. 손글씨 임상 기록 디지털화에 관한 2025년 연구에 따르면, "손글씨 의료 기록의 복잡성과 변동성"으로 인해 "범용 OCR 시스템은 현재 신뢰할 수 있는 임상 데이터 추출에 충분하지 않다"고 합니다 (SciTePress, 2025).
권장 트랙: VLM 기반 의미 추출과 함께, 중요 필드(약물명, 용량, 진단명)에 대한 인간 검토 단계를 포함합니다. Omega Healthcare에서는 AI 기반 문서 처리를 통해 문서 작성 시간을 40% 단축했고, 99.5%의 프로세스 정확도로 월 15,000시간 이상의 직원 시간을 절약했습니다 (Business Insider, 2025). 이를 가능하게 하는 아키텍처는 신뢰도 임계값을 적용한 AI 추출입니다. 임계값 이상의 필드는 자동으로 통과되고, 임계값 미만의 필드는 인간 검토를 위해 플래그가 지정됩니다.
주의 사항: HIPAA 규정 준수. 클라우드 기반 VLM을 사용하는 경우, 공급업체의 BAA(비즈니스 제휴 계약) 및 데이터 처리 방침을 확인하십시오. 일부 기관에서는 온프레미스 배포가 요구될 수 있습니다.
건설 일일 보고서 및 현장 일지
건설 현장 반장은 일일 보고서를 손으로 작성합니다. 대개 현장에서, 악천후 속에서, 잉크가 거의 다 소진된 펜으로 말이죠. 이 보고서에는 안전 관찰 사항, 노동 시간, 장비 사용 내역, 자재 납품, 사고 기록이 포함됩니다. 이는 법적으로 중요할 뿐만 아니라(미국의 Davis-Bacon 인증 급여 요건은 특정 기록 보관을 의무화), 운영상으로도 중요합니다(청구 지연은 현금 흐름 지연을 의미합니다).
권장 트랙: 일괄 처리를 지원하는 VLM 기반 추출. 일반적인 건설 회사는 주당 20~100건의 일일 보고서를 처리하며, 각 보고서는 서로 다른 반장의 서로 다른 손글씨로 작성됩니다. 모든 보고서를 한 번에 업로드하고 통합된 단일 스프레드시트를 받는 일괄 처리 기능은, 실제로 사용하게 되는 도구와 교육 영상 속에만 머무는 도구를 구분 짓는 운영상의 차이점입니다.
주의 사항: 혼합 콘텐츠. 건설 양식은 거의 항상 인쇄된 라벨("날짜", "공사 번호", "반장")과 손글씨 항목이 혼합되어 있습니다. 기존 OCR은 이러한 혼합을 제대로 처리하지 못합니다. 선택한 방식이 한 번의 처리로 두 가지를 모두 다룰 수 있는지 확인하십시오.
역사 문서 및 기록 보관소
도서관, 정부 기관, 계보학 단체들은 수백 년에 걸친 손글씨 기록(출생 증명서, 결혼 등록부, 인구 조사 양식, 군 복무 기록)을 디지털화하고 있습니다. 노스캐롤라이나 대학의 윌슨 도서관은 AI 기반 HTR과 크라우드소싱 인적 검증을 결합하여 짐 크로우 시대의 손글씨 법률 문서를 전사하고 있습니다. 정부 기록 보관소도 같은 방식을 채택하여 100년 이상 된 민원 등록부를 스캔하고 HTR을 적용했으며, 모델이 자신 있게 읽지 못하는 항목은 인간 검토자가 해결하고 있습니다.
권장 트랙: 맞춤 모델 학습 + 인간 검토가 포함된 HTR. 수백 페이지에 걸쳐 한 명의 필체(한 교구 사제의 등록부, 특정 서기의 장부)를 다룰 때, 맞춤 학습된 HTR 모델(예: Transkribus)은 범용 모델이 따라올 수 없는 정확도를 달성할 수 있습니다. 다양한 필체가 있는 컬렉션의 경우, VLM 기반 추출이 학습 없이도 강력한 기준선을 제공하지만 인간 검토는 여전히 필수적입니다. UVA 도서관의 2026년 1차 자료 AI 전사 평가는 "이들은 가장 까다로운 1차 자료였습니다: 손글씨 편지, 복잡한 장부, 교차 선이 있는 문서"라며 AI 정확도가 문서 유형과 상태에 따라 크게 달라진다고 결론지었습니다.
주의할 점: 이미지 품질. 바랜 잉크, 누렇게 변한 종이, 뒷면 비침, 비표준 서체(Fraktur, Sütterlin, secretary hand) 모두 정확도에 큰 영향을 미칩니다. 전처리(기울기 보정, 대비 향상, 배경 정리)는 인식 엔진 자체만큼이나 중요한 경우가 많습니다.
금융 및 회계: 손글씨 장부와 영수증
소규모 사업체, 레스토랑, 현장 서비스 업체는 여전히 손글씨 영수증, 배송 확인서, 수기 장부 항목을 생성합니다. 레스토랑은 여백에 손글씨 수량과 가격이 적힌 공급업체 청구서를 받습니다. 배송 기사는 손글씨 배송 완료 증명서를 수집합니다. 정비사는 종이 작업 지시서에 수리 세부 사항을 적습니다. 이 데이터의 수동 입력은 인건비, 오류 수정, 관리 간접비를 고려할 때 문서당 약 $15–40의 비용이 발생합니다(Constrafor, 2025).
권장 트랙: VLM 기반 구조화 추출. 출력물은 회계 소프트웨어(QuickBooks, Xero, Sage)로 들어가야 하므로 추출은 단순 전사된 텍스트가 아닌 구조화된 데이터를 생성해야 합니다. 출력 열을 한 번 정의하고 동일한 스키마에 대해 여러 손글씨 문서를 처리할 수 있는 기능이 손글씨 추출을 호기심에서 운영 비용 절감으로 전환시킵니다.
주의할 점: 계산 값. 손글씨 영수증에 "수량: 3, 단가: $12.50, 합계: $37.50"이 표시될 수 있습니다. AI가 세 가지를 모두 추출하면 좋지만, 손글씨 합계에 산술 오류가 있는 경우 검증 없는 추출은 실수를 그대로 전파합니다. 최상의 추출 파이프라인은 AI가 추출 중에 계산하는 계산 열(예: "라인 합계 = 수량 × 단가")을 정의할 수 있게 하여 손글씨 합계에 대한 교차 검증을 제공합니다.
물류 및 현장 서비스
배송 기사는 서명, 타임스탬프, 예외 사항("현관문 앞에 놓아둠")이 포함된 손글씨 배송 메모를 작성합니다. 현장 기술자는 체크박스와 서술형 코멘트가 포함된 손글씨 검사 보고서를 작성합니다. 보험 손해사정사는 사고 현장에서 손글씨로 손해 평가서를 작성합니다. 이러한 문서는 현장에서 생성되며, 흔히 카본지 양식으로 작성되어 신속하게 백오피스 시스템에 입력되어야 합니다.
권장 트랙: 모바일 업로드를 통한 VLM 기반 추출. 휴대폰으로 손글씨 양식을 촬영하기만 하면 — 스캔이나 기울기 보정 없이 — 구조화된 데이터를 얻을 수 있다는 점이 현장 팀에게는 운영상의 돌파구입니다. 독립 벤치마크에 따르면 VLM 기반 시스템은 손글씨 문서의 휴대폰 사진에서 65~80%의 정확도를 달성하며(기존 OCR의 20% 미만과 대비), 모바일 우선 워크플로우가 처음으로 실용화되었습니다.
주의할 점: 체크박스 및 서명 감지. 현장 양식은 손글씨 텍스트와 체크된 박스, 동그라미 친 옵션, 서명이 결합된 경우가 많습니다. 추출 시스템이 어떤 박스에 체크되었는지 또는 서명 필드가 있는지 식별할 수 없다면 여전히 부분적인 수동 검토가 필요합니다.
손글씨 추출 도구 평가 방법: 6가지 기준
대부분의 문서 추출 도구 평가 프레임워크는 인쇄 텍스트를 기준으로 작성되었습니다. 손글씨는 평가 기준을 바꿉니다. 실제로 중요한 것은 다음과 같습니다.
귀하의 문서에 대한 정확도, 벤더 샘플이 아닌
어떤 벤더든 깨끗한 샘플만 골라 보여줄 수 있습니다. 실제 문서로 테스트할 것을 요구하세요 — 지저분한 문서, 필기체 문서, 조명이 나쁜 환경에서 휴대폰으로 촬영한 문서까지. 벤더가 자체 파일로 테스트하는 것을 허용하지 않는다면, 그냥 거절하세요.
단순 전사가 아닌 구조화된 출력
도구가 사용자가 정의한 열이 있는 스프레드시트를 생성합니까, 아니면 이후에 직접 파싱해야 하는 텍스트 블록을 생성합니까? 전자는 데이터 입력을 대체하고, 후자는 전사만 대체할 뿐 데이터 입력은 그대로 남깁니다.
혼합 콘텐츠 처리
대부분의 실제 문서는 인쇄된 라벨과 손글씨 항목이 혼합되어 있습니다. 도구가 한 번에 둘 다 읽을 수 있습니까, 아니면 인쇄된 텍스트와 손글씨에 대해 별도의 처리 단계가 필요합니까? 후자는 프로세스 복잡성을 추가하여 도입을 저해합니다.
일괄 처리 기능
손글씨 문서 하나를 처리하는 것은 데모입니다. 50개를 한 번에 처리하고 단일 통합 스프레드시트를 얻는 것은 워크플로우입니다. 일괄 처리 기능 — 여러 파일 업로드, 동일한 열 정의로 처리, 하나의 출력 테이블 확보 — 이 평가와 도입을 구분합니다.
교육이나 설정 불필요
도구가 작동하기 전에 손글씨 샘플 수집, 필드 주석, 모델 교육을 요구한다면, 그 시간이 얼마나 걸리고 문서 소스가 변경될 때 지속 가능한지 물어보세요. 일부 도구(Nanonets, 일부 ICR 엔진)는 문서 유형당 10개 이상의 주석 샘플이 필요합니다. 첫 사용 시 작동하는 템플릿 불필요 도구는 이 단계를 완전히 건너뜁니다.
페이지당 비용이 아닌 총비용
전체 방정식을 계산하세요: 추출 비용 + 실제 오류율에서의 수정 인건비. 30% 수동 수정이 필요한 $0.001/페이지 도구는 5% 수정이 필요한 $0.03/페이지 도구보다 더 비쌉니다. 가격을 비교하기 전에 볼륨으로 계산해 보세요.
FAQ: 손글씨 인식에 대해 사람들이 실제로 묻는 질문
AI가 같은 페이지의 필기체와 인쇄체를 모두 처리할 수 있나요?
네 — 바로 이 부분이 VLM 기반 시스템이 기존 OCR 및 ICR보다 뛰어난 점입니다. 인쇄된 섹션 제목, 필기체 본문, 인쇄체 여백 메모가 섞인 페이지도 VLM은 한 번에 읽어냅니다. 모델이 문자 모양을 대조하는 대신 의미적으로(의미를 이해하며) 읽기 때문입니다. 기존 OCR과 ICR은 인쇄체와 필기체를 서로 다른 엔진이 필요한 별개의 인식 작업으로 취급합니다. 이 기능에 대해 더 자세히 알아보려면 AI 손글씨 인식과 기존 OCR의 직접 비교를 참조하세요.
필기체에서 현실적으로 기대할 수 있는 정확도는 어느 정도인가요?
300 DPI로 스캔한 깨끗하고 읽기 쉬운 필기체의 경우: 전문 ICR/HTR 도구는 85–91%, VLM 기반 추출은 75–90%입니다. 지저분하고 급하게 쓴 필기체의 경우: 최고의 도구도 65–80%를 기대하세요. 저화질 휴대폰 사진 속 필기체의 경우: 60–75%입니다. 실제 환경에서 필기체에 99% 정확도를 달성하는 도구는 없습니다 — 그렇다고 주장하는 곳은 좋은 샘플만 골라 측정한 것입니다. 실용적인 접근 방식은 AI가 가장 잘하는 구조화된 필드 추출에 활용하고, 정확도가 중요한 서술형 텍스트 섹션은 사람의 검토를 남겨두는 것입니다.
손글씨 인식이 바랜 잉크의 역사 문서에서도 작동하나요?
네, 하지만 인식 엔진보다 작업 흐름이 더 중요합니다. 역사 문서의 성공 여부는 다음에 달려 있습니다: (1) 고해상도 스캔(300이 아닌 600 DPI 권장), (2) 전처리 — 대비 향상, 기울기 보정, 배경 노이즈 제거, (3) 인식 엔진 선택 — 컬렉션의 필체가 일관되면 유사한 필체로 맞춤 학습한 HTR, 다양한 필체가 섞여 있으면 VLM 기반 추출. 정부 및 학계 디지털화 프로젝트는 역사 문서에 사람이 검토하는 단계가 필수적이라고 일관되게 보고합니다 — AI가 작업의 대부분을 처리하고, 사람이 중요한 필드를 검증합니다. UVA 도서관의 2026년 평가는 "AI 정확도는 문서 유형과 상태에 따라 크게 달라졌다"고 밝혀, 역사 문서가 여전히 가장 어려운 범주임을 확인했습니다.
AI를 내 손글씨로 학습시켜야 하나요?
VLM 기반 추출의 경우: 아니요. 이러한 시스템은 어떤 손글씨 스타일이든 첫 사용부터 작동하도록 설계되었습니다 — 학습 샘플 대조가 아닌 의미적으로 읽기 때문입니다. ICR/HTR 도구의 경우: 때때로 필요합니다. Transkribus 같은 도구는 맞춤 모델 학습을 지원하며, 한 사람의 필체로 수백 페이지가 있다면 정확도를 더 높일 수 있습니다. 기존 OCR의 경우: 아니요, 학습해도 소용없습니다 — 이러한 엔진은 필기체를 어차피 처리할 수 없습니다. 절충점은 맞춤 학습된 HTR 모델이 특정 필체에서 더 높은 정확도를 달성할 수 있지만 초기 학습 노력이 필요하고, VLM 기반 시스템은 어떤 필체든 즉시 작동하지만 필기체에서 약 90%가 최대치라는 점입니다. 하나의 일관된 필체를 대규모로 처리할지, 다양한 필체를 처리할지에 따라 선택하세요.
AI가 손글씨 양식에서 데이터를 추출해 Excel로 옮길 수 있나요 — 아니면 손글씨를 텍스트로만 변환하나요?
이는 전적으로 도구에 달려 있습니다. 대부분의 손글씨 OCR 도구는 텍스트만 생성합니다 — 손글씨 양식을 전사할 뿐, "Date: June 15"을 Date 열로, "Amount: $342"를 Amount 열로 분리하지 않습니다. VLM 기반 추출 도구(예: ImageToTable.ai)는 구조화된 스프레드시트 출력을 생성하도록 특별히 설계되었습니다. 원하는 열을 정의하면 — "Date," "Amount," "Customer Name," "Notes" — AI가 각 문서에서 해당 값을 해당 열로 추출하여, 각 행이 하나의 문서이고 각 열이 하나의 필드인 테이블을 생성합니다. 이는 전사가 아닌 추출이며, 회계, 물류, 운영 워크플로우에서 손글씨 데이터 자동화를 실용적으로 만드는 기능입니다. 실습 가이드는 손글씨 데이터를 Excel로 직접 추출하는 방법을 참조하세요.
무료 OCR(Tesseract, Google Keep)이 손글씨에 충분한가요?
빠르고 중요하지 않은 용도 — 쇼핑 목록이나 짧은 메모 캡처 — 에는 무료 도구가 명확한 인쇄체 손글씨에서 적절히 작동합니다. 필기체, 지저분한 글씨, 또는 정확도가 중요한 비즈니스 애플리케이션의 경우: 아닙니다. Tesseract는 필기체에서 약 45%의 단어 정확도를 달성합니다. Google Keep은 필기체보다 명확한 인쇄체 손글씨를 훨씬 잘 처리합니다. 무료 도구와 유료 솔루션 간의 격차는 손글씨 인식에서 다른 어떤 OCR 카테고리보다 큽니다. 손글씨 특화 AI 모델은 무료 도구가 경제적으로 제공할 수 없는 상당한 학습 데이터와 컴퓨팅 리소스를 요구하기 때문입니다. 사용 사례가 "손글씨 메모에서 단어를 찾아야 한다"라면 무료 도구로 충분할 수 있습니다. "100개의 손글씨 양식에서 50개 필드를 5% 미만의 오류율로 스프레드시트에 추출해야 한다"라면 유료 솔루션이 필요합니다.
다음 단계: 2027–2028년 전망
2023–2026년 손글씨 인식의 변화는 LLM이 의미론적으로 읽는 법을 배우면서 주도되었습니다. 연구에서는 이미 확인되었지만 아직 프로덕션 도구에는 적용되지 않은 다음 변화는 세 가지 개발에 의해 주도될 것입니다:
추출, 검증, 추론을 한 번에 수행하는 멀티모달 모델. 현재 도구는 추출("이 페이지에 무엇이 쓰여 있나?")과 검증("이것이 말이 되나?")을 분리합니다. 새로운 모델은 두 가지를 동시에 수행할 것입니다 — 인보이스 라인 항목을 추출하면서 라인 합계가 헤더 합계와 일치하는지 확인하고, 별도의 검증 단계 없이 불일치를 표시합니다. 이는 일상적인 문서에 대해 추출-검토 파이프라인을 단일 단계로 축소합니다.
규제 산업을 위한 설명 가능한 손글씨 인식. 의료, 법률, 정부 사용자는 AI가 특정 필드를 "$500"이 아닌 "$600"으로 읽은 이유를 알아야 합니다 — 특히 손글씨가 모호한 경우에 더욱 그렇습니다. 문서 처리를 위한 설명 가능한 AI 연구가 진행 중이며, 문서 수준이 아닌 문자 수준의 신뢰도 점수가 프로덕션 사용에 더 가까워지고 있습니다. 이는 현재 100% 인간 검토가 필요한 규정 준수 워크플로우에 AI 추출을 감사 가능하게 만들 것입니다.
현장 사용을 위한 온디바이스 처리. 클라우드 업로드 없이, 연결 요구 사항 없이, 즉각적인 결과를 제공하는 휴대폰에서의 로컬 손글씨 인식은 더 작은 양자화 모델로 기술적으로 가능합니다. 정확성과 속도/지연 시간 간의 균형은 좁혀지고 있습니다. 작업 현장을 떠나기 전에 추출 결과가 필요한 현장 서비스, 건설, 물류 팀에게 온디바이스 처리는 클라우드 의존 도구가 지원할 수 없는 워크플로우를 가능하게 합니다.
방향은 분명합니다. 손글씨 인식은 일반적인 문서 유형의 구조화된 추출에 있어 해결된 문제가 되고 있으며, 가장 어려운 범주(역사 문서, 심하게 손상된 입력)에 대해서는 "검토 시 충분히 좋음" 영역에 접근하고 있습니다. 기술 투자 주기는 여전히 초기 가속 단계에 있습니다. 2028년에 제공될 도구는 오늘날의 최고 도구를 우리가 지금 보는 Tesseract처럼 보이게 만들 것입니다.
2026년 손글씨 추출을 평가하는 모든 분을 위한 핵심 요약:
기존 OCR에 대한 과거의 실망이 현재의 가능성에 대한 기대를 왜곡하게 두지 마십시오. 세 가지 기술 트랙(기존 OCR, ICR/HTR, VLM 기반 의미 추출)은 정확도 상한선, 출력 형식, 비용 프로필이 근본적으로 다른 접근 방식입니다. 올바른 트랙은 문서에 따라 결정됩니다. 잘못된 트랙(손글씨가 포함된 문서에는 거의 항상 기존 OCR이 해당)은 비용과 시간 모두에서 올바른 트랙보다 더 많은 비용이 듭니다. 실제 문서로 테스트하고, 교정 인력을 포함한 전체 비용을 계산하고, 선택한 도구가 단순한 전사 텍스트가 아닌 구조화된 출력을 생성하는지 확인하십시오.
손글씨 문서를 업로드하고 필요한 열을 입력하면 몇 초 안에 구조화된 스프레드시트를 얻을 수 있습니다. 학습이나 템플릿이 필요 없습니다.