IA de Escrita Manual para Texto:
O Guia Completo de 2026 para o Que Funciona
Em 2023, se você perguntasse se a IA poderia converter de forma confiável escrita manual em texto, a resposta honesta era "mais ou menos: se a escrita for legível, se for em letras de forma, se o scan estiver limpo, e se você não se importar em corrigir grande parte do que ela lê." Três anos depois, essa resposta mudou. O reconhecimento de escrita manual por IA melhorou o suficiente entre o final de 2024 e meados de 2025 que a maioria das pessoas ainda não se atualizou: a tecnologia realmente funciona agora, mas somente se você escolher a abordagem certa para seus documentos específicos. Este guia mapeia o cenário como ele realmente é em 2026, não como os fornecedores querem que você acredite.
O Que Realmente Mudou no Reconhecimento de Escrita Manual Desde 2023
Três coisas aconteceram, e aconteceram rápido o suficiente para que a maioria das suposições que as pessoas carregam sobre o reconhecimento de escrita manual esteja dois anos desatualizada.
Primeiro, o avanço dos LLMs. Quando o GPT-4V foi lançado no final de 2023, foi a primeira vez que um modelo de IA de propósito geral conseguiu ler escrita cursiva com alguma confiabilidade. Não era ótimo — as taxas de alucinação eram altas, e ele não conseguia gerar dados estruturados. Mas provou algo fundamental: o reconhecimento de escrita manual não precisa ser um problema de correspondência de caracteres. Um modelo que entende a linguagem semanticamente pode ler escrita ilegível da mesma forma que um humano — inferindo caracteres ambíguos a partir do contexto.
Em meados de 2025, o GPT-5 e o Gemini 3 Pro levaram essa capacidade a um território de nível de produção. O benchmark de escrita cursiva de janeiro de 2026 da AIMultiple — um teste controlado com 100 amostras de escrita de 10 escritores — colocou GPT-5, Gemini 3 Pro Preview e olmOCR-2-7B no topo em similaridade semântica em texto cursivo, superando APIs de OCR dedicadas como Azure e Google Document AI (AIMultiple, janeiro de 2026). A principal descoberta não foi que os LLMs superam o OCR tradicional em escrita manual — isso era esperado. Foi o quanto eles superaram. Enquanto os mecanismos de OCR tradicionais retornavam 45–60% de precisão de palavras em cursiva mista, os sistemas baseados em VLM retornavam 80–90%.
Segundo, os mecanismos especializados de escrita manual amadureceram. Enquanto os LLMs estavam nas manchetes, ferramentas dedicadas de OCR de escrita manual alcançaram precisão de nível de produção em casos de uso específicos. O HandwritingOCR alcançou uma Taxa de Erro de Palavras de 0,9% (99,1% de precisão) em prosa inglesa manuscrita padrão em benchmarks independentes (handwritingocr.com, 2026). O ABBYY FineReader 16 atingiu 91,7% em cursiva e 95,2% em letra de forma manuscrita em uma comparação entre fornecedores. Esses não são os tipos de números que existiam em 2023.
Terceiro, a infraestrutura de mercado acompanhou. O mercado global de OCR/ICR atingiu US$ 13,95–16,26 bilhões em 2024 e deve chegar a US$ 42–46 bilhões até 2030–2033, crescendo a 13–17% CAGR (ArticSledge, 2026). Isso não é apenas "o mercado está crescendo" — significa que capital suficiente está fluindo para o setor, de modo que a curva de melhoria tecnológica de 2024–2026 parecerá lenta em comparação com o que está por vir em 2027–2028.
A consequência prática dessas três mudanças: o reconhecimento de escrita manual não é mais uma questão de "funciona ou não". É uma questão de "qual trilha tecnológica se encaixa nos seus documentos, nos seus requisitos de precisão e no seu formato de saída".
As Três Trilhas de Tecnologia — e Por Que Não São Intercambiáveis
Toda ferramenta de reconhecimento de escrita manual no mercado em 2026 se enquadra em uma de três trilhas de tecnologia. Elas diferem não apenas em precisão, mas no tipo de entrada que podem processar, no tipo de saída que produzem e se conseguem extrair dados estruturados. Escolha a trilha errada e a precisão que um fornecedor mostrou em uma demonstração não sobreviverá ao contato com seus próprios documentos.
Trilha 1: OCR Tradicional (Tesseract, ABBYY, APIs de Nuvem)
Como funciona: Correspondência de padrões caractere por caractere. O mecanismo compara cada região de pixel contra uma biblioteca de formatos de caracteres conhecidos e gera a correspondência mais próxima. Ele trata o texto como um problema de reconhecimento de padrões visuais — "como esta forma se parece?" — sem compreensão de linguagem, contexto ou significado.
No que é bom: Digitalizações limpas e de alta resolução de texto impresso em fontes padrão. Em digitalizações de 300 DPI de documentos impressos a laser, o OCR tradicional alcança 95–99% de precisão. O Azure Document Intelligence e o AWS Textract ambos atingem ~99% em formulários impressos limpos.
Onde falha: No momento em que a escrita manual entra em cena. O OCR tradicional assume que cada caractere ocupa uma caixa delimitadora separável. A escrita cursiva viola completamente essa suposição — as letras fluem umas nas outras sem limite claro. O mecanismo ou mescla várias letras em um único bloco (lendo "claro" como "caro") ou divide uma única letra entre caixas (lendo "m" como "rn").
Em produção: o Tesseract, o mecanismo de OCR de código aberto mais amplamente implantado, retorna 45–50% de precisão de palavras em escrita cursiva geral. O Azure Document Intelligence alcança ~95% em letras de forma nítidas, mas cai para ~45% em comentários narrativos cursivos. O Google Document AI atinge ~50% em seções de comentários manuscritos. Esses números vêm de benchmarks independentes e relatos de profissionais no r/computervision do Reddit, não de páginas de marketing de fornecedores.
Resumo: O OCR tradicional é para texto impresso. No momento em que seus documentos contêm escrita manual — qualquer escrita manual — você precisa de uma trilha diferente.
Trilha 2: ICR / HTR (Redes Neurais Específicas para Escrita Manual)
Como funciona: O Reconhecimento Inteligente de Caracteres (ICR) e o Reconhecimento de Texto Manuscrito (HTR) usam redes neurais convolucionais (CNNs) e redes neurais recorrentes (RNNs) treinadas especificamente em conjuntos de dados de texto manuscrito. Diferentemente da correspondência de padrões do OCR, essas redes aprendem as características subjacentes da escrita manual — padrões de traços, pontos de conexão, variações de letras — e podem generalizar entre escritores. O ICR normalmente lida com caracteres impressos à mão (letras de forma escritas separadamente), enquanto o HTR se estende à escrita cursiva e conectada. Algumas ferramentas combinam ambos no mesmo mecanismo.
No que é bom: Formulários estruturados com campos manuscritos, especialmente quando a caligrafia é razoavelmente clara em letras de forma. O ABBYY FineReader atinge 91,7% em cursiva e 95,2% em letras de forma manuscritas. O HandwritingOCR alcança 99,1% de precisão de palavras (0,9% WER) em prosa inglesa manuscrita de boa qualidade. O Transkribus, a plataforma acadêmica de HTR da Universidade de Innsbruck, permite treinar modelos personalizados na caligrafia de um único escritor em centenas de páginas — útil para arquivos históricos e coleções de um único autor.
Onde falha: O ICR/HTR ainda trata a escrita manual como um problema visual. Ele lê formas, não significados. Se um caractere for ambíguo — um "a" descuidado que parece um "o" — o mecanismo adivinha com base na semelhança visual, não no contexto. Um leitor humano sabe que "apples cost $5" é mais provável que "opples cost $5"; uma rede neural treinada apenas em formas de caracteres não sabe. É por isso que a precisão do ICR em cursiva e escrita confusa, embora melhor que a do OCR tradicional, ainda deixa uma lacuna significativa de erros.
Além disso, a maioria das ferramentas de ICR/HTR gera transcrição (texto simples), não extração estruturada (pares campo-valor em uma tabela). Ler o texto de um formulário manuscrito é uma coisa; colocar "Date", "Amount" e "Customer Name" em colunas separadas do Excel é outra — e a maioria das ferramentas de ICR não faz a segunda.
Resumo: O ICR/HTR é a trilha certa para transcrição de texto manuscrito — cartas históricas, entradas de diário, anotações livres. Para extrair dados estruturados de formulários manuscritos, você precisa de algo que una o reconhecimento visual à compreensão semântica.
Trilha 3: Extração Semântica com VLM/IA
Como funciona: Modelos de Visão e Linguagem (VLMs) como GPT-5, Gemini 3 Pro e Claude Sonnet processam documentos como imagens completas e entendem seu conteúdo semanticamente. Eles não comparam formatos de caracteres nem reconhecem padrões de traços — eles "leem" o documento como uma pessoa faz: olhando a página inteira, entendendo o que cada campo significa e extraindo informações pelo significado, não pela posição. Quando o modelo encontra um caractere manuscrito ambíguo, ele resolve a ambiguidade pelo contexto — exatamente como um leitor humano.
No que é bom: Tudo em uma única página, simultaneamente. Um VLM pode ler texto impresso, escrita cursiva e letras de forma no mesmo formulário em uma única passada. Ele pode identificar caixas de seleção (marcadas, circuladas, riscadas), localizar assinaturas e carimbos, e lidar com o documento real mais comum: um formulário impresso com entradas manuscritas nos campos em branco. O benchmark AIMultiple 2026 mostrou que sistemas baseados em VLM alcançam altas pontuações de similaridade semântica em texto cursivo que o OCR tradicional não conseguia processar de forma alguma.
Mais importante ainda, a extração baseada em VLM pode produzir saída estruturada. Você define quais colunas deseja — "Número da Fatura", "Data", "Valor Total", "Anotações Manuscritas" — e o modelo localiza cada valor em qualquer lugar da página entendendo o que ele significa, não onde está. Essa é a capacidade crítica que separa as duas primeiras trilhas da terceira: a capacidade de ir de "consigo ler esta página" para "aqui está sua planilha".
Onde falha: Três limitações honestas. Velocidade: A inferência de VLM é computacionalmente mais pesada que o OCR tradicional — o processamento leva de 5 a 10 segundos por página, em vez de menos de um segundo. Risco de alucinação: VLMs podem ocasionalmente inventar texto, especialmente em entradas extremamente degradadas ou ambíguas. Isso está melhorando (o GPT-5 alucina significativamente menos que o GPT-4V), mas não é zero — para uma estrutura de diagnóstico que cobre alucinação e os outros sete padrões comuns de falha, consulte nosso guia de modos de falha na extração de escrita manual. Custo: Os custos de API por página são mais altos que os do OCR tradicional — aproximadamente $0,01–0,05 por página vs $0,001–0,005. Se isso importa depende do custo de corrigir erros (veja a seção de custos abaixo).
Resumo: Esta é a trilha que torna a extração de dados de escrita manual prática em escala. Se seu objetivo é colocar dados manuscritos em uma planilha — não apenas transcrever texto manuscrito — esta é a arquitetura que você procura.
| Dimensão | OCR Tradicional | ICR / HTR | Semântico VLM/IA |
|---|---|---|---|
| Precisão de texto impresso | 95–99% | 90–95% | 95–99% |
| Precisão de letra de forma manuscrita | 70–85% | 85–95% | 85–93% |
| Precisão de cursiva | 15–45% | 75–91% | 75–90% |
| Impresso + manuscrito misturado | ❌ Quebra | ⚡ Parcial | ✅ Lê junto |
| Saída de dados estruturados | ❌ Somente texto | ❌ Principalmente texto | ✅ Excel/JSON |
| Compreensão contextual | ❌ Nenhuma | ❌ Limitada | ✅ Semântica |
| Custo por página | $0,001–0,005 | $0,005–0,02 | $0,01–0,05 |
| Treinamento necessário | Nenhum | Às vezes | Nenhum |
Verificação da Realidade da Precisão: O Que os Números Realmente Significam
Todo fornecedor de reconhecimento de escrita manual publica um número de precisão. Poucos explicam em que esse número foi medido, sob quais condições e o que o mesmo sistema entrega quando as condições não são ideais. Esta seção fornece os números que você realmente precisa, divididos por cenário.
O padrão que emerge de múltiplos benchmarks independentes em 2025–2026 é consistente. Em texto impresso, as três trilhas ficam na mesma faixa, separadas por apenas alguns pontos. Em escrita manual, elas se distanciam.
| Cenário do Documento | Traditional OCR | ICR/HTR | VLM/AI | Diferença no Mundo Real |
|---|---|---|---|---|
| Formulário impresso limpo (digitalização de 300 DPI) | 92–98% | 90–95% | 95–99% | Pequena |
| Letras de forma legíveis em caixas | 70–85% | 85–95% | 85–93% | Moderada |
| Rótulos impressos + cursiva mista no formulário | 45–60% | 65–85% | 80–90% | Grande |
| Texto narrativo totalmente cursivo | 15–30% | 75–91% | 75–88% | Enorme vs OCR |
| Foto de celular de documento manuscrito (iluminação ruim) | <20% | 40–60% | 65–80% | Enorme |
| Documento histórico (tinta desbotada, papel amarelado) | <15% | 50–70% | 60–80% | Enorme |
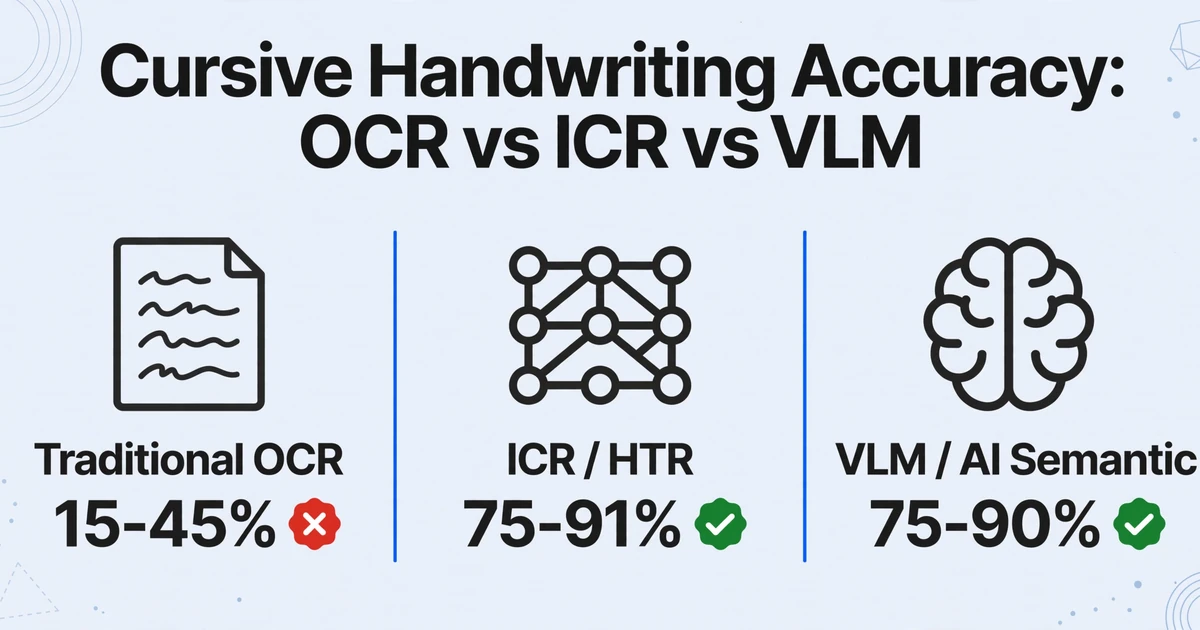
Fontes: AIMultiple 2026 Handwriting Recognition Benchmark, Suparse 2026 Best Handwriting OCR Tools Comparison, benchmark do handwritingocr.com, relatórios de produção do Reddit r/computervision. Todos os números representam medições independentes, não alegações de fornecedores.
Duas coisas se destacam nesta tabela. Primeiro, o padrão de degradação é assimétrico. O Traditional OCR despenca ao primeiro sinal de escrita manual, caindo dos baixos 90% em texto impresso para menos de um terço em cursiva. Isso não é um declínio gradual; é uma falha do sistema. Os VLMs também degradam, mas de forma mais suave, permanecendo em uma faixa utilizável desde texto impresso até fotos de campo.
Segundo, "precisão de reconhecimento de escrita manual" como um número único não tem significado. Uma ferramenta que atinge 95% em letras de forma legíveis em campos de formulário restritos pode atingir 45% nos comentários narrativos em cursiva no mesmo formulário. Se seus documentos contêm ambos (e a maioria dos documentos reais contém), a precisão combinada depende da mistura dos seus documentos, não do número principal do fornecedor.
A única maneira confiável de avaliar uma ferramenta é testá-la em seus documentos reais — não em amostras limpas fornecidas pelo fornecedor. Qualquer fornecedor que não permita que você teste em seus próprios arquivos deve ser tratado com ceticismo.
Transcrição vs. Extração: A Distinção Que a Maioria dos Guias Ignora
Transcrição e extração são tratadas como o mesmo trabalho. Não são, e a diferença decide se o seu projeto produz uma planilha ou um bloco de texto.
Transcrição é a etapa de conversão de texto manuscrito em texto digital. O resultado é um parágrafo ou um bloco de texto: "Paciente relata dor abdominal há três dias, nega náusea." Isso é transcrição. É útil para busca, arquivamento e leitura, mas não é útil para análise, contabilidade ou qualquer fluxo de trabalho que precise colocar dados em colunas.
Extração significa extrair pontos de dados específicos de um documento manuscrito para campos estruturados. O resultado é uma linha de tabela: Data = 2026-06-15, Valor = $342.50, Cliente = Acme Corp, Observações = "pedido urgente — entregar até sexta-feira." Isso é extração. É o que sua planilha, ERP ou sistema contábil realmente precisa.
A maioria das ferramentas de reconhecimento de escrita manual — incluindo quase todas as soluções tradicionais de OCR e ICR — só fazem transcrição. Elas fornecem um bloco de texto. Não dizem qual número é o total da fatura e qual é o valor do imposto. Essa etapa de separação — ler o documento e depois estruturar o que foi lido — é onde o trabalho humano tradicionalmente entra no fluxo, e é onde a maioria dos projetos de automação para.
As ferramentas que fazem extração, particularmente os sistemas baseados em VLM, preenchem essa lacuna lendo documentos de forma semântica. Você define as colunas que deseja, e a IA localiza cada valor na página compreendendo o que ele significa, não procurando texto em zonas predefinidas. Uma ferramenta que consegue extrair "Valor Total = $342.50" de uma fatura manuscrita não precisa saber onde na página esse número aparece. Ela precisa entender que "Valor Total" é um rótulo e "$342.50" é o valor associado a ele, mesmo que estejam separados por uma quebra de linha, uma seta manuscrita ou um estilo de escrita completamente diferente.
É isso que as pessoas querem dizer com Extração de Colunas Personalizadas. Você nomeia os campos uma vez, em palavras simples como "Número da Fatura", "Data" ou "Total", e essa mesma lista de colunas é aplicada a todos os documentos que você enviar, por mais diferentes que sejam os formulários. Não há modelo para criar para cada fornecedor e nada para retreinar quando um formulário muda, porque nada na configuração está vinculado a uma posição na página.
Se o seu fluxo de trabalho termina com dados indo para uma planilha, você precisa de extração, não de transcrição. Certifique-se de que a ferramenta que você está avaliando consegue fazer a segunda, não apenas a primeira.
A Equação do Custo Real: Por Que o Preço por Página é a Métrica Errada
A conversa sobre preços das ferramentas de reconhecimento de escrita manual sempre começa pelo custo por página. OCR tradicional: $0,001–0,005 por página. Baseado em VLM: $0,01–0,05 por página. Matemática simples: OCR é 5–10x mais barato. Caso encerrado.
Só que não é. O custo que importa não é o preço da extração por página — é o custo de produzir um resultado correto. E isso inclui o tempo e o trabalho gastos corrigindo erros.
A equação real é:
Custo Real = (Preço de Extração por Página × Número de Páginas) + (Tempo de Correção por Erro × Número de Erros × Taxa de Mão de Obra)
Quando a taxa de erro é baixa (texto impresso, OCR tradicional), o termo de correção é pequeno. Quando é alta (escrita manual cursiva, OCR tradicional), o termo de correção domina a equação completamente.
Vamos tornar isso concreto. Uma empresa de construção processa 100 relatórios diários manuscritos por semana. Cada relatório contém cerca de 25 campos de dados — datas, horas trabalhadas, materiais usados, horas de equipamento, anotações do encarregado. Isso dá 2.500 campos por semana, 130.000 campos por ano.
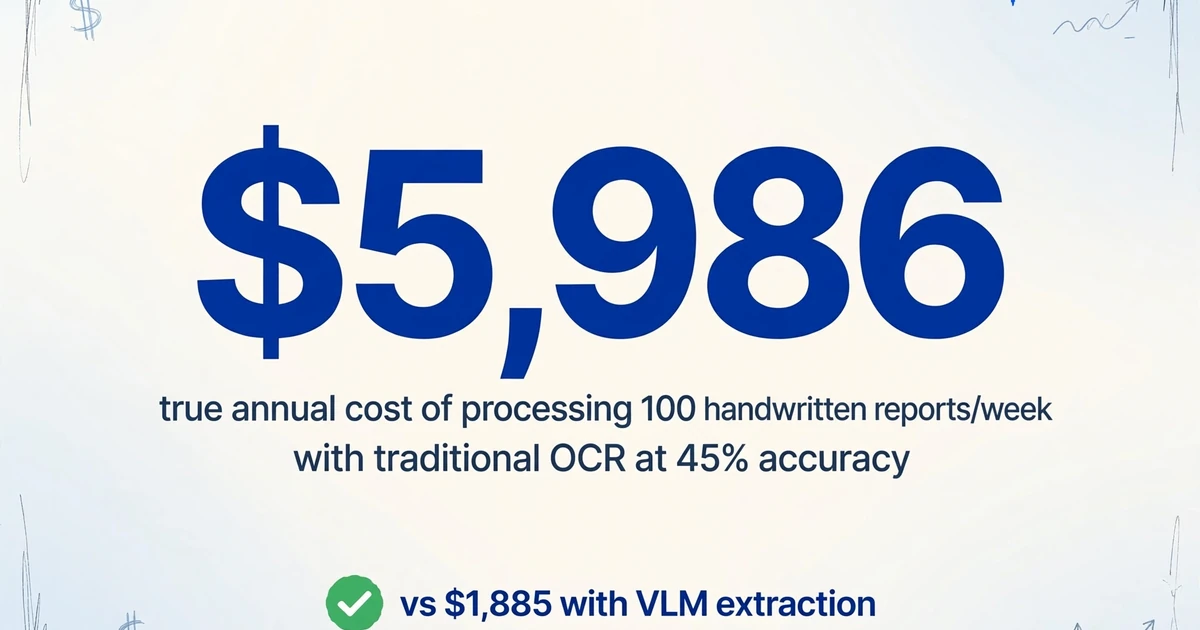
Com OCR tradicional (45% de precisão em anotações cursivas): 71.500 campos precisam de correção manual por ano. A 15 segundos por correção, são 298 horas de trabalho manual — cerca de $5.960 por ano a $20/hora. O custo por página do OCR é insignificante (~$26/ano). Custo anual real: ~$5.986.
Com extração baseada em VLM (85% de precisão em cursiva): 19.500 campos precisam de correção manual por ano. A 15 segundos por correção, são 81 horas — cerca de $1.625 por ano. O custo por página do VLM é maior (~$260/ano). Custo anual real: ~$1.885.
A abordagem VLM custa 3x mais por página — e 3x menos no total quando você inclui o trabalho de correção. Essa matemática vale para qualquer tipo de documento em que a escrita manual seja uma parte significativa do conteúdo. Um usuário do Reddit que processou mais de 150.000 páginas em produção confirmou esse padrão: "As plataformas tradicionais de OCR parecem econômicas (~$0,001–0,005 por página), mas sua baixa precisão em escrita manual (~45–50%) as torna inutilizáveis para fluxos de trabalho empresariais com conteúdo manuscrito significativo. O tempo gasto corrigindo erros manualmente torna o custo real muito maior do que soluções especializadas" (r/computervision, 2025).
A comparação de custo por página é uma armadilha. O único custo que importa é o custo por resultado correto. Quando a escrita manual representa uma parcela significativa do conteúdo, a extração baseada em VLM tende a ser mais barata no total, muitas vezes dramaticamente, quando você inclui o trabalho humano de correção que o OCR tradicional exige.
Aplicação por Aplicação: Qual Trilha se Adequa aos Seus Documentos
Nenhuma trilha de tecnologia é categoricamente melhor; a certa depende dos seus documentos. O que se encaixa onde, com base em implantações reais e dados de benchmark:
Prontuários Médicos e Notas Clínicas
A caligrafia médica é notoriamente ruim, e uma grande parcela da documentação clínica ainda começa em papel ou em arquivos digitalizados. Os riscos são altos: um nome de medicamento ou dosagem lido incorretamente é um evento de segurança do paciente, e a conformidade com a HIPAA exige precisão auditável. Um estudo de 2025 sobre digitalização de registros clínicos manuscritos descobriu que "os sistemas de OCR de propósito geral são atualmente insuficientes para extração confiável de dados clínicos" devido à "complexidade e variabilidade dos prontuários médicos manuscritos" (SciTePress, 2025).
Trilha recomendada: Extração semântica baseada em VLM, com etapa de revisão humana para campos críticos (nomes de medicamentos, dosagens, diagnósticos). Na Omega Healthcare, o processamento de documentos assistido por IA reduziu o tempo de documentação em 40% e economizou mais de 15.000 horas de funcionários por mês com 99,5% de precisão no processo (Business Insider, 2025). A arquitetura que torna isso possível é a extração por IA com um limite de confiança: campos acima do limite passam direto; campos abaixo dele sinalizam para revisão humana.
O que observar: Conformidade com a HIPAA. Se você estiver usando um VLM baseado em nuvem, confirme o BAA (Business Associate Agreement) do fornecedor e as práticas de tratamento de dados. A implantação local pode ser necessária para certas instituições.
Relatórios Diários de Construção e Registros de Campo
Encarregados de construção preenchem relatórios diários à mão — muitas vezes no local, com mau tempo, com uma caneta ficando sem tinta. Esses relatórios contêm observações de segurança, horas de trabalho, uso de equipamentos, entregas de materiais e notas de incidentes. Eles são legalmente significativos (requisitos de folha de pagamento certificada Davis-Bacon nos EUA exigem manutenção de registros específica) e operacionalmente críticos (faturamento atrasado significa fluxo de caixa atrasado).
Trilha recomendada: Extração baseada em VLM com processamento em lote. Uma empresa de construção típica processa de 20 a 100 relatórios diários por semana, cada um de encarregados diferentes com caligrafias diferentes. A capacidade de processamento em lote — enviar todos os relatórios de uma vez e obter uma única planilha consolidada — é a diferença operacional entre uma ferramenta que você realmente usará e uma que fica parada em um vídeo de treinamento.
O que observar: Conteúdo misto. Os formulários de construção quase sempre misturam rótulos impressos ("Data", "Nº do Trabalho", "Encarregado") com entradas manuscritas. O OCR tradicional falha com essa mistura. Certifique-se de que a abordagem escolhida lide com ambos em uma única passada.
Documentos Históricos e Arquivos
Bibliotecas, agências governamentais e organizações genealógicas estão digitalizando séculos de registros manuscritos — certidões de nascimento, registros de casamento, formulários de censo, registros de serviço militar. A Wilson Library da Universidade da Carolina do Norte usa HTR assistido por IA com validação humana colaborativa para transcrever documentos legais manuscritos da era Jim Crow. Arquivos governamentais seguiram o mesmo caminho, digitalizando registros civis com mais de um século e aplicando HTR sobre eles, com revisores humanos resolvendo as entradas que o modelo não consegue ler com confiança.
Trilha recomendada: HTR com treinamento de modelo personalizado + revisão humana. Quando você lida com a caligrafia de um único escritor em centenas de páginas (o registro de um único pároco, os livros de um funcionário específico), modelos HTR treinados sob medida (como o Transkribus) podem atingir níveis de precisão que modelos de uso geral não alcançam. Para coleções com muitos escritores diferentes, a extração baseada em VLM oferece uma base sólida sem treinamento, mas a revisão humana continua essencial — a avaliação de 2026 da UVA Library sobre transcrição por IA em documentos de fontes primárias concluiu que "estas foram algumas de nossas fontes primárias mais complicadas: cartas manuscritas, livros contábeis complexos, documentos com escrita cruzada" e que a precisão da IA variava drasticamente conforme o tipo e a condição do documento.
O que observar: Qualidade da imagem. Tinta desbotada, papel amarelado, vazamento do verso e escritas não padronizadas (Fraktur, Sütterlin, escrita secretarial) afetam drasticamente a precisão. O pré-processamento — endireitamento, realce de contraste, limpeza de fundo — muitas vezes é tão importante quanto o próprio mecanismo de reconhecimento.
Finanças e Contabilidade: Livros Contábeis e Recibos Manuscritos
Pequenas empresas, restaurantes e operações de serviço de campo ainda geram recibos manuscritos, confirmações de entrega e lançamentos contábeis manuais. Um restaurante recebe faturas de fornecedores com quantidades e preços manuscritos nas margens. Um motorista de entrega coleta comprovantes de entrega manuscritos. Um mecânico escreve os detalhes do reparo em uma ordem de serviço em papel. A entrada manual desses dados custa entre US$ 15 e US$ 40 por documento, considerando mão de obra, correção de erros e custos administrativos (Constrafor, 2025).
Trilha recomendada: Extração estruturada baseada em VLM. Os resultados precisam ser integrados a softwares contábeis (QuickBooks, Xero, Sage), o que significa que a extração deve produzir dados estruturados — não apenas texto transcrito. A capacidade de definir colunas de saída uma vez e processar vários documentos manuscritos contra o mesmo esquema é o que transforma a extração de escrita manual de uma curiosidade em uma redução de custos operacionais.
O que observar: Valores calculados. Um recibo manuscrito pode mostrar "Qtd: 3, Unit: US$ 12,50, Total: US$ 37,50." Se a IA extrair os três, isso é bom — mas se o total manuscrito contiver um erro aritmético, a extração sem validação propaga o erro. Os melhores pipelines de extração permitem definir colunas calculadas (ex.: "Total da Linha = Qtd × Preço Unitário") que a IA calcula durante a extração, fornecendo uma verificação cruzada contra o total manuscrito.
Logística e Serviço de Campo
Motoristas de entrega preenchem formulários manuscritos de entrega com assinaturas, carimbos de data/hora e notas de exceção ("deixado na porta dos fundos"). Técnicos de campo preenchem relatórios de inspeção manuscritos com caixas de seleção e comentários narrativos. Avaliadores de seguros escrevem avaliações de sinistros manuscritas em locais de acidente. Esses documentos são gerados em campo, frequentemente em formulários com cópia carbono, e precisam entrar rapidamente nos sistemas do back-office.
Trilha recomendada: Extração baseada em VLM com upload móvel. A capacidade de fotografar um formulário manuscrito com um celular — sem digitalização, sem correção de inclinação — e obter dados estruturados de volta é o avanço operacional para equipes de campo. Benchmarks independentes mostram sistemas baseados em VLM alcançando 65–80% de precisão em fotos de celular de documentos manuscritos (versus <20% para OCR tradicional), tornando fluxos de trabalho mobile-first práticos pela primeira vez.
O que observar: Detecção de caixas de seleção e assinaturas. Formulários de campo frequentemente combinam texto manuscrito com caixas marcadas, opções circuladas e assinaturas. Se o sistema de extração não conseguir identificar qual caixa foi marcada ou se um campo de assinatura está presente, você ainda estará fazendo revisão manual parcial.
Como Avaliar uma Ferramenta de Extração de Escrita Manual: 6 Dimensões
A maioria dos frameworks de avaliação para ferramentas de extração de documentos foi escrita para texto impresso. A escrita manual muda os critérios de avaliação. Aqui está o que realmente importa.
Precisão em seus documentos, não em exemplos do fornecedor
Qualquer fornecedor pode selecionar exemplos limpos. Exija testar em seus documentos reais — os desordenados, os manuscritos, os tirados com um telefone com pouca luz. Se o fornecedor não permitir testar em seus próprios arquivos, vá a outro lugar.
Saída estruturada, não apenas transcrição
A ferramenta produz uma planilha com colunas que você definiu, ou produz um bloco de texto que você precisa analizar depois? A primeira substituye a entrada de dados; a segunda substituye a transcrição, mas deixa a entrada de dados intacta.
Manipulação de conteúdo misto
A maioria dos documentos reais combina etiquetas impressas com entradas manuscritas. A ferramenta consegue ler ambos em uma única passada, ou exige etapas de processamento separadas para texto impresso e escrita manual? A segunda opção adiciona complexidade ao processo que prejudica a adoção.
Capacidade de processamento em lote
Processar um documento manuscrito é uma demonstração. Processar 50 de uma vez e obter uma única planilha consolidada é um fluxo de trabalho. A capacidade de lote — enviar vários arquivos, processar com as mesmas definições de columna, obter uma tabela de saída — é o que separa a avaliação da adoção.
Sem treinamento ou configuração necessária
Se a ferramenta exige que você colete exemplos de escrita manual, anote campos ou treine um modelo antes de funcionar, pergunte quanto tempo isso leva e se é sustentable à medida que suas fontes de documentos mudam. Algumas ferramentas (Nanonets, alguns motores ICR) exigem 10+ exemplos anotados por tipo de documento. Ferramentas sem modelo que funcionam desde o primeiro uso omitem esta etapa por completo.
Custo total, não custo por página
Calcule a equação completa: custo de extração + trabalho de correção à sua taxa de erro real. Uma ferramenta de $0.001/página que precisa de 30% de correção manual custa mais que uma de $0.03/página que precisa de 5% de correção. Faça as contas com seus volumes antes de comparar preços.
FAQ: Perguntas reais sobre reconhecimento de escrita manual
A IA consegue lidar com letra cursiva e letra de forma na mesma página?
Sim — e é exatamente aqui que os sistemas baseados em VLM superam o OCR tradicional e o ICR. Uma página com cabeçalhos impressos, texto corrido em cursiva e anotações marginais em letra de forma é lida em uma única passada por um VLM, porque o modelo lê semanticamente (compreendendo o significado) em vez de tentar corresponder formatos de caracteres. O OCR tradicional e o ICR tratam texto impresso e cursivo como tarefas de reconhecimento separadas que exigem mecanismos diferentes. Para um aprofundamento sobre essa capacidade, veja nossa comparação direta entre reconhecimento de escrita manual por IA e OCR tradicional.
Qual precisão posso realmente esperar em escrita cursiva?
Em cursiva limpa e legível digitalizada a 300 DPI: 85–91% com ferramentas especializadas de ICR/HTR, 75–90% com extração baseada em VLM. Em cursiva bagunçada e apressada: espere 65–80% das melhores ferramentas. Em cursiva em fotos de celular de baixa qualidade: 60–75%. Nenhuma ferramenta atinge 99% em cursiva em condições reais — quem afirma o contrário está medindo em amostras selecionadas. A abordagem prática é usar extração para campos estruturados (onde a IA tem melhor desempenho) e reservar revisão humana para seções de texto narrativo onde a precisão é crítica.
O reconhecimento de escrita manual funciona em documentos históricos com tinta desbotada?
Sim, mas o fluxo de trabalho importa mais do que o mecanismo de reconhecimento. O sucesso com documentos históricos depende de: (1) digitalização em alta resolução (600 DPI recomendado, não 300), (2) pré-processamento — realce de contraste, correção de inclinação, remoção de ruído de fundo, (3) escolha do mecanismo de reconhecimento — HTR com treinamento personalizado em escritas semelhantes se a coleção tiver caligrafia consistente, extração baseada em VLM se houver muitos escritores diferentes. Projetos de digitalização governamentais e acadêmicos relatam consistentemente que a revisão humana no processo é essencial para documentos históricos — a IA faz a maior parte do trabalho, humanos verificam campos críticos. A avaliação de 2026 da UVA Library descobriu que "a precisão da IA variou drasticamente por tipo e condição do documento", confirmando que documentos históricos continuam sendo a categoria mais difícil.
Preciso treinar a IA com a minha caligrafia?
Para extração baseada em VLM: não. Esses sistemas são projetados para funcionar no primeiro uso com qualquer estilo de caligrafia — eles leem semanticamente, não por correspondência com amostras de treinamento. Para ferramentas de ICR/HTR: às vezes. Ferramentas como Transkribus permitem treinamento de modelo personalizado, o que pode aumentar a precisão se você tiver centenas de páginas de um único escritor. Para OCR tradicional: não, porque treinar não vai ajudar — esses mecanismos não conseguem lidar com escrita manual de qualquer forma. A compensação é que modelos HTR treinados sob medida podem alcançar maior precisão em um escritor específico, mas exigem esforço de treinamento inicial, enquanto sistemas baseados em VLM funcionam imediatamente com qualquer escritor, mas atingem no máximo ~90% em cursiva. Escolha com base em se você está processando um estilo de caligrafia consistente em escala ou muitos estilos diferentes.
A IA consegue extrair dados de formulários manuscritos para Excel — ou apenas converter escrita manual em texto?
Isto depende inteiramente da ferramenta. A maioria das ferramentas de OCR para escrita manual só produz texto — transcribem um formulário manuscrito, mas não separam "Data: 15 de junho" em uma coluna Data e "Montante: $342" em uma coluna Montante. As ferramentas de extração baseadas em VLM (como ImageToTable.ai) são especificamente concebidas para produzir resultados estruturados em planilha. Você define as colunas que deseja — "Data", "Montante", "Nome do Cliente", "Notas" — e a IA extrae os valores correspondentes de cada documento nessas colunas, produzindo uma tabela onde cada linha é um documento e cada columna é um campo. Isto é extração, não transcrição — e é a capacidade que torna a automatização de dados manuscritos prática para fluxos de trabalho de contabilidade, logística e operações. Para o guía prático, consulte como extraer dados manuscritos diretamente para Excel.
O OCR gratuito (Tesseract, Google Keep) é suficientemente bom para escrita manual?
Para uso rápido e não crítico — capturar uma lista de compras ou uma nota curta — as ferramentas gratuitas funcionam adequadamente em letras de imprensa claras. Para qualquer aplicação empresarial que envolva cursiva, escrita desordenada, ou onde a precisão importa: não. Tesseract alcanza ~45% de precisão de palavras em cursiva. Google Keep lida com escrita de imprensa clara muito melhor que com cursiva. A diferença entre ferramentas gratuitas e soluções pagas é maior no reconhecimento de escrita manual que em qualquer outra categoria de OCR, porque os modelos de IA específicos para escrita manual requerem dados de treinamento e computação substancials que as ferramentas gratuitas não podem fornecer economicamente. Se seu caso de uso é "preciso encontrar uma palavra nas minhas notas manuscritas", as ferramentas gratuitas podem ser suficientes. Se é "preciso extraer 50 campos de 100 formulários manuscritos numa planilha com <5% de taxa de erro", você precisa de uma solução paga.
O Que Vem a Seguir: O Horizonte 2027–2028
A transformação de 2023–2026 no reconhecimento de escrita manual foi impulsionada por LLMs aprendendo a ler semanticamente. A próxima mudança — já visível em pesquisas, mas ainda não em ferramentas de produção — será impulsionada por três desenvolvimentos:
Modelos multimodais que extraem, validam e raciocinam em uma única passada. As ferramentas atuais separam a extração ("o que esta página diz?") da validação ("isso faz sentido?"). Modelos emergentes farão ambos simultaneamente — extraindo itens de linha de faturas enquanto verificam se a soma dos totais das linhas é igual ao total do cabeçalho, sinalizando discrepâncias sem uma etapa de validação separada. Isso colapsa o pipeline de extração mais revisão em uma única etapa para documentos rotineiros.
Reconhecimento de escrita manual explicável para indústrias regulamentadas. Usuários de saúde, jurídico e governo precisam saber por que a IA leu um determinado campo como "$500" e não "$600" — especialmente quando a escrita é ambígua. A pesquisa em IA explicável para processamento de documentos está avançando, com a pontuação de confiança no nível do caractere (em vez do nível do documento) se aproximando do uso em produção. Isso tornará a extração por IA auditável o suficiente para fluxos de conformidade que atualmente exigem 100% de revisão humana.
Processamento no dispositivo para uso em campo. Executar o reconhecimento de escrita manual localmente em um telefone — sem upload para a nuvem, sem necessidade de conectividade, resultados instantâneos — é tecnicamente viável com modelos quantizados menores. A troca entre precisão e velocidade/latência está diminuindo. Para equipes de serviço de campo, construção e logística que precisam de resultados de extração antes de sair do local de trabalho, o processamento no dispositivo desbloqueará fluxos de trabalho que ferramentas dependentes da nuvem não podem suportar.
A direção é clara: o reconhecimento de escrita manual está se tornando um problema resolvido para extração estruturada de tipos de documentos comuns, e está se aproximando do território "bom o suficiente com revisão" para as categorias mais difíceis (documentos históricos, entradas severamente degradadas). O ciclo de investimento em tecnologia ainda está em sua fase inicial de aceleração. As ferramentas disponíveis em 2028 farão as melhores ferramentas de hoje parecerem o que o Tesseract parece para nós agora.
O ponto principal para quem avalia extração de escrita manual em 2026:
Não deixe que decepções passadas com OCR tradicional moldem suas expectativas sobre o que é possível agora. As três trilhas tecnológicas — OCR tradicional, ICR/HTR e extração semântica baseada em VLM — são abordagens fundamentalmente diferentes, com tetos de precisão diferentes, formatos de saída diferentes e perfis de custo diferentes. A trilha certa depende dos seus documentos. A trilha errada — que quase sempre é o OCR tradicional para qualquer documento com escrita manual — custa mais do que a certa, tanto em dinheiro quanto em tempo. Teste com seus documentos reais, calcule o custo total incluindo o trabalho de correção e certifique-se de que a ferramenta escolhida produz saída estruturada, não apenas texto transcrito.
Envie um documento manuscrito — digite as colunas que você precisa — receba uma planilha estruturada em segundos. Sem treinamento, sem modelos.