IA de l'écriture manuscrite au texte :
Le guide complet 2026 de ce qui fonctionne
En 2023, si vous demandiez si l'IA pouvait convertir de manière fiable l'écriture manuscrite en texte, la réponse honnête était « en quelque sorte : si l'écriture est soignée, si c'est en lettres majuscules, si la numérisation est propre, et si cela ne vous dérange pas de corriger une grande partie de ce qu'elle lit. » Trois ans plus tard, cette réponse a changé. La reconnaissance d'écriture manuscrite par l'IA s'est suffisamment améliorée entre fin 2024 et mi-2025 pour que la plupart des gens n'aient pas encore pris la mesure de ces progrès : la technologie fonctionne désormais réellement, mais seulement si vous choisissez la bonne approche pour vos documents spécifiques. Ce guide cartographie le paysage tel qu'il est réellement en 2026, et non tel que les fournisseurs veulent vous le faire croire.
Ce qui a réellement changé dans la reconnaissance d'écriture manuscrite depuis 2023
Trois choses se sont produites, et elles sont arrivées si vite que la plupart des idées reçues sur la reconnaissance d'écriture manuscrite ont deux ans de retard.
Premièrement, la percée des LLM. Lorsque GPT-4V est sorti fin 2023, c'était la première fois qu'un modèle d'IA polyvalent pouvait lire l'écriture cursive avec une certaine fiabilité. Ce n'était pas parfait — les taux d'hallucination étaient élevés et il ne pouvait pas produire de données structurées. Mais cela a prouvé quelque chose de fondamental : la reconnaissance d'écriture manuscrite n'a pas besoin d'être un problème de correspondance de caractères. Un modèle qui comprend le langage sémantiquement peut lire une écriture manuscrite brouillonne comme le ferait un humain — en déduisant les caractères ambigus à partir du contexte.
D'ici mi-2025, GPT-5 et Gemini 3 Pro avaient propulsé cette capacité dans le domaine de la qualité production. Le benchmark d'écriture cursive d'AIMultiple de janvier 2026 — un test contrôlé avec 100 échantillons d'écriture manuscrite provenant de 10 rédacteurs — a placé GPT-5, Gemini 3 Pro Preview et olmOCR-2-7B en tête pour la similarité sémantique sur texte cursif, surpassant les API OCR dédiées comme Azure et Google Document AI (AIMultiple, janvier 2026). Le constat clé n'était pas que les LLM battaient l'OCR traditionnel sur l'écriture manuscrite — c'était attendu. C'était à quel point ils les battaient. Là où les moteurs OCR traditionnels obtenaient une précision de 45 à 60 % sur la cursive mixte, les systèmes basés sur VLM atteignaient 80 à 90 %.
Deuxièmement, les moteurs spécialisés en écriture manuscrite ont mûri. Pendant que les LLM faisaient la une, les outils OCR dédiés à l'écriture manuscrite ont atteint une précision de qualité production sur des cas d'usage spécifiques. HandwritingOCR a obtenu un taux d'erreur de mots de 0,9 % (précision de 99,1 %) sur des textes anglais manuscrits standard dans des benchmarks indépendants (handwritingocr.com, 2026). ABBYY FineReader 16 a atteint 91,7 % sur la cursive et 95,2 % sur l'écriture manuscrite imprimée dans une comparaison multi-fournisseurs. Ce ne sont pas le genre de chiffres qui existaient en 2023.
Troisièmement, l'infrastructure du marché a rattrapé son retard. Le marché mondial de l'OCR/ICR a atteint 13,95 à 16,26 milliards de dollars en 2024 et devrait atteindre 42 à 46 milliards de dollars d'ici 2030-2033, avec une croissance de 13 à 17 % en TCAC (ArticSledge, 2026). Ce n'est pas juste « le marché est en croissance » — cela signifie que suffisamment de capitaux affluent dans ce secteur pour que la courbe d'amélioration technologique de 2024 à 2026 paraisse lente par rapport à ce qui arrive en 2027-2028.
La conséquence pratique de ces trois évolutions : la reconnaissance d'écriture manuscrite n'est plus une question de « est-ce que ça fonctionne du tout ». C'est une question de « quelle piste technologique correspond à vos documents, à vos exigences de précision et à votre format de sortie ».
Les trois pistes technologiques — et pourquoi elles ne sont pas interchangeables
Chaque outil de reconnaissance d'écriture manuscrite sur le marché en 2026 relève de l'une de ces trois pistes technologiques. Elles diffèrent non seulement en termes de précision, mais aussi par le type d'entrée qu'elles peuvent traiter, le type de sortie qu'elles produisent, et leur capacité à extraire des données structurées. Choisissez la mauvaise piste et la précision qu'un vendeur vous a montrée lors d'une démonstration ne survivra pas au contact avec vos propres documents.
Piste 1 : OCR traditionnel (Tesseract, ABBYY, API cloud)
Comment cela fonctionne : Correspondance de motifs caractère par caractère. Le moteur compare chaque région de pixels à une bibliothèque de formes de caractères connues et renvoie la correspondance la plus proche. Il traite le texte comme un problème de reconnaissance de motifs visuels — « à quoi ressemble cette forme ? » — sans compréhension du langage, du contexte ou du sens.
Ce qu'il fait bien : Des scans propres et haute résolution de texte imprimé dans des polices standard. Sur des scans à 300 DPI de documents laser, l'OCR traditionnel atteint une précision de 95 à 99 %. Azure Document Intelligence et AWS Textract atteignent tous deux ~99 % sur des formulaires imprimés propres.
Où il échoue : Dès que l'écriture manuscrite entre en jeu. L'OCR traditionnel suppose que chaque caractère occupe une boîte englobante séparable. L'écriture cursive viole entièrement cette hypothèse — les lettres se fondent les unes dans les autres sans frontière nette. Le moteur fusionne soit plusieurs lettres en un seul bloc (lisant « clear » comme « dear »), soit divise une seule lettre entre plusieurs boîtes (lisant « m » comme « rn »).
En production : Tesseract, le moteur OCR open source le plus déployé, renvoie une précision de 45 à 50 % sur l'écriture cursive générale. Azure Document Intelligence atteint ~95 % sur une écriture en lettres détachées soignée, mais chute à ~45 % sur les commentaires narratifs en cursive. Google Document AI atteint ~50 % sur les sections de commentaires manuscrits. Ces chiffres proviennent de benchmarks indépendants et de rapports de praticiens sur le subreddit r/computervision, et non de pages marketing de fournisseurs.
En résumé : L'OCR traditionnel est destiné au texte imprimé. Dès que vos documents contiennent de l'écriture manuscrite — quelle qu'elle soit — vous avez besoin d'une autre piste.
Piste 2 : ICR / HTR (réseaux neuronaux spécialisés dans l'écriture manuscrite)
Comment ça fonctionne : La reconnaissance intelligente de caractères (ICR) et la reconnaissance de texte manuscrit (HTR) utilisent des réseaux neuronaux convolutifs (CNN) et des réseaux neuronaux récurrents (RNN) entraînés spécifiquement sur des ensembles de données de texte manuscrit. Contrairement à la correspondance de motifs de l'OCR, ces réseaux apprennent les caractéristiques sous-jacentes de l'écriture manuscrite — les schémas de tracé, les points de liaison, les variations de lettres — et peuvent généraliser d'un scripteur à l'autre. L'ICR gère généralement les caractères imprimés à la main (lettres majuscules écrites séparément), tandis que la HTR s'étend à l'écriture cursive et liée. Certains outils combinent les deux dans un même moteur.
Ses points forts : Les formulaires structurés avec des champs manuscrits, surtout lorsque l'écriture est raisonnablement claire en lettres majuscules. ABBYY FineReader atteint 91,7 % sur l'écriture cursive et 95,2 % sur les caractères imprimés manuscrits. HandwritingOCR atteint 99,1 % de précision au niveau du mot (0,9 % WER) sur de la prose anglaise manuscrite de bonne qualité. Transkribus, la plateforme HTR académique de l'Université d'Innsbruck, permet d'entraîner des modèles personnalisés sur l'écriture d'un seul scripteur à travers des centaines de pages — utile pour les archives historiques et les collections d'un seul auteur.
Ses limites : L'ICR/HTR traite encore l'écriture manuscrite comme un problème visuel. Elle lit des formes, pas du sens. Si un caractère est ambigu — un « a » bâclé qui ressemble à un « o » — le moteur devine en se basant sur la similarité visuelle, pas sur le contexte. Un lecteur humain sait que « les pommes coûtent 5 $ » est plus probable que « les opples coûtent 5 $ » ; un réseau neuronal entraîné uniquement sur les formes de caractères ne le sait pas. C'est pourquoi la précision de l'ICR sur l'écriture cursive et désordonnée, bien que meilleure que celle de l'OCR traditionnel, laisse encore un écart d'erreur significatif.
De plus, la plupart des outils ICR/HTR produisent une transcription (texte brut), pas une extraction structurée (paires champ-valeur dans un tableau). Lire le texte d'un formulaire manuscrit est une chose ; extraire la « Date », le « Montant » et le « Nom du client » dans des colonnes Excel séparées en est une autre — et la plupart des outils ICR ne font pas la seconde.
En résumé : L'ICR/HTR est la bonne piste pour la transcription de texte manuscrit — lettres historiques, journaux intimes, notes libres. Pour extraire des données structurées de formulaires manuscrits, vous avez besoin de quelque chose qui fait le pont entre la reconnaissance visuelle et la compréhension sémantique.
Piste 3 : Extraction sémantique par VLM/IA
Comment ça fonctionne : Les modèles de vision-langage (VLM) comme GPT-5, Gemini 3 Pro et Claude Sonnet traitent les documents comme des images complètes et en comprennent le contenu sémantiquement. Ils ne comparent pas des formes de caractères ni ne reconnaissent des motifs de tracé — ils « lisent » le document comme le ferait une personne : en regardant la page entière, en comprenant ce que chaque champ signifie, et en extrayant l'information par le sens plutôt que par la position. Lorsque le modèle rencontre un caractère manuscrit ambigu, il résout l'ambiguïté grâce au contexte — tout comme un lecteur humain.
Ses points forts : Tout sur une seule page, simultanément. Un VLM peut lire le texte imprimé, l'écriture cursive et les lettres majuscules sur le même formulaire en une seule passe. Il peut identifier les cases à cocher (cochées, entourées, barrées), localiser les signatures et les tampons, et gérer le document réel courant : un formulaire imprimé avec des entrées manuscrites dans les champs vides. Le benchmark AIMultiple 2026 a montré que les systèmes basés sur VLM atteignent des scores de similarité sémantique élevés sur du texte cursif que l'OCR traditionnel ne pouvait pas traiter du tout.
Plus important encore, l'extraction basée sur VLM peut produire une sortie structurée. Vous définissez les colonnes souhaitées — « Numéro de facture », « Date », « Montant total », « Notes manuscrites » — et le modèle localise chaque valeur n'importe où sur la page en comprenant ce qu'elle signifie, et non où elle se trouve. C'est la capacité essentielle qui distingue les deux premières pistes de la troisième : la capacité de passer de « je peux lire cette page » à « voici votre feuille de calcul ».
Ses limites : Trois limitations honnêtes. Vitesse : L'inférence VLM est plus lourde en calcul que l'OCR traditionnel — le traitement prend 5 à 10 secondes par page plutôt que moins d'une seconde. Risque d'hallucination : Les VLM peuvent parfois inventer du texte, surtout sur des entrées extrêmement dégradées ou ambiguës. Cela s'améliore (GPT-5 hallucine nettement moins que GPT-4V), mais ce n'est pas nul — pour un cadre de diagnostic couvrant l'hallucination et les sept autres modes de défaillance courants, consultez notre guide sur les modes de défaillance de l'extraction d'écriture manuscrite. Coût : Les coûts d'API par page sont plus élevés que l'OCR traditionnel — environ 0,01 à 0,05 $ par page contre 0,001 à 0,005 $. L'importance de ce facteur dépend du coût de correction des erreurs (voir la section sur les coûts ci-dessous).
En résumé : C'est la piste qui rend l'extraction de données manuscrites pratique à grande échelle. Si votre objectif est d'obtenir des données manuscrites dans une feuille de calcul — et pas seulement de transcrire du texte manuscrit — c'est l'architecture qu'il vous faut.
| Dimension | OCR traditionnel | ICR / HTR | Sémantique VLM/IA |
|---|---|---|---|
| Précision du texte imprimé | 95–99 % | 90–95 % | 95–99 % |
| Précision de l'écriture manuscrite en capitales | 70–85 % | 85–95 % | 85–93 % |
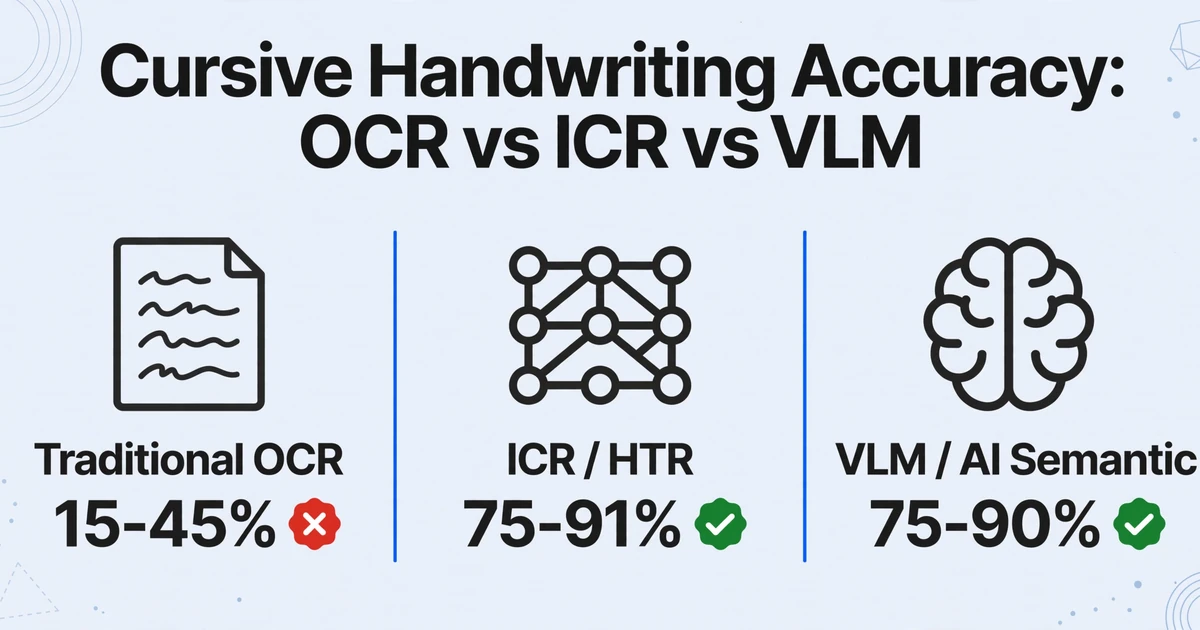
| Précision de l'écriture cursive | 15–45 % | 75–91 % | 75–90 % |
| Imprimé + manuscrit mélangés | ❌ Échoue | ⚡ Partiel | ✅ Lit l'ensemble |
| Sortie de données structurées | ❌ Texte uniquement | ❌ Surtout du texte | ✅ Excel/JSON |
| Compréhension contextuelle | ❌ Aucune | ❌ Limitée | ✅ Sémantique |
| Coût par page | 0,001–0,005 $ | 0,005–0,02 $ | 0,01–0,05 $ |
| Formation requise | Aucune | Parfois | Aucune |
Vérification de la précision : ce que les chiffres signifient réellement
Chaque fournisseur de reconnaissance d'écriture manuscrite publie un chiffre de précision. Peu expliquent sur quoi ce chiffre a été mesuré, dans quelles conditions, et ce que le même système offre lorsque les conditions ne sont pas idéales. Cette section vous donne les chiffres dont vous avez réellement besoin, répartis par scénario.
Le schéma qui ressort de plusieurs benchmarks indépendants en 2025–2026 est cohérent. Sur texte imprimé, les trois pistes se situent dans la même plage, séparées de seulement quelques points. Sur l'écriture manuscrite, elles se démarquent nettement.
| Scénario de document | OCR traditionnel | ICR/HTR | VLM/AI | Écart réel |
|---|---|---|---|---|
| Formulaire imprimé propre (scan 300 DPI) | 92–98% | 90–95% | 95–99% | Faible |
| Écriture manuscrite en lettres capitales soignées dans des cases | 70–85% | 85–95% | 85–93% | Modéré |
| Mélange de cursive + étiquettes imprimées sur formulaire | 45–60% | 65–85% | 80–90% | Important |
| Texte narratif entièrement en cursive | 15–30% | 75–91% | 75–88% | Massif vs OCR |
| Photo de téléphone d'un document manuscrit (mauvais éclairage) | <20% | 40–60% | 65–80% | Massif |
| Document historique (encre délavée, papier jauni) | <15% | 50–70% | 60–80% | Massif |
Sources : AIMultiple 2026 Handwriting Recognition Benchmark, Suparse 2026 Best Handwriting OCR Tools Comparison, benchmark handwritingocr.com, rapports de production Reddit r/computervision. Tous les chiffres représentent des mesures indépendantes, pas des affirmations de fournisseurs.
Deux choses ressortent de ce tableau. Premièrement, le schéma de dégradation est asymétrique. L'OCR traditionnel chute brutalement au premier signe d'écriture manuscrite, passant du début des années 90 sur texte imprimé à moins d'un tiers sur la cursive. Ce n'est pas un déclin progressif ; c'est une défaillance du système. Les VLM se dégradent aussi, mais plus doucement, restant dans une plage utilisable du texte imprimé aux photos de terrain.
Deuxièmement, « la précision de la reconnaissance d'écriture manuscrite » en tant que chiffre unique n'a pas de sens. Un outil qui atteint 95% sur des lettres capitales soignées dans des champs de formulaire contraints pourrait atteindre 45% sur les commentaires narratifs en cursive du même formulaire. Si vos documents contiennent les deux (et c'est le cas de la plupart des documents réels), la précision combinée dépend de votre mélange de documents, pas du chiffre principal du fournisseur.
La seule façon fiable d'évaluer un outil est de le tester sur vos documents réels — pas sur des échantillons propres fournis par le vendeur. Tout fournisseur qui refuse de vous laisser tester sur vos propres fichiers doit être considéré avec scepticisme.
Transcription ou extraction : la distinction que la plupart des guides oublient
La transcription et l'extraction sont souvent traitées comme une seule et même tâche. Or, elles diffèrent, et cette différence détermine si votre projet aboutit à un tableur ou à un mur de texte.
La transcription est l'étape qui consiste à passer de l'écriture manuscrite au texte numérique. Le résultat est un paragraphe ou un bloc de texte : « Le patient signale des douleurs abdominales depuis trois jours, nie toute nausée. » C'est de la transcription. C'est utile pour la recherche, l'archivage et la lecture, mais pas pour l'analytique, la comptabilité ou tout flux de travail qui doit insérer des données dans des colonnes.
L'extraction consiste à extraire des points de données précis d'un document manuscrit vers des champs structurés. Le résultat est une ligne de tableau : Date = 2026-06-15, Montant = $342.50, Client = Acme Corp, Remarques = « commande urgente — livrer avant vendredi. » C'est de l'extraction. C'est ce dont votre tableur, votre ERP ou votre système comptable a réellement besoin.
La plupart des outils de reconnaissance d'écriture manuscrite — y compris presque toutes les solutions OCR et ICR traditionnelles — ne font que de la transcription. Ils vous donnent un mur de texte. Ils ne vous disent pas quel nombre est le total de la facture et lequel est le montant de la taxe. Cette étape de séparation — lire le document, puis structurer ce qui a été lu — est le point où le travail humain entre traditionnellement dans le flux de travail, et c'est là que la plupart des projets d'automatisation échouent.
Les outils qui font de l'extraction, en particulier les systèmes basés sur VLM, comblent cette lacune en lisant les documents de manière sémantique. Vous définissez les colonnes souhaitées, et l'IA localise chaque valeur sur la page en comprenant ce qu'elle signifie, et non en cherchant du texte dans des zones prédéfinies. Un outil capable d'extraire « Montant total = $342.50 » d'une facture manuscrite n'a pas besoin de savoir où ce nombre apparaît sur la page. Il doit comprendre que « Montant total » est un libellé et que « $342.50 » est la valeur associée, même s'ils sont séparés par un saut de ligne, une flèche manuscrite ou une écriture entièrement différente.
C'est ce que l'on entend par extraction de colonnes personnalisées. Vous nommez les champs une seule fois, en termes simples tels que « Numéro de facture », « Date » ou « Total », et cette même liste de colonnes s'applique à chaque document que vous téléchargez, quelle que soit la différence de formulaire. Il n'y a pas de modèle à créer pour chaque fournisseur ni rien à réentraîner lorsqu'un formulaire change, car rien dans la configuration n'est lié à une position sur la page.
Si votre flux de travail se termine par l'insertion de données dans un tableur, vous avez besoin d'extraction, pas de transcription. Assurez-vous que l'outil que vous évaluez peut faire la seconde, pas seulement la première.
L'équation du coût réel : pourquoi le prix par page est la mauvaise mesure
La conversation sur les prix des outils de reconnaissance d'écriture manuscrite commence toujours par le coût par page. OCR traditionnel : 0,001 à 0,005 $ par page. Basé sur VLM : 0,01 à 0,05 $ par page. Calcul simple : l'OCR est 5 à 10 fois moins cher. Affaire classée.
Sauf que ce n'est pas le cas. Le coût qui compte n'est pas le prix d'extraction par page — c'est le coût de production d'un résultat correct. Et cela inclut le temps et la main-d'œuvre consacrés à la correction des erreurs.
La véritable équation est :
Coût réel = (Prix d'extraction par page × Nombre de pages) + (Temps de correction par erreur × Nombre d'erreurs × Taux horaire)
Lorsque le taux d'erreur est faible (texte imprimé, OCR traditionnel), le terme de correction est faible. Lorsqu'il est élevé (écriture cursive, OCR traditionnel), le terme de correction domine entièrement l'équation.
Prenons un exemple concret. Une entreprise de construction traite 100 rapports quotidiens manuscrits par semaine. Chaque rapport contient environ 25 champs de données — dates, heures travaillées, matériaux utilisés, heures d'équipement, notes du chef de chantier. Cela représente 2 500 champs par semaine, soit 130 000 champs par an.
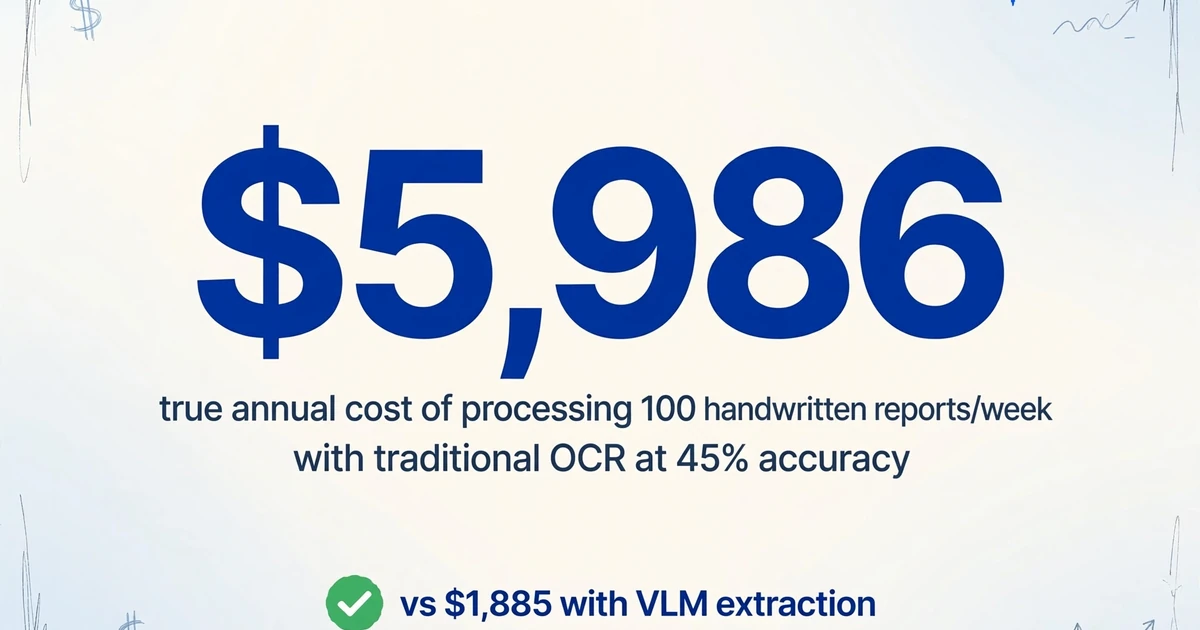
Avec l'OCR traditionnel (45 % de précision sur les notes cursives) : 71 500 champs nécessitent une correction manuelle par an. À 15 secondes par correction, cela représente 298 heures de travail manuel — environ 5 960 $ par an à 20 $/heure. Le coût OCR par page est négligeable (~26 $/an). Coût annuel réel : ~5 986 $.
Avec l'extraction basée sur VLM (85 % de précision sur la cursive) : 19 500 champs nécessitent une correction manuelle par an. À 15 secondes par correction, cela représente 81 heures — environ 1 625 $ par an. Le coût VLM par page est plus élevé (~260 $/an). Coût annuel réel : ~1 885 $.
L'approche VLM coûte 3 fois plus par page — et 3 fois moins au total lorsque l'on inclut la main-d'œuvre de correction. Ce calcul vaut pour tout type de document où l'écriture manuscrite représente une part importante du contenu. Un utilisateur de Reddit ayant traité plus de 150 000 pages en production a confirmé ce schéma : « Les plateformes OCR traditionnelles semblent rentables (~0,001 à 0,005 $ par page), mais leur mauvaise précision sur l'écriture manuscrite (~45 à 50 %) les rend inutilisables pour les flux de travail professionnels comportant un contenu manuscrit important. Le temps passé à corriger manuellement les erreurs rend le coût réel bien plus élevé que celui des solutions spécialisées » (r/computervision, 2025).
La comparaison du coût par page est un piège. Le seul coût qui compte est le coût par résultat correct. Lorsque l'écriture manuscrite représente une part significative du contenu, l'extraction basée sur VLM tend à être moins chère au total, souvent de manière spectaculaire, une fois que l'on inclut le travail de correction humaine qu'exige l'OCR traditionnel.
Application par application : quel parcours convient à vos documents
Aucun parcours technologique n'est catégoriquement supérieur ; le bon choix dépend de vos documents. Ce qui convient où, selon des déploiements réels et des données de référence :
Dossiers médicaux et notes cliniques
L'écriture manuscrite médicale est notoirement difficile à lire, et une grande partie de la documentation clinique commence encore sur papier ou dans des fichiers numérisés. Les enjeux sont élevés : un nom de médicament ou un dosage mal lu est un incident de sécurité des patients, et la conformité HIPAA exige une précision vérifiable. Une étude de 2025 sur la numérisation des dossiers cliniques manuscrits a constaté que « les systèmes OCR à usage général sont actuellement insuffisants pour une extraction fiable des données cliniques » en raison de la « complexité et de la variabilité des dossiers médicaux manuscrits » (SciTePress, 2025).
Parcours recommandé : extraction sémantique basée sur VLM, avec une étape de révision humaine pour les champs critiques (noms de médicaments, dosages, diagnostics). Chez Omega Healthcare, le traitement documentaire assisté par IA a réduit le temps de documentation de 40 % et permis d'économiser plus de 15 000 heures employé par mois avec une précision de processus de 99,5 % (Business Insider, 2025). L'architecture qui rend cela possible est l'extraction IA avec un seuil de confiance : les champs au-dessus du seuil passent directement ; ceux en dessous sont signalés pour révision humaine.
Points d'attention : conformité HIPAA. Si vous utilisez un VLM basé sur le cloud, confirmez la BAA (Business Associate Agreement) du fournisseur et ses pratiques de traitement des données. Un déploiement sur site peut être requis pour certaines institutions.
Rapports quotidiens de chantier et journaux de terrain
Les chefs de chantier remplissent les rapports quotidiens à la main — souvent sur site, par mauvais temps, avec un stylo à court d'encre. Ces rapports contiennent des observations de sécurité, des heures de travail, l'utilisation des équipements, les livraisons de matériaux et des notes d'incidents. Ils ont une importance juridique (les exigences de paie certifiée Davis-Bacon aux États-Unis imposent une tenue de registres spécifique) et sont essentiels sur le plan opérationnel (une facturation retardée signifie un flux de trésorerie retardé).
Parcours recommandé : extraction basée sur VLM avec traitement par lots. Une entreprise de construction typique traite 20 à 100 rapports quotidiens par semaine, chacun provenant de différents chefs de chantier avec des écritures différentes. La capacité de traitement par lots — téléverser tous les rapports en une fois et obtenir un seul tableau consolidé — est la différence opérationnelle entre un outil que vous utiliserez réellement et un qui reste dans une vidéo de formation.
Points d'attention : contenu mixte. Les formulaires de construction mélangent presque toujours des étiquettes imprimées (« Date », « N° de chantier », « Chef de chantier ») avec des entrées manuscrites. L'OCR traditionnel échoue sur ce mélange. Assurez-vous que l'approche choisie gère les deux en un seul passage.
Documents historiques et archives
Les bibliothèques, les agences gouvernementales et les organisations généalogiques numérisent des siècles de documents manuscrits — actes de naissance, registres de mariage, formulaires de recensement, dossiers de service militaire. La Wilson Library de l'Université de Caroline du Nord utilise la reconnaissance d'écriture manuscrite assistée par IA avec validation humaine participative pour transcrire des documents juridiques manuscrits de l'ère Jim Crow. Les archives gouvernementales ont emprunté la même voie, en scannant des registres d'état civil remontant à plus d'un siècle et en y appliquant la reconnaissance d'écriture manuscrite, avec des réviseurs humains qui résolvent les entrées que le modèle ne peut pas lire avec certitude.
Piste recommandée : Reconnaissance d'écriture manuscrite avec entraînement de modèle personnalisé + révision humaine. Lorsque vous avez affaire à l'écriture d'une seule personne sur des centaines de pages (le registre d'un curé de paroisse, les livres de comptes d'un greffier spécifique), les modèles de reconnaissance d'écriture manuscrite entraînés sur mesure (comme Transkribus) peuvent atteindre des niveaux de précision que les modèles généralistes ne peuvent pas égaler. Pour les collections comportant de nombreux scripteurs différents, l'extraction basée sur les VLM offre une base solide sans entraînement, mais la révision humaine reste essentielle — l'évaluation 2026 de la transcription IA de documents de sources primaires par la bibliothèque de l'UVA a conclu que « c'étaient parmi nos sources primaires les plus délicates : lettres manuscrites, registres complexes, documents à double face » et que la précision de l'IA variait considérablement selon le type et l'état des documents.
Points de vigilance : La qualité de l'image. L'encre délavée, le papier jauni, le transfert d'encre depuis le verso et les écritures non standard (Fraktur, Sütterlin, écriture de secrétaire) affectent tous considérablement la précision. Le prétraitement — redressement, amélioration du contraste, nettoyage de l'arrière-plan — est souvent aussi important que le moteur de reconnaissance lui-même.
Finance et comptabilité : registres et reçus manuscrits
Les petites entreprises, les restaurants et les opérations de service sur le terrain génèrent encore des reçus manuscrits, des confirmations de livraison et des écritures de registre manuelles. Un restaurant reçoit des factures de fournisseurs avec des quantités et des prix manuscrits dans les marges. Un livreur collecte des preuves de livraison manuscrites. Un mécanicien note les détails de réparation sur un bon de travail papier. La saisie manuelle de ces données coûte environ 15 à 40 $ par document, en tenant compte de la main-d'œuvre, de la correction des erreurs et des frais de gestion (Constrafor, 2025).
Piste recommandée : Extraction structurée basée sur les VLM. Les résultats doivent être intégrés dans des logiciels de comptabilité (QuickBooks, Xero, Sage), ce qui signifie que l'extraction doit produire des données structurées — pas seulement du texte transcrit. La possibilité de définir une fois les colonnes de sortie et de traiter plusieurs documents manuscrits selon le même schéma est ce qui transforme l'extraction d'écriture manuscrite d'une curiosité en une réduction des coûts opérationnels.
Points de vigilance : Les valeurs calculées. Un reçu manuscrit peut indiquer « Qté : 3, Prix unitaire : 12,50 $, Total : 37,50 $ ». Si l'IA extrait les trois, c'est bien — mais si le total manuscrit contient une erreur arithmétique, l'extraction sans validation propage l'erreur. Les meilleurs pipelines d'extraction vous permettent de définir des colonnes calculées (par exemple, « Total ligne = Qté × Prix unitaire ») que l'IA calcule pendant l'extraction, offrant ainsi une vérification croisée par rapport au total manuscrit.
Logistique et service sur le terrain
Les livreurs remplissent des bons de livraison manuscrits avec signatures, horodatages et notes d'exception (« laissé à la porte arrière »). Les techniciens de terrain complètent des rapports d'inspection manuscrits avec cases à cocher et commentaires narratifs. Les experts en sinistres rédigent des évaluations manuscrites sur les lieux d'accident. Ces documents sont générés sur le terrain, souvent sur des formulaires en papier carbone, et doivent rapidement intégrer les systèmes back-office.
Piste recommandée : extraction basée sur VLM avec téléversement mobile. La capacité de photographier un formulaire manuscrit avec un téléphone — sans numérisation, sans redressement — et d'obtenir des données structurées est la percée opérationnelle pour les équipes terrain. Des benchmarks indépendants montrent que les systèmes basés sur VLM atteignent 65–80 % de précision sur des photos de documents manuscrits prises au téléphone (contre <20 % pour l'OCR traditionnel), rendant les flux de travail mobile-first pratiques pour la première fois.
Points de vigilance : détection des cases à cocher et des signatures. Les formulaires terrain combinent souvent texte manuscrit, cases cochées, options encerclées et signatures. Si le système d'extraction ne peut pas identifier quelle case a été cochée ou si un champ de signature est présent, vous devrez encore effectuer une révision manuelle partielle.
Comment évaluer un outil d'extraction manuscrite : 6 dimensions
La plupart des cadres d'évaluation pour les outils d'extraction de documents ont été conçus pour le texte imprimé. L'écriture manuscrite change les critères d'évaluation. Voici ce qui compte réellement.
Précision sur vos documents, pas sur des échantillons du fournisseur
N'importe quel fournisseur peut sélectionner des échantillons propres. Exigez de tester sur vos documents réels — ceux qui sont en désordre, ceux en écriture cursive, ceux pris avec un téléphone dans une mauvaise lumière. Si le fournisseur refuse de vous laisser tester sur vos propres fichiers, passez votre chemin.
Sortie structurée, pas seulement une transcription
L'outil produit-il une feuille de calcul avec les colonnes que vous avez définies, ou produit-il un bloc de texte que vous devez ensuite analyser ? Le premier remplace la saisie de données ; le second remplace la transcription mais laisse la saisie de données intacte.
Gestion du contenu mixte
La plupart des documents réels mélangent des étiquettes imprimées avec des entrées manuscrites. L'outil peut-il lire les deux en une seule passe, ou nécessite-t-il des étapes de traitement séparées pour le texte imprimé et l'écriture manuscrite ? Cette dernière option ajoute une complexité de processus qui érode l'adoption.
Capacité de traitement par lots
Traiter un document manuscrit est une démonstration. En traiter 50 à la fois et obtenir une seule feuille de calcul consolidée est un flux de travail. La capacité de traitement par lots — télécharger plusieurs fichiers, les traiter avec les mêmes définitions de colonnes, obtenir un tableau de sortie unique — est ce qui distingue l'évaluation de l'adoption.
Aucune formation ni configuration requise
Si l'outil exige de collecter des échantillons d'écriture manuscrite, d'annoter des champs ou d'entraîner un modèle avant de fonctionner, demandez combien de temps cela prend et si c'est durable à mesure que vos sources de documents évoluent. Certains outils (Nanonets, certains moteurs ICR) exigent 10+ échantillons annotés par type de document. Les outils sans modèle qui fonctionnent dès la première utilisation contournent entièrement cette étape.
Coût total, pas le coût par page
Calculez l'équation complète : coût d'extraction + travail de correction à votre taux d'erreur réel. Un outil à 0,001 $/page qui nécessite 30 % de correction manuelle coûte plus cher qu'un outil à 0,03 $/page qui nécessite 5 % de correction. Faites le calcul sur vos volumes avant de comparer les prix.
FAQ : Les questions que les gens se posent vraiment sur la reconnaissance d'écriture manuscrite
L'IA peut-elle gérer l'écriture cursive et les lettres moulées sur la même page ?
Oui — et c'est précisément là que les systèmes basés sur VLM surpassent l'OCR et l'ICR traditionnels. Une page avec des en-têtes de section imprimés, un texte courant en cursive et des notes en lettres moulées dans les marges est lue en une seule passe par un VLM, car le modèle lit sémantiquement (en comprenant le sens) plutôt qu'en essayant de faire correspondre des formes de caractères. L'OCR et l'ICR traditionnels traitent le texte imprimé et la cursive comme des tâches de reconnaissance distinctes nécessitant des moteurs différents. Pour approfondir cette capacité, consultez notre comparaison directe entre la reconnaissance d'écriture manuscrite par IA et l'OCR traditionnel.
Quelle précision puis-je réalistement attendre sur l'écriture cursive ?
Sur une cursive propre et lisible numérisée à 300 DPI : 85–91 % avec des outils ICR/HTR spécialisés, 75–90 % avec une extraction basée sur VLM. Sur une cursive brouillonne et rapide : attendez-vous à 65–80 % avec les meilleurs outils. Sur une cursive dans des photos de téléphone de faible qualité : 60–75 %. Aucun outil n'atteint 99 % sur la cursive dans des conditions réelles — quiconque prétend le contraire mesure sur des échantillons triés sur le volet. L'approche pratique consiste à utiliser l'extraction pour les champs structurés (où l'IA excelle) et à réserver la relecture humaine pour les sections de texte narratif où la précision est critique.
La reconnaissance d'écriture manuscrite peut-elle fonctionner sur des documents historiques à l'encre délavée ?
Oui, mais le flux de travail importe plus que le moteur de reconnaissance. Le succès avec les documents historiques dépend : (1) d'une numérisation haute résolution (600 DPI recommandé, pas 300), (2) du prétraitement — amélioration du contraste, redressement, suppression du bruit de fond, (3) du choix du moteur de reconnaissance — HTR avec entraînement personnalisé sur des écritures similaires si la collection a une écriture cohérente, extraction basée sur VLM s'il s'agit de nombreux scripteurs différents. Les projets de numérisation gouvernementaux et académiques rapportent systématiquement que la relecture humaine est essentielle pour les documents historiques — l'IA gère l'essentiel du travail, les humains vérifient les champs critiques. L'évaluation 2026 de la UVA Library a constaté que « la précision de l'IA variait considérablement selon le type et l'état du document », confirmant que les documents historiques restent la catégorie la plus difficile.
Dois-je entraîner l'IA sur mon écriture manuscrite ?
Pour l'extraction basée sur VLM : non. Ces systèmes sont conçus pour fonctionner dès la première utilisation avec n'importe quel style d'écriture — ils lisent sémantiquement, pas en faisant correspondre des échantillons d'entraînement. Pour les outils ICR/HTR : parfois. Des outils comme Transkribus permettent un entraînement personnalisé du modèle, ce qui peut améliorer la précision si vous avez des centaines de pages d'un même scripteur. Pour l'OCR traditionnel : non, car l'entraînement n'aidera pas — ces moteurs ne peuvent pas gérer l'écriture manuscrite de toute façon. Le compromis est que les modèles HTR entraînés sur mesure peuvent atteindre une précision supérieure sur un scripteur spécifique mais nécessitent un effort d'entraînement initial, tandis que les systèmes basés sur VLM fonctionnent immédiatement sur n'importe quel scripteur mais plafonnent à ~90 % sur la cursive. Choisissez en fonction de si vous traitez un style d'écriture cohérent à grande échelle ou de nombreux styles différents.
L'IA peut-elle extraire des données de formulaires manuscrits vers Excel — ou seulement convertir l'écriture manuscrite en texte ?
Cela dépend entièrement de l'outil. La plupart des outils OCR pour l'écriture manuscrite ne produisent que du texte — ils transcrivent un formulaire manuscrit mais ne séparent pas « Date : 15 juin » dans une colonne Date et « Montant : 342 $ » dans une colonne Montant. Les outils d'extraction basés sur les VLM (comme ImageToTable.ai) sont spécifiquement conçus pour produire une sortie structurée en feuille de calcul. Vous définissez les colonnes souhaitées — « Date », « Montant », « Nom du client », « Remarques » — et l'IA extrait les valeurs correspondantes de chaque document dans ces colonnes, produisant un tableau où chaque ligne correspond à un document et chaque colonne à un champ. Il s'agit d'une extraction, pas d'une transcription — et c'est cette capacité qui rend l'automatisation des données manuscrites pratique pour les flux de travail en comptabilité, logistique et opérations. Pour le guide pratique, consultez comment extraire des données manuscrites directement dans Excel.
L'OCR gratuit (Tesseract, Google Keep) est-il suffisant pour l'écriture manuscrite ?
Pour une utilisation rapide et non critique — capturer une liste de courses ou une courte note — les outils gratuits fonctionnent correctement sur des lettres majuscules claires. Pour toute application professionnelle impliquant de l'écriture cursive, une écriture désordonnée, ou lorsque la précision compte : non. Tesseract atteint environ 45 % de précision au niveau des mots sur l'écriture cursive. Google Keep gère bien mieux l'écriture imprimée claire que la cursive. L'écart entre les outils gratuits et les solutions payantes est plus large dans la reconnaissance d'écriture manuscrite que dans toute autre catégorie d'OCR, car les modèles d'IA spécialisés dans l'écriture manuscrite nécessitent des données d'entraînement et une puissance de calcul substantielles que les outils gratuits ne peuvent pas fournir économiquement. Si votre cas d'usage est « je dois trouver un mot dans mes notes manuscrites », les outils gratuits peuvent suffire. S'il s'agit de « je dois extraire 50 champs de 100 formulaires manuscrits dans une feuille de calcul avec un taux d'erreur inférieur à 5 % », vous avez besoin d'une solution payante.
Ce qui nous attend : l'horizon 2027-2028
La transformation de la reconnaissance d'écriture manuscrite entre 2023 et 2026 a été portée par les LLM apprenant à lire sémantiquement. Le prochain changement — déjà visible dans la recherche mais pas encore dans les outils de production — sera porté par trois évolutions :
Des modèles multimodaux qui extraient, valident et raisonnent en une seule passe. Les outils actuels séparent l'extraction (« que dit cette page ? ») de la validation (« est-ce que cela a du sens ? »). Les modèles émergents feront les deux simultanément — extrayant les lignes d'une facture tout en vérifiant que la somme des totaux de lignes est égale au total de l'en-tête, signalant les écarts sans étape de validation séparée. Cela réduit le pipeline extraction-plus-relecture à une seule étape pour les documents courants.
Une reconnaissance d'écriture manuscrite explicable pour les secteurs réglementés. Les utilisateurs de la santé, du droit et du secteur public ont besoin de savoir pourquoi l'IA a lu un champ particulier comme étant « 500 $ » et non « 600 $ » — surtout lorsque l'écriture est ambiguë. La recherche sur l'IA explicable pour le traitement de documents progresse, avec un score de confiance au niveau du caractère (plutôt qu'au niveau du document) se rapprochant d'une utilisation en production. Cela rendra l'extraction par IA suffisamment auditable pour les flux de travail de conformité qui exigent actuellement un examen 100 % humain.
Traitement sur l'appareil pour une utilisation sur le terrain. Exécuter la reconnaissance d'écriture manuscrite localement sur un téléphone — pas d'envoi vers le cloud, aucune exigence de connectivité, résultats instantanés — est techniquement faisable avec des modèles quantifiés plus petits. Le compromis entre précision et rapidité/latence se réduit. Pour les équipes de service sur site, de construction et de logistique qui ont besoin de résultats d'extraction avant de quitter le lieu de travail, le traitement sur l'appareil débloquera des flux de travail que les outils dépendants du cloud ne peuvent pas prendre en charge.
La direction est claire : la reconnaissance d'écriture manuscrite devient un problème résolu pour l'extraction structurée de types de documents courants, et approche du territoire « assez bon avec relecture » pour les catégories les plus difficiles (documents historiques, entrées fortement dégradées). Le cycle d'investissement technologique est encore dans sa phase d'accélération précoce. Les outils disponibles en 2028 feront paraître les meilleurs outils d'aujourd'hui comme Tesseract nous paraît maintenant.
L'essentiel pour toute personne évaluant l'extraction d'écriture manuscrite en 2026 :
Ne laissez pas les déceptions passées avec l'OCR traditionnel façonner vos attentes sur ce qui est possible aujourd'hui. Les trois pistes technologiques — OCR traditionnel, ICR/HTR et extraction sémantique basée sur les VLM — sont des approches fondamentalement différentes, avec des plafonds de précision, des formats de sortie et des profils de coûts différents. La bonne piste dépend de vos documents. La mauvaise piste — qui est presque toujours l'OCR traditionnel pour tout document contenant de l'écriture manuscrite — coûte plus cher que la bonne piste, en argent comme en temps. Testez sur vos documents réels, calculez le coût total incluant le travail de correction, et assurez-vous que l'outil choisi produit une sortie structurée, pas seulement du texte transcrit.
Téléchargez un document manuscrit — saisissez les colonnes dont vous avez besoin — obtenez un tableur structuré en quelques secondes. Sans formation, sans modèles.