IA de escritura manuscrita a texto:
La guía completa de 2026 sobre lo que funciona
En 2023, si preguntaba si la IA podía convertir de manera confiable la escritura manuscrita a texto, la respuesta honesta era "más o menos: si la letra es clara, si es en mayúsculas, si el escaneo es limpio y si no le importa corregir gran parte de lo que lee". Tres años después, esa respuesta ha cambiado. El reconocimiento de escritura manuscrita con IA mejoró lo suficiente entre finales de 2024 y mediados de 2025 como para que la mayoría de las personas no se hayan puesto al día: la tecnología realmente funciona ahora, pero solo si elige el enfoque adecuado para sus documentos específicos. Esta guía traza el panorama tal como es realmente en 2026, no como los proveedores quieren que usted crea.
Qué cambió realmente en el reconocimiento de escritura manuscrita desde 2023
Ocurrieron tres cosas, y sucedieron tan rápido que la mayoría de las suposiciones que la gente tiene sobre el reconocimiento de escritura manuscrita están dos años desactualizadas.
Primero, el avance de los LLM. Cuando GPT-4V se lanzó a fines de 2023, fue la primera vez que un modelo de IA de propósito general pudo leer escritura cursiva con cierta confiabilidad. No era excelente — las tasas de alucinación eran altas y no podía generar datos estructurados. Pero demostró algo fundamental: el reconocimiento de escritura manuscrita no necesita ser un problema de coincidencia de caracteres. Un modelo que comprende el lenguaje semánticamente puede leer escritura desordenada como lo haría un humano — infiriendo caracteres ambiguos a partir del contexto.
Para mediados de 2025, GPT-5 y Gemini 3 Pro habían llevado esta capacidad a un nivel de producción. El benchmark de escritura cursiva de AIMultiple de enero de 2026 — una prueba controlada con 100 muestras de escritura de 10 escritores — colocó a GPT-5, Gemini 3 Pro Preview y olmOCR-2-7B en la cima en similitud semántica en texto cursivo, superando a las API de OCR dedicadas como Azure y Google Document AI (AIMultiple, enero de 2026). El hallazgo clave no fue que los LLM superaran al OCR tradicional en escritura manuscrita — eso era esperado. Fue cuánto lo superaron. Mientras que los motores de OCR tradicionales devolvían una precisión de palabras del 45–60% en cursiva mixta, los sistemas basados en VLM alcanzaban el 80–90%.
Segundo, los motores especializados en escritura manuscrita maduraron. Mientras los LLM acaparaban los titulares, las herramientas de OCR dedicadas a escritura manuscrita alcanzaron precisión de nivel producción en casos de uso específicos. HandwritingOCR logró una tasa de error de palabras del 0.9% (99.1% de precisión) en prosa inglesa manuscrita estándar en benchmarks independientes (handwritingocr.com, 2026). ABBYY FineReader 16 alcanzó 91.7% en cursiva y 95.2% en imprenta manuscrita en una comparación entre proveedores. Estos no son los tipos de cifras que existían en 2023.
Tercero, la infraestructura del mercado se puso al día. El mercado global de OCR/ICR alcanzó los $13.95–16.26 mil millones en 2024 y se proyecta que llegue a $42–46 mil millones para 2030–2033, con un crecimiento del 13–17% CAGR (ArticSledge, 2026). Eso no es solo "el mercado está creciendo" — significa que fluye suficiente capital hacia el sector como para que la curva de mejora tecnológica de 2024–2026 parezca lenta en comparación con lo que viene en 2027–2028.
La consecuencia práctica de estos tres cambios: el reconocimiento de escritura manuscrita ya no es una cuestión de "¿funciona siquiera?". Es una cuestión de "qué vía tecnológica se adapta a sus documentos, sus requisitos de precisión y su formato de salida".
Las Tres Vías Tecnológicas — y Por Qué No Son Intercambiables
Cada herramienta de reconocimiento de escritura manuscrita en el mercado en 2026 se clasifica en una de tres vías tecnológicas. No solo difieren en precisión, sino en qué tipo de entrada pueden manejar, qué tipo de salida producen y si pueden extraer datos estructurados. Elige la vía equivocada y la precisión que un proveedor te mostró en una demostración no sobrevivirá al contacto con tus propios documentos.
Vía 1: Traditional OCR (Tesseract, ABBYY, APIs en la nube)
Cómo funciona: Coincidencia de patrones carácter por carácter. El motor compara cada región de píxeles contra una biblioteca de formas de caracteres conocidas y genera la coincidencia más cercana. Trata el texto como un problema de reconocimiento de patrones visuales — "¿a qué se parece esta forma?" — sin comprensión del lenguaje, contexto o significado.
Para qué es bueno: Escaneos limpios y de alta resolución de texto impreso en fuentes estándar. En escaneos de 300 DPI de documentos impresos con láser, el Traditional OCR alcanza una precisión del 95–99%. Azure Document Intelligence y AWS Textract ambos alcanzan ~99% en formularios impresos limpios.
Dónde falla: En el momento en que la escritura manuscrita entra en escena. El Traditional OCR asume que cada carácter ocupa un cuadro delimitador separable. La escritura cursiva viola esta suposición por completo — las letras fluyen unas en otras sin un límite claro. El motor o fusiona múltiples letras en un solo bloque (leyendo "clear" como "dear") o divide una sola letra entre cuadros (leyendo "m" como "rn").
En producción: Tesseract, el motor de OCR de código abierto más ampliamente desplegado, devuelve una precisión de palabras del 45–50% en escritura cursiva general. Azure Document Intelligence alcanza ~95% en letra de molde ordenada pero cae a ~45% en comentarios narrativos en cursiva. Google Document AI alcanza ~50% en secciones de comentarios manuscritos. Estos números provienen de evaluaciones comparativas independientes e informes de profesionales en r/computervision de Reddit, no de páginas de marketing de proveedores.
Conclusión: El Traditional OCR es para texto impreso. En el momento en que tus documentos contengan escritura manuscrita — cualquier escritura manuscrita — necesitas una vía diferente.
Pista 2: ICR / HTR (Redes neuronales especializadas en escritura manuscrita)
Cómo funciona: El reconocimiento inteligente de caracteres (ICR) y el reconocimiento de texto manuscrito (HTR) utilizan redes neuronales convolucionales (CNN) y redes neuronales recurrentes (RNN) entrenadas específicamente con conjuntos de datos de escritura manuscrita. A diferencia del coincidencia de patrones del OCR, estas redes aprenden las características subyacentes de la escritura a mano — patrones de trazos, puntos de conexión, variaciones de letras — y pueden generalizar entre distintos escritores. El ICR normalmente maneja caracteres impresos a mano (letras de molde escritas por separado), mientras que el HTR se extiende a la escritura cursiva y conectada. Algunas herramientas combinan ambos en el mismo motor.
En qué destaca: Formularios estructurados con campos manuscritos, especialmente cuando la escritura es razonablemente clara en letras de molde. ABBYY FineReader alcanza un 91.7% en cursiva y un 95.2% en letra de imprenta manuscrita. HandwritingOCR llega a un 99.1% de precisión por palabra (0.9% WER) en prosa inglesa manuscrita de buena calidad. Transkribus, la plataforma académica de HTR de la Universidad de Innsbruck, permite entrenar modelos personalizados con la escritura de un solo autor a lo largo de cientos de páginas — útil para archivos históricos y colecciones de un solo autor.
Dónde falla: El ICR/HTR sigue tratando la escritura manuscrita como un problema visual. Lee formas, no significado. Si un carácter es ambiguo — una "a" descuidada que parece una "o" — el motor adivina basándose en la similitud visual, no en el contexto. Un lector humano sabe que "apples cost $5" es más probable que "opples cost $5"; una red neuronal entrenada solo con formas de caracteres no lo sabe. Por eso la precisión del ICR en escritura cursiva y desordenada, aunque mejor que la del OCR tradicional, aún deja una brecha de error significativa.
Además, la mayoría de las herramientas de ICR/HTR producen transcripción (texto plano), no extracción estructurada (pares campo-valor en una tabla). Leer el texto de un formulario manuscrito es una cosa; extraer "Date," "Amount," y "Customer Name" en columnas separadas de Excel es otra — y la mayoría de las herramientas de ICR no hacen lo segundo.
En resumen: El ICR/HTR es la pista adecuada para la transcripción de texto manuscrito — cartas históricas, entradas de diario, notas de forma libre. Para extraer datos estructurados de formularios manuscritos, necesitas algo que combine el reconocimiento visual con la comprensión semántica.
Pista 3: Extracción Semántica Impulsada por VLM/IA
Cómo funciona: Los Modelos de Lenguaje y Visión (VLM) como GPT-5, Gemini 3 Pro y Claude Sonnet procesan documentos como imágenes completas y comprenden su contenido semánticamente. No comparan formas de caracteres ni reconocen patrones de trazos — "leen" el documento como lo haría una persona: mirando la página completa, entendiendo qué significa cada campo, y extrayendo información por significado en lugar de por posición. Cuando el modelo encuentra un carácter manuscrito ambiguo, resuelve la ambigüedad mediante el contexto — igual que un lector humano.
En qué destaca: Todo en una sola página, simultáneamente. Un VLM puede leer texto impreso, escritura cursiva y letras de molde en el mismo formulario en una sola pasada. Puede identificar casillas de verificación (marcadas, circuladas, tachadas), localizar firmas y sellos, y manejar el documento real común: un formulario impreso con entradas manuscritas en los campos en blanco. El benchmark de AIMultiple 2026 mostró que los sistemas basados en VLM alcanzan puntuaciones altas de similitud semántica en texto cursivo que el OCR tradicional no podía procesar en absoluto.
Más importante aún, la extracción basada en VLM puede producir salida estructurada. Usted define qué columnas quiere — "Número de Factura", "Fecha", "Monto Total", "Notas Manuscritas" — y el modelo localiza cada valor en cualquier parte de la página comprendiendo qué significa, no dónde está. Esta es la capacidad crítica que separa las dos primeras pistas de la tercera: la capacidad de pasar de "puedo leer esta página" a "aquí tiene su hoja de cálculo".
Dónde falla: Tres limitaciones honestas. Velocidad: La inferencia de VLM es computacionalmente más pesada que el OCR tradicional — el procesamiento toma 5–10 segundos por página en lugar de menos de un segundo. Riesgo de alucinación: Los VLM pueden ocasionalmente inventar texto, especialmente en entradas extremadamente degradadas o ambiguas. Esto está mejorando (GPT-5 alucina significativamente menos que GPT-4V), pero no es cero — para un marco de diagnóstico que cubre la alucinación y los otros siete patrones comunes de fallo, consulte nuestra guía de modos de fallo en extracción de escritura manuscrita. Costo: Los costos de API por página son más altos que el OCR tradicional — aproximadamente $0.01–0.05 por página frente a $0.001–0.005. Si esto importa depende del costo de corregir errores (consulte la sección de costos más abajo).
Conclusión: Esta es la pista que hace práctica la extracción de datos de escritura manuscrita a escala. Si su objetivo es llevar datos manuscritos a una hoja de cálculo — no solo transcribir texto manuscrito — esta es la arquitectura que busca.
| Dimensión | OCR Tradicional | ICR / HTR | Semántico VLM/IA |
|---|---|---|---|
| Precisión en texto impreso | 95–99% | 90–95% | 95–99% |
| Precisión en letra de molde | 70–85% | 85–95% | 85–93% |
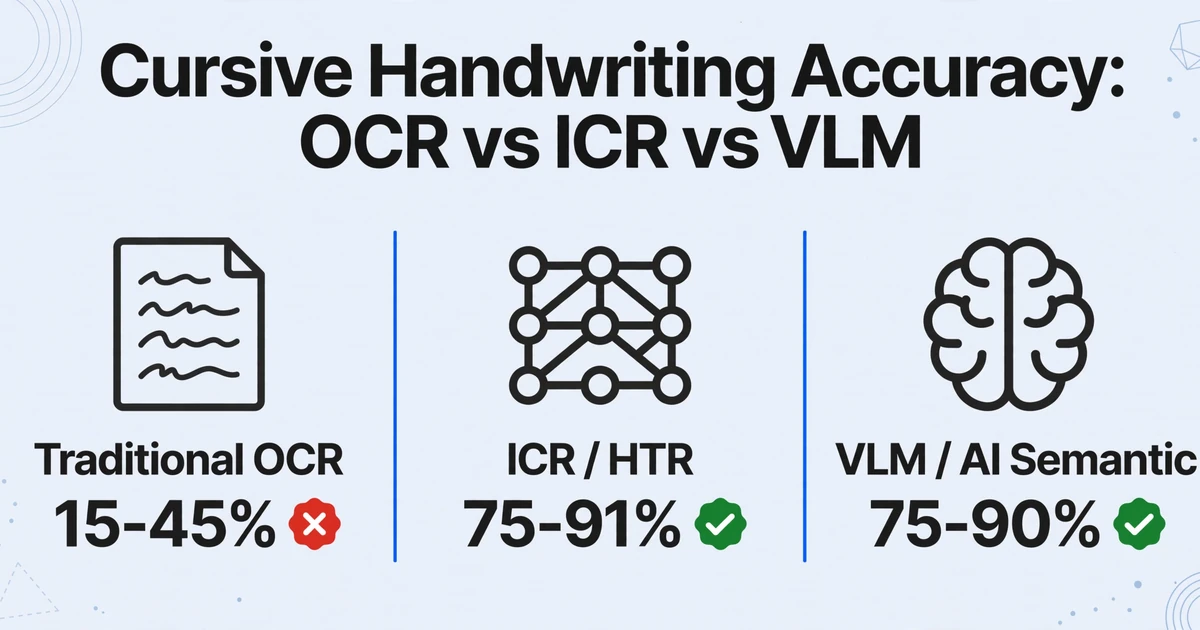
| Precisión en cursiva | 15–45% | 75–91% | 75–90% |
| Impreso + manuscrito mixto | ❌ Fallo | ⚡ Parcial | ✅ Lee ambos |
| Salida de datos estructurados | ❌ Solo texto | ❌ Mayormente texto | ✅ Excel/JSON |
| Comprensión contextual | ❌ Ninguna | ❌ Limitada | ✅ Semántica |
| Costo por página | $0.001–0.005 | $0.005–0.02 | $0.01–0.05 |
| Entrenamiento requerido | Ninguno | A veces | Ninguno |
Verificación de la Realidad de la Precisión: Qué Significan Realmente los Números
Cada proveedor de reconocimiento de escritura manuscrita publica un número de precisión. Pocos explican sobre qué se midió ese número, bajo qué condiciones, y qué entrega el mismo sistema cuando las condiciones no son ideales. Esta sección le brinda los números que realmente necesita, desglosados por escenario.
El patrón que surge de múltiples evaluaciones independientes en 2025–2026 es consistente. En texto impreso, las tres categorías se sitúan en el mismo rango, separadas por solo unos pocos puntos. En escritura manuscrita, se distancian.
| Escenario del Documento | Traditional OCR | ICR/HTR | VLM/AI | Brecha en el Mundo Real |
|---|---|---|---|---|
| Formulario impreso limpio (escaneo a 300 DPI) | 92–98% | 90–95% | 95–99% | Estrecha |
| Escritura manuscrita clara en mayúsculas dentro de casillas | 70–85% | 85–95% | 85–93% | Moderada |
| Mezcla de cursiva + etiquetas impresas en formulario | 45–60% | 65–85% | 80–90% | Amplia |
| Texto narrativo completamente en cursiva | 15–30% | 75–91% | 75–88% | Masiva vs OCR |
| Foto de teléfono de documento manuscrito (mala iluminación) | <20% | 40–60% | 65–80% | Masiva |
| Documento histórico (tinta desvanecida, papel amarillento) | <15% | 50–70% | 60–80% | Masiva |
Fuentes: AIMultiple 2026 Handwriting Recognition Benchmark, Suparse 2026 Best Handwriting OCR Tools Comparison, handwritingocr.com benchmark, informes de producción de Reddit r/computervision. Todos los números representan mediciones independientes, no afirmaciones de proveedores.
Dos cosas destacan de esta tabla. Primero, el patrón de degradación es asimétrico. El Traditional OCR cae por un precipicio ante la primera señal de escritura manuscrita, pasando de los 90 bajos en texto impreso a menos de un tercio en cursiva. Eso no es una disminución gradual; es una falla del sistema. Los VLM también se degradan, pero de manera más suave, permaneciendo en un rango utilizable desde texto impreso hasta fotos de campo.
Segundo, "precisión del reconocimiento de escritura manuscrita" como un número único no tiene sentido. Una herramienta que logra un 95% en letras claras en mayúsculas dentro de campos de formulario restringidos podría lograr un 45% en los comentarios narrativos en cursiva del mismo formulario. Si sus documentos contienen ambos (y la mayoría de los documentos reales los contienen), la precisión combinada depende de su mezcla de documentos, no del número destacado del proveedor.
La única forma confiable de evaluar una herramienta es probarla en sus documentos reales — no en muestras limpias que el proveedor proporciona. Cualquier proveedor que no esté dispuesto a permitirle probar con sus propios archivos debe tratarse con escepticismo.
Transcripción vs. Extracción: La Distinción Que la Mayoría de las Guías Pasan por Alto
La transcripción y la extracción se tratan como si fueran el mismo trabajo. No lo son, y la diferencia determina si tu proyecto produce una hoja de cálculo o un muro de texto.
Transcripción es el paso de texto manuscrito a texto digital. El resultado es un párrafo o un bloque de texto: "El paciente reporta dolor abdominal durante tres días, niega náuseas." Eso es transcripción. Es útil para búsqueda, archivo y lectura, pero no es útil para análisis, contabilidad ni ningún flujo de trabajo que necesite poner datos en columnas.
Extracción significa extraer puntos de datos específicos de un documento manuscrito hacia campos estructurados. El resultado es una fila de tabla: Fecha = 2026-06-15, Monto = $342.50, Cliente = Acme Corp, Notas = "pedido urgente — entregar antes del viernes." Eso es extracción. Es lo que tu hoja de cálculo, ERP o sistema contable realmente necesita.
La mayoría de las herramientas de reconocimiento de escritura manuscrita — incluidas casi todas las soluciones tradicionales de OCR e ICR — solo hacen transcripción. Te darán un muro de texto. No te dirán cuál número es el total de la factura y cuál es el monto de impuestos. Ese paso de separación — leer el documento y luego estructurar lo leído — es donde tradicionalmente entra el trabajo humano en el flujo, y es donde la mayoría de los proyectos de automatización se estancan.
Las herramientas que hacen extracción, particularmente los sistemas basados en VLM, cierran esta brecha al leer documentos semánticamente. Tú defines las columnas que quieres, y la IA localiza cada valor en la página al comprender qué significa, no al escanear texto en zonas predefinidas. Una herramienta que puede extraer "Monto Total = $342.50" de una factura manuscrita no necesita saber dónde aparece ese número en la página. Necesita entender que "Monto Total" es una etiqueta y "$342.50" es el valor asociado a ella, incluso si están separados por un salto de línea, una flecha manuscrita o un estilo de escritura completamente diferente.
Esto es lo que la gente quiere decir con Extracción de Columnas Personalizadas. Nombras los campos una vez, en palabras simples como "Número de Factura," "Fecha" o "Total," y esa misma lista de columnas se aplica a cada documento que subes, sin importar cuán diferentes sean los formularios. No hay plantilla que construir para cada proveedor ni nada que reentrenar cuando un formulario cambia, porque nada en la configuración está ligado a una posición en la página.
Si tu flujo de trabajo termina con datos que van a una hoja de cálculo, necesitas extracción, no transcripción. Asegúrate de que la herramienta que estás evaluando pueda hacer la segunda, no solo la primera.
La ecuación del costo real: por qué el precio por página es la métrica equivocada
La conversación sobre precios de las herramientas de reconocimiento de escritura manuscrita siempre comienza con el costo por página. OCR tradicional: $0.001–0.005 por página. Basado en VLM: $0.01–0.05 por página. Matemática simple: el OCR es 5–10 veces más barato. Caso cerrado.
Excepto que no lo es. El costo que importa no es el precio de extracción por página — es el costo de producir un resultado correcto. Y eso incluye el tiempo y la mano de obra dedicados a corregir errores.
La ecuación real es:
Costo real = (Precio de extracción por página × Número de páginas) + (Tiempo de corrección por error × Cantidad de errores × Tarifa de mano de obra)
Cuando la tasa de error es baja (texto impreso, OCR tradicional), el término de corrección es pequeño. Cuando es alta (escritura cursiva, OCR tradicional), el término de corrección domina la ecuación por completo.
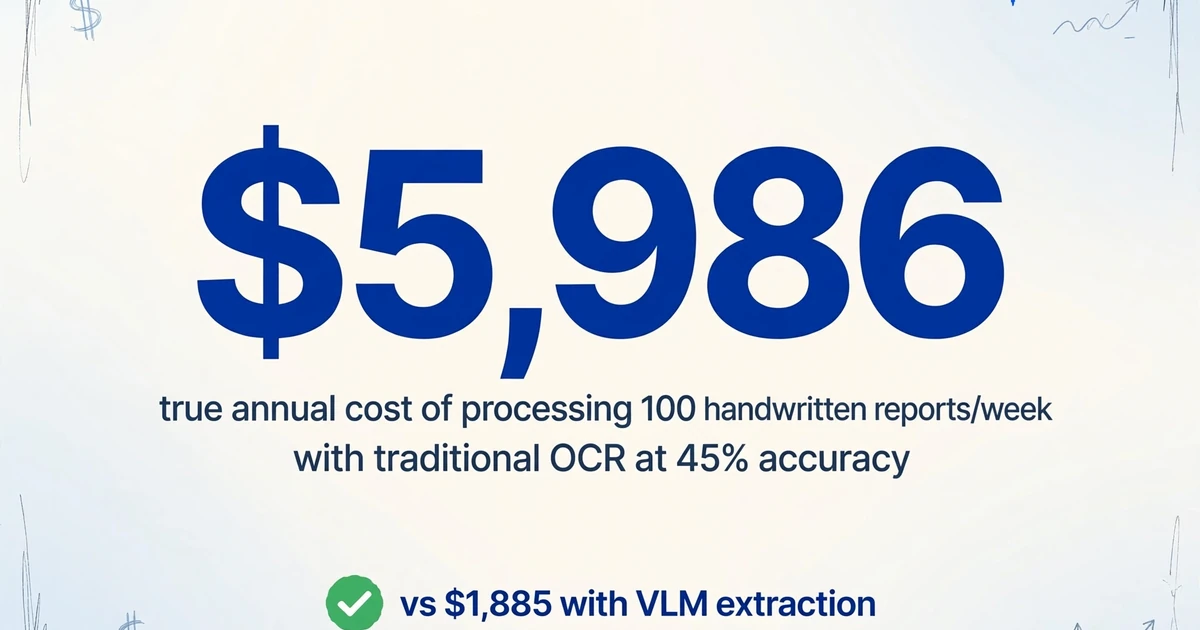
Hagamos esto concreto. Una empresa de construcción procesa 100 informes diarios manuscritos por semana. Cada informe contiene aproximadamente 25 campos de datos: fechas, horas trabajadas, materiales utilizados, horas de equipo, notas del capataz. Eso son 2,500 campos por semana, 130,000 campos por año.
Con OCR tradicional (45% de precisión en notas cursivas): 71,500 campos necesitan corrección manual por año. A 15 segundos por corrección, eso son 298 horas de mano de obra manual — aproximadamente $5,960 por año a $20/hora. El costo de OCR por página es insignificante (~$26/año). Costo anual real: ~$5,986.
Con extracción basada en VLM (85% de precisión en cursiva): 19,500 campos necesitan corrección manual por año. A 15 segundos por corrección, eso son 81 horas — aproximadamente $1,625 por año. El costo de VLM por página es más alto (~$260/año). Costo anual real: ~$1,885.
El enfoque VLM cuesta 3 veces más por página — y 3 veces menos en total cuando se incluye la mano de obra de corrección. Esta matemática se mantiene para cualquier tipo de documento donde la escritura manuscrita sea una parte significativa del contenido. Un usuario de Reddit que procesó más de 150,000 páginas en producción confirmó este patrón: "Las plataformas de OCR tradicional parecen rentables (~$0.001–0.005 por página), pero su baja precisión con escritura manuscrita (~45–50%) las hace inutilizables para flujos de trabajo empresariales con contenido manuscrito significativo. El tiempo dedicado a corregir errores manualmente hace que el costo real sea mucho más alto que el de soluciones especializadas" (r/computervision, 2025).
La comparación de costo por página es una trampa. El único costo que importa es el costo por resultado correcto. Cuando la escritura manuscrita constituye una parte significativa del contenido, la extracción basada en VLM tiende a ser más barata en total, a menudo de forma drástica, una vez que se incluye la mano de obra de corrección humana que exige el OCR tradicional.
Aplicación por aplicación: qué pista se adapta a sus documentos
Ninguna pista tecnológica es categóricamente mejor; la adecuada depende de sus documentos. Esto es lo que encaja en cada caso, según implementaciones reales y datos de referencia:
Registros médicos y notas clínicas
La escritura manuscrita médica es famosamente mala, y una gran parte de la documentación clínica aún comienza en papel o en archivos escaneados. Lo que está en juego es alto: una lectura errónea del nombre de un medicamento o de una dosis es un evento de seguridad del paciente, y el cumplimiento de HIPAA exige una precisión auditable. Un estudio de 2025 sobre la digitalización de registros clínicos manuscritos encontró que "los sistemas OCR de propósito general son actualmente insuficientes para una extracción fiable de datos clínicos" debido a la "complejidad y variabilidad de los registros médicos manuscritos" (SciTePress, 2025).
Pista recomendada: extracción semántica basada en VLM, con un paso de revisión humana en el circuito para campos críticos (nombres de medicamentos, dosis, diagnósticos). En Omega Healthcare, el procesamiento de documentos asistido por IA redujo el tiempo de documentación en un 40% y ahorró más de 15,000 horas de empleado al mes con un 99.5% de precisión en el proceso (Business Insider, 2025). La arquitectura que hace que esto funcione es la extracción con IA con un umbral de confianza: los campos por encima del umbral pasan directamente; los que están por debajo se marcan para revisión humana.
Qué tener en cuenta: cumplimiento de HIPAA. Si utiliza un VLM basado en la nube, confirme el BAA (Acuerdo de Asociado Comercial) del proveedor y sus prácticas de manejo de datos. La implementación local puede ser necesaria para ciertas instituciones.
Informes diarios de construcción y registros de campo
Los capataces de construcción completan informes diarios a mano, a menudo en el sitio, con mal tiempo y con un bolígrafo quedándose sin tinta. Estos informes contienen observaciones de seguridad, horas de trabajo, uso de equipos, entregas de materiales y notas de incidentes. Son legalmente significativos (los requisitos de nómina certificada Davis-Bacon en EE. UU. exigen un mantenimiento de registros específico) y operativamente críticos (la facturación retrasada significa flujo de caja retrasado).
Pista recomendada: extracción basada en VLM con procesamiento por lotes. Una empresa de construcción típica procesa de 20 a 100 informes diarios por semana, cada uno de diferentes capataces con diferentes escrituras. La capacidad de procesamiento por lotes — subir todos los informes a la vez y obtener una única hoja de cálculo consolidada — es la diferencia operativa entre una herramienta que realmente usará y una que queda en un video de capacitación.
Qué tener en cuenta: contenido mixto. Los formularios de construcción casi siempre combinan etiquetas impresas ("Fecha", "Trabajo #", "Capatáz") con entradas manuscritas. El OCR tradicional falla con esta combinación. Asegúrese de que su enfoque elegido maneje ambos en una sola pasada.
Documentos Históricos y Archivos
Bibliotecas, agencias gubernamentales y organizaciones genealógicas están digitalizando siglos de registros manuscritos: certificados de nacimiento, registros matrimoniales, formularios de censo, registros de servicio militar. La Biblioteca Wilson de la Universidad de Carolina del Norte utiliza HTR asistido por IA con validación humana colaborativa para transcribir documentos legales manuscritos de la era de Jim Crow. Los archivos gubernamentales han tomado el mismo camino, escaneando registros civiles que datan de más de un siglo y aplicando HTR sobre ellos, con revisores humanos resolviendo las entradas que el modelo no puede leer con confianza.
Trayectoria recomendada: HTR con entrenamiento de modelo personalizado + revisión humana. Cuando se trata con la escritura de una sola persona a lo largo de cientos de páginas (el registro de un párroco individual, los libros de contabilidad de un secretario específico), los modelos HTR entrenados a medida (como Transkribus) pueden alcanzar niveles de precisión que los modelos de propósito general no pueden igualar. Para colecciones con muchos escritores diferentes, la extracción basada en VLM proporciona una base sólida sin entrenamiento, pero la revisión humana sigue siendo esencial: la evaluación de 2026 de la Biblioteca UVA sobre transcripción de IA en documentos de fuentes primarias concluyó que "estos eran algunos de nuestros materiales de origen primario más difíciles: cartas manuscritas, libros de contabilidad complicados, documentos con escritura cruzada" y que la precisión de la IA variaba drásticamente según el tipo de documento y su condición.
Qué tener en cuenta: Calidad de imagen. Tinta desvaída, papel amarillento, traspaso de tinta del reverso y escrituras no estándar (Fraktur, Sütterlin, escritura secretarial) afectan drásticamente la precisión. El preprocesamiento (enderezado, mejora de contraste, limpieza de fondo) es a menudo tan importante como el propio motor de reconocimiento.
Finanzas y Contabilidad: Libros de Contabilidad y Recibos Manuscritos
Pequeñas empresas, restaurantes y operaciones de servicio en campo aún generan recibos manuscritos, confirmaciones de entrega y entradas de contabilidad manuales. Un restaurante recibe facturas de proveedores con cantidades y precios manuscritos en los márgenes. Un conductor de reparto recoge comprobantes de entrega manuscritos. Un mecánico escribe los detalles de la reparación en una orden de trabajo en papel. La entrada manual de estos datos cuesta un estimado de $15–40 por documento cuando se consideran la mano de obra, la corrección de errores y los gastos generales de gestión (Constrafor, 2025).
Trayectoria recomendada: Extracción estructurada basada en VLM. Los resultados deben integrarse en software de contabilidad (QuickBooks, Xero, Sage), lo que significa que la extracción debe producir datos estructurados, no solo texto transcrito. La capacidad de definir columnas de salida una vez y procesar múltiples documentos manuscritos con el mismo esquema es lo que convierte la extracción de escritura manuscrita de una curiosidad en una reducción de costos operativos.
Qué tener en cuenta: Valores calculados. Un recibo manuscrito podría mostrar "Cant.: 3, Precio unit.: $12.50, Total: $37.50." Si la IA extrae los tres, eso es bueno, pero si el total manuscrito contiene un error aritmético, la extracción sin validación propaga el error. Los mejores pipelines de extracción permiten definir columnas calculadas (p. ej., "Total de línea = Cant. × Precio unitario") que la IA calcula durante la extracción, proporcionando una verificación cruzada contra el total manuscrito.
Logística y Servicio de Campo
Los conductores de reparto completan notas de entrega manuscritas con firmas, marcas de tiempo y notas de excepción ("dejado en la puerta trasera"). Los técnicos de campo completan informes de inspección manuscritos con casillas de verificación y comentarios narrativos. Los ajustadores de seguros redactan evaluaciones de reclamos manuscritas en los lugares de accidentes. Estos documentos se generan en el campo, a menudo en formularios de copia carbón, y deben ingresar rápidamente a los sistemas de oficina central.
Trayectoria recomendada: extracción basada en VLM con carga móvil. La capacidad de fotografiar un formulario manuscrito con un teléfono — sin escaneo, sin enderezado — y obtener datos estructurados es el avance operativo para los equipos de campo. Los puntos de referencia independientes muestran que los sistemas basados en VLM logran una precisión del 65–80% en fotos de teléfono de documentos manuscritos (frente a <20% para OCR tradicional), lo que hace que los flujos de trabajo móviles sean prácticos por primera vez.
Qué tener en cuenta: detección de casillas de verificación y firmas. Los formularios de campo a menudo combinan texto manuscrito con casillas marcadas, opciones circuladas y firmas. Si el sistema de extracción no puede identificar qué casilla se marcó o si hay un campo de firma presente, aún estará realizando una revisión manual parcial.
Cómo Evaluar una Herramienta de Extracción de Escritura Manuscrita: 6 Dimensiones
La mayoría de los marcos de evaluación para herramientas de extracción de documentos fueron escritos para texto impreso. La escritura manuscrita cambia los criterios de evaluación. Esto es lo que realmente importa.
Precisión en sus documentos, no en muestras del proveedor
Cualquier proveedor puede seleccionar muestras limpias. Exija probar con sus documentos reales: los desordenados, los manuscritos, los tomados con un teléfono con mala iluminación. Si el proveedor no le permite probar con sus propios archivos, aléjese.
Salida estructurada, no solo transcripción
¿La herramienta produce una hoja de cálculo con las columnas que usted definió, o produce un bloque de texto que luego necesita procesar? La primera reemplaza la entrada de datos; la segunda reemplaza la transcripción pero deja la entrada de datos intacta.
Manejo de contenido mixto
La mayoría de los documentos reales combinan etiquetas impresas con entradas manuscritas. ¿Puede la herramienta leer ambos en una sola pasada, o requiere pasos de procesamiento separados para texto impreso y escritura manuscrita? Esto último añade complejidad al proceso que dificulta la adopción.
Capacidad de procesamiento por lotes
Procesar un documento manuscrito es una demostración. Procesar 50 a la vez y obtener una sola hoja de cálculo consolidada es un flujo de trabajo. La capacidad de procesamiento por lotes —subir múltiples archivos, procesarlos con las mismas definiciones de columnas, obtener una tabla de salida— es lo que separa la evaluación de la adopción.
Sin entrenamiento ni configuración previa
Si la herramienta requiere que recolecte muestras de escritura manuscrita, anote campos o entrene un modelo antes de que funcione, pregunte cuánto tiempo toma y si es sostenible a medida que cambian sus fuentes de documentos. Algunas herramientas (Nanonets, algunos motores ICR) requieren 10 o más muestras anotadas por tipo de documento. Las herramientas sin plantilla que funcionan desde el primer uso omiten este paso por completo.
Costo total, no costo por página
Calcule la ecuación completa: costo de extracción + trabajo de corrección a su tasa de error real. Una herramienta de $0.001/página que requiere 30% de corrección manual cuesta más que una de $0.03/página que requiere 5% de corrección. Haga los cálculos con sus volúmenes antes de comparar precios.
Preguntas frecuentes: Reconocimiento de escritura manuscrita que la gente realmente hace
¿Puede la IA manejar escritura cursiva y letras de molde en la misma página?
Sí — y aquí es precisamente donde los sistemas basados en VLM superan al OCR tradicional y al ICR. Una página con encabezados de sección impresos, texto corrido en cursiva y notas al margen en letra de molde se lee en una sola pasada con un VLM, porque el modelo lee semánticamente (comprendiendo el significado) en lugar de intentar comparar formas de caracteres. El OCR tradicional y el ICR tratan el texto impreso y la cursiva como tareas de reconocimiento separadas que requieren motores distintos. Para profundizar en esta capacidad, consulte nuestra comparación directa entre el reconocimiento de escritura manuscrita con IA y el OCR tradicional.
¿Qué precisión puedo esperar de forma realista con escritura cursiva?
En cursiva limpia y legible escaneada a 300 DPI: 85–91 % con herramientas especializadas de ICR/HTR, 75–90 % con extracción basada en VLM. En cursiva desordenada y apresurada: espere 65–80 % con las mejores herramientas. En cursiva en fotos de teléfono de baja calidad: 60–75 %. Ninguna herramienta alcanza el 99 % en cursiva en condiciones del mundo real — quien afirme lo contrario está midiendo con muestras seleccionadas. El enfoque práctico es usar la extracción para campos estructurados (donde la IA rinde mejor) y reservar la revisión humana para secciones de texto narrativo donde la precisión es crítica.
¿Puede el reconocimiento de escritura manuscrita funcionar en documentos históricos con tinta desvanecida?
Sí, pero el flujo de trabajo importa más que el motor de reconocimiento. El éxito con documentos históricos depende de: (1) escaneo de alta resolución (se recomienda 600 DPI, no 300), (2) preprocesamiento — mejora de contraste, enderezado, eliminación de ruido de fondo, (3) elección del motor de reconocimiento — HTR con entrenamiento personalizado en escrituras similares si la colección tiene caligrafía consistente, extracción basada en VLM si hay muchos escritores distintos. Los proyectos gubernamentales y académicos de digitalización reportan sistemáticamente que la revisión con supervisión humana es esencial para documentos históricos — la IA maneja la mayor parte del trabajo, los humanos verifican los campos críticos. La evaluación de 2026 de la Biblioteca de la UVA encontró que "la precisión de la IA variaba drásticamente según el tipo de documento y su condición", confirmando que los documentos históricos siguen siendo la categoría más difícil.
¿Necesito entrenar la IA con mi escritura?
Para extracción basada en VLM: no. Estos sistemas están diseñados para funcionar desde el primer uso con cualquier estilo de escritura — leen semánticamente, no comparando con muestras de entrenamiento. Para herramientas de ICR/HTR: a veces. Herramientas como Transkribus permiten entrenar modelos personalizados, lo que puede aumentar la precisión si tiene cientos de páginas de un mismo escritor. Para OCR tradicional: no, porque entrenar no ayudará — estos motores no pueden manejar escritura manuscrita de todos modos. La disyuntiva es que los modelos HTR entrenados a medida pueden lograr mayor precisión con un escritor específico, pero requieren esfuerzo de entrenamiento inicial, mientras que los sistemas basados en VLM funcionan de inmediato con cualquier escritor, pero alcanzan un máximo de ~90 % en cursiva. Elija según procese un estilo de escritura consistente a gran escala o muchos estilos diferentes.
¿Puede la IA extraer datos de formularios manuscritos a Excel, o solo convertir escritura manuscrita a texto?
Esto depende completamente de la herramienta. La mayoría de las herramientas de OCR para escritura manuscrita solo producen texto: transcribirán un formulario manuscrito pero no separarán "Fecha: 15 de junio" en una columna de Fecha y "Monto: $342" en una columna de Monto. Las herramientas de extracción basadas en VLM (como ImageToTable.ai) están diseñadas específicamente para producir resultados estructurados en hojas de cálculo. Usted define las columnas que desea — "Fecha," "Monto," "Nombre del Cliente," "Notas" — y la IA extrae los valores correspondientes de cada documento en esas columnas, produciendo una tabla donde cada fila es un documento y cada columna es un campo. Esto es extracción, no transcripción — y es la capacidad que hace que la automatización de datos manuscritos sea práctica para flujos de trabajo de contabilidad, logística y operaciones. Para la guía práctica, consulte cómo extraer datos manuscritos directamente a Excel.
¿Es suficiente el OCR gratuito (Tesseract, Google Keep) para escritura manuscrita?
Para uso rápido y no crítico — capturar una lista de compras o una nota breve — las herramientas gratuitas funcionan adecuadamente con letras de molde claras. Para cualquier aplicación empresarial que involucre escritura cursiva, letra desordenada, o donde la precisión importe: no. Tesseract logra ~45% de precisión de palabras en escritura cursiva. Google Keep maneja escritura de molde clara mucho mejor que la cursiva. La brecha entre las herramientas gratuitas y las soluciones de pago es más amplia en el reconocimiento de escritura manuscrita que en cualquier otra categoría de OCR, porque los modelos de IA específicos para escritura manuscrita requieren datos de entrenamiento y cómputo sustanciales que las herramientas gratuitas no pueden proporcionar económicamente. Si su caso de uso es "necesito encontrar una palabra en mis notas manuscritas," las herramientas gratuitas podrían ser suficientes. Si es "necesito extraer 50 campos de 100 formularios manuscritos a una hoja de cálculo con una tasa de error <5%," necesita una solución de pago.
Lo que viene después: el horizonte 2027–2028
La transformación de 2023–2026 en el reconocimiento de escritura manuscrita fue impulsada por los LLM que aprendieron a leer semánticamente. El próximo cambio — ya visible en la investigación, pero aún no en las herramientas de producción — estará impulsado por tres avances:
Modelos multimodales que extraen, validan y razonan en una sola pasada. Las herramientas actuales separan la extracción ("¿qué dice esta página?") de la validación ("¿tiene esto sentido?"). Los modelos emergentes harán ambas cosas simultáneamente: extraer los elementos de línea de una factura mientras verifican que la suma de los totales de línea coincida con el total del encabezado, señalando discrepancias sin un paso de validación separado. Esto reduce el flujo de extracción más revisión a un solo paso para documentos rutinarios.
Reconocimiento de escritura manuscrita explicable para industrias reguladas. Los usuarios de salud, legales y gubernamentales necesitan saber por qué la IA leyó un campo particular como "$500" y no "$600" — especialmente cuando la escritura es ambigua. La investigación sobre IA explicable para el procesamiento de documentos está avanzando, con la puntuación de confianza a nivel de carácter (en lugar de a nivel de documento) acercándose al uso en producción. Esto hará que la extracción con IA sea auditable para flujos de trabajo de cumplimiento que actualmente requieren revisión humana al 100%.
Procesamiento en el dispositivo para uso en campo. Ejecutar el reconocimiento de escritura manuscrita localmente en un teléfono — sin carga en la nube, sin requisito de conectividad, resultados instantáneos — es técnicamente factible con modelos cuantizados más pequeños. La disyuntiva entre precisión y velocidad/latencia se está reduciendo. Para los equipos de servicio en campo, construcción y logística que necesitan resultados de extracción antes de abandonar el sitio de trabajo, el procesamiento en el dispositivo desbloqueará flujos de trabajo que las herramientas dependientes de la nube no pueden soportar.
La dirección es clara: el reconocimiento de escritura manuscrita se está convirtiendo en un problema resuelto para la extracción estructurada de tipos de documentos comunes, y se acerca al territorio de "suficientemente bueno con revisión" para las categorías más difíciles (documentos históricos, entradas muy degradadas). El ciclo de inversión tecnológica todavía está en su fase temprana de aceleración. Las herramientas disponibles en 2028 harán que las mejores herramientas de hoy parezcan lo que Tesseract nos parece a nosotros ahora.
La conclusión para cualquiera que evalúe la extracción de escritura manuscrita en 2026:
No deje que la decepción pasada con el OCR tradicional moldee sus expectativas sobre lo que es posible ahora. Las tres vías tecnológicas — OCR tradicional, ICR/HTR y extracción semántica basada en VLM — son enfoques fundamentalmente diferentes con distintos techos de precisión, distintos formatos de salida y distintos perfiles de costo. La vía correcta depende de sus documentos. La vía incorrecta — que casi siempre es el OCR tradicional para cualquier documento que contenga escritura manuscrita — cuesta más que la vía correcta, tanto en dinero como en tiempo. Pruebe con sus documentos reales, calcule el costo total incluyendo la mano de obra de corrección y asegúrese de que la herramienta que elija produzca salida estructurada, no solo texto transcrito.
Suba un documento manuscrito — escriba las columnas que necesita — obtenga una hoja de cálculo estructurada en segundos. Sin entrenamiento, sin plantillas.