Telegramの暗号通貨ウォレット:
チャットのスクリーンショットからアドレスと金額を取得
暗号通貨のTelegramグループ — トレードシグナル、P2Pマーケットプレイス、NFTコミュニティ — で、誰かがチャットにウォレットアドレスを送り、別の誰かが金額を送り、取引を記録するためにスクリーンショットを撮ります。アドレス自体は42文字の16進数文字列、または大文字小文字が混在するBase58文字列です。打ち直すときに1文字でも間違えると、資金は別の場所へ送られます。チャージバックもなければ、カスタマーサービスの電話番号もありません — ブロックチェーンはアドレスが示す通りに実行されるだけです。ミスを犯す最速の方法は、コピーペーストや、このようなアドレスを扱うように設計されていないツールに頼ることです。これは支払いスクリーンショットの抽出が見た目より難しいのと同じ問題です — ソースはチャットメッセージであり、構造化されたドキュメントではなく、重要なフィールド(アドレスや金額)はフォームではなく会話の中にあります。
重要なポイント
- Telegramのスクリーンショットからウォレットアドレスを読み取るためにOCRを信頼しています — それは単なる42文字の文字列で、最も基本的なテキスト抽出タスクです。
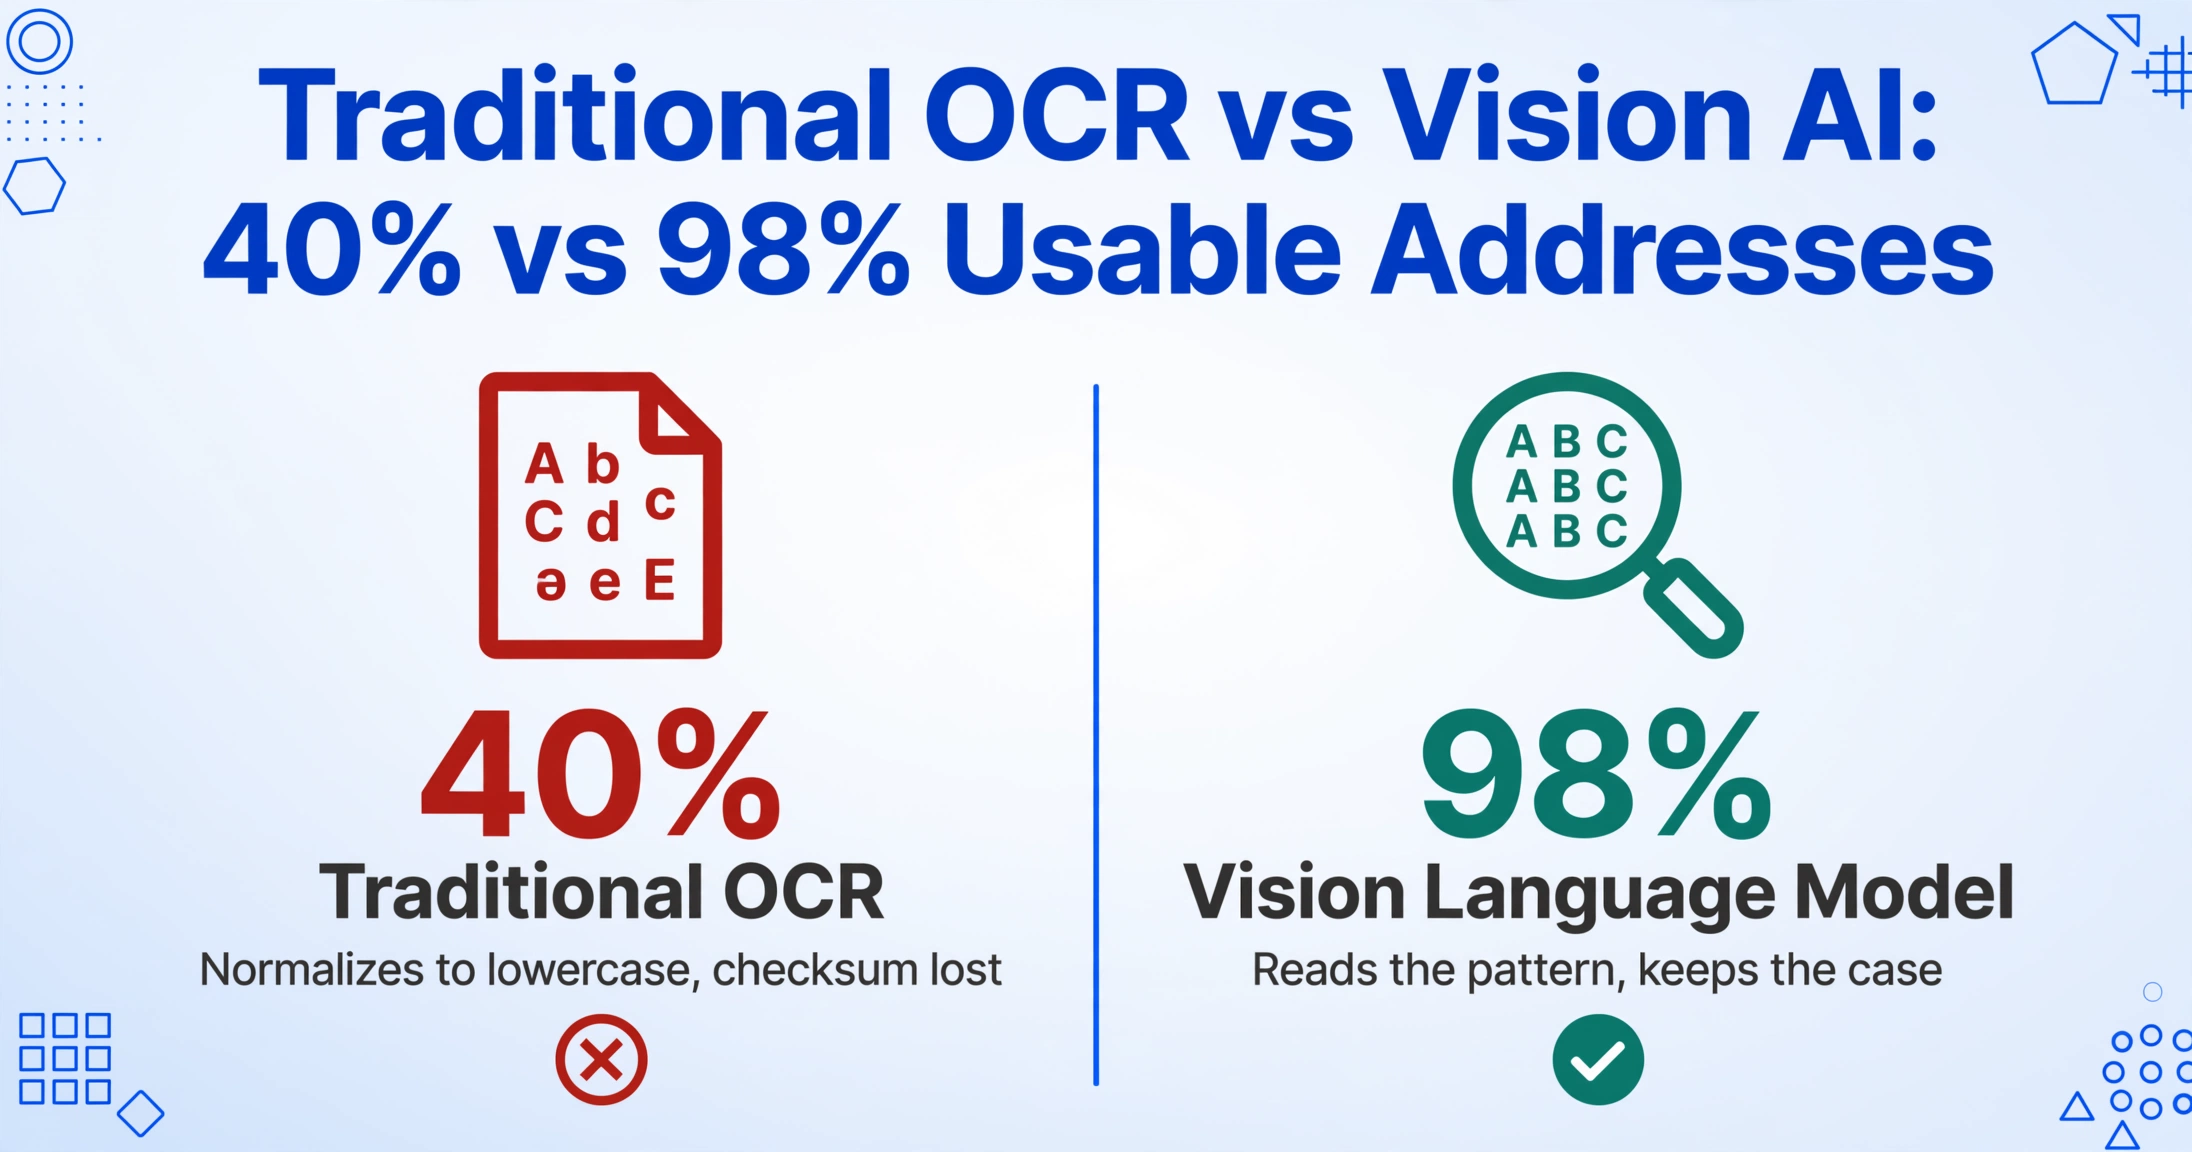
- しかしOCRは出力を静かに小文字に正規化します — EthereumのEIP-55チェックサムを剥がし、大文字小文字を区別するSolanaアドレスを壊し、圧縮されたスクリーンショットで0/O/l/Iを混同します。TRM Labsはわずか40%の実用精度しか測定できませんでした。
- ビジュアルAIは構造パターンでアドレスを読み取ります — 0xの後に40文字の16進数が続けばEthereum — ピクセルの推測ではなくフォーマット制約によって正確な大文字小文字を保持し、文字を曖昧さなく識別します。同じスクリーンショットで98%の精度です。
Telegramの暗号資産スクリーンショットの実際の見え方
Telegramのチャットで共有される一般的な暗号資産アドレスには、構造化されたフォームやラベル付きフィールド、QRコードラッパーは付いていません。誰かが文字列をメッセージボックスに入力または貼り付けて送信します。アドレスはチャットバブルに表示されます。「これが私のETHアドレスです」と上に書かれていることもあれば、文字列だけが単独で表示されることもあります。これが支払い指示の場合、金額は別のメッセージまたは同じ行に「0.5 ETH to 0xAb5801a7D398351b8bE11C439e05C5B3259aeC9B」のように書かれます。
アドレスの形式はブロックチェーンによって異なります:
- イーサリアムおよびEVMチェーン(ETH、BSC、Polygon、Arbitrumなど) —
0xの後に40文字の16進数(0-9、a-f)が続き、合計42文字。例:0xAb5801a7D398351b8bE11C439e05C5B3259aeC9B。ネットワーク上では大文字小文字を区別しませんが、EIP-55チェックサムアドレスは大文字と小文字が混在します。 - ビットコイン —
1(レガシーP2PKH)、3(P2SH)、またはbc1(SegWit、Bech32)で始まります。26〜62文字。一部の形式(P2SH、P2PKH)は大文字小文字を区別します。Bech32(bc1...)は大文字小文字を区別しませんが、すべて小文字またはすべて大文字である必要があります。 - Solana — Base58エンコード、32〜44文字。大文字小文字を区別します。例:
7EcDhSYGxXyscszYEp35KHN8vvw3svAuLKTzXwCFLtV2。 - Tron(TRX) —
Tで始まり、Base58、大文字小文字を区別します。 - Monero(XMR) —
4または8で始まり、95文字。大文字小文字を区別します。
注目すべき重要な点:これらの形式はすべて、特定の視覚的パターン(一貫したプレフィックス、予測可能な文字セット、既知の範囲内の長さ)を使用しています。経験豊富な暗号資産ユーザーの目は「これはETHアドレスのように見える」と一目で認識しますが、その認識を正しく入力された文字列に変換することは、20枚のスクリーンショットを処理する場合にはまったく別の問題です。
「コピー&ペースト」問題:手動操作は安全ではない理由
明白な方法は、Telegramのメッセージからアドレスをコピーして、ウォレットやスプレッドシートに貼り付けることです。問題は、この単純な操作 — 一度のCtrl+C — が、それを悪用するために設計されたクリップボードハイジャッカーマルウェアのエコシステム全体の中心にあることです。
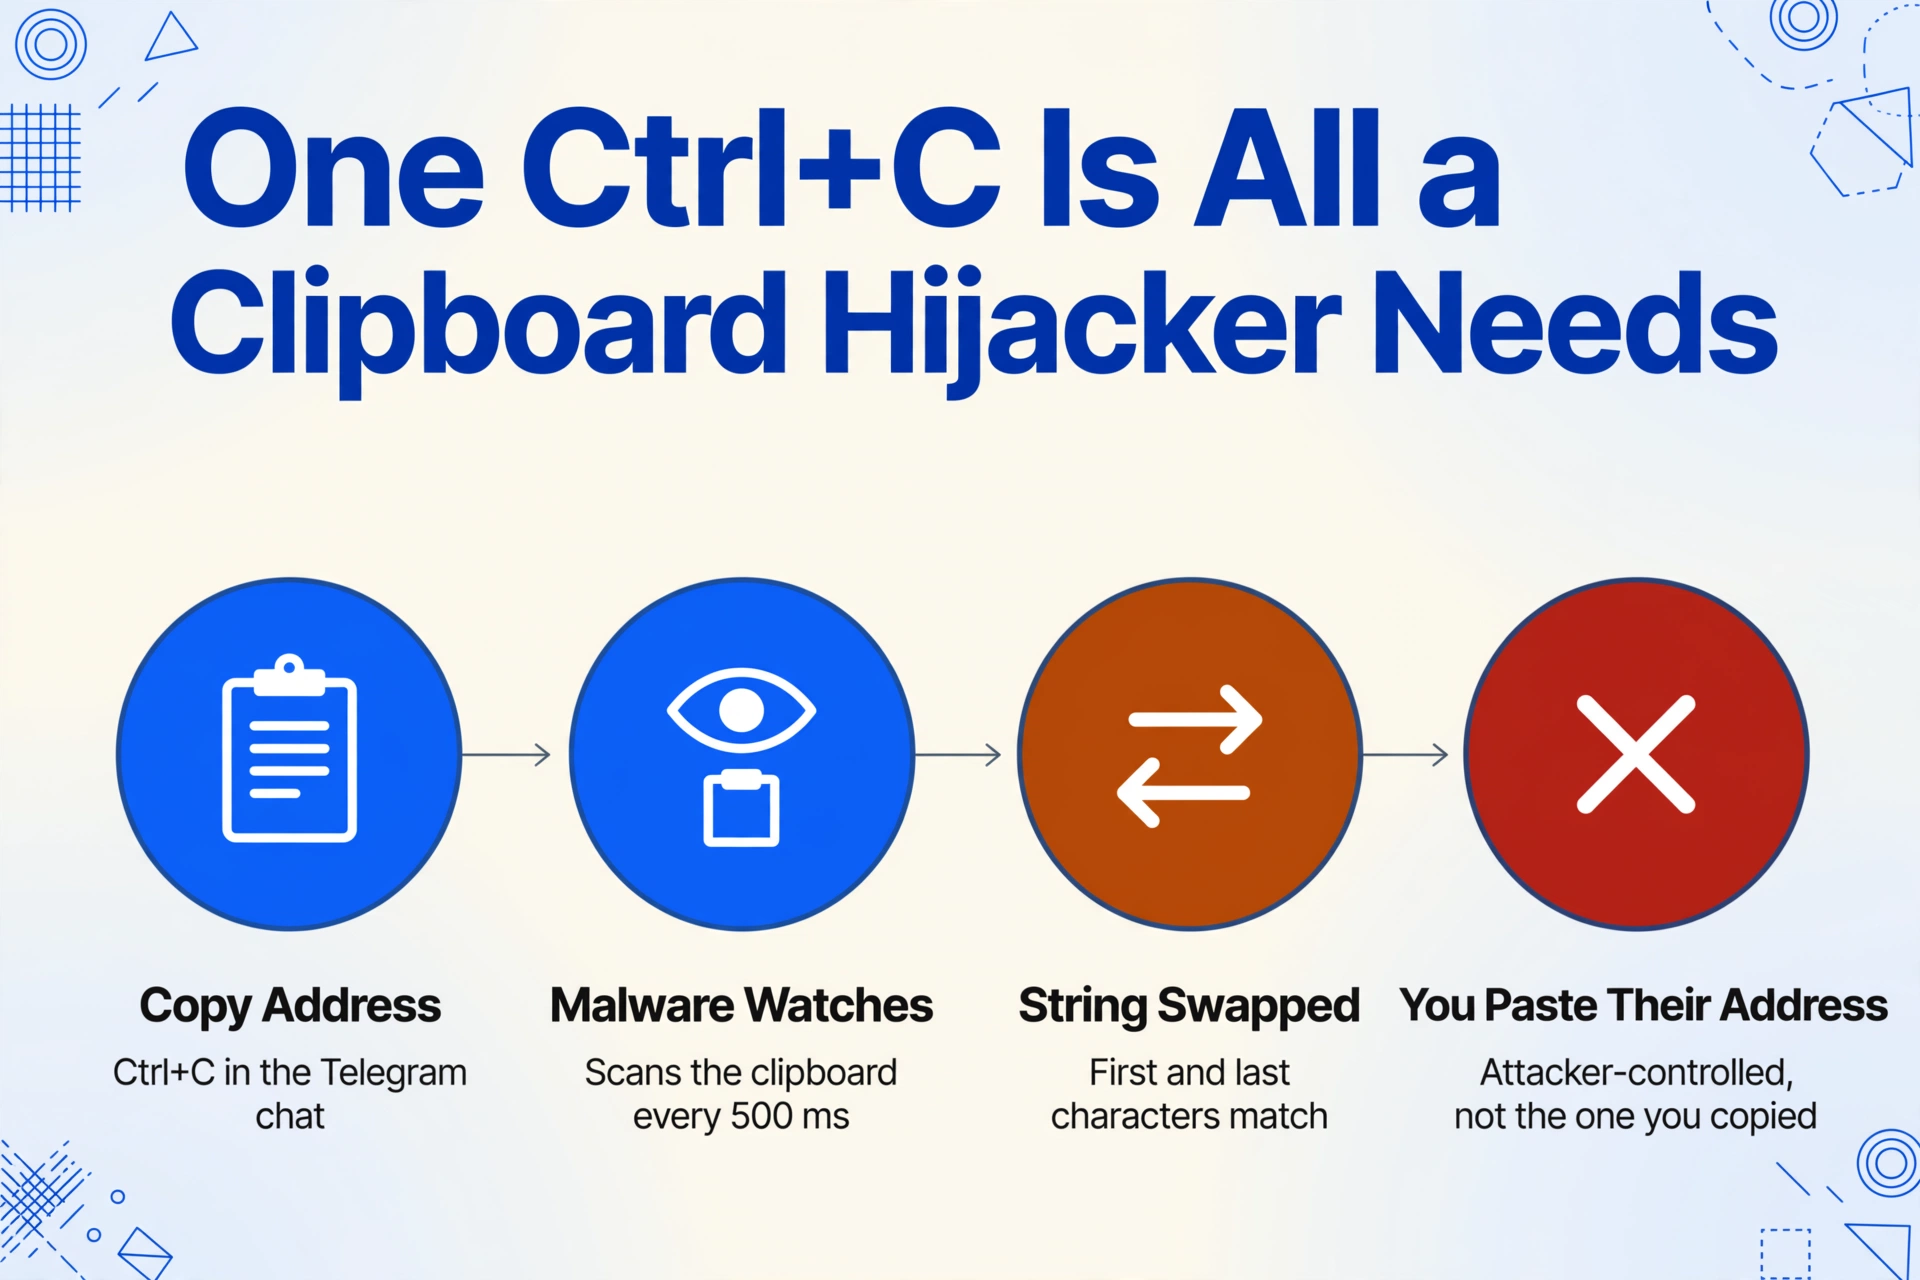
Laplas ClipperやMasad Stealerのようなクリップボードハイジャッカーは、バックグラウンドで静かに動作し、暗号通貨アドレスのように見える文字列をシステムのクリップボードで監視します。それらを検出すると、貼り付ける前に攻撃者管理のアドレスに置き換えます。置き換えられたアドレスは、元のアドレスと同じ文字で始まり終わるように巧妙に作られていることが多く、最初と最後の数文字を一目見ただけではすり替えに気づきません。
2026年2月、MicrosoftはTrojan:Win32/CryptoBandits.Aを公開しました。これはUSB経由で拡散するワームで、500ミリ秒ごとにクリップボードをチェックし、Bitcoin、Ethereum、Tron、Moneroのウォレットアドレスを探します。それらを攻撃者のアドレスに置き換え、盗んだデータをポータブルTorクライアント経由で送信します。このキャンペーンは少なくとも2026年2月から活動しており、USBドライブ上の悪意のあるショートカットファイルを介してマシンに感染させていました。
マルウェアがなくても、手動のコピー&ペーストはエラーが発生しやすいものです。ウォレットアドレスには人間が読める意味がありません。米国の電話番号や住所のように「声に出して読む」ことも、頭の中の参照と照合することもできません。42文字の16進数文字列で1文字を打ち間違えると、有効だが異なるアドレスが生成され、ブロックチェーンはそのアドレスへの送金を問題なく実行します。その資金は戻ってきません。
従来のOCRがウォレットアドレスで失敗する理由
従来のOCR — スキャナー、PDFツール、多くの「画像からテキスト」アプリに組み込まれている技術 — は、個々の文字の形を認識して文書を読み取ります。これは、構造化された文書の印刷テキスト(入力済みの請求書、標準化されたフォーム、機械印字の住所)向けに設計されています。TelegramのスクリーンショットにOCRツールを実行すると、テキストの文字列が生成されますが、暗号通貨ウォレットにとって重要な一貫した問題があります。
大文字と小文字が最大の問題です。 ほとんどのOCRエンジンは、デフォルトで出力を小文字に正規化します。イーサリアムアドレスの場合、これではアドレスは壊れません(ネットワークは大文字小文字を区別しない)が、ウォレットがアドレスが正しく入力されたかを検証するのに役立つEIP-55チェックサム情報が失われます。BitcoinのP2SHアドレス(3で始まる)の場合、大文字小文字を間違えると実際にアドレスが壊れます — チェックサムが失敗し、トランザクションがバウンスされます — しかし、その頃にはスクリーンショットから正しい文字列をすでに失っています。完全に大文字小文字を区別するSolanaとTronの場合、小文字に正規化された出力は単に間違っています。
TRM Labs(ブロックチェーンインテリジェンス企業)は、この問題を実際に記録しました。スクリーンショットから暗号通貨アドレスとトランザクションハッシュを抽出する際の従来のOCR精度を測定したところ、約40%の実用精度であることがわかりました。視覚言語モデル(VLM)アプローチに切り替えた後、精度は98%に向上しました。その違いは、より良い文字認識ではなく、VLMが読み取っているものの構造を理解したことでした。
ここにはもっと深い違いがあります。従来のOCRはスクリーンショットをピクセルのグリッドとして読み取り、各クラスターを既知の文字形状に一致させようとします。0xがイーサリアムアドレスのプレフィックスであることは認識せず、ゼロ、小文字のxを見て、その後各文字を個別に推測しようとします。フォントが珍しい場合、背景が暗い場合、圧縮で文字が少しぼやけている場合 — OCRは間違った推測をします。
視覚AIがアドレスを読み取る仕組み — 文字単位ではなくパターン単位
視覚ベースのAIは、同じスクリーンショットを異なる方法で処理します。このモデルは何百万ものドキュメント画像でトレーニングされており、テキストをその視覚的なコンテキストの中で理解します。0xの後に[0-9a-fA-F]のセットからなる40文字が続くのを見ると、イーサリアムのウォレットアドレスのパターンを認識します。すべてのグリフを完全な光学解像度で識別する必要はなく、アドレスのフォーマット制約を利用して曖昧な文字を補完します。
このパターンベースのアプローチから、いくつかのフォーマット固有の動作が生まれます:
- プレフィックス認識 — AIは
0x、bc1、T、4をアドレスのプレフィックスとして識別し、残りの文字列が対応するフォーマットに一致することを期待します。これにより、改行でアドレスが分割されたり、チャットバブル内のスペースをフィールドの境界と誤認したりすることを防ぎます。 - 大文字小文字の保持 — モデルはアドレスを視覚的なパターン(大文字は小文字とは異なる視覚的特徴を持つ傾向があります)として読み取るため、元の大文字小文字を保持します。
0xAb5801a7は0xab5801a7にならず、0xAb5801a7のままです。 - 文字の曖昧性解消 —
0(ゼロ)とO(大文字のオー)、l(小文字のエル)とI(大文字のアイ) — これらのペアは多くのフォントでほぼ区別がつかず、OCR出力で常にエラーの原因となります。視覚AIは、アドレスフォーマットの期待される文字セットに対して文字をチェックすることでこれらを解決します。イーサリアムの16進数アルファベットにはOやIはありません。そのため、モデルが0かOの可能性がある形状を検出した場合、フォーマット制約に基づいて0を選択します。
このアプローチが最も重要になるのは、スクリーンショットの品質が理想的でない場合です。スマートフォンで撮影されたTelegramのスクリーンショットが、チャットアプリで圧縮され、さらに再スクリーンショットされる — これは誰かがアドレスをあるチャットから別のチャットに転送する際によくあるシナリオです — と、文字単位のOCRが信頼できなくなるほど解像度が低下します。パターンベースの抽出は、完全なピクセルの明瞭さに依存せず、アドレスフォーマット自体をシグナルとして使用するため、安定した状態を保ちます。
実際の違い:従来のOCRツールは暗号通貨アドレスを読み取り、各文字を1つずつ推測します。視覚AIはアドレスフォーマットを読み取り、その構造ルールを適用し、大文字小文字とチェックサムを含む正確な文字列を抽出します。
スクリーンショットからスプレッドシートへ:両方のフィールドを取得する
アドレスと金額 — これらは、Telegramのチャットから暗号通貨取引を追跡する人にとって重要な2つのデータです。金額は送信されたもの(または要求されたもの)を示し、アドレスは送信先を特定します。これらが揃うことで、「この日付に、この金額のETHがこのアドレスに送信された」という完全な記録が形成されます。
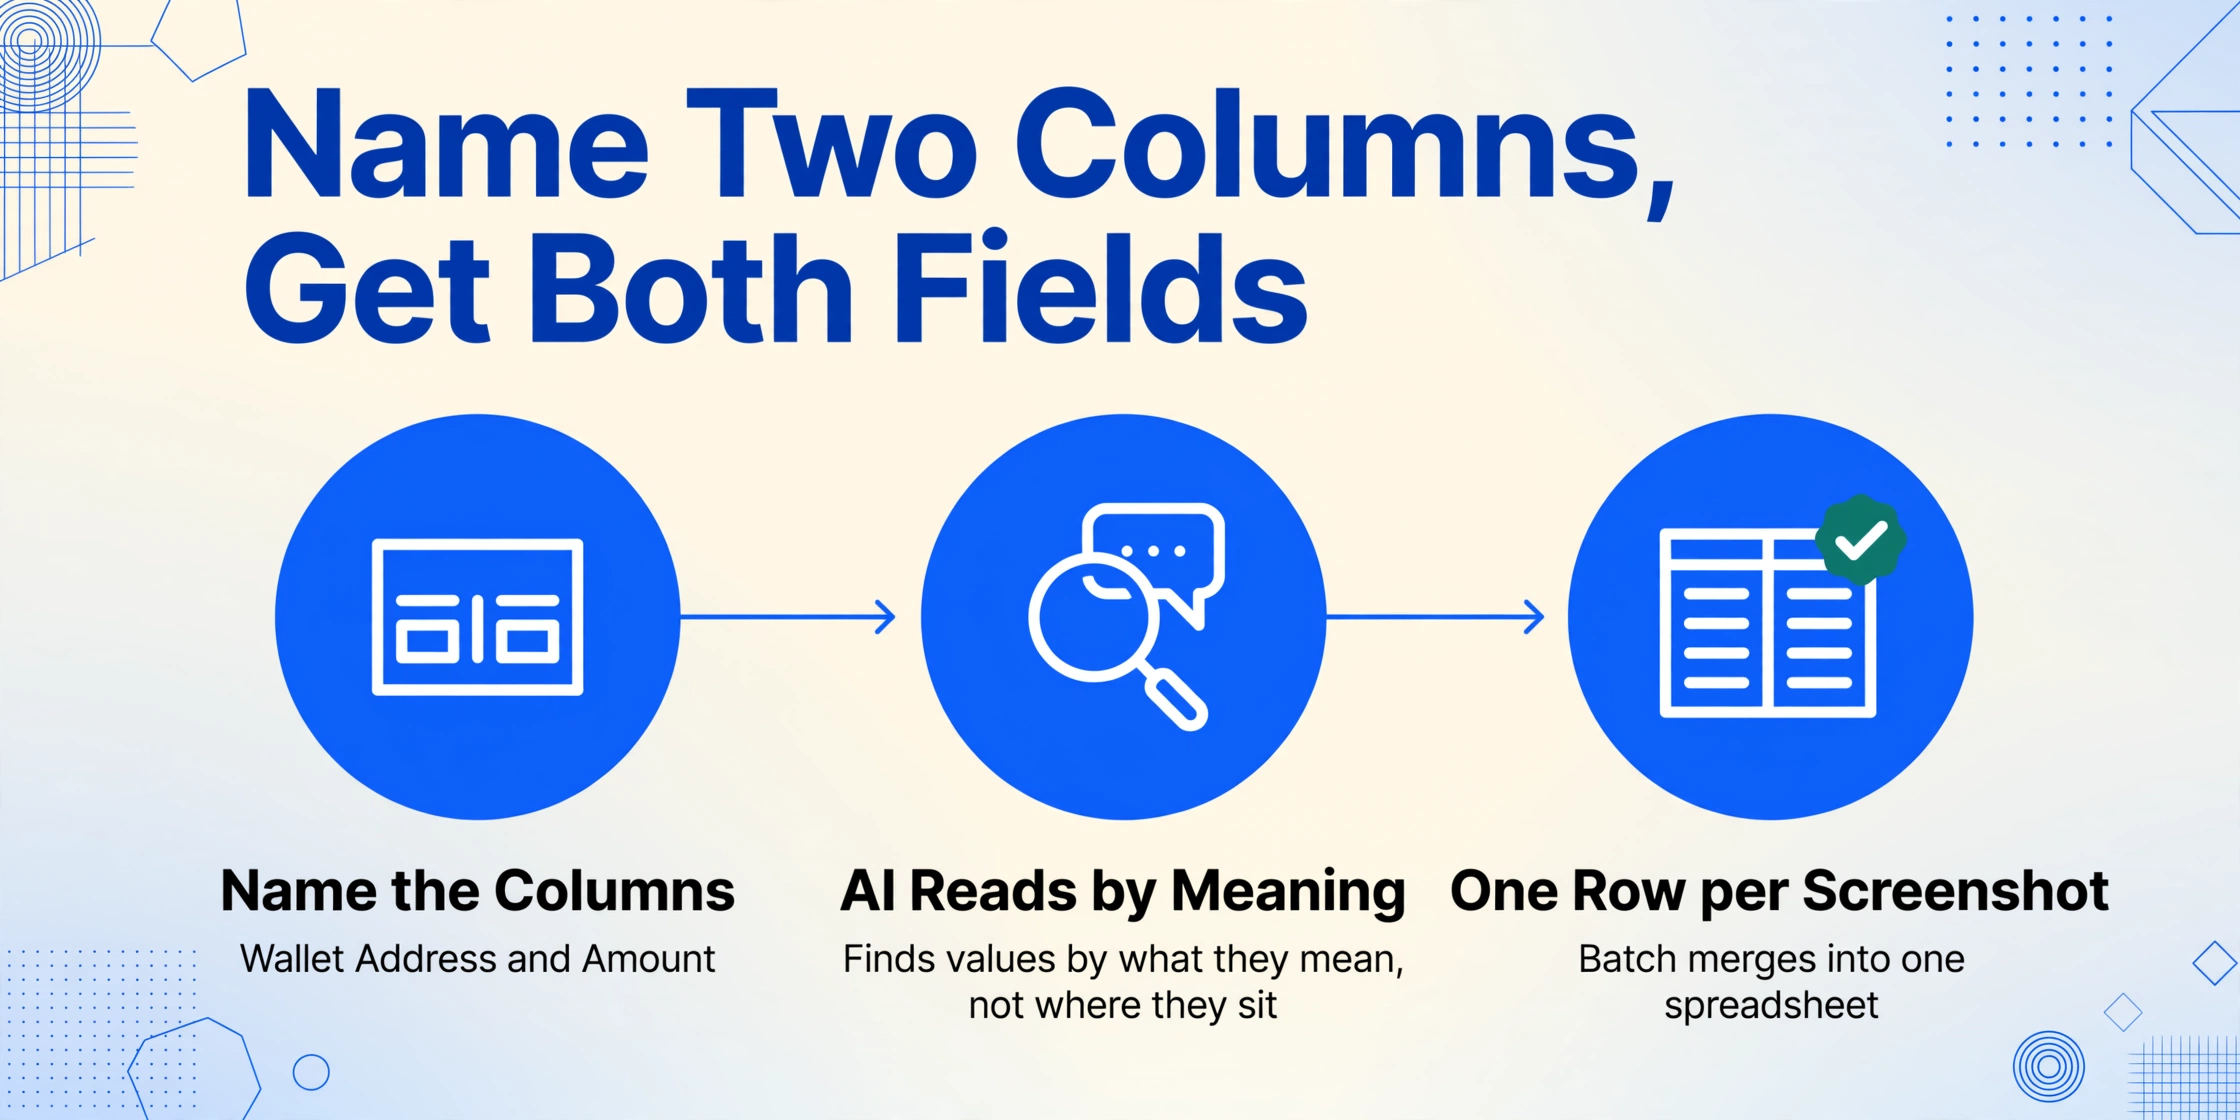
ImageToTable.aiはこれをカスタム列抽出で処理します。Telegramのスクリーンショットをアップロードしてツールが自動的に必要なものを判断してくれるのを期待するわけではありません。列に名前を付けます:ウォレットアドレスと金額。AIがスクリーンショットを読み取り、それらの意味的な説明に一致するテキストを特定し、テーブルに抽出します。
これは、各チャット形式にバウンディングボックスを描画したり解析ルールを定義したりする必要がある従来のデータ抽出ツールとは根本的に異なるワークフローです。Telegramのスクリーンショットでは、アドレスはチャットバブルのどこにでも表示される可能性があります — 左揃え、2行にまたがる、ラベルの有無など。金額は同じメッセージにある場合も、別のメッセージにある場合もあります。カスタム列抽出はレイアウトの問題を完全に回避します。値がページ上のどこにあるかではなく、何を意味するかで値を見つけるからです。
複数のスクリーンショットに適用する場合 — たとえば、1週間の間にトレーディンググループで共有された15個のTelegramウォレットアドレス — バッチ処理により結果が単一のテーブルに統合されます。各行には、アップロードした順序で1つのスクリーンショットのアドレスと金額が表示されます。手動での入力も、チャット履歴とメモ帳を照合する必要もありません。
クリーンな抽出のための実用的な注意点:
- 関連する領域にクロップする — スクリーンショットに上下の無関係なチャットメッセージが含まれる場合。AIはスクリーンショット全体を処理しますが、入力が狭いほど、無関係な会話からアドレスを取得する可能性が減ります。
- ユースケースに合わせて列に名前を付ける。「ウォレットアドレス」と「金額」が自然です。ネットワークも必要な場合は、「ネットワーク(ETH/BTC/SOL)」を列として追加します — AIがアドレスのプレフィックスを読み取り、ネットワークを推測できます。
- スクリーンショットに完全なアドレスを含める。チャットプレビューでメッセージが切り詰められている場合は、スクリーンショットを撮る前に展開してください。AIは表示されているものしか抽出できません。
よくある質問
AIはTelegramのスクリーンショットからあらゆる暗号ウォレットアドレス形式を抽出できますか?
はい。AIはアドレスをその構造パターン(プレフィックス、文字セット、長さ)で認識するため、形式固有のルールに依存しません。ETH(0x + 40桁の16進数)、BTC(1/3/bc1)、Solana(Base58)、Tron(Tプレフィックス)など、スクリーンショットに完全なアドレス文字列が表示されていれば正しく識別されます。
抽出されたアドレスは元の大文字小文字を保持しますか?
はい。ビジュアルAIは、スクリーンショットに表示されている通りの文字の大文字小文字を保持します。出力を小文字に正規化することが多い従来のOCRとは異なり、AIは各文字を視覚的なコンテキストで読み取り、元の大文字小文字を保持します。これは、Solana、Bitcoin P2SH、Tronなど大文字小文字を区別する形式にとって重要です。
スクリーンショット内でアドレスがQRコードとして表示されている場合はどうなりますか?
スクリーンショットにテキスト文字列ではなくQRコードが表示されている場合、アドレスはQRコードからデコードする必要があります。現在の抽出機能は画像から表示されているテキストを読み取ります。TelegramのチャットメッセージにアドレスとQRコードの両方が表示されている場合、AIはテキスト版を抽出します。QRコードのみが表示されている場合は、まずQRスキャナーでアドレスをデコードする必要があります。
複数のTelegramウォレットスクリーンショットを一度にバッチ処理できますか?
はい。複数のスクリーンショットを1つのバッチでアップロードし、列(ウォレットアドレス、金額)を定義すれば、AIがまとめて処理します。結果は1つのスプレッドシートに統合され、各行が1つのスクリーンショットに対応します。これは、Telegramチャットから大量のウォレットアドレスを扱う方(トレーディンググループのスクリーンショット、P2P支払い確認、送金記録など)のための主要なワークフローです。
AIはアドレス形式からネットワークを判別できますか?
部分的に可能です。アドレスのプレフィックスが強力な手がかりとなります。0xはEVMチェーン(Ethereum、BSC、Polygon、Arbitrumなど)、bc1はBitcoin SegWit、TはTronを示します。ただし、EVMアドレスは複数のチェーン間で同じように見えます。Telegramチャットからネットワークのコンテキストがわかっている場合は、「ネットワーク」列を追加してAIにアドレスのプレフィックスから推測させるか、確認時に手動で入力することができます。