ノーコードのデータクレンジングが対応できる範囲と
Pythonが必要になる範囲
ドキュメント抽出プロジェクトには、計画している作業の背後に、もう一つの作業が隠れています。アップロードが実行され、テーブルが表示され、その後も誰かが日付列を修正し、通貨記号を削除し、2つの仕入先名が同じベンダーかどうかを判断し、明細項目の合計が印刷された合計と一致するかを確認する必要があります。時間がかかるのはこの2つ目の作業です。AnacondaのState of Data Science調査(データ専門家2,360人を対象)では、回答者が時間の45%をデータの読み込みとクレンジングに費やしており、モデリングと可視化を合わせた時間よりも多いと報告しています 1。
クレンジングが繰り返し発生するようになると、Pythonスクリプトを書くのが反射的な対応になります。これは愚かな反射ではありません。スクリプトは思いつく限りのルールを表現でき、毎回同じように実行されます。しかし、抽出後のクレンジングの大半は「何でもできる」問題ではありません。フィールド単位の小さな変換の繰り返しであり、そのすべてをスクリプトの問題として扱うと、書く必要のなかったコードを保守することになります。重要な問いは「Pythonかノーコードか」ではなく、各変換がどのレイヤーに属するかです。
重要なポイント
- データが乱雑なためにPythonを導入するチームが多いが、乱雑さ自体は実際に重要なシグナルではない。
- 本当の判断基準は、データの見た目の乱雑さではなく、ルールが単一のフィールドを記述するものか、システム間の関係を記述するものかである。
- フィールド単位のクレンジングはフィールドが読み取られる場所で実行できるため、Pythonは価値のある結合や照合に集中できる。
抽出後データクリーニングに実際に含まれるもの
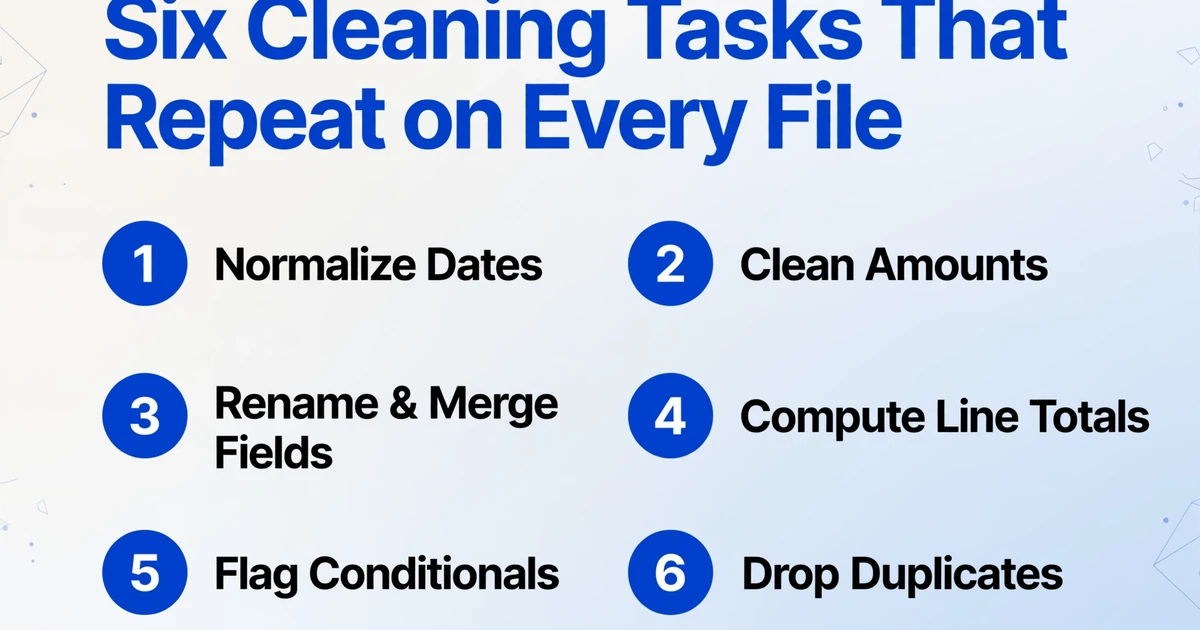
抽出後データクリーニングとは、生のフィールド値を下流システムが受け入れられる値に変換する作業です。ドキュメントは多様でシステムも異なるため、このタスクはチームを問わず繰り返し発生します。その大半は6つのカテゴリに分類できます。
- 日付と時刻の正規化。ドキュメントには
04/05/2026、5 Apr 2026、2026.04.05、「4月5日」などが混在します。列が単一の形式になるまで、並べ替え、経過日数計算、照合はすべて機能しません。 - 金額と数値のクリーンアップ。通貨記号、桁区切り記号、ヨーロッパ式の小数点カンマ、負数を表す括弧はすべて、数値であるべき中に含まれています。
$1.2Bや($47.99)は、変換されるまでテキストのままです。 - フィールドの名前変更と結合。ドキュメントには「お支払い額」とあり、システムでは「患者自己負担額」が必要な場合があります。ドキュメントでは住所が3行に分かれているのに、システムでは1つの列が必要な場合もあります。
- 明細行の集計。数量に単価を掛け、セクション内のすべての行を合計し、ページに印刷されなかった小計を算出します。
- 条件フラグ。合計が内訳の合計と一致しない場合、または請求書が予算しきい値を超えた場合に行にマークを付けます。
- 重複検出。ページ区切りをまたぐテーブルでは、同じ行が2回抽出され、誰も気づかないうちに小計が膨らむ可能性があります。
これらはまさに、Python後処理サンドボックスが処理するために作られたタスクです。また、これらはまさに、宣言型抽出ルールがスクリプトなしで処理できるタスクでもあります。この違いは、実務者がファイル間でPDFデータをExcelにきれいに取り込む方法を尋ねるときに説明するばらつきです。一部のソースは問題なくインポートできますが、他のソースは一貫した構造のない乱雑なテキストとして届き、手動コピーも汎用モデルもスケールしません。ある r/excelの一貫性のないPDFに関するスレッド が指摘している通りです。違いは、ルールがどこに存在し、6か月後に誰がそれを維持できるかです。
変換がスクリプトに属するかどうかの判断基準は、入力がどれほど乱雑かに見えるかではありません。ルールが単一のフィールドについて述べているのか、それともドキュメントとシステムの関係について述べているのかです。
Pythonスクリプトが正直な答えに感じられる理由
スクリプトを否定するのは不誠実です。なぜなら、一部の変換は確かにスクリプト向きだからです。ルールがこのドキュメントを別のドキュメントと比較する必要がある場合、複数のシステムからデータを結合する場合、外部サービスを呼び出す場合、または実行全体で状態を保持する場合、列ルールでは表現できず、スクリプトが適切な手段となります。
ドキュメント間のマッチング。 請求書がPO-4471を参照しているとします。その発注書が存在するか、金額が一致するか、商品がすでに支払われているかは、別のファイルまたは別のシステムにあります。
複数ソースの結合と照合。 明細書と元帳、請求書と発注書および納品書、3つのクライアントからの3つのエクスポートを1つのクリーンなテーブルに統合する場合などです。
外部ルックアップ。 リアルタイムの為替レート、現在の税率表、またはデータベースで管理しているマスターベンダーリストなどです。
ステートフルなオーケストレーション。 リトライ、部分的な失敗に基づく分岐、キュー、および実行済みの記録などです。
スクリプトはこれらの作業で真の強みを発揮します。再利用可能で、バージョン管理でき、テスト可能で、スケジュール実行も可能です。タスクが本当にスクリプト向きである場合、それをビジュアルワークフローとして再構築すると、多くの場合、同じスクリプトの劣化版ができあがります。
自動化コミュニティもほぼ同じ線上で線引きをしています。PythonとMakeおよびn8nに関するr/automationのスレッドでは、ビジュアルツールをオーケストレーションと制御に優れた抽象化レイヤーと表現しつつ、コードを書ける人にとって完全なノーコード化は後退であると同意しています。ロジックにはコードを、ステップ間の配線にはビジュアルツールを使うべきだと、そのスレッドは主張しています。
スクリプトが静かにコストを膨らませる場所
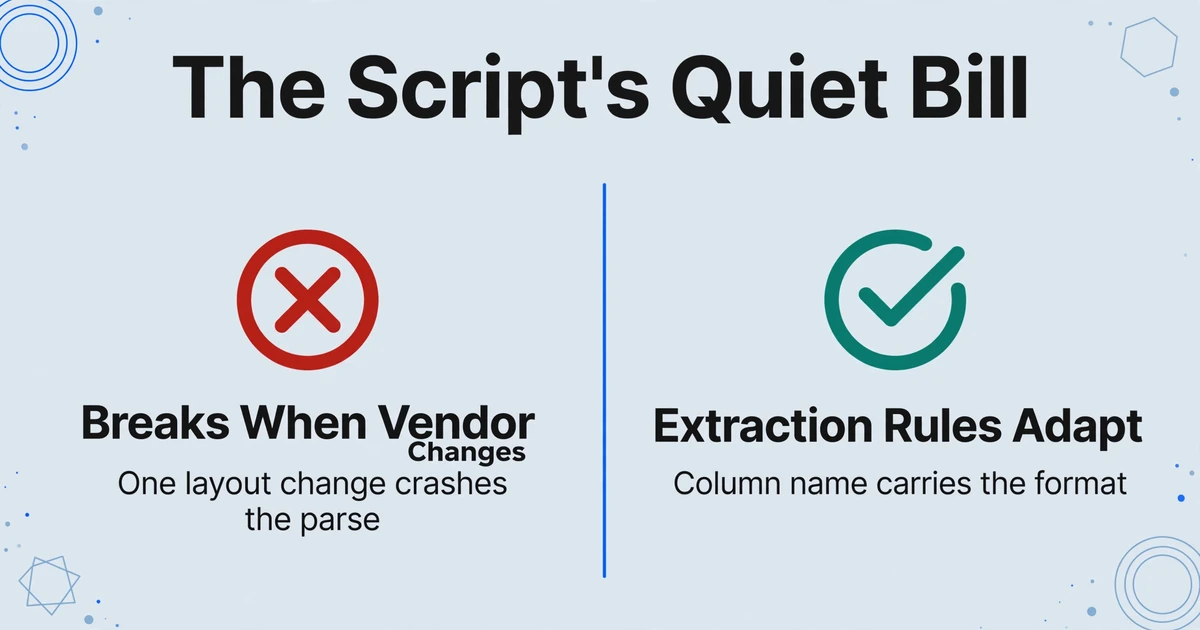
スクリプトは柔軟性の代償としてメンテナンスが必要になり、その請求書はプロジェクト計画には決して載らない形で届きます。
バージョン変更でパースが壊れる。 あるデータ専門家が r/TrueOffMyChestで まさにこの状況を語っています。Pythonスクリプトが6ヶ月間毎日の請求書処理を担当していましたが、あるベンダーが請求書のレイアウトを少し変更したところ、スクリプトは未処理のエラーでクラッシュし、作成者は手動プロセスを完全に忘れていました。スクリプトが悪かったわけではありません。対象としていたドキュメントが変わったために失敗したのです。
作成者だけが修正できる状態になる。 ドキュメント化されていないパースロジックは単一障害点です。その人が休暇を取ると、プロセスは待たされることになります。
依存関係が漂流する。 ライブラリのバージョンが変わり、マシンごとに環境が異なり、先四半期まで動いていたパイプラインが、誰も追跡していなかったアップグレード後に動かなくなります。
静かな失敗が最も高くつく。 クラッシュするスクリプトは目に見えます。しかし、正常に実行されて列に誤った値を書き込むスクリプトは見えず、それが誰にも疑問視されずに台帳に到達する結果となります。
フォーマットごとに専用スクリプトが必要になる。 ある仕入先の請求書に合わせた正規表現は、次の仕入先には転用できません。結局、ソースごとにスクリプトを管理することになり、その数は増える一方です。
仕入先が請求書を再設計するたびに編集が必要なスクリプトは、一度きりのセットアップではありません。変動する請求額が付くサブスクリプションです。
エディタを開く前に宣言的ルートがカバーする内容
宣言的ルートは変換を抽出ステップに移すため、テーブルが表示される時点で値は望ましい形になっています。ImageToTable.aiは、 AIデータ入力 ツールであり、これを3つの方法で実現し、それらが上記の6つのタスクファミリーをカバーします。
カスタム列抽出が最初の方法です。必要な列の名前を入力すると、AIはページ上の位置ではなく意味を理解して各値を特定します。列名がそのまま指示となるため、フォーマット要求を列名に含めることができます。列に「請求日 (YYYY-MM-DD)」と名前を付けると、ドキュメントがどの表記を使用していても、出力には正規化された日付が含まれます。「合計金額 (小数)」と名前を付けると、通貨記号とロケール区切り文字は、値がスプレッドシートに到達する前に解決されます。
計算列が2番目の方法です。計算列とは、同じドキュメント内の他のフィールドから抽出中に値が計算される列です。行レベルの算術、セクション内の全行の合計、条件付き結果、固定パラメータ、またはドキュメントに印刷されていない導出値を、この方法で定義できます。単純なルールは列名に直接記述できます。例えば 行合計 (数量 × 単価)。複数ステップの導出は、JSONルール形式で記述でき、列名を簡潔に保ちながらロジックを正確に維持できます。
インテリジェントなデータ後処理が3番目の方法です。このツールは、同じ抽出パス中に日付、金額、シリアル番号を指定した形式に標準化するため、エクスポートされたExcel、CSV、またはJSONは、追加のクリーンアップラウンドを必要とせずにすぐ使用できます。
6つのファミリーにマッピングすると、宣言的バージョンは具体的です。日付や金額は、列名内のフォーマットによって正規化されます。名前変更やマージは命名上の決定です。AIは各ドキュメントフィールドを意味によって出力名にマッピングするためです。行のロールアップや導出小計は計算列です。条件フラグも計算列です。例えば、抽出された合計がドキュメントが請求した金額と等しくない場合に差分を出力するものなどです。税率などの固定パラメータは、ドキュメントに含まれることなくルールに埋め込まれます。ページ区切りから生じる重複行は、マルチページマージによって処理され、分割されたページを1行に折りたたみ、競合する値をルールで解決します。
これは、 計算を抽出に移すためのガイド が請求書合計について展開しているのと同じ考え方であり、 検証ワークフロー は、依然として人間に属するチェックを引き継ぎます。
ファイルは安全に処理され、保存されることはありません。
このツールの価値は、思考を代行してくれることではありません。定型の計算とフォーマット処理がフィールドの読み取り時に行われることで、レビューが生の文字列ではなく回答から始められる点にあります。
境界線: 本当にコードが必要な場合
ここで境界線について正直に述べることは、きれいな説明よりも重要です。なぜなら、過大な主張に基づいて構築されたワークフローは、スクリプトと同じように失敗するからです。ImageToTable.ai は任意の Python を実行せず、スクリプト用サンドボックスも提供せず、ドキュメント間のフィールド対フィールドのマッチングも行いません。そのルールはフィールドレベルです。つまり、この値を正規化する、これらのフィールドからこれを計算する、このカテゴリを推論する、これらのページを1行にまとめる、といったものです。あるドキュメントを別のドキュメントやシステムと比較する必要があるものは、すべて抽出ステップの外側に留まります。
これにより、コードに属する作業の短く正直なリストが残ります。請求書を発注書や領収書と照合する、銀行明細を元帳と照合する、為替レートやマスターベンダーリストを参照する、ベンダー名を正規のレコードに解決する、リトライと状態管理を伴う多段階の作業を調整する、といったものです。これらは、列ルールに無理に組み込んでも簡単にはならず、そう装うことは、この記事が反対している脆さを再現するだけです。
このツールがコードと接するのは、引き渡しの時点です。v1 API はクリーンで構造化された JSON を返すため、ツール内で抽出と標準化を行い、その後、すでに一貫性のある値に対して独自のスクリプトを実行できます。組み込みのサンドボックスとこの分割アプローチのどちらを選ぶか検討している場合は、Airparser との比較でそのトレードオフを説明しています。フィールドレベルの作業に抽出時ルールを選択しても、データチームから Python がなくなるわけではありません。Python を本当に必要とする作業のために予約しておくのです。
今すぐ使える判断ルール
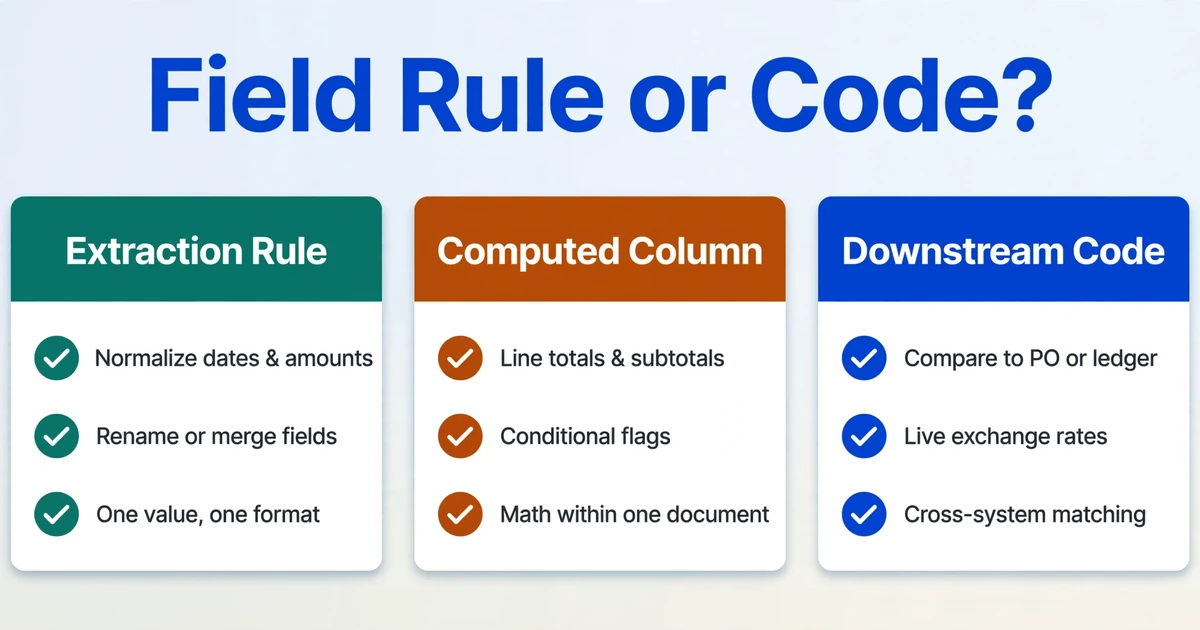
各変換を確認し、1つの質問をしてみてください。そのルールは「フィールド」を説明するものですか、それとも「ドキュメントとシステムの関係」を説明するものですか。フィールドのルールは抽出時に設定し、システムのロジックはコードに記述します。
| 変換 | 設定場所 | 理由 |
|---|---|---|
| 日付、金額、識別子の正規化 | 抽出ルール | 1つの値に対して、決定的な形式が1つあるため |
| フィールドの名前変更、結合、分割 | 抽出ルール | 出力列名がマッピングそのものだから |
| 行内の計算と行合計 | 計算列 | 抽出したフィールドに対する行内の計算だから |
| セクション小計または派生合計 | 計算列 | 1つのドキュメント内の複数行にわたる合計だから |
| 条件フラグ(合計が請求額と一致しない場合) | 計算列 | すでに抽出された値に対する条件だから |
| ページ区切りによる重複行 | マルチページマージ | 1つの論理ドキュメントのページをグループ化するため |
| この請求書を発注書と比較する | 後続コード | 2つ目のドキュメントが必要だから |
| 明細書と元帳の照合 | 後続コード | 別のシステム、状態、照合が必要だから |
| リアルタイム為替レートまたはマスターデータ参照 | 後続コード | 外部サービスが必要だから |
| ベンダー名を1つのマスターレコードに解決する | コードまたはデータツール | 管理された正規リストが必要だから |
変換をフィールドに関する文章として記述できるなら、それは抽出時に設定します。「別のドキュメント」や「システム」という言葉が必要なら、それはコードに記述します。
よくある質問
ImageToTable.aiは抽出したデータに対してPythonスクリプトを実行できますか?
いいえ。このツールは列ルールを通じて抽出中に形式を標準化し、値を計算します。任意のコードを実行したり、スクリプト用のサンドボックスを提供したりすることはありません。変換に本当にPythonが必要な場合、v1 APIが構造化JSONを返すため、ご自身の環境で処理できます。
計算列はPythonの後処理と同じですか?
いいえ。計算列はドキュメント内のフィールドに対する算術演算と論理演算に限定されます。行レベルの計算、セクション内の合計、条件付き出力、固定パラメータ、導出値などです。ライブラリのインポート、外部サービスの呼び出し、ドキュメント間での状態保持は行いません。この限定された範囲こそが要点であり、列ルールが確実に実行できることを保証するためです。
スクリプトを書くのが適切な選択となるのはどのような場合ですか?
ルールが単一のドキュメントの外部に触れる必要がある場合です。請求書と発注書の照合、銀行明細と元帳の照合、為替レートの取得、仕入先名とマスターレコードの照合、リトライや分岐を伴う多段階処理の調整などです。これらの作業は本質的にスクリプト向きであり、抽出ルールがカバーするべきではありません。
組み込みの標準化機能は異なる国の日付形式に対応していますか?
指定した正規形式を出力できるため、異なる表記が混在する列も一貫した形式になります。ただし、04/05/2026のような文脈なしでは真に曖昧な値を解決することはできません。ドキュメントにロケール情報がない場合、安全な出力は黙って推測するのではなくレビュー用のフラグを立てることです。正規化された日付列を信頼する前に、この境界線を覚えておく価値があります。
抽出後にスクリプトを使わずに列のマージやリネームはできますか?
出力列は抽出前に定義し、AIは各ドキュメントのフィールドを位置ではなく意味で指定した名前にマッピングするため、リネームやマージは後付けのコードではなく命名上の判断になります。あるドキュメントの値を別のドキュメントの値と照合することは対象外で、コード側で対応します。
これによってデータチームにとってのPythonが不要になるわけではありません。Pythonの役割が選択的になるだけです。フィールドレベルのクリーニングがフィールドの読み取り時に行われると、残るコードは価値のあるコード、つまり結合、照合、そして列ルールでは表現できないシステムロジックだけになります。抽出後の2番目の作業がなくなるわけではありません。それは小さくなり、残る部分こそが書く価値のある部分です。