Où le nettoyage de données sans code s'arrête
et où Python commence
Chaque projet d'extraction de documents cache une seconde tâche derrière celle que vous planifiez. L'import s'exécute, le tableau apparaît, puis quelqu'un doit encore corriger la colonne des dates, supprimer les symboles de devise, déterminer si deux noms de fournisseurs désignent le même vendeur, et vérifier que les lignes correspondent au total imprimé. C'est dans cette seconde tâche que les heures s'accumulent. Dans l'enquête State of Data Science d'Anaconda auprès de 2 360 professionnels des données, les répondants ont déclaré consacrer 45 % de leur temps au chargement et au nettoyage des données, plus qu'à la modélisation ou à la visualisation combinées 1.
Le réflexe, une fois que le nettoyage se répète, est d'écrire un script Python. Ce n'est pas un réflexe insensé. Un script peut exprimer n'importe quelle règle à laquelle vous pensez, et il s'exécute de la même manière à chaque fois. Mais la plupart des nettoyages après extraction ne sont pas un problème de tout-et-n'importe-quoi. C'est un petit ensemble répété de transformations au niveau des champs, et traiter tout cela comme un problème de script, c'est ainsi que les équipes finissent par maintenir du code qu'elles n'avaient jamais besoin d'écrire. La question qui vaut la peine d'être posée n'est pas Python ou sans code. C'est à quelle couche chaque transformation appartient.
Points clés à retenir
- Les documents désordonnés sont la raison pour laquelle la plupart des équipes se tournent vers Python, mais le désordre n'est pas le signal qui compte vraiment.
- Le vrai test n'est pas l'apparence désordonnée des données, mais de savoir si la règle décrit un champ unique ou une relation entre systèmes.
- Le nettoyage au niveau des champs peut se faire là où le champ est lu, ce qui laisse Python pour les jointures et les rapprochements qui valent leur pesant d'or.
Ce que comprend réellement le nettoyage des données après extraction
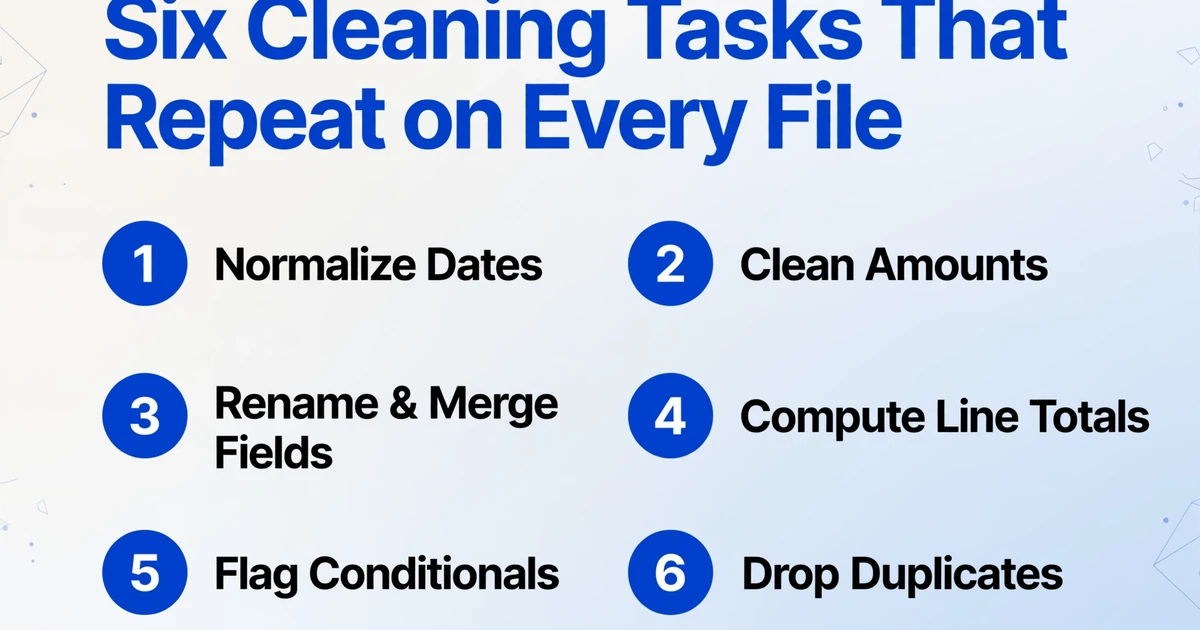
Le nettoyage des données après extraction consiste à transformer les valeurs brutes des champs en valeurs acceptables pour le système en aval. Ces tâches se répètent d'une équipe à l'autre, car les documents varient et les systèmes diffèrent. Six familles couvrent l'essentiel.
- Normalisation des dates et heures. Les documents mélangent
04/05/2026,5 Apr 2026,2026.04.05et « le 5 avril ». Le tri, le vieillissement et la mise en correspondance échouent tant que la colonne ne porte pas un format unique. - Nettoyage des montants et des nombres. Les symboles de devise, les séparateurs de milliers, les virgules décimales européennes et les parenthèses pour les négatifs se retrouvent tous dans ce qui devrait être un nombre.
$1.2Bet($47.99)restent du texte tant que rien ne les convertit. - Renommage et fusion de champs. Le document indique « Vous devez » et votre système attend « Part du patient ». Le document répartit une adresse sur trois lignes et votre système attend une seule colonne.
- Regroupements de lignes. Multiplier la quantité par le prix unitaire, additionner chaque ligne d'une section, dériver un sous-total jamais imprimé sur la page.
- Indicateurs conditionnels. Marquer une ligne lorsque le total ne correspond pas à la somme de ses parties, ou lorsqu'une facture franchit un seuil budgétaire.
- Détection des doublons. Un tableau qui chevauche un saut de page peut extraire deux fois la même ligne, gonflant un sous-total avant que quiconque ne s'en aperçoive.
Ce sont exactement les tâches pour lesquelles un environnement de post-traitement Python est conçu. Ce sont aussi exactement les tâches qu'une règle d'extraction déclarative peut gérer sans script. C'est cette variance que les praticiens décrivent lorsqu'ils demandent comment importer proprement des données PDF dans Excel à travers des fichiers : certaines sources s'importent bien, d'autres arrivent sous forme de texte en désordre sans structure cohérente, et ni la copie manuelle ni un modèle général ne passent à l'échelle, comme le souligne un fil r/excel sur les PDF incohérents. La différence réside dans l'emplacement de la règle et dans la capacité à la maintenir six mois plus tard.
Le critère pour savoir si une transformation appartient à un script n'est pas l'aspect désordonné de l'entrée. C'est de savoir si la règle concerne un seul champ, ou la relation entre les documents et les systèmes.
Pourquoi un script Python semble être la réponse honnête
Rejeter les scripts serait malhonnête, car certaines transformations sont réellement de nature scriptée. Si la règle doit comparer ce document à un autre, joindre des données de plusieurs systèmes, appeler un service externe, ou conserver un état entre deux exécutions, aucune règle de colonne ne l'exprime, et un script est le bon outil.
Correspondance entre documents. Votre facture fait référence à PO-4471. Que ce bon de commande existe, que les montants concordent, et que les marchandises soient déjà payées se trouve dans un autre fichier ou un autre système.
Jointures multi-sources et rapprochement. Relevé contre grand livre, facture contre bon de commande et bon de réception, trois exports de trois clients fusionnés en un seul tableau propre.
Recherches externes. Un taux de change en direct, une table fiscale à jour, ou une liste maîtresse de fournisseurs que vous maintenez dans une base de données.
Orchestration avec état. Nouvelles tentatives, branchement en cas d'échec partiel, files d'attente, et enregistrements de ce qui a déjà été exécuté.
Les scripts offrent de réels atouts pour ces tâches. Ils sont réutilisables, peuvent être versionnés, testés, et exécutés selon un calendrier. Lorsqu'une tâche est réellement de nature scriptée, la reconstruire comme un flux de travail visuel produit souvent une version moins bonne du même script.
La communauté de l'automatisation trace la ligne à peu près au même endroit. Un fil r/automation sur Python versus Make et n8n décrit les outils visuels comme des couches d'abstraction excellentes pour l'orchestration et le contrôle, tout en convenant que passer entièrement au no-code est un pas en arrière pour quiconque sait déjà coder. Le code pour la logique, argue le fil, et les outils visuels pour le câblage entre les étapes.
Là où le script coûte silencieusement plus qu'il n'en sauve
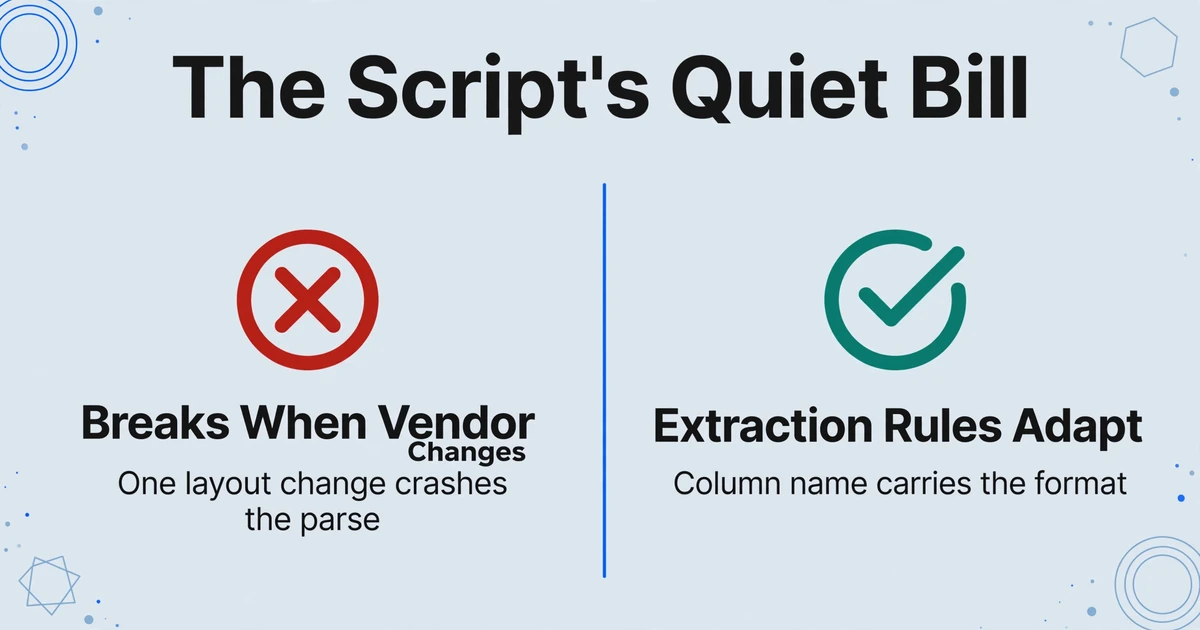
Les scripts paient leur flexibilité en maintenance, et la facture arrive sous une forme qui n'apparaît jamais dans un plan de projet.
Les changements de version cassent l'analyse. Un professionnel des données a décrit exactement cela sur r/TrueOffMyChest : un script Python traitait le traitement quotidien des factures pendant six mois, puis un fournisseur a légèrement modifié la mise en page d'une facture, le script a planté sur une erreur qu'il n'avait jamais gérée, et l'auteur avait complètement oublié le processus manuel. Le script n'a pas échoué parce qu'il était mal écrit. Il a échoué parce que le document sur lequel il était basé a changé.
L'auteur devient la seule personne capable de le réparer. Une logique d'analyse non documentée est un point de défaillance unique. Lorsque cette personne est en congé, le processus attend.
Les dépendances dérivent. Les versions de bibliothèques changent, les environnements diffèrent entre les machines, et un pipeline qui fonctionnait le trimestre dernier cesse de fonctionner après une mise à niveau que personne n'a suivie.
L'échec silencieux est le plus coûteux. Un script qui plante est visible. Un script qui s'exécute avec succès et écrit les mauvaises valeurs dans la colonne ne l'est pas, et c'est ce résultat qui atteint un grand livre avant que quiconque ne le remette en question.
Chaque format veut son propre script. Une expression régulière adaptée à la facture d'un fournisseur ne se transfère pas au fournisseur suivant. Vous finissez par maintenir un script par source, et le nombre ne fait qu'augmenter.
Un script qui doit être modifié chaque fois qu'un fournisseur redessine une facture n'est pas une configuration ponctuelle. C'est un abonnement avec une facture variable.
Ce que couvre une route déclarative avant d'ouvrir un éditeur
Une route déclarative déplace la transformation à l'étape d'extraction, de sorte qu'une valeur arrive sous la forme souhaitée au moment où le tableau apparaît. ImageToTable.ai, un outil de saisie de données par IA, procède de trois manières, qui couvrent ensemble les six familles de tâches ci-dessus.
Custom Column Extraction est la première. Vous saisissez les noms des colonnes souhaitées, et l'IA localise chaque valeur en comprenant ce qu'elle signifie plutôt qu'en fonction de sa position sur la page. Comme le nom de la colonne est aussi l'instruction, une demande de format peut y être intégrée. Nommez une colonne « Invoice Date (YYYY-MM-DD) » et la sortie contient la date normalisée, quelle que soit la convention utilisée par le document. Nommez-en une « Total Amount (decimal) » et le symbole monétaire et les séparateurs régionaux sont résolus avant que la valeur n'atteigne votre feuille de calcul.
Computed columns sont la deuxième. Une computed column est une colonne dont la valeur est calculée pendant l'extraction à partir d'autres champs du même document. Une opération arithmétique au niveau des lignes, une somme sur chaque ligne d'une section, un résultat conditionnel, un paramètre fixe ou une valeur dérivée que le document n'a jamais imprimée peuvent tous être définis de cette manière. Les règles simples vont directement dans le nom de la colonne, par exemple Line Total (Qty × Unit Price). Une dérivation en plusieurs étapes peut être écrite dans un JSON Rule Format à la place, ce qui garde le nom de la colonne propre tandis que la logique reste précise.
Intelligent data post-processing est la troisième. L'outil normalise les dates, les montants et les numéros de série dans le format que vous spécifiez pendant la même passe d'extraction, de sorte que l'Excel, le CSV ou le JSON exporté est prêt à l'emploi au lieu de nécessiter une seconde passe de nettoyage.
Mappées aux six familles, la version déclarative est concrète. Une date ou un montant est normalisé par le format contenu dans le nom de la colonne. Un renommage ou une fusion est une décision de nommage, car l'IA mappe chaque champ du document à votre nom de sortie par signification. Un regroupement de lignes ou un sous-total dérivé est une computed column. Un indicateur conditionnel est aussi une computed column, par exemple une qui produit la différence chaque fois que le total extrait ne correspond pas au montant facturé par le document. Un paramètre fixe tel qu'un taux d'imposition est intégré à la règle sans que le document ne le contienne jamais. Les lignes en double provenant d'un saut de page sont gérées par Multi-Page Merge, qui replie les pages divisées en une seule ligne et résout les valeurs conflictuelles par règle.
C'est la même idée que le guide pour déplacer le calcul dans l'extraction développe pour les totaux de factures, et le flux de vérification reprend les contrôles qui reviennent encore à un humain.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
La valeur ne réside pas dans le fait que l'outil pense à votre place. C'est que l'arithmétique et le formatage mécaniques se produisent là où le champ est lu, de sorte que votre relecture commence par des réponses plutôt que par des chaînes brutes.
La limite : quand vous avez réellement besoin de code
Être honnête sur la limite importe plus ici qu'un argumentaire propre, car un flux de travail fondé sur une affirmation exagérée échoue comme le script l'a fait. ImageToTable.ai n'exécute pas de Python arbitraire, n'offre pas de sandbox de script, et n'effectue pas de correspondance champ-à-champ entre documents. Ses règles sont au niveau des champs : normaliser cette valeur, calculer ceci à partir de ces champs, inférer cette catégorie, fusionner ces pages en une seule ligne. Tout ce qui nécessite de comparer un document à un autre, ou à un système, reste en dehors de l'étape d'extraction.
Cela laisse une liste courte et honnête de tâches qui relèvent du code : comparer une facture à son bon de commande et à son reçu, rapprocher un relevé bancaire d'un grand livre, appeler un taux de change en direct ou une liste maîtresse de fournisseurs, résoudre un nom de fournisseur en un enregistrement canonique, et orchestrer un travail en plusieurs étapes avec des tentatives et un état. Aucune de ces tâches ne devient plus facile en les forçant dans une règle de colonne, et prétendre le contraire ne ferait que recréer la fragilité que cet article conteste.
Là où l'outil rencontre le code, c'est la transition. L'API v1 renvoie un JSON propre et structuré, vous pouvez donc extraire et standardiser dans l'outil, puis exécuter votre propre script sur des valeurs déjà cohérentes. Si vous évaluez spécifiquement un sandbox intégré contre cette approche répartie, notre comparaison avec Airparser couvre le compromis. Choisir des règles au moment de l'extraction pour le travail au niveau des champs ne retire pas Python d'une équipe de données. Cela réserve Python au travail qui en a réellement besoin.
Une règle de décision à appliquer dès aujourd'hui
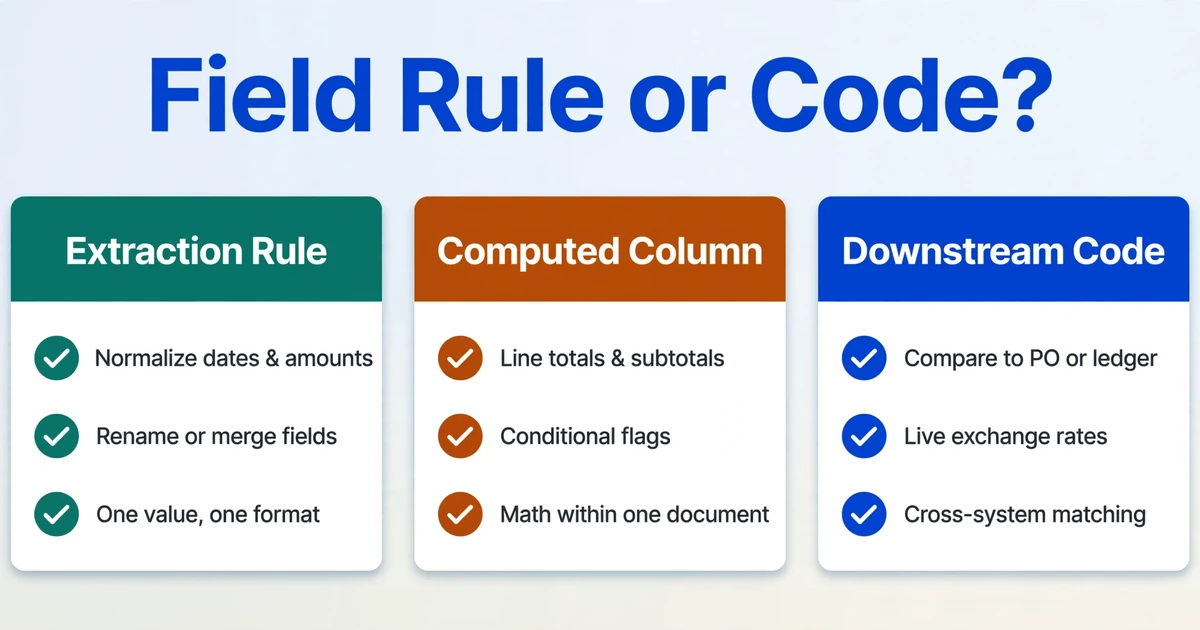
Lisez chaque transformation et posez-vous une question : la règle décrit-elle un champ, ou une relation entre documents et systèmes ? Les règles de champ relèvent de l'extraction. La logique système relève du code.
| Transformation | Où elle appartient | Pourquoi |
|---|---|---|
| Normaliser dates, montants, identifiants | Règle d'extraction | Une valeur, un format déterministe |
| Renommer, fusionner ou diviser des champs | Règle d'extraction | Le nom de la colonne de sortie est le mappage |
| Arithmétique de ligne et totaux de ligne | colonne calculée | Calculs intra-ligne sur les champs extraits |
| Sous-total de section ou total dérivé | colonne calculée | Somme sur les lignes d'un même document |
| Indicateur conditionnel (le total ne correspond pas au montant facturé) | colonne calculée | Une condition sur des valeurs déjà extraites |
| Ligne en double due à un saut de page | fusion multipage | Regroupe les pages d'un même document logique |
| Comparer cette facture à son bon de commande | Code en aval | Nécessite un second document |
| Rapprocher le relevé du grand livre | Code en aval | Nécessite un autre système, un état et une mise en correspondance |
| Taux de change en direct ou recherche de données de référence | Code en aval | Nécessite un service externe |
| Résoudre un nom de fournisseur vers un enregistrement maître unique | Code ou outil de données | Nécessite une liste canonique maintenue |
Si vous pouvez formuler la transformation en une phrase à propos d'un champ, elle relève de l'extraction. Si la phrase nécessite les mots « un autre document » ou « le système », elle relève du code.
Questions fréquemment posées
ImageToTable.ai peut-il exécuter un script Python sur mes données extraites ?
Non. L'outil standardise les formats et calcule les valeurs lors de l'extraction via des règles de colonnes. Il n'exécute pas de code arbitraire et ne fournit pas d'environnement de script. Si une transformation nécessite réellement Python, l'API v1 renvoie du JSON structuré que vous pouvez traiter dans votre propre environnement.
Une colonne calculée est-elle la même chose qu'un post-traitement Python ?
Non. Une colonne calculée se limite à l'arithmétique et à la logique sur les champs d'un document : calculs au niveau des lignes, sommes au sein d'une section, sorties conditionnelles, paramètres fixes et valeurs dérivées. Elle n'importe pas de bibliothèques, n'appelle pas de services externes et ne conserve pas d'état entre les documents. Cette portée plus restreinte est précisément ce qui permet à une règle de colonne de garantir un fonctionnement fiable.
Quand écrire un script est-il le bon choix ?
Lorsque la règle doit toucher à quelque chose en dehors du document unique : comparer une facture à un bon de commande, rapprocher un relevé bancaire avec un grand livre, récupérer un taux de change en direct, faire correspondre un nom de fournisseur à un enregistrement maître, ou orchestrer un travail en plusieurs étapes avec des tentatives et des branchements. Ces tâches relèvent véritablement du script, et les règles d'extraction ne devraient pas prétendre les couvrir.
La standardisation intégrée gère-t-elle les dates de différents pays ?
Elle peut émettre le format canonique que vous spécifiez, de sorte qu'une colonne mélangeant les conventions ressort de manière cohérente. Elle ne peut pas résoudre une valeur réellement ambiguë comme 04/05/2026 sans contexte. Lorsque le document n'offre aucun signal de locale, la sortie sûre est un indicateur de révision plutôt qu'une supposition silencieuse, et cette limite mérite d'être gardée à l'esprit avant de se fier à une colonne de dates normalisée.
Peut-il fusionner ou renommer des colonnes après l'extraction au lieu d'utiliser un script ?
Vous définissez les colonnes de sortie avant l'extraction, et l'IA fait correspondre chaque champ du document à votre nom par signification plutôt que par position, donc un renommage ou une fusion est une décision de nommage plutôt qu'un code ajouté après coup. Faire correspondre une valeur d'un document à une valeur d'un autre document sort de son champ d'action et reste dans le code.
Rien de tout cela ne rend Python facultatif pour une équipe de données. Cela rend Python sélectif. Lorsque le nettoyage au niveau du champ se fait là où le champ est lu, le code qui reste est le code qui en vaut la peine : les jointures, les rapprochements et la logique système qu'aucune règle de colonne ne peut exprimer. La deuxième tâche après l'extraction ne disparaît pas. Elle devient plus petite, et la partie qui reste est celle qui vaut la peine d'être écrite.