Wo No-Code-Datenbereinigung aufhört
und Python beginnt
Hinter jedem Dokumentextraktionsprojekt steckt eine zweite Aufgabe, die man nicht eingeplant hat. Der Upload läuft, die Tabelle erscheint – und dann muss jemand die Datumsspalte korrigieren, Währungssymbole entfernen, entscheiden, ob zwei Lieferantennamen derselbe Anbieter sind, und prüfen, ob die Positionsbeträge mit der gedruckten Summe übereinstimmen. Diese zweite Aufgabe kostet die meiste Zeit. In Anacondas State-of-Data-Science-Umfrage unter 2.360 Datenfachleuten gaben die Befragten an, 45 % ihrer Zeit mit Laden und Bereinigen von Daten zu verbringen – mehr als mit Modellierung oder Visualisierung zusammen 1.
Der Reflex, sobald sich die Bereinigung wiederholt, ist ein Python-Skript zu schreiben. Das ist kein dummer Reflex. Ein Skript kann jede Regel ausdrücken, die man sich vorstellen kann, und es läuft jedes Mal gleich. Aber die meiste Bereinigung nach der Extraktion ist kein Alles-Mögliche-Problem. Es ist eine kleine, wiederkehrende Menge von Transformationen auf Feldebene – und alles als Skriptproblem zu behandeln, führt dazu, dass Teams Code pflegen, den sie nie hätten schreiben müssen. Die Frage, die es wert ist, beantwortet zu werden, ist nicht Python oder No-Code. Es ist die Frage, zu welcher Ebene jede Transformation gehört.
Wichtige Erkenntnisse
- Unübersichtliche Dokumente sind der Grund, warum die meisten Teams zu Python greifen – aber Unübersichtlichkeit ist nicht das Signal, das wirklich zählt.
- Der eigentliche Test ist nicht, wie unübersichtlich die Daten aussehen, sondern ob die Regel ein einzelnes Feld oder eine Beziehung zwischen Systemen beschreibt.
- Die Bereinigung auf Feldebene kann dort erfolgen, wo das Feld gelesen wird – das überlässt Python die Joins und Abgleiche, die ihren Aufwand rechtfertigen.
Was die Datenbereinigung nach der Extraktion tatsächlich umfasst
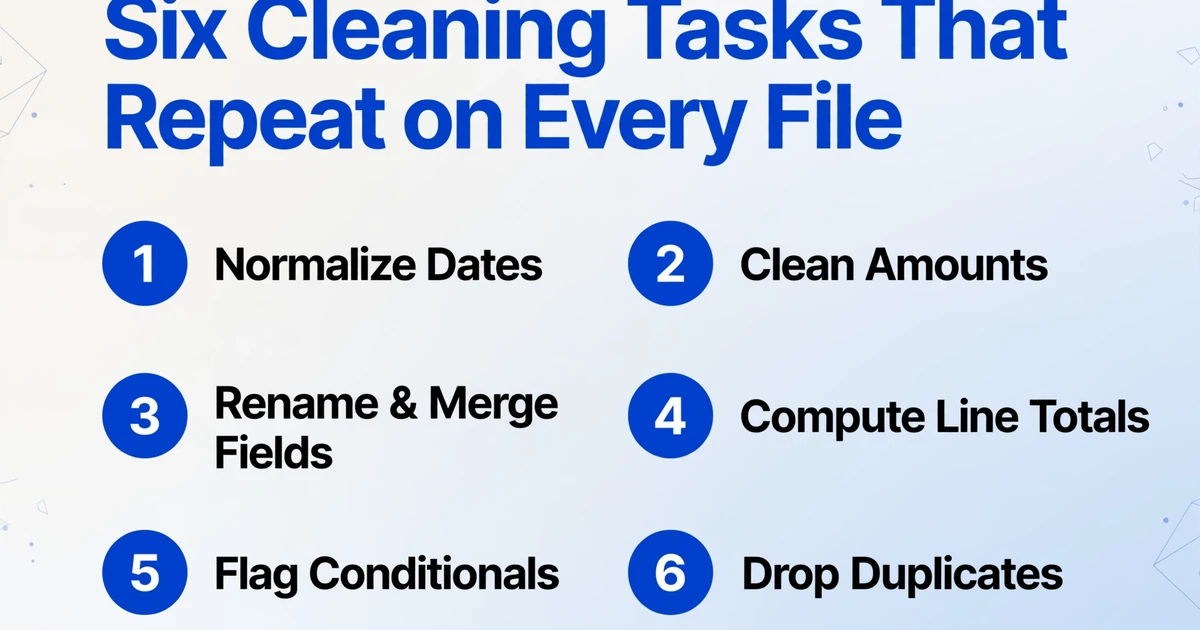
Die Datenbereinigung nach der Extraktion ist die Arbeit, rohe Feldwerte in Werte umzuwandeln, die ein nachgelagertes System akzeptiert. Die Aufgaben wiederholen sich in Teams, weil Dokumente variieren und Systeme dies nicht tun. Sechs Kategorien decken den Großteil ab.
- Normalisierung von Datum und Uhrzeit. Dokumente mischen
04/05/2026,5 Apr 2026,2026.04.05und „der 5. April". Sortierung, Alterung und Abgleich funktionieren erst, wenn die Spalte ein einheitliches Format trägt. - Bereinigung von Beträgen und Zahlen. Währungssymbole, Tausendertrennzeichen, europäische Dezimalkommas und Klammern für negative Werte befinden sich alle in dem, was eine Zahl sein sollte.
$1.2Bund($47.99)bleiben Text, bis etwas sie umwandelt. - Feld umbenennen und zusammenführen. Das Dokument sagt „Sie schulden" und Ihr System möchte „Patientenverantwortung". Das Dokument teilt eine Adresse auf drei Zeilen auf und Ihr System möchte eine Spalte.
- Zeilensummen. Multiplizieren Sie Menge mit Einzelpreis, summieren Sie jede Zeile in einem Abschnitt, leiten Sie eine Zwischensumme ab, die nie auf der Seite gedruckt wurde.
- Bedingte Kennzeichnungen. Markieren Sie eine Zeile, wenn die Summe nicht der Summe ihrer Teile entspricht, oder wenn eine Rechnung eine Budgetschwelle überschreitet.
- Duplikaterkennung. Eine Tabelle, die einen Seitenumbruch überquert, kann dieselbe Zeile zweimal extrahieren und so eine Zwischensumme aufblähen, bevor es jemand bemerkt.
Dies sind genau die Aufgaben, für die eine Python-Postprocessing-Sandbox gebaut ist. Sie sind auch genau die Aufgaben, die eine deklarative Extraktionsregel ohne Skript bewältigen kann. Die Varianz ist das, was Praktiker beschreiben, wenn sie fragen, wie man PDF-Daten sauber in Excel über Dateien hinweg bekommt: einige Quellen importieren einwandfrei, andere kommen als wirrer Text ohne konsistente Struktur an, und weder manuelles Kopieren noch ein allgemeines Modell skaliert, wie ein r/excel-Thread über inkonsistente PDFs es ausdrückt. Der Unterschied liegt darin, wo die Regel lebt und wer sie sechs Monate später pflegen kann.
Der Test dafür, ob eine Transformation in ein Skript gehört, ist nicht, wie unordentlich die Eingabe aussieht. Es ist, ob die Regel über ein einzelnes Feld spricht, oder über die Beziehung zwischen Dokumenten und Systemen.
Warum ein Python-Skript sich wie die ehrliche Antwort anfühlt
Skripte abzutun wäre unehrlich, denn manche Transformationen sind wirklich skriptförmig. Wenn die Regel dieses Dokument mit einem anderen vergleichen, Daten aus mehreren Systemen zusammenführen, einen externen Dienst aufrufen oder einen Zustand über einen Lauf hinweg behalten muss, drückt keine Spaltenregel das aus, und ein Skript ist das richtige Instrument.
Dokumentübergreifender Abgleich. Ihre Rechnung verweist auf PO-4471. Ob dieser Auftrag existiert, ob die Beträge übereinstimmen und ob die Waren bereits bezahlt wurden, liegt in einer anderen Datei oder in einem anderen System.
Multi-Quellen-Joins und Abgleich. Kontoauszug gegen Hauptbuch, Rechnung gegen Auftrag und Wareneingang, drei Exporte von drei Kunden zu einer sauberen Tabelle zusammengeführt.
Externe Abfragen. Ein aktueller Wechselkurs, eine aktuelle Steuertabelle oder eine Stammkundenliste, die Sie in einer Datenbank pflegen.
Zustandsbehaftete Orchestrierung. Wiederholungen, Verzweigungen bei Teilschlägen, Warteschlangen und Aufzeichnungen darüber, was bereits gelaufen ist.
Skripte bringen bei diesen Aufgaben echte Stärken mit. Sie sind wiederverwendbar, versionierbar, testbar und planbar. Wenn eine Aufgabe wirklich skriptförmig ist, führt der Umbau in einen visuellen Workflow oft zu einer schlechteren Version desselben Skripts.
Die Automatisierungs-Community zieht die Grenze ungefähr an derselben Stelle. Ein r/automation-Thread zu Python gegenüber Make und n8n beschreibt die visuellen Tools als Abstraktionsebenen, die für Orchestrierung und Steuerung hervorragend sind, stimmt aber zu, dass ein vollständiger No-Code-Ansatz ein Rückschritt für alle ist, die bereits Code schreiben können. Code für die Logik, so der Thread, und visuelle Tools für die Verdrahtung zwischen den Schritten.
Wo das Skript still mehr kostet, als es spart
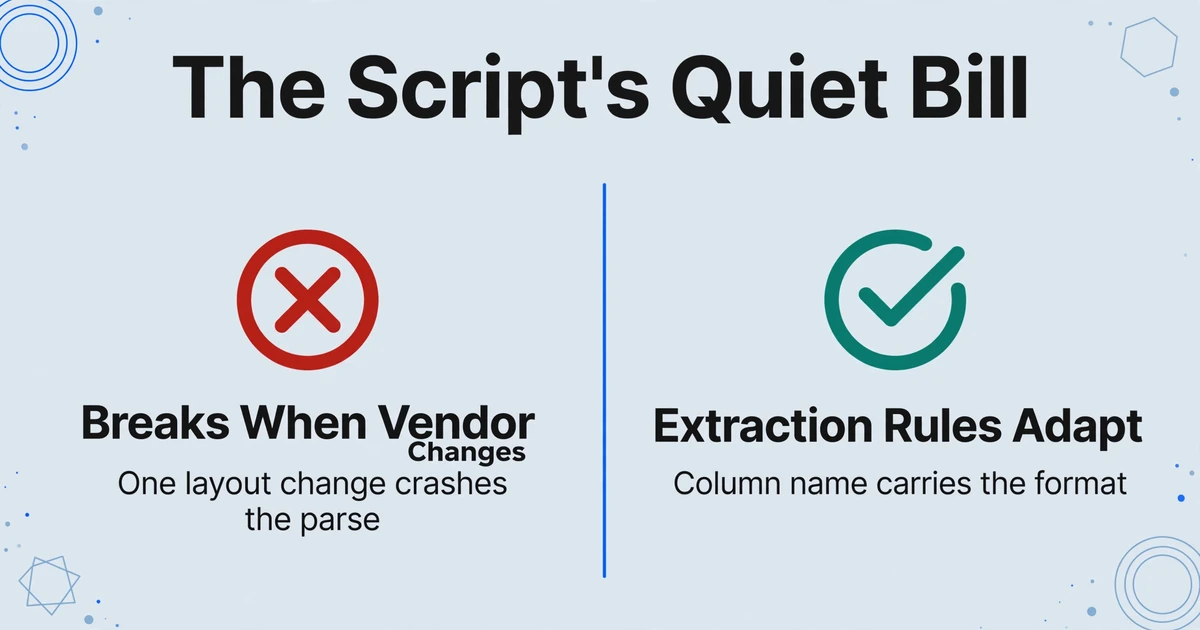
Skripte zahlen für ihre Flexibilität mit Wartungsaufwand – und die Rechnung kommt in einer Form, die in keinem Projektplan auftaucht.
Versionsänderungen brechen das Parsing. Ein Datenprofi beschrieb genau das auf r/TrueOffMyChest: Ein Python-Skript verarbeitete sechs Monate lang täglich Rechnungen, dann änderte ein Anbieter das Rechnungslayout leicht, das Skript stürzte bei einem Fehler ab, den es nie behandelt hatte, und der Autor hatte den manuellen Prozess komplett vergessen. Das Skript scheiterte nicht, weil es schlecht geschrieben war. Es scheiterte, weil sich das Dokument, für das es geschrieben wurde, geändert hatte.
Der Autor wird zur einzigen Person, die es reparieren kann. Undokumentierte Parsing-Logik ist ein Single Point of Failure. Wenn diese Person im Urlaub ist, wartet der Prozess.
Abhängigkeiten driften. Bibliotheksversionen ändern sich, Umgebungen unterscheiden sich zwischen Maschinen, und eine Pipeline, die letztes Quartal funktionierte, funktioniert nach einem Upgrade, das niemand verfolgt hat, nicht mehr.
Stilles Versagen ist die teure Art. Ein Skript, das abstürzt, ist sichtbar. Ein Skript, das erfolgreich läuft und die falschen Werte in die Spalte schreibt, ist es nicht – und genau dieses Ergebnis erreicht ein Hauptbuch, bevor es jemand hinterfragt.
Jedes Format will sein eigenes Skript. Regex, das auf die Rechnung eines Lieferanten abgestimmt ist, lässt sich nicht auf den nächsten Lieferanten übertragen. Am Ende pflegt man ein Skript pro Quelle, und die Zahl wächst nur.
Ein Skript, das jedes Mal bearbeitet werden muss, wenn ein Lieferant eine Rechnung neu gestaltet, ist keine einmalige Einrichtung. Es ist ein Abonnement mit variabler Rechnung.
Was eine deklarative Route abdeckt, bevor Sie einen Editor öffnen
Eine deklarative Route verlagert die Transformation in den Extraktionsschritt, sodass ein Wert in der gewünschten Form ankommt, sobald die Tabelle erscheint. ImageToTable.ai, ein KI-Datenerfassungs -Tool, macht dies auf drei Arten, und zusammen decken sie die sechs Aufgabenfamilien oben ab.
Custom Column Extraction ist die erste. Sie geben die Namen der Spalten ein, die Sie möchten, und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet, und nicht, wo er auf der Seite steht. Da der Spaltenname auch die Anweisung ist, kann eine Formatanforderung darin enthalten sein. Benennen Sie eine Spalte „Invoice Date (YYYY-MM-DD)" und die Ausgabe enthält das normalisierte Datum, unabhängig von der Konvention, die das Dokument verwendet hat. Benennen Sie eine „Total Amount (decimal)" und das Währungssymbol sowie die lokalen Trennzeichen werden aufgelöst, bevor der Wert Ihre Tabellenkalkulation erreicht.
Computed Columns sind die zweite. Eine berechnete Spalte ist eine Spalte, deren Wert während der Extraktion aus anderen Feldern in demselben Dokument berechnet wird. Zeilenarithmetik, eine Summe über jede Zeile in einem Abschnitt, ein bedingtes Ergebnis, ein fester Parameter oder ein abgeleiteter Wert, den das Dokument nie gedruckt hat, können alle auf diese Weise definiert werden. Einfache Regeln gehen direkt in den Spaltennamen, zum Beispiel Line Total (Qty × Unit Price). Eine mehrstufige Ableitung kann stattdessen in ein JSON Rule Format geschrieben werden, wodurch der Spaltenname sauber bleibt, während die Logik präzise bleibt.
Intelligente Daten-Nachbearbeitung ist die dritte. Das Tool standardisiert Daten, Beträge und Seriennummern in das Format, das Sie während desselben Extraktionsdurchgangs angeben, sodass das exportierte Excel, CSV oder JSON sofort verwendbar ist, anstatt eine zweite Bereinigungsrunde zu benötigen.
Auf die sechs Familien übertragen, ist die deklarative Version konkret. Ein Datum oder Betrag wird durch das Format im Spaltennamen normalisiert. Eine Umbenennung oder Zusammenführung ist eine Benennungsentscheidung, da die KI jedes Dokumentfeld anhand der Bedeutung Ihrem Ausgabenamen zuordnet. Eine Zeilensumme oder eine abgeleitete Zwischensumme ist eine berechnete Spalte. Ein bedingtes Flag ist ebenfalls eine berechnete Spalte, zum Beispiel eine, die die Differenz ausgibt, wenn die extrahierte Summe nicht dem Betrag entspricht, den das Dokument in Rechnung gestellt hat. Ein fester Parameter wie ein Steuersatz ist in der Regel eingebettet, ohne dass das Dokument ihn jemals enthält. Doppelte Zeilen, die von einem Seitenumbruch stammen, werden von Multi-Page Merge behandelt, das geteilte Seiten wieder zu einer Zeile zusammenführt und widersprüchliche Werte per Regel auflöst.
Dies ist dieselbe Idee, die der Leitfaden zur Verlagerung der Berechnung in die Extraktion für Rechnungssummen entwickelt, und der Verifizierungs-Workflow übernimmt die Prüfungen, die weiterhin einem Menschen gehören.
Dateien werden sicher verarbeitet und nicht gespeichert.
Der Wert liegt nicht darin, dass das Tool das Denken für Sie übernimmt. Sondern darin, dass die mechanische Arithmetik und Formatierung dort stattfinden, wo das Feld gelesen wird, sodass Ihre Prüfung bei Antworten beginnt statt bei rohen Zeichenketten.
Die Grenze: Wann Sie wirklich Code benötigen
Ehrlichkeit über die Grenze ist hier wichtiger als ein sauberer Pitch, denn ein Workflow, der auf einer übertriebenen Behauptung aufbaut, scheitert so wie das Skript. ImageToTable.ai führt kein beliebiges Python aus, bietet keine Skript-Sandbox und führt keinen dokumentübergreifenden Feld-zu-Feld-Abgleich durch. Seine Regeln sind feldebene: diesen Wert normalisieren, dies aus diesen Feldern berechnen, diese Kategorie ableiten, diese Seiten zu einer Zeile zusammenführen. Alles, was den Vergleich eines Dokuments mit einem anderen oder mit einem System erfordert, bleibt außerhalb des Extraktionsschritts.
Das hinterlässt eine kurze, ehrliche Liste von Aufgaben, die in Code gehören: den Vergleich einer Rechnung mit ihrer Bestellung und dem Lieferschein, den Abgleich eines Kontoauszugs mit einem Hauptbuch, das Abrufen eines Live-Wechselkurses oder einer Master-Lieferantenliste, die Auflösung eines Lieferantennamens zu einem kanonischen Datensatz sowie die Orchestrierung mehrstufiger Arbeit mit Wiederholungen und Zustand. Keine dieser Aufgaben wird einfacher, wenn man sie in eine Spaltenregel zwingt, und das Gegenteil zu behaupten würde nur die Sprödigkeit wiederherstellen, gegen die sich dieser Artikel richtet.
Wo das Tool auf Code trifft, ist die Übergabe. Die v1 API liefert sauberes, strukturiertes JSON, sodass Sie im Tool extrahieren und standardisieren und dann Ihr eigenes Skript über bereits konsistente Werte laufen lassen können. Wenn Sie konkret eine integrierte Sandbox gegen diesen geteilten Ansatz abwägen, behandelt unser Vergleich mit Airparser den Kompromiss. Die Wahl von Extraktionszeit-Regeln für die feldebene Arbeit entfernt Python nicht aus einem Datenteam. Sie reserviert Python für die Arbeit, die es tatsächlich benötigt.
Eine Entscheidungsregel, die Sie noch heute anwenden können
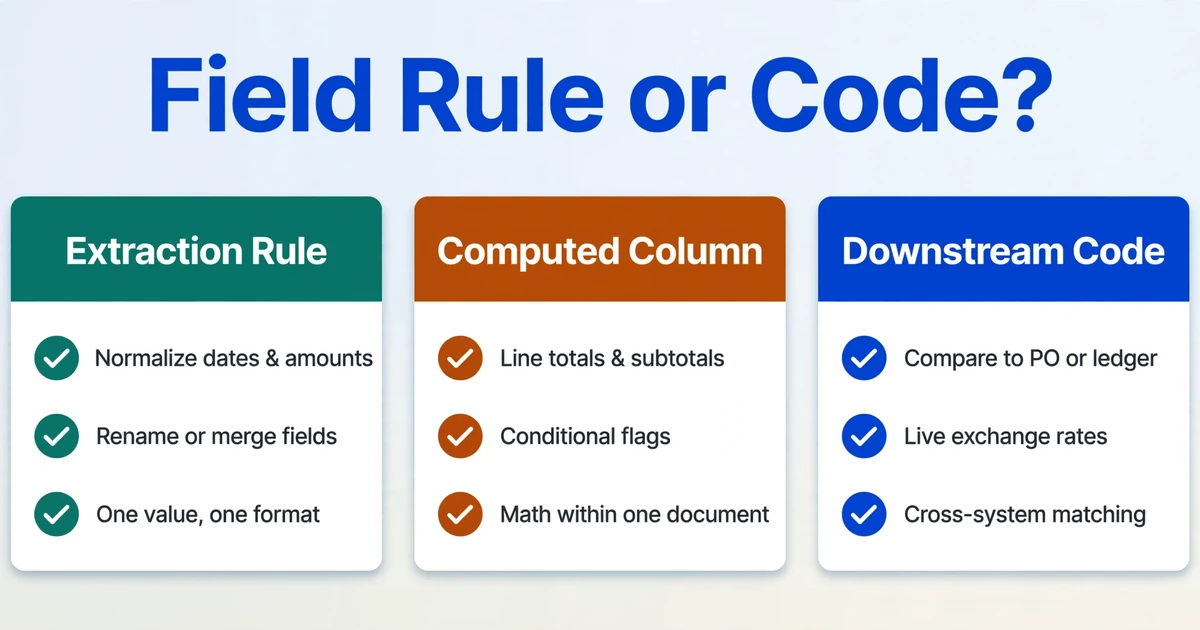
Lesen Sie jede Transformation und stellen Sie eine Frage: Beschreibt die Regel ein Feld oder eine Beziehung zwischen Dokumenten und Systemen? Feldregeln gehören zur Extraktion. Systemlogik gehört in den Code.
| Transformation | Wohin sie gehört | Warum |
|---|---|---|
| Daten, Beträge, Kennungen normalisieren | Extraktionsregel | Ein Wert, ein deterministisches Format |
| Felder umbenennen, zusammenführen oder aufteilen | Extraktionsregel | Der Name der Ausgabespalte ist die Zuordnung |
| Zeilenarithmetik und Positionssummen | berechnete Spalte | Mathematik innerhalb einer Zeile auf extrahierten Feldern |
| Abschnittszwischensumme oder abgeleitete Summe | berechnete Spalte | Summe über Zeilen innerhalb eines Dokuments |
| Bedingtes Flag (Summe stimmt nicht mit Rechnungsbetrag überein) | berechnete Spalte | Eine Bedingung für bereits extrahierte Werte |
| Doppelte Zeile durch Seitenumbruch | Mehrseiten-Zusammenführung | Gruppiert Seiten eines logischen Dokuments |
| Diese Rechnung mit ihrer Bestellung vergleichen | Nachgelagerter Code | Benötigt ein zweites Dokument |
| Auszug mit Hauptbuch abgleichen | Nachgelagerter Code | Benötigt ein anderes System, Zustand und Abgleich |
| Live-Wechselkurs oder Stammdatenabfrage | Nachgelagerter Code | Benötigt einen externen Dienst |
| Lieferantennamen einem Master-Datensatz zuordnen | Code oder ein Daten-Tool | Benötigt eine gepflegte kanonische Liste |
Wenn Sie die Transformation als einen Satz über ein Feld formulieren können, gehört sie zur Extraktion. Wenn der Satz die Wörter „ein anderes Dokument" oder „das System" benötigt, gehört er in den Code.
Häufig gestellte Fragen
Kann ImageToTable.ai ein Python-Skript auf meinen extrahierten Daten ausführen?
Nein. Das Tool standardisiert Formate und berechnet Werte während der Extraktion über Spaltenregeln. Es führt keinen beliebigen Code aus und bietet keine Skript-Sandbox. Wenn eine Transformation wirklich Python benötigt, gibt die v1 API strukturiertes JSON zurück, das Sie in Ihrer eigenen Umgebung verarbeiten können.
Ist eine berechnete Spalte dasselbe wie Python-Postprocessing?
Nein. Eine berechnete Spalte ist auf Arithmetik und Logik über die Felder in einem Dokument beschränkt: zeilenweise Mathematik, Summen innerhalb eines Abschnitts, bedingte Ausgaben, feste Parameter und abgeleitete Werte. Sie importiert keine Bibliotheken, ruft keine externen Dienste auf und behält keinen Zustand über Dokumente hinweg. Diese engere Beschränkung ist der Punkt, denn genau das kann eine Spaltenregel zuverlässig garantieren.
Wann ist das Schreiben eines Skripts die richtige Wahl?
Wenn die Regel etwas außerhalb des einzelnen Dokuments berühren muss: eine Rechnung mit einer Bestellung vergleichen, einen Kontoauszug mit einem Hauptbuch abgleichen, einen Live-Wechselkurs abrufen, einen Lieferantennamen mit einem Masterdatensatz abgleichen oder mehrstufige Arbeiten mit Wiederholungen und Verzweigungen orchestrieren. Diese Aufgaben sind wirklich skriptförmig, und Extraktionsregeln sollten nicht so tun, als würden sie sie abdecken.
Behandelt die integrierte Standardisierung Daten aus verschiedenen Ländern?
Sie kann das kanonische Format ausgeben, das Sie festlegen, sodass eine Spalte mit gemischten Konventionen konsistent wird. Sie kann einen wirklich mehrdeutigen Wert wie 04/05/2026 ohne Kontext nicht auflösen. Wenn das Dokument kein Locale-Signal bietet, ist die sichere Ausgabe ein Flag zur Überprüfung statt einer stillen Vermutung, und diese Grenze sollte man sich merken, bevor man einer normalisierten Datumsspalte vertraut.
Kann es Spalten nach der Extraktion zusammenführen oder umbenennen, anstatt ein Skript zu verwenden?
Sie legen die Ausgabespalten vor der Extraktion fest, und die KI ordnet jedes Dokumentfeld Ihrer Benennung nach Bedeutung statt nach Position zu, sodass eine Umbenennung oder Zusammenführung eine Benennungsentscheidung ist und kein nachträglicher Code. Das Abgleichen eines Werts in einem Dokument mit einem Wert in einem anderen Dokument liegt außerhalb ihres Anwendungsbereichs und bleibt im Code.
Keines davon macht Python für ein Datenteam optional. Es macht Python selektiv. Wenn die bereinigungslogik auf Feldebene dort stattfindet, wo das Feld gelesen wird, bleibt der Code, der sich lohnt: die Joins, die Abstimmungen und die Systemlogik, die keine Spaltenregel ausdrücken kann. Die zweite Aufgabe nach der Extraktion verschwindet nicht. Sie wird kleiner, und der Teil, der bleibt, ist der Teil, der sich zu schreiben lohnt.