Dónde se detiene la limpieza de datos sin código
y comienza Python
Todo proyecto de extracción de documentos esconde un segundo trabajo detrás del que usted planifica. La carga se ejecuta, la tabla aparece, y luego alguien todavía tiene que corregir la columna de fechas, eliminar los símbolos de moneda, decidir si dos nombres de proveedores son el mismo vendedor y confirmar que las partidas suman el total impreso. Ese segundo trabajo es donde se van las horas. En la encuesta State of Data Science de Anaconda a 2,360 profesionales de datos, los encuestados informaron dedicar el 45% de su tiempo a cargar y limpiar datos, más que a modelar o visualizar combinados 1.
El reflejo, una vez que la limpieza se repite, es escribir un script de Python. No es un reflejo insensato. Un script puede expresar cualquier regla que usted imagine y se ejecuta de la misma manera cada vez. Pero la mayor parte de la limpieza posterior a la extracción no es un problema de cualquier cosa. Es un conjunto pequeño y repetido de transformaciones a nivel de campo, y tratar todo como un problema de scripting es cómo los equipos terminan manteniendo código que nunca necesitaron escribir. La pregunta que vale la pena responder no es Python o sin código. Es a qué capa pertenece cada transformación.
Conclusiones clave
- Los documentos desordenados son la razón por la que la mayoría de los equipos recurren a Python, pero el desorden no es la señal que realmente importa.
- La verdadera prueba no es cuán desordenados se ven los datos, sino si la regla describe un solo campo o una relación entre sistemas.
- La limpieza a nivel de campo puede ocurrir donde se lee el campo, lo que deja Python para las uniones y conciliaciones que justifican su uso.
Qué incluye realmente la limpieza de datos posterior a la extracción
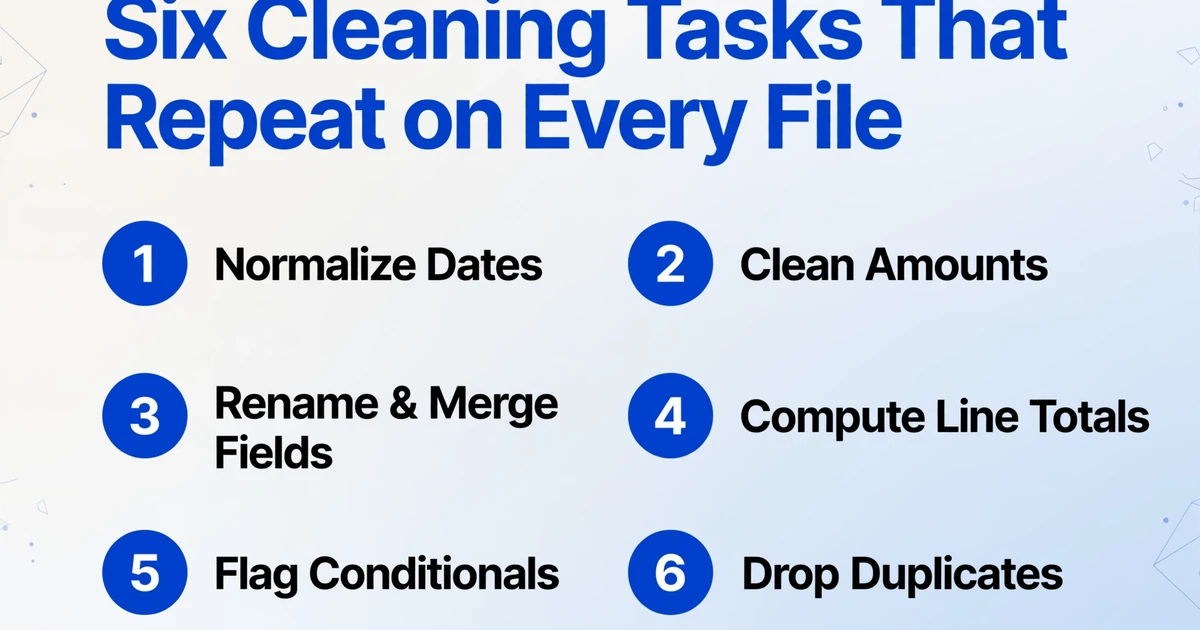
La limpieza de datos posterior a la extracción es el trabajo de convertir valores de campo sin procesar en valores que un sistema posterior aceptará. Las tareas se repiten en todos los equipos porque los documentos varían y los sistemas no. Seis familias cubren la mayor parte.
- Normalización de fecha y hora. Los documentos mezclan
04/05/2026,5 Apr 2026,2026.04.05y "el 5 de abril". La clasificación, el envejecimiento y la coincidencia se rompen hasta que la columna lleva un solo formato. - Limpieza de montos y números. Los símbolos de moneda, los separadores de miles, las comas decimales europeas y los paréntesis para negativos se encuentran dentro de lo que debería ser un número.
$1.2By($47.99)siguen siendo texto hasta que algo los convierte. - Renombrado y fusión de campos. El documento dice "Usted debe" y su sistema quiere "Responsabilidad del paciente". El documento divide una dirección en tres líneas y su sistema quiere una sola columna.
- Acumulaciones de partidas. Multiplique la cantidad por el precio unitario, sume cada línea de una sección, derive un subtotal que nunca se imprimió en la página.
- Indicadores condicionales. Marque una fila cuando el total no sea igual a la suma de sus partes, o cuando una factura supere un umbral presupuestario.
- Detección de duplicados. Una tabla que cruza un salto de página puede extraer la misma línea dos veces, inflando un subtotal antes de que alguien lo note.
Estas son las tareas exactas para las que está diseñado un entorno de pruebas de posprocesamiento en Python. También son las tareas exactas que una regla de extracción declarativa puede manejar sin un script. La variación es lo que los profesionales describen cuando preguntan cómo obtener datos de PDF a Excel de forma limpia entre archivos: algunas fuentes se importan bien, otras llegan como texto desordenado sin una estructura consistente, y ni la copia manual ni un modelo general escalan, como lo plantea un hilo de r/excel sobre PDFs inconsistentes. La diferencia es dónde vive la regla y quién puede mantenerla seis meses después.
La prueba de si una transformación pertenece a un script no es lo desordenada que se ve la entrada. Es si la regla habla de un solo campo, o de la relación entre documentos y sistemas.
Por qué un script de Python parece la respuesta honesta
Descartar los scripts sería deshonesto, porque algunas transformaciones realmente tienen forma de script. Si la regla tiene que comparar este documento con otro, combinar datos de varios sistemas, llamar a un servicio externo o mantener estado entre ejecuciones, ninguna regla de columna lo expresa, y un script es el instrumento adecuado.
Coincidencia entre documentos. Su factura hace referencia a PO-4471. Si esa orden de compra existe, si los montos coinciden, y si los bienes ya fueron pagados, reside en un archivo diferente o en un sistema diferente.
Combinaciones de múltiples fuentes y conciliación. Estado de cuenta contra libro mayor, factura contra orden de compra y recepción de mercancía, tres exportaciones de tres clientes combinadas en una sola tabla limpia.
Consultas externas. Un tipo de cambio en vivo, una tabla de impuestos actual o una lista maestra de proveedores que usted mantiene en una base de datos.
Orquestación con estado. Reintentos, ramificación ante fallos parciales, colas y registros de lo que ya se ejecutó.
Los scripts aportan fortalezas reales en estos trabajos. Son reutilizables, pueden controlarse por versiones, pueden probarse y pueden ejecutarse en un horario. Cuando una tarea realmente tiene forma de script, reconstruirla como un flujo de trabajo visual a menudo produce una versión peor del mismo script.
La comunidad de automatización traza la línea aproximadamente en el mismo lugar. Un hilo de r/automation sobre Python frente a Make y n8n describe las herramientas visuales como capas de abstracción excelentes para la orquestación y el control, al tiempo que coincide en que volverse completamente no-code es un paso atrás para cualquiera que ya sepa escribir código. Código para la lógica, argumenta el hilo, y herramientas visuales para la conexión entre pasos.
Dónde el script cuesta silenciosamente más de lo que ahorra
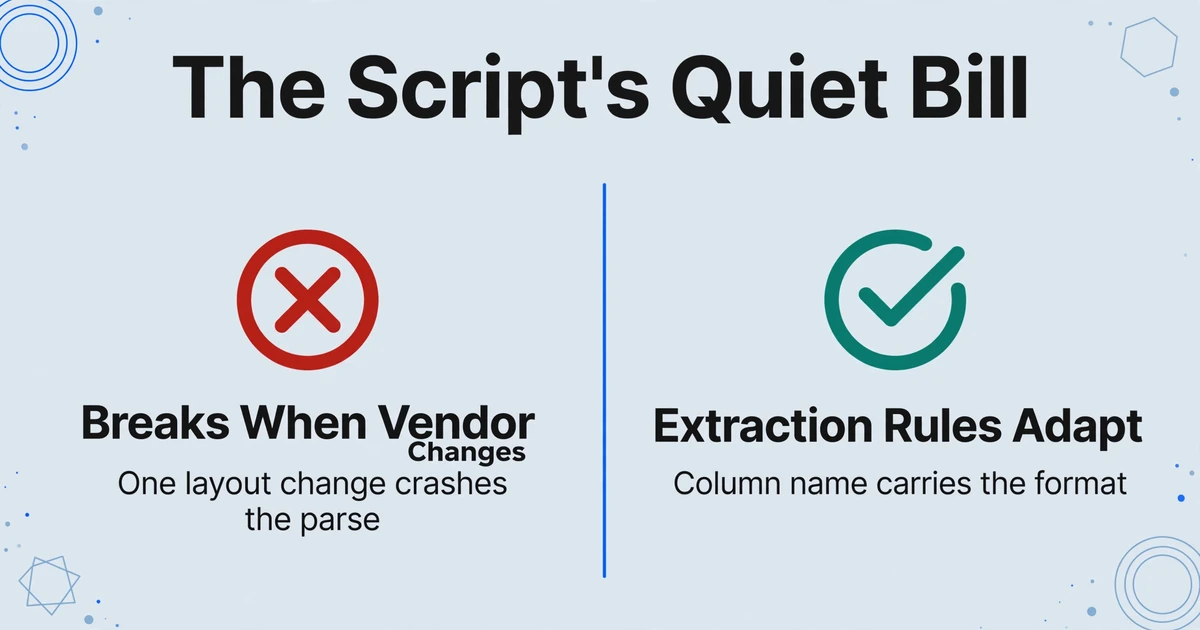
Los scripts pagan su flexibilidad con mantenimiento, y la factura llega de una forma que nunca aparece en un plan de proyecto.
Los cambios de versión rompen el análisis. Un profesional de datos describió exactamente esto en r/TrueOffMyChest: un script de Python procesó facturas diarias durante seis meses, luego un proveedor cambió ligeramente el diseño de una factura, el script falló con un error que nunca había manejado, y el autor había olvidado por completo el proceso manual. El script no falló porque estuviera mal escrito. Falló porque el documento para el que fue escrito cambió.
El autor se convierte en la única persona que puede arreglarlo. La lógica de análisis no documentada es un punto único de fallo. Cuando esa persona está de vacaciones, el proceso espera.
Las dependencias se desactualizan. Las versiones de las bibliotecas cambian, los entornos difieren entre máquinas, y un pipeline que funcionó el trimestre pasado deja de funcionar después de una actualización que nadie rastreó.
El fallo silencioso es el tipo costoso. Un script que falla es visible. Un script que se ejecuta correctamente y escribe valores incorrectos en la columna no lo es, y ese es el resultado que llega a un libro mayor antes de que alguien lo cuestione.
Cada formato quiere su propio script. La expresión regular ajustada a la factura de un proveedor no se transfiere al siguiente proveedor. Terminas manteniendo un script por fuente, y el número solo crece.
Un script que debe editarse cada vez que un proveedor rediseña una factura no es una configuración única. Es una suscripción con una factura variable.
Qué cubre una ruta declarativa antes de abrir un editor
Una ruta declarativa traslada la transformación al paso de extracción, de modo que un valor llega con la forma que usted desea cuando aparece la tabla. ImageToTable.ai, una herramienta de entrada de datos con IA, lo hace de tres maneras, y juntas cubren las seis familias de tareas mencionadas anteriormente.
Custom Column Extraction es la primera. Usted escribe los nombres de las columnas que desea, y la IA localiza cada valor comprendiendo lo que significa en lugar de dónde se encuentra en la página. Debido a que el nombre de la columna es también la instrucción, una solicitud de formato puede residir dentro de él. Nombre una columna "Invoice Date (YYYY-MM-DD)" y la salida llevará la fecha normalizada, sea cual sea la convención que usara el documento. Nombre una "Total Amount (decimal)" y el símbolo de moneda y los separadores de configuración regional se resolverán antes de que el valor llegue a su hoja de cálculo.
Computed Columns son la segunda. Una columna calculada es una columna cuyo valor se calcula durante la extracción a partir de otros campos del mismo documento. Aritmética a nivel de fila, una suma de todas las líneas de una sección, un resultado condicional, un parámetro fijo o un valor derivado que el documento nunca imprimió pueden definirse de esta manera. Las reglas simples van directamente al nombre de la columna, por ejemplo Line Total (Qty × Unit Price). Una derivación de varios pasos puede escribirse en un JSON Rule Format, lo que mantiene limpio el nombre de la columna mientras la lógica permanece precisa.
Intelligent data post-processing es la tercera. La herramienta estandariza fechas, montos y números de serie al formato que usted especifica durante la misma pasada de extracción, de modo que el Excel, CSV o JSON exportado esté listo para usar en lugar de necesitar una segunda ronda de limpieza.
Mapeada a las seis familias, la versión declarativa es concreta. Una fecha o un monto se normaliza mediante el formato dentro del nombre de la columna. Un cambio de nombre o una fusión es una decisión de nomenclatura, porque la IA asigna cada campo del documento a su nombre de salida por significado. Un resumen de líneas o un subtotal derivado es una columna calculada. Una marca condicional también es una columna calculada, por ejemplo una que genere la diferencia siempre que el total extraído no coincida con el monto facturado por el documento. Un parámetro fijo, como una tasa impositiva, se incorpora a la regla sin que el documento lo contenga jamás. Las líneas duplicadas que provienen de un salto de página se gestionan mediante Multi-Page Merge, que pliega las páginas divididas de nuevo en una fila y resuelve los valores en conflicto según la regla.
Esta es la misma idea que la guía para trasladar el cálculo a la extracción desarrolla para los totales de facturas, y el flujo de verificación retoma las comprobaciones que aún corresponden a una persona.
Los archivos se procesan de forma segura y no se almacenan.
El valor no es que la herramienta piense por usted. Es que la aritmética mecánica y el formato ocurren donde se lee el campo, de modo que su revisión comienza a partir de respuestas en lugar de cadenas de texto sin procesar.
El Límite: Cuándo Realmente Necesita Código
Ser honesto sobre el límite importa más aquí que un discurso impecable, porque un flujo de trabajo basado en una afirmación exagerada falla de la misma manera que el script. ImageToTable.ai no ejecuta Python arbitrario, no ofrece un entorno de pruebas para scripts y no realiza coincidencias campo a campo entre documentos. Sus reglas son a nivel de campo: normalizar este valor, calcular esto a partir de estos campos, inferir esta categoría, fusionar estas páginas en una fila. Cualquier cosa que requiera comparar un documento con otro, o con un sistema, queda fuera del paso de extracción.
Eso deja una lista breve y honesta de tareas que pertenecen al código: comparar una factura con su orden de compra y su recibo, conciliar un extracto bancario con un libro mayor, consultar un tipo de cambio en vivo o una lista maestra de proveedores, resolver un nombre de proveedor a un registro canónico y orquestar trabajos de varios pasos con reintentos y estado. Ninguna de estas tareas se facilita al forzarlas dentro de una regla de columna, y pretender lo contrario solo recrearía la fragilidad contra la que argumenta este artículo.
Donde la herramienta sí se encuentra con el código es en la entrega. La API v1 devuelve JSON limpio y estructurado, de modo que puede extraer y estandarizar en la herramienta y luego ejecutar su propio script sobre valores que ya son consistentes. Si está considerando específicamente un entorno de pruebas integrado frente a este enfoque dividido, nuestra comparación con Airparser cubre la disyuntiva. Elegir reglas de extracción para el trabajo a nivel de campo no elimina Python de un equipo de datos. Reserva Python para el trabajo que realmente lo necesita.
Una regla de decisión que puede aplicar hoy
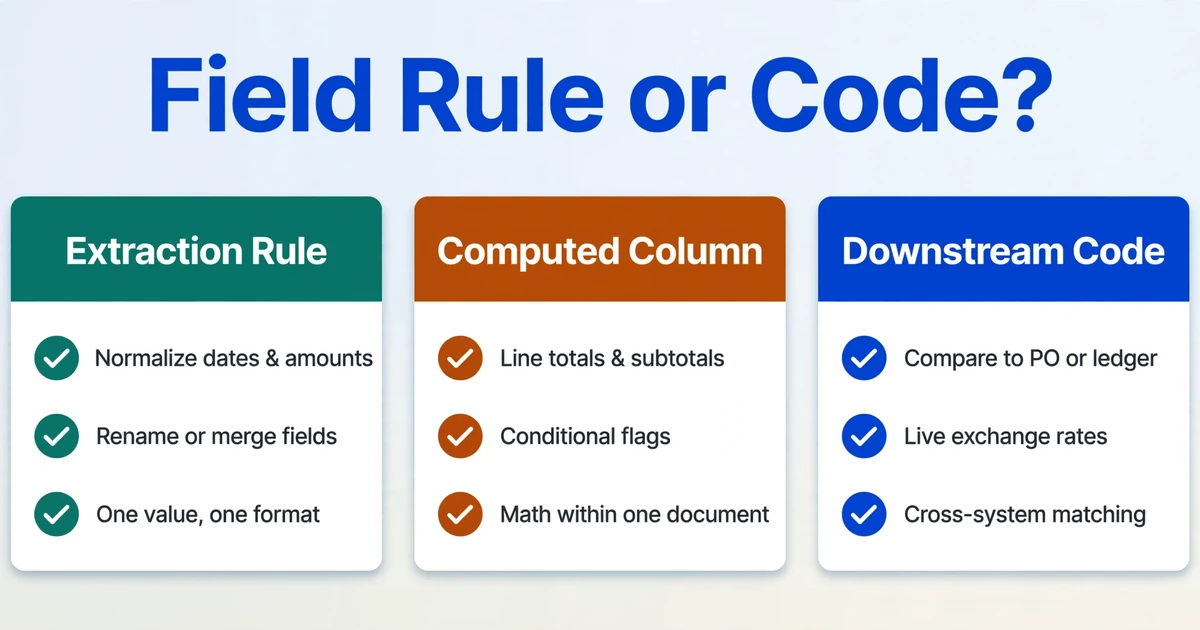
Lea cada transformación y hágase una pregunta: ¿la regla describe un campo o una relación entre documentos y sistemas? Las reglas de campo pertenecen a la extracción. La lógica de sistema pertenece al código.
| Transformación | Dónde corresponde | Por qué |
|---|---|---|
| Normalizar fechas, montos, identificadores | Regla de extracción | Un valor, un formato determinista |
| Renombrar, fusionar o dividir campos | Regla de extracción | El nombre de la columna de salida es la asignación |
| Aritmética de filas y totales de línea | columna calculada | Matemática dentro de la fila sobre campos extraídos |
| Subtotal de sección o total derivado | columna calculada | Suma entre filas dentro de un documento |
| Indicador condicional (el total no coincide con el monto facturado) | columna calculada | Una condición sobre valores ya extraídos |
| Fila duplicada por un salto de página | fusión de varias páginas | Agrupa páginas de un documento lógico |
| Comparar esta factura con su orden de compra | Código posterior | Requiere un segundo documento |
| Conciliar el estado de cuenta contra el libro mayor | Código posterior | Requiere otro sistema, estado y coincidencia |
| Tipo de cambio en vivo o consulta de datos maestros | Código posterior | Requiere un servicio externo |
| Resolver un nombre de proveedor a un registro maestro | Código o una herramienta de datos | Requiere una lista canónica mantenida |
Si puede escribir la transformación como una frase sobre un campo, pertenece a la extracción. Si la frase necesita las palabras "otro documento" o "el sistema", pertenece al código.
Preguntas frecuentes
¿Puede ImageToTable.ai ejecutar un script de Python sobre mis datos extraídos?
No. La herramienta estandariza formatos y calcula valores durante la extracción mediante reglas de columna. No ejecuta código arbitrario ni proporciona un entorno de scripting. Si una transformación realmente necesita Python, la API v1 devuelve JSON estructurado que puede procesar en su propio entorno.
¿Es una columna calculada lo mismo que un post-procesamiento con Python?
No. Una columna calculada se limita a operaciones aritméticas y lógicas sobre los campos de un documento: matemáticas a nivel de fila, sumas dentro de una sección, salidas condicionales, parámetros fijos y valores derivados. No importa bibliotecas, no llama a servicios externos ni mantiene estado entre documentos. Ese alcance más reducido es el punto clave, porque es lo que una regla de columna puede garantizar de manera confiable.
¿Cuándo es la opción correcta escribir un script?
Cuando la regla tiene que tocar algo fuera del documento individual: comparar una factura con una orden de compra, conciliar un extracto bancario contra un libro mayor, obtener un tipo de cambio en vivo, hacer coincidir un nombre de proveedor con un registro maestro, u orquestar trabajos de varios pasos con reintentos y ramificaciones. Esas tareas son genuinamente de tipo script, y las reglas de extracción no deberían pretender cubrirlas.
¿La estandarización integrada maneja fechas de diferentes países?
Puede emitir el formato canónico que usted especifique, de modo que una columna que mezcla convenciones resulte consistente. No puede resolver un valor genuinamente ambiguo como 04/05/2026 sin contexto. Cuando el documento no ofrece una señal de configuración regional, la salida segura es una marca para revisión en lugar de una suposición silenciosa, y ese límite vale la pena recordarlo antes de confiar en una columna de fechas normalizada.
¿Puede fusionar o renombrar columnas después de la extracción en lugar de usar un script?
Usted define las columnas de salida antes de la extracción, y la IA asigna cada campo del documento a su nombre por significado y no por posición, de modo que un renombrado o una fusión es una decisión de nomenclatura en lugar de código posterior. Hacer coincidir un valor en un documento con un valor en otro documento está fuera de su alcance y permanece en el código.
Nada de esto hace que Python sea opcional para un equipo de datos. Hace que Python sea selectivo. Cuando la limpieza a nivel de campo ocurre donde se lee el campo, el código que queda es el código que se justifica: las uniones, las conciliaciones y la lógica del sistema que ninguna regla de columna puede expresar. La segunda tarea después de la extracción no desaparece. Se reduce, y la parte que permanece es la parte que vale la pena escribir.