Onde a Limpeza de Dados Sem Código Para
e o Python Começa
Todo projeto de extração de documentos esconde um segundo trabalho por trás daquele que você planeja. O upload é feito, a tabela aparece, e então alguém ainda precisa corrigir a coluna de datas, remover os símbolos de moeda, decidir se dois nomes de fornecedores são o mesmo vendedor e confirmar se os itens de linha somam o total impresso. É nesse segundo trabalho que as horas se vão. Na pesquisa State of Data Science da Anaconda com 2.360 profissionais de dados, os entrevistados relataram gastar 45% do tempo carregando e limpando dados, mais do que em modelagem ou visualização combinadas 1.
O reflexo, quando a limpeza se repete, é escrever um script em Python. Não é um reflexo tolo. Um script pode expressar qualquer regra que você imaginar e roda da mesma forma todas as vezes. Mas a maior parte da limpeza pós-extração não é um problema de qualquer coisa. É um conjunto pequeno e repetido de transformações em nível de campo, e tratar tudo isso como um problema de script é como as equipes acabam mantendo código que nunca precisaram escrever. A pergunta que vale a pena responder não é Python ou sem código. É a qual camada cada transformação pertence.
Principais Conclusões
- Documentos bagunçados são o motivo pelo qual a maioria das equipes recorre ao Python, mas a bagunça não é o sinal que realmente importa.
- O teste real não é o quão bagunçados os dados parecem, mas se a regra descreve um único campo ou uma relação entre sistemas.
- A limpeza em nível de campo pode acontecer onde o campo é lido, o que deixa o Python para as junções e reconciliações que valem a pena.
O que a Limpeza de Dados Pós-Extração Realmente Inclui
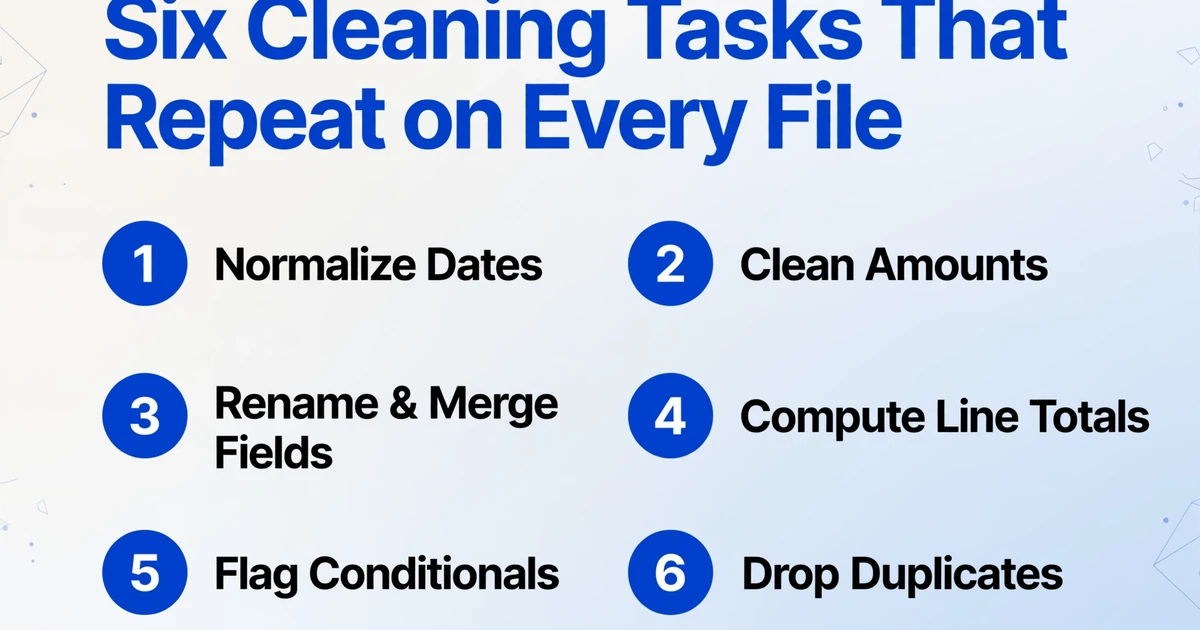
A limpeza de dados pós-extração é o trabalho de transformar valores brutos de campos em valores que um sistema downstream aceitará. As tarefas se repetem entre equipes porque os documentos variam e os sistemas não. Seis famílias cobrem a maior parte disso.
- Normalização de data e hora. Documentos misturam
04/05/2026,5 Apr 2026,2026.04.05e "o dia 5 de abril". Classificação, envelhecimento e correspondência quebram tudo até que a coluna carregue um formato. - Limpeza de valores e números. Símbolos de moeda, separadores de milhares, vírgulas decimais europeias e parênteses para negativos ficam dentro do que deveria ser um número.
$1.2Be($47.99)permanecem como texto até que algo os converta. - Renomeação e mesclagem de campos. O documento diz "You Owe" e seu sistema quer "Patient Responsibility". O documento divide um endereço em três linhas e seu sistema quer uma coluna.
- Consolidação de itens de linha. Multiplique a quantidade pelo preço unitário, some cada linha de uma seção, derive um subtotal que nunca foi impresso na página.
- Sinalizadores condicionais. Marque uma linha quando o total não for igual à soma de suas partes, ou quando uma fatura ultrapassar um limite orçamentário.
- Detecção de duplicatas. Uma tabela que atravessa uma quebra de página pode extrair a mesma linha duas vezes, inflando um subtotal antes que alguém perceba.
Essas são exatamente as tarefas para as quais um sandbox de pós-processamento Python é construído. Elas também são exatamente as tarefas que uma regra de extração declarativa pode tratar sem um script. A variação é o que os profissionais descrevem quando perguntam como colocar dados de PDF no Excel de forma limpa entre arquivos: algumas fontes importam bem, outras chegam como texto embaralhado sem estrutura consistente, e nem a cópia manual nem um modelo geral escalam, como um tópico do r/excel sobre PDFs inconsistentes coloca. A diferença é onde a regra vive e quem pode mantê-la seis meses depois.
O teste para saber se uma transformação pertence a um script não é o quão bagunçada a entrada parece. É se a regra fala sobre um campo, ou sobre a relação entre documentos e sistemas.
Por que um Script em Python Parece a Resposta Mais Honesta
Descartar scripts seria desonesto, porque algumas transformações realmente têm a forma de um script. Se a regra precisa comparar este documento com outro, unir dados de vários sistemas, chamar um serviço externo ou manter estado durante uma execução, nenhuma regra de coluna expressa isso, e um script é o instrumento certo.
Correspondência entre documentos. Sua fatura faz referência ao PO-4471. Se essa ordem de compra existe, se os valores coincidem e se as mercadorias já foram pagas estão em um arquivo diferente ou em um sistema diferente.
Junções e conciliação de múltiplas fontes. Extrato contra razão contábil, fatura contra ordem de compra e recebimento de mercadorias, três exportações de três clientes mescladas em uma tabela limpa.
Consultas externas. Uma taxa de câmbio em tempo real, uma tabela tributária atual ou uma lista mestre de fornecedores que você mantém em um banco de dados.
Orquestração com estado. Tentativas, ramificação em caso de falha parcial, filas e registros do que já foi executado.
Scripts trazem pontos fortes reais nessas tarefas. Eles são reutilizáveis, podem ser versionados, podem ser testados e podem ser executados em um agendamento. Quando uma tarefa é genuinamente em forma de script, reconstruí-la como um fluxo de trabalho visual geralmente produz uma versão pior do mesmo script.
A comunidade de automação traça a linha mais ou menos no mesmo lugar. Um tópico do r/automation sobre Python versus Make e n8n descreve as ferramentas visuais como camadas de abstração excelentes para orquestração e controle, concordando que ir totalmente no-code é um passo atrás para quem já sabe escrever código. Código para lógica, argumenta o tópico, e ferramentas visuais para a conexão entre as etapas.
Onde o Script Silenciosamente Custa Mais do que Economiza
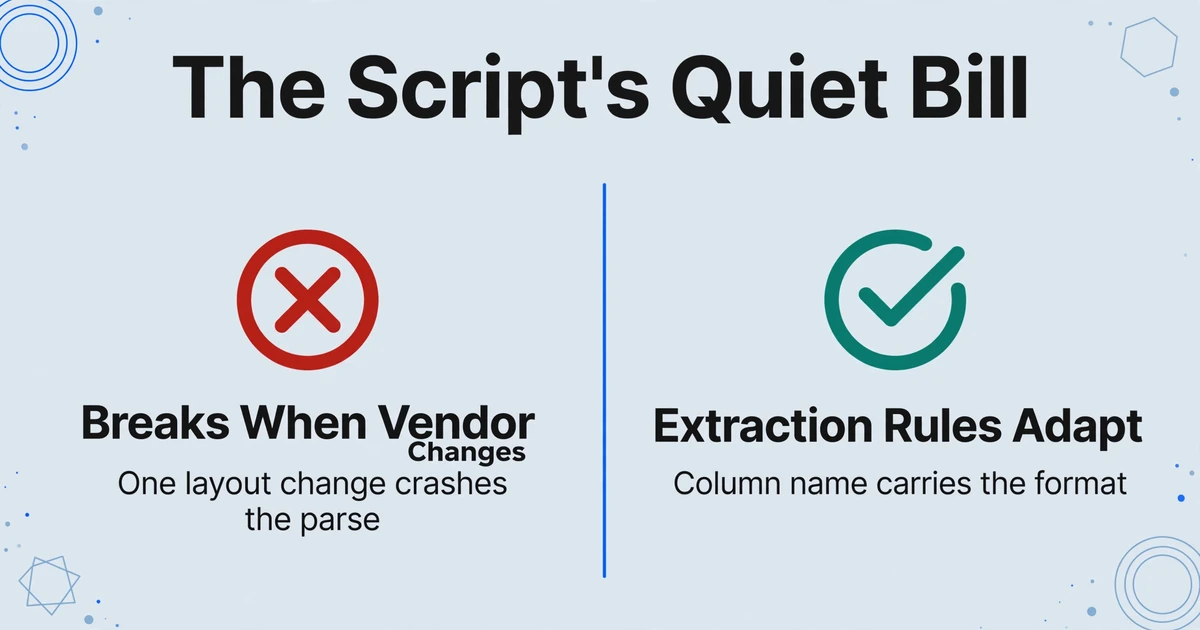
Os scripts pagam pela flexibilidade com manutenção, e a conta chega de uma forma que nunca aparece no plano do projeto.
Mudanças de versão quebram o parse. Um profissional de dados descreveu exatamente isso no r/TrueOffMyChest: um script Python processava faturas diárias por seis meses, até que um fornecedor mudou levemente o layout de uma fatura, o script travou em um erro que nunca havia tratado, e o autor havia esquecido completamente o processo manual. O script não falhou porque foi mal escrito. Falhou porque o documento para o qual foi escrito mudou.
O autor se torna a única pessoa que pode corrigi-lo. Lógica de parsing não documentada é um ponto único de falha. Quando essa pessoa está de férias, o processo espera.
Dependências se desatualizam. Versões de bibliotecas mudam, ambientes diferem entre máquinas, e um pipeline que funcionava no trimestre passado para de funcionar após uma atualização que ninguém acompanhou.
Falha silenciosa é o tipo caro. Um script que trava é visível. Um script que roda com sucesso e escreve valores errados na coluna não é, e é esse resultado que chega a um livro-razão antes que alguém questione.
Cada formato quer seu próprio script. Uma regex ajustada para a fatura de um fornecedor não se transfere para o próximo fornecedor. Você acaba mantendo um script por fonte, e a contagem só cresce.
Um script que precisa ser editado sempre que um fornecedor redesenha uma fatura não é uma configuração única. É uma assinatura com conta variável.
O que uma rota declarativa cobre antes de você abrir um editor
Uma rota declarativa move a transformação para a etapa de extração, de modo que um valor chegue no formato desejado quando a tabela aparecer. ImageToTable.ai, uma ferramenta de entrada de dados por IA, faz isso de três maneiras, e juntas elas cobrem as seis famílias de tarefas acima.
Custom Column Extraction é a primeira. Você digita os nomes das colunas que deseja, e a IA localiza cada valor entendendo o que ele significa em vez de onde ele está na página. Como o nome da coluna também é a instrução, uma solicitação de formato pode estar dentro dele. Nomeie uma coluna "Invoice Date (YYYY-MM-DD)" e a saída trará a data normalizada, independentemente da convenção usada pelo documento. Nomeie uma "Total Amount (decimal)" e o símbolo de moeda e os separadores de localidade serão resolvidos antes que o valor chegue à sua planilha.
Computed Columns são a segunda. Uma coluna calculada é uma coluna cujo valor é calculado durante a extração a partir de outros campos no mesmo documento. Aritmética por linha, uma soma em todas as linhas de uma seção, um resultado condicional, um parâmetro fixo ou um valor derivado que o documento nunca imprimiu podem ser definidos dessa forma. Regras simples vão diretamente no nome da coluna, por exemplo Line Total (Qty × Unit Price). Uma derivação de várias etapas pode ser escrita em um JSON Rule Format, o que mantém o nome da coluna limpo enquanto a lógica permanece precisa.
Intelligent data post-processing é a terceira. A ferramenta padroniza datas, valores e números de série no formato que você especificar durante a mesma passada de extração, para que o Excel, CSV ou JSON exportado esteja pronto para uso em vez de precisar de uma segunda rodada de limpeza.
Mapeado para as seis famílias, a versão declarativa é concreta. Uma data ou valor é normalizado pelo formato dentro do nome da coluna. Uma renomeação ou mesclagem é uma decisão de nomenclatura, porque a IA mapeia cada campo do documento para o seu nome de saída por significado. Um rollup de linha ou um subtotal derivado é uma coluna calculada. Um sinalizador condicional também é uma coluna calculada, por exemplo, uma que gera a diferença sempre que o total extraído não for igual ao valor cobrado no documento. Um parâmetro fixo, como uma taxa de imposto, é incorporado à regra sem que o documento o contenha. Linhas duplicadas provenientes de uma quebra de página são tratadas pela Multi-Page Merge, que dobra páginas divididas de volta em uma linha e resolve valores conflitantes por regra.
Essa é a mesma ideia que o guia para mover o cálculo para a extração desenvolve para totais de faturas, e o fluxo de verificação assume as verificações que ainda pertencem a um humano.
Os arquivos são processados com segurança e não são armazenados.
O valor não está no fato de a ferramenta pensar por você. Está no fato de que a aritmética mecânica e a formatação acontecem onde o campo é lido, então sua revisão começa a partir de respostas em vez de strings brutas.
O Limite: Quando Você Realmente Precisa de Código
Ser honesto sobre o limite importa mais aqui do que um discurso limpo, porque um fluxo de trabalho construído sobre uma afirmação exagerada falha da mesma forma que o script falhou. O ImageToTable.ai não executa Python arbitrário, não oferece um sandbox de script e não realiza correspondência campo a campo entre documentos. Suas regras são no nível de campo: normalizar este valor, calcular isto a partir destes campos, inferir esta categoria, dobrar estas páginas em uma linha. Qualquer coisa que exija comparar um documento com outro, ou com um sistema, permanece fora da etapa de extração.
Isso deixa uma lista curta e honesta de tarefas que pertencem ao código: comparar uma fatura com sua ordem de compra e recibo, conciliar um extrato bancário com um livro-razão, consultar uma taxa de câmbio em tempo real ou uma lista mestra de fornecedores, resolver um nome de fornecedor para um registro canônico e orquestrar trabalhos de várias etapas com novas tentativas e estado. Nenhuma dessas tarefas fica mais fácil ao forçá-las em uma regra de coluna, e fingir o contrário apenas recriaria a fragilidade contra a qual este artigo argumenta.
Onde a ferramenta encontra o código é na transferência. A v1 API retorna JSON limpo e estruturado, então você pode extrair e padronizar na ferramenta e depois executar seu próprio script sobre valores que já são consistentes. Se você está especificamente avaliando um sandbox integrado em vez dessa abordagem dividida, nossa comparação com o Airparser aborda a compensação. Escolher regras no momento da extração para o trabalho no nível de campo não remove o Python de uma equipe de dados. Isso reserva o Python para o trabalho que realmente precisa dele.
Uma Regra de Decisão que Você Pode Aplicar Hoje
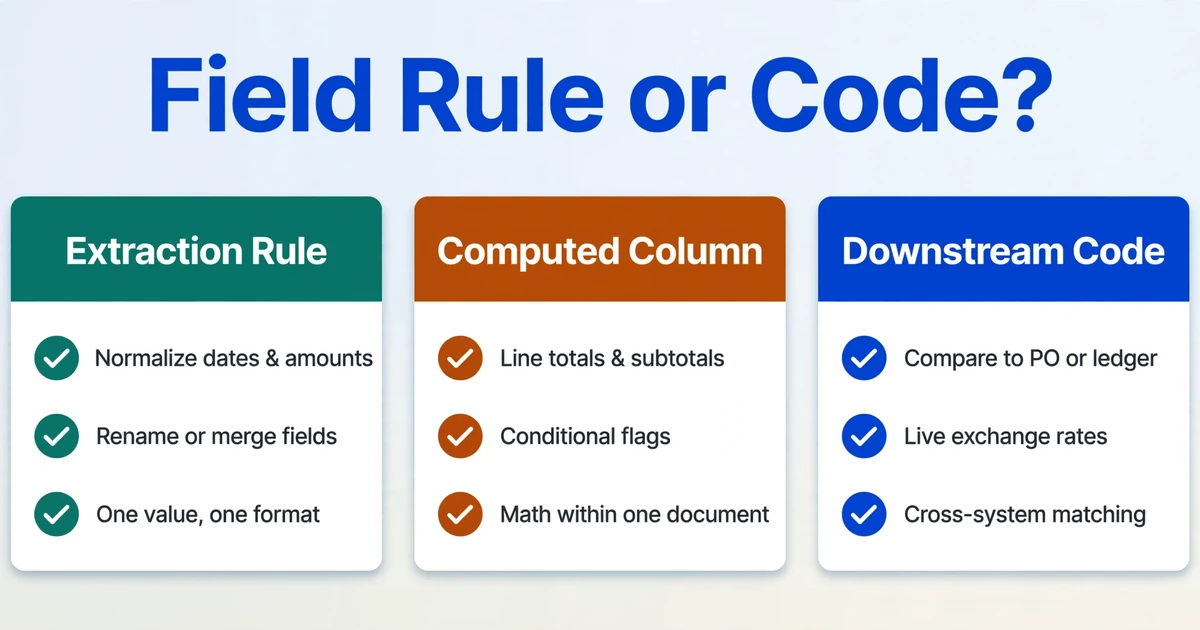
Leia cada transformação e faça uma pergunta: a regra descreve um campo, ou uma relação entre documentos e sistemas? Regras de campo pertencem à extração. Lógica de sistema pertence ao código.
| Transformação | Onde pertence | Por quê |
|---|---|---|
| Normalizar datas, valores, identificadores | Regra de extração | Um valor, um formato determinístico |
| Renomear, mesclar ou dividir campos | Regra de extração | O nome da coluna de saída é o mapeamento |
| Aritmética de linha e totais de linha | coluna calculada | Matemática dentro da linha em campos extraídos |
| Subtotal de seção ou total derivado | coluna calculada | Soma entre linhas dentro de um documento |
| Sinalizador condicional (total não corresponde ao valor faturado) | coluna calculada | Uma condição sobre valores já extraídos |
| Linha duplicada por quebra de página | Multi-Page Merge | Agrupa páginas de um documento lógico |
| Comparar esta fatura com seu pedido de compra | Código downstream | Precisa de um segundo documento |
| Conciliar extrato com razão contábil | Código downstream | Precisa de outro sistema, estado e correspondência |
| Taxa de câmbio ao vivo ou consulta de dados mestre | Código downstream | Precisa de um serviço externo |
| Resolver um nome de fornecedor para um registro mestre | Código ou uma ferramenta de dados | Precisa de uma lista canônica mantida |
Se você consegue escrever a transformação como uma frase sobre um campo, ela pertence à extração. Se a frase precisa das palavras "outro documento" ou "o sistema", ela pertence ao código.
Perguntas Frequentes
O ImageToTable.ai pode executar um script Python nos meus dados extraídos?
Não. A ferramenta padroniza formatos e calcula valores durante a extração por meio de regras de coluna. Ela não executa código arbitrário nem oferece um sandbox de script. Se uma transformação realmente precisar de Python, a API v1 retorna JSON estruturado que você pode processar no seu próprio ambiente.
Uma coluna calculada é o mesmo que pós-processamento em Python?
Não. Uma coluna calculada se limita a aritmética e lógica sobre os campos de um documento: matemática em nível de linha, somas dentro de uma seção, saídas condicionais, parâmetros fixos e valores derivados. Ela não importa bibliotecas, não chama serviços externos nem mantém estado entre documentos. Esse escopo mais restrito é o objetivo, porque é o que uma regra de coluna pode garantir de forma confiável.
Quando escrever um script é a escolha certa?
Quando a regra precisa envolver algo fora do documento individual: comparar uma fatura a um pedido de compra, conciliar um extrato bancário com um livro-razão, buscar uma taxa de câmbio em tempo real, associar um nome de fornecedor a um registro mestre ou orquestrar trabalhos de várias etapas com tentativas e ramificações. Esses trabalhos são genuinamente adequados a scripts, e as regras de extração não devem fingir cobri-los.
A padronização integrada lida com datas de países diferentes?
Ela pode emitir o formato canônico que você especificar, então uma coluna que mistura convenções fica consistente. Ela não consegue resolver um valor genuinamente ambíguo, como 04/05/2026, sem contexto. Quando o documento não oferece um sinal de localidade, a saída segura é um sinalizador para revisão, em vez de uma suposição silenciosa, e esse limite vale a pena lembrar antes de confiar em uma coluna de data normalizada.
Ele consegue mesclar ou renomear colunas após a extração em vez de usar um script?
Você define as colunas de saída antes da extração, e a IA mapeia cada campo do documento para o seu nome pelo significado, e não pela posição, então renomear ou mesclar é uma decisão de nomenclatura, e não um código posterior. Corresponder um valor em um documento a um valor em outro documento está fora do escopo e permanece no código.
Nada disso torna o Python opcional para uma equipe de dados. Isso torna o Python seletivo. Quando a limpeza no nível do campo acontece onde o campo é lido, o código que permanece é o código que vale a pena: as junções, as reconciliações e a lógica do sistema que nenhuma regra de coluna consegue expressar. A segunda tarefa após a extração não desaparece. Ela fica menor, e a parte que permanece é a parte que vale a pena escrever.