規制文書がデータ抽出に
抵抗する理由
医薬品規制申請書類は、世界で最もデータ抽出が簡単な文書のように見えます。国際的に合意された固定構造に従い、すべてのスポンサーが同じ順序で使用する番号付きセクションまで定められています。しかし、それらを扱う人々、すなわち臨床試験報告書やCTDモジュールを構造化データに変換する規制業務の専門家は、同じ失敗を繰り返し口にします。返ってきたテーブルが必要だったテーブルではない、と。その理由は文書が長いからではありません。完全な新薬申請は数十万ページに及ぶこともあり、それは事実ですが、長さだけが抽出を失敗させるわけではありません。理由は、単一の規制文書が同じ事実を複数の形状で格納しており、どの形状を指しているのか誰も指定しないときに抽出が失敗するからです。
重要ポイント
- 世界で最も rigid な文書こそ、抽出が間違え続ける文書です。
- 1つの重篤な有害事象が3つのセクションに3つの詳細レベルで存在するため、「有害事象を抽出する」には3つの正当な答えがあります。
- 列と必要な形状を指定すれば、そのフィールド名はプログラム全体に引き継がれます。
規制文書ファミリーと、重要となるフィールド
規制当局への提出物は、単一の文書ではありません。これは文書のファミリーであり、コモン・テクニカル・ドキュメント(CTD)と呼ばれる形式によってまとめられています。CTDは、2000年11月に国際調和会議(ICH)が採択し、すべての医薬品規制当局が同じ構造でレビューできるようにしたものです。CTDは5つのモジュールで構成されています。モジュール1は地域固有の行政資料、モジュール2は要約と概要、モジュール3は品質、化学、製造、管理に関する情報、モジュール4は非臨床試験報告書、モジュール5は臨床試験報告書を収載します。電子版であるeCTDは、同じ構造をXMLバックボーンで包みますが、基盤となるコンテンツとモジュール番号は同一です。この調和された枠組みは、ICHによって公開されています。
臨床試験報告書(CSR)は、試験データの抽出が必要だと言うときに、ほとんどの人が意味する文書です。これはICH E3で定義された固定の16セクションからなる報告書であり、モジュール5内に位置し、モジュール2の臨床概要からクロスモジュール参照されます。安全性ナラティブは、単一の死亡または重篤な有害事象に関する短い散文の記述であり、一人の患者に何が起こったかの経緯を伝える自由文形式のブロックです。モジュール3のCMC規格表は、原薬または製品が満たさなければならないパラメータ(定量法、不純物、溶出規格など)を一覧にします。これらの各文書には、認識可能な一連のフィールドがあり、そのセットこそが、あらゆる抽出が対象としなければならないものです。
| 文書 | 所在 | 抽出されるフィールド |
|---|---|---|
| 臨床試験報告書 | CTDモジュール5、ICH E3で定義 | 試験タイトル、フェーズ、適応症、主要・副次評価項目、患者集団、有効性結果の要約、有害事象発生率 |
| 安全性ナラティブ | CSR付録16、イベントごとに1件 | 被験者ID、イベント用語、重症度、発症日、処置、転帰、因果関係の判定 |
| CMC規格表 | CTDモジュール3 | 原薬名、試験名、受理基準、分析方法、製造サイト |
| 統合安全性サマリー | CTDモジュール2.7.4 | 安全性評価対象集団、曝露データ、身体システム別の有害事象頻度 |
そのフィールドリストは推測ではありません。安全性フィールドはデータ標準に遡ります。ICH E2Dは、症例が完全とみなされるために必要な最小限の要素、すなわち特定可能な報告者、特定可能な患者、有害反応、被疑薬を定めており、その添付資料には患者、製品、事象の詳細のより完全なセットが列挙されています。電子送信形式であるICH E2B(R3)は、これらを安全性データベースが名前で期待する正式なデータ要素に変換します。したがって、被験者ID、事象名、重症度、発症日、処置、転帰、因果関係を求めるとき、業界がすでに合意したフィールドを要求していることになります。ICH E2Dガイドラインは、最小セットの情報源です。
規制提出物のフィールドは標準化されています。しかし、文書内でそれらが現れる場所は標準化されておらず、そのギャップこそが抽出を失敗させる原因です。
固定構造でも抽出が失敗する理由
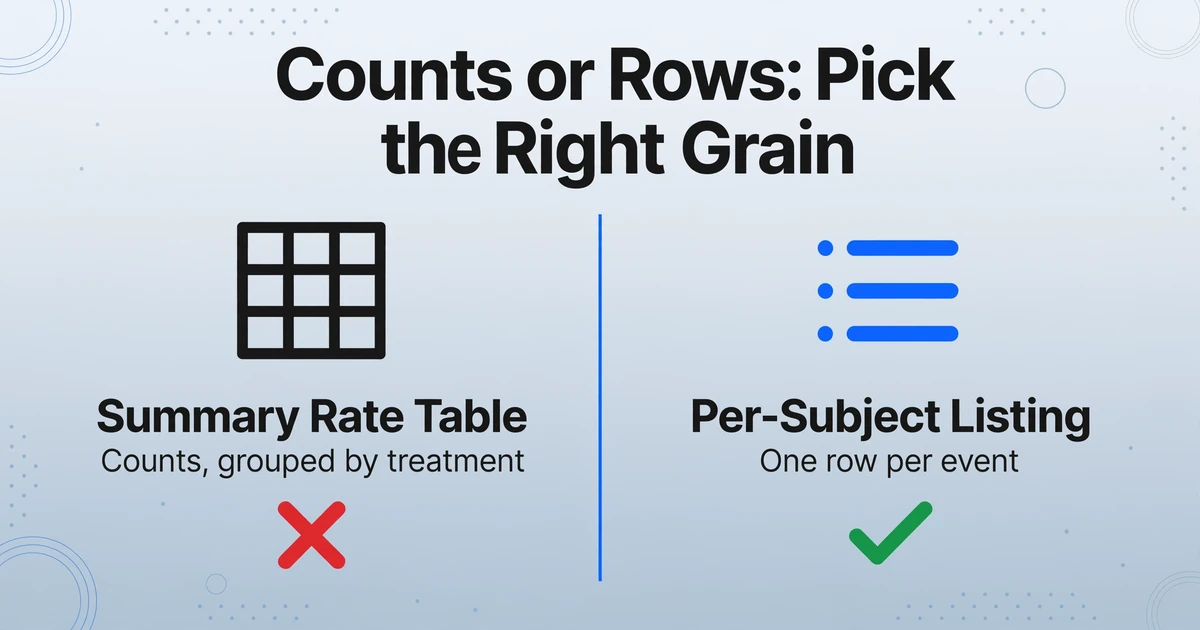
構造が固定され、フィールドが標準化されていれば、抽出は簡単なはずです。しかし実際はそうではなく、その最も明確な例は、単一の臨床試験報告書内で有害事象データがどのように整理されているかです。
ICH E3は、同じ有害事象情報を、詳細度の異なる3つのセクションに配置しています。セクション12.2は報告書本文中の安全性評価であり、12.2.2では、治療群間でグループ化・比較された要約表に事象を表示することを求めています。これらの詳細な表示は実際には12.2に印刷されず、ガイドラインはそれらをセクション14.3.1に誘導しており、そこでは各事象が身体システム別に重症度と関連性とともに配置されています。そしてセクション16.2.7は、事象が被験者ごとに1件ずつ表示される一覧です。ICH E3ガイドライン本文は、これらが同じ基礎となる事象の異なる表現であることを明示しています。
これが最初の構造上の罠です。ツールに「有害事象」と、どの形式を望むかを指定せずに尋ねると、集計率表、被験者別一覧、ナラティブという3つの正当な候補があります。列名として表現されたリクエストは、モデルが最初に読み取った表示から取得され、被験者別一覧を望んでいたのに要約表を取得した場合、イベントごとに1行を期待していたのに件数だらけのテーブルができあがります。これは長文書の問題ではありません。特異性の問題であり、50ページの報告書でも発生します。
その上に、さらに2つの失敗ポイントがあります。 クロスモジュール参照とは、探している数値が、見ている場所に印刷されていない可能性があることを意味します。モジュール2の要約は、モジュール5の試験報告書と同じ結果を説明しており、繰り返すのではなく、それらを参照しています。値がクロスリファレンスとしてのみ表示される場合、それは要約ではなく、元の報告書から読み取る必要があります。 入れ子・結合ヘッダーが2つ目です。有害事象の表では、身体システムと基本語の階層を表現するために結合セルが日常的に使用されるため、単純な読み手はイベント用語を取得しても、それぞれがどの身体システムに属していたかを失います。この機械的な失敗モードは、文書処理の概要のより広い全体像の一部であり、この記事はグリッドではなく規制構造に焦点を当てています。
この仕事に携わる人々は、より平易な言葉で同じことを言います。規制業務の専門家が情報交換をするサブレディットでは、日常業務の自動化に関するスレッドは、同じ一連の作業を巡っています。試験報告書の要約、プロトコルの骨子の作成、長いPDFから同じ数値を繰り返し抽出することです。この作業は、統計分析のような知的に難しいものではありません。それは、それ以外は rigid な文書タイプの中での反復性であり、チームを疲弊させます。なぜなら、その rigid さがテンプレートが機能するはずだという錯覚を与え、そして新しい試験報告書が、同じセクションでありながら異なる表で、静かにそれを打ち負かすからです。
業界が自らに与える抽出アドバイスに現れる、このバージョンがあります。PDFからスプレッドシートへ表をコピーすることについてのよく知られた質問では、データが単一の乱雑なセルとして貼り付けられるという不満があります。 「そうすると、データはほとんどの場合、単一のセルに貼り付けられます。」 これは、規制のケースと同じ失敗を、縮小して示したものです。値は存在し、読み取れますが、それらを意味のあるものにした構造が失われています。r/excelスレッドは通常のPDFに関するものであり、そのパターンは直接的に当てはまります。
手動抽出が実際に破綻する場面
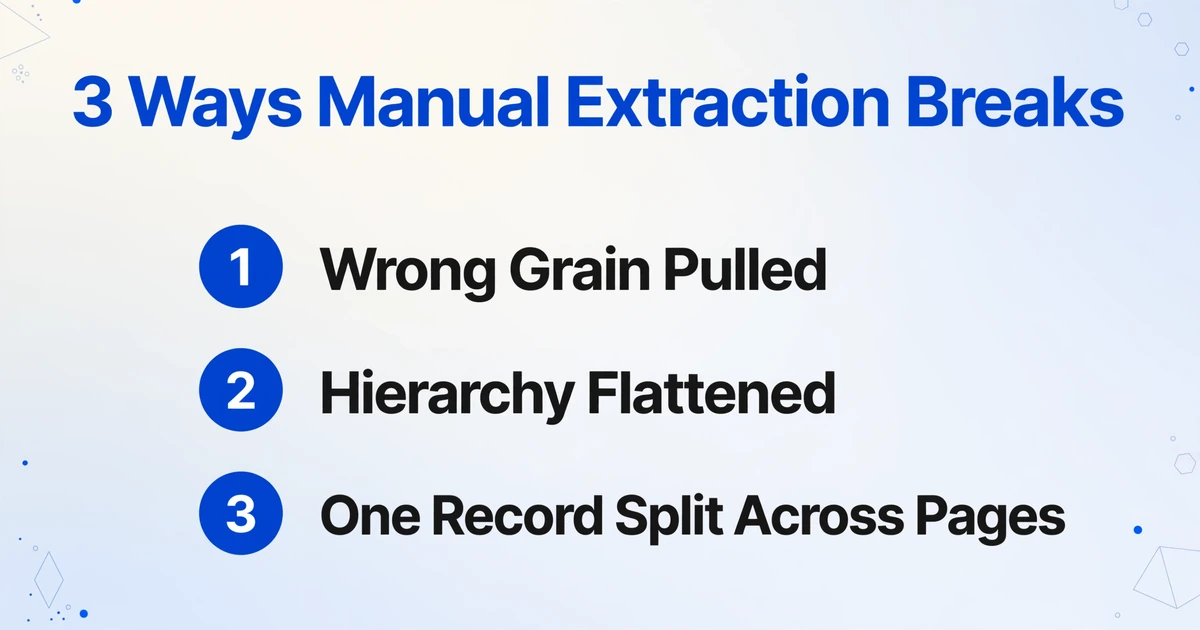
具体的なミスを特定することが、「エラー」と一般化して語るよりも有効です。担当者が臨床試験報告書とスプレッドシートを前にしたとき、3つの問題が予測可能な順序で発生します。
誤った粒度が取得される。 報告書には、あるセクションに件数、別のセクションに被験者レベルの行が含まれており、12.2の便利な表を読んで、分析に実際に必要なイベントレベルのレコードではなく率を取得してしまうことがよくあります。これは再作業を余儀なくさせるミスです。修正されたデータは、まったく別のセクションから取得する必要があるからです。
階層が平坦化される。 身体システム、次に基本語、そして個々のイベントという3レベル構造があります。これをフラットな行に書き写すと、中間レベルが頻繁に消え、各イベントが特定の身体システムに属さない状態になります。後でそれを再構築するには、元の表に戻る必要があります。
1つの論理レコードがページをまたぐ。 重篤な事象の安全性ナラティブはページの区切りをまたぐことがあり、被験者のイベントは数十ページに及ぶ付録に分割されることがあります。手作業で書き写すと、そのレコードは2つの行に分割されるか、一部が完全に欠落します。
これらのミスは、いずれもタイピング速度の問題ではありません。文書が紙面から離れた時点で保持されない構造を、担当者が手作業で保持しようとすることの問題です。これが抽出の根拠であり、適切な種類の抽出を選択する根拠でもあります。テンプレートベースのツールは、同じ3つのミスを機械の速度で繰り返すからです。位置で照合し、表がずれた瞬間に意味を失います。
テンプレートを描く代わりに列を定義する
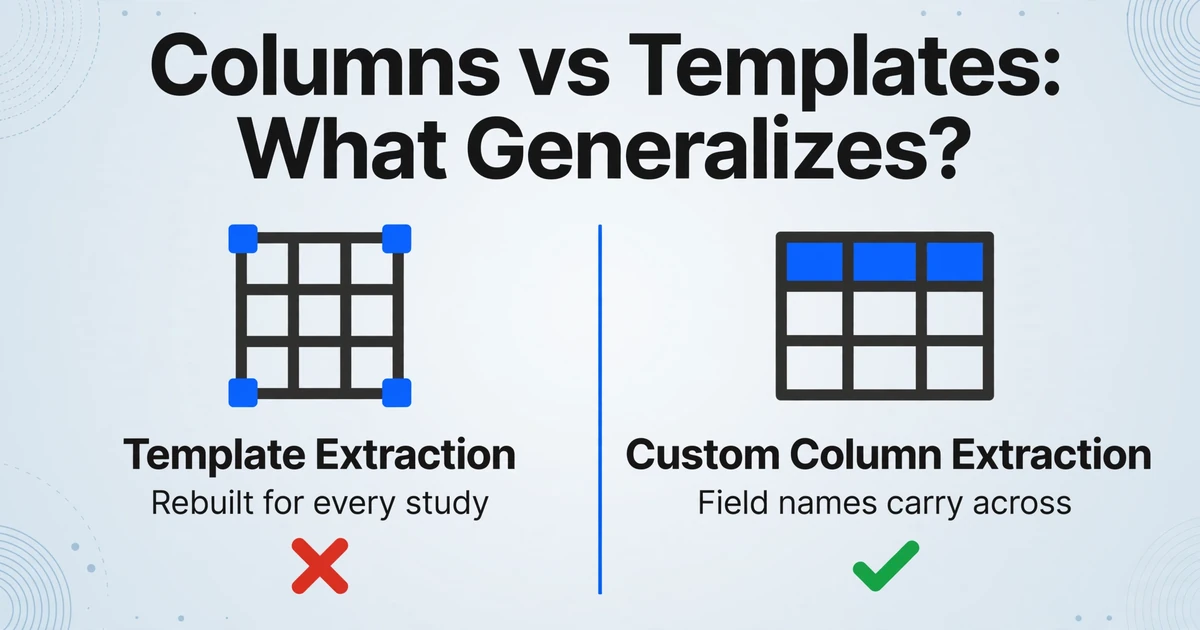
解決策は、データがどこにあるかを記述するのをやめ、何を求めたいかを記述することです。カスタム列抽出は列名で機能します。「被験者ID」「イベント用語」「重症度」「発症日」「因果関係」などのフィールド名を入力すると、AIはページ上の固定位置を照合するのではなく、列名の意味を理解して各値を特定します。入力した列名が出力テーブルのヘッダーになります。読み取りがセマンティックであるため、同じ列名のセットが、イベントが1つでも50個でも被験者別一覧をソースとする場合や、先月抽出した研究とレイアウトが一致しない場合でも機能します。
これは、コンプライアンス重視の文書ファミリーにおいて、特定の理由で重要です。構造が固定されているためフィールド名は安定して再利用可能ですが、正確なテーブルは固定されていないため、位置ベースのアプローチは決して汎用化されません。列を定義すると、安定した部分(フィールド)は文書間で引き継がれ、不安定な部分(レイアウト)は重要ではなくなります。これは、モジュールごとのテンプレートをすべての臨床試験報告書とCMC規格表について再構築する必要があるテンプレート抽出の動作とは逆です。
3つの列タイプがほとんどの規制ニーズをカバーします。直接列は、明示的に印刷されているフィールドを取得します。これはほとんどのフィールドに当てはまります。エンドポイント、発症日、規格値などです。計算列は抽出中に計算します。例えば、開始日と終了日から期間を導出したり、記載された合計がその内訳と一致しない場合に差を出力したりします。推論列は、文書が印刷していないが暗に示している値を割り当てます。イベントが継続中として記述されているかどうかなどの分類に役立ちます。最後のタイプはテキストの解釈であり、臨床的判断ではありません。判定を必要とするものに使用してはなりません。
ファイルは安全に処理され、保存されません。
一般的な仕組みと、それ以前の位置ベースのツールとの違いについては、テンプレート不要の文書抽出で説明しています。規制チームにとって、実際の運用は理論よりもシンプルです。列名を一度定義すれば、プログラム内のすべてのレポートでそれを再利用できます。
抽出したテーブルをレビュー可能にする
規制対象分野では、抽出したテーブルは、資格のある担当者がソースを再読せずに確認できる場合にのみ有用です。これが、時間を節約する抽出と、検証の負担を増やす抽出の違いです。この課題に直接対応する3つの機能があります。
バウンディングボックス検証付きレビューモードでは、抽出された任意のセルにホバーすると、その値が元のページのどこから来たのかを正確に確認でき、ページ上の領域をクリックすると、対応するセルにジャンプできます。発症日や因果関係などのフィールドでは、「抽出を信頼する」から「抽出をスポットチェックする」へと数秒で変わります。また、フィールドが編集された場合にはAIの元の値も表示されるため、修正の追跡が可能です。
マルチページマージは、複数ページにまたがる文書を、被験者IDなどの共有値でグループ化して1つの行にまとめます。これにより、ページの区切りをまたぐ重大な事象のナラティブや、付録に分散した被験者の記録が、2つの不完全なレコードとして扱われるのを防ぎます。フィールドはそれを含むページから入力され、被験者IDなどの繰り返し情報はすべての行に引き継がれます。
モデルティアは、ソースがスキャン文書や写真撮影された文書の場合に重要です。古い試験報告書は紙のスキャンであることが多く、手書きの注釈が含まれるものもあります。上位の処理ティアでは、密度の高い手書き文字や複雑なレイアウトに対してより強力な基盤モデルを使用しますが、標準ティアでもほとんどの印刷された表形式の文書をカバーしています。同じプラットフォームで、医療文書抽出コンプライアンスガイドで扱われているスキャンされた管理書類など、試験以外の規制文書も処理できます。
バッチ処理も、プログラムレベルの理由から同じリストに含まれます。提出プログラムでは多くのレポートが生成されますが、それらをグループとして処理すると、結果が1つのテーブルに統合され、調整が必要な単一ドキュメントのエクスポートの山が残りません。このパターンは、臨床試験文書抽出など、他の臨床記録でも使用されているものと同じで、出力の粒度の問題は被験者全体です。
この種の抽出が行わないこと
境界を明確にすることは、過大評価するよりも有用です。この分野では、ブログ記事での主張と検証済みシステムはまったく異なるものだからです。
有害事象のコード化は行いません。報告された用語をMedDRAの基本語にマッピングし、身体システムに分類することは、独自の辞書と規約を持つコード化のステップです。抽出は、すでにコード化された用語を文書から運び出すことはできますが、用語を割り当てることはしません。
安全性の判定は行いません。因果関係、重篤度、予測可能性は、資格のある担当者が判断する事項です。推論列は文書に記載されている内容を読み取るだけで、それ以上のことはしません。
匿名化は行いません。レポート内の被験者IDは出力に残ります。ファイルがデータ契約のない場所へ送られる場合、それらを削除することは別の、意図的なステップです。
検証済みまたは監査認定されたシステムではなく、eCTD公開ツールでもありません。規制対象の電子記録には、ICH E6(R3)および21 CFR Part 11に基づき、すべての変更に対する監査証跡や文書化されたシステム検証などの要件が伴います。このツールはそのような認定を保持していません。大規模な提出物の管理・公開を行うシステム、LORENZ docuBridge、EXTEDO eCTDmanagerおよびEXTEDOpulse、Veeva Vault Submissions、Certara GlobalSubmitは、ドシエが組み立てられ、検証され、提出される場所です。抽出はそれらの上流に位置し、人間がレビューするファーストパスであり、システムオブレコードでも公開者でもありません。ここでの比較は、それらのプラットフォームとの比較ではありません。レポートを読んで再入力する人間との比較です。
これらの制限内に残るものは、依然として手作業の大部分を占めています。繰り返し現れる値を文書から取り出し、レビュー担当者が確認できるテーブルにすることです。それが、このタスクを人から、途中で構造を失わないツールへ移すことの要点です。
FAQ
AIは、モジュールごとにテンプレートを作成しなくても、臨床試験報告書からデータを抽出できますか? はい、ページ上に領域を描画するのではなく、必要なフィールドを列名として定義すれば可能です。意味に基づいて読み取るため、同じ列セットが異なる試験報告書や異なるレイアウトでも機能します。CSRには同じ有害事象データが複数の場所に含まれるため、どのセクションのデータを指すのかを指定する必要は依然としてあります。
CTD提出データ抽出とは、正確には何ですか? コモン・テクニカル・ドキュメントを構成する文書から構造化フィールドを引き出すことです。例えば、モジュール5の臨床試験報告書からのエンドポイントや有害事象の詳細、モジュール3のCMC規格表からの規格値、モジュール2からの要約数値などが該当します。目的は、指定した列をキーとした、人間がレビューできる表を作成することです。
有害事象ごとに1行を期待していたのに、抽出結果が件数になったのはなぜですか? CSRには有害事象データが要約率表、被験者別一覧、ナラティブの3つの形式で含まれており、リクエストでどの形式かを指定しなかったためです。被験者IDやイベント用語など、必要な形式の列名を指定することで、要約表ではなく被験者別一覧を対象にできます。
これは、eCTD公開システムや安全性データベースを置き換えるものですか? いいえ。抽出はレビュー可能なファーストパスを生成し、Veeva Vault、LORENZ docuBridge、EXTEDOなどのシステムの上流に位置します。検証済みの監査認定プラットフォームではなく、提出物の公開は行わず、MedDRAへのコード化や因果関係・重篤度の判定も行いません。
構造が固定されているからこそ、列も固定できる
規制文書からの抽出が難しいのは、文書が長いからではありません。固定された構造であっても、同じ事実が率、行、文章として現れることがあり、クロスモジュール参照が、確認している場所に印刷されていない数値を指すことがあるからです。これを理解すれば、解決策はより大きなモデルではなく、よりシンプルなものになります。フィールドを指定し、必要な形式を指定し、位置ではなく意味によってツールに見つけさせることです。これらの文書を厳格にしている規制フレームワークこそが、列名をプログラム全体で再利用可能にしているのです。
1つの臨床試験報告書または1つのCMC規格表を例に、実際に必要な列を定義し、バッチを実行する前に出力を確認してください。