Pourquoi les documents réglementaires résistent
à l'extraction de données
Les soumissions réglementaires pharmaceutiques ressemblent aux documents les plus faciles du monde à extraire. Elles suivent une structure fixe, convenue au niveau international, jusqu'aux sections numérotées que chaque promoteur utilise dans le même ordre. Pourtant, les personnes qui travaillent avec elles, les spécialistes des affaires réglementaires qui transforment les rapports d'étude clinique et les modules CTD en données structurées, décrivent encore et encore le même échec : le tableau qui revient n'est pas celui dont ils avaient besoin. La raison n'est pas que les documents sont longs. Une demande complète de nouveau médicament peut atteindre des centaines de milliers de pages, et c'est réel, mais la longueur à elle seule ne casse pas l'extraction. La raison est qu'un seul document réglementaire stocke le même fait sous plus d'une forme, et l'extraction échoue lorsque personne ne précise quelle forme est visée.
Points clés à retenir
- Les documents les plus rigides du monde sont ceux que l'extraction continue de mal traiter.
- Un seul événement indésirable grave peut figurer dans trois sections à trois niveaux de détail, donc « extraire les événements indésirables » a trois réponses légitimes.
- Nommez les colonnes et la forme souhaitée, et ces noms de champs s'appliquent à tout le programme.
La famille de documents réglementaires et les champs qui comptent
Une soumission réglementaire n'est pas un document unique. C'est une famille de documents, reliés par un format appelé Common Technical Document, que le Conseil international d'harmonisation a adopté en novembre 2000 pour donner à chaque autorité de santé la même structure d'examen. Le CTD est organisé en cinq modules. Le module 1 contient les documents administratifs spécifiques à la région, le module 2 contient les résumés et les synthèses, le module 3 couvre la qualité et la chimie, la fabrication et les contrôles, le module 4 contient les rapports d'études non cliniques et le module 5 contient les rapports d'études cliniques. La version électronique, eCTD, enveloppe cette même structure dans un squelette XML, mais le contenu sous-jacent et la numérotation des modules sont identiques. Le cadre harmonisé est publié par ICH.
Le rapport d'étude clinique (CSR) est le document que la plupart des gens désignent lorsqu'ils disent avoir besoin d'extraire des données d'essai. C'est un rapport fixe en seize sections défini par l'ICH E3, et il se trouve dans le module 5, avec des renvois depuis les résumés cliniques du module 2. Un narratif de sécurité est un court texte en prose décrivant un décès ou un événement indésirable grave unique, le type de bloc de texte libre qui raconte ce qui est arrivé à un patient. Les tableaux de spécifications CMC du module 3 listent les paramètres qu'une substance médicamenteuse ou un produit doit respecter, tels que le dosage, les impuretés et les limites de dissolution. Chacun de ces documents comporte un ensemble reconnaissable de champs, et c'est cet ensemble que toute extraction doit cibler.
| Document | Emplacement | Champs extraits |
|---|---|---|
| Rapport d'étude clinique | Module 5 du CTD, défini par l'ICH E3 | Titre de l'étude, phase, indication, critères d'évaluation principaux et secondaires, population de patients, résumé des résultats d'efficacité, taux d'événements indésirables |
| Narratif de sécurité | Annexe 16 du CSR, un par événement | Identifiant du sujet, terme de l'événement, gravité, date de début, mesure prise, issue, évaluation de la causalité |
| Tableau de spécifications CMC | Module 3 du CTD | Nom de la substance médicamenteuse, nom du test, critères d'acceptation, méthode analytique, site de fabrication |
| Résumé intégré de sécurité | Module 2.7.4 du CTD | Population de sécurité, données d'exposition, fréquence des événements indésirables par système d'organe |
Cette liste de champs n'est pas une supposition. Les champs de sécurité remontent à une norme de données. L'ICH E2D définit les éléments minimaux qu'un cas doit contenir pour être considéré comme complet : un déclarant identifiable, un patient identifiable, une réaction indésirable et un produit suspect, et son annexe liste l'ensemble plus détaillé des informations sur le patient, le produit et l'événement. Le format de transmission électronique, l'ICH E2B(R3), transforme ces éléments en éléments de données formels qu'une base de données de sécurité attend par leur nom. Ainsi, lorsque quelqu'un demande l'identifiant du sujet, le terme de l'événement, la gravité, la date de début, la mesure prise, l'issue et l'évaluation de la causalité, il demande des champs sur lesquels l'industrie s'est déjà accordée. La directive ICH E2D est la source de l'ensemble minimal.
Les champs d'une soumission réglementaire sont standardisés. Les endroits où ils apparaissent dans le document ne le sont pas, et c'est cet écart qui fait échouer l'extraction.
Pourquoi une structure fixe fait toujours échouer l'extraction
Si la structure est fixe et les champs sont standard, l'extraction devrait être triviale. Ce n'est pas le cas, et l'exemple le plus clair est la façon dont les données sur les événements indésirables sont organisées dans un même rapport d'étude clinique.
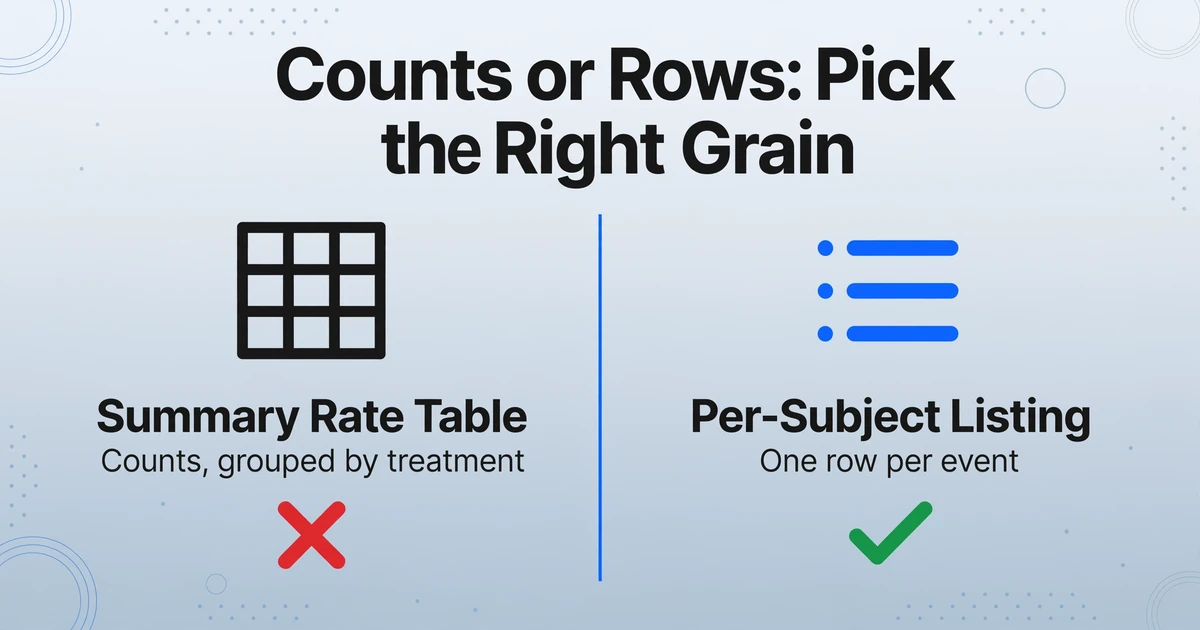
L'ICH E3 place les mêmes informations sur les événements indésirables dans trois sections différentes, à trois niveaux de détail différents. La section 12.2 est l'évaluation de la sécurité dans le corps du rapport, et la section 12.2.2 demande que les événements soient présentés dans des tableaux récapitulatifs, regroupés et comparés entre les groupes de traitement. Ces présentations détaillées ne sont pas réellement imprimées dans la section 12.2 ; la directive les renvoie à la section 14.3.1, où chaque événement est présenté par système d'organe avec la gravité et le lien de causalité. Ensuite, la section 16.2.7 est la liste où les événements apparaissent un sujet à la fois. Le texte de la directive ICH E3 précise qu'il s'agit de présentations différentes des mêmes événements sous-jacents.
C'est le premier piège structurel. Si vous demandez à un outil les « événements indésirables » sans préciser quelle forme vous voulez, il a trois candidats légitimes parmi lesquels choisir : le tableau de taux récapitulatif, la liste par sujet et le narratif. Une demande formulée comme un nom de colonne extraira de la présentation que le modèle lit en premier, et si vous vouliez la liste par sujet mais avez obtenu le tableau récapitulatif, vous avez un tableau rempli de comptages là où vous attendiez une ligne par événement. Ce n'est pas un problème de document long. C'est un problème de spécificité, et il apparaît même dans un rapport de cinquante pages.
Deux autres points de défaillance s'ajoutent à celui-là. Les renvois inter-modules signifient que le nombre recherché peut ne pas être imprimé à l'endroit où l'on regarde. Les résumés du module 2 décrivent les mêmes résultats que les rapports d'étude clinique du module 5 et y renvoient plutôt que de les répéter. Si une valeur n'apparaît que sous forme de renvoi, elle doit être lue dans le rapport source, et non dans le résumé. Les en-têtes de tableau imbriqués et fusionnés constituent le deuxième point : les tableaux d'événements indésirables utilisent couramment des cellules fusionnées pour exprimer une hiérarchie de systèmes d'organes et de termes préférés, de sorte qu'un lecteur naïf capture les termes de l'événement mais perd le système d'organe auquel chacun appartenait. Ce mode de défaillance mécanique fait partie du contexte plus large décrit dans la vue d'ensemble du traitement des documents, cet article se concentre donc sur la structure réglementaire plutôt que sur la grille.
Les personnes qui travaillent dans ce domaine disent la même chose en termes plus simples. Dans le subreddit où les professionnels des affaires réglementaires échangent, les discussions sur l'automatisation des tâches courantes tournent autour des mêmes types de travaux : résumer un rapport d'essai, rédiger une ébauche de protocole, extraire les mêmes chiffres d'un long PDF à plusieurs reprises. Le travail n'est pas intellectuellement difficile comme peut l'être une analyse statistique. C'est la répétitivité au sein d'un type de document par ailleurs rigide qui épuise les équipes, car la rigidité donne l'illusion qu'un modèle devrait fonctionner, puis un nouveau rapport d'étude, avec les mêmes sections mais des tableaux différents, le défait silencieusement.
Il existe une version de ce problème qui apparaît dans les conseils d'extraction que l'industrie se donne. Dans une question bien connue sur la copie de tableaux de PDF vers des feuilles de calcul, la plainte est que les données se collent dans une seule cellule en désordre : « Quand je le fais, les données se collent presque toujours dans une seule cellule. » C'est la même défaillance que dans le cas réglementaire, en miniature. Les valeurs sont présentes et lisibles, mais la structure qui leur donnait un sens a disparu. Le fil r/excel concerne des PDF ordinaires, et le schéma se transpose directement.
Là où l'extraction manuelle échoue réellement
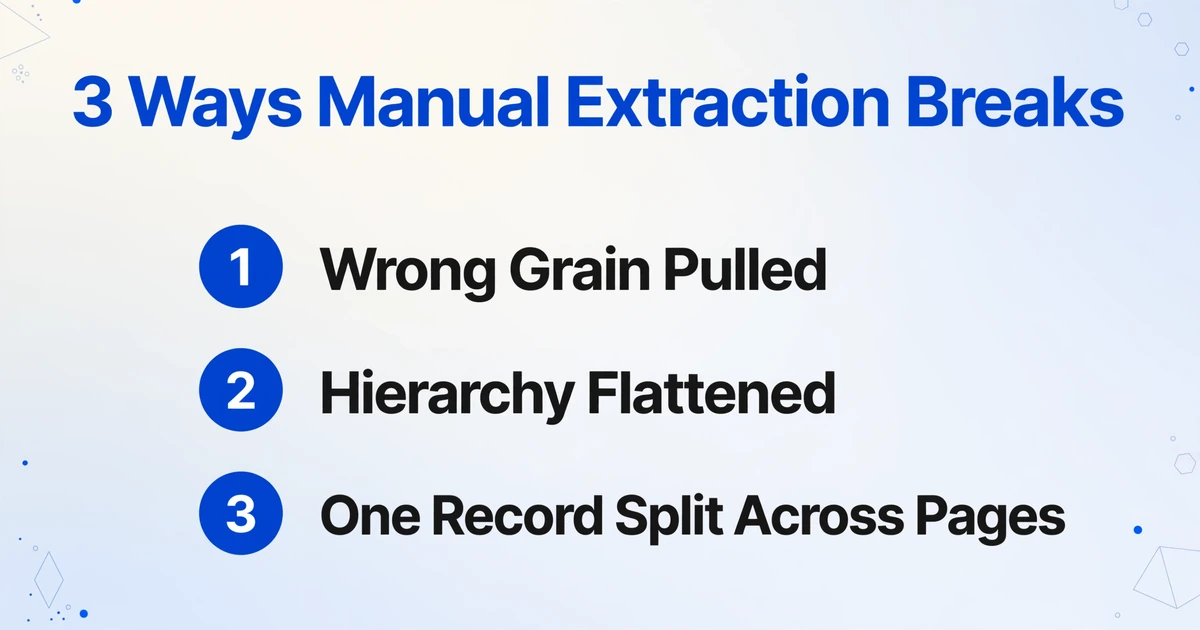
Il est utile de nommer les erreurs spécifiques plutôt que de parler d'« erreurs » en général. Lorsqu'une personne travaille sur un rapport d'étude clinique et un tableur, trois problèmes surviennent dans un ordre prévisible.
La mauvaise granularité est extraite. Le rapport présente des comptes dans une section et des lignes au niveau du sujet dans une autre, et il est facile de lire le tableau pratique de la section 12.2 et d'obtenir un taux au lieu de l'enregistrement au niveau de l'événement dont l'analyse avait réellement besoin. C'est l'erreur qui oblige à tout recommencer, car les données corrigées doivent provenir d'une section entièrement différente.
La hiérarchie est aplatie. Système d'organe, puis terme préféré, puis événements individuels : c'est une structure à trois niveaux. Lorsqu'elle est transcrite en lignes plates, le niveau intermédiaire disparaît souvent, et chaque événement se retrouve sans lien avec un système d'organe particulier. Reconstruire cela plus tard signifie revenir au tableau source.
Un enregistrement logique s'étend sur plusieurs pages. Un narratif de sécurité pour un événement grave peut s'étendre sur un saut de page, et les événements d'un sujet peuvent être répartis sur une annexe qui continue sur des dizaines de pages. Transcrit à la main, cet enregistrement est soit divisé en deux lignes, soit l'une des parties est entièrement omise.
Aucune de ces erreurs n'est liée à la vitesse de frappe. Elles concernent une personne qui maintient manuellement une structure que le document ne conserve pas intacte une fois l'encre sur la page. C'est l'argument en faveur de l'extraction, et c'est aussi l'argument pour choisir le bon type d'extraction, car un outil basé sur un modèle répète les trois mêmes erreurs à la vitesse de la machine : il fait correspondre par position et perd le sens dès qu'un tableau se déplace.
Définir des colonnes au lieu de dessiner des modèles
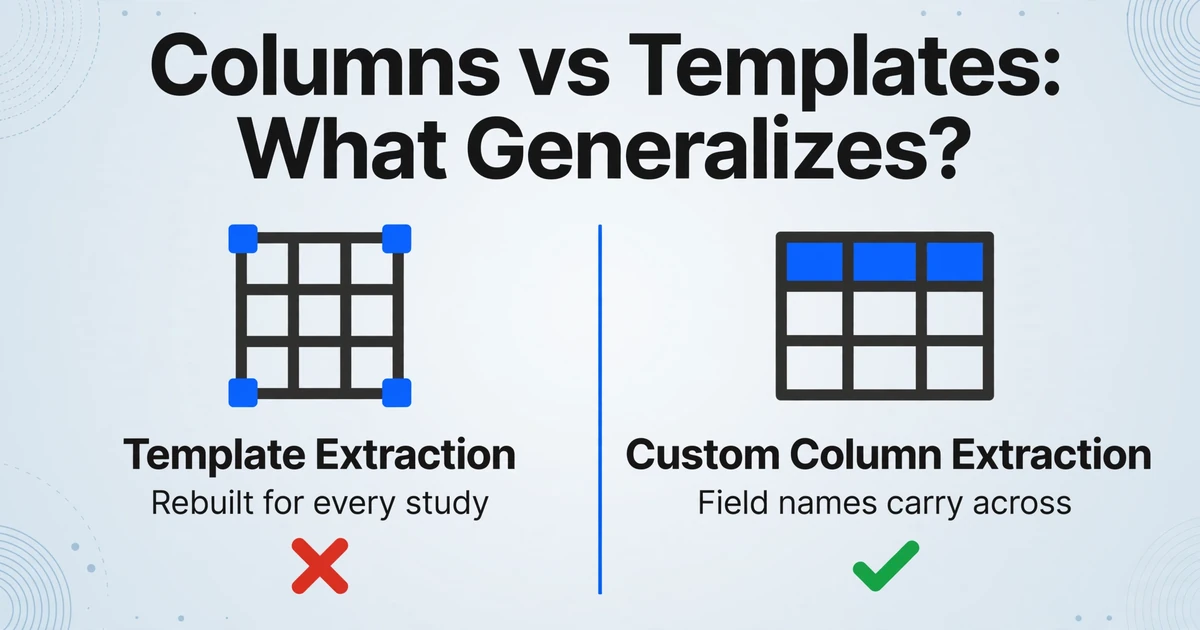
La solution consiste à cesser de décrire où se trouvent les données et à commencer à décrire ce que l'on veut. Custom Column Extraction fonctionne par nom de colonne : on saisit les noms de champs nécessaires, tels que « identifiant du sujet », « terme de l'événement », « gravité », « date de début » et « évaluation de la causalité », et l'IA localise chaque valeur en comprenant la signification du nom de colonne plutôt qu'en cherchant une position fixe sur la page. Les noms de colonnes saisis deviennent les en-têtes du tableau de sortie. Comme la lecture est sémantique, le même ensemble de noms de colonnes fonctionne, que la source soit une liste par sujet avec un seul événement ou cinquante, et que la mise en page corresponde ou non à l'étude extraite le mois dernier.
Cela importe dans une famille de documents soumis à des exigences de conformité pour une raison précise : la structure est fixe, donc les noms de champs sont stables et réutilisables, mais les tableaux exacts ne le sont pas, si bien qu'une approche basée sur la position ne se généralise jamais. Lorsque l'on définit des colonnes, la partie stable (le champ) est conservée d'un document à l'autre et la partie instable (la mise en page) cesse d'importer. C'est l'inverse du comportement de l'extraction par modèle, où un modèle par module doit être reconstruit pour chaque rapport d'étude clinique et chaque tableau de spécifications CMC.
Trois types de colonnes couvrent la plupart des besoins réglementaires. Les colonnes directes extraient les champs explicitement imprimés, ce qui est le cas de la plupart d'entre eux : critères d'évaluation, dates de début, limites de spécifications. Les colonnes calculées effectuent des calculs pendant l'extraction, par exemple en dérivant une durée à partir d'une date de début et de fin, ou en produisant un écart lorsqu'un total indiqué ne correspond pas à ses composantes. Les colonnes déduites attribuent une valeur que le document n'imprime pas mais qu'il implique, utile pour une catégorie telle que le fait qu'un événement soit décrit comme en cours. Ce dernier type est une lecture du texte, pas un jugement clinique, et il ne doit jamais être utilisé pour quoi que ce soit qui nécessite une adjudication.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Le mécanisme général, et ce qui le distingue des outils basés sur la position qui l'ont précédé, est décrit dans l'extraction de documents sans modèle. Pour une équipe réglementaire, la version pratique est plus simple que la théorie : définir une fois les noms de colonnes et les réutiliser pour chaque rapport du programme.
Rendre le tableau extrait vérifiable
Dans un domaine réglementé, un tableau extrait n'est utile que si une personne qualifiée peut le vérifier sans relire la source. C'est la différence entre une extraction qui fait gagner du temps et une extraction qui ajoute une charge de vérification. Trois capacités répondent directement à ce besoin.
Mode de révision avec vérification par boîte englobante permet de survoler n'importe quelle cellule extraite pour voir exactement d'où provient cette valeur sur la page d'origine, et de cliquer sur une région de la page pour revenir à la cellule correspondante. Pour un champ tel qu'une date de début ou une évaluation de la causalité, cela transforme « faire confiance à l'extraction » en « vérifier ponctuellement l'extraction » en quelques secondes. Cela affiche également la valeur d'origine de l'IA lorsqu'un champ a été modifié, afin qu'une correction soit traçable.
Multi-Page Merge regroupe un document qui s'étend sur plusieurs pages en une seule ligne, groupé par une valeur partagée telle qu'un identifiant du sujet. C'est ce qui évite qu'un événement grave dont le narratif traverse un saut de page, ou les enregistrements d'un sujet répartis dans l'annexe, n'arrivent sous forme de deux demi-enregistrements. Les champs se remplissent à partir de la page qui les contient, et les informations récurrentes telles que l'identifiant du sujet sont reportées sur chaque ligne.
Niveau de modèle importe lorsque la source est un document numérisé ou photographié. Les rapports d'étude clinique plus anciens sont souvent des scans papier, et certains comportent des annotations manuscrites. Un niveau de traitement supérieur utilise un modèle sous-jacent plus puissant pour l'écriture manuscrite dense et la mise en page complexe, tandis que le niveau standard couvre déjà la plupart des documents tabulaires imprimés. La même plateforme gère également les documents réglementaires hors essais, y compris le type de documents administratifs numérisés couvert par le guide de conformité pour l'extraction de documents de santé.
Le traitement par lots appartient à la même liste pour une raison au niveau du programme. Un programme de soumission produit de nombreux rapports, et les traiter en groupe fusionne les résultats en un seul tableau au lieu de laisser une pile d'exportations de documents individuels à rapprocher. Le schéma est le même que celui utilisé pour d'autres dossiers cliniques, y compris l'extraction de documents d'essais cliniques où le problème de granularité de sortie est le sujet dans son ensemble.
Ce que ce type d'extraction ne fait pas
Définir clairement les limites est plus utile que de survendre, car dans ce domaine, une affirmation dans un article de blog et un système validé sont des choses très différentes.
Il ne code pas les événements indésirables. Le mappage d'un terme textuel rapporté à un terme préféré MedDRA sous un système d'organe est une étape de codage avec son propre dictionnaire et ses propres conventions. L'extraction peut transporter un terme déjà codé hors d'un document, mais elle n'en attribue pas un.
Il ne procède pas à l'adjudication de la sécurité. La causalité, la gravité et le caractère attendu sont des décisions qui reviennent à une personne qualifiée. Une colonne inférée lit ce que dit le document, et c'est tout ce qu'elle fait.
Il ne procède pas à la désidentification. Les identifiants du sujet dans un rapport restent dans la sortie. Si le fichier est destiné à un environnement sans accord sur les données, leur suppression est une étape distincte et délibérée.
Il ne s'agit pas d'un système validé ou certifié pour l'audit, ni d'un outil de publication eCTD. Les enregistrements électroniques réglementés comportent des exigences telles qu'une piste d'audit pour chaque modification et une validation du système documentée, conformément à ICH E6(R3) et 21 CFR Part 11. Cet outil ne détient aucune certification de ce type. Les systèmes qui gèrent et publient les soumissions à grande échelle, LORENZ docuBridge, EXTEDO eCTDmanager et EXTEDOpulse, Veeva Vault Submissions et Certara GlobalSubmit, sont ceux où le dossier est assemblé, validé et déposé. L'extraction se situe en amont, comme un premier passage examiné par un humain, et non comme le système d'enregistrement ni comme l'éditeur. La comparaison ici ne se fait pas avec ces plateformes. Elle se fait avec une personne qui lit un rapport et le ressaisit.
Ce qui reste dans ces limites constitue encore l'essentiel du travail manuel : extraire les valeurs répétées des documents et les placer dans un tableau qu'un examinateur peut vérifier. C'est tout l'intérêt de transférer la tâche d'une personne vers un outil qui ne perd pas la structure en cours de route.
FAQ
L'IA peut-elle extraire des données d'un rapport d'étude clinique sans créer de modèle par module ? Oui, si vous définissez les champs souhaités comme noms de colonnes plutôt qu'en dessinant des zones sur une page. La lecture se fait par le sens, donc le même ensemble de colonnes fonctionne pour différents rapports d'étude et différentes mises en page. Vous devez toutefois préciser les données de quelle section vous parlez, car un CSR contient les mêmes données d'événements indésirables à plusieurs endroits.
Qu'est-ce que l'extraction de données pour soumission CTD, exactement ? Il s'agit d'extraire des champs structurés des documents qui composent un Common Technical Document, comme les critères d'évaluation et les détails des événements indésirables des rapports d'étude clinique du Module 5, les limites de spécifications des tableaux CMC du Module 3, et les chiffres récapitulatifs du Module 2. L'objectif est un tableau, indexé par les colonnes que vous avez nommées, qu'une personne peut examiner.
Pourquoi mon extraction a-t-elle renvoyé des comptages alors que je voulais une ligne par événement indésirable ? Parce que le CSR contient les données d'événements indésirables sous trois formes : un tableau de taux récapitulatif, une liste par sujet et un narratif, et la demande ne précisait pas laquelle. Nommez les colonnes de la forme souhaitée, comme l'identifiant du sujet et le terme de l'événement, afin que l'outil cible la liste par sujet plutôt que le tableau récapitulatif.
Cela remplace-t-il mon système de publication eCTD ou ma base de données de sécurité ? Non. L'extraction produit un premier passage examinable et se situe en amont de systèmes tels que Veeva Vault, LORENZ docuBridge et EXTEDO. Ce n'est pas une plateforme validée et certifiée pour l'audit, ne publie pas de soumissions, ne code pas les termes vers MedDRA et ne porte pas de jugement sur la causalité ou la gravité.
La structure est fixe, les colonnes peuvent donc l'être aussi
Les documents réglementaires ne sont pas difficiles à extraire parce qu'ils sont longs. Ils sont difficiles parce qu'une structure fixe permet quand même au même fait d'apparaître comme un taux, une ligne et une phrase, et parce qu'un renvoi peut pointer vers un nombre qui n'est pas imprimé à l'endroit où vous regardez. Une fois cela accepté, la solution cesse d'être une question de modèles plus grands et devient plus simple : nommez les champs, nommez la forme souhaitée, et laissez l'outil les trouver par le sens plutôt que par la position. Le cadre réglementaire qui rend ces documents rigides est la même chose qui rend les noms de colonnes réutilisables dans tout un programme.
Prenez un rapport d'étude clinique ou un tableau de spécifications CMC, définissez les colonnes dont vous avez réellement besoin, et voyez le résultat avant d'y engager un lot.