Por qué los documentos regulatorios se resisten a la
extracción de datos
Las presentaciones regulatorias farmacéuticas parecen los documentos más fáciles del mundo para extraer datos. Siguen una estructura fija y acordada internacionalmente, hasta secciones numeradas que todos los patrocinadores usan en el mismo orden. Sin embargo, las personas que trabajan con ellos, especialistas en asuntos regulatorios que convierten informes de estudio clínico y módulos CTD en datos estructurados, describen una y otra vez el mismo fallo: la tabla que se obtiene no es la tabla que necesitaban. La razón no es que los documentos sean largos. Una solicitud completa de nuevo fármaco puede llegar a cientos de miles de páginas, y eso es real, pero la longitud por sí sola no rompe la extracción. La razón es que un único documento regulatorio almacena el mismo dato en más de una forma, y la extracción falla cuando nadie especifica qué forma se quiere.
Conclusiones clave
- Los documentos más rígidos del mundo son los que la extracción sigue fallando.
- Un único evento adverso grave puede aparecer en tres secciones con tres niveles de detalle, por lo que "extraer los eventos adversos" tiene tres respuestas legítimas.
- Defina las columnas y la forma que desea, y esos nombres de campos se mantienen en todo el programa.
La familia de documentos regulatorios y los campos que importan
Una presentación regulatoria no es un solo documento. Es una familia de documentos, unidos por un formato llamado Documento Técnico Común, que el Consejo Internacional para la Armonización adoptó en noviembre de 2000 para dar a todas las autoridades sanitarias la misma estructura de revisión. El CTD se organiza en cinco módulos. El Módulo 1 contiene material administrativo específico de cada región, el Módulo 2 contiene los resúmenes y las visiones generales, el Módulo 3 cubre calidad y química, fabricación y controles, el Módulo 4 contiene los informes de estudios no clínicos y el Módulo 5 contiene los informes de estudios clínicos. La versión electrónica, eCTD, envuelve esa misma estructura en un esqueleto XML, pero el contenido subyacente y la numeración de los módulos son idénticos. El marco armonizado está publicado por ICH.
El informe de estudio clínico (CSR) es el documento que la mayoría de las personas quiere decir cuando dicen que necesitan extraer datos de ensayos. Es un informe fijo de dieciséis secciones definido por ICH E3, y se encuentra dentro del Módulo 5, con referencias cruzadas desde los resúmenes clínicos del Módulo 2. Una narrativa de seguridad es una breve descripción en prosa de una sola muerte o evento adverso grave, el tipo de bloque de texto libre que cuenta la historia de lo que le sucedió a un paciente. Las tablas de especificaciones CMC del Módulo 3 enumeran los parámetros que una sustancia farmacológica o un producto debe cumplir, como ensayo, impurezas y límites de disolución. Cada uno de estos documentos contiene un conjunto reconocible de campos, y ese conjunto es el objetivo de cualquier extracción.
| Documento | Dónde se encuentra | Campos que se extraen |
|---|---|---|
| Informe de estudio clínico | Módulo 5 del CTD, definido por ICH E3 | Título del estudio, fase, indicación, criterios de valoración primarios y secundarios, población de pacientes, resumen de resultados de eficacia, tasas de eventos adversos |
| Narrativa de seguridad | Apéndice 16 del CSR, una por evento | ID del sujeto, término del evento, gravedad, fecha de inicio, acción tomada, resultado, evaluación de causalidad |
| Tabla de especificaciones CMC | Módulo 3 del CTD | Nombre de la sustancia farmacológica, nombre de la prueba, criterios de aceptación, método analítico, sitio de fabricación |
| Resumen integrado de seguridad | Módulo 2.7.4 del CTD | Población de seguridad, datos de exposición, frecuencia de eventos adversos por sistema de órganos |
Esa lista de campos no es una suposición. Los campos de seguridad se remontan a un estándar de datos. ICH E2D establece los elementos mínimos que un caso debe contener para considerarse completo: un notificador identificable, un paciente identificable, una reacción adversa y un producto sospechoso, y su anexo enumera el conjunto más completo de detalles del paciente, el producto y el evento. El formato de transmisión electrónica, ICH E2B(R3), convierte esos elementos en elementos de datos formales que una base de datos de seguridad espera por nombre. Así que cuando alguien dice que quiere ID del sujeto, término del evento, gravedad, fecha de inicio, acción tomada, resultado y causalidad, está pidiendo campos que la industria ya acordó. La guía ICH E2D es la fuente del conjunto mínimo.
Los campos en una presentación regulatoria están estandarizados. Los lugares donde aparecen en el documento no lo están, y esa brecha es donde la extracción falla.
Por qué una estructura fija sigue derrotando a la extracción
Si la estructura es fija y los campos son estándar, la extracción debería ser trivial. No lo es, y el ejemplo más claro es cómo se organizan los datos de eventos adversos dentro de un único informe de estudio clínico.
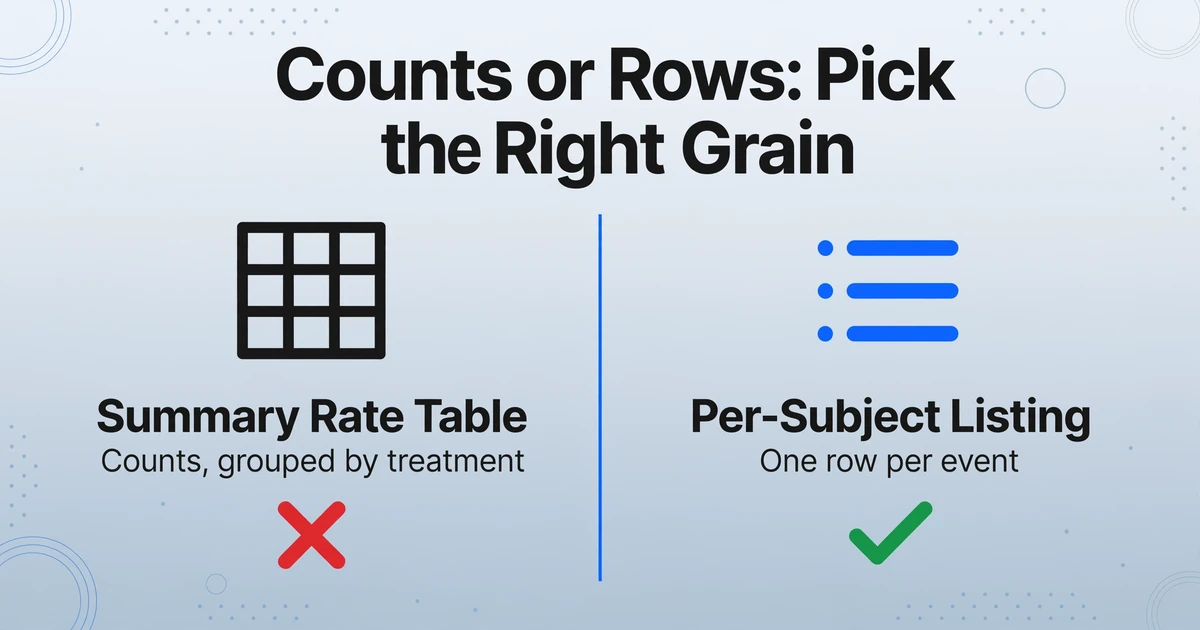
ICH E3 coloca la misma información de eventos adversos en tres secciones diferentes, con tres niveles de detalle distintos. La sección 12.2 es la evaluación de seguridad en el cuerpo del informe, y la 12.2.2 solicita que los eventos se muestren en tablas resumen, agrupados y comparados entre grupos de tratamiento. Esas presentaciones detalladas no se imprimen realmente en la 12.2; la guía las remite a la sección 14.3.1, donde cada evento se presenta por sistema de órganos con gravedad y relación. Luego, la sección 16.2.7 es el listado donde los eventos aparecen un sujeto a la vez. El texto de la guía ICH E3 es explícito en que estas son presentaciones diferentes de los mismos eventos subyacentes.
Esa es la primera trampa estructural. Si le pides a una herramienta "eventos adversos" sin especificar qué forma quieres, tiene tres candidatos legítimos para elegir: la tabla de tasas resumen, el listado por sujeto y la narrativa. Una solicitud expresada como nombre de columna extraerá de la presentación que el modelo lea primero, y si querías el listado por sujeto pero obtuviste la tabla resumen, tienes una tabla llena de recuentos donde esperabas una fila por evento. Esto no es un problema de documentos largos. Es un problema de especificidad, y aparece incluso en un informe de cincuenta páginas.
Sobre esa base se suman dos puntos de fallo más. Las referencias cruzadas entre módulos significan que el número que buscas puede no estar impreso donde estás mirando. Los resúmenes del Módulo 2 describen los mismos resultados que los informes de estudio del Módulo 5 y remiten a ellos en lugar de repetirlos. Si un valor aparece solo como referencia cruzada, debe leerse del informe fuente, no del resumen. Los encabezados de tabla anidados y combinados son el segundo: las tablas de eventos adversos usan habitualmente celdas combinadas para expresar una jerarquía de sistema de órganos y término preferido, por lo que un lector ingenuo captura los términos del evento pero pierde a qué sistema de órganos pertenecía cada uno. Ese modo de fallo mecánico forma parte del panorama más amplio en la descripción general del procesamiento de documentos, así que este artículo se centra en la estructura regulatoria y no en la cuadrícula.
Quienes trabajan en este ámbito lo expresan en términos más sencillos. En el subreddit donde los profesionales de asuntos regulatorios intercambian opiniones, los hilos sobre automatizar tareas rutinarias giran en torno al mismo conjunto de tareas: resumir un informe de prueba, redactar un esquema de protocolo, extraer los mismos números de un PDF largo una y otra vez. El trabajo no es intelectualmente difícil como lo es un análisis estadístico. Es la repetitividad dentro de un tipo de documento que por lo demás es rígido lo que desgasta a los equipos, porque la rigidez da la ilusión de que una plantilla debería funcionar y luego un nuevo informe de estudio, con las mismas secciones pero tablas diferentes, la derrota silenciosamente.
Hay una versión de esto que aparece en los consejos de extracción que la industria se da a sí misma. En una pregunta conocida sobre copiar tablas de PDF a hojas de cálculo, la queja es que los datos se pegan como una sola celda desordenada: "Cuando lo hago, los datos casi siempre se pegan en una sola celda". Ese es el mismo fallo que en el caso regulatorio, en miniatura. Los valores están ahí y son legibles, pero la estructura que les daba significado se ha perdido. El hilo de r/excel trata sobre PDF ordinarios, y el patrón se transfiere directamente.
Dónde falla realmente la extracción manual
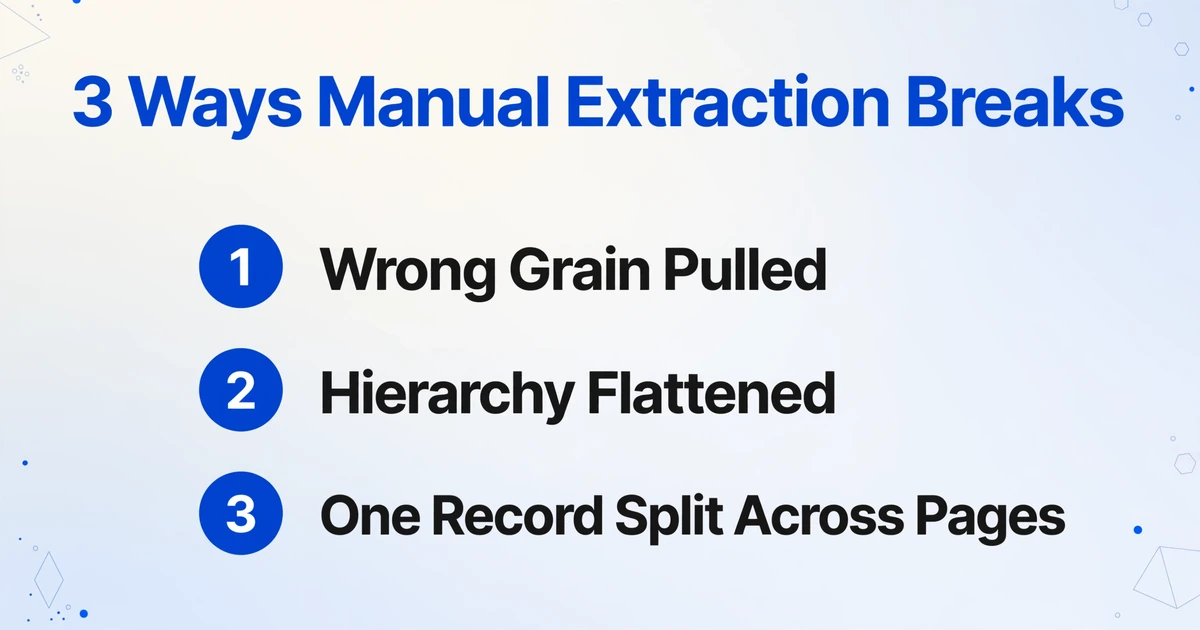
Ayuda nombrar los errores específicos en lugar de hablar de "errores" en general. Cuando una persona se sienta con un informe de estudio clínico y una hoja de cálculo, tres cosas salen mal en un orden predecible.
Se extrae la granularidad incorrecta. El informe ofrece recuentos en una sección y filas a nivel de sujeto en otra, y es fácil leer la tabla conveniente en 12.2 y terminar con una tasa en lugar del registro a nivel de evento que el análisis realmente necesitaba. Este es el error que obliga a rehacer el trabajo, porque los datos corregidos tienen que provenir de una sección completamente diferente.
La jerarquía se aplana. Sistema de órganos, luego término preferido, luego eventos individuales es una estructura de tres niveles. Cuando se transcribe en filas planas, el nivel intermedio desaparece con frecuencia, y cada evento termina sin estar vinculado a ningún sistema de órganos en particular. Reconstruir eso más tarde significa volver a la tabla de origen.
Un registro lógico abarca varias páginas. Una narrativa de seguridad para un evento grave puede extenderse a través de un salto de página, y los eventos de un sujeto pueden dividirse en un apéndice que continúa durante docenas de páginas. Transcrito a mano, ese registro se divide en dos filas o una de las partes se pierde por completo.
Ninguno de estos errores tiene que ver con la velocidad de escritura. Tienen que ver con que una persona mantenga manualmente una estructura que el documento no conserva intacta una vez que la tinta sale de la página. Ese es el argumento a favor de la extracción, y también es el argumento para elegir el tipo correcto de extracción, porque una herramienta basada en plantillas repite los mismos tres errores a velocidad de máquina: coincide por posición y pierde el significado en el momento en que una tabla se desplaza.
Definir columnas en lugar de dibujar plantillas
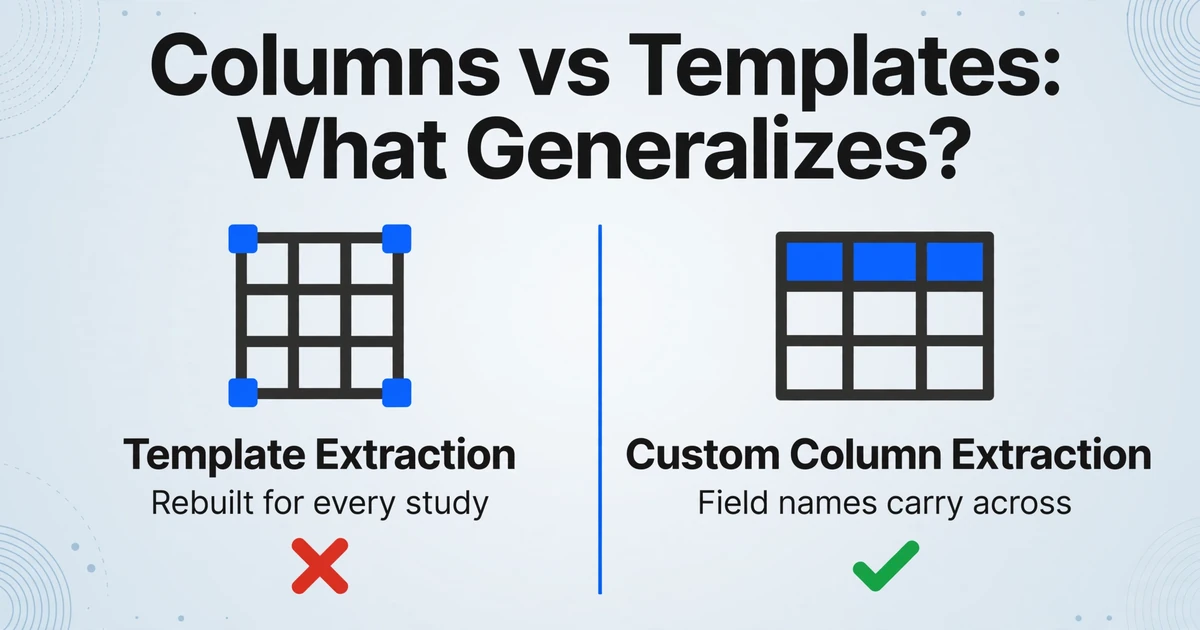
La solución es dejar de describir dónde se encuentran los datos y empezar a describir qué se necesita. Custom Column Extraction funciona por nombre de columna: se escriben los nombres de los campos necesarios, como "ID del sujeto", "término del evento", "gravedad", "fecha de inicio" y "causalidad", y la IA localiza cada valor comprendiendo el significado del nombre de la columna, en lugar de buscar una posición fija en la página. Los nombres de columna que se introducen se convierten en los encabezados de la tabla de salida. Dado que la lectura es semántica, el mismo conjunto de nombres de columna funciona tanto si la fuente es un listado por sujeto con un evento como con cincuenta, y tanto si el diseño coincide con el estudio extraído el mes pasado como si no.
Esto es importante en una familia de documentos sujeta a cumplimiento normativo por una razón específica: la estructura es fija, por lo que los nombres de los campos son estables y reutilizables, pero las tablas exactas no lo son, por lo que un enfoque basado en posición nunca se generaliza. Al definir columnas, la parte estable (el campo) se traslada entre documentos y la parte inestable (el diseño) deja de importar. Esto es lo contrario de cómo se comporta la extracción por plantilla, donde una plantilla por módulo debe reconstruirse para cada informe de estudio y cada tabla de especificaciones CMC.
Tres tipos de columnas cubren la mayoría de las necesidades regulatorias. Las columnas directas extraen campos que están impresos explícitamente, que son la mayoría: criterios de valoración, fechas de inicio, límites de especificaciones. Las columnas calculadas se calculan durante la extracción, por ejemplo, derivando una duración a partir de una fecha de inicio y una de fin, o generando una diferencia cuando un total declarado no coincide con sus partes. Las columnas inferidas asignan un valor que el documento no imprime pero implica, útil para una categoría como si un evento se describe como en curso. Este último tipo es una lectura del texto, no un juicio clínico, y nunca debe utilizarse para nada que requiera adjudicación.
Los archivos se procesan de forma segura y no se almacenan.
El mecanismo general, y en qué se diferencia de las herramientas basadas en posición que existían antes, se describe en extracción de documentos sin plantilla. Para un equipo regulatorio, la versión práctica es más simple que la teoría: escriba los nombres de las columnas una vez y reutilícelos en todos los informes del programa.
Cómo Hacer Revisable la Tabla Extraída
En un campo regulado, una tabla extraída solo es útil si una persona calificada puede verificarla sin volver a leer la fuente. Esa es la diferencia entre una extracción que ahorra tiempo y una que añade una carga de verificación. Tres capacidades abordan esto directamente.
Review Mode con verificación de cuadro delimitador le permite pasar el cursor sobre cualquier celda extraída y ver exactamente de dónde proviene ese valor en la página original, y hacer clic en una región de la página para saltar a la celda correspondiente. Para un campo como la fecha de inicio o la evaluación de causalidad, esto convierte "confiar en la extracción" en "verificar la extracción" en segundos. También muestra el valor original de la IA cuando se ha editado un campo, de modo que una corrección sea trazable.
Multi-Page Merge pliega un documento que abarca varias páginas de nuevo en una sola fila, agrupado por un valor compartido como un ID del sujeto. Esto es lo que evita que un evento grave cuya narrativa cruza un salto de página, o los registros de un sujeto repartidos en el apéndice, lleguen como dos medios registros. Los campos se completan desde la página que los contiene, y la información recurrente, como el ID del sujeto, se traslada a cada línea.
Model Tier importa cuando la fuente es un documento escaneado o fotografiado. Los informes de estudio más antiguos suelen ser escaneos en papel, y algunos contienen anotaciones manuscritas. Un nivel de procesamiento superior utiliza un modelo subyacente más potente para escritura densa y diseño complejo, mientras que el nivel estándar ya cubre la mayoría de los documentos tabulares impresos. La misma plataforma gestiona también los documentos regulatorios no relacionados con ensayos, incluido el tipo de papeleo administrativo escaneado que se cubre en la guía de cumplimiento de extracción de documentos sanitarios.
El procesamiento por lotes pertenece a la misma lista por una razón a nivel de programa. Un programa de presentación produce muchos informes, y procesarlos como grupo fusiona los resultados en una sola tabla en lugar de dejar una pila de exportaciones de documentos individuales que conciliar. El patrón es el mismo que se usa para otros registros clínicos, incluida la extracción de documentos de ensayos clínicos, donde el problema de granularidad de salida es el sujeto completo.
Lo que este tipo de extracción no hace
Ser claro sobre el límite es más útil que prometer de más, porque en este campo una afirmación en una publicación de blog y un sistema validado son cosas muy diferentes.
No codifica eventos adversos. Mapear un término verbatim informado a un término preferido de MedDRA bajo un sistema de órganos es un paso de codificación con su propio diccionario y convenciones. La extracción puede transportar un término que ya está codificado desde un documento, pero no asigna uno.
No adjudica la seguridad. La causalidad, la gravedad y la expectativa son decisiones de una persona calificada. Una columna inferida lee lo que dice el documento, y eso es todo lo que hace.
No desidentifica. Los identificadores de sujetos en un informe permanecen en la salida. Si el archivo se dirige a algún lugar sin un acuerdo de datos, eliminarlos es un paso separado y deliberado.
No es un sistema validado ni certificado para auditoría, y no es una herramienta de publicación eCTD. Los registros electrónicos regulados conllevan requisitos como una pista de auditoría para cada cambio y una validación del sistema documentada, según ICH E6(R3) y 21 CFR Part 11. Esta herramienta no posee dicha certificación. Los sistemas que gestionan y publican presentaciones a escala, LORENZ docuBridge, EXTEDO eCTDmanager y EXTEDOpulse, Veeva Vault Submissions y Certara GlobalSubmit, son donde se ensambla, valida y presenta el expediente. La extracción se sitúa antes de ellos, como un primer paso que un humano revisa, no como el sistema de registro ni como publicador. La comparación aquí no es contra esas plataformas. Es contra una persona que lee un informe y lo vuelve a escribir.
Lo que queda dentro de esos límites sigue siendo la mayor parte del trabajo manual: sacar los valores repetidos de los documentos y ponerlos en una tabla que un revisor pueda verificar. Ese es el objetivo de trasladar la tarea de una persona a una herramienta que no pierde la estructura en el camino.
Preguntas frecuentes
¿Puede la IA extraer datos de un informe de estudio clínico sin crear una plantilla para cada módulo? Sí, si define los campos que desea como nombres de columnas en lugar de dibujar zonas en una página. La lectura se realiza por significado, por lo que el mismo conjunto de columnas funciona en diferentes informes de estudio y diseños. Aún debe indicar de qué sección desea los datos, porque un CSR contiene los mismos datos de eventos adversos en más de un lugar.
¿Qué es exactamente la extracción de datos de presentación CTD? Es extraer campos estructurados de los documentos que componen un Common Technical Document, como puntos finales y detalles de eventos adversos de los informes de estudio clínicos del Módulo 5, límites de especificaciones de las tablas CMC del Módulo 3 y cifras resumen del Módulo 2. El objetivo es una tabla, claveada por las columnas que usted nombró, que una persona pueda revisar.
¿Por qué mi extracción devolvió conteos cuando quería una fila por evento adverso? Porque el CSR contiene datos de eventos adversos en tres formatos: una tabla de tasas resumen, un listado por sujeto y una narrativa, y la solicitud no especificó cuál. Nombre las columnas del formato que necesita, como ID del sujeto y término del evento, para que la herramienta se dirija al listado por sujeto en lugar de a la tabla resumen.
¿Esto reemplaza mi sistema de publicación eCTD o mi base de datos de seguridad? No. La extracción produce un primer paso revisable y se sitúa aguas arriba de sistemas como Veeva Vault, LORENZ docuBridge y EXTEDO. No es una plataforma validada ni certificada para auditoría, no publica presentaciones, no codifica términos a MedDRA y no realiza juicios de causalidad o gravedad.
La estructura es fija, por lo que las columnas también pueden serlo
Los documentos regulatorios no son difíciles de extraer porque sean largos. Son difíciles porque una estructura fija aún permite que el mismo hecho aparezca como una tasa, una fila y una oración, y porque una referencia cruzada puede apuntar a un número que no está impreso donde usted mira. Una vez que acepta esto, la solución deja de tratarse de modelos más grandes y se vuelve más simple: nombre los campos, nombre el formato que desea y deje que la herramienta los encuentre por significado en lugar de por posición. El marco regulatorio que hace rígidos estos documentos es lo mismo que hace que los nombres de las columnas sean reutilizables en todo un programa.
Tome un informe de estudio clínico o una tabla de especificaciones CMC, defina las columnas que realmente necesita y vea el resultado antes de comprometer un lote.