Warum sich Regulierungsdokumente
der Datenextraktion widersetzen
Regulierungsdossiers für Arzneimittel wirken wie die einfachsten Dokumente der Welt für die Datenextraktion. Sie folgen einer festen, international vereinbarten Struktur, bis hin zu nummerierten Abschnitten, die jeder Sponsor in derselben Reihenfolge verwendet. Doch die Menschen, die mit ihnen arbeiten – Spezialisten für regulatorische Angelegenheiten, die klinische Studienberichte und CTD-Module in strukturierte Daten überführen – beschreiben immer wieder dasselbe Scheitern: Die zurückgegebene Tabelle ist nicht die Tabelle, die sie benötigten. Der Grund ist nicht, dass die Dokumente lang sind. Ein vollständiger Antrag für ein neues Arzneimittel kann Hunderttausende von Seiten umfassen, und das ist real, aber die Länge allein bringt die Extraktion nicht zum Scheitern. Der Grund ist, dass ein einzelnes Regulierungsdokument dieselbe Tatsache in mehr als einer Form speichert, und die Extraktion scheitert, wenn niemand angibt, welche Form gemeint ist.
Wichtige Erkenntnisse
- Die starrsten Dokumente der Welt sind diejenigen, bei denen die Extraktion immer wieder falsch liegt.
- Ein einziges schwerwiegendes unerwünschtes Ereignis kann in drei Abschnitten mit drei Detailebenen stehen, daher hat „unerwünschte Ereignisse extrahieren“ drei legitime Antworten.
- Benennen Sie die Spalten und die gewünschte Form, und diese Feldnamen gelten für das gesamte Programm.
Die regulatorische Dokumentenfamilie und die Felder, die zählen
Eine regulatorische Einreichung ist nicht ein einzelnes Dokument. Sie ist eine Familie von Dokumenten, die durch ein Format namens Common Technical Document zusammengehalten wird, das der International Council for Harmonisation im November 2000 eingeführt hat, um allen Gesundheitsbehörden dieselbe Struktur zur Prüfung zu geben. Das CTD ist in fünf Module gegliedert. Modul 1 enthält regionsspezifisches administratives Material, Modul 2 enthält die Zusammenfassungen und Übersichten, Modul 3 deckt Qualität sowie Chemie, Herstellung und Kontrolle ab, Modul 4 enthält nichtklinische Studienberichte und Modul 5 enthält die klinischen Studienberichte. Die elektronische Version, eCTD, verpackt dieselbe Struktur in eine XML-Struktur, aber der zugrunde liegende Inhalt und die Modulnummerierung sind identisch. Der harmonisierte Rahmen wird von der ICH veröffentlicht.
Der klinische Studienbericht (CSR) ist das Dokument, das die meisten meinen, wenn sie sagen, dass sie Studiendaten extrahieren müssen. Es ist ein festgelegter Bericht mit sechzehn Abschnitten, der durch ICH E3 definiert ist, und er befindet sich in Modul 5, mit Querverweisen aus den klinischen Zusammenfassungen in Modul 2. Ein Sicherheitsnarrativ ist eine kurze Prosabeschreibung eines einzelnen Todesfalls oder schwerwiegenden unerwünschten Ereignisses – die Art von Freitextblock, der die Geschichte eines einzelnen Patienten erzählt. CMC-Spezifikationstabellen in Modul 3 listen die Parameter auf, die ein Arzneimittelwirkstoff oder -produkt erfüllen muss, wie z. B. Gehalt, Verunreinigungen und Freisetzungsgrenzen. Jedes dieser Dokumente trägt einen erkennbaren Satz von Feldern, und dieser Satz ist das Ziel jeder Extraktion.
| Dokument | Ort | Felder, die extrahiert werden |
|---|---|---|
| Klinischer Studienbericht | CTD-Modul 5, definiert durch ICH E3 | Studientitel, Phase, Indikation, primäre und sekundäre Endpunkte, Patientenpopulation, Zusammenfassung der Wirksamkeitsergebnisse, Raten unerwünschter Ereignisse |
| Sicherheitsnarrativ | CSR-Anhang 16, eines pro Ereignis | Probanden-ID, Ereignisbegriff, Schweregrad, Beginndatum, ergriffene Maßnahme, Ergebnis, Kausalitätsbewertung |
| CMC-Spezifikationstabelle | CTD-Modul 3 | Name des Arzneimittelwirkstoffs, Testname, Akzeptanzkriterien, Analysemethode, Herstellungsort |
| Integrierte Sicherheitsübersicht | CTD-Modul 2.7.4 | Sicherheitspopulation, Expositionsdaten, Häufigkeit unerwünschter Ereignisse nach Körpersystem |
Diese Feldliste ist keine Vermutung. Die Sicherheitsfelder gehen auf einen Datenstandard zurück. ICH E2D legt die Mindestelemente fest, die ein Fall enthalten muss, um als vollständig zu gelten: einen identifizierbaren Melder, einen identifizierbaren Patienten, eine unerwünschte Arzneimittelwirkung und ein verdächtiges Produkt. Der Anhang listet die vollständigeren Angaben zu Patient, Produkt und Ereignis auf. Das elektronische Übertragungsformat ICH E2B(R3) wandelt diese in formale Datenelemente um, die eine Sicherheitsdatenbank namentlich erwartet. Wenn also jemand Probanden-ID, Ereignisbegriff, Schweregrad, Beginndatum, ergriffene Maßnahme, Ergebnis und Kausalitätsbewertung verlangt, fordert er Felder an, auf die sich die Branche bereits geeinigt hat. Die ICH-E2D-Leitlinie ist die Quelle für den Mindestsatz.
Die Felder in einer regulatorischen Einreichung sind standardisiert. Die Stellen, an denen sie im Dokument erscheinen, sind es nicht – und genau an dieser Lücke scheitert die Extraktion.
Warum eine feste Struktur die Extraktion dennoch scheitern lässt
Wenn die Struktur fest und die Felder standardisiert sind, sollte die Extraktion trivial sein. Das ist sie nicht, und das deutlichste Beispiel ist die Organisation von Daten zu unerwünschten Ereignissen innerhalb eines einzelnen klinischen Studienberichts.
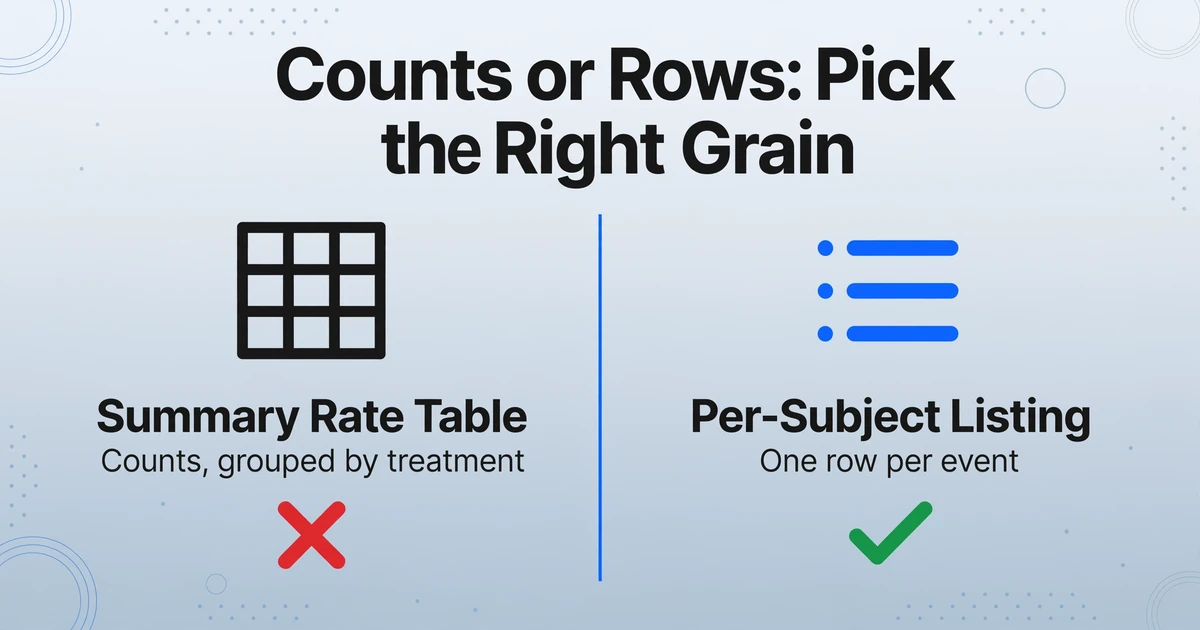
ICH E3 platziert dieselben Informationen zu unerwünschten Ereignissen in drei verschiedenen Abschnitten mit drei verschiedenen Detailstufen. Abschnitt 12.2 ist die Sicherheitsbewertung im Hauptteil des Berichts, und 12.2.2 verlangt die Darstellung der Ereignisse in Zusammenfassungstabellen, gruppiert und über Behandlungsgruppen hinweg verglichen. Diese detaillierten Darstellungen werden nicht direkt in 12.2 abgedruckt; die Leitlinie verweist auf Abschnitt 14.3.1, wo jedes Ereignis nach Körpersystem mit Schweregrad und Kausalität aufgeschlüsselt ist. Abschnitt 16.2.7 ist dann die Auflistung, in der die Ereignisse pro Proband erscheinen. Der Text der ICH-E3-Leitlinie stellt ausdrücklich klar, dass es sich um unterschiedliche Darstellungen derselben zugrunde liegenden Ereignisse handelt.
Das ist die erste strukturelle Falle. Wenn Sie ein Tool nach „unerwünschten Ereignissen“ fragen, ohne anzugeben, welche Form Sie möchten, gibt es drei legitime Kandidaten: die aggregierte Ratentabelle, die Probandenliste und das Narrativ. Eine Anfrage, die als Spaltenname formuliert ist, zieht Daten aus der Darstellung, die das Modell zuerst liest. Wenn Sie die Probandenliste wollten, aber die Zusammenfassungstabelle erhalten haben, haben Sie eine Tabelle voller Zählwerte, wo Sie eine Zeile pro Ereignis erwartet haben. Das ist kein Problem langer Dokumente. Es ist ein Spezifitätsproblem, und es tritt selbst in einem fünfzigseitigen Bericht auf.
Zwei weitere Fehlerquellen kommen zu dieser hinzu. Modulübergreifende Verweise bedeuten, dass die gesuchte Zahl möglicherweise nicht dort gedruckt ist, wo man gerade sucht. Die Zusammenfassungen in Modul 2 beschreiben dieselben Ergebnisse wie die Studienberichte in Modul 5 und verweisen auf diese zurück, anstatt sie zu wiederholen. Wenn ein Wert nur als Querverweis erscheint, muss er aus dem Quellbericht gelesen werden, nicht aus der Zusammenfassung. Verschachtelte und zusammengeführte Tabellenköpfe sind die zweite Fehlerquelle: Tabellen zu unerwünschten Ereignissen verwenden routinemäßig zusammengeführte Zellen, um eine Hierarchie aus Körpersystem und bevorzugtem Begriff auszudrücken. Ein naiver Leser erfasst daher die Ereignisbegriffe, verliert aber, zu welchem Körpersystem jeder einzelne gehört. Dieser mechanische Fehlermodus ist Teil des größeren Bildes in der Übersicht zur Dokumentverarbeitung, daher konzentriert sich dieser Artikel auf die regulatorische Struktur und nicht auf das Raster.
Die Menschen, die in diesem Bereich arbeiten, sagen dasselbe in einfacheren Worten. Im Subreddit, in dem Fachleute für regulatorische Angelegenheiten Erfahrungen austauschen, drehen sich Diskussionen über die Automatisierung von Routineaufgaben um dieselben Aufgaben: einen Testbericht zusammenfassen, ein Protokollgerüst entwerfen, dieselben Zahlen immer wieder aus einem langen PDF ziehen. Die Arbeit ist intellektuell nicht so anspruchsvoll wie eine statistische Analyse. Es ist die Wiederholung innerhalb eines ansonsten starren Dokumenttyps, die Teams ermüdet, denn die Starrheit erweckt die Illusion, dass eine Vorlage funktionieren sollte – und dann scheitert ein neuer Studienbericht mit denselben Abschnitten, aber anderen Tabellen leise daran.
Es gibt eine Version davon, die in Extraktionsratschlägen auftaucht, die sich die Branche selbst gibt. In einer bekannten Frage zum Kopieren von Tabellen aus PDFs in Tabellenkalkulationen lautet die Beschwerde, dass die Daten als eine einzige unübersichtliche Zelle eingefügt werden: „Wenn ich das tue, werden die Daten fast immer in eine einzige Zelle eingefügt.“ Das ist derselbe Fehler wie im regulatorischen Fall, nur im Kleinen. Die Werte sind vorhanden und lesbar, aber die Struktur, die sie bedeutungsvoll machte, ist verloren. Der r/excel-Thread handelt von gewöhnlichen PDFs, und das Muster überträgt sich direkt.
Wo die manuelle Extraktion tatsächlich scheitert
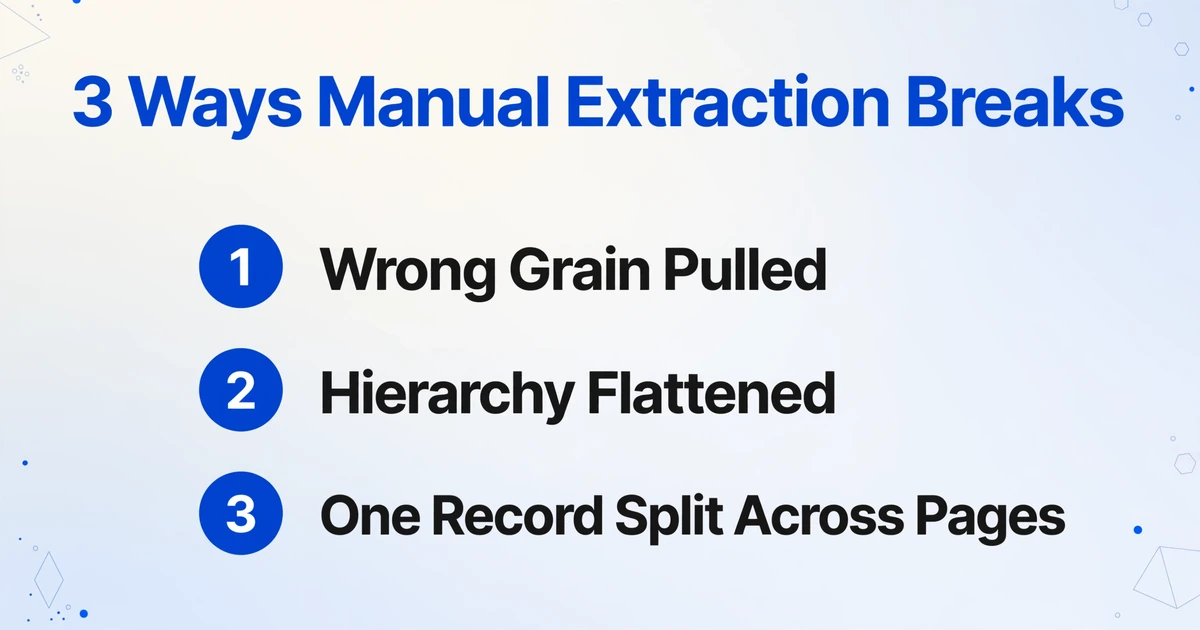
Es hilft, die konkreten Fehler zu benennen, statt allgemein von „Fehlern" zu sprechen. Wenn eine Person mit einem klinischen Studienbericht und einer Tabellenkalkulation arbeitet, gehen drei Dinge in vorhersehbarer Reihenfolge schief.
Es wird die falsche Körnung gezogen. Der Bericht bietet Zählungen in einem Abschnitt und Zeilen auf Probandenebene in einem anderen, und es ist leicht, die praktische Tabelle in 12.2 zu lesen und am Ende eine Rate statt des Ereignisebenen-Datensatzes zu erhalten, den die Analyse tatsächlich benötigte. Das ist der Fehler, der eine Wiederholung erzwingt, weil die korrigierten Daten aus einem völlig anderen Abschnitt stammen müssen.
Die Hierarchie wird abgeflacht. Körpersystem, dann bevorzugter Begriff, dann einzelne Ereignisse – das ist eine dreistufige Struktur. Wenn sie in flache Zeilen übertragen wird, verschwindet die mittlere Ebene häufig, und jedes Ereignis wird keinem bestimmten Körpersystem zugeordnet. Das später zu rekonstruieren bedeutet, zur Quelltabelle zurückzukehren.
Ein logischer Datensatz erstreckt sich über Seiten. Ein Sicherheitsnarrativ für ein schwerwiegendes Ereignis kann über einen Seitenumbruch hinweggehen, und die Ereignisse einer Person können über einen Anhang verteilt sein, der sich über Dutzende Seiten erstreckt. Von Hand übertragen wird dieser Datensatz entweder in zwei Zeilen aufgeteilt oder einer der Teile geht vollständig verloren.
Keiner dieser Fehler betrifft die Tippgeschwindigkeit. Sie betreffen eine Person, die manuell eine Struktur zusammenhält, die das Dokument nicht intakt lässt, sobald die Tinte die Seite verlässt. Das ist das Argument für die Extraktion, und es ist auch das Argument für die Wahl der richtigen Art der Extraktion, denn ein templatebasiertes Tool wiederholt dieselben drei Fehler mit Maschinengeschwindigkeit: Es gleicht nach Position ab und verliert die Bedeutung, sobald sich eine Tabelle verschiebt.
Spalten definieren statt Vorlagen zeichnen
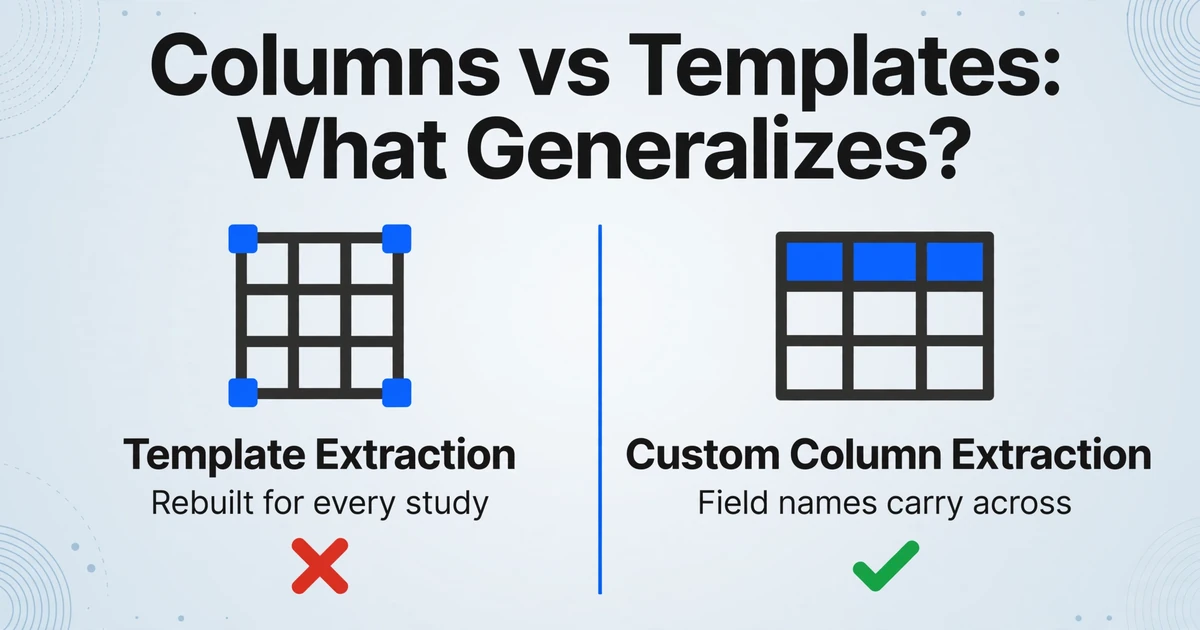
Der Ausweg besteht darin, nicht mehr zu beschreiben, wo die Daten stehen, sondern zu beschreiben, was Sie benötigen. Custom Column Extraction funktioniert über den Spaltennamen: Sie geben die benötigten Feldnamen ein, z. B. „Probanden-ID", „Ereignisbegriff", „Schweregrad", „Beginndatum" und „Kausalität", und die KI findet jeden Wert, indem sie die Bedeutung des Spaltennamens versteht, statt eine feste Position auf der Seite abzugleichen. Die von Ihnen eingegebenen Spaltennamen werden zu den Kopfzeilen der Ausgabetabelle. Da das Lesen semantisch ist, funktioniert derselbe Satz an Spaltennamen unabhängig davon, ob die Quelle eine Probandenliste mit einem oder fünfzig Ereignissen ist, und unabhängig davon, ob das Layout der letzte Monat extrahierten Studie entspricht oder nicht.
Dies ist in einer compliance-getriebenen Dokumentfamilie aus einem bestimmten Grund wichtig: Die Struktur ist festgelegt, daher sind die Feldnamen stabil und wiederverwendbar, aber die genauen Tabellen sind es nicht, sodass ein positionsbasierter Ansatz nie verallgemeinert. Wenn Sie Spalten definieren, überträgt der stabile Teil (das Feld) die Dokumente und der instabile Teil (das Layout) spielt keine Rolle mehr. Das ist das Gegenteil des Verhaltens der Template-Extraktion, bei der eine pro Modul erstellte Vorlage für jeden Studienbericht und jede CMC-Tabelle neu erstellt werden muss.
Drei Spaltentypen decken die meisten regulatorischen Anforderungen ab. Direkte Spalten ziehen Felder, die explizit gedruckt sind, was auf die meisten zutrifft: Endpunkte, Beginndaten, Spezifikationsgrenzen. Berechnete Spalten berechnen während der Extraktion, z. B. die Ableitung einer Dauer aus einem Start- und Enddatum oder die Ausgabe einer Differenz, wenn eine angegebene Summe nicht mit ihren Teilen übereinstimmt. Abgeleitete Spalten weisen einen Wert zu, den das Dokument nicht druckt, aber impliziert, nützlich für eine Kategorie wie etwa, ob ein Ereignis als andauernd beschrieben wird. Dieser letzte Typ ist eine Lesart des Textes, kein klinisches Urteil, und sollte niemals für etwas verwendet werden, das eine Beurteilung erfordert.
Dateien werden sicher verarbeitet und nicht gespeichert.
Der allgemeine Mechanismus und sein Unterschied zu den positionsbasierten Tools, die davor kamen, wird in vorlagenfreier Dokumentextraktion beschrieben. Für ein Regulierungsteam ist die praktische Version einfacher als die Theorie: Spaltennamen einmal aufschreiben und sie in jedem Bericht des Programms wiederverwenden.
Die extrahierte Tabelle überprüfbar machen
In einem regulierten Bereich ist eine extrahierte Tabelle nur nützlich, wenn eine qualifizierte Person sie prüfen kann, ohne die Quelle erneut zu lesen. Das ist der Unterschied zwischen einer Extraktion, die Zeit spart, und einer, die eine Verifikationslast hinzufügt. Drei Funktionen adressieren dies direkt.
Überprüfungsmodus mit Begrenzungsrahmen-Verifikation ermöglicht es, jede extrahierte Zelle zu überfahren und genau zu sehen, woher dieser Wert auf der Originalseite stammt, sowie auf eine Region der Seite zu klicken, um zur passenden Zelle zurückzuspringen. Für ein Feld wie ein Beginndatum oder eine Kausalitätsbewertung verwandelt das „Vertraue der Extraktion“ in Sekunden in „Stichprobenprüfung der Extraktion“. Es zeigt auch den ursprünglichen KI-Wert, wenn ein Feld bearbeitet wurde, sodass eine Korrektur nachvollziehbar ist.
Multi-Page Merge faltet ein Dokument, das sich über Seiten erstreckt, wieder in eine einzelne Zeile zusammen, gruppiert nach einem gemeinsamen Wert wie einer Probanden-ID. Das verhindert, dass ein schwerwiegendes Ereignis, dessen Narrativ einen Seitenumbruch überschreitet, oder die über den Anhang verteilten Datensätze eines Probanden als zwei halbe Datensätze ankommen. Felder werden von der jeweiligen Seite übernommen, und wiederkehrende Informationen wie die Probanden-ID werden in jede Zeile übernommen.
Modellstufe ist wichtig, wenn die Quelle ein gescanntes oder fotografiertes Dokument ist. Ältere Studienberichte sind häufig Papierscans, und einige enthalten handschriftliche Anmerkungen. Eine höhere Verarbeitungsstufe verwendet ein stärkeres zugrunde liegendes Modell für dichte Handschrift und komplexes Layout, während die Standardstufe bereits die meisten gedruckten tabellarischen Dokumente abdeckt. Dieselbe Plattform verarbeitet auch die nicht-studienbezogenen Regulierungsdokumente, einschließlich der Art gescannter administrativer Unterlagen, die im Compliance-Leitfaden zur Extraktion von Gesundheitsdokumenten behandelt werden.
Stapelverarbeitung gehört aus programmbezogenen Gründen in dieselbe Liste. Ein Einreichungsprogramm erzeugt viele Berichte, und die Verarbeitung als Gruppe führt die Ergebnisse in einer Tabelle zusammen, anstatt einen Stapel von Einzeldokument-Exporten abgleichen zu müssen. Das Muster ist dasselbe wie bei anderen klinischen Aufzeichnungen, einschließlich Extraktion klinischer Studiendokumente, wo das Problem der Ausgabekörnung der gesamte Proband ist.
Was diese Art der Extraktion nicht leistet
Die Grenzen klar zu benennen ist nützlicher als übertriebene Versprechungen, denn in diesem Bereich unterscheiden sich ein Anspruch in einem Blogbeitrag und ein validiertes System erheblich.
Es kodiert keine unerwünschten Ereignisse. Die Zuordnung eines berichteten wörtlichen Begriffs zu einem MedDRA-bevorzugten Begriff unter einer Systemorganklasse ist ein Kodierungsschritt mit eigenem Wörterbuch und eigenen Konventionen. Die Extraktion kann einen bereits kodierten Begriff aus einem Dokument übernehmen, aber sie weist keinen zu.
Es beurteilt keine Sicherheit. Kausalität, Schweregrad und Erwartbarkeit sind Entscheidungen einer qualifizierten Person. Eine abgeleitete Spalte liest, was das Dokument sagt, und das ist alles.
Es anonymisiert nicht. Probanden-IDs in einem Bericht bleiben in der Ausgabe. Wenn die Datei ohne Datenvereinbarung an einen anderen Ort geht, ist deren Entfernung ein separater, bewusster Schritt.
Es ist kein validiertes oder audit-zertifiziertes System und kein eCTD-Publishing-Tool. Regulierte elektronische Aufzeichnungen unterliegen Anforderungen wie einem Prüfpfad für jede Änderung und einer dokumentierten Systemvalidierung gemäß ICH E6(R3) und 21 CFR Part 11. Dieses Tool besitzt keine solche Zertifizierung. Die Systeme, die Einreichungen in großem Umfang verwalten und veröffentlichen – LORENZ docuBridge, EXTEDO eCTDmanager und EXTEDOpulse, Veeva Vault Submissions und Certara GlobalSubmit – sind der Ort, an dem das Dossier zusammengestellt, validiert und eingereicht wird. Die Extraktion ist diesen Systemen vorgelagert und dient als erster Durchlauf, der von einem Menschen überprüft wird – nicht als System of Record und nicht als Publisher. Der Vergleich hier ist nicht gegen diese Plattformen gerichtet, sondern gegen eine Person, die einen Bericht liest und neu abtippt.
Was innerhalb dieser Grenzen bleibt, ist dennoch der Großteil der manuellen Arbeit: die wiederkehrenden Werte aus den Dokumenten in eine Tabelle zu überführen, die ein Prüfer kontrollieren kann. Genau darum geht es, wenn man die Aufgabe von einer Person auf ein Tool verlagert, das die Struktur auf dem Weg nicht verliert.
FAQ
Kann KI Daten aus einem klinischen Studienbericht extrahieren, ohne pro Modul eine Vorlage zu erstellen? Ja, wenn Sie die gewünschten Felder als Spaltennamen definieren, anstatt Bereiche auf einer Seite zu markieren. Das Lesen erfolgt semantisch, sodass dieselben Spalten für verschiedene Studienberichte und Layouts funktionieren. Sie müssen dennoch angeben, auf welche Sektion Sie sich beziehen, da ein CSR dieselben Daten zu unerwünschten Ereignissen an mehreren Stellen enthält.
Was genau ist die Datenextraktion für CTD-Einreichungen? Dabei werden strukturierte Felder aus den Dokumenten eines Common Technical Document extrahiert, z. B. Endpunkte und Details zu unerwünschten Ereignissen aus klinischen Studienberichten in Modul 5, Spezifikationsgrenzen aus CMC-Tabellen in Modul 3 und zusammenfassende Kennzahlen aus Modul 2. Ziel ist eine Tabelle, die nach den von Ihnen benannten Spalten aufgebaut ist und von einer Person geprüft werden kann.
Warum lieferte meine Extraktion Zählwerte, obwohl ich eine Zeile pro unerwünschtem Ereignis wollte? Weil der CSR Daten zu unerwünschten Ereignissen in drei Formen enthält – eine Zusammenfassungsratentabelle, eine Probandenliste und ein Narrativ – und die Anfrage nicht spezifizierte, welche gemeint ist. Benennen Sie die Spalten der benötigten Form, z. B. Probanden-ID und Ereignisbegriff, damit das Tool die Probandenliste statt der Zusammenfassungstabelle ansteuert.
Ersetzt dies mein eCTD-Publishing-System oder meine Sicherheitsdatenbank? Nein. Die Extraktion erzeugt einen überprüfbaren ersten Durchlauf und ist vorgelagert zu Systemen wie Veeva Vault, LORENZ docuBridge und EXTEDO. Sie ist keine validierte, audit-zertifizierte Plattform, veröffentlicht keine Einreichungen, kodiert keine Begriffe nach MedDRA und trifft keine Kausalitäts- oder Schweregradbewertungen.
Die Struktur ist festgelegt, also können es auch die Spalten sein
Regulatorische Dokumente sind nicht schwer zu extrahieren, weil sie lang sind. Sie sind schwer, weil eine feste Struktur es dennoch erlaubt, dass dieselbe Tatsache als Rate, als Zeile und als Satz erscheint, und weil ein Querverweis auf eine Zahl zeigen kann, die nicht dort gedruckt ist, wo Sie suchen. Sobald Sie das akzeptieren, geht es nicht mehr um größere Modelle, sondern wird einfacher: Benennen Sie die Felder, benennen Sie die gewünschte Form, und lassen Sie das Tool sie semantisch statt positionsbasiert finden. Der regulatorische Rahmen, der diese Dokumente starr macht, ist zugleich der Grund, warum die Spaltennamen programmweit wiederverwendbar sind.
Nehmen Sie einen klinischen Studienbericht oder eine CMC-Spezifikationstabelle, definieren Sie die tatsächlich benötigten Spalten und sehen Sie die Ausgabe, bevor Sie einen Batch darauf festlegen.