Por que documentos regulatórios resistem à
extração de dados
Submissões regulatórias farmacêuticas parecem os documentos mais fáceis do mundo para extrair dados. Elas seguem uma estrutura fixa, acordada internacionalmente, até seções numeradas que todos os patrocinadores usam na mesma ordem. No entanto, as pessoas que trabalham com elas — especialistas em assuntos regulatórios que transformam relatórios de estudo clínico e módulos de CTD em dados estruturados — descrevem a mesma falha repetidamente: a tabela que volta não é a tabela de que precisavam. O motivo não é que os documentos sejam longos. Um novo pedido de medicamento completo pode chegar a centenas de milhares de páginas, e isso é real, mas o comprimento sozinho não quebra a extração. O motivo é que um único documento regulatório armazena o mesmo fato em mais de um formato, e a extração falha quando ninguém diz qual formato se refere.
Principais conclusões
- Os documentos mais rígidos do mundo são os que a extração continua errando.
- Um único evento adverso grave pode estar em três seções com três níveis de detalhe, então "extrair os eventos adversos" tem três respostas legítimas.
- Defina as colunas e o formato desejado, e esses nomes de campos se aplicam a todo o programa.
A Família de Documentos Regulatórios e os Campos que Importam
Uma submissão regulatória não é um único documento. É uma família de documentos, unidos por um formato chamado Common Technical Document, que o International Council for Harmonisation adotou em novembro de 2000 para dar a todas as autoridades de saúde a mesma estrutura para revisão. O CTD é organizado em cinco módulos. O Módulo 1 contém material administrativo específico da região, o Módulo 2 contém os resumos e visões gerais, o Módulo 3 cobre qualidade e química, fabricação e controles, o Módulo 4 contém relatórios de estudos não clínicos, e o Módulo 5 contém os relatórios de estudo clínico. A versão eletrônica, eCTD, envolve essa mesma estrutura em um backbone XML, mas o conteúdo subjacente e a numeração dos módulos são idênticos. A estrutura harmonizada é publicada pela ICH.
O relatório de estudo clínico (CSR) é o documento que a maioria das pessoas quer dizer quando afirma que precisa extrair dados de ensaios clínicos. É um relatório fixo de dezesseis seções definido pela ICH E3, e está localizado no Módulo 5, com referências cruzadas aos resumos clínicos do Módulo 2. Uma narrativa de segurança é uma descrição curta em prosa de uma única morte ou evento adverso grave, o tipo de bloco de texto livre que conta a história do que aconteceu com um paciente. As tabelas de especificações CMC no Módulo 3 listam os parâmetros que uma substância ou produto farmacêutico deve atender, como ensaio, impurezas e limites de dissolução. Cada um desses documentos contém um conjunto reconhecível de campos, e é esse conjunto que qualquer extração deve ter como alvo.
| Documento | Onde está localizado | Campos que são extraídos |
|---|---|---|
| Relatório de estudo clínico | Módulo 5 do CTD, definido pela ICH E3 | Título do estudo, fase, indicação, desfechos primário e secundário, população de pacientes, resumo dos resultados de eficácia, taxas de eventos adversos |
| Narrativa de segurança | Apêndice 16 do CSR, um por evento | ID do sujeito, termo do evento, gravidade, data de início, ação tomada, desfecho, avaliação de causalidade |
| Tabela de especificações CMC | Módulo 3 do CTD | Nome da substância farmacêutica, nome do teste, critérios de aceitação, método analítico, local de fabricação |
| Resumo integrado de segurança | Módulo 2.7.4 do CTD | População de segurança, dados de exposição, frequência de eventos adversos por sistema de órgãos |
Essa lista de campos não é um palpite. Os campos de segurança remontam a um padrão de dados. O ICH E2D define os elementos mínimos que um caso deve conter para ser considerado completo: um notificador identificável, um paciente identificável, uma reação adversa e um produto suspeito, e seu anexo lista o conjunto mais completo de detalhes do paciente, do produto e do evento. O formato de transmissão eletrônica, ICH E2B(R3), transforma esses elementos em elementos de dados formais que um banco de dados de segurança espera pelo nome. Então, quando alguém diz que quer ID do sujeito, termo do evento, gravidade, data de início, ação tomada, desfecho e causalidade, está pedindo campos que a indústria já acordou. A diretriz ICH E2D é a fonte para o conjunto mínimo.
Os campos em uma submissão regulatória são padronizados. Os lugares onde eles aparecem no documento não são, e essa lacuna é onde a extração falha.
Por que uma Estrutura Fixa Ainda Derrota a Extração
Se a estrutura é fixa e os campos são padrão, a extração deveria ser trivial. Não é, e o exemplo mais claro é como os dados de eventos adversos são organizados dentro de um único relatório de estudo clínico.
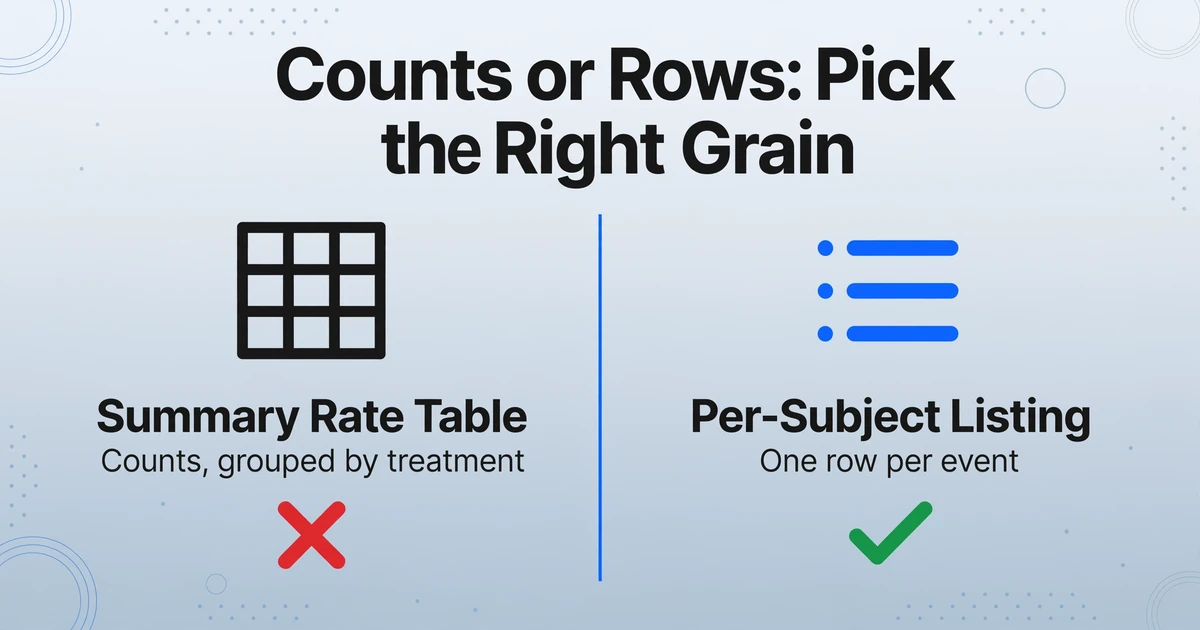
O ICH E3 coloca as mesmas informações de eventos adversos em três seções diferentes, em três níveis diferentes de detalhe. A seção 12.2 é a avaliação de segurança no corpo do relatório, e a 12.2.2 pede que os eventos sejam exibidos em tabelas resumo, agrupados e comparados entre os grupos de tratamento. Essas exibições detalhadas não são realmente impressas na 12.2; a diretriz as aponta para a seção 14.3.1, onde cada evento é organizado por sistema de órgãos com gravidade e relação. Em seguida, a seção 16.2.7 é a listagem onde os eventos aparecem um sujeito por vez. O texto da diretriz ICH E3 é explícito que essas são apresentações diferentes dos mesmos eventos subjacentes.
Essa é a primeira armadilha estrutural. Se você pedir a uma ferramenta "eventos adversos" sem especificar qual formato quer, ela tem três candidatos legítimos para escolher: a tabela de taxas agregada, a listagem por sujeito e a narrativa. Uma solicitação expressa como nome de coluna puxará de qualquer exibição que o modelo ler primeiro, e se você queria a listagem por sujeito mas recebeu a tabela resumo, você tem uma tabela cheia de contagens onde esperava uma linha por evento. Isso não é um problema de documento longo. É um problema de especificidade, e aparece até em um relatório de cinquenta páginas.
Em cima disso, há mais dois pontos de falha. Referências cruzadas entre módulos significam que o número que você procura pode não estar impresso onde você está olhando. Os resumos do Módulo 2 descrevem os mesmos resultados dos relatórios de estudo do Módulo 5 e apontam para eles em vez de repeti-los. Se um valor aparece apenas como referência cruzada, ele precisa ser lido no relatório de origem, não no resumo. Cabeçalhos de tabela aninhados e mesclados são o segundo: tabelas de eventos adversos usam rotineiramente células mescladas para expressar uma hierarquia de sistema de órgãos e termo preferido, então um leitor ingênuo captura os termos do evento, mas perde sob qual sistema de órgãos cada um estava. Esse modo de falha mecânica faz parte do panorama mais amplo na visão geral do processamento de documentos, então este artigo permanece na estrutura regulatória, e não na grade.
As pessoas que vivem esse trabalho dizem a mesma coisa em termos mais simples. No subreddit onde profissionais de assuntos regulatórios trocam ideias, discussões sobre automatizar tarefas rotineiras giram em torno do mesmo conjunto de tarefas: resumir um relatório de teste, redigir um esqueleto de protocolo, extrair os mesmos números de um PDF longo repetidamente. O trabalho não é intelectualmente difícil como uma análise estatística. É a repetitividade dentro de um tipo de documento que, de outra forma, é rígido que desgasta as equipes, porque a rigidez dá a ilusão de que um modelo deveria funcionar — e então um novo relatório de estudo, com as mesmas seções, mas tabelas diferentes, silenciosamente o derrota.
Há uma versão disso que aparece nos conselhos de extração que a indústria dá a si mesma. Em uma pergunta conhecida sobre copiar tabelas de PDFs para planilhas, a reclamação é que os dados são colados como uma única célula bagunçada: "Quando eu faço isso, os dados quase sempre são colados em uma única célula." Essa é a mesma falha do caso regulatório, em miniatura. Os valores estão lá e são legíveis, mas a estrutura que os tornava significativos se foi. O tópico do r/excel é sobre PDFs comuns, e o padrão se transfere diretamente.
Onde a Extração Manual Realmente Falha
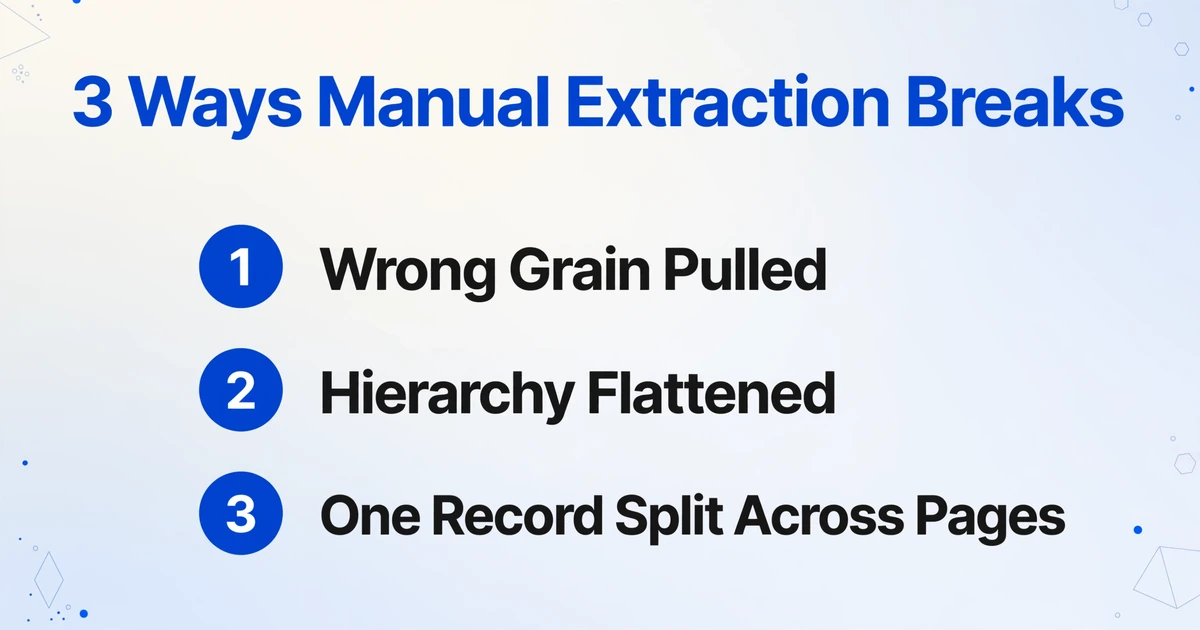
É útil nomear os erros específicos em vez de falar sobre "erros" de forma geral. Quando uma pessoa se senta com um CSR e uma planilha, três coisas dão errado em uma ordem previsível.
A granularidade errada é extraída. O relatório oferece contagens em uma seção e linhas no nível do sujeito em outra, e é fácil ler a tabela conveniente em 12.2 e acabar com uma taxa em vez do registro no nível do evento que a análise realmente precisava. Este é o erro que força uma refação, porque os dados corrigidos têm que vir de uma seção completamente diferente.
A hierarquia é achatada. Sistema de órgãos, depois termo preferido, depois eventos individuais é uma estrutura de três níveis. Quando é transcrita em linhas planas, o nível do meio frequentemente desaparece, e cada evento acaba sem estar vinculado a nenhum sistema de órgãos específico. Reconstruir isso depois significa voltar à tabela de origem.
Um registro lógico abrange páginas. Uma narrativa de segurança para um evento grave pode se estender por uma quebra de página, e os eventos de um sujeito podem ser divididos em um apêndice que continua por dezenas de páginas. Transcrito manualmente, esse registro ou é dividido em duas linhas ou uma das partes é descartada completamente.
Nenhum desses erros é sobre velocidade de digitação. Eles são sobre uma pessoa segurando manualmente uma estrutura que o documento não mantém intacta uma vez que a tinta sai da página. Esse é o argumento para a extração, e também é o argumento para escolher o tipo certo de extração, porque uma ferramenta baseada em modelo repete os mesmos três erros na velocidade da máquina: ela corresponde por posição e perde o significado no momento em que uma tabela muda.
Definindo Colunas em vez de Desenhar Modelos
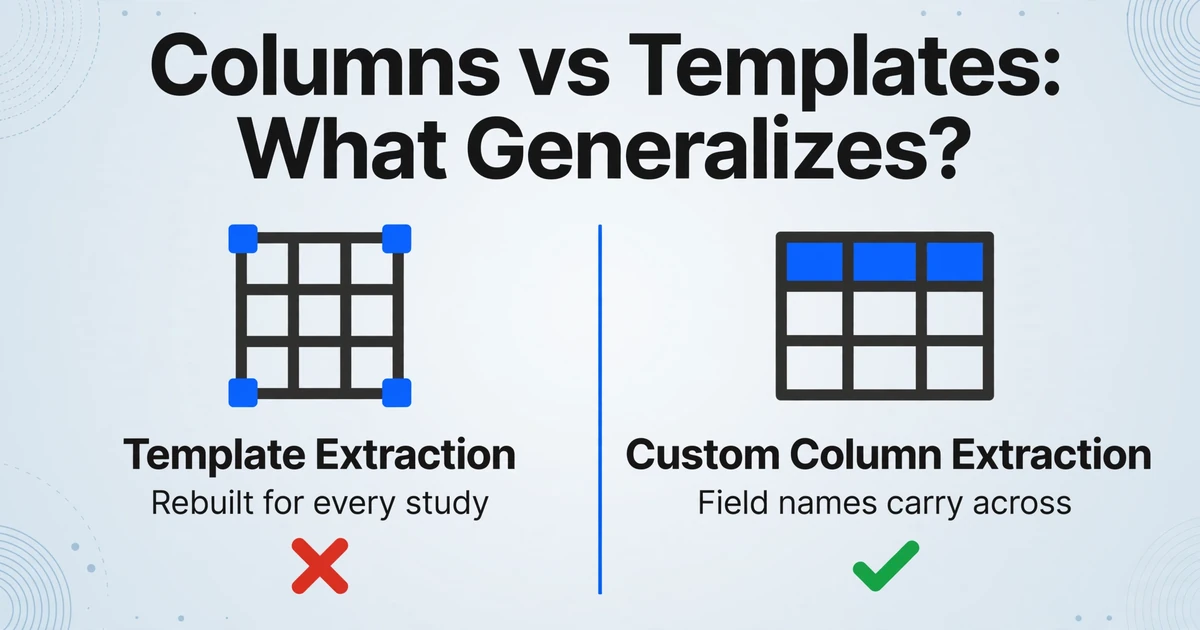
A saída é parar de descrever onde os dados estão e começar a descrever o que você quer. A Custom Column Extraction funciona por nome de coluna: você digita os nomes dos campos necessários, como "Subject ID", "Event Term", "Severity", "Onset Date" e "Causality", e a IA localiza cada valor entendendo o que o nome da coluna significa, em vez de corresponder a uma posição fixa na página. Os nomes de colunas que você insere se tornam os cabeçalhos da tabela de saída. Como a leitura é semântica, o mesmo conjunto de nomes de colunas funciona quer a origem seja uma listagem por sujeito com um evento ou cinquenta, e quer o layout corresponda ou não ao estudo extraído no mês passado.
Isso é importante em uma família de documentos orientada por conformidade por um motivo específico: a estrutura é fixa, então os nomes dos campos são estáveis e reutilizáveis, mas as tabelas exatas não são, portanto uma abordagem baseada em posição nunca se generaliza. Quando você define colunas, a parte estável (o campo) é mantida entre documentos e a parte instável (o layout) deixa de importar. Isso é o oposto do comportamento da extração por modelo, em que um modelo por módulo precisa ser reconstruído para cada relatório de estudo e cada tabela de especificações CMC.
Três tipos de colunas cobrem a maioria das necessidades regulatórias. Colunas diretas extraem campos que são explicitamente impressos, que são a maioria: desfechos, datas de início, limites de especificação. Colunas calculadas calculam durante a extração, por exemplo, derivando uma duração a partir de uma data de início e término, ou gerando uma diferença quando um total informado não corresponde às suas partes. Colunas inferidas atribuem um valor que o documento não imprime, mas implica, útil para uma categoria como se um evento é descrito como em andamento. Esse último tipo é uma leitura do texto, não um julgamento clínico, e nunca deve ser usado para algo que exija adjudicação.
Os arquivos são processados com segurança e não são armazenados.
O mecanismo geral, e como ele difere das ferramentas baseadas em posição que vieram antes, é descrito em extração de documentos sem modelo. Para uma equipe regulatória, a versão prática é mais simples que a teoria: escreva os nomes das colunas uma vez e reutilize-os em todos os relatórios do programa.
Tornando a Tabela Extraída Revisável
Em uma área regulamentada, uma tabela extraída só é útil se uma pessoa qualificada puder verificá-la sem reler a fonte. Essa é a diferença entre extração que economiza tempo e extração que adiciona uma carga de verificação. Três capacidades abordam isso diretamente.
Review Mode com verificação de caixa delimitadora permite que você passe o mouse sobre qualquer célula extraída e veja exatamente onde na página original aquele valor veio, e clique em uma região da página para voltar à célula correspondente. Para um campo como data de início ou avaliação de causalidade, isso transforma "confiar na extração" em "verificar a extração por amostragem" em segundos. Também mostra o valor original da IA quando um campo foi editado, para que uma correção seja rastreável.
Multi-Page Merge dobra um documento que abrange páginas de volta em uma única linha, agrupado por um valor compartilhado, como um ID do sujeito. É isso que impede que um evento grave cuja narrativa cruza uma quebra de página, ou os registros de um sujeito espalhados pelo apêndice, cheguem como dois meios-registros. Os campos são preenchidos a partir da página que os contém, e informações recorrentes, como o ID do sujeito, são transportadas para cada linha.
Model Tier importa quando a fonte é um documento escaneado ou fotografado. Relatórios de estudo mais antigos são frequentemente digitalizações em papel, e alguns contêm anotações manuscritas. Um nível de processamento mais alto usa um modelo subjacente mais forte para escrita manual densa e layout complexo, enquanto o nível padrão já cobre a maioria dos documentos tabulares impressos. A mesma plataforma lida também com os documentos regulatórios não relacionados a ensaios, incluindo o tipo de papelada administrativa escaneada abordada no guia de conformidade de extração de documentos de saúde.
O processamento em lote pertence à mesma lista por um motivo de nível de programa. Um programa de submissão produz muitos relatórios, e processá-los como um grupo mescla os resultados em uma única tabela, em vez de deixar uma pilha de exportações de documentos individuais para reconciliar. O padrão é o mesmo usado para outros registros clínicos, incluindo extração de documentos de ensaios clínicos, onde o problema de granularidade da saída é o sujeito inteiro.
O Que Este Tipo de Extração Não Faz
Ser claro sobre o limite é mais útil do que superestimar, porque nesse campo uma afirmação em um post de blog e um sistema validado são coisas muito diferentes.
Não codifica eventos adversos. Mapear um termo verbatim relatado para um termo preferido MedDRA em um sistema de órgãos é uma etapa de codificação com seu próprio dicionário e convenções. A extração pode transportar um termo já codificado de um documento, mas não atribui um.
Não faz adjudicação de segurança. Causalidade, gravidade e expectativa são decisões de uma pessoa qualificada. Uma coluna inferida lê o que o documento diz, e isso é tudo o que ela faz.
Não faz desidentificação. Identificadores de sujeito em um relatório permanecem na saída. Se o arquivo for para algum lugar sem um acordo de dados, removê-los é uma etapa separada e deliberada.
Não é um sistema validado ou certificado para auditoria, e não é uma ferramenta de publicação eCTD. Registros eletrônicos regulados exigem requisitos como trilha de auditoria para cada alteração e validação de sistema documentada, sob ICH E6(R3) e 21 CFR Part 11. Esta ferramenta não possui tal certificação. Os sistemas que gerenciam e publicam submissões em escala, LORENZ docuBridge, EXTEDO eCTDmanager e EXTEDOpulse, Veeva Vault Submissions e Certara GlobalSubmit, são onde o dossiê é montado, validado e arquivado. A extração fica a montante deles, como uma primeira passada que um humano revisa, não como o sistema de registro e não como publicador. A comparação aqui não é contra essas plataformas. É contra uma pessoa lendo um relatório e redigitando-o.
O que permanece dentro desses limites ainda é a maior parte do trabalho manual: extrair os valores repetidos dos documentos e colocá-los em uma tabela que um revisor possa verificar. Esse é o objetivo de transferir a tarefa de uma pessoa para uma ferramenta que não perde a estrutura no caminho.
FAQ
A IA consegue extrair dados de um relatório de estudo clínico sem criar um modelo para cada módulo? Sim, se você definir os campos desejados como nomes de colunas em vez de desenhar zonas em uma página. A leitura é por significado, então o mesmo conjunto de colunas funciona em diferentes relatórios de estudo e layouts diferentes. Você ainda precisa indicar de qual seção os dados são, porque um CSR contém os mesmos dados de eventos adversos em mais de um lugar.
O que é exatamente a extração de dados para submissão CTD? É extrair campos estruturados dos documentos que compõem um Common Technical Document, como desfechos e detalhes de eventos adversos dos relatórios de estudo clínicos do Módulo 5, limites de especificação das tabelas CMC do Módulo 3 e figuras resumo do Módulo 2. O objetivo é uma tabela, organizada pelas colunas que você nomeou, que uma pessoa possa revisar.
Por que minha extração retornou contagens quando eu queria uma linha por evento adverso? Porque o CSR contém dados de eventos adversos em três formatos: uma tabela de taxas resumo, uma listagem por sujeito e uma narrativa, e a solicitação não especificou qual deles. Nomeie as colunas do formato que você precisa, como ID do sujeito e termo do evento, para que a ferramenta tenha como alvo a listagem por sujeito em vez da tabela resumo.
Isso substitui meu sistema de publicação eCTD ou banco de dados de segurança? Não. A extração produz uma primeira passada revisável e fica a montante de sistemas como Veeva Vault, LORENZ docuBridge e EXTEDO. Não é uma plataforma validada e certificada para auditoria, não publica submissões, não codifica termos para MedDRA e não faz julgamentos de causalidade ou gravidade.
A Estrutura É Fixa, Então as Colunas Também Podem Ser
Documentos regulatórios não são difíceis de extrair porque são longos. Eles são difíceis porque uma estrutura fixa ainda permite que o mesmo fato apareça como uma taxa, uma linha e uma frase, e porque uma referência cruzada pode apontar para um número que não está impresso onde você está olhando. Depois que você aceita isso, a solução deixa de ser sobre modelos maiores e fica mais simples: nomeie os campos, nomeie o formato que deseja e deixe a ferramenta encontrá-los pelo significado, não pela posição. A estrutura regulatória que torna esses documentos rígidos é a mesma coisa que torna os nomes das colunas reutilizáveis em todo um programa.
Pegue um relatório de estudo clínico ou uma tabela de especificações CMC, defina as colunas que você realmente precisa e veja o resultado antes de comprometer um lote com ele.