月末経費の山場:
領収書を追いかけずに決算を締める方法
Ledgeの2025年月次決算ベンチマーク調査(SaaS、ヘルスケア、製造業の財務担当者100名を対象)によると、財務チームの半数が毎月の決算締めに5営業日以上を要しています。この5日という基準が重要なのは、新月度の最初の週内に締められるか、第2週にずれ込むかの分岐点だからです。第2週にずれ込むと、分析、予測、翌月の準備に充てる時間が圧迫されます。この5日以上の期間の中で、最も過小評価されている時間の浪費要因は、銀行残高調整や発生主義の計算ではありません。経費報告書です。ポリシーの確認でも、承認ルートでもありません。写真に撮られ、スキャンされ、くしゃくちゃにされ、メールで送られてきた領収書の山を、スプレッドシートや総勘定元帳の行に変換する、生の手作業こそが問題なのです。
重要ポイント
- 経費報告書の処理は、中堅企業の経理チームにとって月末締め時間の30〜40%を占めるが、チェックリスト上では単一の項目としてしか表示されない。
- 手作業による経費報告書1件あたりのコストは$58、所要時間は18分。従業員100人の企業では、月60時間の経理時間を消費する。
- 月末の締め切りプレッシャー下ではエラー率が上昇し、19%の報告書にミスが含まれ、修正に1件あたり追加で$52と18分を要する。
- 25日を提出期限とし、ストレスのないアップロードで徹底することで、4日間の締めを7日間に引き延ばす依存連鎖を防ぐことができる。
- バッチ方式の列名抽出により、50件の領収書の手入力15時間分が、意味的に処理されることで90分のレビューに短縮される。固定座標ではなく意味ベースで処理されるためである。
経費報告書が月末締めの静かなボトルネックとなる理由
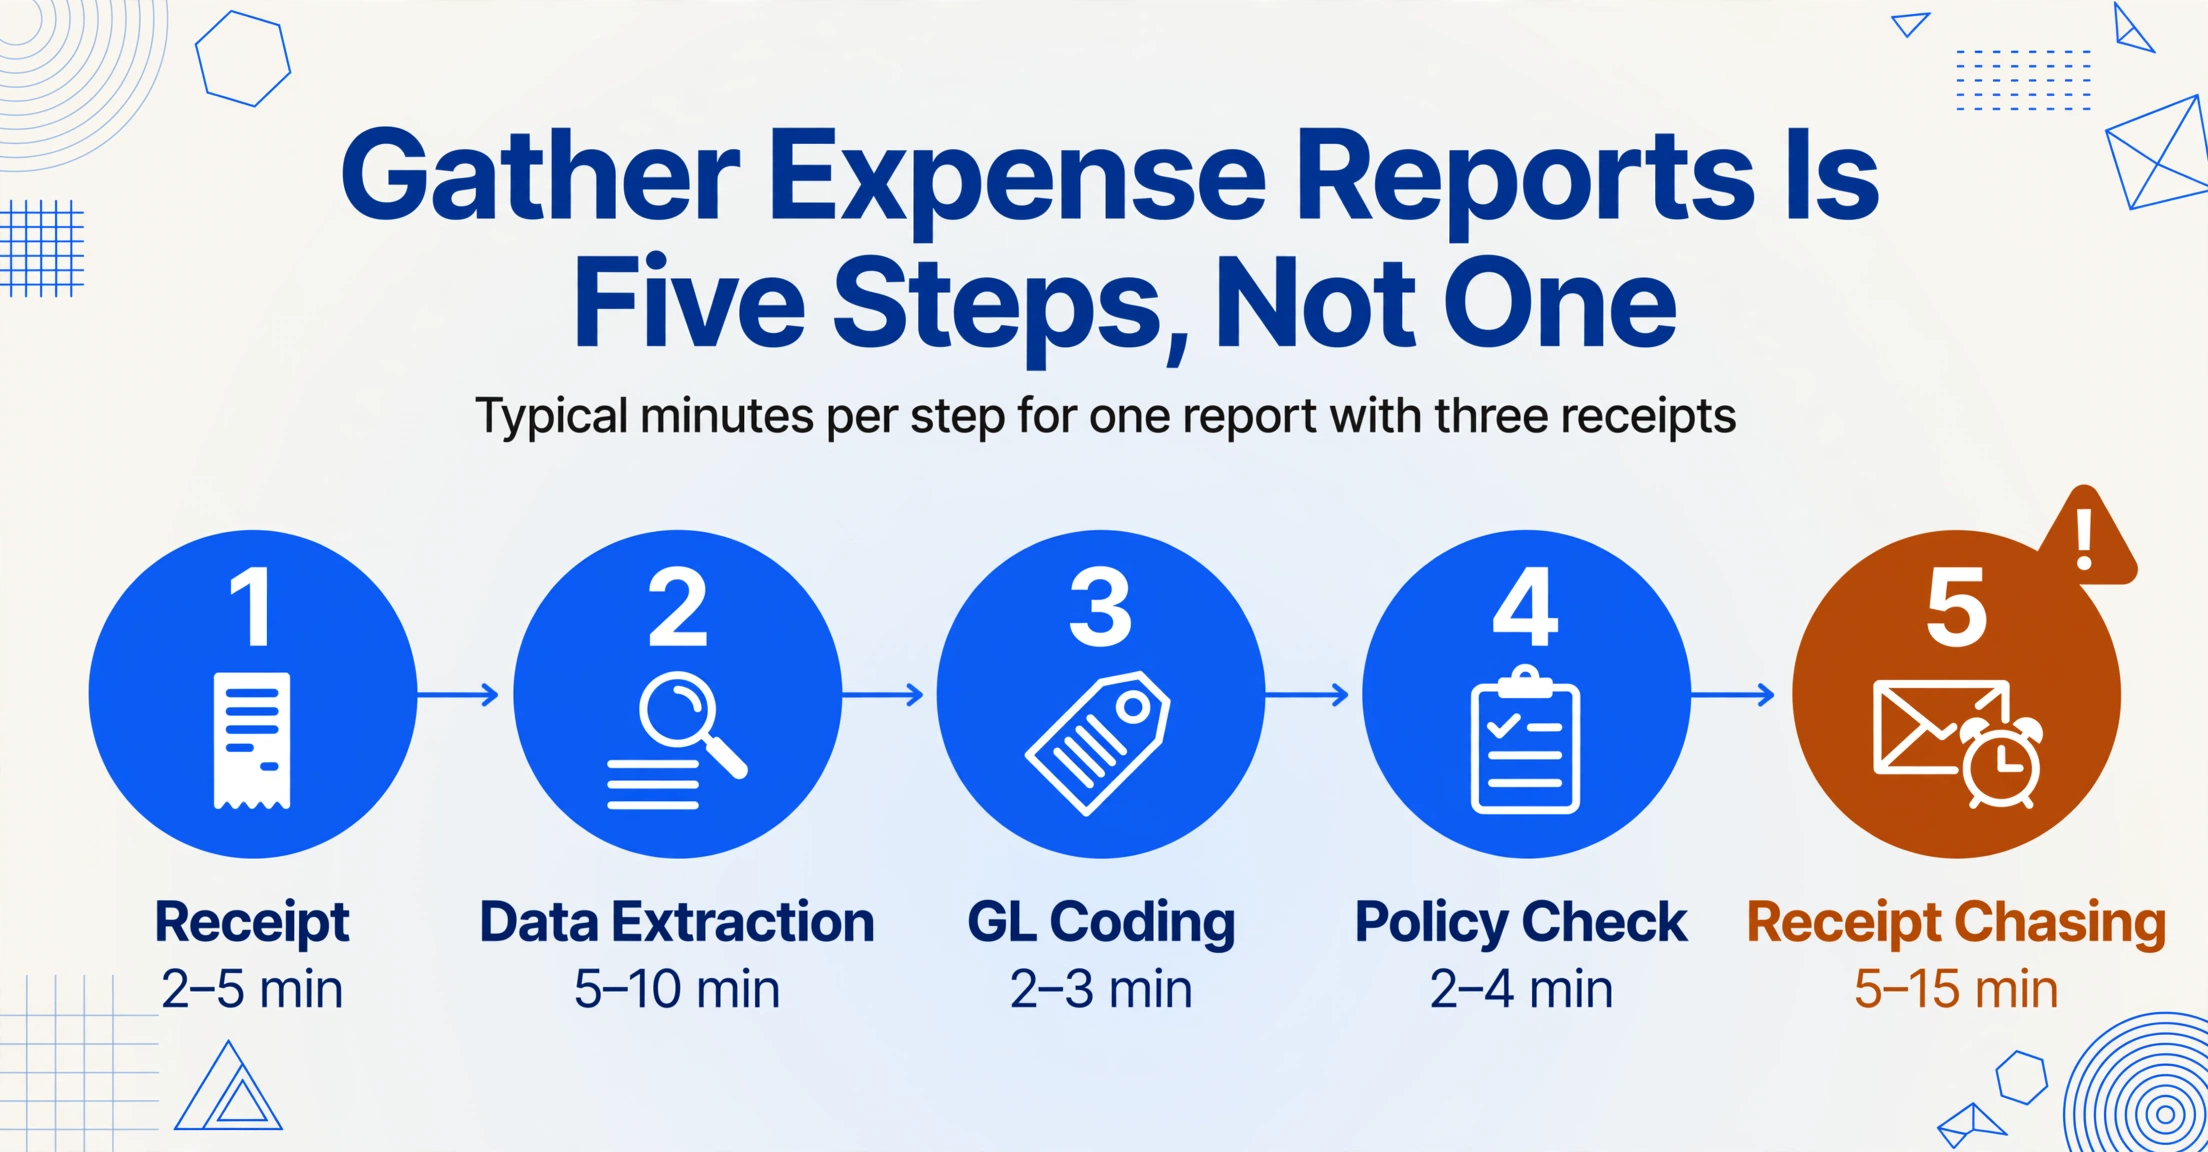
月末締めのチェックリストには必ず経費報告書が含まれている。通常は20項目中の1項目として。「従業員の経費報告書を収集」「経費報告書のコンプライアンスを確認」「経費の払い戻しを計上」。チェックリスト形式では、経費処理が単一の独立したタスクのように見える。チェックを入れて次に進むだけのものとして。しかし実際には、その3つの言葉の背後には、相互に依存するサブタスクのパイプラインが隠れており、営業やフィールド担当者が多い中堅企業の経理チームにとって、締め全体の30〜40%を消費する可能性がある。
このパイプラインを実際のステップに分解すると、領収書3枚が添付された経費報告書1件の場合、次のようになる:
| ステップ | タスク | 標準時間(分) | 実際の内容 |
|---|---|---|---|
| 1 | 領収書の受け取り | 2~5 | 従業員がメール、Slack、経費アプリで提出します。領収書はスマホの写真で、90度回転している場合や、転送されたメール添付のスクリーンショットの場合もあります。OCRの品質は大きくばらつきます。 |
| 2 | データ抽出 | 5~10 | 経理担当者または従業員が領収書画像を読み取り、手動で入力します。店名、日付、金額、経費カテゴリ、明細項目などです。「収集」という言葉が隠しているのは、このステップです。 |
| 3 | GLコード付与 | 2~3 | 正しい総勘定元帳の勘定科目コードを割り当てます。従業員が誤って推測した場合、経理が修正します。接待費と飲食費(50%控除対象)と事務用品費の違いなど、ここでのミスは税務・監査上のリスクを生みます。 |
| 4 | ポリシーチェック | 2~4 | 金額がポリシーの限度額内かを確認し、重複申請をチェックし、領収書が申請額と一致することを確認し、領収書の欠落をフラグ付けします。 |
| 5 | 領収書の追跡 | 5~15 | 領収書が欠落している、読み取れない、または申請額と一致しない場合、従業員にメールを送り、返信を待ち、再確認します。このステップは最も変動が大きく、月末には最も危険です。経理チームの締め切りに依存しない人々への依存が生じるからです。 |
| 6 | 承認ルーティング | 3~5 | マネージャーがレビューして承認します。マネージャーが休暇中や出張中の場合は、レポートが停滞します。月末は多くの営業マネージャーにとって四半期末の出張と重なります。 |
| 7 | 仕訳 | 1~2 | 調整済みの金額をERPまたは会計システムに入力します。 |
合計すると、レポート1件あたり20~44分かかります。領収書の品質や欠落の有無によって異なります。APQCのベンチマークデータによると、手動処理の経費レポート1件あたりの平均は約18分です。従業員100人の会社で毎月2件のレポートを提出する場合、3,600分、つまり60時間もの経理時間が、1か月の経費処理だけで消費されます。月末には、この60時間が銀行残高調整、未払費用の計算、財務諸表の作成と直接競合します。
このパイプラインは、他の決算タスクにはない脆さがあります。銀行残高調整は開始、一時停止、再開が可能です。データは変わりません。経費レポートのパイプラインは、経理部門外の人々からの生の入力に依存しています。3週間前にレストランの領収書を撮影したまま提出を忘れた従業員、または31日の午後9時47分に「すみません、忘れてました」という件名で転送した従業員などです。領収書が1枚欠けるごとに、経理だけでは解決できない依存関係の連鎖が生じます。そして月末、時計が刻々と進み、遅延したレポートが決算期限をさらに押し延ばすとき、これらの依存関係は単なる不便ではありません。4日で完了する決算が7日になるメカニズムそのものなのです。
経費精算書1件の処理に実際にかかる時間とコスト
APQCの18分というベンチマークは基準として有用ですが、問題を過小評価しています。これは、5分で済む領収書1枚のクリーンな申請を含むすべての報告書の平均だからです。月末の本当の負担はテール部分、つまり領収書4枚のうち1枚が誰も読めない色あせた感熱紙の駐車券だったり、従業員が為替レートの記載を忘れた外国語のレストラン請求書が含まれる報告書にあります。
コスト面はさらに顕著です。GBTA Foundationのベンチマークでは、経費精算書1件の処理コストは58ドル、従業員と経理の合計時間は20分とされています。19%にエラーが含まれ、修正に追加で52ドルと18分かかります。この58ドルという数字の内訳と従業員1人あたりのコストモデルの詳細は、手動経費精算書処理コストの分析をご覧ください。要点は明確です。従業員150人の企業で、1人あたり月1.2件の報告書がある場合、年間処理コストは146,000ドルを超えます。これは管理間接費のみで、1ドルの払い戻しが行われる前の数字です。
月末の倍率効果でこれらの数字はさらに悪化します。決算期間中、経理チームは時間的プレッシャーのもとで経費精算書をバッチ処理します。つまり、報告書間のコンテキスト切り替え、レビュー手順の迅速化、月中よりも速い分類判断が求められます。エラー率は上昇し、修正コストは複利的に増加します。さらに、修正にはすでに経費精算書から気が逸れている従業員への問い合わせが必要なため、対応時間は数時間から数日に延びます。3日に提出された修正報告書が解決されるのは7日になるかもしれません。その時点で決算期限はすでに過ぎています。
これが、CFO.comがAPQCのオープンスタンダードベンチマークを引用して示す、APQCの中央値である6.4営業日という決算期間が、有用なベンチマークであると同時に誤解を招く数字である理由です。この数字からは、6.4日のうち最後の2日が経費精算書の整理、つまり最終15%の申請の追跡、最後の領収書不一致の解決、初日からデジタル化されるべきだったデータの手入力に費やされることが多いという事実は見えてきません。
プレクローズ期間:締め切りカウントダウン開始前に行うべきこと
財務チームが月次経費処理プロセスに加えられる最も効果の高い変更は、テクノロジーの変更ではありません。タイムラインの変更です。従業員の提出締め切りを毎月25日に設定し、慢性的な遅延提出の問題がある企業では22日に設定し、それを厳守します。
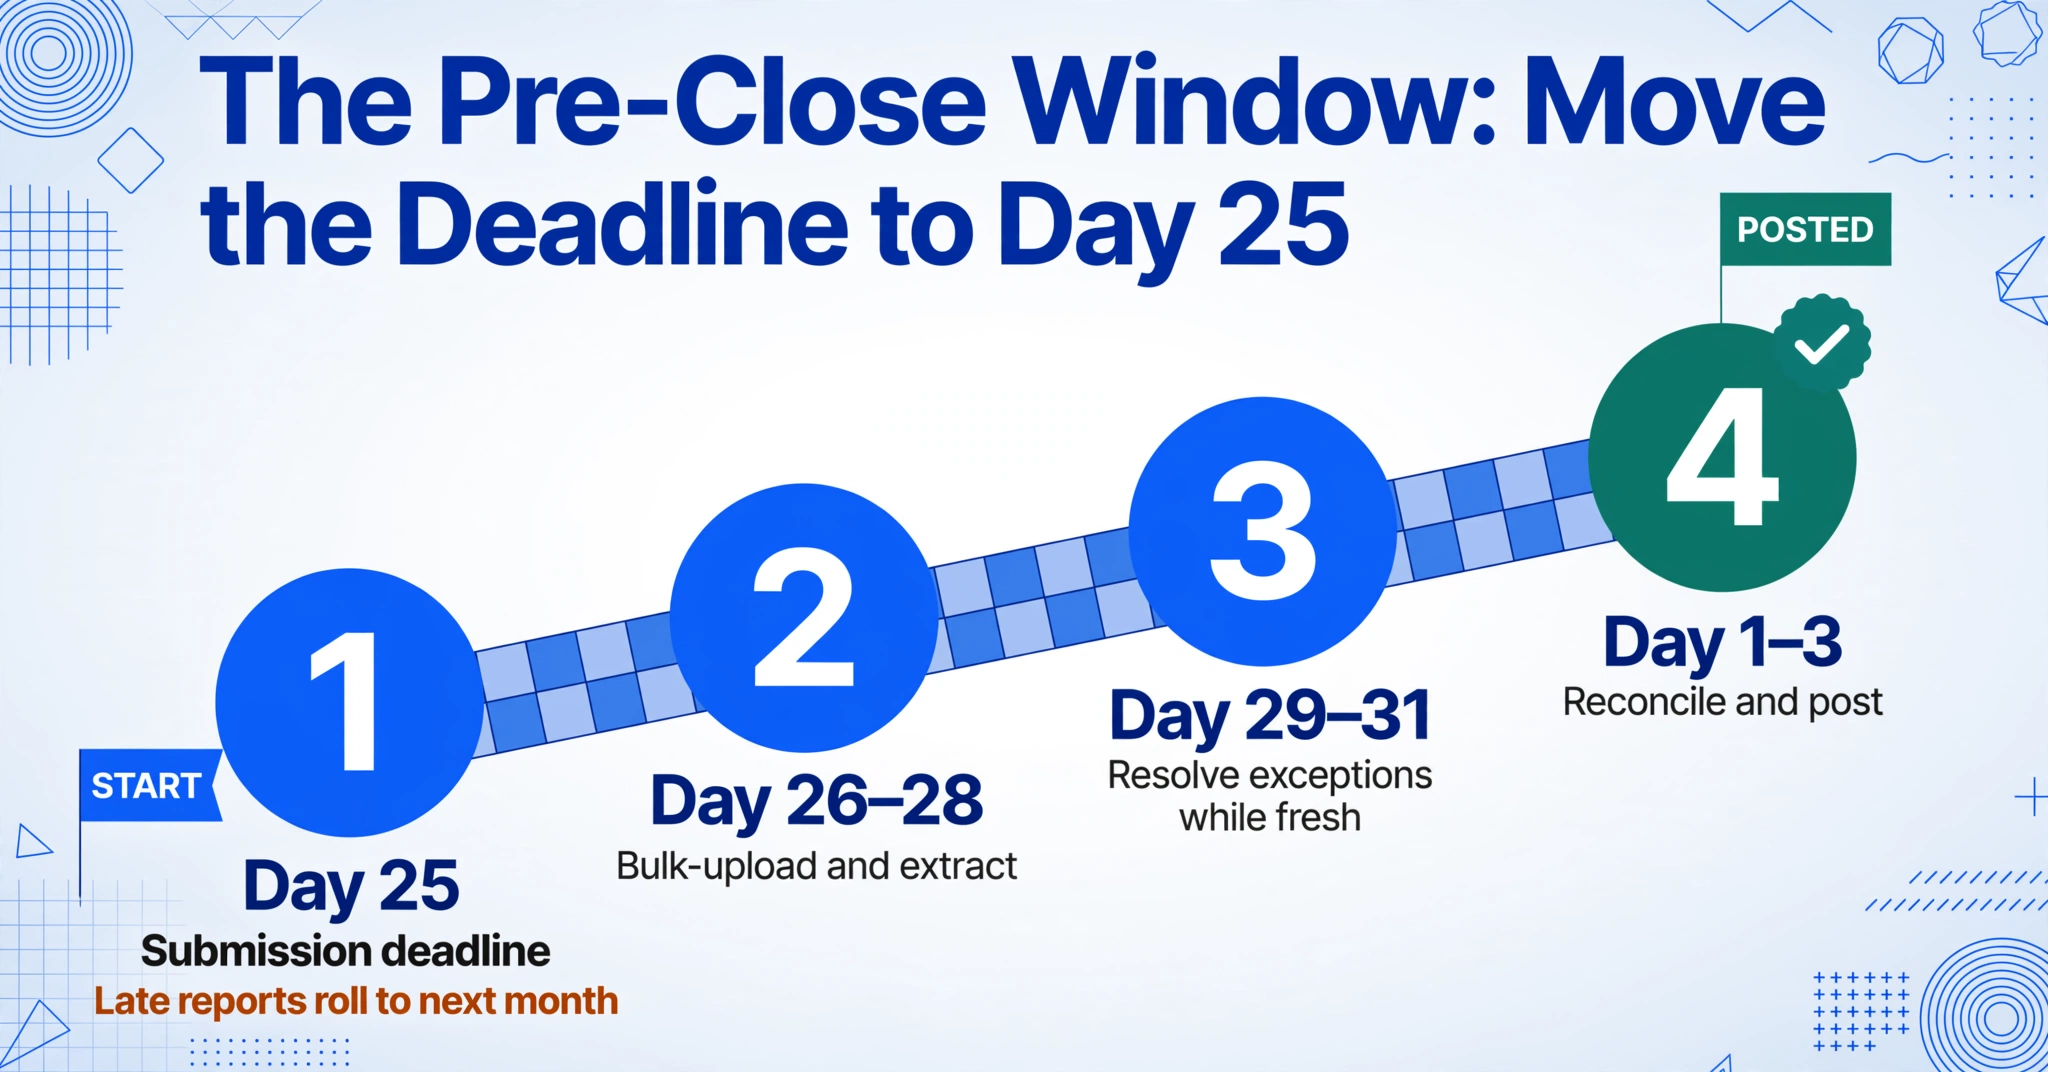
これは当然のことのように思えます。ほとんどの企業にはすでに締め切りがあります。違いは執行の仕組みにあります。メールやポリシー文書に記載された締め切りは、単なる提案に過ぎません。提出ウィンドウを自動的に閉じるシステムに裏付けられた締め切り、あるいはより現実的には、提出の手間を徹底的に取り除き、締め切りに間に合わせることが逃すことより簡単になるようにするシステムは、行動を変えます。プレクローズ期間は次のようになるべきです:
- 25日:従業員の提出締め切り。当月分のすべての経費報告書は、領収書を添付して提出する必要があります。この日以降の遅延提出は、経理責任者の事前承認がない限り、翌月のサイクルに繰り越されます。
- 26〜28日:財務の前処理期間。提出されたすべての報告書を一括アップロードし、抽出を実行し、例外にフラグを立てます。この期間に、AI抽出により、手動データ入力に2〜3日かかっていた作業が1回のセッションに圧縮されます。
- 29〜31日:例外の解決。財務チームは、領収書の欠落やポリシー違反について従業員に連絡します。取引がまだ新しい(数日以内、数週間ではない)ため、従業員は問題を迅速に解決できます。
- 翌月1〜3日:最終照合と転記。月が正式に終了する頃には、経費データの85〜90%がすでに抽出、検証、コード化されています。クローズ期間は、レビューと最終仕訳に費やされ、一次データの取得には費やされません。
このタイムラインを以前は不可能だった方法で実現可能にする仕組みがCollection Linkです。これは、経費システムへのログイン、アプリのインストール、アカウント作成を必要とせずに、従業員が領収書を財務チームの処理キューに直接アップロードできる共有可能なURLです。リンクを開き、短い認証コードを入力して、スマートフォン、デスクトップ、または転送されたメールからアップロードします。領収書は単一のキューに集約され、バッチ処理の準備が整います。ダウンロードが必要なメール添付ファイルも、「先週の領収書です」というSlack DMも、ファイル名でリンクされた不一致の領収書が入ったスプレッドシートもありません。Collection Linkは、提出のボトルネックを「従業員が対応したかどうか」から「領収書がキューにあるかどうか」に移します。
1回のアップロード、1回のエクスポート:1か月分の提出を1回の処理で
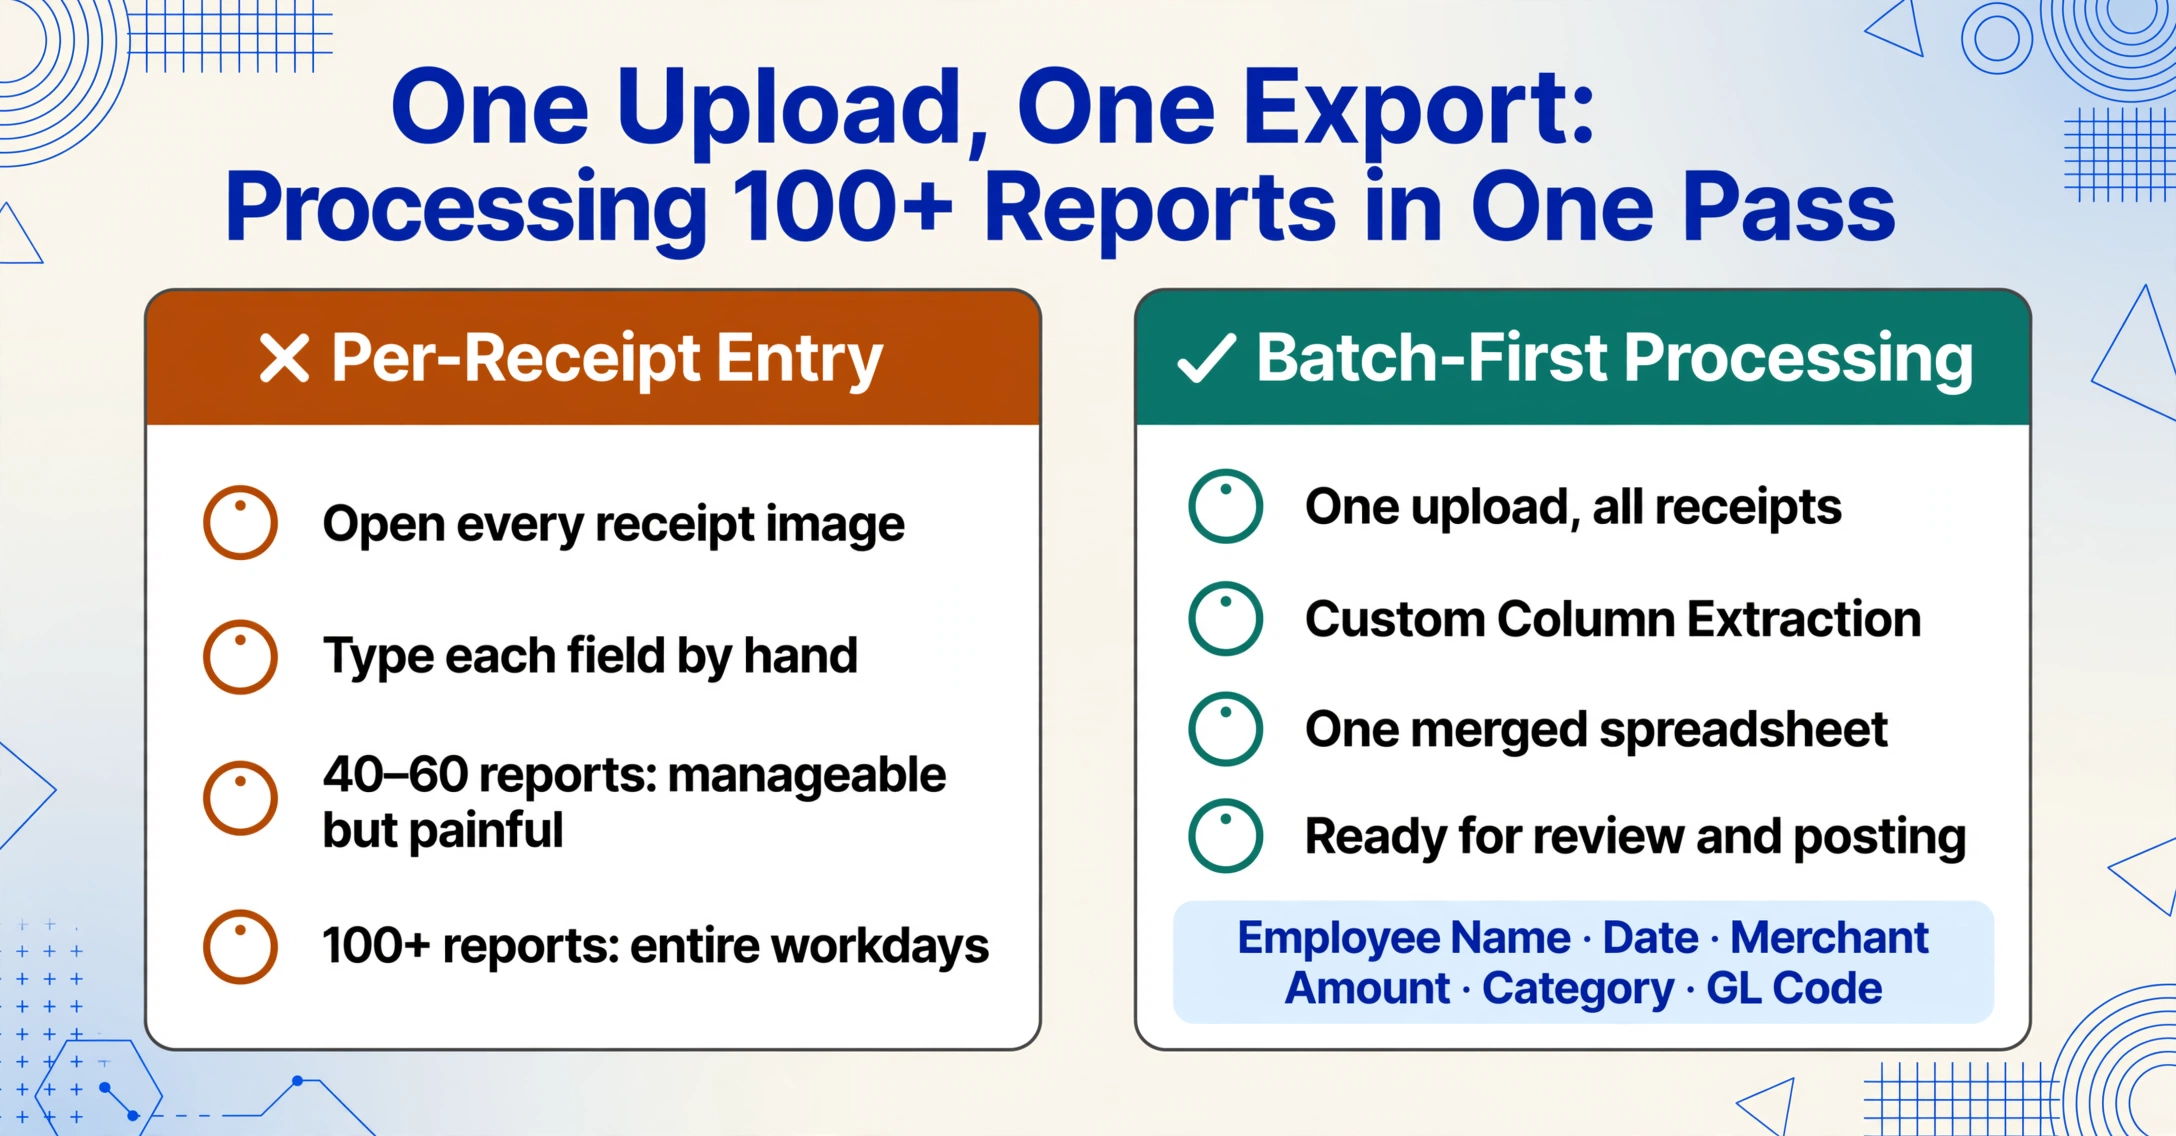
レシートが集まると、ボトルネックは収集から抽出へと移ります。この段階の従来の方法(各レシート画像を開き、ベンダー名・日付・金額を読み取り、経費システムやスプレッドシートに転記する)は、スケールしません。月40〜60件なら対応可能ですが負担が大きく、100件以上になると丸1日を費やします。代替策はバッチ抽出です。すべての提出物を一度にアップロードし、各レシートから抽出するフィールドをツールに指定して、1つの結合スプレッドシートを受け取ります。
ここで列名抽出がワークフローを変えます。各レシートを個別に開いてセルにデータを入力する代わりに、必要な列(「従業員名」「日付」「取引先」「金額」「カテゴリ」「GLコード」)を定義すると、AIがバッチ内のすべてのレシートを読み取り、各フィールドの意味(ページ上の位置ではなく)を理解して特定し、対応する列に入力します。出力は、すべての経費報告書が1つのテーブルにまとめられた単一のExcelファイルで、レビューと転記の準備が整います。
ファイルは安全に処理され、保存されません。
列名アプローチは、経費報告書で従来のOCRを脆弱にするテンプレート依存を排除します。レシートの形式は大きく異なります。Square POSのレシートはホテルの明細書とは似ても似つかず、ホテルの明細書は半分筆記体のトルコ語で書く運転手の手書きタクシーレシートとはまったく異なります。テンプレートベースのOCRツールは固定座標に依存するため、形式のばらつきに弱いのです。列名抽出は意味的に機能することでこれを回避します。AIは「ピクセル座標(340, 120)のテキスト」ではなく「この取引が発生した日付」を探します。財務チームが実際に直面するレシートの多様性におけるこの仕組みの詳細については、スキャンしたPDFからの経費報告書データ抽出ガイドをご覧ください。
月次の従業員経費報告書のバッチを処理するチームにとって、効率向上は相乗効果をもたらします。50件の単一レシート報告書を個別に処理する場合、1件あたり18分として、経理チームは15時間を要するかもしれません。しかし、50件すべてを1つのバッチとしてアップロードし、列を一度指定して、結合された出力をレビューする場合(抽出は1ページあたり5〜10秒)、この15時間のタスクは約90分のレビュー時間に短縮されます。抽出自体はバックグラウンドで実行されるため、経理チームの役割はデータ入力担当者から例外レビュー担当者へと変わります。
経理チームが実際に実行できる3日間の経費締めワークフロー
月末締めは6日間の試練である必要はありません。ここでは、バッチ抽出がデータ取得レイヤーを担当し、経理チームの時間がレビューと意思決定(実際に人間の判断を必要とする活動)に費やされることを前提とした、3日間の経費締めワークフローを紹介します。
1日目: 収集と抽出
午前: コレクションリンクを締め切ります。期限までに提出されたすべての経費申請が1つのキューにまとまります。追跡するメールや転送する領収書添付のSlackメッセージもありません。全バッチを抽出ツールにアップロードします。列名を指定: 従業員、日付、仕入先、金額、カテゴリ、部門、GLコード、領収書画像リンク。抽出を実行します。正午までに、すべての領収書のデータが抽出・整理された1つのスプレッドシートが完成します — 20件、50件、100件のレポートが1つのテーブルに集約されます。午後: 初期レビューを実施します。抽出金額が明らかな領収書パターンと一致しない行にフラグを立てます(例: 夕食の領収書が$45.00ではなく$450として抽出された場合 — AI抽出では小数点エラーはまれですが、高額項目のスポットチェックは価値があります)。必須フィールドが欠落しているレポートを特定します。
2日目: 例外のレビューと照合
午前: フラグが立てられた例外を解決します。問題のあるレポート(5〜10%)について従業員に連絡します — $200以上の経費の領収書欠落、申告カテゴリと一致しない仕入先名、同じ領収書の重複提出など。抽出によりレビュー可能な形式の構造化データがすでに得られているため、データ入力中にこれらの問題を発見するのではなく、完了した抽出結果の外れ値をレビューすることになります。これは根本的に異なるタスクです: より速く、エラーが少なく、見逃しの可能性も低くなります。午後: カテゴリとGLコードのレビューを実行します。推論列を使用した場合 — AIが領収書の内容を読み取り、領収書にカテゴリフィールドがない場合でも「食事」や「出張」などのカテゴリを割り当てる機能 — 分類の10〜15%をスポットチェックして正確性を確認します。誤分類された項目を調整します。部門別合計サマリーを実行して明らかな異常を検出します(例: エンジニアリング部門が出張していない月に$12,000の出張費が計上されている場合)。
3日目: 確定と転記
午前: 最終承認レビューを実施します。完成したスプレッドシートまたは抽出データを経費システムの承認ワークフローに回します — または、ERPに直接転記する場合は、証憑を添付した仕訳を準備します(スプレッドシートの各行が元の領収書画像を参照します)。午後: 経費エントリを総勘定元帳に転記します。経費取引の期間をロックします。経費照合レポートを生成し、コントローラーまたはCFOのレビューに回します。3日目の終わりまでに、経費は締められ、転記され、照合されます — 4日目と5日目はクロージングプロセスの残り(銀行照合、未収費用、財務諸表作成、差異分析)に充てられます。
このワークフローは1つの構造的変更に基づいています: 抽出はクロージングの開始時に高速で自動化されたバッチプロセスとして行われ、期間全体に分散する遅い手動データ入力ではありません。財務チームの時間は価値を生む活動 — レビュー、例外処理、分析 — に費やされ、領収書画像の読み取りやセルへの数字入力には費やされません。ほとんどのミッドマーケットチームにとって、この変更だけでクロージングの経費コンポーネントから2〜3日短縮されます。
紙の領収書、スキャンしたPDF、複数通貨の経費については?
月末には、完璧に読み取れるデジタル領収書だけが揃っているわけではありません。従業員が過去30日間に集めたものがそのまま届きます。それには以下が含まれます:
- オフィスの複合機でスキャンした紙の領収書:200 DPI、傾きがあることが多く、従業員がスキャナベッドに正しく置かなかったために領収書の上半分が切れていることもあります。AI抽出はテンプレートOCRよりもこれらをうまく処理します。文書全体を必要とせず、セマンティックな理解でフィールドを特定するため、全ページのレイアウトをスキャンする必要がないからです。
- 色あせた感熱紙の領収書:古い感熱紙の領収書の文字は、6〜12か月で肉眼では読めなくなります。従業員が9か月前の領収書を遅延経費申請で提出した場合、画像には文字があった場所にかすかな灰色の線だけが残っていることがあります。AI抽出は、残っているコントラストパターンを利用して、人間の目には見えない文字を復元できることがありますが、魔法ではありません。感熱インクが完全に劣化している場合、どの抽出ツールでも復元できません。これは、抽出技術の向上だけでなく、より迅速な申請サイクルの重要性を示しています。
- 外国語の領収書:日本への出張中の従業員が、日本語のみのレストラン領収書を提出した場合、AIはその領収書を現地の言語で読み取り、日付、金額、ベンダー名を抽出します。翻訳は不要です。出力は構造化データであり、翻訳文書ではないからです。金額は数値として抽出され(記号があれば通貨も識別)、ベンダー名はそのまま抽出されます(これが望ましい結果です。「すき家」をベンダー列に記載することは、機械翻訳による近似値よりも監査目的に有用です)。
- 複数通貨のシナリオ:経費ポリシーで現地通貨の元の領収書と換算額の提出が求められている場合、AIは領収書から元の金額と通貨を抽出します。換算ステップは財務部門のポリシー判断であり、AIは文書に記載されている内容を識別するもので、償還レートを決定するものではありません。
これらのエッジケースは月末には珍しくなく、経費処理が予想以上に時間がかかる主な理由です。80件のレポートのバッチには、読み取り不能になりかけている感熱紙の領収書が15件、外国語のレストラン請求書が8件、位置ずれのあるスキャンPDFが12件含まれている可能性があります。標準的なOCRツールはこれらでエラーを出しますが、列名抽出はクリーンなデジタル領収書と同じバッチでこれらを処理し、低信頼度の抽出をパイプラインを停止するのではなく手動レビュー用にフラグ付けします。AI抽出と従来の経費管理アプリのどちらがこの変動性をうまく処理するかを評価しているチームにとって、違いはエラーが発生するかどうかではなく(発生します)、システムがクリーンな領収書の90%を自動処理し、エッジケースの10%をレビューキューに送るか、それともどれがどれかを判断できないためにすべてを手動で処理しなければならないかです。
よくある質問
AI抽出は経費ポリシーを自動的に適用しますか?
いいえ — そして、それを期待すべきではありません。ポリシーの適用には判断が必要です。マンハッタンでの95ドルの夕食はポリシー内かもしれませんが、同じ金額がオマハでは超過する可能性があります。AI抽出はレシートに記載されている内容(業者、日付、金額、明細項目)を取得し、レビューのために構造化します。ポリシーの適用が行われるのはレビューの段階です。AIが変えるのは、レビュー担当者がレシート画像のフォルダではなく、構造化された検索可能なデータから始められることです。金額順に並べられたスプレッドシートでポリシー違反を見つけるのは、レシートを一枚ずつめくって見つけるよりもはるかに速いです。
AIがGLコードを割り当てることはできますか、それともすべてを確認する必要がありますか?
推論列(AIが文書内の内容に基づいて値を割り当てるカスタムフィールド)を設定して、カテゴリやGLコードを提案させることができます。例えば、「GLコード(選択肢:6100-食事、6200-出張、6300-備品、6400-接待)」という列は、AIにレシートを読ませて適切なコードを選ばせます。AIの分類精度は明確なケース(レストランのレシート→6100-食事、航空券→6200-出張)では高いですが、混合カテゴリ(出張中の食事がポリシーによって6100か6200のどちらにもなり得る)では曖昧になることがあります。推奨されるワークフローは、抽出中にAIにコードを割り当てさせ、レビュー中にサンプルをスポットチェックすることです — AIの出力を時間節約の第一パスとして扱い、保証された最終回答とは見なさないことです。
抽出されたデータは当社のERPや会計ソフトウェアと統合できますか?
抽出出力はExcel(XLSX)、CSV、またはJSONです — すべてのERPおよび会計プラットフォームがインポートできる形式です。QuickBooks、Xero、NetSuite、Sage、SAPなどのツールはすべて、仕訳や経費データのCSVまたはExcelインポートをサポートしています。抽出ツール自体はAPIを介してデータを直接ERPにプッシュしません。ワークフローは抽出 → エクスポート → インポートです。Google Sheetsユーザーの場合、Google Sheetsアドオンが抽出データをスプレッドシートに直接書き込み、それを会計システムのインポートソースとして使用できます。
一度に処理できるバッチの最大サイズは?
バッチサイズに厳密な技術的制限はありませんが、実務上のワークフロー上の考慮事項があります。1回のバッチで領収書画像100〜200枚をアップロードするのは通常の運用範囲内であり、数分で処理されます。それを超えると、抽出時間ではなくアップロードと確認の時間がボトルネックになります。Excelで抽出されたデータ500行をスクロールしてスポットチェックするのは、確認に集中できる小さめのバッチを2回処理するよりも非効率です。非常に大量のデータを処理するチームでは、部門やコストセンターごとにバッチを分割すると、確認がより管理しやすくなります。
監査時に領収書画像が必要になった場合はどうすればよいですか?
抽出されたスプレッドシートには各領収書のデータが含まれていますが、元の領収書画像は別途保管しておく必要があります。経費管理システム、クラウドストレージフォルダ、またはスプレッドシート内の画像リンクとして添付する方法があります。抽出リクエストに「領収書画像」列(ソースファイルへの参照を取得する列)を含めると、出力の各行でどの画像から取得されたかを参照できるため、監査時に元の画像を簡単に見つけることができます。