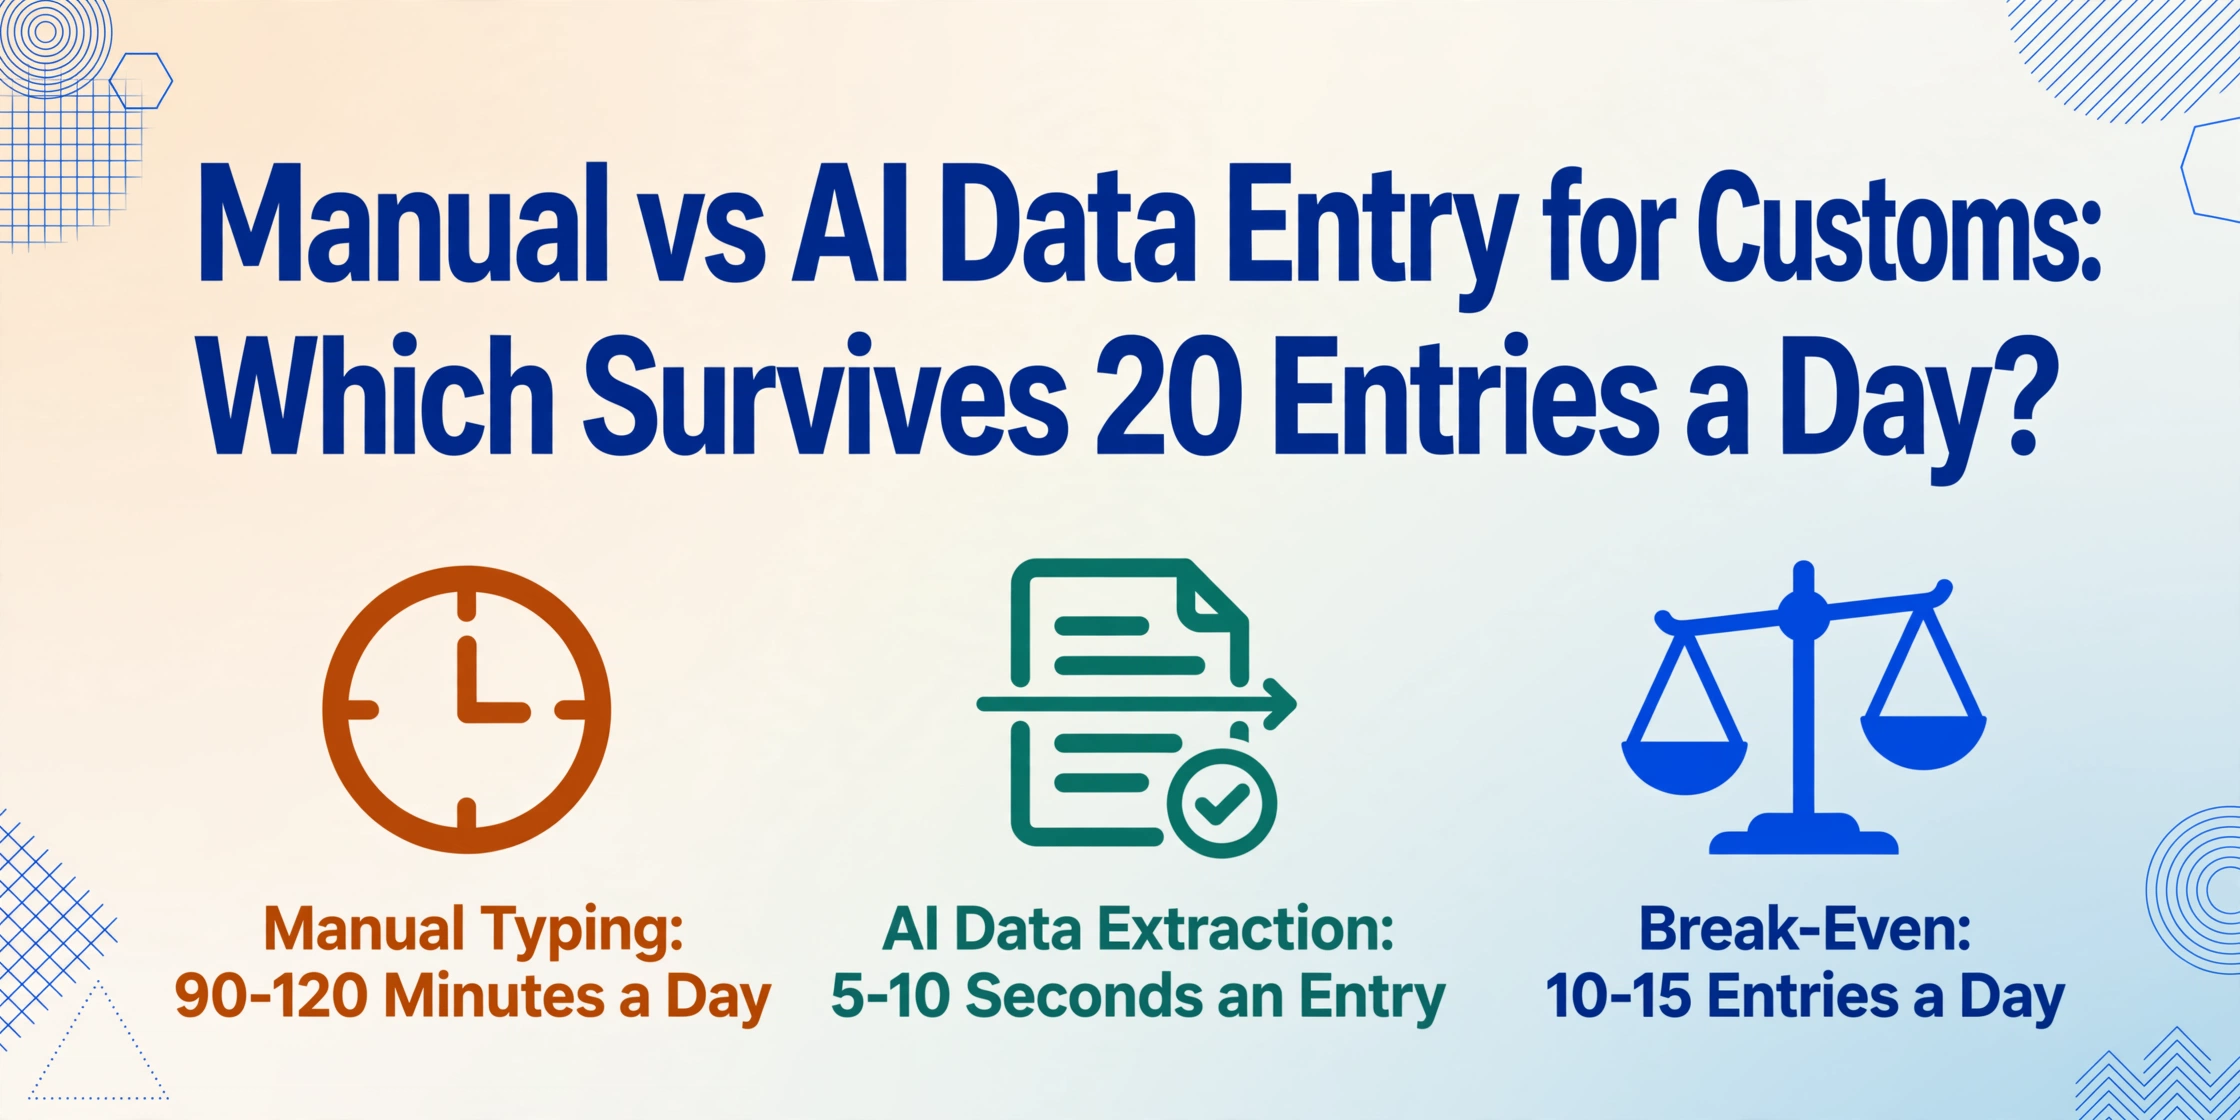
手作業 vs AI通関データ入力:
1日20件の入力に耐えるのはどちらか?
2025年度、米国関税・国境警備局は5,000万件の輸入申告(エントリーサマリー)を処理し、2,432件の通関違反に対する制裁措置を発動し、輸入申告審査から343.4億ドルを回収しました。これらの申告はすべて、商業送り状、パッキングリスト、船荷証券からデータを抽出し、申告書類に転記する作業から始まります。この工程は、現在でもほとんどの通関業者で手作業が主流です。本比較では、この工程に実際にどれだけの時間とコストがかかり、どのようなエラーが発生し、処理能力にどのような影響があるのか、また、どの処理量で手作業のワークフローが管理不能になるのかを測定します。
重要なポイント
- 通関申告の準備時間の60〜70%は、通関士の資格が活かされる分類やコンプライアンス業務ではなく、仕入先の請求書から数値を読み取り、手作業で再入力する作業に費やされています。
- 1日20件の場合、手作業による転記工程は週に7.5〜10時間、つまり丸1営業日を消費し、その入力時間の毎時間、誤った数字が監査の引き金となり、5年間遡って通関監査を受けるリスクがあります。
- 1日10件未満であれば手作業での入力は経済的に合理的ですが、20件を超えると状況は逆転します。処理量を維持するための人材雇用コストは転記工程を撤廃するコストを上回り、ImageToTable.aiはあらゆる文書の全フィールドを1ページあたり10秒未満で抽出します。
手動での通関申告準備で実際に何が起きているのか
通関申告の提出プロセス — CBPのACEシステム、HMRCのCDS、EU加盟国の税関当局への正式なデータ提出 — はすでにデジタル化されています。デジタル化されていないのは、大多数の通関業者において、提出前のステップ、つまり原資料から貿易データを抽出し、申告ソフトウェアに入力する作業です。ここが、ほとんどの自動化議論が飛ばしてしまうギャップです。EDIやAPI接続は、すでに構造化データを持つシステム間の機械対機械の転送を処理します。深圳の工場からのスキャンされたパッキングリストを読み取ることはできません。
単一の通関申告を準備する手動ワークフローは、5つのステップに分けられます:
ソース文書の受領と仕分け
商業送り状、パッキングリスト、船荷証券または航空貨物運送状、原産地証明書 — 1つの貨物で、異なる当事者から、異なる形式で、異なる経路(メール、共有ドライブ、ポータルダウンロード)を通じて10件以上の文書が届くことがあります。運送業者の調査によると、通関手続きの遅延の40%は、申告準備が始まる前のこれらの文書間の不整合に起因していました。
データ項目の特定と申告ソフトへの入力
オペレーターは商業送り状を読み、荷送人、荷受人住所、貨物の説明、数量、重量、申告価額、通貨、インコタームズ、原産国、HSコードを特定し、申告システムの該当フィールドにそれぞれ入力します。CBPフォーム7501だけでも47のデータ欄があります。5つの品目がある複数行の申告の場合、オペレーターは申告1件につき約35〜50の個別データを処理し、その都度ウィンドウを切り替えます。
文書間のデータ整合性チェック
送り状の数量はパッキングリストと一致している必要があります。申告価額は商業送り状の合計と整合している必要があります。HSコードは貨物の説明と一致している必要があります。これらのチェックは手作業かつ順次実行されます — オペレーターは文書Aを読み、文書Bを読み、頭の中で比較します。金曜日の午後4時、まだ8件の申告が待機列にある場合、整合性チェックは最初に省略または簡略化されるステップです。
貨物の分類と貿易プログラムの適用
オペレーターは正しいHSコードを決定し、自由貿易協定の特恵を適用し、ADD/CVDの適用可能性を確認し、PGA要件(FDA、USDA、EPA)を確認します。これは通関知識が最も重要となるステップであり、経験豊富なブローカーでもCBP監査のきっかけとなる分類エラーを起こすステップでもあります。誤分類されたHTSコードは、フォーカスド・アセスメントで発見されるまで、数ヶ月分の申告にわたって関税の過少納付を引き起こす可能性があります。
申告書を提出し、却下に対応してMRNを取得する
申告書は税関当局に電子的に送信されます。検証に合格すれば、Movement Reference Number(MRN)または輸入申告番号が数秒で返されます。HTSコードの不一致、PGAデータ要素の欠落、無効なEORIなどが原因で失敗した場合は、却下メッセージが返され、担当者がトラブルシューティングを開始します。却下された申告が1件あるだけで、正常な申告3件分と同じ時間を消費することがあります。
ステップ2と3 — 書類上のデータの特定と転記 — は、通常、申告準備全体の時間の60〜70%を占めます。税関の専門知識と判断を要するステップ4と5は、残りの30〜40%を占めます。この比率こそが、手動と自動化の比較を有意義にする理由です:時間のかかるステップは機械的なものであり、専門知識を要するものではないのです。DHLの調査によると、通関遅延の80%は不正確または欠落した書類に起因しており、物理的な検査の滞留や港湾の混雑によるものではありません。つまり、書類からシステムへの変換ステップこそが構造的なボトルネックが存在する場所なのです。
この労力の逆転 — 単純作業が熟練作業よりも多くの時間を消費するパターン — こそが、手動ワークフローが機能不全に陥る状況を定義づけます。また、自動化が実際に役立つ場所も定義します:税関の専門知識を置き換えるのではなく、専門知識を適用する前に消費される転記の障壁を取り除くことです。このパターンが業界全体でなぜ続くのかをより深く知るには、貨物運用における税関データ管理がボトルネックであり続ける構造的理由に関する分析をご覧ください。
速度:「1件あたり3分」が100件の申告を1週間処理する場合に意味すること
印刷されたデータ1ページの手動転記には、およそ3分かかります。各フィールドを探し、入力し、確認する作業です。これは、通常の作業条件下での熟練データ入力オペレーターの平均値です。熟練データ入力オペレーターに関する研究では、管理された条件下でもエラー率は0.5%から1%の間であることが一貫して判明しており、その率は勤務時間が進むにつれて上昇します。午前9時に1%の正確性で入力していた同じオペレーターも、認知疲労が蓄積する午後遅くには3%以上のエラーを発生させます。
1日あたり20件の申告を処理する通関業者(中小規模の通関業者にとって一般的な量)の場合、計算は単純です。20件 × 1件あたり3分のデータ抽出 = 60分です。実際には、書類の仕分け、照合、フォーマットの不整合への対応を含めると、データ転記だけで1日あたり90〜120分に近くなります。100件を処理する5日間の週では、7.5〜10時間になります。つまり、週にほぼ1営業日分が、通関知識を追加せず、エラーの大部分を生み出す作業に費やされていることになります。
標準的な単一ラインの申告について、両方のワークフローでの1件あたりのタイムラインの内訳は次のとおりです。
| 作業 | 手動ワークフロー(1件あたり) | AI支援ワークフロー(1件あたり) |
|---|---|---|
| 書類の受領と仕分け | 2〜3分 | 2〜3分(変更なし — 書類は既存の経路で引き続き届きます) |
| データフィールドの特定と転記 | 3〜5分 | 5〜10秒(すべての書類をアップロードし、AIが構造化データを抽出) |
| 書類間の整合性の照合 | 2〜4分 | 1〜2分(フラグが付いた不一致についてAI抽出テーブルを確認) |
| 貨物の分類、貿易プログラムの適用 | 2〜5分 | 2〜5分(変更なし — 通関の専門知識が必要) |
| 申告、拒否への対応、MRNの取得 | 1〜3分 | 1〜3分(変更なし — 電子申告は抽出方法とは独立) |
| 1件あたりの合計 | 10〜20分 | 6〜13分 |
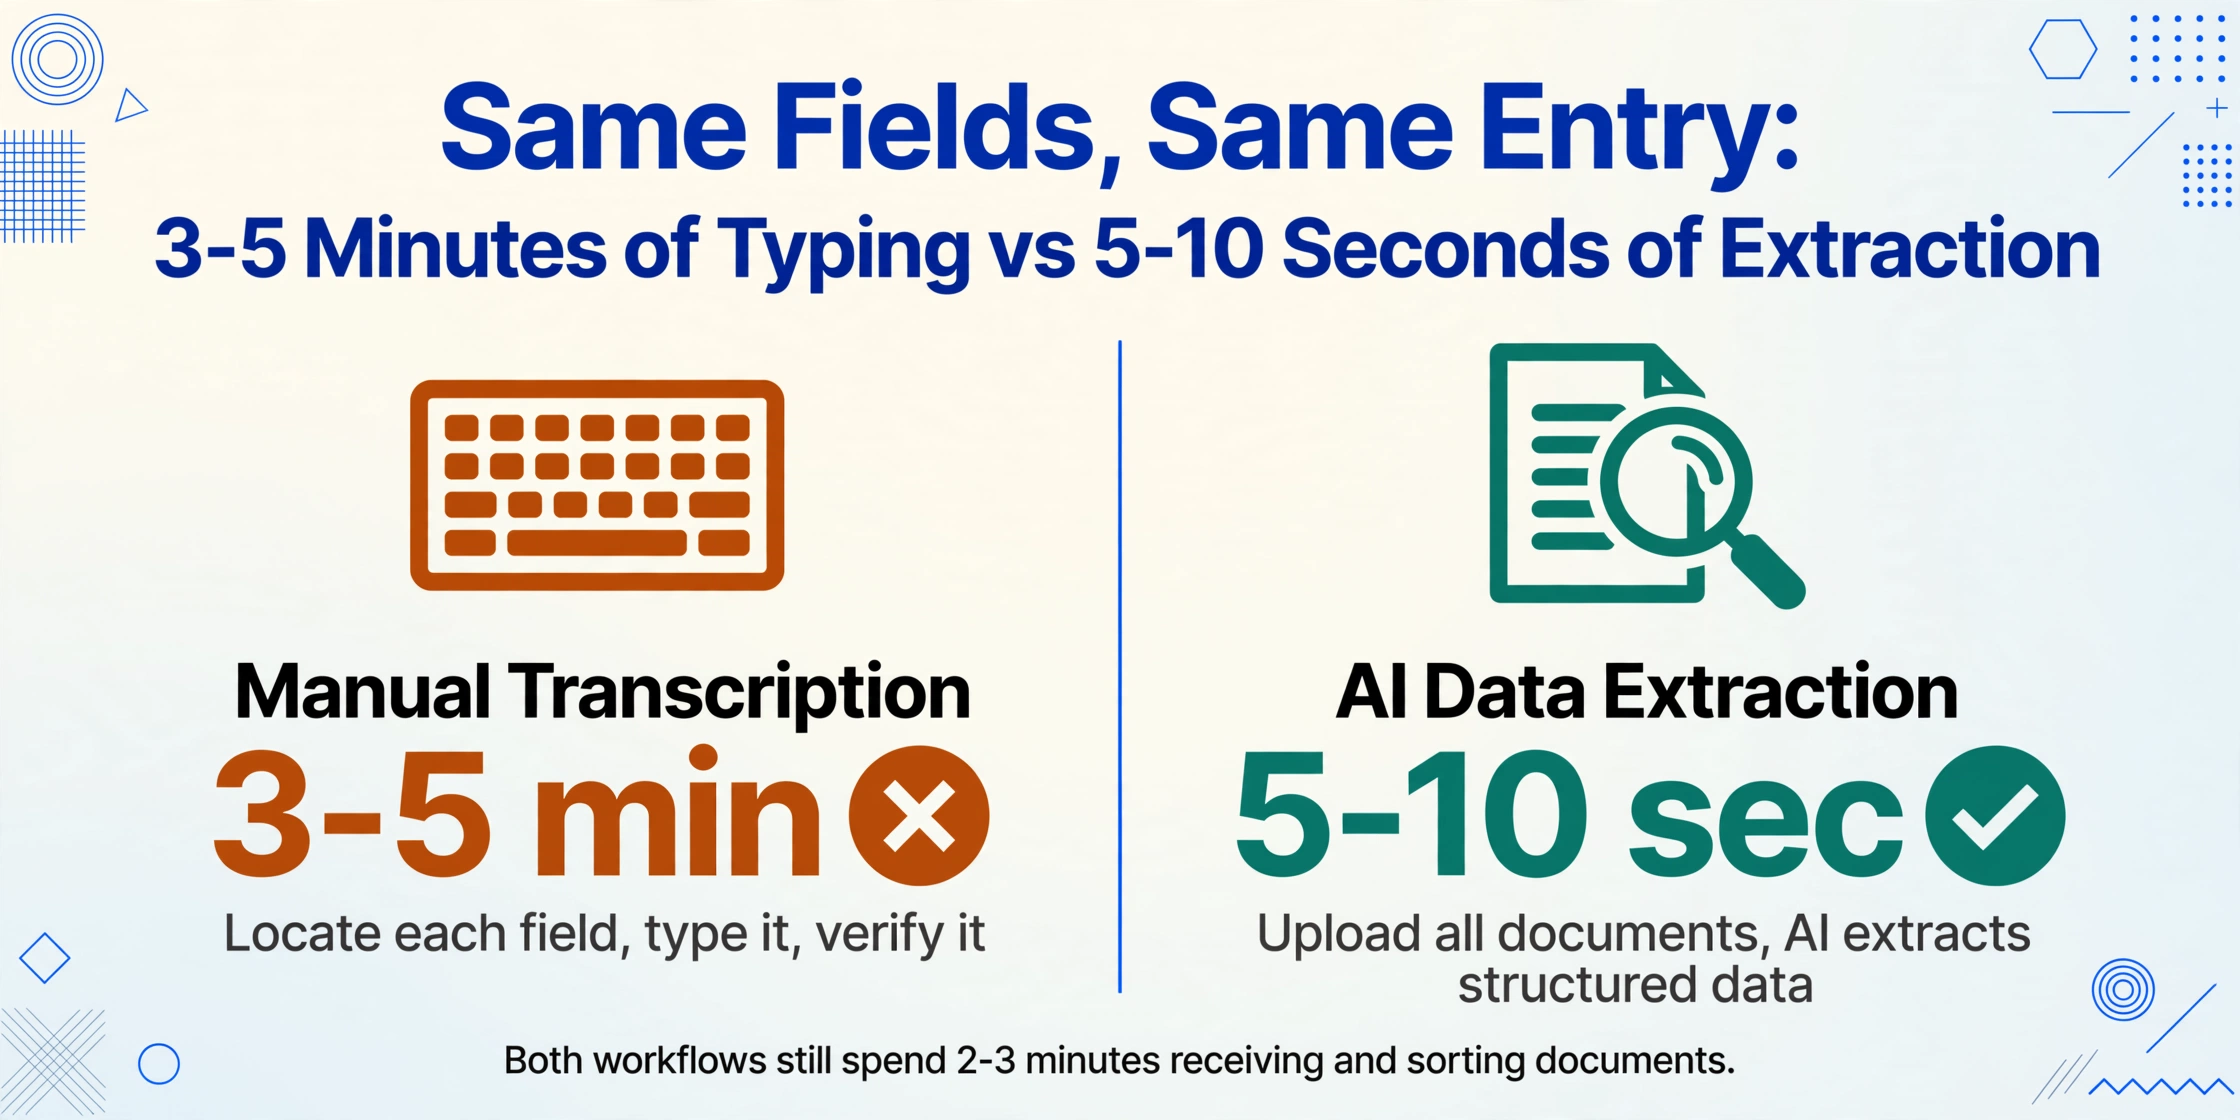
抽出ステップだけでも、1件あたり3〜5分から5〜10秒に短縮されます。1日20件の申告であれば、約1〜1.5時間の時間を取り戻せます。これは申告書作成プロセス全体ではなく、機械的な転記作業に限った時間です。分類・提出・コンプライアンスの各ステップは、時間も品質も変わりません。タイピングが速くなっても恩恵がないからです。むしろ、そこに到達した時点で担当者に余裕が生まれることが恩恵です。
このスピードを生み出す仕組みは列名抽出です。各書類を読んで項目ごとに転記する代わりに、「HSコード」「申告価額」「原産国」「荷受人名」など必要なデータ項目を定義すると、AIが意味を理解してページ上のどこからでも各値を特定します。中国の輸出申告書の「商品编码」、CBP 7501の「HS Code」、EUのSADの「Commodity Code」といった項目名は、フォーマット別のテンプレート設定なしで、すべて出力の同じ列にマッピングされます。申告書フォーマット別のこの手法の詳細ガイドは、税関申告書からExcelへのデータ抽出方法をご覧ください。
ファイルは安全に処理され、保存されません。
1ページあたり5〜10秒の処理時間は、手動転記の1ページあたり約3分と比べて、速度の利点が量に比例して直接積み上がります。ただし、これは抽出ステップに限った話です。意思決定を伴うステップのペースは変わりません。税関の専門知識こそが価値であり、ボトルネックではないからです。1日10件を処理するブローカーは約30〜50分を節約できます。50件を処理する場合は2.5〜4時間の節約です。「これで1日の組み立て方が変わる」と実感できる転換点は、1日あたり約20〜25件の申告です。
精度:通関申告エラーの3つのタイプ — 自動化が実際に排除するものはどれか
自動化のマーケティングでは「精度」という言葉が曖昧に使われますが、通関申告エラーはひとつのカテゴリーではありません。これらは3つの異なるタイプに分類され、自動化はそれぞれに異なる形で対応します。自動化がどのエラーを排除し、どのエラーを排除しないかを正確に区別することが、正直な比較とセールストークの違いです。
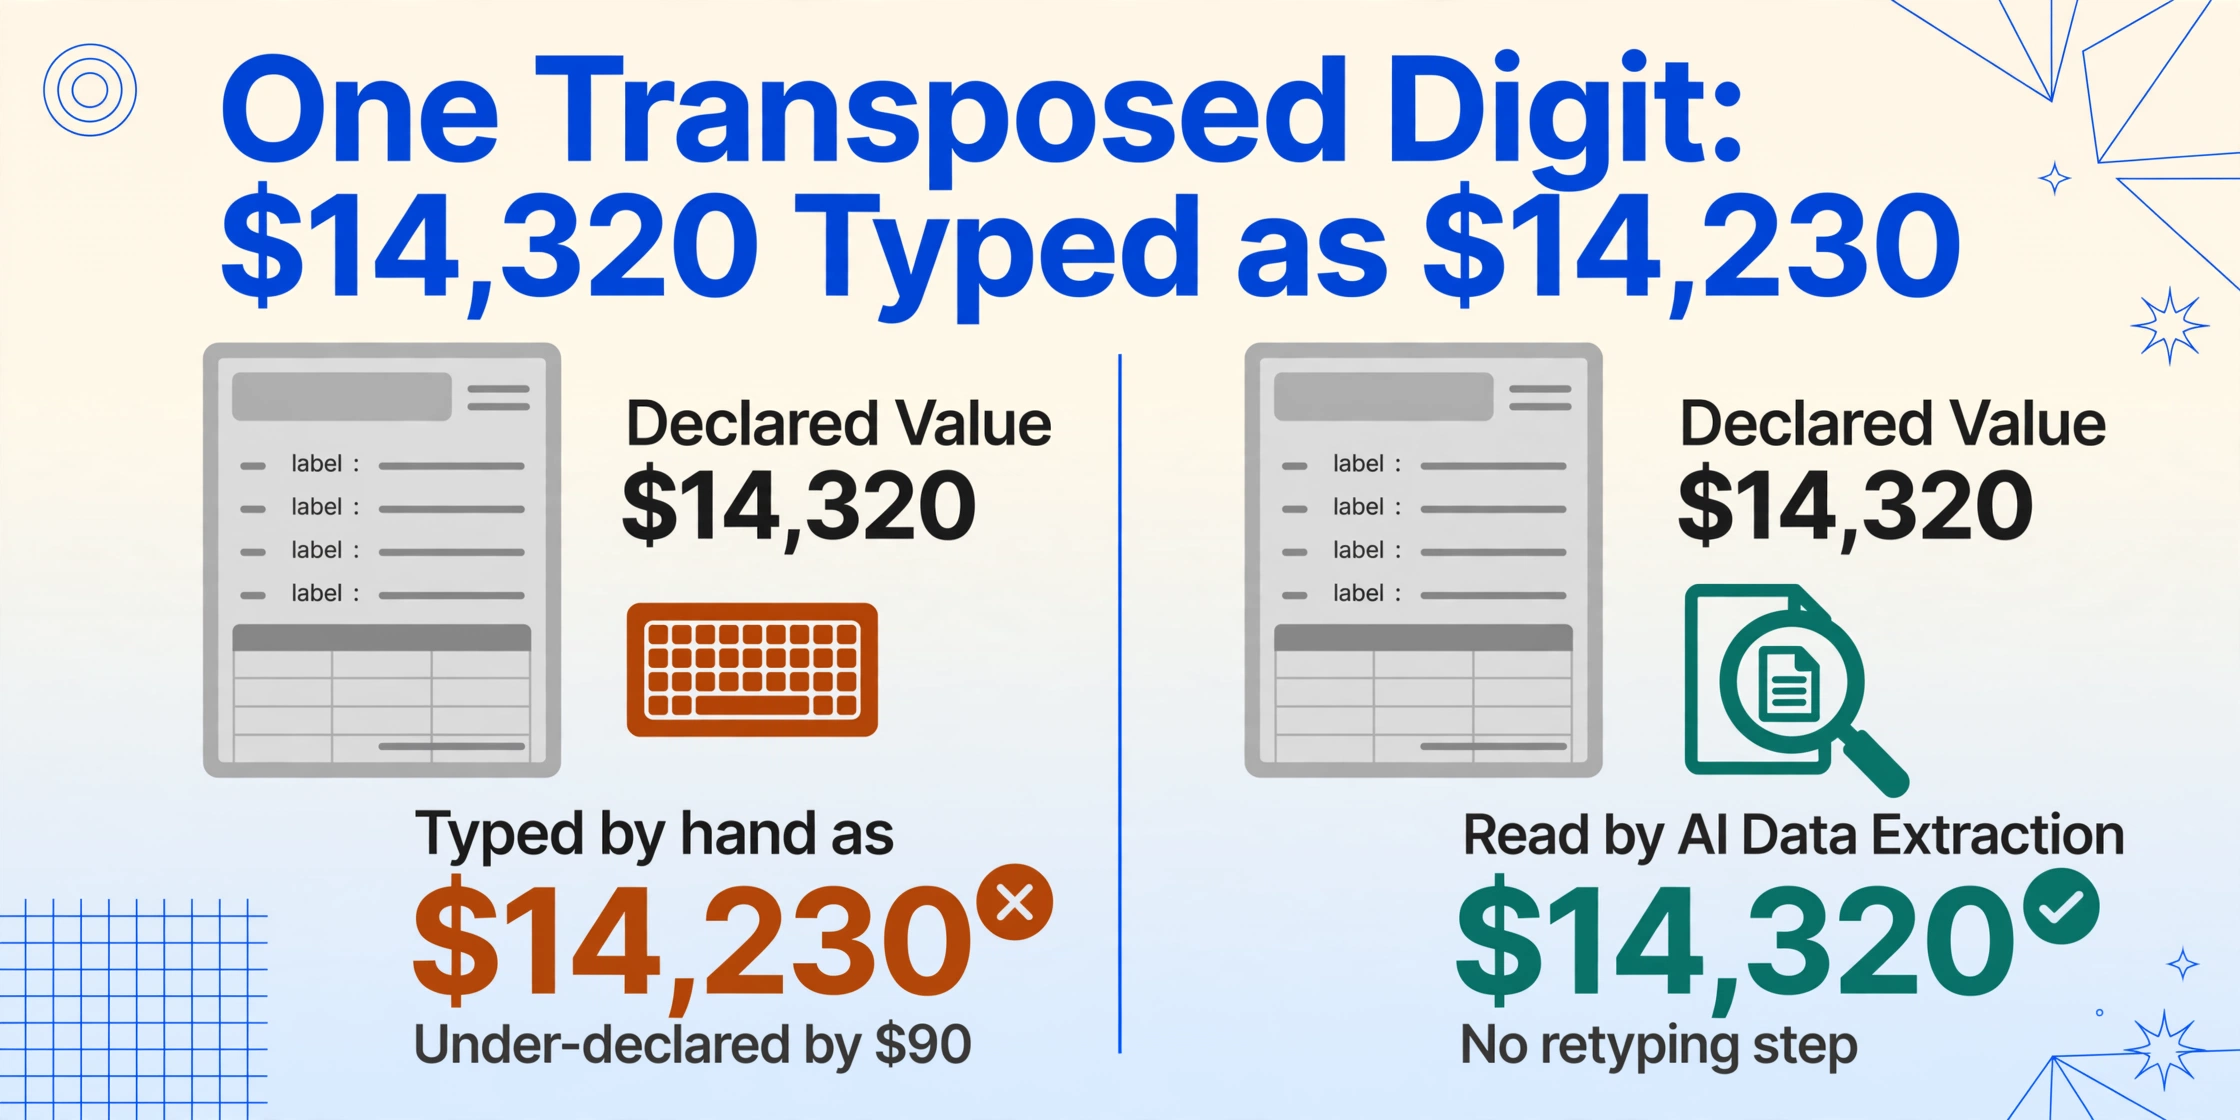
転記エラー。請求書には申告価格が$14,320と記載されています。オペレーターが$14,230と入力します。1桁の転記ミスです。このエラーが申告後も残り、CBPの検証で検出されない場合(価格が妥当な範囲内にある場合に発生します)、輸入者は$90の過少申告となり、同じエラーパターンを持つその後のすべての申告に責任が生じます。数十年にわたるデータ入力研究によると、熟練した人間の転記エラー率は、管理された条件下では0.5〜1%、さまざまな文書形式、時間的プレッシャー、終業時の疲労がある実務条件下では2〜5%です。月に500件の申告を処理する通関業者の場合、1%のエラー率は月に5件の申告に転記ミスが含まれることを意味します。そして、その5件がCBPの重点監査で検出された場合、19 CFR Part 163の記録保存要件に基づき、過去5年間に提出されたすべての申告のレビューが開始される可能性があります。AI抽出は転記エラーを完全に排除します — AIは人間の再入力ステップなしで文書から直接値を読み取ります。AIが正しく読み取れば、値は正しいものになります。文書が低品質のスキャンでAIが誤読する可能性がある場合、オペレーターはすべての申告を手動入力するのではなく、その特定の申告をレビューします。
分類およびコードエラー。オペレーターがタブレットコンピューターだと思ってHTS 8471.30.0100(携帯型自動データ処理機器)を割り当てたが、実際の製品はセルラー機能を備えたデバイスであり、8517.12.0050に分類されるべきだった場合を考えます。これは転記エラーではありません。オペレーターは意図したコードを入力したのです。これは分類の判断エラーであり、金銭的リスクが最も高いエラータイプです。課税輸入品に対するCBPの過失による罰金は、関税損失額の0.5倍から2倍の範囲です。重大な過失の場合は最大4倍、詐欺の場合は最大8倍の失われた関税額となります。非課税品の場合、罰金は詐欺の場合、商品価値の50〜80%に達することがあります。AI抽出は分類エラーを排除しません。AIができることは、不整合をフラグすることです — AIは請求書から貨物の説明を、申告書からHSコードを読み取り、説明に「リチウムイオン電池パック」とありコードが8507.60.0020(リチウムイオン蓄電池)の場合、オペレーターは3つの文書を手動で照合する代わりにクロスチェック信号を受け取ります。しかし、分類の決定自体は依然として人間の判断に委ねられています。
文書間の整合性エラー。商業送り状には1,200ユニットと記載されています。梱包明細書には1,150と記載されています。船荷証券には1,200と記載されています。オペレーターは送り状から1,200を入力し、午後の14件目の入力作業中であるため、梱包明細書を照合しません。入力されたデータは、原本文書間で数量の不一致がある状態で申告されます。そして、CBPの自動ターゲティングシステムが、マニフェストレベルでこの不整合を検出します。これは、フォワーディングの書類に関する調査研究で、出荷の40%に影響を及ぼし、文書間の不一致が最も一般的な書類問題であると判明したエラータイプです。AI抽出は、出荷に関するすべての文書をまとめて処理することでこれを削減します。抽出されたデータテーブルには、送り状、梱包明細書、船荷証券の数量フィールドが並べて表示されます。1,200 / 1,150 / 1,200という行はすぐに目に見えてわかります。オペレーターは3つの別々の文書を開いて、比較することを覚えておく必要はありません。
| エラーの種類 | 手動ワークフロー | AI支援ワークフロー |
|---|---|---|
| 転記(タイプミス、桁の入れ替え) | 発生あり — 条件や疲労度によりフィールドあたり0.5〜5% | 解消 — AIが文書を直接読み取るため、人の再入力ステップが不要 |
| 分類およびHSコード | 発生あり — 機械的なものではなく判断ミス | 解消されない — ただし照合は実施:AIが説明文とコードの不一致を検出し、レビュー用にフラグを立てる |
| 文書間の整合性 | 発生あり — 文書間での順次手動チェックであり、時間的プレッシャーがあると簡単に省略される | 削減 — すべての文書をまとめて処理し、不一致が出力で並べて表示されるためすぐにわかる |
2025年度のCBP貿易統計は、その重要性を具体的に示しています。発行された貿易制裁は2,432件、課せられた液体化損害は53,052件、輸入申告レビューから回収された金額は$34.41 billionです。これらの各調査結果は、税関申告書類の誤ったデータポイントから始まりました。転記ミス、誤分類、データの不整合などです。すべてが手動データ入力によるものではありませんが、そのすべてがデータ品質の失敗でした。月500件の申告における1%のエラー率と、99%以上の抽出精度との差は、月5件のミスと、潜在的にはゼロとの差です。そして、単一のエラーが5年間の遡及レビューを引き起こす可能性がある規制環境では、1件あたりの率ではなく、複合的な影響が重要です。
拡張性:1日20件の申告では、手入力はプロセスではなく採用問題になる
拡張性の観点では、手作業のワークフローの失敗モードは運用上の問題ではなく構造的なものになります。1日5件未満の入力であれば、手動データ入力は問題ありません。速くはありませんが、人を追加で雇うのは不合理です。1日5〜15件の間では、非効率性は目に見えますが管理可能です。オペレーターは毎日1〜2時間を転記に費やしますが、これは苛立たしいものの、ブローカレッジの処理能力を制限するものではありません。
1日20件の入力 — 標準的な勤務時間で働く1人のオペレーターが、純粋にデータ転記だけで2〜3時間を費やす閾値 — に達すると、手作業のワークフローは処理能力の天井になります。クライアントや貿易レーンを追加することは、人員を追加することを意味し、そのコストは給与だけではありません。Savino Del Beneの南アフリカ事業は、現実的な基準を示しています。2,000以上のサプライヤーから年間50,000件以上の商業インボイスを処理するにあたり、同社は時間の80%を手動データ入力に費やしていました。文書処理自動化を導入した後、インボイス処理は11倍高速化し、予測される月間節約額は$100,000を超えました。
これは、規模が拡大した税関ブローカレッジにとって重要な処理能力の算術です:
| 1日の申告件数 | 手動データ入力時間/日 | 必要人員(手動) | 必要人員(AI支援) | 処理能力の上限 |
|---|---|---|---|---|
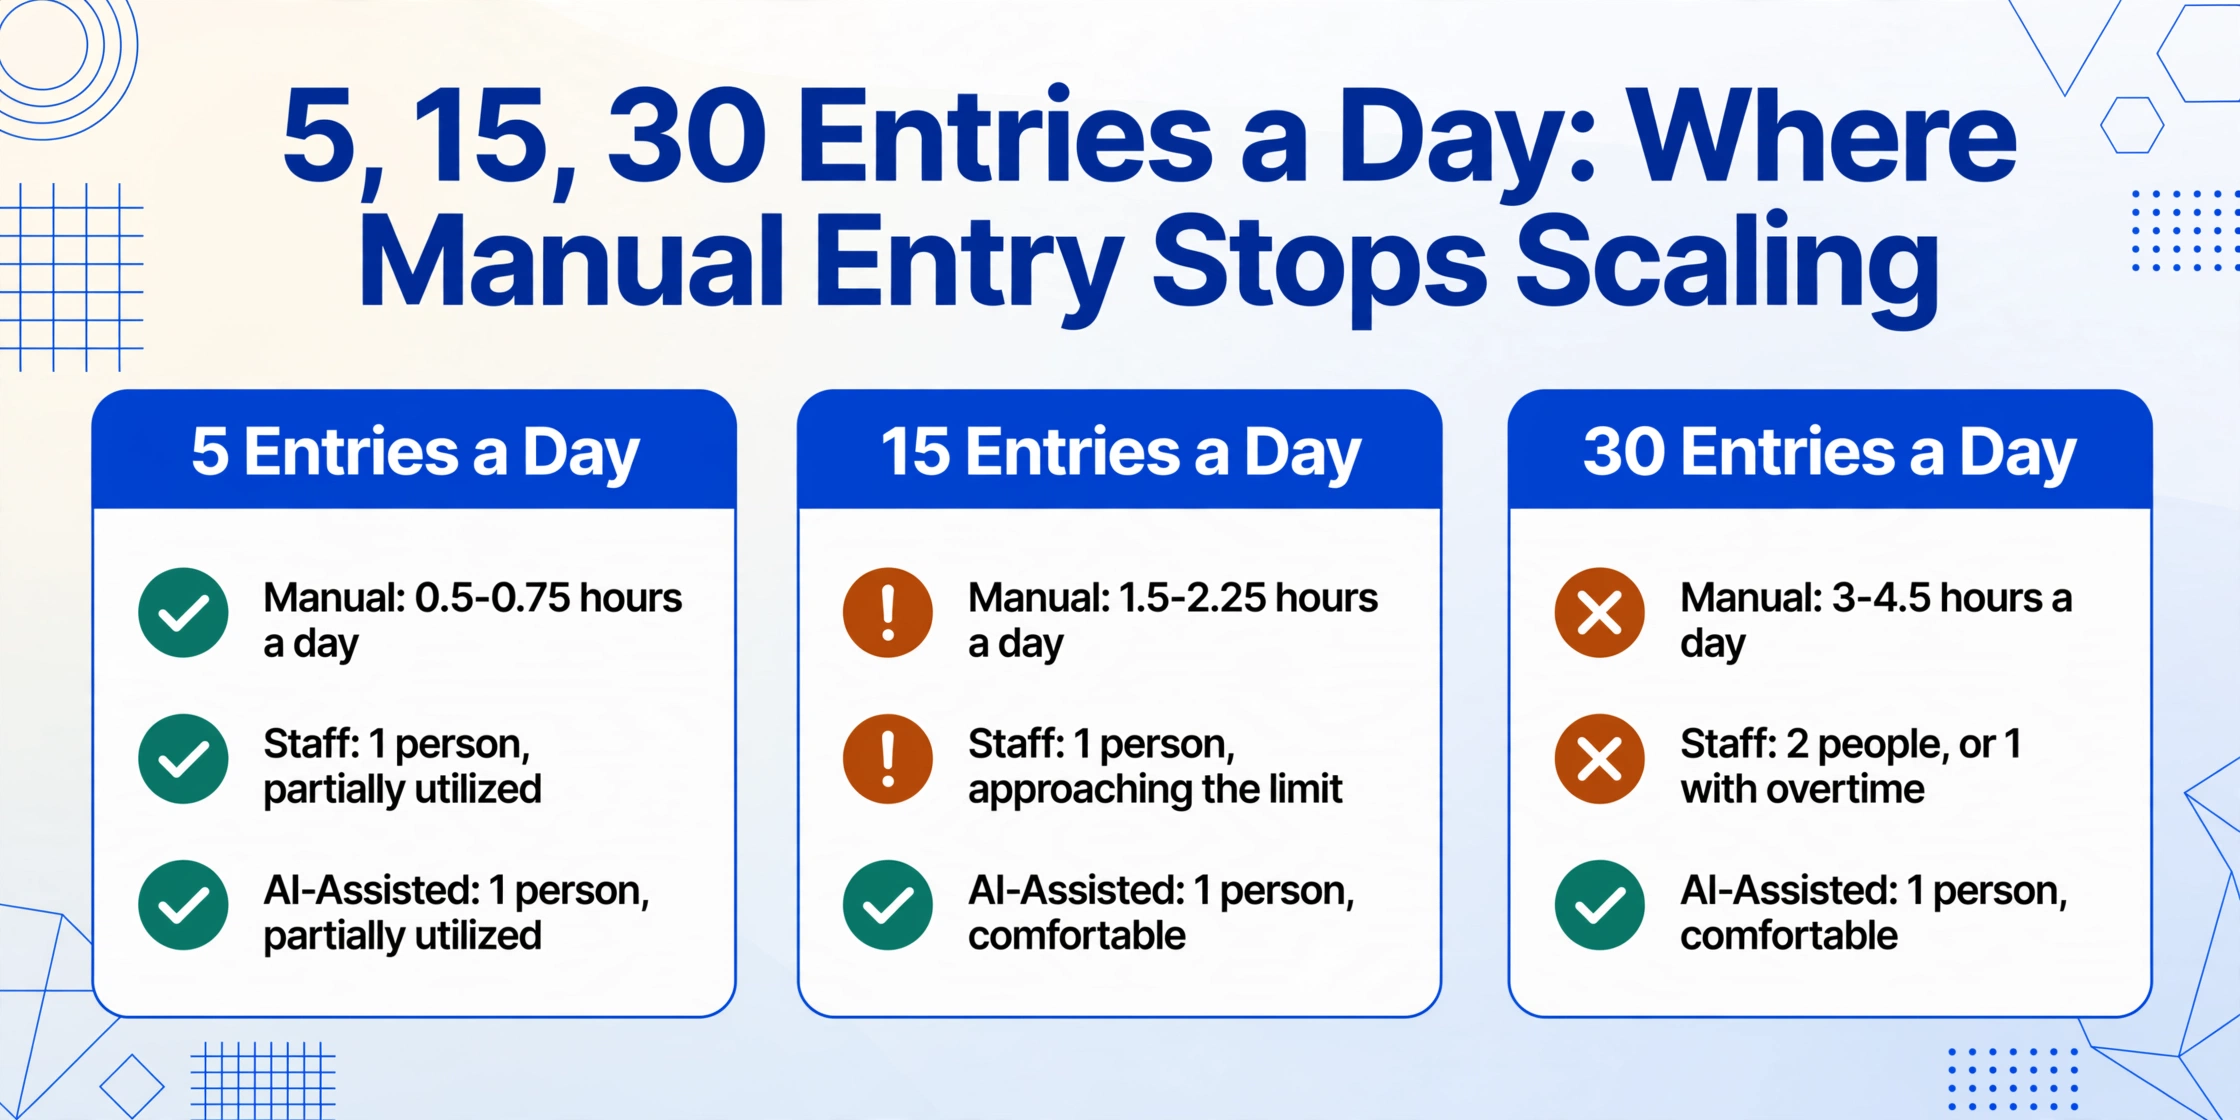
| 5件 | 0.5〜0.75時間 | 1名(一部活用) | 1名(一部活用) | 該当なし |
| 15件 | 1.5〜2.25時間 | 1名(限界に近い) | 1名(余裕あり) | 1人あたり約20〜25件/日 |
| 30件 | 3〜4.5時間 | 2名(または1名で残業) | 1名(余裕あり) | 利用可能な訓練済み労働力の規模 |
| 50件以上 | 5〜7.5時間 | 2〜3名(カバー体制含む) | 1〜2名 | 採用パイプラインが処理能力を制限 |
複数明細の申告を扱う通関業者にとって — 5明細以上の商品ラインがあり、それぞれにHSコード、価額、数量、原産国が必要な貨物 — 申告1件あたりの処理時間は倍増します。手動入力による10明細の申告は、全明細の転記に30〜45分かかることがあります。AI抽出では、10明細すべてが同じ処理サイクルで同じソース文書から読み取られます — ソース文書1ページあたり5〜10秒であり、商品明細ごとではありません。ここで複数明細の通関申告を1つのスプレッドシートにバッチ処理することで計算が変わります:手動転記で25〜37時間かかる50件の複数明細申告が、アップロードとレビューを1回行うだけの数分の作業になります。
Descartes Systemsが400社以上のフォワーダーと通関業者を対象に行った調査では、67%がテクノロジーを成長の基盤または極めて重要と見なしている一方、61%が顧客からの価格圧力を最大の課題として挙げています。その緊張関係は明らかです:通関業者はマージンを維持するために取扱量を増やす必要がありますが、1日20件で機能する手動ワークフローは50件では機能せず、訓練された通関専門家の採用は業界で最も頻繁に挙げられる制約の1つです。自動化は人材不足を解決しません — 既存スタッフが、新規クライアントごとに比例した人員増を必要とせずに成長に対応できるよう、人員計画の計算を変えるのです。
学習への投資:AI支援による通関データ入力の導入に実際に必要なこと
手動ワークフローの最も強い利点は、テクノロジー導入がゼロで済むことです。商業送り状の読み方とACEポータルの操作方法を知っている新規認定通関士は、初日から申告の準備を始められます。すべての通関士は、どのデータを抽出する必要があるか、どの形式でなければならないか、間違えた場合に何が起こるかをすでに知っています。手動プロセスは遅く、エラーが発生しやすく、取扱量に限界があります — しかし、誰でも利用できます。代替ワークフローは、開始コストがゼロで訓練も不要なプロセスに対して、その価値を証明しなければなりません。
AI支援抽出の学習投資は、1つの新しいパターンに集中しています:各文書を開いて申告ソフトウェアに値を入力する代わりに、貨物の全ソース文書を一度にアップロードし、列名を使用して抽出したい内容を定義します — 「荷送人名」「荷受人住所」「HSコード」「原産国」「申告価額」「正味重量」。AIは、特定のフォーム上の位置ではなく、意味を理解することで各フィールドを読み取ります。一度定義すれば、これらの列セットは保存して再利用できます — 同じ貿易ルートで同じ種類の申告を行う輸入者は、毎回同じ列テンプレートを使用します。申告1件あたりの作業は次のようになります:文書をアップロードし、保存済みテンプレートを選択し、抽出テーブルをエクスポートし、レビューする。
これは、文書形式ごとに個別のテンプレート設定が必要な従来のOCRテンプレートシステムとは根本的に異なります — CBP 7501テンプレート、EU SADテンプレート、中国の輸出申告テンプレート、さらに各サプライヤーのインボイス形式。テンプレート保守の負担が、特に文書形式が予告なく変更される複数国のサプライヤーを扱う通関業者において、初期の世代の通関自動化を失敗させたのです。AI抽出は、既知のフォームレイアウト上の位置ではなく意味を読み取るため、この問題を回避します。
比較のために言うと、通関業者とクライアントのERPシステムを接続するEDI導入は、マッピング、テスト、認定に数か月かかることがあり、しかもその1社のクライアントにしか対応できません。完全な通関管理プラットフォームの導入には数週間かかり、IT部門の関与が必要で、すべての貿易データが同じシステムを通過することが前提となります。AI支援による抽出の学習曲線は、書類をアップロードして列名を入力するのにかかる時間で測れます。1日20件の申告であれば、新しいパターンを学ぶための時間投資(数件のサンプル申告で試すのに約15〜30分)は、使用初日で回収できます。
通関申告用に作成した列定義は、商業送り状、パッキングリスト、原産地証明書など他の貿易書類にも使用できます。抽出エンジンは書類の種類を区別しないためです。通関書類からHSコードと申告価格を抽出する保存済みテンプレートは、商業送り状に適用すれば、同じテンプレートで請求書番号と合計金額も抽出します。この書類横断的な再利用性により、テンプレートライブラリは書類フォーマットの数ではなく、使用とともに成長していきます。
手作業が依然として優位なケース — 埋められないギャップ
次元比較は、両方の側面について正直であってこそ有用です。手作業のワークフローには、AI支援による抽出が排除できない真の利点があり、それを認めることで比較全体に重みが生まれます:
- 限界費用ゼロ。 手作業での入力には、訓練を受けた担当者と申告ソフトウェアへのアクセスが必要ですが、どちらも通関業者はすでに保有しています。1日5件未満の申告を処理する業務では、自動化による時間節約はツールコストを回収できません。そのボリューム以下では、手作業のワークフローが経済的に合理的な選択です。
- 書類には存在しない文脈的判断。 経験豊富な通関士が商業送り状を読めば、記載された商品に対して申告価格が不自然に低いことに気づくかもしれません。これは移転価格のレッドフラグですが、AI抽出はページに書かれているものだけを読み、欠けているものは読まないため、警告しません。この組織的知識(「このサプライヤーは送り状の電子機器を一貫して過少評価しており、CBPで指摘を受ける」)は、書類ではなく通関士の頭の中にあり、手作業でのレビュー中に表面化しますが、自動抽出では再現されません。
- 複数当事者間のコミュニケーション。 通関申告がCBPの情報提供要請(CBPフォーム28)や措置通知(CBPフォーム29)を引き起こした場合、対応には輸入者、サプライヤー、場合によっては貿易弁護士とのコミュニケーションが必要です。このワークフローは本質的に人間の作業であり、抽出ツールが自動化できるものではなく、試みるべきでもありません。ここでの価値は、照会に先立つデータ入力ステップではなく、通関士の関係管理と規制コミュニケーションのスキルです。
- 政府申告インターフェースとの統合。 AI抽出は構造化データのテーブルを生成します。そのデータをACE、CDS、ATLASに入力するには、申告システムへの手動再入力か、ソフトウェア統合レイヤーが必要です。一部の通関管理プラットフォーム(Descartes、AEB、iCustoms)は構造化データを直接受け入れるAPI接続を提供していますが、スタンドアロンまたはレガシー申告システムを使用する通関業者では、抽出したデータテーブルから申告ソフトウェアへの手動転送ステップが残ります。抽出出力を直接入力ではなく検証ソースとして使用しない限り、その手順は避けられません。
手作業入力が劣る領域は、速度、転記精度、拡張性であり、その劣り方は取扱量に正比例します。これらの要素は複合的に作用します。1日20件の申告で転記に1.5時間を節約できる通関業者は、人員を増やさずにより多くの申告を処理でき、その浮いた時間をデータ入力ではなくコンプライアンス審査に充てられ、さらにCBPのペナルティ発動の最も一般的な原因となるエラー率を低減できます。通関遅延を引き起こす最も一般的な税関データ入力ミス7種は、主に転記ミスと文書間の整合性エラーであり、これらはまさにAI抽出が対応するカテゴリです。
世界税関機構のタイムリリース調査手法(現在は第4版)は、貨物通関における主要なボトルネックは物理的検査でも港の混雑でもなく、書類到着から申告提出までの時間であることを繰り返し指摘しています。世界銀行のTRSパイロットプログラムでは、デジタル事前通関とシングルウィンドウ連携を導入した国々で、国境自動化により平均通関日数が3.6日から1日未満に短縮されました。申告準備段階(手作業によるデータ入力が行われる部分)は、エンドツーエンドの通関プロセスにおいて時間短縮の最大の機会です。これは営業トークではありません。WCO自身の測定手法が一貫して示している結果です。
手動とAIによる税関データ入力に関するよくある質問
通関業者はどの程度の申告量から手動からAI支援のデータ入力に移行すべきですか?
1日あたり10〜15件程度が目安です。それ以下の場合、自動化による時間節約効果が学習への初期投資を十分に回収できず、切り替えの正当性が薄くなります。特に、馴染みのある書式の文書を扱う安定した顧客基盤を持ち、反復によってオペレーターの速度が向上する通関業者ではその傾向が顕著です。1日20件以上になると、手動ワークフローでは2〜3時間の転記時間が消費され、これを回収できるようになります。また、その工程を自動化するコストは、同じ量を処理するために追加スタッフを雇うコストよりも低くなります。損益分岐点は、1時間あたりの人件費と1日あたりの申告量によって異なりますが、ほとんどの通関業者では1日10〜20件の間に位置します。
AI抽出は通関申告におけるEDIとどう違うのですか?
EDI(電子データ交換)は、同じ形式を理解しているシステム間で構造化データを機械同士で交換する仕組みです。例えば、クライアントのERPシステムが発注データを事前に合意されたデータ形式で通関業者の申告システムに直接送信するケースが挙げられます。EDIは、双方が統合に投資し、互換性のあるデータ構造を維持している場合に機能します。一方、AI抽出は、EDIを導入する予定のないサプライヤーから届く非構造化文書(PDF、スキャン、画像)を読み取ります。深圳の工場、ムンバイの販売代理店、ベトナムの小規模メーカーなどがメール添付で商業送り状を送ってくるケースです。EDIとAI抽出は、文書サプライチェーンの異なる部分を担っています。EDIは統合システムを持つ大規模クライアント向け、AI抽出は貿易文書の大部分を占める中小サプライヤーや多様な形式への対応向けです。
AI抽出は通関業者を置き換えるものですか?
いいえ。AI抽出が置き換えるのはデータ転記の工程、つまり文書から値を読み取ってソフトウェアに入力する作業です。分類の専門知識、規制知識、貿易プログラムの分析、クライアントへの助言、CBPとのやり取りといった、通関業の実際の専門サービスを構成する部分は置き換えませんし、置き換えることはできません。この比較で論じている自動化は、文書からデータへのパイプラインに作用するものであり、通関業者の判断を代替するものではありません。AI抽出を利用する通関業者は、引き続き商品の分類を行い、自由貿易協定の適用有無を判断し、CBPの照会に対応し、クライアントにコンプライアンス戦略を助言します。違いは、送り状データの転記に費やす時間が減り、ライセンスと専門知識を要する業務に多くの時間を割けるようになることです。
通関申告でAI抽出はどのような文書形式に対応していますか?
PDF(デジタル生成・スキャンの両方)、JPG/PNG画像、WebP、AVIFに対応しています。これにより、ERPで生成されたPDF、スキャンした商業送り状、紙のパッキングリストの写真、サプライヤーポータルのスクリーンショットなど、実際の貿易文書の幅広い形式をカバーします。スキャン文書の手書き文字も読み取り可能ですが、精度はスキャン品質に依存します。クリーンな300 DPIスキャンではほぼ完璧な抽出が可能ですが、手書きのパッキングリストを斜めから撮影した低解像度のスマートフォン写真では、特定の項目について手動での確認が必要になる場合があります。
AI抽出は複数言語の貿易書類を処理できますか?
はい。基盤となるビジュアル言語モデルは、あらゆる言語のテキストを読み取ります。中国の輸出申告書、ドイツの商業送り状、スペインのパッキングリスト、韓国の原産地証明書はすべて同じ方法で処理されます。英語で定義された列名が抽出をガイドし、AIはソース文書の言語に関係なく対応する値を特定します。数値フィールド(金額、重量、数量、HSコード)は言語に依存せずクリーンに抽出されます。アジア、ヨーロッパ、アメリカ大陸にまたがる多レーン貿易を扱う通関業者にとって、これは従来データ入力にバイリンガルスタッフを必要としていた言語固有の摩擦を排除します。
抽出列の定義はエントリーやクライアント間で再利用できますか?
はい。標準的な輸入エントリーの列セット(輸入者記録、荷受人、原産国、HSコード、商品説明、数量、単位、申告価格、通貨、関税率、総重量、船荷証券番号)は一度定義してアカウントに保存すれば、以降のすべてのエントリーにワンクリックで適用できます。異なるエントリータイプ(正式消費エントリー、非公式エントリー、一時輸入保税)を扱う通関業者の場合、エントリータイプごとに複数の列テンプレートを保存できます。テンプレートライブラリは、遭遇する文書形式の数ではなく、使用とともに成長します。
AI抽出はHSコードを自動的に割り当てますか?
一部の専門的な税関AIプラットフォーム(Digicust、iCustoms)は、別機能としてHSコード提案と分類支援を提供しています。ImageToTable.aiの抽出は、文書にHSコードがすでに印刷されている場合にそれを読み取ります。例えば、サプライヤーが商業送り状にHTSコードを含めている場合などです。コード化されていない製品を分類したり、印刷された関税分類のない品目にHSコードを提案したりすることはありません。分類ステップは、通関業者の専門知識、解釈の一般規則、CBPの裁定データベースに基づく人間の判断のままです。AI支援による分類が必要な場合は、抽出と分類を組み合わせた税関特化型プラットフォームを探してください。HSコードがすでに存在するが一貫性のない形式に埋もれている文書からの抽出が必要な場合は、このツールが直接処理します。
抽出したデータはCBPのACEシステムと直接連携しますか?
いいえ — ここは重要な違いです。抽出処理は構造化データをExcel、CSV、またはJSON形式で生成します。そのデータをACEポータル、CDS、またはATLASに取り込むには、手動での再入力かソフトウェア統合レイヤーが必要です。API接続に対応した通関管理プラットフォーム(Descartes、AEB、WiseTechのCargoWise)を利用する通関業者は、構造化データを直接インポートできる場合があります。ACEセキュアデータポータルに直接申告する通関業者は、抽出したデータをポータルに手動で転記するか、データインポート機能を持つ通関管理システムを使用する必要があります。抽出処理が不要にするのは、元文書から構造化データへのステップです。申告システムへの構造化データ転送のステップは、申告ソフトウェアが対応していない限り残ります。
通関業は、1つの誤ったHTSコードの分類が5年間の遡及監査を引き起こす可能性がある、ハイステークスの職業です。この比較が答えようとしている問いは、AIが手動入力を時代遅れにするかどうかではありません。それはしませんし、1日10件未満の申告を扱う通関業者にとって、手動入力は依然として合理的な既定値です。問題は、どの数量で経済性が逆転するかです。1日20件の申告では、手動ワークフローが2〜3時間の転記時間を消費しており、それを取り戻すことができます。50件では、フルタイムの給与に相当するタイピング作業を消費しています。抽出技術はすでに存在します。WCO、FIATA、各国の税関当局はすべて、デジタル化された貿易書類へと移行しています。各通関業者の決定は、書類読み取りのステップを通関専門知識のステップから分離し、機械がより上手くできる作業に有資格の専門家を割くのをやめる時期についてです。それは「いつ」であり、「するかどうか」ではありません。
関連: 通関申告書からExcelへデータを抽出する方法 · 複数国の通関申告書を1つのスプレッドシートにバッチ処理する方法 · 通関遅延を引き起こす7つの通関データ入力ミス