Saisie manuelle ou IA des données douanières :
Laquelle survit à 20 saisies par jour ?
Au cours de l'exercice fiscal 2025, U.S. Customs and Border Protection a traité 50 millions de déclarations récapitulatives, émis 2 432 sanctions commerciales et recouvré 34,41 milliards de dollars grâce aux examens de déclarations récapitulatives. Chacune de ces déclarations a commencé par des données extraites d'une facture commerciale, d'une liste de colisage ou d'un connaissement, puis transcrites dans une déclaration — une étape encore majoritairement manuelle dans la plupart des courtiers en douane. Cette comparaison mesure le coût réel de cette étape en temps, en erreurs et en débit, et détermine à partir de quel volume le flux de travail manuel cesse d'être gérable.
Points clés à retenir
- De 60 à 70 pour cent du temps de préparation de chaque déclaration douanière est consacré non pas à la classification ou à la conformité — le travail pour lequel la licence d'un courtier a été obtenue — mais à la lecture des valeurs sur les factures des fournisseurs et à leur ressaisie manuelle.
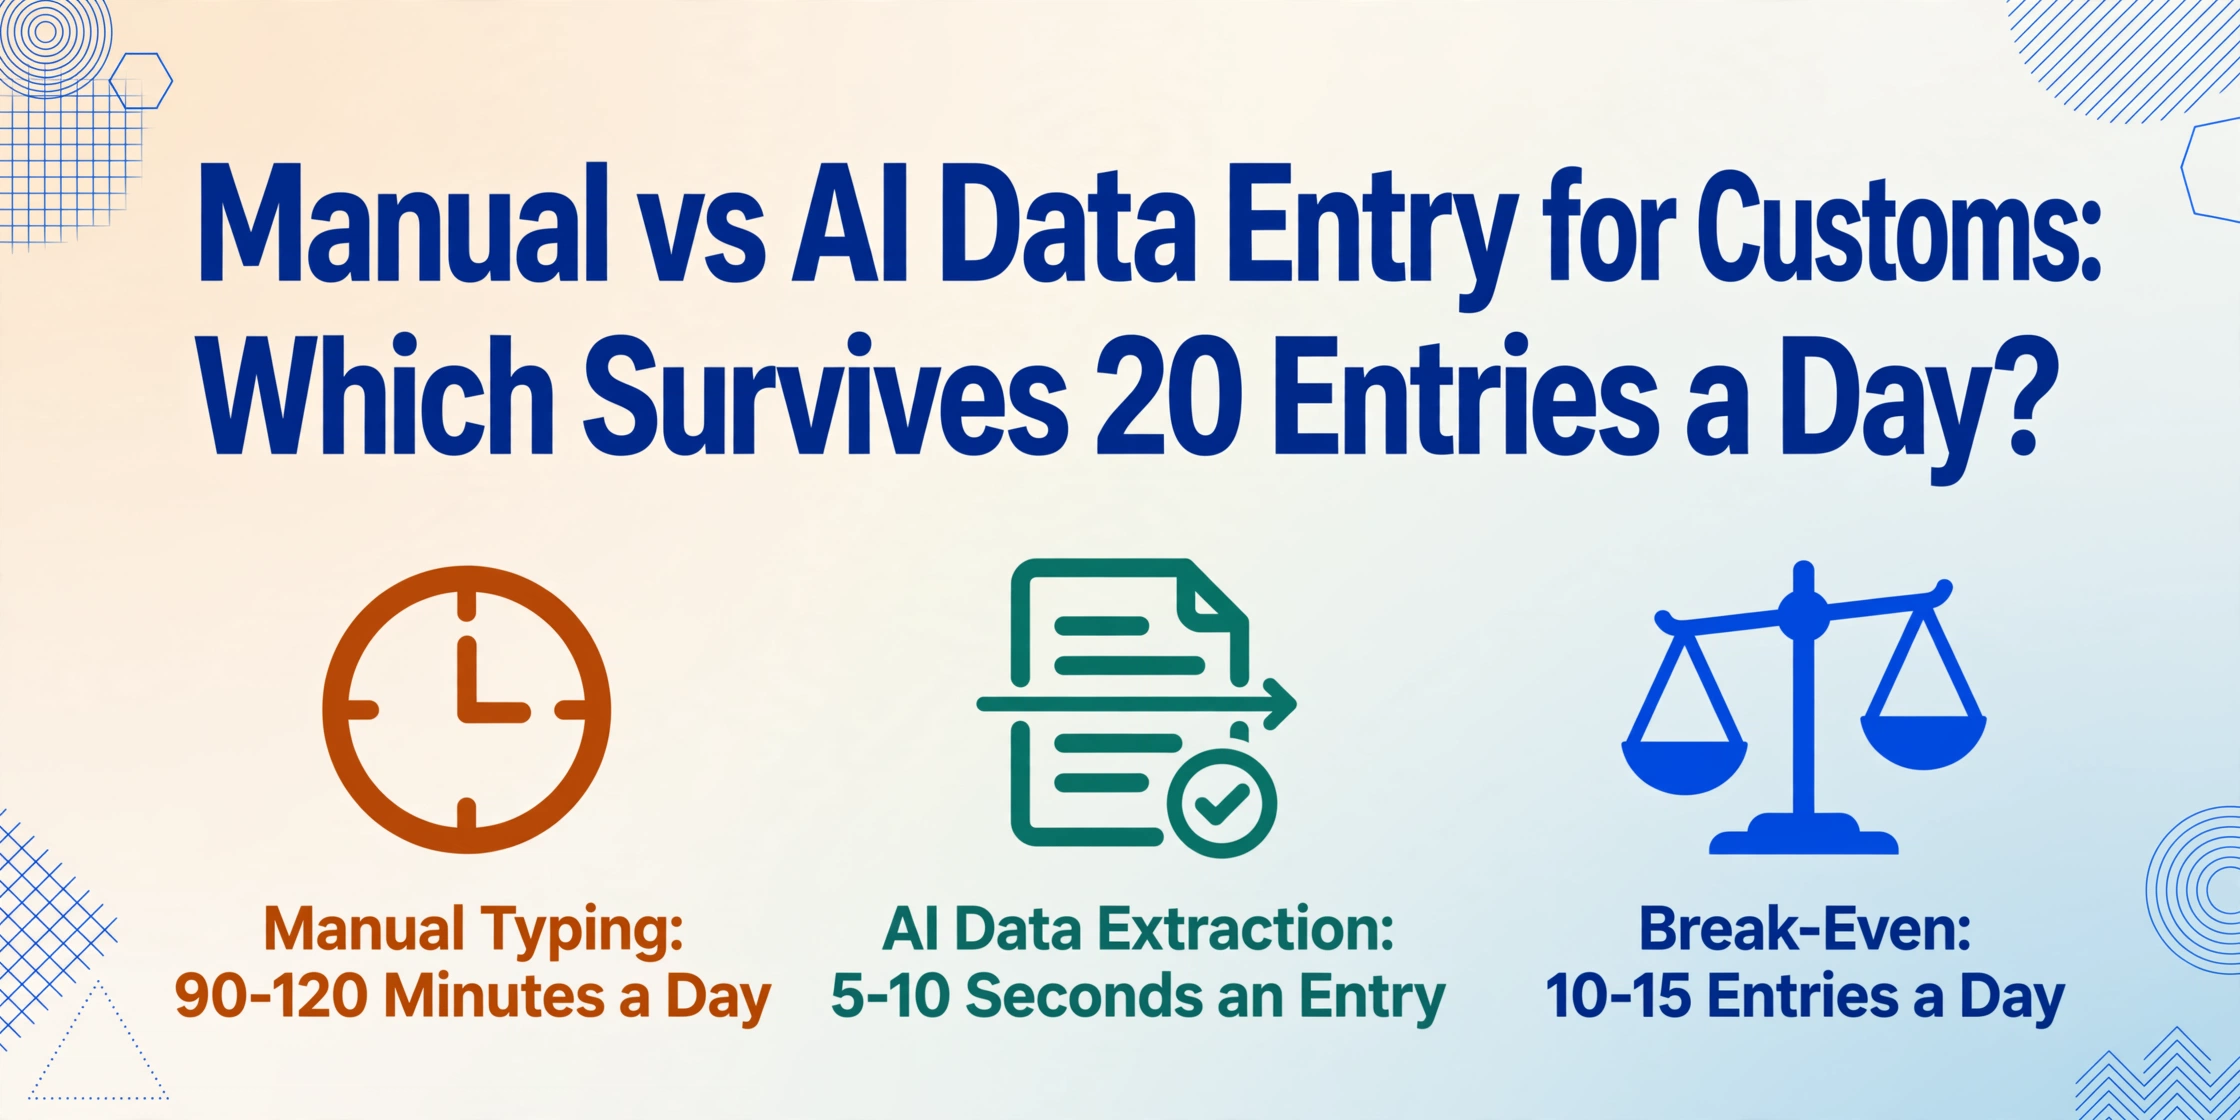
- À raison de 20 saisies par jour, l'étape de transcription manuelle consomme de 7,5 à 10 heures par semaine — une journée complète de travail — et chaque heure de saisie risque une erreur de chiffre pouvant déclencher un audit douanier remontant jusqu'à cinq ans en arrière.
- En dessous de 10 saisies par jour, la saisie manuelle est économiquement rationnelle, mais au-delà de 20, les chiffres s'inversent — embaucher pour suivre le rythme coûte plus cher que de supprimer l'étape de transcription, et ImageToTable.ai extrait chaque champ de chaque document en moins de 10 secondes par page.
Ce qui se passe réellement lors de la préparation manuelle d'une déclaration en douane
Le processus de dépôt de déclaration en douane — la soumission formelle des données au système ACE de CBP, au CDS de HMRC, aux autorités douanières des États membres de l'UE — est déjà numérique. Ce qui n'est pas numérique, dans la majorité des courtiers, c'est l'étape précédant le dépôt : extraire les données commerciales des documents sources et les saisir dans le logiciel de déclaration. C'est cet écart que la plupart des discussions sur l'automatisation ignorent. Les connexions EDI et API gèrent le transfert machine à machine entre des systèmes qui contiennent déjà des données structurées. Elles ne lisent pas une liste de colisage scannée provenant d'une usine de Shenzhen.
Le flux de travail manuel pour préparer une seule entrée en douane se décompose en cinq étapes :
Réceptionner et trier les documents sources
Facture commerciale, liste de colisage, connaissement ou lettre de transport aérien, certificat d'origine — une seule expédition peut générer plus de 10 documents provenant de différentes parties, dans différents formats, arrivant par différents canaux (e-mail, lecteur partagé, téléchargement depuis un portail). Une étude menée auprès de transitaires a révélé que 40 % des retards douaniers provenaient de divergences entre ces documents, avant même le début de la préparation de la déclaration.
Localiser et saisir les champs de données dans le logiciel de déclaration
L'opérateur lit la facture commerciale, trouve le nom de l'expéditeur, l'adresse du destinataire, la description de la marchandise, la quantité, le poids, la valeur déclarée, la devise, les Incoterms, le pays d'origine et le code HS — puis les saisit dans les champs correspondants du système de déclaration. Le formulaire CBP 7501 à lui seul comporte 47 blocs de données. Pour une déclaration multi-lignes avec 5 lignes de marchandises, l'opérateur gère environ 35 à 50 points de données distincts par déclaration, en alternant entre les fenêtres pour chacun d'eux.
Recouper les données entre les documents pour vérifier la cohérence
La quantité sur la facture doit correspondre à la liste de colisage. La valeur déclarée doit être cohérente avec le total de la facture commerciale. Le code HS doit correspondre à la description de la marchandise. Ces vérifications sont manuelles et séquentielles — l'opérateur lit le document A, lit le document B, compare mentalement. À 16 h un vendredi avec 8 déclarations encore en attente, la vérification de cohérence est la première étape à être écourtée ou sautée.
Classer les marchandises et appliquer la logique des programmes commerciaux
L'opérateur détermine le code HS correct, applique les préférences des accords de libre-échange, vérifie l'applicabilité des droits ADD/CVD et confirme les exigences des agences PGA (FDA, USDA, EPA). C'est l'étape où les connaissances douanières comptent le plus — et c'est aussi l'étape où même les courtiers expérimentés commettent des erreurs de classification qui déclenchent des audits du CBP. Un code HTS mal classé peut entraîner un sous-paiement des droits sur des mois de déclarations avant d'être détecté lors d'une évaluation ciblée.
Soumettre la déclaration, gérer les rejets, récupérer le MRN
La déclaration est transmise électroniquement à l'autorité douanière. Si elle passe la validation, le numéro de référence du mouvement (MRN) ou le numéro d'entrée est renvoyé en quelques secondes. En cas d'échec — en raison d'un code HTS non concordant, d'un élément de données PGA manquant ou d'un EORI invalide — le message de rejet revient et l'opérateur commence le dépannage. Une seule entrée rejetée peut prendre autant de temps que trois entrées valides.
Les étapes 2 et 3 — localiser les données sur les documents et les transcrire — consomment généralement 60 à 70 % du temps total de préparation de l'entrée. Les étapes 4 et 5, qui exigent une expertise et un jugement en matière de douane, représentent les 30 à 40 % restants. C'est ce ratio qui rend la comparaison manuel vs automatisé pertinente : les étapes les plus chronophages sont les étapes mécaniques, pas celles qui exigent une expertise. Les recherches de DHL confirment que 80 % des retards douaniers proviennent de documents incorrects ou manquants — et non de retards d'inspection physique ou de congestion portuaire — ce qui signifie que l'étape de traduction document-vers-système est là où se situe le goulot d'étranglement structurel.
Cette inversion de l'effort — où le travail mécanique consomme plus de temps que le travail qualifié — est le schéma qui définit quand les flux de travail manuels échouent. Elle définit également là où l'automatisation aide réellement : non pas en remplaçant l'expertise douanière, mais en supprimant la barrière de transcription qui consomme le temps avant que l'expertise puisse être appliquée. Pour un aperçu plus approfondi des raisons pour lesquelles ce schéma persiste dans l'industrie, consultez notre analyse de les raisons structurelles pour lesquelles la gestion des données douanières reste un goulot d'étranglement dans les opérations de fret.
Vitesse : ce que « 3 minutes par document » signifie réellement sur une semaine de 100 déclarations
Une seule page de données imprimées prend environ 3 minutes à transcrire manuellement — localiser chaque champ, le saisir, le vérifier. C'est la moyenne observée chez les opérateurs de saisie expérimentés dans des conditions de travail normales. Les recherches sur les opérateurs de saisie qualifiés révèlent systématiquement des taux d'erreur entre 0,5 % et 1 %, même dans des conditions contrôlées — et ces taux augmentent au fil de la journée de travail. Le même opérateur qui saisit avec 1 % d'erreurs à 9 h produit plus de 3 % d'erreurs en fin d'après-midi, à mesure que la fatigue cognitive s'installe.
Pour un courtier en douane traitant 20 déclarations par jour — un volume typique pour une petite ou moyenne structure — le calcul est simple : 20 déclarations × 3 minutes d'extraction de données par déclaration = 60 minutes. En pratique, avec le tri des documents, la vérification croisée et la gestion des incohérences de format, le chiffre réel se rapproche de 90 à 120 minutes par jour consacrées uniquement à la transcription des données. Sur une semaine de cinq jours traitant 100 déclarations, cela représente 7,5 à 10 heures — soit essentiellement une journée de travail complète par semaine absorbée par une étape qui n'apporte aucune connaissance douanière et génère la majorité des erreurs.
Voici comment le calendrier par déclaration se décompose pour les deux flux de travail, pour une déclaration standard à ligne unique :
| Tâche | Flux manuel (par déclaration) | Flux assisté par IA (par déclaration) |
|---|---|---|
| Réceptionner et trier les documents | 2-3 minutes | 2-3 minutes (inchangé — les documents arrivent toujours par les canaux existants) |
| Localiser et transcrire les champs de données | 3-5 minutes | 5-10 secondes (téléverser tous les documents, l'IA extrait les données structurées) |
| Vérifier la cohérence des documents | 2-4 minutes | 1-2 minutes (examiner le tableau extrait par l'IA pour les écarts signalés) |
| Classer les marchandises, appliquer les programmes commerciaux | 2-5 minutes | 2-5 minutes (inchangé — nécessite une expertise douanière) |
| Soumettre, gérer les rejets, récupérer le MRN | 1-3 minutes | 1-3 minutes (inchangé — le dépôt électronique est indépendant de la méthode d'extraction) |
| Total par déclaration | 10-20 minutes | 6-13 minutes |
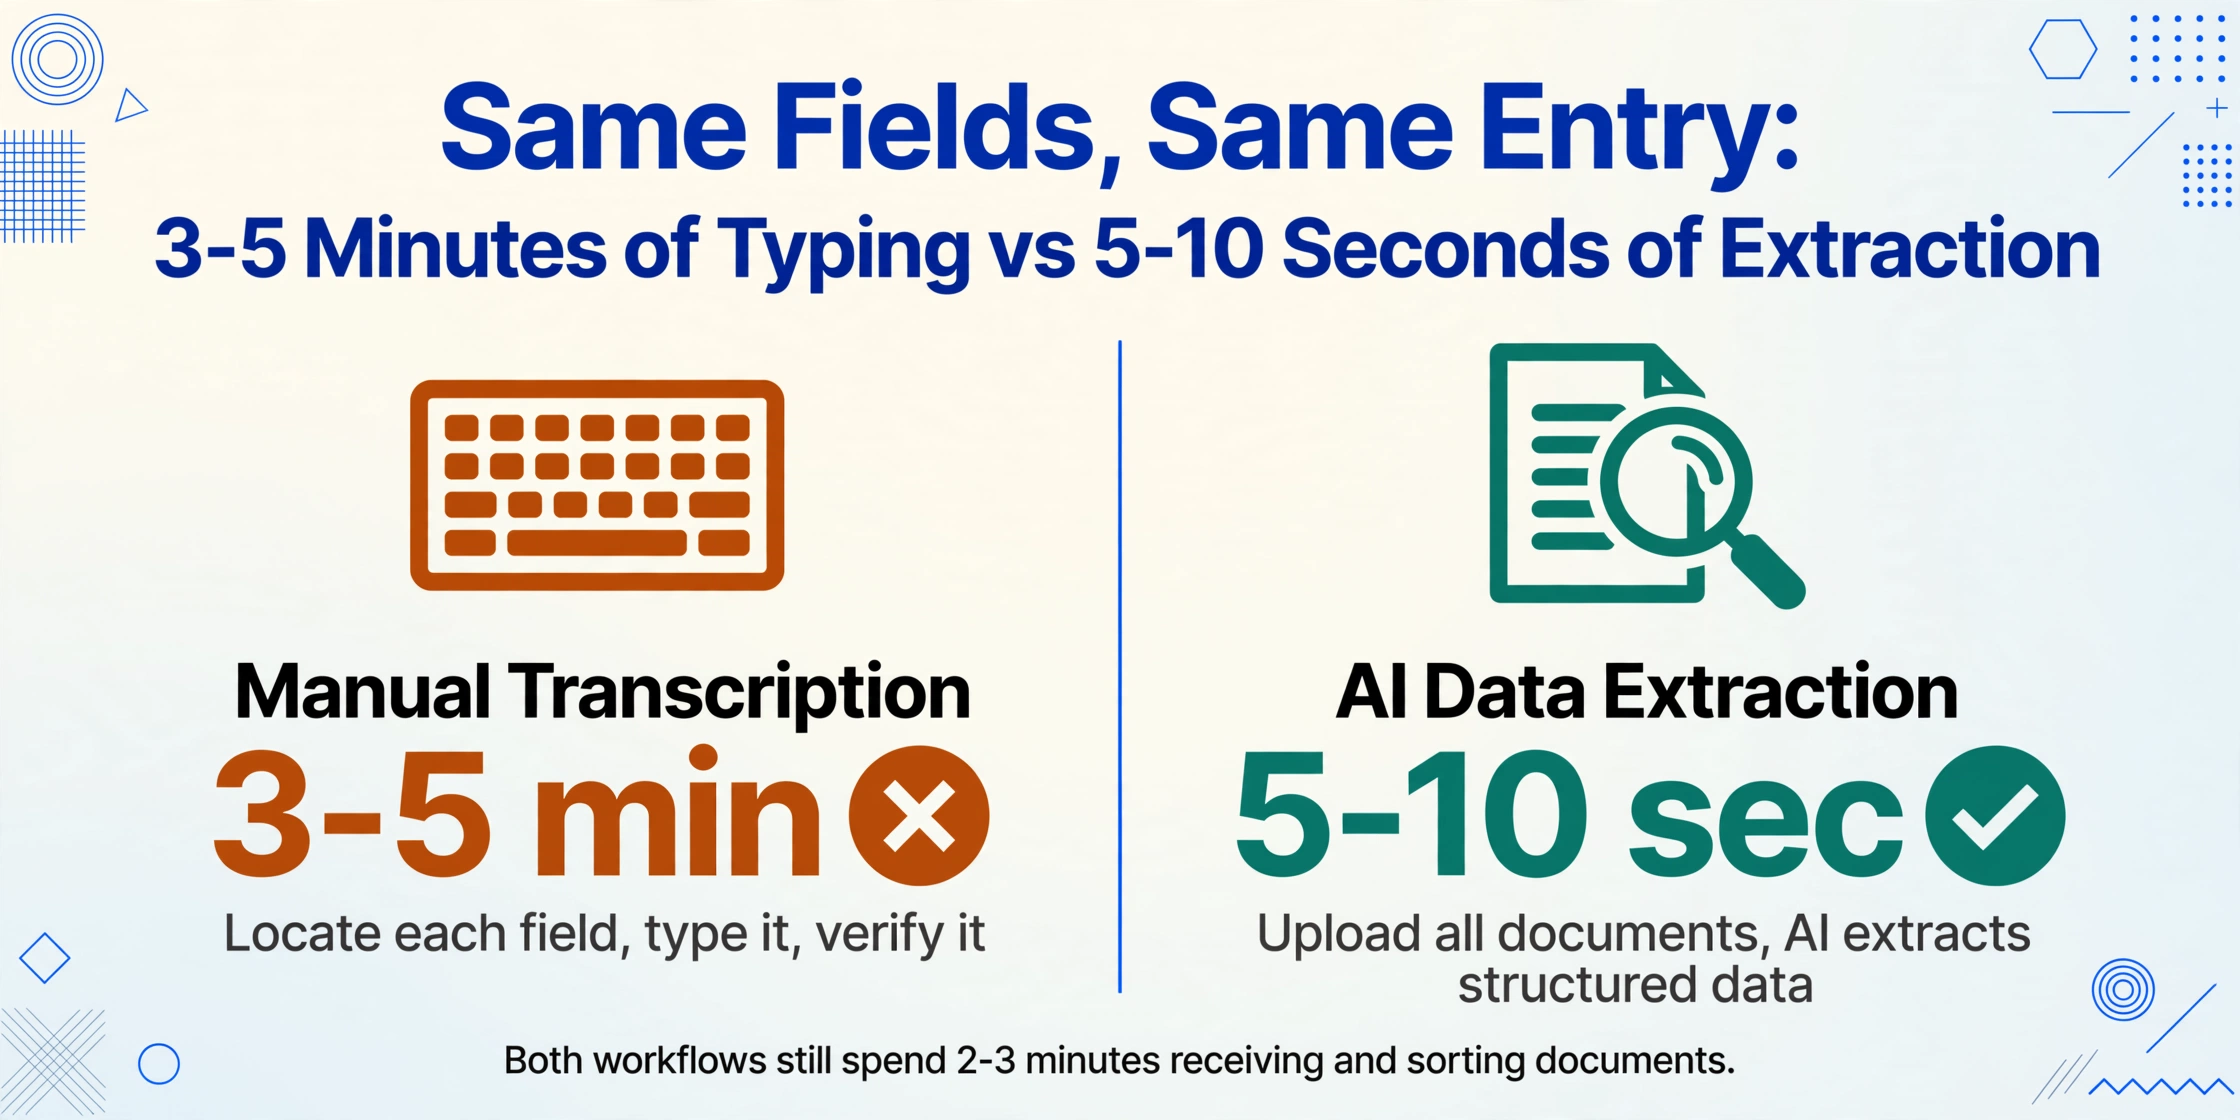
L'étape d'extraction à elle seule passe de 3 à 5 minutes par déclaration à 5 à 10 secondes. À raison de 20 déclarations par jour, cela récupère environ 1 à 1,5 heure — non pas de l'ensemble du processus de préparation des déclarations, mais spécifiquement du travail de transcription mécanique. Les étapes de classification, de dépôt et de conformité restent inchangées en termes de temps et de qualité, car elles ne bénéficient pas d'une saisie plus rapide. Elles bénéficient du fait que l'opérateur dispose d'une plus grande capacité mentale lorsqu'il y arrive.
Le mécanisme qui produit cette vitesse est l'extraction par nom de colonne : au lieu de lire chaque document et de transcrire champ par champ, vous définissez les points de données souhaités — « code HS », « valeur déclarée », « pays d'origine », « nom du destinataire » — et l'IA localise chaque valeur n'importe où sur la page en comprenant sa signification sémantique. Un champ intitulé « 商品编码 » sur une déclaration d'exportation chinoise, « HS Code » sur un formulaire CBP 7501 et « Commodity Code » sur un SAD de l'UE correspondent tous à la même colonne dans votre sortie, sans configuration de modèle par format. Pour un guide détaillé de cette approche sur différents formats de déclaration, voir comment extraire des données de formulaires de déclaration en douane vers Excel.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Le temps de traitement de 5 à 10 secondes par page, comparé aux 3 minutes environ de transcription manuelle par page, signifie que l'avantage de vitesse se cumule directement avec le volume — mais uniquement pour l'étape d'extraction. Les étapes de prise de décision restent au même rythme, car l'expertise en douane est la valeur ajoutée, et non le goulot d'étranglement. Un courtier qui traite 10 déclarations par jour économise environ 30 à 50 minutes. Celui qui en traite 50 économise 2,5 à 4 heures. Le point d'inflexion où les économies de temps franchissent le seuil du « cela change ma façon d'organiser ma journée » se situe autour de 20 à 25 déclarations par jour.
Précision : trois types d'erreurs de déclaration en douane — et lesquelles l'automatisation élimine réellement
Le mot « précision » est utilisé à la légère dans le marketing de l'automatisation, mais les erreurs de déclaration en douane ne forment pas une seule catégorie. Elles se répartissent en trois types distincts, et l'automatisation traite chacun différemment. Savoir précisément lesquelles elle élimine et lesquelles elle n'élimine pas fait la différence entre une comparaison honnête et un argumentaire de vente.
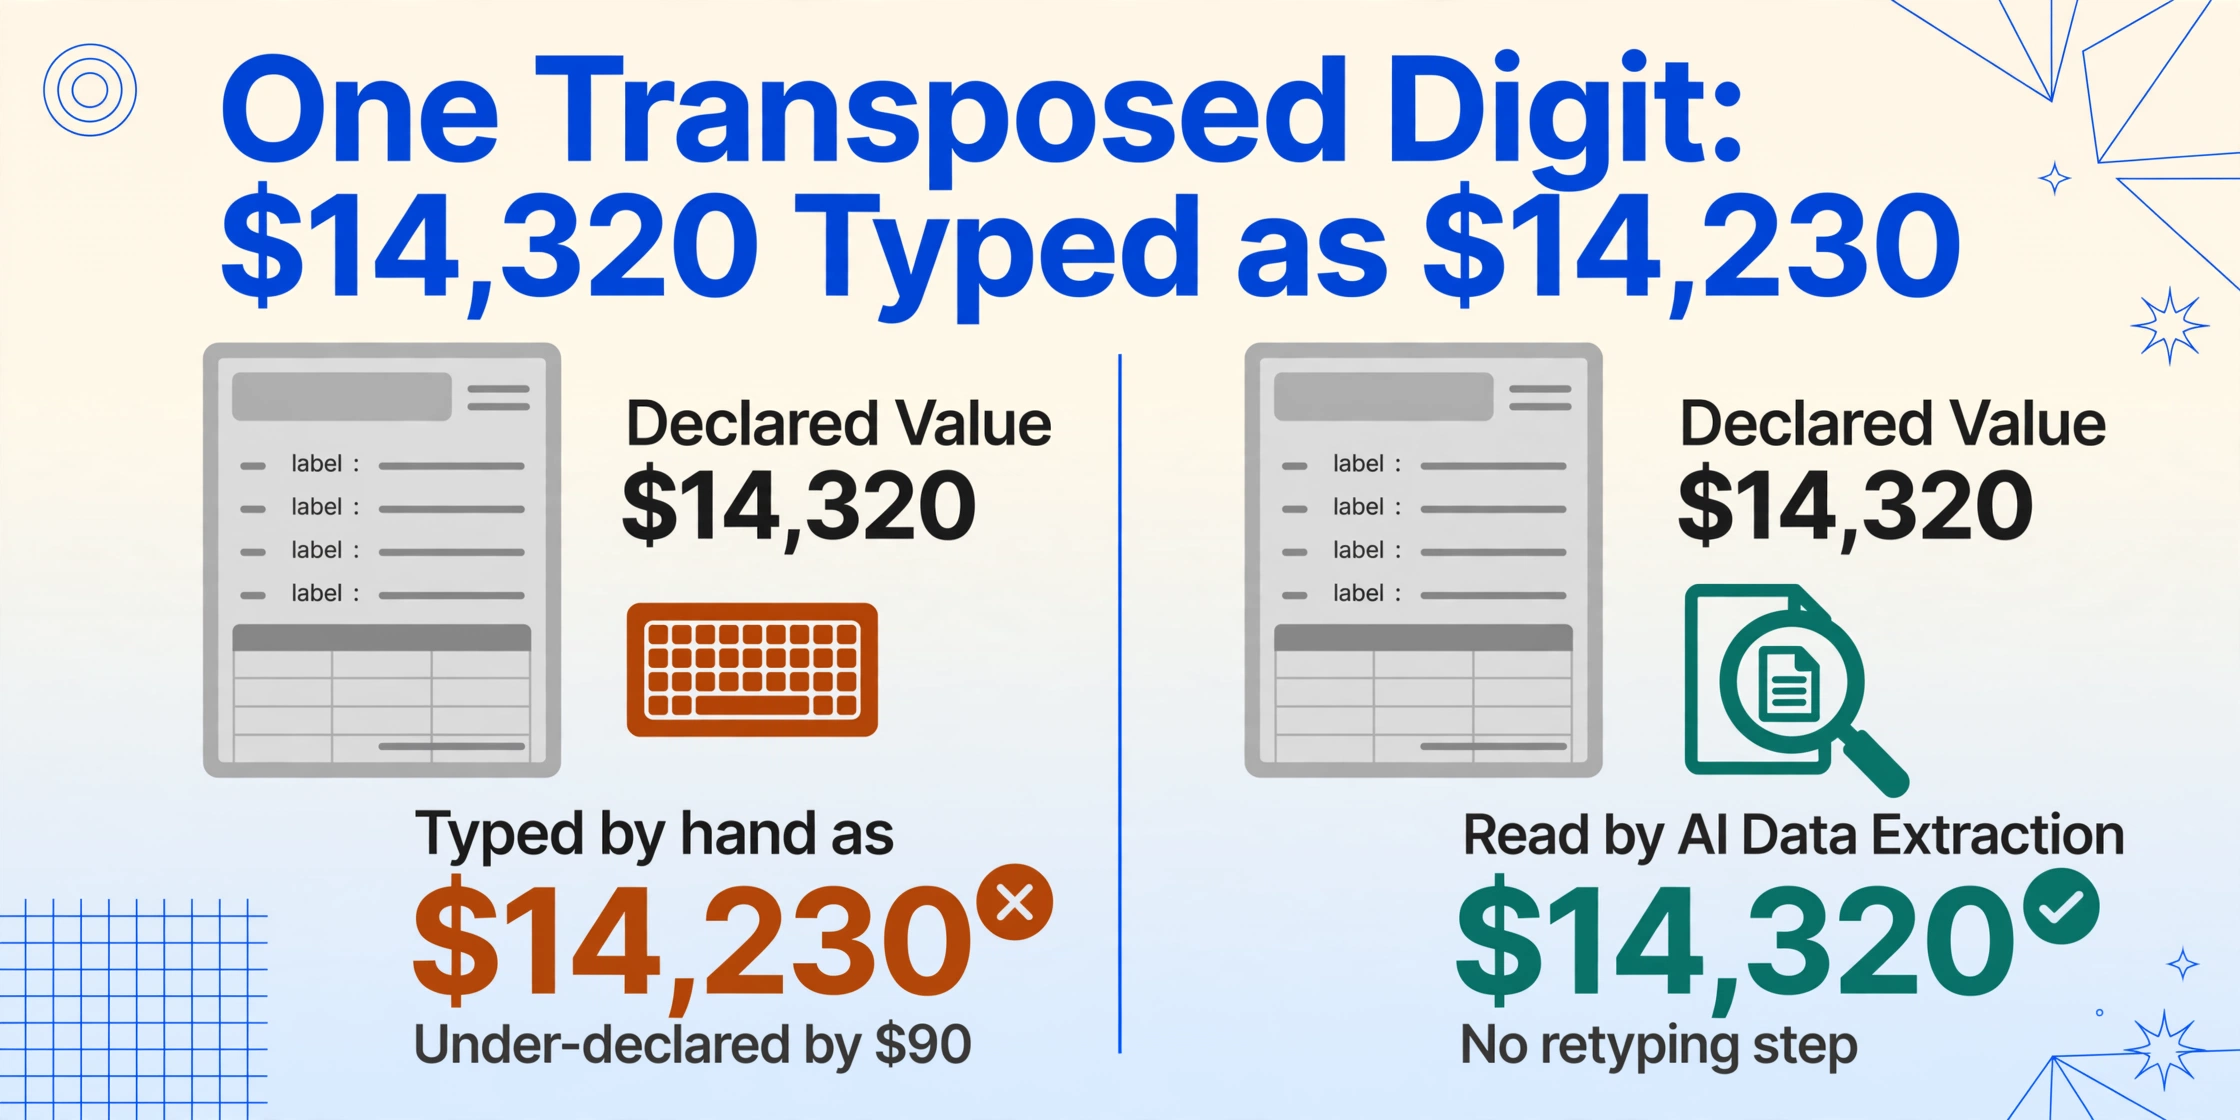
Erreurs de transcription. La facture indique une valeur déclarée de 14 320 $. L'opérateur saisit 14 230 $. Un chiffre transposé. Si cette erreur survit jusqu'au dépôt et que la validation du CBP ne la détecte pas — ce qui se produit lorsque la valeur se situe dans une fourchette plausible — l'importateur a sous-déclaré de 90 $, créant une responsabilité sur chaque déclaration ultérieure présentant le même schéma d'erreur. Les recherches menées sur des décennies d'études sur la saisie de données situent le taux d'erreur de transcription humain qualifié entre 0,5 et 1 % dans des conditions contrôlées, et entre 2 et 5 % dans des conditions réelles avec des formats de documents variés, une pression temporelle et la fatigue de fin de journée. Pour un courtier déposant 500 déclarations par mois, un taux d'erreur de 1 % signifie que 5 déclarations par mois contiennent une erreur de transcription — et ces 5 déclarations, si elles sont détectées lors d'une évaluation ciblée du CBP, peuvent déclencher un examen de chaque déclaration déposée au cours des cinq dernières années en vertu des exigences de tenue de registres du 19 CFR Part 163. L'extraction par IA élimine entièrement les erreurs de transcription — l'IA lit la valeur directement à partir du document sans étape de ressaisie humaine. Si l'IA la lit correctement, la valeur est correcte. Si le document est un scan de faible qualité où l'IA pourrait mal lire, l'opérateur examine cette déclaration spécifique plutôt que de saisir manuellement chaque déclaration.
Erreurs de classification et de code. L'opérateur attribue le code HTS 8471.30.0100 (machines automatiques de traitement de données portatives) à ce qu'il croit être une tablette — mais le produit est en réalité un appareil doté d'une capacité cellulaire qui devrait être classé sous le code 8517.12.0050. Ce n'est pas une erreur de transcription ; l'opérateur a saisi le code qu'il voulait. C'est une erreur de jugement de classification, et c'est le type d'erreur aux enjeux financiers les plus élevés. Les pénalités du CBP pour négligence sur les importations passibles de droits vont de 0,5 à 2 fois la perte de droits ; pour négligence grave, jusqu'à 4 fois ; pour fraude, jusqu'à 8 fois les droits perdus. Sur les articles non passibles de droits, les pénalités peuvent atteindre 50 à 80 % de la valeur des marchandises en cas de fraude. L'extraction par IA n'élimine pas les erreurs de classification. Ce qu'elle peut faire, c'est signaler les incohérences — l'IA lit la description de la cargaison sur la facture et le code HS sur la déclaration, et si la description indique « bloc-batterie lithium-ion » et que le code est 8507.60.0020 (accumulateurs au lithium-ion), l'opérateur reçoit un signal de recoupement plutôt que de devoir trouver l'incohérence manuellement sur trois documents. Mais la décision de classification elle-même reste un jugement humain.
Erreurs de cohérence entre documents. La facture commerciale indique 1 200 unités. La liste de colisage en indique 1 150. Le connaissement en indique 1 200. L'opérateur saisit 1 200 à partir de la facture et ne recoupe jamais la liste de colisage, car il en est à sa 14e saisie de l'après-midi. La déclaration est déposée avec un écart de quantité entre les documents sources — et le système de ciblage automatisé de CBP signale l'incohérence au niveau du manifeste. C'est le type d'erreur qu'une étude de recherche sur la documentation du fret a constaté dans 40 % des envois, les écarts entre documents étant le problème documentaire le plus courant. L'extraction par IA réduit ce risque en traitant tous les documents d'un envoi ensemble — le tableau de données extraites affiche le champ quantité de la facture, de la liste de colisage et du connaissement côte à côte. Une ligne 1 200 / 1 150 / 1 200 est immédiatement visible. L'opérateur n'a pas besoin d'ouvrir trois documents séparés et de penser à les comparer.
| Type d'erreur | Flux de travail manuel | Flux de travail assisté par IA |
|---|---|---|
| Saisie (fautes de frappe, inversion de chiffres) | Présente — 0,5 à 5 % par champ selon les conditions et la fatigue | Éliminée — l'IA lit le document directement ; aucune étape de ressaisie humaine |
| Classification et code HS | Présente — erreur de jugement, pas mécanique | Non éliminée — mais recoupée : l'IA signale les écarts description-code pour examen |
| Cohérence entre documents | Présente — vérification manuelle séquentielle entre documents, facilement omise sous pression | Réduite — tous les documents sont traités ensemble ; les écarts sont visibles côte à côte dans la sortie |
Les statistiques commerciales de CBP pour l'exercice fiscal 2025 chiffrent l'enjeu : 2 432 pénalités commerciales émises, 53 052 dommages-intérêts liquidés et 34,41 milliards de dollars récupérés lors des examens de déclarations récapitulatives. Chacune de ces constatations a commencé par une donnée erronée sur une déclaration en douane — une erreur de saisie, une mauvaise classification, une incohérence de données. Toutes n'étaient pas dues à la saisie manuelle, mais chacune représentait un défaut de qualité des données. L'écart entre un taux d'erreur de 1 % sur 500 déclarations par mois et une précision d'extraction supérieure à 99 % correspond à la différence entre 5 erreurs par mois et potentiellement zéro — et dans un environnement réglementaire où une seule erreur peut déclencher un examen rétroactif sur cinq ans, c'est l'effet cumulatif qui compte, pas le taux par déclaration.
Évolutivité : à 20 déclarations par jour, la saisie manuelle n'est pas un processus — c'est un problème de recrutement
La dimension de l'évolutivité est celle où le mode de défaillance du flux de travail manuel devient structurel plutôt qu'opérationnel. En dessous de 5 entrées par jour, la saisie manuelle des données est acceptable — ce n'est pas rapide, mais embaucher une personne supplémentaire serait absurde. Entre 5 et 15 entrées par jour, l'inefficacité est visible mais gérable : l'opérateur passe 1 à 2 heures par jour à la transcription, ce qui est frustrant mais ne plafonne pas la capacité du courtier.
À 20 entrées par jour — le seuil où un opérateur unique travaillant une journée standard passe 2 à 3 heures uniquement à la transcription des données — le flux de travail manuel devient un plafond de débit. Ajouter un autre client ou une autre voie commerciale signifie ajouter un autre effectif, et le coût n'est pas seulement le salaire. L'opération de Savino Del Bene en Afrique du Sud fournit un étalonnage concret : traitant plus de 50 000 factures commerciales par an pour plus de 2 000 fournisseurs, l'entreprise consacrait 80 % de son temps à la saisie manuelle des données. Après la mise en œuvre de l'automatisation du traitement des documents, le traitement des factures est devenu 11 fois plus rapide, et les économies mensuelles projetées dépassaient 100 000 $.
C'est l'arithmétique de capacité qui importe pour les courtiers en douane à grande échelle :
| Volume d'entrées quotidien | Heures de saisie manuelle/jour | Personnel requis | Personnel requis (assisté par IA) | Plafond de capacité |
|---|---|---|---|---|
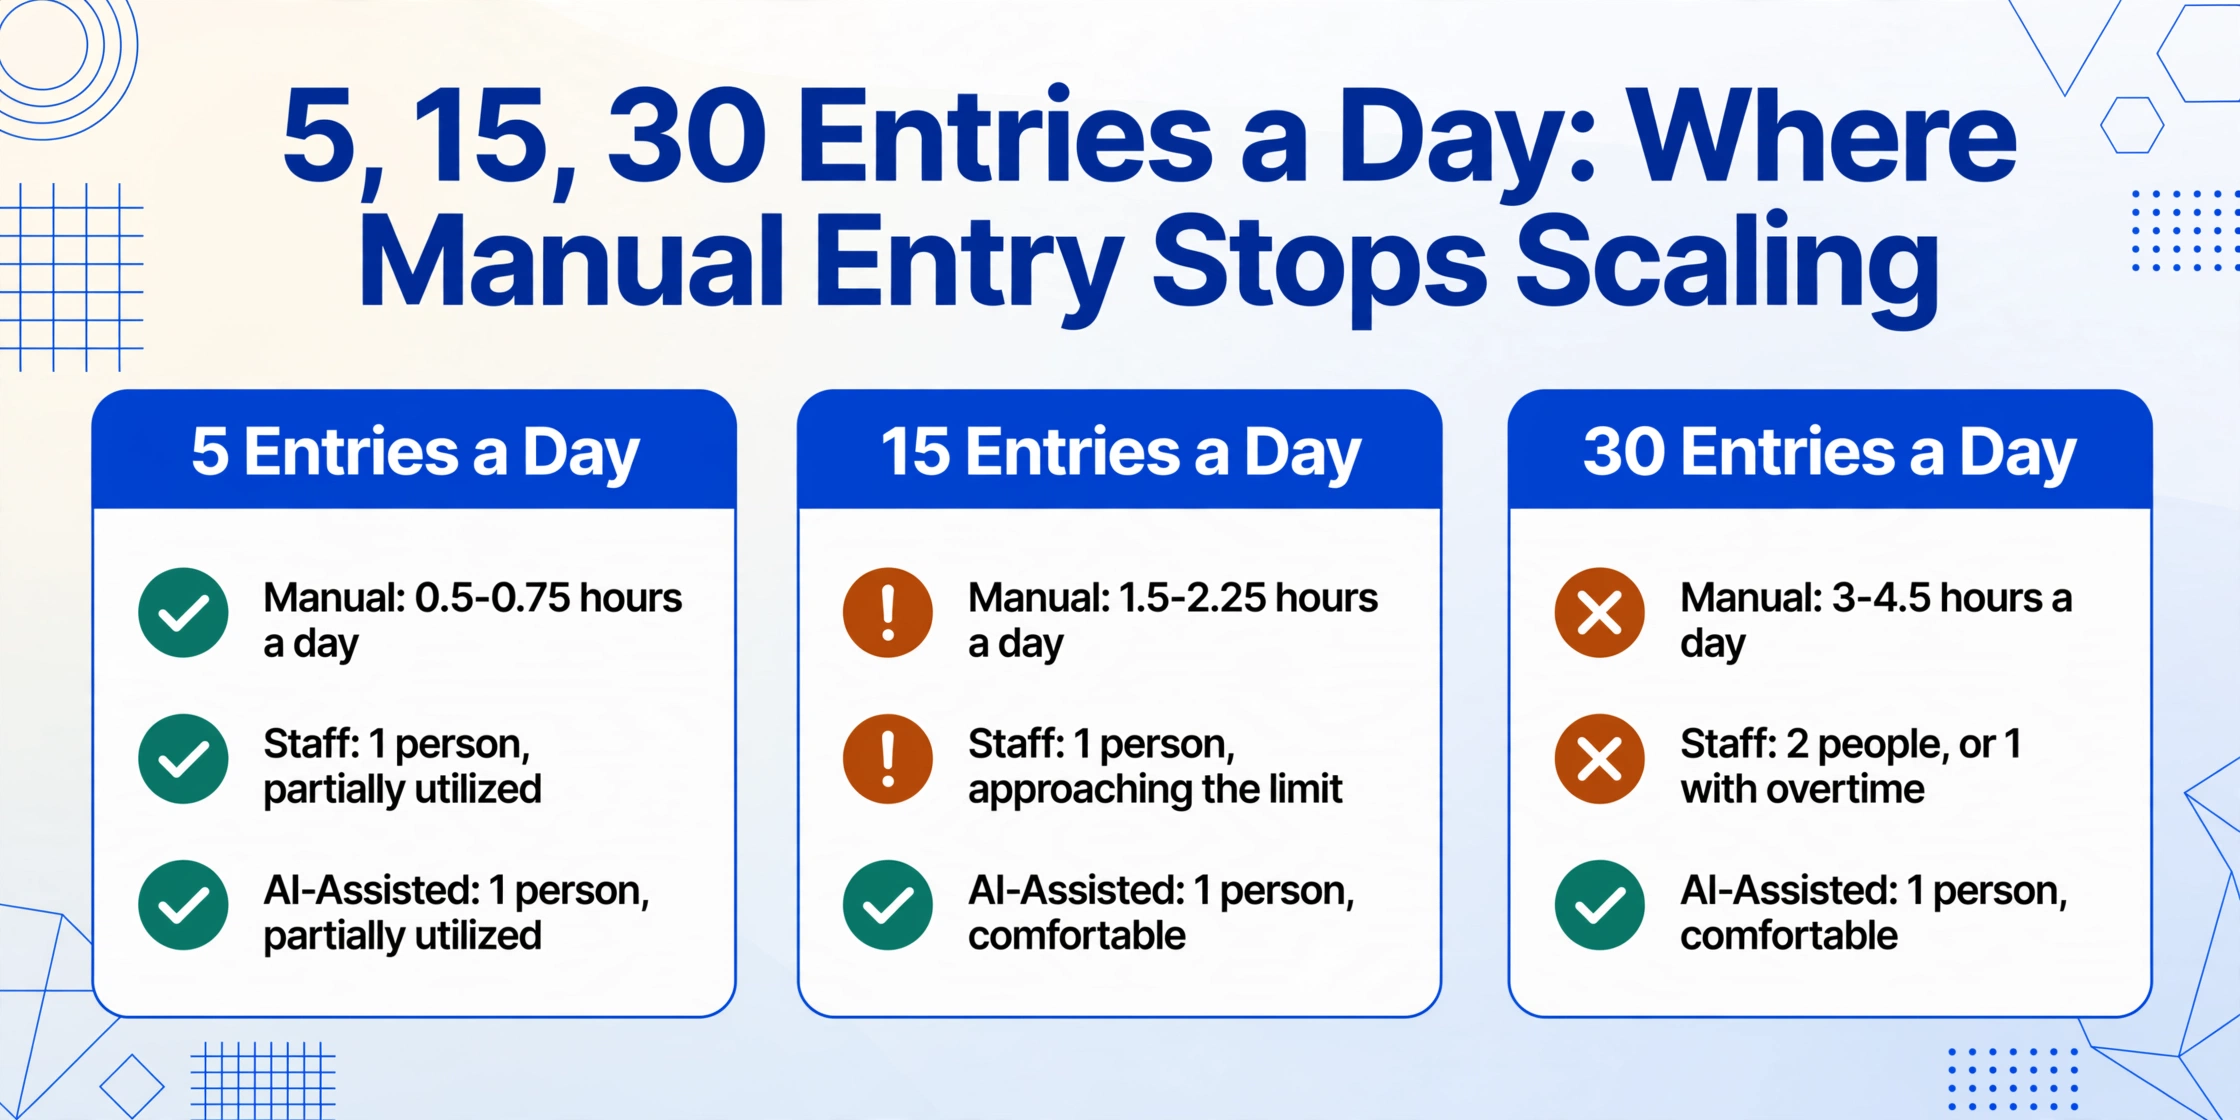
| 5 entrées | 0,5 à 0,75 heure | 1 (partiellement utilisé) | 1 (partiellement utilisé) | Non pertinent |
| 15 entrées | 1,5 à 2,25 heures | 1 (approche de la limite) | 1 (confortable) | ~20-25 entrées/jour par personne |
| 30 entrées | 3 à 4,5 heures | 2 (ou 1 avec heures supplémentaires) | 1 (confortable) | Taille de la main-d'œuvre formée disponible |
| 50+ entrées | 5 à 7,5 heures | 2-3 (plus couverture) | 1-2 | Le pipeline de recrutement limite le débit |
Pour un courtier qui gère des déclarations multi-lignes — des envois comportant 5 lignes de marchandises ou plus, chacune nécessitant son propre code HTS, sa valeur, sa quantité et son pays d'origine — le temps par déclaration se multiplie. Une déclaration de 10 lignes avec saisie manuelle peut consommer 30 à 45 minutes de transcription sur l'ensemble des lignes. Avec l'extraction par IA, les 10 lignes de marchandises sont lues à partir des mêmes documents sources dans le même cycle de traitement — 5 à 10 secondes par page de document source, et non par ligne de marchandises. C'est là que le traitement par lots des déclarations en douane multi-lignes dans un seul tableur transforme l'arithmétique : 50 déclarations multi-lignes qui exigeraient 25 à 37 heures de transcription manuelle deviennent une seule session de téléversement et de vérification mesurée en minutes.
Une étude de Descartes Systems portant sur plus de 400 transitaires et courtiers en douane a révélé que 67 % considèrent la technologie comme fondamentale ou très importante pour la croissance — pourtant 61 % ont cité la pression sur les prix des clients comme un défi majeur. La tension est claire : les courtiers doivent augmenter leur volume pour maintenir leurs marges, mais le flux de travail manuel qui fonctionne à 20 déclarations par jour ne fonctionne pas à 50, et l'embauche de professionnels en douane formés est l'une des contraintes les plus souvent citées dans le secteur. L'automatisation ne résout pas la pénurie de personnel — elle change l'arithmétique du personnel afin que les équipes existantes puissent gérer la croissance sans que chaque nouveau client exige une augmentation proportionnelle des effectifs.
L'investissement d'apprentissage : ce qu'il faut réellement pour adopter la saisie de données douanières assistée par IA
L'argument le plus fort en faveur du flux de travail manuel est qu'il ne nécessite aucune adoption technologique. Un courtier en douane nouvellement agréé qui sait lire une facture commerciale et naviguer dans le portail ACE peut commencer à préparer des déclarations dès le premier jour. Chaque courtier en douane sait déjà quelles données il doit extraire, dans quel format elles doivent être présentées et ce qui se passe si elles sont erronées. Le processus manuel est lent, sujet aux erreurs et limité en volume — mais il est universellement accessible. Tout flux de travail alternatif doit gagner sa place face à un processus qui ne coûte rien au départ et ne nécessite aucune formation.
L'investissement d'apprentissage pour l'extraction assistée par IA se concentre sur un seul nouveau modèle : au lieu d'ouvrir chaque document et de saisir les valeurs dans le logiciel de déclaration, vous téléversez tous les documents sources d'un envoi en une fois et définissez ce que vous souhaitez extraire à l'aide de noms de colonnes — « Nom de l'expéditeur », « Adresse du destinataire », « Code HS », « Pays d'origine », « Valeur déclarée », « Poids net ». L'IA lit chaque champ en comprenant sa signification sémantique, et non en fonction de sa position sur un formulaire spécifique. Une fois définis, ces ensembles de colonnes peuvent être enregistrés et réutilisés — un importateur qui dépose les mêmes types de déclarations sur les mêmes couloirs commerciaux utilise le même modèle de colonnes à chaque fois. L'effort par déclaration devient : téléverser les documents, sélectionner le modèle enregistré, exporter le tableau d'extraction, vérifier.
C'est fondamentalement différent des systèmes OCR traditionnels à modèles, qui exigent de configurer un modèle séparé pour chaque format de document — le modèle CBP 7501, le modèle SAD de l'UE, le modèle de déclaration d'exportation chinoise, plus le format de facture de chaque fournisseur. La charge de maintenance des modèles est ce qui a fait échouer les générations précédentes d'automatisation douanière, en particulier dans les courtiers traitant avec des fournisseurs de plusieurs pays dont les formats de documents changent sans préavis. L'extraction par IA contourne ce problème car elle lit pour le sens, et non pour la position sur une mise en page de formulaire connue.
À titre de comparaison : une mise en œuvre EDI reliant un courtier en douane au système ERP d'un client peut prendre des mois de mapping, de tests et de certification — et elle ne fonctionne qu'avec ce seul client. Un déploiement complet d'une plateforme de gestion douanière peut prendre des semaines, nécessite l'implication des services informatiques et suppose que toutes les données commerciales transitent par le même système. L'extraction assistée par IA a une courbe d'apprentissage mesurée par le temps nécessaire pour téléverser un document et saisir un nom de colonne. À raison de 20 écritures par jour, le temps d'apprentissage du nouveau modèle — environ 15 à 30 minutes d'essai sur quelques échantillons — est amorti dès le premier jour d'utilisation.
Les définitions de colonnes que vous créez pour les écritures douanières peuvent également être utilisées pour d'autres documents commerciaux — factures commerciales, listes de colisage, certificats d'origine — car le moteur d'extraction ne fait pas de distinction entre les types de documents. Le même modèle enregistré qui extrait les codes HS et les valeurs déclarées d'un formulaire douanier extrait également les numéros de facture et les totaux d'une facture commerciale lorsqu'il est appliqué à ce document. Cette réutilisabilité inter-documents signifie que la bibliothèque de modèles s'enrichit avec l'usage plutôt qu'avec le nombre de formats de documents.
Là où la saisie manuelle reste gagnante — et où l'écart est infranchissable
Une comparaison dimensionnelle n'est utile que si elle est honnête des deux côtés. Le flux de travail manuel présente des avantages réels que l'extraction assistée par IA n'élimine pas, et les reconnaître donne du poids au reste de la comparaison :
- Coût marginal nul. La saisie manuelle nécessite une personne formée et un accès au logiciel de déclaration — deux éléments que le courtier possède déjà. Pour les opérations traitant moins de 5 écritures par jour, les économies de temps de l'automatisation ne compensent pas le coût de l'outil. En dessous de ce volume, le flux de travail manuel est le choix économiquement rationnel.
- Jugement contextuel absent des documents. Un courtier expérimenté lisant une facture commerciale peut remarquer que la valeur déclarée est suspecte pour les marchandises décrites — un signal d'alarme de prix de transfert qu'une extraction IA ne signale pas car elle ne lit que ce qui est sur la page, pas ce qui manque. Cette connaissance institutionnelle — « ce fournisseur sous-évalue systématiquement l'électronique sur ses factures et se fait signaler par le CBP » — vit dans la tête du courtier, pas dans un document, et ressort lors de la revue manuelle d'une manière que l'extraction automatisée ne reproduit pas.
- Communication multipartite. Lorsqu'une écriture douanière déclenche une demande de renseignements du CBP (formulaire CBP 28) ou un avis d'action (formulaire CBP 29), la réponse nécessite une communication avec l'importateur, le fournisseur et éventuellement un avocat spécialisé en commerce. Ce flux de travail est intrinsèquement humain — aucun outil d'extraction ne l'automatise, et aucun ne devrait essayer. La gestion des relations et les compétences en communication réglementaire du courtier sont la valeur ici, pas l'étape de saisie des données qui a précédé la demande.
- Intégration à l'interface de dépôt gouvernementale. L'extraction IA produit un tableau de données structurées. Pour intégrer ces données dans le système ACE, le CDS ou ATLAS, il faut soit une ressaisie manuelle dans le système de dépôt, soit une couche d'intégration logicielle. Certaines plateformes de gestion douanière (Descartes, AEB, iCustoms) fournissent des connexions API qui acceptent directement les données structurées, mais les courtiers utilisant des systèmes de dépôt autonomes ou hérités devront toujours effectuer un transfert manuel du tableau de données extraites vers le logiciel de déclaration — à moins d'utiliser la sortie d'extraction comme source de vérification plutôt que comme entrée directe.
Les dimensions où la saisie manuelle perd — et perd en proportion directe du volume — sont la rapidité, la précision de transcription et l'évolutivité. Ces dimensions se cumulent : un courtier qui économise 1,5 heure par jour en transcription pour 20 écritures peut traiter davantage d'écritures sans embaucher de personnel, peut consacrer ce temps récupéré à la vérification de conformité plutôt qu'à la saisie de données, et peut réduire le taux d'erreur qui déclenche les types de pénalités CBP les plus courants. Les 7 erreurs de saisie de données douanières les plus fréquentes qui causent des retards de dédouanement sont principalement des erreurs de transcription et de cohérence entre documents — exactement les catégories que l'extraction par IA traite.
La méthodologie de l'Étude de mesure du temps de dédouanement de l'Organisation mondiale des douanes — désormais dans sa 4e version — a identifié à plusieurs reprises que le principal goulot d'étranglement dans le dédouanement des marchandises n'est ni l'inspection physique, ni la congestion portuaire, mais le temps entre l'arrivée des documents et le dépôt de la déclaration. Dans les programmes pilotes de la Banque mondiale, l'automatisation des frontières a réduit le dédouanement d'une moyenne de 3,6 jours à moins d'un jour dans les pays ayant adopté le pré-dédouanement numérique et la coordination du guichet unique. L'étape de préparation de la déclaration — où vit la saisie manuelle des données — est la plus grande opportunité de compression du temps dans le processus de dédouanement de bout en bout. Ce n'est pas une affirmation commerciale. C'est ce que la méthodologie de mesure de l'OMD constate systématiquement.
Questions fréquentes sur la saisie de données douanières manuelle vs IA
À quel volume d'écritures un courtier en douane devrait-il passer de la saisie manuelle à la saisie assistée par IA ?
Environ 10 à 15 écritures par jour. En dessous, les économies de temps de l'automatisation peuvent ne pas compenser assez rapidement l'investissement d'apprentissage pour justifier le changement — surtout pour les courtiers ayant une clientèle stable utilisant des formats de documents familiers où l'opérateur gagne en rapidité par la répétition. À 20+ écritures par jour, le flux manuel consomme 2 à 3 heures de transcription qui pourraient être récupérées, et le coût d'automatisation de cette étape est inférieur au coût d'embauche de personnel supplémentaire pour traiter le même volume. Le seuil de rentabilité dépend de votre coût de main-d'œuvre chargé par heure et de votre volume quotidien d'écritures, mais pour la plupart des courtiers, il se situe entre 10 et 20 écritures quotidiennes.
En quoi l’extraction par IA diffère-t-elle de l’EDI pour les déclarations en douane ?
L’EDI (échange de données informatisé) est un échange de données structurées entre machines, entre systèmes qui comprennent déjà le même format — par exemple, le système ERP d’un client transmettant des données de bons de commande directement au système de dépôt d’un courtier en douane dans un format de données prédéfini. L’EDI fonctionne lorsque les deux parties ont investi dans l’intégration et maintiennent des structures de données compatibles. L’extraction par IA lit des documents non structurés — PDF, scans, images — provenant de fournisseurs qui ne mettront jamais en place l’EDI, car ce sont des usines à Shenzhen, des distributeurs à Mumbai ou de petits fabricants au Vietnam qui envoient des factures commerciales en pièces jointes par e-mail. L’EDI et l’extraction par IA traitent différentes parties de la chaîne d’approvisionnement documentaire : l’EDI pour les grands clients disposant de systèmes intégrés, l’extraction par IA pour la longue traîne de fournisseurs et de formats qui constituent la majorité de la documentation commerciale.
L’extraction par IA remplace-t-elle un courtier en douane ?
Non. Elle remplace l’étape de transcription des données — lire les valeurs des documents et les saisir dans un logiciel. Elle ne remplace pas, et ne peut pas remplacer, l’expertise en classification, les connaissances réglementaires, l’analyse des programmes commerciaux, la consultation des clients ou la communication avec le CBP qui constituent le véritable service professionnel du courtage en douane. L’automatisation abordée dans cette comparaison opère sur le pipeline document-vers-données, et non sur le jugement du courtier. Un courtier utilisant l’extraction par IA continue de classifier les marchandises, de déterminer l’applicabilité des accords de libre-échange, de traiter les demandes du CBP et de conseiller ses clients sur la stratégie de conformité. La différence est que le courtier passe moins de temps à transcrire les données des factures et plus de temps sur les étapes qui exigent une licence et une expertise professionnelle.
Avec quels formats de documents l’extraction par IA fonctionne-t-elle pour les déclarations en douane ?
Les fichiers PDF (générés numériquement et scannés), les images JPG/PNG, WebP et AVIF sont tous pris en charge. Cela couvre la gamme réelle des documents commerciaux : PDF générés par ERP, factures commerciales scannées, photos de listes de colisage papier et captures d’écran de portails fournisseurs. L’écriture manuscrite sur les documents scannés est lisible, bien que la précision diminue avec la qualité du scan — un scan propre à 300 DPI produit une extraction quasi parfaite, tandis qu’une photo basse résolution d’une liste de colisage manuscrite prise en angle peut nécessiter une vérification manuelle de certains champs.
L’extraction par IA peut-elle traiter des documents commerciaux dans plusieurs langues ?
Oui. Le modèle de langage visuel sous-jacent lit le texte dans n’importe quelle langue. Une déclaration d’exportation chinoise, une facture commerciale allemande, une liste de colisage espagnole et un certificat d’origine coréen sont tous traités de la même manière — les noms de colonnes définis en anglais guident l’extraction, et l’IA localise les valeurs correspondantes, quelle que soit la langue du document source. Les champs numériques — valeurs, poids, quantités, codes HS — sont extraits proprement, indépendamment de la langue. Pour les courtiers qui gèrent des échanges multilatéraux en Asie, en Europe et dans les Amériques, cela élimine les frictions liées à la langue qui, autrement, exigent du personnel bilingue pour la saisie des données.
Les définitions de colonnes d’extraction peuvent-elles être réutilisées entre les écritures et les clients ?
Oui. Un ensemble standard de colonnes pour une écriture d’importation — Importateur enregistré, Destinataire, Pays d’origine, Code HS, Description des marchandises, Quantité, Unité de mesure, Valeur déclarée, Devise, Taux de droit, Poids brut, Numéro de connaissement — peut être défini une seule fois, enregistré sur votre compte, puis appliqué à chaque écriture suivante en un seul clic. Pour les courtiers qui gèrent différents types d’écritures (écritures de consommation formelles, écritures informelles, cautionnements d’importation temporaire), plusieurs modèles de colonnes peuvent être enregistrés pour chaque type d’écriture. La bibliothèque de modèles s’enrichit avec l’usage, et non avec le nombre de formats de documents rencontrés.
L’extraction par IA attribue-t-elle automatiquement les codes HS ?
Certaines plateformes douanières spécialisées en IA (Digicust, iCustoms) proposent la suggestion de codes HS et une assistance à la classification en tant que fonctionnalité distincte. L’extraction d’ImageToTable.ai lit le code HS s’il est déjà imprimé sur le document — par exemple, lorsqu’un fournisseur inclut le code HTS sur sa facture commerciale. Elle ne classe pas les produits sans code ni ne suggère de codes HS pour les articles sans classification tarifaire imprimée. L’étape de classification reste une décision humaine, éclairée par l’expertise du courtier, les Règles générales d’interprétation et les bases de données de décisions de la CBP. Si vous avez besoin d’une classification assistée par IA, recherchez des plateformes spécifiques au domaine douanier qui combinent extraction et classification. Si vous avez besoin d’extraire des documents où les codes HS sont déjà présents mais enfouis dans des formats incohérents, l’outil gère cela directement.
Les données extraites s'intègrent-elles directement au système ACE de la CBP ?
Non — et cette distinction est importante. L'extraction produit des données structurées au format Excel, CSV ou JSON. L'acheminement de ces données vers le portail ACE, le CDS ou ATLAS nécessite toujours une saisie manuelle ou une couche d'intégration logicielle. Les courtiers utilisant des plateformes de gestion douanière avec connectivité API (Descartes, AEB, CargoWise de WiseTech) peuvent importer directement les données structurées. Les courtiers qui déposent leurs déclarations via le portail sécurisé ACE devront soit transférer manuellement les données extraites vers le portail, soit utiliser un système de gestion de courtage doté d'une capacité d'importation de données. L'extraction élimine l'étape de conversion du document source en données structurées. Elle n'élimine pas l'étape de transfert des données structurées vers le système de dépôt, sauf si votre logiciel de dépôt le prend en charge.
Le courtage en douane est une profession à haut risque où un seul code HTS mal classé peut déclencher un audit rétroactif de cinq ans. La question à laquelle cette comparaison répond n'est pas de savoir si l'IA rend la saisie manuelle obsolète — ce n'est pas le cas, et pour les courtiers traitant moins de 10 déclarations par jour, la saisie manuelle reste le choix rationnel par défaut. La question est à partir de quel volume l'économie s'inverse. À 20 déclarations par jour, le flux de travail manuel consomme 2 à 3 heures de transcription qui pourraient être récupérées. À 50 déclarations, il consomme l'équivalent d'un salaire à temps plein en frappe. La technologie d'extraction existe. L'OMD, la FIATA et les autorités douanières nationales évoluent toutes vers une documentation commerciale numérisée. La décision pour chaque courtier est de savoir quand — pas si — séparer l'étape de lecture des documents de l'étape d'expertise douanière, et cesser de payer des professionnels agréés pour effectuer un travail qu'une machine peut faire mieux.
Lié : Comment extraire des données de formulaires de déclaration en douane vers Excel · Traitement par lots de déclarations en douane multi-pays dans une seule feuille de calcul · 7 erreurs de saisie de données douanières qui causent des retards de dédouanement