Manuelle vs. KI-Zolldateneingabe:
Was übersteht 20 Einträge pro Tag?
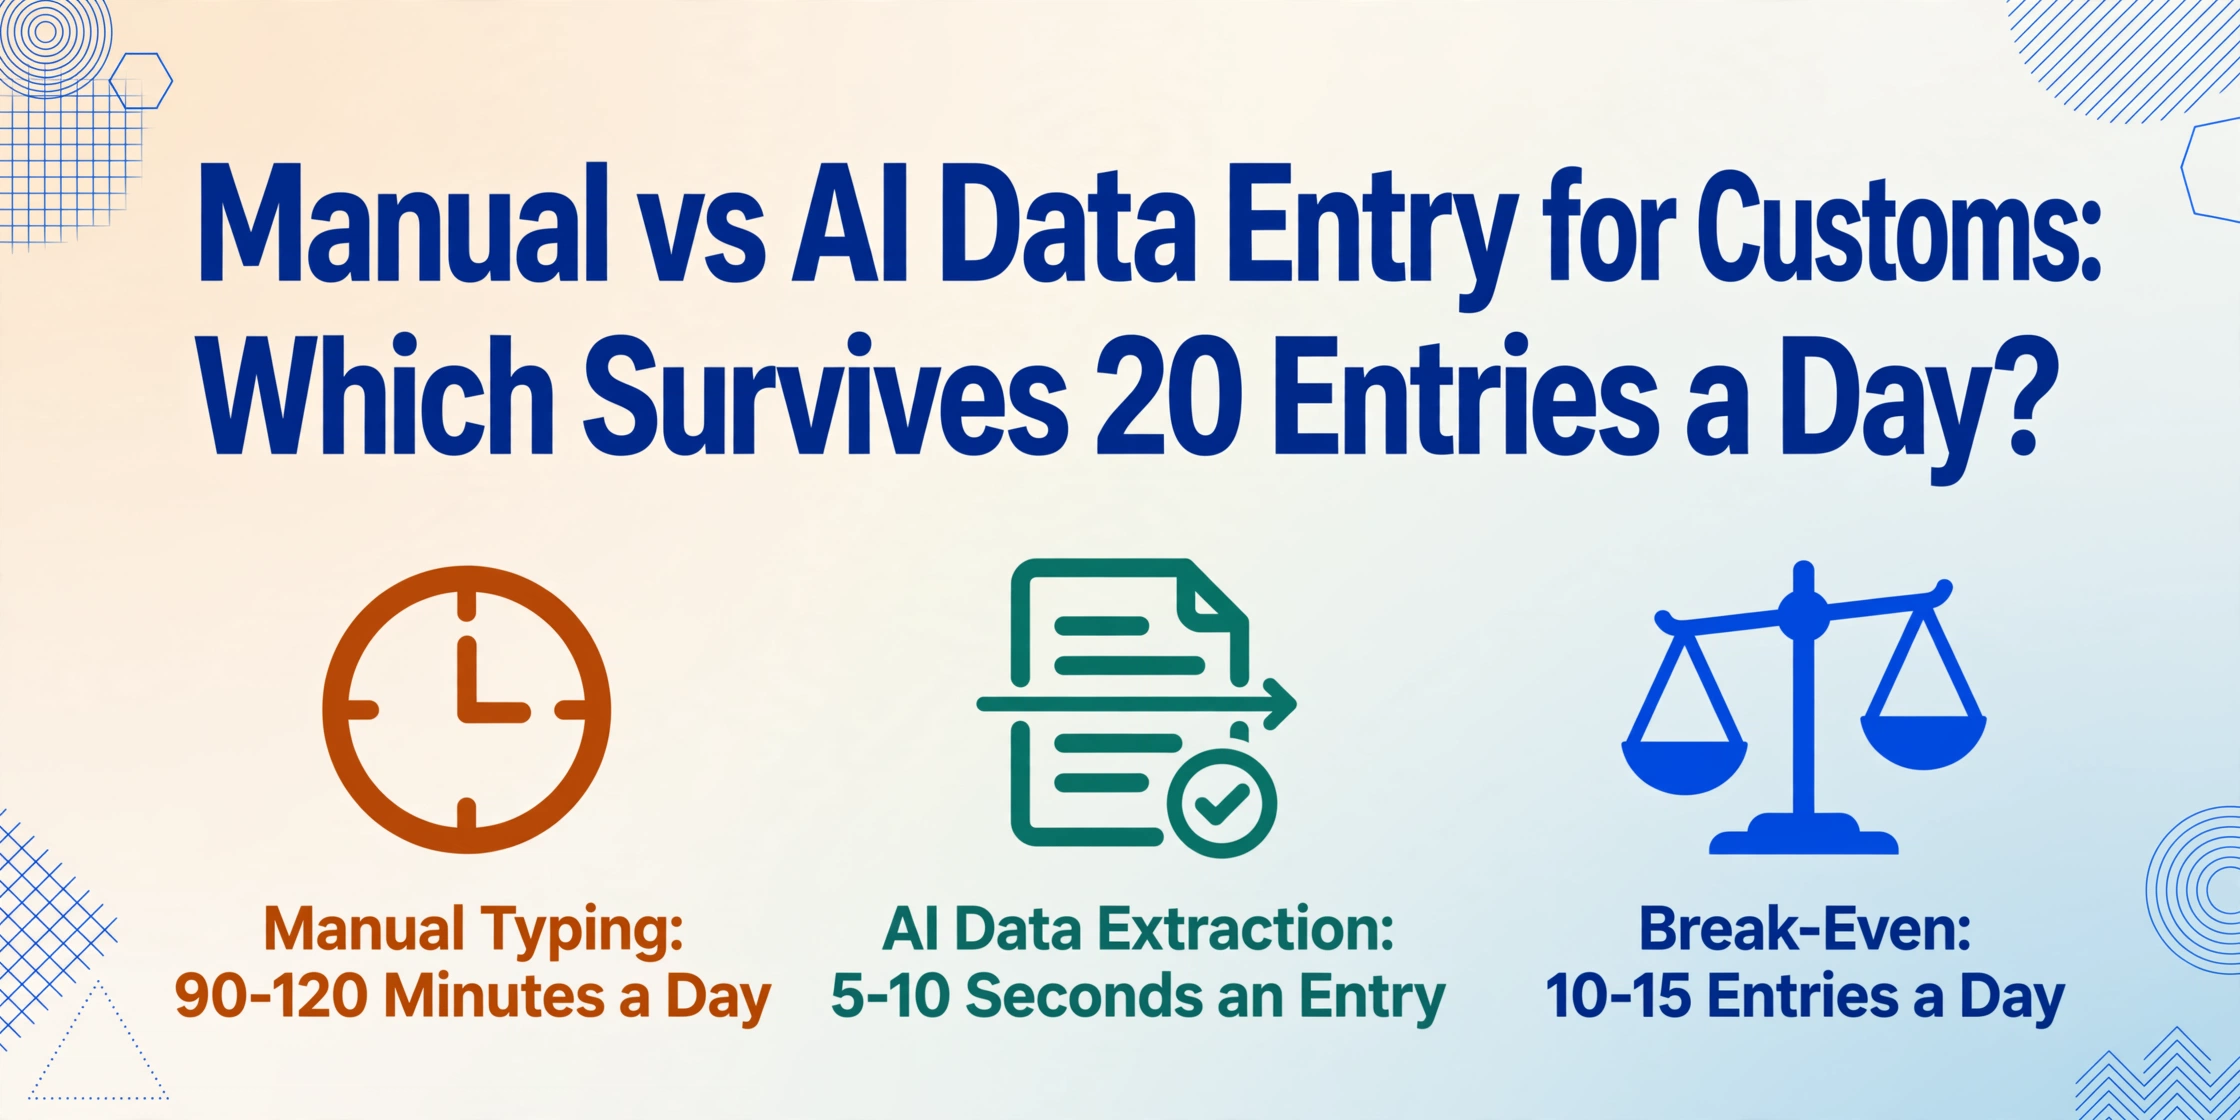
Im Geschäftsjahr 2025 verarbeitete die U.S. Customs and Border Protection 50 Millionen Entry Summaries, erließ 2.432 Handelssanktionen und nahm 34,41 Milliarden US-Dollar aus Entry-Summary-Prüfungen ein. Jeder dieser Einträge begann als Daten, die aus einer Handelsrechnung, Packliste oder einem Frachtbrief extrahiert und in eine Zollerklärung übertragen wurden – ein Schritt, der in den meisten Speditionen noch immer überwiegend manuell erfolgt. Dieser Vergleich misst, was dieser Schritt tatsächlich an Zeit, Fehlern und Durchsatz kostet und ab welchem Volumen der manuelle Arbeitsablauf nicht mehr beherrschbar ist.
Wichtigste Erkenntnisse
- 60 bis 70 Prozent der Vorbereitungszeit für jeden Zolleintrag werden nicht durch Klassifizierung oder Compliance verbraucht – die Arbeit, für die die Lizenz eines Maklers erworben wurde –, sondern durch das Ablesen von Werten aus Lieferantenrechnungen und deren manuelles Neuabtippen.
- Bei 20 Einträgen pro Tag verbraucht der manuelle Übertragungsschritt 7,5 bis 10 Stunden pro Woche – einen ganzen Arbeitstag – und jede Stunde dieses Tippens birgt das Risiko einer falschen Ziffer, die ein Zollaudit auslösen kann, das fünf Jahre zurückreicht.
- Unter 10 Einträgen pro Tag ist das manuelle Tippen wirtschaftlich sinnvoll, aber über 20 kehrt sich das Verhältnis um – die Einstellung von Personal, um Schritt zu halten, kostet mehr als die Beseitigung des Übertragungsschritts, und ImageToTable.ai extrahiert jedes Feld aus jedem Dokument in unter 10 Sekunden pro Seite.
Was bei der manuellen Zollanmeldungsvorbereitung tatsächlich passiert
Der Prozess der Zollanmeldung – die formelle Übermittlung von Daten an das ACE-System der CBP, an das CDS der HMRC, an die Zollbehörden der EU-Mitgliedstaaten – ist bereits digital. Was bei den meisten Speditionen nicht digital ist, ist der Schritt vor der Einreichung: das Extrahieren von Handelsdaten aus den Quelldokumenten und deren Eingabe in die Anmeldesoftware. Das ist die Lücke, die die meisten Automatisierungsdiskussionen überspringen. EDI- und API-Verbindungen bewältigen die Maschine-zu-Maschine-Übertragung zwischen Systemen, die bereits strukturierte Daten enthalten. Sie lesen keine gescannte Packliste aus einer Fabrik in Shenzhen.
Der manuelle Arbeitsablauf für die Vorbereitung einer einzelnen Zollanmeldung gliedert sich in fünf Schritte:
Quelldokumente empfangen und sortieren
Handelsrechnung, Packliste, Konnossement oder Luftfrachtbrief, Ursprungszeugnis – eine Sendung kann 10+ Dokumente von verschiedenen Parteien in unterschiedlichen Formaten erzeugen, die über verschiedene Kanäle eingehen (E-Mail, gemeinsames Laufwerk, Portal-Download). Eine Studie unter Spediteuren ergab, dass 40 % der Zollverzögerungen auf Unstimmigkeiten zwischen diesen Dokumenten zurückzuführen waren, noch bevor mit der Einfuhranmeldung begonnen wurde.
Datenfelder lokalisieren und in die Anmeldesoftware übertragen
Der Sachbearbeiter liest die Handelsrechnung, findet den Namen des Versenders, die Adresse des Empfängers, die Warenbeschreibung, Menge, Gewicht, den erklärten Wert, die Währung, Incoterms, das Ursprungsland und den HS-Code – und tippt dann jedes Feld in das entsprechende Feld im Anmeldesystem ein. Allein ein CBP-Formular 7501 enthält 47 Datenblöcke. Bei einer Position mit 5 Warenzeilen verwaltet der Sachbearbeiter etwa 35–50 einzelne Datenpunkte pro Anmeldung und wechselt für jeden einzelnen Punkt zwischen den Fenstern hin und her.
Daten dokumentenübergreifend auf Konsistenz prüfen
Die Menge auf der Rechnung muss mit der Packliste übereinstimmen. Der erklärte Wert muss mit der Summe der Handelsrechnung konsistent sein. Der HS-Code muss zur Warenbeschreibung passen. Diese Prüfungen sind manuell und sequenziell – der Sachbearbeiter liest Dokument A, liest Dokument B und vergleicht gedanklich. Freitags um 16 Uhr, wenn noch 8 Anmeldungen in der Warteschlange stehen, ist die Konsistenzprüfung der erste Schritt, der verkürzt oder übersprungen wird.
Waren klassifizieren und Logik für Handelsprogramme anwenden
Der Sachbearbeiter bestimmt den korrekten HS-Code, wendet etwaige Präferenzen aus Freihandelsabkommen an, prüft die Anwendbarkeit von ADD/CVD und bestätigt die PGA-Anforderungen (FDA, USDA, EPA). Dies ist der Schritt, bei dem Zollwissen am wichtigsten ist – und es ist auch der Schritt, bei dem selbst erfahrene Broker Klassifizierungsfehler machen, die CBP-Prüfungen auslösen. Ein falsch klassifizierter HTS-Code kann über Monate hinweg zu niedrige Zölle auf zahlreiche Anmeldungen zur Folge haben, bevor er bei einer gezielten Prüfung entdeckt wird.
Zollanmeldung einreichen, Ablehnungen bearbeiten, MRN abrufen
Die Zollanmeldung wird elektronisch an die Zollbehörde übermittelt. Wenn sie die Validierung besteht, wird die Movement Reference Number oder die Eintragungsnummer innerhalb von Sekunden zurückgegeben. Schlägt sie fehl – wegen eines nicht übereinstimmenden HTS-Codes, eines fehlenden PGA-Datenelements oder einer ungültigen EORI – kommt die Ablehnungsmeldung zurück und der Bearbeiter beginnt mit der Fehlersuche. Ein einziger abgelehnter Eintrag kann so viel Zeit in Anspruch nehmen wie drei fehlerfreie Einträge.
Die Schritte 2 und 3 – das Auffinden von Daten auf Dokumenten und deren Übertragung – beanspruchen typischerweise 60-70 % der gesamten Vorbereitungszeit für eine Anmeldung. Die Schritte 4 und 5, die Zollfachwissen und Urteilsvermögen erfordern, machen die restlichen 30-40 % aus. Dieses Verhältnis macht den Vergleich zwischen manuell und automatisiert aussagekräftig: Die zeitintensiven Schritte sind die mechanischen, nicht die fachlich anspruchsvollen. Die DHL-Forschung bestätigt, dass 80 % der Zollverzögerungen auf fehlerhafte oder fehlende Dokumentation zurückzuführen sind – nicht auf Rückstände bei physischen Inspektionen oder Hafenüberlastung –, was bedeutet, dass der Schritt der Dokument-zu-System-Übertragung der Ort ist, an dem der strukturelle Engpass liegt.
Diese Umkehrung des Aufwands – bei der die mechanische Arbeit mehr Zeit beansprucht als die fachlich anspruchsvolle – ist das Muster, das definiert, wann manuelle Arbeitsabläufe zusammenbrechen. Sie definiert auch, wo Automatisierung tatsächlich hilft: nicht beim Ersetzen von Zollfachwissen, sondern beim Beseitigen der Übertragungsbarriere, die die Zeit verbraucht, bevor Fachwissen angewendet werden kann. Für einen tieferen Einblick, warum dieses Muster in der gesamten Branche fortbesteht, lesen Sie unsere Analyse zu den strukturellen Gründen, warum die Zolldatenverwaltung ein Engpass bleibt im Frachtbetrieb.
Geschwindigkeit: Was „3 Minuten pro Dokument“ bei 100 Zollanmeldungen pro Woche tatsächlich bedeutet
Eine einzelne Seite mit gedruckten Daten benötigt etwa 3 Minuten für die manuelle Übertragung – Feld lokalisieren, eingeben, prüfen. Dies ist der Durchschnittswert bei erfahrenen Datenerfassungskräften unter normalen Arbeitsbedingungen. Studien zu qualifizierten Datenerfassungskräften zeigen durchweg Fehlerraten zwischen 0,5 % und 1 %, selbst unter kontrollierten Bedingungen – und diese Raten steigen im Laufe des Arbeitstages. Dieselbe Person, die um 9 Uhr morgens mit 1 % Fehlerquote arbeitet, produziert am späten Nachmittag über 3 % Fehler, wenn die kognitive Ermüdung zunimmt.
Für einen Zollagenten, der 20 Anmeldungen pro Tag bearbeitet – ein typisches Volumen für ein kleines bis mittelgroßes Maklerunternehmen – ist die Rechnung einfach: 20 Anmeldungen × 3 Minuten Datenextraktion pro Anmeldung = 60 Minuten. In der Praxis liegt der tatsächliche Wert durch Dokumentsortierung, Gegenprüfung und den Umgang mit Formatabweichungen eher bei 90–120 Minuten pro Tag, die ausschließlich für die Datenerfassung aufgewendet werden. Über eine Fünf-Tage-Woche mit 100 Anmeldungen sind das 7,5–10 Stunden – im Wesentlichen ein voller Arbeitstag pro Woche, der für einen Schritt aufgewendet wird, der kein Zollwissen erfordert und die meisten Fehler verursacht.
So sieht der Zeitaufwand pro Anmeldung in beiden Arbeitsabläufen für eine standardmäßige Einzelpositionsanmeldung aus:
| Aufgabe | Manueller Arbeitsablauf (pro Anmeldung) | KI-gestützter Arbeitsablauf (pro Anmeldung) |
|---|---|---|
| Dokumente empfangen und sortieren | 2–3 Minuten | 2–3 Minuten (unverändert – Dokumente treffen weiterhin über bestehende Kanäle ein) |
| Datenfelder lokalisieren und übertragen | 3–5 Minuten | 5–10 Sekunden (alle Dokumente hochladen, KI extrahiert strukturierte Daten) |
| Dokumentkonsistenz gegenprüfen | 2–4 Minuten | 1–2 Minuten (extrahierte Tabelle auf markierte Abweichungen prüfen) |
| Waren klassifizieren, Handelsprogramme anwenden | 2–5 Minuten | 2–5 Minuten (unverändert – erfordert Zollfachwissen) |
| Einreichen, Ablehnungen bearbeiten, MRN abrufen | 1–3 Minuten | 1–3 Minuten (unverändert – elektronische Einreichung ist unabhängig von der Extraktionsmethode) |
| Gesamt pro Anmeldung | 10–20 Minuten | 6–13 Minuten |
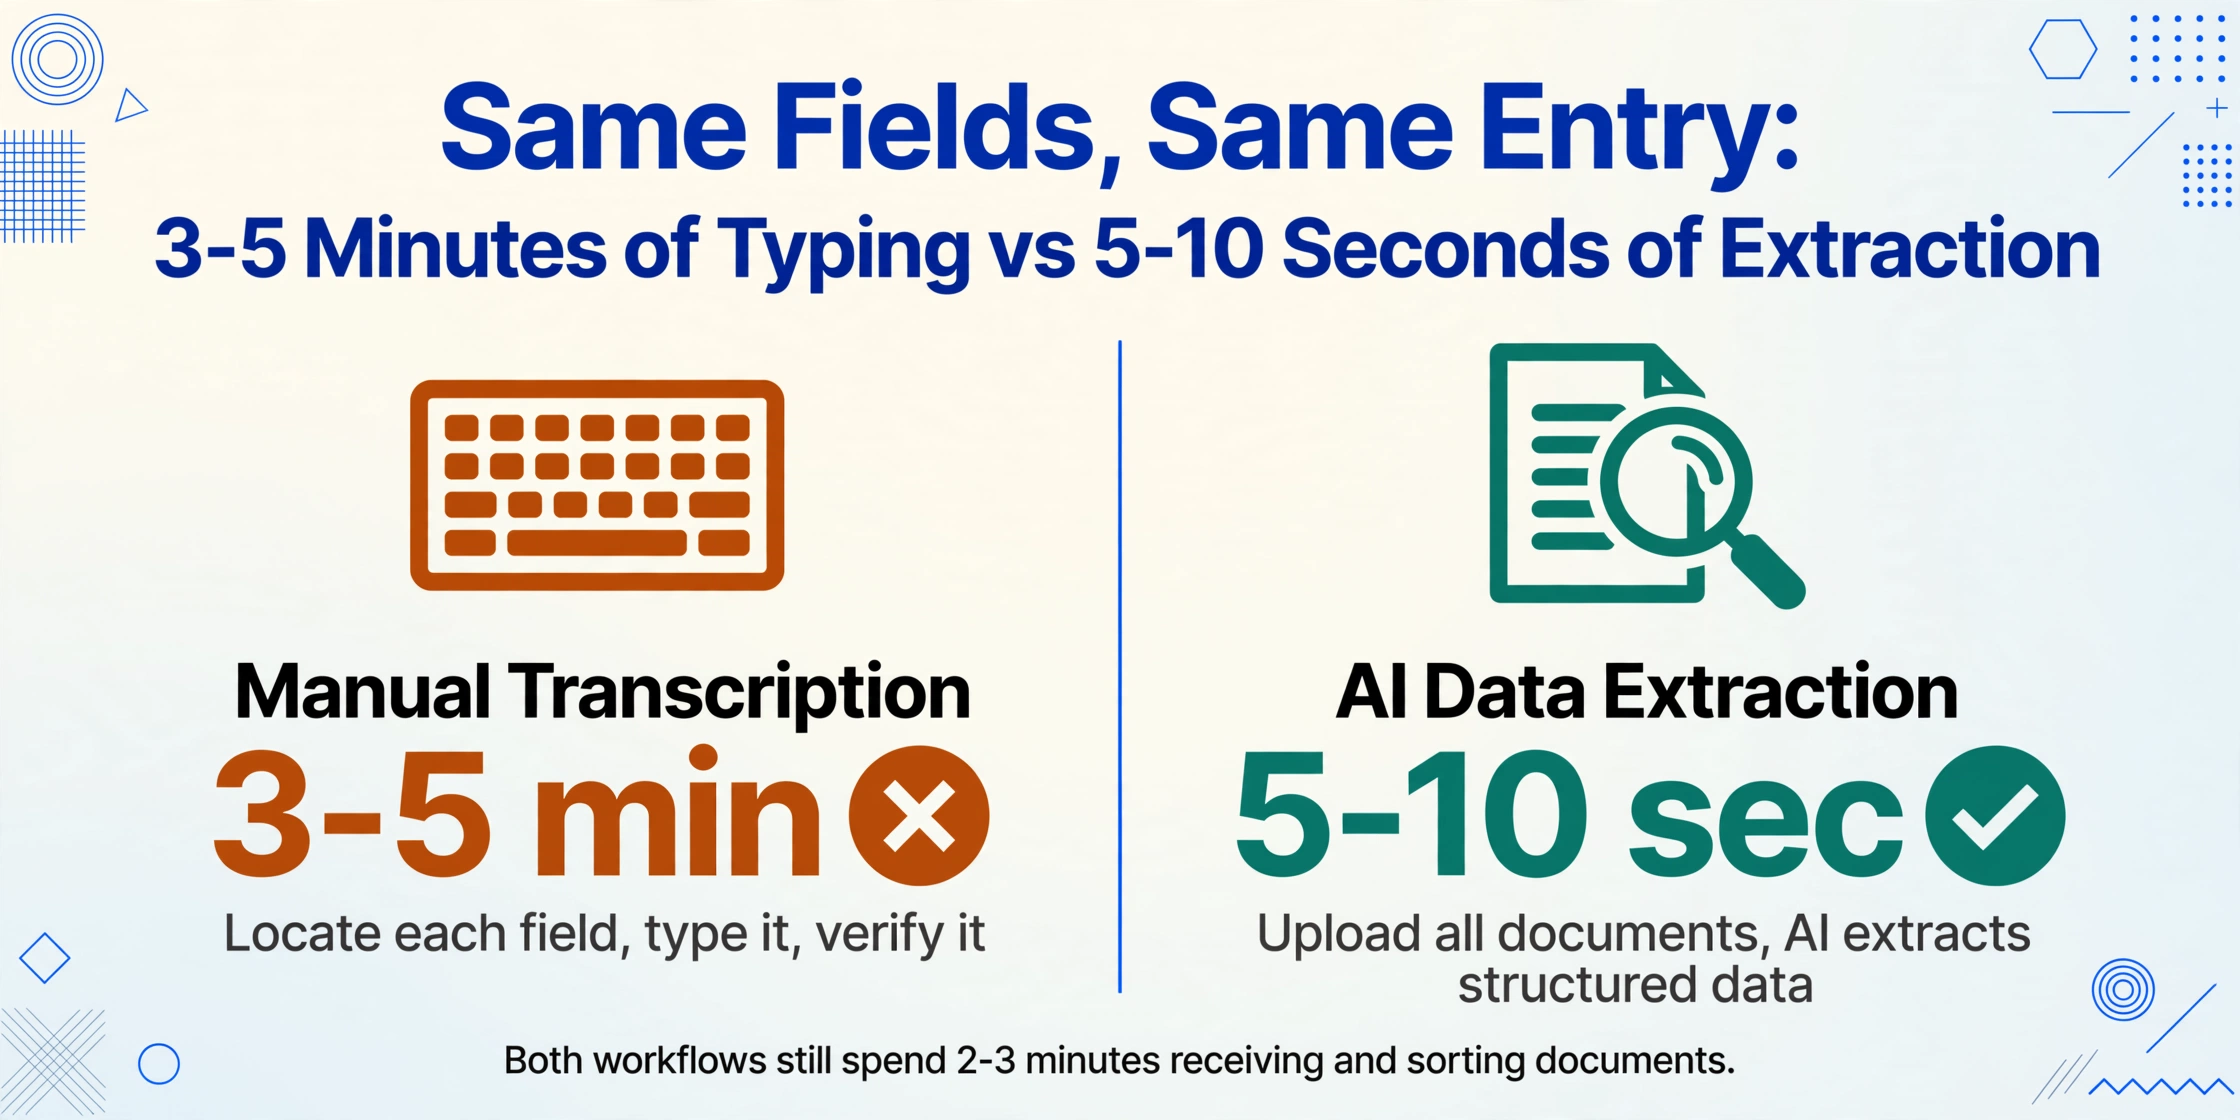
Allein der Extraktionsschritt schrumpft von 3-5 Minuten pro Anmeldung auf 5-10 Sekunden. Bei 20 Anmeldungen pro Tag spart das etwa 1-1,5 Stunden – nicht der gesamten Anmeldevorbereitung, sondern gezielt der mechanischen Übertragungsarbeit. Klassifizierung, Einreichung und Compliance-Schritte bleiben in Zeit und Qualität unverändert, da sie nicht von schnellerem Tippen profitieren. Sie profitieren davon, dass der Bearbeiter mehr mentale Kapazität hat, wenn er sie erreicht.
Der Mechanismus, der diese Geschwindigkeit erzeugt, ist die Spaltennamensextraktion: Statt jedes Dokument zu lesen und Feld für Feld zu übertragen, definieren Sie die gewünschten Datenpunkte – „HS-Code", „Erklärter Wert", „Ursprungsland", „Empfängername" – und die KI lokalisiert jeden Wert an beliebiger Stelle auf der Seite, indem sie dessen Bedeutung semantisch versteht. Ein Feld mit der Bezeichnung „商品编码" auf einer chinesischen Exportanmeldung, „HS Code" auf einem CBP 7501 und „Commodity Code" auf einem EU-SAD werden derselben Spalte in Ihrer Ausgabe zugeordnet, ohne dass eine formatabhängige Vorlagenkonfiguration erforderlich ist. Eine ausführliche Anleitung zu diesem Ansatz über Anmeldeformate hinweg finden Sie unter Daten aus Zollanmeldeformularen nach Excel extrahieren.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Verarbeitungszeit von 5-10 Sekunden pro Seite im Vergleich zu etwa 3 Minuten manueller Transkription pro Seite bedeutet, dass sich der Geschwindigkeitsvorteil direkt mit dem Volumen multipliziert – aber nur für den Extraktionsschritt. Die Entscheidungsschritte bleiben im gleichen Tempo, denn Zollfachwissen ist der Wert, nicht der Engpass. Ein Broker, der 10 Anmeldungen pro Tag bearbeitet, spart etwa 30-50 Minuten. Einer, der 50 bearbeitet, spart 2,5-4 Stunden. Der Wendepunkt, an dem die Zeitersparnis in den Bereich „das verändert, wie ich meinen Tag strukturiere" übergeht, liegt bei etwa 20-25 Anmeldungen täglich.
Genauigkeit: Drei Arten von Zollanmeldefehlern – und welche die Automatisierung tatsächlich beseitigt
Das Wort „Genauigkeit“ wird im Automatisierungsmarketing oft locker verwendet, aber Zollanmeldefehler sind keine einheitliche Kategorie. Sie fallen in drei verschiedene Typen, und die Automatisierung geht mit jedem unterschiedlich um. Präzise zu sein, welche sie beseitigt und welche nicht, ist der Unterschied zwischen einem ehrlichen Vergleich und einem Verkaufsargument.
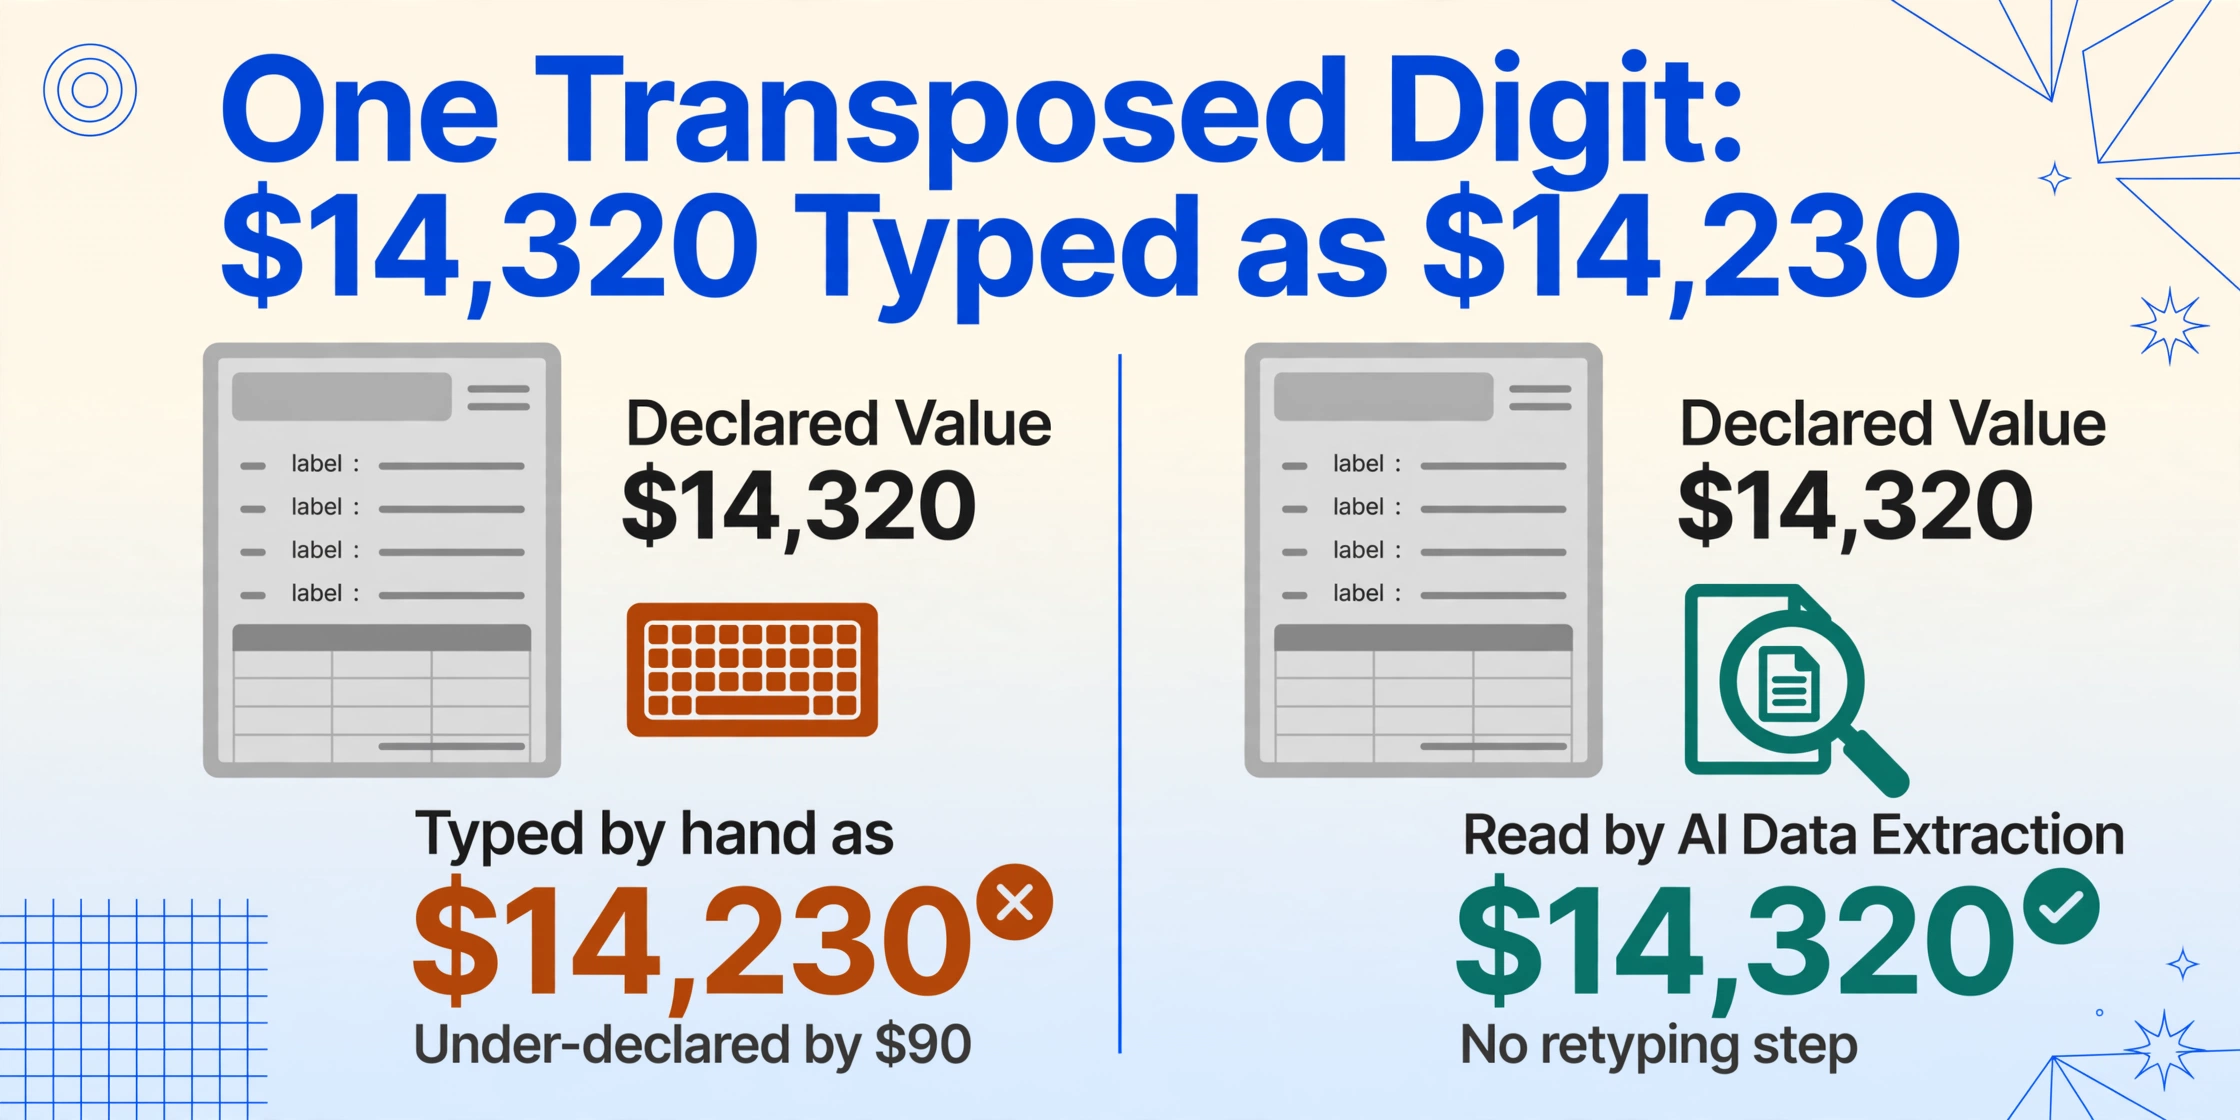
Übertragungsfehler. Die Rechnung weist einen Erklärungswert von 14.320 $ aus. Der Sachbearbeiter tippt 14.230 $. Eine vertauschte Ziffer. Wenn dieser Fehler die Einreichung übersteht und die Validierung von CBP ihn nicht erkennt – was vorkommt, wenn der Wert in einem plausiblen Bereich liegt –, hat der Importeur um 90 $ zu niedrig deklariert, was bei jeder weiteren Anmeldung mit demselben Fehlermuster eine Haftung begründet. Forschungsergebnisse aus jahrzehntelangen Dateneingabestudien beziffern die Fehlerquote qualifizierter menschlicher Übertragung auf 0,5–1 % unter kontrollierten Bedingungen und auf 2–5 % unter realen Bedingungen mit unterschiedlichen Dokumentformaten, Zeitdruck und Ermüdung am Tagesende. Für einen Agenten, der 500 Anmeldungen pro Monat einreicht, bedeutet eine Fehlerquote von 1 % fünf Anmeldungen pro Monat mit einem Übertragungsfehler – und diese fünf Anmeldungen können, falls sie in einer gezielten Prüfung von CBP aufgedeckt werden, eine Überprüfung aller in den letzten fünf Jahren eingereichten Anmeldungen gemäß den Aufbewahrungspflichten von 19 CFR Part 163 auslösen. KI-Extraktion beseitigt Übertragungsfehler vollständig – die KI liest den Wert direkt aus dem Dokument, ohne dass ein Mensch ihn erneut abtippt. Wenn die KI ihn korrekt liest, ist der Wert korrekt. Wenn es sich um einen Scan geringer Qualität handelt, bei dem die KI ihn möglicherweise falsch liest, überprüft der Sachbearbeiter diesen spezifischen Eintrag, anstatt jeden Eintrag manuell zu tippen.
Klassifizierungs- und Codefehler. Der Sachbearbeiter weist HTS 8471.30.0100 (tragbare automatische Datenverarbeitungsgeräte) einem Gerät zu, das er für einen Tablet-Computer hält – aber das Produkt ist tatsächlich ein Gerät mit Mobilfunkfunktion, das unter 8517.12.0050 klassifiziert werden sollte. Dies ist kein Übertragungsfehler; der Sachbearbeiter hat den Code eingegeben, den er beabsichtigt hat. Es ist ein Klassifizierungs-Urteilsfehler, und es ist die Fehlerart mit dem höchsten finanziellen Risiko. Die Strafen von CBP für Fahrlässigkeit bei zollpflichtigen Importen reichen von 0,5 bis 2 Mal dem Verlust an Zoll; bei grober Fahrlässigkeit bis zum 4-fachen; bei Betrug bis zum 8-fachen des entgangenen Zolls. Bei nicht zollpflichtigen Artikeln können die Strafen 50–80 % des Warenwerts bei Betrug erreichen. KI-Extraktion beseitigt Klassifizierungsfehler nicht. Was sie tun kann, ist, Unstimmigkeiten zu kennzeichnen – die KI liest die Warenbeschreibung aus der Rechnung und den HS-Code aus der Anmeldung, und wenn die Beschreibung „Lithium-Ionen-Akkupack“ und der Code 8507.60.0020 (Lithium-Ionen-Akkumulatoren) lautet, erhält der Sachbearbeiter ein Querverweissignal, anstatt die Diskrepanz manuell über drei Dokumente hinweg zu finden. Aber die Klassifizierungsentscheidung selbst bleibt ein menschliches Urteil.
Fehler bei der Dokumentenübereinstimmung. Die Handelsrechnung weist 1.200 Einheiten aus. Die Packliste weist 1.150 aus. Der Frachtbrief weist 1.200 aus. Der Sachbearbeiter übernimmt die 1.200 aus der Rechnung und gleicht sie nie mit der Packliste ab, weil es bereits der 14. Eintrag am Nachmittag ist. Der Eintrag wird mit einer Mengenabweichung zwischen den Quelldokumenten eingereicht – und das automatisierte Targeting-System der CBP markiert die Unstimmigkeit auf Manifestebene. Diese Fehlerart betrifft laut einer Forschungsstudie zur Speditionsdokumentation 40 % der Sendungen, wobei Abweichungen zwischen Dokumenten das häufigste Dokumentationsproblem darstellen. KI-Extraktion reduziert dies, indem alle Dokumente einer Sendung gemeinsam verarbeitet werden – die extrahierte Datentabelle zeigt das Mengenfeld aus Rechnung, Packliste und Frachtbrief nebeneinander. Eine Zeile mit 1.200 / 1.150 / 1.200 ist sofort sichtbar. Der Sachbearbeiter muss nicht drei separate Dokumente öffnen und daran denken, sie zu vergleichen.
| Fehlerart | Manueller Workflow | KI-gestützter Workflow |
|---|---|---|
| Übertragungsfehler (Tippfehler, Vertauschungen) | Vorhanden – 0,5–5 % pro Feld, abhängig von Bedingungen und Ermüdung | Eliminiert – KI liest das Dokument direkt; kein manueller Abtippschritt |
| Klassifizierung und HS-Code | Vorhanden – Beurteilungsfehler, kein mechanischer Fehler | Nicht eliminiert – aber gegengeprüft: KI markiert Abweichungen zwischen Beschreibung und Code zur Überprüfung |
| Dokumentenübergreifende Konsistenz | Vorhanden – sequenzielle manuelle Prüfung über Dokumente hinweg, wird unter Zeitdruck leicht übersprungen | Reduziert – alle Dokumente werden gemeinsam verarbeitet; Abweichungen sind im Output nebeneinander sichtbar |
Die CBP-Handelsstatistiken für das Geschäftsjahr 2025 verdeutlichen die Tragweite: 2.432 Handelssanktionen, 53.052 Schadensersatzforderungen und 34,41 Milliarden US-Dollar, die durch Zusammenfassungsprüfungen von Einträgen zurückgefordert wurden. Jeder dieser Befunde begann mit einem falschen Datenpunkt in einem Zolleintrag – einem Übertragungsfehler, einer Fehlklassifizierung, einer Dateninkonsistenz. Nicht alle wurden durch manuelle Dateneingabe verursacht, aber jeder einzelne war ein Datenqualitätsversagen. Der Unterschied zwischen einer Fehlerquote von 1 % bei 500 Einträgen pro Monat und einer Extraktionsgenauigkeit von über 99 % ist der Unterschied zwischen 5 Fehlern pro Monat und potenziell null – und in einem regulatorischen Umfeld, in dem ein einziger Fehler eine rückwirkende Prüfung über fünf Jahre auslösen kann, zählt der kumulative Effekt, nicht die Fehlerquote pro Eintrag.
Skalierbarkeit: Bei 20 Anmeldungen pro Tag ist die manuelle Erfassung kein Prozess — sie ist ein Einstellungsproblem
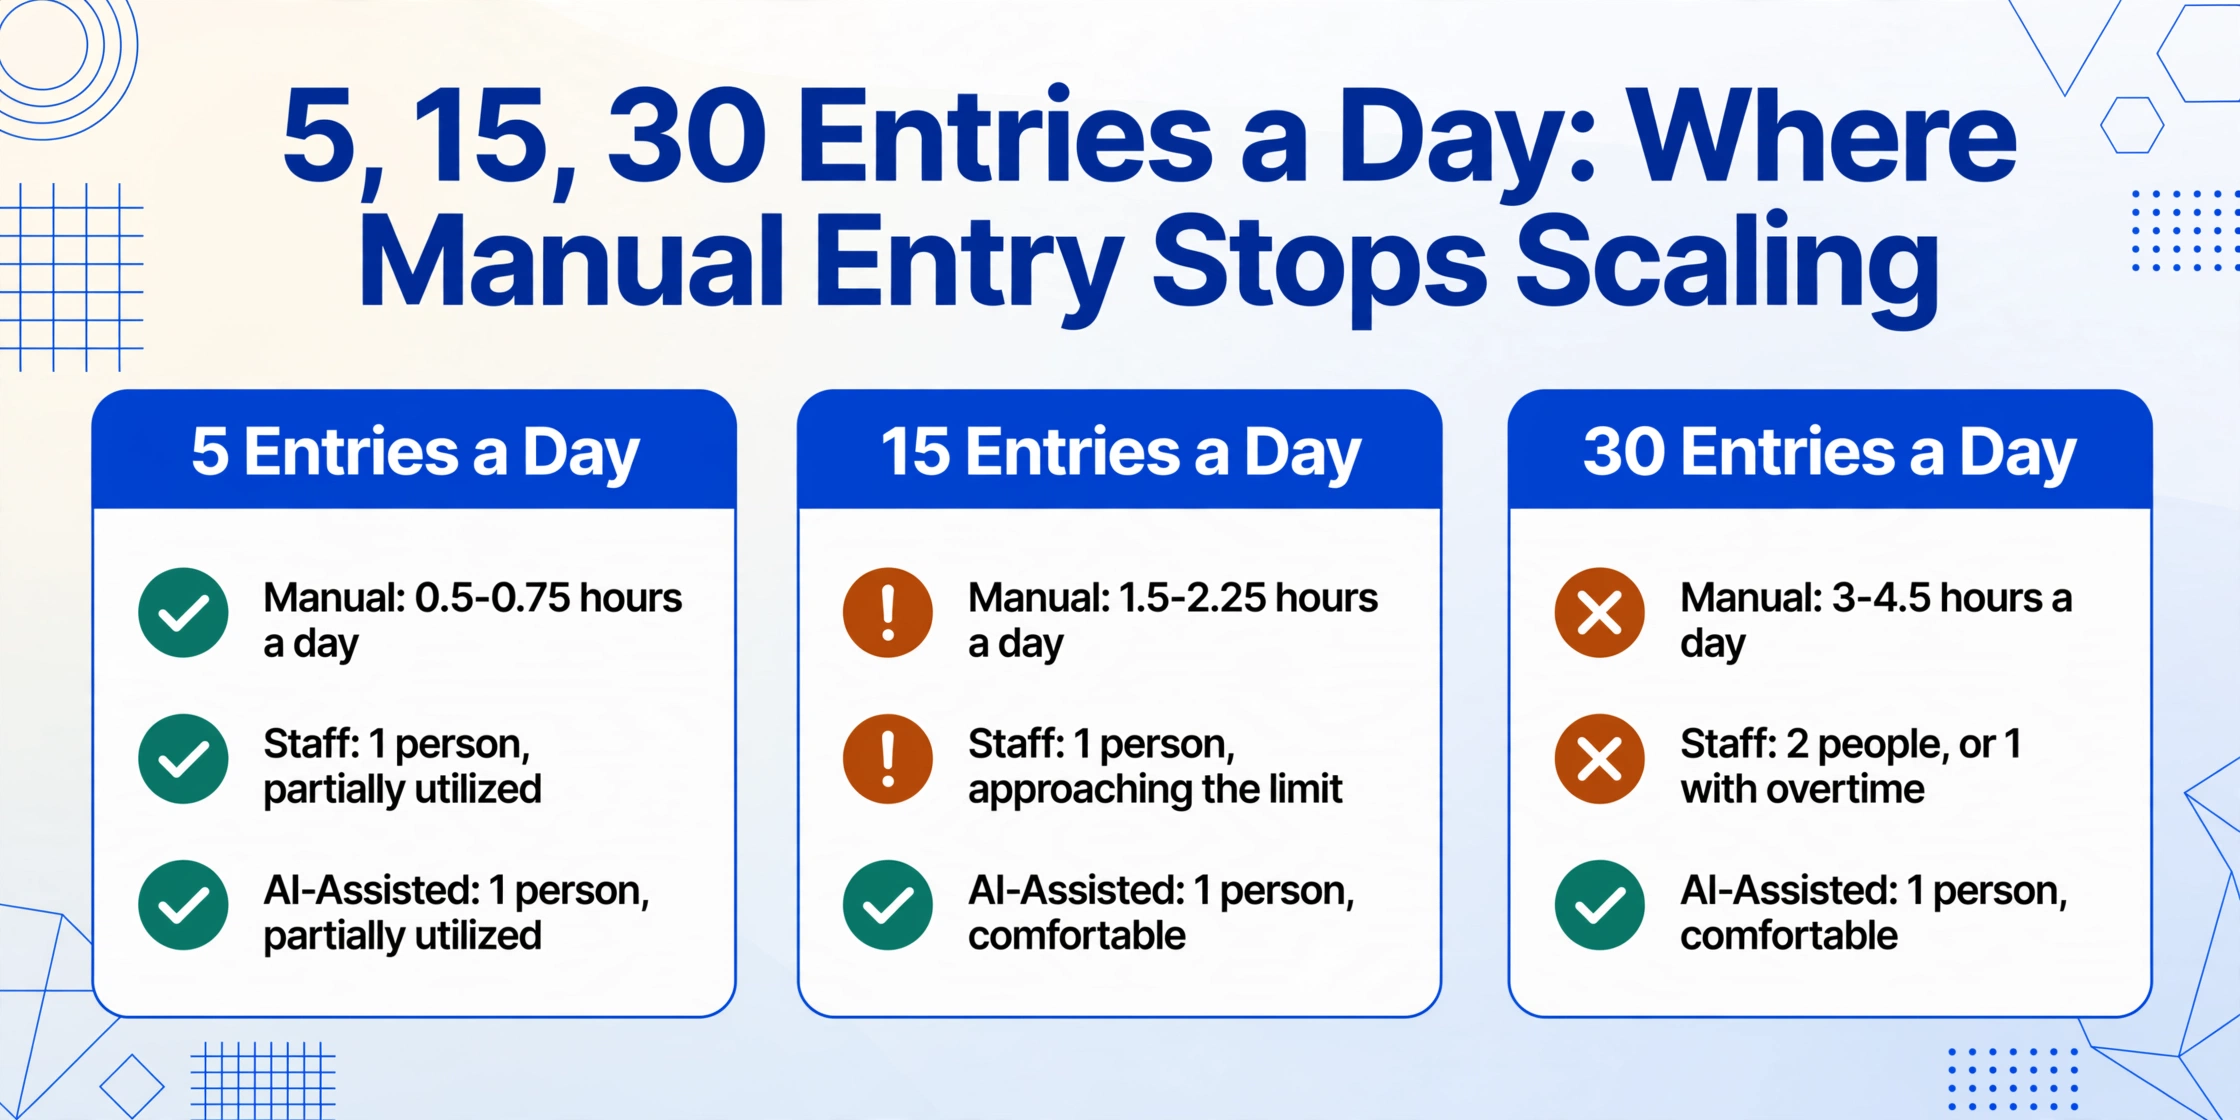
Die Skalierbarkeitsdimension ist der Punkt, an dem das Versagen des manuellen Workflows strukturell statt operativ wird. Unter 5 Anmeldungen pro Tag ist die manuelle Dateneingabe in Ordnung — sie ist nicht schnell, aber eine zusätzliche Einstellung wäre absurd. Zwischen 5 und 15 Anmeldungen pro Tag ist die Ineffizienz sichtbar, aber beherrschbar: Der Sachbearbeiter verbringt täglich 1-2 Stunden mit der Übertragung, was frustrierend ist, aber die Kapazität der Spedition nicht begrenzt.
Bei 20 Anmeldungen pro Tag — der Schwelle, ab der ein einzelner Sachbearbeiter an einem normalen Arbeitstag 2-3 Stunden rein mit der Datenerfassung verbringt — wird der manuelle Workflow zur Durchsatzgrenze. Ein weiterer Kunde oder eine weitere Handelsroute bedeutet eine weitere Stelle, und die Kosten sind nicht nur das Gehalt. Der Südafrika-Betrieb von Savino Del Bene liefert einen realistischen Maßstab: Bei der Verarbeitung von über 50.000 Handelsrechnungen pro Jahr für mehr als 2.000 Lieferanten verwendete das Unternehmen 80% seiner Zeit für die manuelle Dateneingabe. Nach der Einführung der Automatisierung der Dokumentenverarbeitung wurde die Rechnungsverarbeitung 11-mal schneller, und die prognostizierten monatlichen Einsparungen überstiegen $100.000.
Dies ist die Kapazitätsrechnung, die für Zollagenturen im größeren Maßstab entscheidend ist:
| Tägliches Anmeldevolumen | Manuelle Dateneingabe (Std./Tag) | Personalbedarf (manuell) | Personalbedarf (KI-gestützt) | Kapazitätsgrenze |
|---|---|---|---|---|
| 5 Anmeldungen | 0,5-0,75 Stunden | 1 (teilweise ausgelastet) | 1 (teilweise ausgelastet) | Nicht relevant |
| 15 Anmeldungen | 1,5-2,25 Stunden | 1 (nahe am Limit) | 1 (komfortabel) | ~20-25 Anmeldungen/Tag pro Person |
| 30 Anmeldungen | 3-4,5 Stunden | 2 (oder 1 mit Überstunden) | 1 (komfortabel) | Größe des verfügbaren geschulten Personals |
| 50+ Anmeldungen | 5-7,5 Stunden | 2-3 (plus Vertretung) | 1-2 | Einstellungspipeline begrenzt den Durchsatz |
Bei einer Spedition, die Mehrpositionsanmeldungen abwickelt — Sendungen mit 5 oder mehr Warenpositionen, die jeweils einen eigenen HS-Code, Wert, Menge und Ursprungsland benötigen — vervielfacht sich die Bearbeitungszeit pro Anmeldung. Eine Anmeldung mit 10 Positionen und manueller Dateneingabe kann 30-45 Minuten reine Übertragungszeit über alle Positionen hinweg beanspruchen. Mit KI-Extraktion werden alle 10 Warenpositionen im selben Verarbeitungszyklus aus denselben Quelldokumenten gelesen — 5-10 Sekunden pro Seite Quelldokument, nicht pro Warenposition. Hier verändert die Stapelverarbeitung von Zollanmeldungen mit mehreren Positionen in eine einzige Tabelle die Rechnung: 50 Mehrpositionsanmeldungen, die 25-37 Stunden manueller Übertragung erfordern würden, werden zu einer einzigen Upload- und Prüfsitzung, die in Minuten gemessen wird.
Eine Studie von Descartes Systems mit über 400 Spediteuren und Zollagenten ergab, dass 67% Technologie als grundlegend oder sehr wichtig für Wachstum betrachten — doch 61% nannten Preisdruck durch Kunden als größte Herausforderung. Der Konflikt ist klar: Speditionen müssen ihr Volumen steigern, um Margen zu halten, aber der manuelle Arbeitsablauf, der bei 20 Anmeldungen pro Tag funktioniert, funktioniert bei 50 nicht, und die Einstellung geschulter Zollfachkräfte ist eine der am häufigsten genannten Einschränkungen der Branche. Automatisierung löst den Personalmangel nicht — sie verändert die Personalrechnung, sodass bestehende Mitarbeiter Wachstum bewältigen können, ohne dass jeder neue Kunde einen proportionalen Personalaufbau erfordert.
Die Lerninvestition: Was die Einführung KI-gestützter Zolldateneingabe tatsächlich erfordert
Das stärkste Argument für den manuellen Arbeitsablauf ist, dass er keinerlei Technologieeinführung erfordert. Ein neu zugelassener Zollagent, der eine Handelsrechnung lesen und das ACE-Portal bedienen kann, kann am ersten Tag mit der Erstellung von Anmeldungen beginnen. Jeder Zollagent weiß bereits, welche Daten er extrahieren muss, in welchem Format sie vorliegen müssen und was passiert, wenn sie falsch sind. Der manuelle Prozess ist langsam, fehleranfällig und volumenbegrenzt — aber allgemein zugänglich. Jeder alternative Arbeitsablauf muss sich gegen einen Prozess behaupten, der nichts kostet und keine Schulung erfordert.
Die Lerninvestition für KI-gestützte Extraktion konzentriert sich auf ein einziges neues Muster: Statt jedes Dokument zu öffnen und Werte in die Anmeldungssoftware einzutippen, laden Sie alle Quelldokumente einer Sendung auf einmal hoch und definieren, was Sie extrahieren möchten, mithilfe von Spaltennamen — „Absendername", „Empfängeradresse", „HS-Code", „Ursprungsland", „Deklarierter Wert", „Nettogewicht". Die KI liest jedes Feld, indem sie dessen semantische Bedeutung versteht, nicht durch seine Position auf einem bestimmten Formular. Einmal definiert, können diese Spaltensätze gespeichert und wiederverwendet werden — ein Importeur, der dieselben Anmeldungsarten über dieselben Handelsrouten einreicht, verwendet jedes Mal dieselbe Spaltenvorlage. Der Aufwand pro Anmeldung wird zu: Dokumente hochladen, gespeicherte Vorlage auswählen, Extraktionstabelle exportieren, prüfen.
Dies unterscheidet sich grundlegend von traditionellen OCR-Vorlagensystemen, die die Konfiguration einer separaten Vorlage für jedes Dokumentformat erfordern — die CBP-7501-Vorlage, die EU-SAD-Vorlage, die chinesische Exportdeklarationsvorlage sowie jedes Lieferanten-Rechnungsformat. Die Wartungslast der Vorlagen war es, die frühere Generationen der Zollautomatisierung scheitern ließ, insbesondere bei Speditionen mit Lieferanten aus mehreren Ländern, deren Dokumentformate sich ohne Vorankündigung ändern. KI-Extraktion umgeht dies, weil sie nach Bedeutung liest, nicht nach Position auf einem bekannten Formularlayout.
Zum Vergleich: Eine EDI-Implementierung, die eine Zollagentur mit dem ERP-System eines Kunden verbindet, kann Monate für Mapping, Tests und Zertifizierung dauern – und sie funktioniert nur mit diesem einen Kunden. Die Einführung einer vollständigen Zollverwaltungsplattform kann Wochen dauern, erfordert IT-Beteiligung und setzt voraus, dass alle Handelsdaten durch dasselbe System fließen. Die KI-gestützte Extraktion hat eine Lernkurve, die sich in der Zeit bemisst, die zum Hochladen eines Dokuments und zur Eingabe eines Spaltennamens benötigt wird. Bei 20 Einträgen pro Tag wird der Zeitaufwand für das Erlernen des neuen Musters – etwa 15–30 Minuten, in denen man es mit einigen Beispieleinträgen ausprobiert – bereits am ersten Tag der Nutzung wieder hereingeholt.
Die Spaltendefinitionen, die Sie für Zolleinträge erstellen, können auch für andere Handelsdokumente verwendet werden – Handelsrechnungen, Packlisten, Ursprungszeugnisse –, da die Extraktions-Engine nicht zwischen Dokumenttypen unterscheidet. Dieselbe gespeicherte Vorlage, die HS-Codes und angegebene Werte aus einem Zollformular extrahiert, extrahiert auch Rechnungsnummern und Summen aus einer Handelsrechnung, wenn sie auf dieses Dokument angewendet wird. Diese dokumentübergreifende Wiederverwendbarkeit bedeutet, dass die Vorlagenbibliothek mit der Nutzung wächst und nicht mit der Anzahl der Dokumentformate.
Wo die manuelle Erfassung weiterhin überlegen ist – und wo die Lücke unüberbrückbar bleibt
Ein dimensionaler Vergleich ist nur dann nützlich, wenn er beide Seiten ehrlich betrachtet. Der manuelle Workflow hat tatsächlich Vorteile, die die KI-gestützte Extraktion nicht beseitigt, und diese anzuerkennen verleiht dem restlichen Vergleich Gewicht:
- Keine Grenzkosten. Die manuelle Erfassung erfordert eine geschulte Person und Zugang zu Anmeldesoftware – beides hat die Agentur bereits. Für Betriebe mit weniger als 5 Einträgen pro Tag decken die Zeitersparnisse der Automatisierung die Werkzeugkosten nicht. Unterhalb dieser Menge ist der manuelle Workflow die wirtschaftlich rationale Wahl.
- Kontextuelles Urteilsvermögen, das in Dokumenten nicht vorhanden ist. Ein erfahrener Agent, der eine Handelsrechnung liest, könnte bemerken, dass der angegebene Wert für die beschriebenen Waren verdächtig niedrig ist – ein Warnsignal für Verrechnungspreise, das eine KI-Extraktion nicht kennzeichnet, weil sie nur liest, was auf der Seite steht, nicht was fehlt. Dieses institutionelle Wissen – „dieser Lieferant unterbewertet Elektronik auf seinen Rechnungen konsequent und wird bei CBP auffällig“ – lebt im Kopf des Agents, nicht in einem Dokument, und kommt bei der manuellen Prüfung auf eine Weise zum Vorschein, die die automatisierte Extraktion nicht nachbildet.
- Kommunikation mit mehreren Parteien. Wenn ein Zolleintrag eine CBP-Anfrage um Informationen (CBP-Formular 28) oder eine Mitteilung über eine Maßnahme (CBP-Formular 29) auslöst, erfordert die Antwort Kommunikation mit dem Importeur, dem Lieferanten und möglicherweise einem Handelsanwalt. Dieser Workflow ist von Natur aus menschlich – kein Extraktionstool automatisiert ihn, und keines sollte es versuchen. Die Beziehungspflege und die regulatorischen Kommunikationsfähigkeiten des Agents sind hier der Wert, nicht der Datenerfassungsschritt, der der Anfrage vorausging.
- Integration mit der Schnittstelle der Regierungsanmeldung. Die KI-Extraktion erzeugt eine Tabelle strukturierter Daten. Um diese Daten in ACE, CDS oder ATLAS zu bringen, ist weiterhin entweder eine manuelle Wiedereingabe in das Anmeldesystem oder eine Software-Integrationsschicht erforderlich. Einige Zollverwaltungsplattformen (Descartes, AEB, iCustoms) bieten API-Verbindungen, die strukturierte Daten direkt akzeptieren, aber Agenturen mit eigenständigen oder veralteten Anmeldesystemen haben weiterhin einen manuellen Übertragungsschritt von der extrahierten Datentabelle in die Anmeldesoftware – es sei denn, sie verwenden das Extraktionsergebnis als Prüfquelle statt als direkte Eingabe.
Die Dimensionen, bei denen manuelle Eingabe verliert — und zwar in direktem Verhältnis zum Volumen — sind Geschwindigkeit, Übertragungsgenauigkeit und Skalierbarkeit. Diese Dimensionen verstärken sich gegenseitig: Eine Spedition, die bei 20 Einträgen täglich 1,5 Stunden Übertragungszeit spart, kann mehr Einträge bewältigen, ohne Personal aufzustocken, kann die gewonnene Zeit für Compliance-Prüfungen statt für Dateneingabe nutzen und kann die Fehlerquote senken, die die häufigste Ursache für CBP-Strafandrohungen darstellt. Die 7 häufigsten Fehler bei der Zolldateneingabe, die Verzögerungen bei der Abfertigung verursachen, sind überwiegend Übertragungs- und dokumentübergreifende Konsistenzfehler — genau die Kategorien, die KI-Extraktion adressiert.
Die Time-Release-Study-Methodik der Weltzollorganisation — mittlerweile in der 4. Version — hat wiederholt festgestellt, dass der primäre Engpass bei der Frachtabfertigung nicht die physische Inspektion, nicht die Hafenüberlastung, sondern die Zeit zwischen Dokumenteingang und Abgabe der Zollanmeldung ist. In Pilotprogrammen der Weltbank zur TRS verkürzte Grenzautomatisierung die Abfertigung in Ländern, die digitale Vorabklärung und Single-Window-Koordination einführten, von durchschnittlich 3,6 Tagen auf unter 1 Tag. Der Schritt der Anmeldungserstellung — in dem die manuelle Dateneingabe stattfindet — ist die größte Einzelmöglichkeit zur Zeitersparnis im gesamten Abfertigungsprozess. Das ist keine Verkaufsbehauptung. Es ist das, was die eigene Messmethodik der WCO durchgängig feststellt.
Häufig gestellte Fragen zu manueller vs. KI-gestützter Zolldateneingabe
Ab welchem Eingabevolumen sollte eine Zollspedition von manueller auf KI-gestützte Dateneingabe umstellen?
Bei etwa 10–15 Einträgen pro Tag. Darunter rechtfertigt die Zeitersparnis durch Automatisierung möglicherweise nicht den Lernaufwand, um den Wechsel zu rechtfertigen — insbesondere für Speditionen mit einem stabilen Kundenstamm und vertrauten Dokumentformaten, bei denen der Bearbeiter durch Wiederholung Geschwindigkeit entwickelt. Bei 20+ Einträgen pro Tag verbraucht der manuelle Arbeitsablauf 2–3 Stunden Übertragungszeit, die wiedergewonnen werden könnte, und die Kosten für die Automatisierung dieses Schritts sind niedriger als die Kosten für die Einstellung zusätzlichen Personals für dasselbe Volumen. Der Break-even-Punkt hängt von Ihren Lohnkosten pro Stunde und Ihrem täglichen Eingabevolumen ab, liegt aber für die meisten Speditionen zwischen 10 und 20 täglichen Einträgen.
Wie unterscheidet sich die KI-Extraktion von EDI für Zollanmeldungen?
EDI (Electronic Data Interchange) ist ein maschinen-zu-maschinen-Austausch strukturierter Daten zwischen Systemen, die bereits dasselbe Format verstehen – zum Beispiel überträgt das ERP-System eines Kunden Bestelldaten direkt an das Meldesystem eines Zollagenten in einem vorab vereinbarten Datenformat. EDI funktioniert, wenn beide Parteien in die Integration investiert haben und kompatible Datenstrukturen pflegen. Die KI-Extraktion liest unstrukturierte Dokumente – PDFs, Scans, Bilder – die von Lieferanten stammen, die niemals EDI implementieren werden, weil es sich um Fabriken in Shenzhen, Händler in Mumbai oder kleine Hersteller in Vietnam handelt, die Handelsrechnungen als E-Mail-Anhänge versenden. EDI und KI-Extraktion adressieren unterschiedliche Teile der Dokumentenlieferkette: EDI für große Kunden mit integrierten Systemen, KI-Extraktion für den langen Schwanz an Lieferanten und Formaten, die den Großteil der Handelsdokumentation ausmachen.
Ersetzt die KI-Extraktion einen Zollagenten?
Nein. Sie ersetzt den Schritt der Datentranskription – das Lesen von Werten aus Dokumenten und deren Eingabe in Software. Sie ersetzt nicht und kann nicht ersetzen: die Klassifizierungsexpertise, das regulatorische Wissen, die Analyse von Handelsprogrammen, die Kundenberatung oder die Kommunikation mit der CBP, die den eigentlichen professionellen Dienst der Zollagentur ausmachen. Die in diesem Vergleich beschriebene Automatisierung betrifft die Pipeline vom Dokument zu den Daten, nicht das Urteilsvermögen des Agenten. Ein Zollagent, der KI-Extraktion nutzt, klassifiziert weiterhin Waren, prüft weiterhin die Anwendbarkeit von Freihandelsabkommen, bearbeitet weiterhin CBP-Anfragen und berät Kunden weiterhin in Bezug auf Compliance-Strategien. Der Unterschied besteht darin, dass der Agent weniger Zeit mit der Transkription von Rechnungsdaten und mehr Zeit mit den Schritten verbringt, die eine Lizenz und professionelle Expertise erfordern.
Mit welchen Dokumentformaten arbeitet die KI-Extraktion für Zolleinträge?
PDF-Dateien (sowohl digital erzeugt als auch gescannt), JPG/PNG-Bilder, WebP und AVIF werden alle unterstützt. Dies deckt die realistische Bandbreite an Handelsdokumenten ab: ERP-generierte PDFs, gescannte Handelsrechnungen, Fotos von Papierpacklisten und Screenshots von Lieferantenportalen. Handschrift auf gescannten Dokumenten ist lesbar, wobei die Genauigkeit mit der Scanqualität abnimmt – ein sauberer Scan mit 300 DPI erzeugt eine nahezu perfekte Extraktion, während ein niedrig aufgelöstes Handyfoto einer handschriftlichen Packliste in einem Winkel eine manuelle Überprüfung bestimmter Felder erfordern kann.
Kann die KI-Erfassung Handelsdokumente in mehreren Sprachen verarbeiten?
Ja. Das zugrunde liegende visuelle Sprachmodell liest Text in jeder Sprache. Eine chinesische Exportzollanmeldung, eine deutsche Handelsrechnung, eine spanische Packliste und ein koreanisches Ursprungszeugnis werden alle auf dieselbe Weise verarbeitet – in Englisch definierte Spaltennamen leiten die Erfassung, und die KI findet die entsprechenden Werte unabhängig von der Sprache des Quelldokuments. Numerische Felder – Werte, Gewichte, Mengen, HS-Codes – werden sauber und sprachunabhängig erfasst. Für Speditionen, die Handelsrouten über Asien, Europa und Amerika abwickeln, entfällt damit die sprachspezifische Reibung, die andernfalls zweisprachiges Personal für die Dateneingabe erfordert.
Können Erfassungsspalten-Definitionen über Einträge und Kunden hinweg wiederverwendet werden?
Ja. Ein Standardsatz an Spalten für Importeinträge – Importeur (Importer of Record), Empfänger, Ursprungsland, HS-Code, Warenbeschreibung, Menge, Maßeinheit, Erklärter Wert, Währung, Zollsatz, Bruttogewicht, Frachtbriefnummer – kann einmal definiert, in Ihrem Konto gespeichert und mit einem Klick auf jeden weiteren Eintrag angewendet werden. Für Speditionen, die verschiedene Eintragsarten bearbeiten (formelle Verbrauchseinträge vs. informelle Einträge vs. vorübergehende Importbürgschaften), können mehrere Spaltenvorlagen für jede Eintragsart gespeichert werden. Die Vorlagenbibliothek wächst mit der Nutzung, nicht mit der Anzahl der Dokumentformate, die Ihnen begegnen.
Weist die KI-Erfassung HS-Codes automatisch zu?
Einige spezialisierte Zoll-KI-Plattformen (Digicust, iCustoms) bieten HS-Code-Vorschläge und Klassifizierungsunterstützung als separates Feature an. ImageToTable.ai's Erfassung liest den HS-Code, wenn er bereits auf dem Dokument aufgedruckt ist – zum Beispiel, wenn ein Lieferant den HTS-Code auf seiner Handelsrechnung angibt. Es klassifiziert keine Produkte ohne Code und schlägt keine HS-Codes für Artikel vor, die keine gedruckte Zolltarifklassifizierung aufweisen. Der Klassifizierungsschritt bleibt eine menschliche Entscheidung, die auf der Expertise des Zollagenten, den Allgemeinen Auslegungsregeln und den CBP-Richtliniendatenbanken basiert. Wenn Sie KI-gestützte Klassifizierung benötigen, suchen Sie nach zollspezifischen Plattformen, die Erfassung mit Klassifizierung kombinieren. Wenn Sie Erfassung aus Dokumenten benötigen, in denen HS-Codes bereits vorhanden, aber in inkonsistenten Formaten verborgen sind, bewältigt das Tool dies direkt.
Lässt sich die extrahierten Daten direkt in das ACE-System der CBP integrieren?
Nein – und das ist ein wichtiger Unterschied. Die Extraktion erzeugt strukturierte Daten im Excel-, CSV- oder JSON-Format. Um diese Daten in das ACE-Portal, CDS oder ATLAS zu übertragen, ist entweder eine manuelle Eingabe oder eine Software-Integrationsschicht erforderlich. Maklerfirmen, die Zollverwaltungsplattformen mit API-Konnektivität (Descartes, AEB, WiseTech's CargoWise) nutzen, können strukturierte Daten möglicherweise direkt importieren. Maklerfirmen, die direkt über das ACE Secure Data Portal einreichen, müssen die extrahierten Daten entweder manuell in das Portal übertragen oder ein Maklerverwaltungssystem mit Datenimportfunktion verwenden. Die Extraktion eliminiert den Schritt vom Quelldokument zu strukturierten Daten. Sie eliminiert nicht den Schritt von strukturierten Daten zum Einreichungssystem, es sei denn, Ihre Einreichungssoftware unterstützt dies.
Zollabfertigung ist ein Beruf mit hohem Einsatz, bei dem ein einziger falsch klassifizierter HTS-Code eine rückwirkende Prüfung über fünf Jahre auslösen kann. Die Frage, die dieser Vergleich beantwortet, ist nicht, ob KI die manuelle Eingabe überflüssig macht – das tut sie nicht, und für Speditionen mit weniger als 10 Sendungen pro Tag bleibt die manuelle Eingabe die rationale Standardlösung. Die Frage ist, ab welchem Volumen sich die Wirtschaftlichkeit umkehrt. Bei 20 Sendungen pro Tag verbraucht der manuelle Arbeitsablauf 2-3 Stunden Transkriptionszeit, die wiedergewonnen werden könnte. Bei 50 Sendungen verbraucht er das Gehalt einer Vollzeitkraft nur für Tipparbeit. Die Extraktionstechnologie existiert. Die WCO, FIATA und die nationalen Zollbehörden bewegen sich alle in Richtung digitalisierter Handelsdokumente. Die Entscheidung für jede Spedition ist, wann – nicht ob – der Schritt des Dokumentenlesens vom Schritt der Zollfachexpertise getrennt wird und lizenzierte Fachkräfte nicht mehr für Arbeiten bezahlt werden, die eine Maschine besser kann.
Verwandt: So extrahieren Sie Daten aus Zollanmeldeformularen in Excel · Batch-Verarbeitung von Zollanmeldungen aus mehreren Ländern in einer Tabelle · 7 Fehler bei der Zolldateneingabe, die Verzögerungen bei der Abfertigung verursachen