Entrada de datos aduaneros manual vs. IA:
¿Cuál sobrevive a 20 entradas al día?
En el año fiscal 2025, U.S. Customs and Border Protection procesó 50 millones de resúmenes de entrada, emitió 2,432 sanciones comerciales y recuperó $34.41 mil millones de revisiones de resúmenes de entrada. Cada una de esas entradas comenzó como datos extraídos de una factura comercial, lista de empaque o conocimiento de embarque y transcritos a una declaración, un paso que sigue siendo predominantemente manual en la mayoría de las agencias de aduanas. Esta comparación mide lo que ese paso realmente cuesta en tiempo, error y rendimiento, y en qué volumen el flujo de trabajo manual deja de ser manejable.
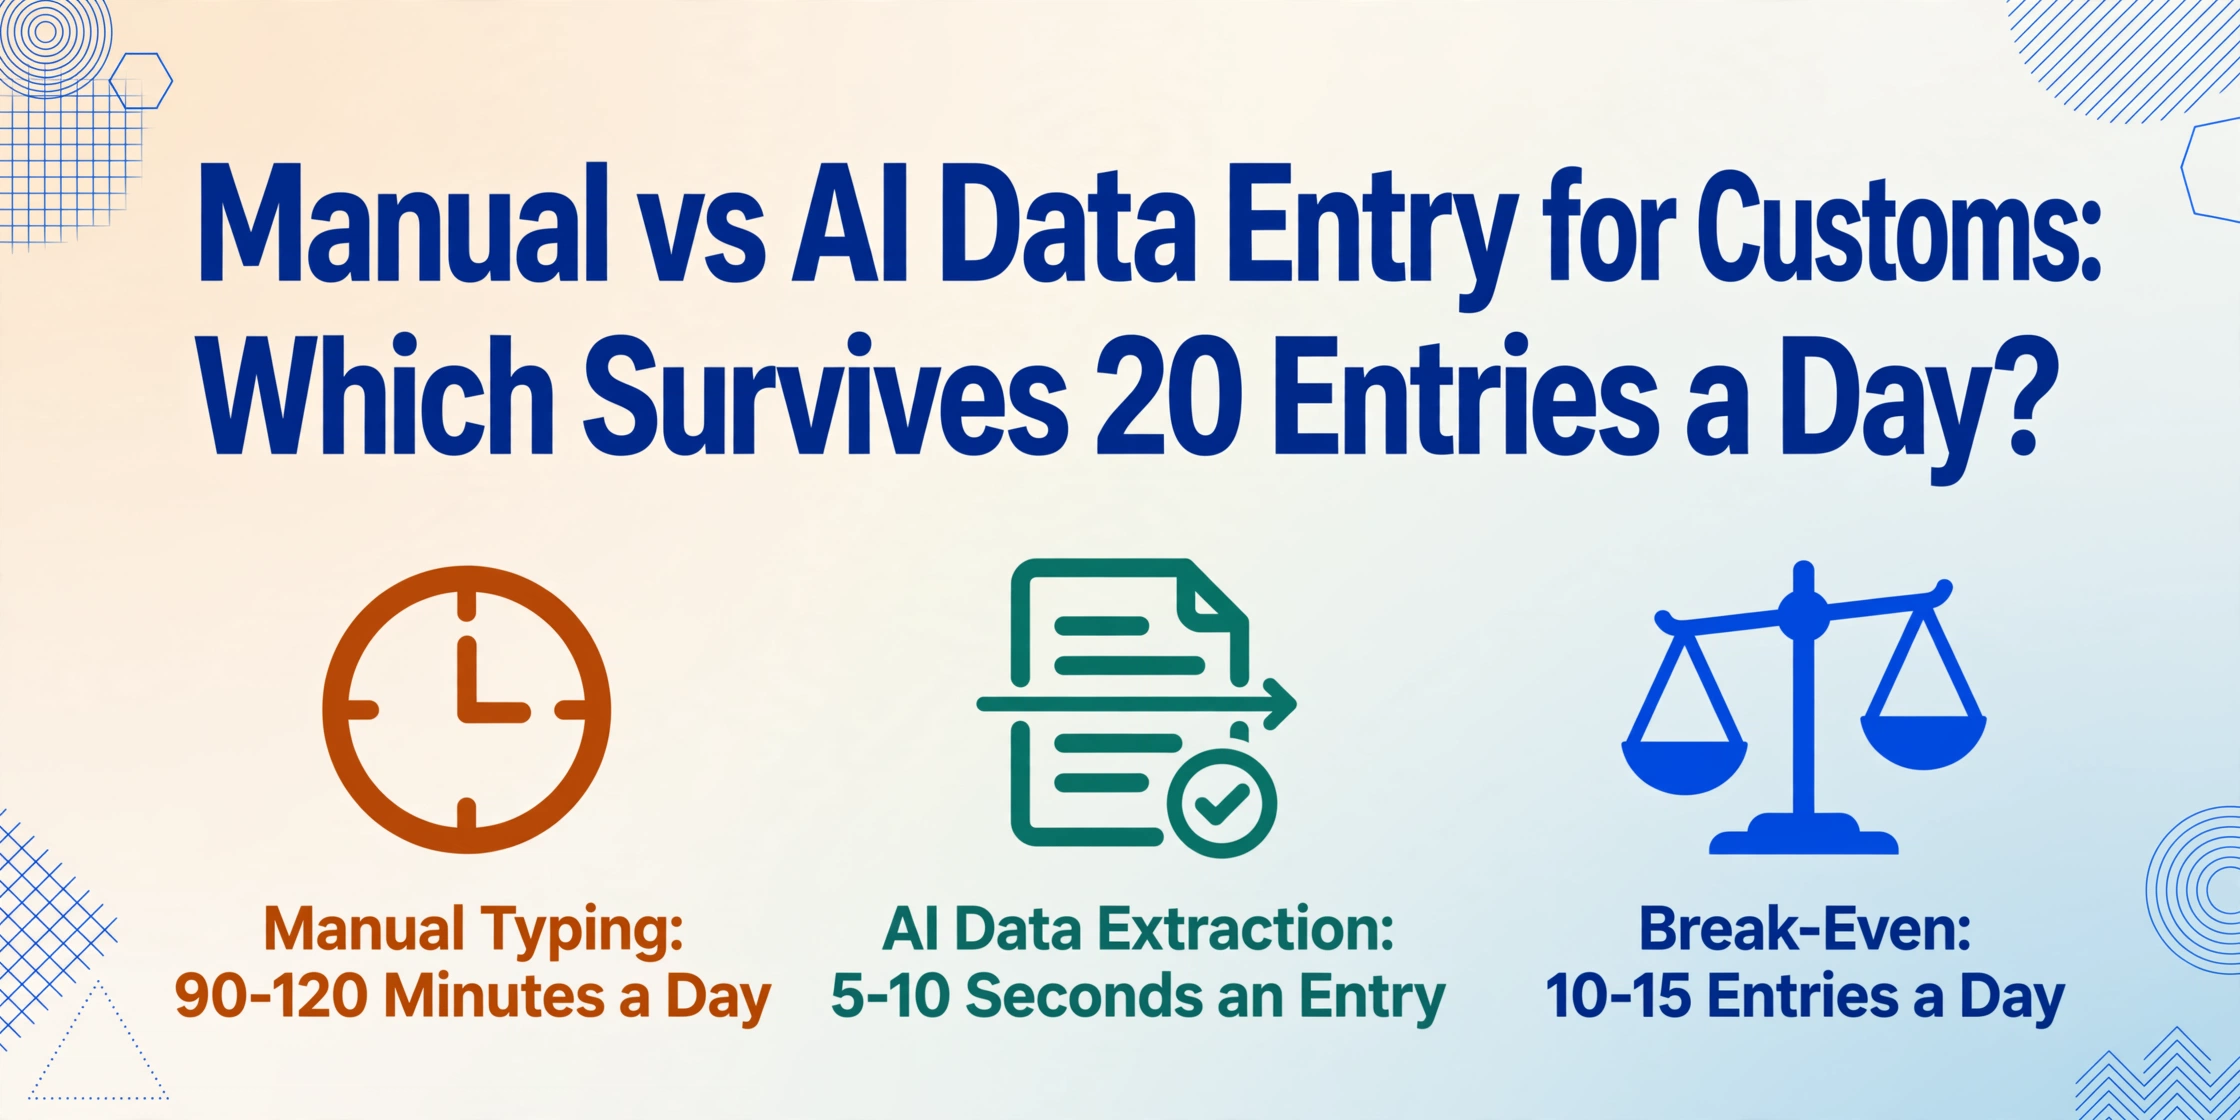
Conclusiones clave
- Del 60 al 70 por ciento del tiempo de preparación de cada entrada aduanera se consume no en la clasificación o el cumplimiento — el trabajo para el que se obtuvo la licencia de agente — sino en leer valores de las facturas de los proveedores y volver a escribirlos manualmente.
- Con 20 entradas al día, el paso de transcripción manual consume de 7.5 a 10 horas semanales — un día laboral completo — y cada hora de esa escritura conlleva el riesgo de un dígito incorrecto que puede desencadenar una auditoría aduanera que se remonta cinco años atrás.
- Por debajo de 10 entradas al día, la escritura manual es económicamente racional, pero por encima de 20 los números se invierten — contratar personal para mantener el ritmo cuesta más que eliminar el paso de transcripción, e ImageToTable.ai extrae cada campo de cada documento en menos de 10 segundos por página.
Qué sucede realmente durante la preparación manual de la declaración de aduanas
El proceso de presentación de la declaración de aduanas — el envío formal de datos al sistema ACE de CBP, al CDS de HMRC, a las autoridades aduaneras de los Estados miembros de la UE — ya es digital. Lo que no es digital, en la mayoría de las agencias de aduanas, es el paso previo a la presentación: extraer los datos comerciales de los documentos de origen y escribirlos en el software de declaración. Esta es la brecha que la mayoría de las discusiones sobre automatización pasan por alto. Las conexiones EDI y API gestionan la transferencia de máquina a máquina entre sistemas que ya contienen datos estructurados. No leen una lista de empaque escaneada de una fábrica en Shenzhen.
El flujo de trabajo manual para preparar una sola entrada de aduanas se divide en cinco pasos:
Recibir y clasificar los documentos de origen
Factura comercial, lista de empaque, conocimiento de embarque o guía aérea, certificado de origen: un solo envío puede generar más de 10 documentos de diferentes partes, en diferentes formatos, que llegan por diferentes canales (correo electrónico, unidad compartida, descarga del portal). Un estudio de agentes de carga encontró que el 40% de las demoras aduaneras se originaron por discrepancias entre estos documentos antes de que siquiera comenzara la preparación de la entrada.
Ubicar y transcribir los campos de datos en el software de declaración
El operador lee la factura comercial, encuentra el nombre del remitente, la dirección del consignatario, la descripción de la carga, la cantidad, el peso, el valor declarado, la moneda, los Incoterms, el país de origen y el código HS, y luego escribe cada uno en el campo correspondiente del sistema de declaración. Solo un formulario CBP 7501 tiene 47 bloques de datos. Para una entrada de varias líneas con 5 líneas de mercancías, el operador maneja aproximadamente de 35 a 50 puntos de datos distintos por entrada, alternando entre ventanas para cada uno.
Verificar la coherencia de los datos entre los documentos
La cantidad en la factura debe coincidir con la lista de empaque. El valor declarado debe ser coherente con el total de la factura comercial. El código HS debe coincidir con la descripción de la carga. Estas comprobaciones son manuales y secuenciales: el operador lee el documento A, lee el documento B y compara mentalmente. A las 4 de la tarde de un viernes con 8 entradas aún en la cola, la verificación de coherencia es el primer paso que se comprime u omite.
Clasificar las mercancías y aplicar la lógica de los programas comerciales
El operador determina el código HS correcto, aplica las preferencias de los acuerdos de libre comercio, verifica la aplicabilidad de ADD/CVD y confirma los requisitos de las PGA (FDA, USDA, EPA). Este es el paso donde más importa el conocimiento aduanero, y también es el paso donde incluso los agentes experimentados cometen errores de clasificación que provocan auditorías de CBP. Un código HTS mal clasificado puede pagar aranceles de menos durante meses de entradas antes de que se detecte en una evaluación enfocada.
Presente la declaración, gestione los rechazos y obtenga el MRN
La declaración se transmite electrónicamente a la autoridad aduanera. Si pasa la validación, el número de referencia del movimiento (MRN) o el número de entrada se devuelve en segundos. Si falla — por un código HTS no coincidente, un elemento de datos PGA faltante o un EORI no válido — se recibe el mensaje de rechazo y el operador comienza a solucionar el problema. Una sola entrada rechazada puede consumir tanto tiempo como tres entradas correctas.
Los pasos 2 y 3 — localizar los datos en los documentos y transcribirlos — suelen consumir el 60-70% del tiempo total de preparación de la entrada. Los pasos 4 y 5, que requieren experiencia y criterio aduanero, representan el 30-40% restante. Esta proporción es lo que hace que la comparación entre manual y automatizado sea significativa: los pasos que consumen más tiempo son los mecánicos, no los que requieren experiencia. La investigación de DHL confirma que el 80% de los retrasos aduaneros se originan por documentación incorrecta o faltante — no por atrasos en la inspección física o congestión portuaria — lo que significa que el paso de traducción de documento a sistema es donde se encuentra el cuello de botella estructural.
Esta inversión del esfuerzo — donde el trabajo mecánico consume más tiempo que el trabajo especializado — es el patrón que define cuándo los flujos de trabajo manuales fallan. También define dónde la automatización realmente ayuda: no en reemplazar la experiencia aduanera, sino en eliminar la barrera de transcripción que consume el tiempo antes de que se pueda aplicar la experiencia. Para una mirada más profunda sobre por qué este patrón persiste en toda la industria, consulte nuestro análisis de las razones estructurales por las que la gestión de datos aduaneros sigue siendo un cuello de botella en las operaciones de carga.
Velocidad: qué significa realmente «3 minutos por documento» en una semana de 100 declaraciones
Una sola página de datos impresos tarda aproximadamente 3 minutos en transcribirse manualmente: localizar cada campo, escribirlo y verificarlo. Este es el promedio entre operadores de entrada de datos con experiencia en condiciones de trabajo normales. Las investigaciones sobre operadores de entrada de datos cualificados encuentran sistemáticamente tasas de error de entre el 0,5 % y el 1 % incluso en condiciones controladas, y esas tasas aumentan a lo largo de la jornada laboral. El mismo operador que escribe con una precisión del 1 % a las 9 de la mañana produce más de un 3 % de errores al final de la tarde, a medida que se instala la fatiga cognitiva.
Para un agente de aduanas que gestiona 20 declaraciones al día —un volumen típico para una agencia pequeña o mediana—, el cálculo es sencillo: 20 declaraciones × 3 minutos de extracción de datos por declaración = 60 minutos. En la práctica, teniendo en cuenta la clasificación de documentos, la verificación cruzada y el manejo de inconsistencias de formato, la cifra real se acerca a los 90-120 minutos diarios dedicados únicamente a la transcripción de datos. En una semana de cinco días con 100 declaraciones, eso supone entre 7,5 y 10 horas, es decir, prácticamente una jornada laboral completa a la semana consumida por un paso que no aporta conocimientos aduaneros y que genera la mayoría de los errores.
Así se desglosa el tiempo por declaración en ambos flujos de trabajo para una declaración estándar de una sola línea:
| Tarea | Flujo de trabajo manual (por declaración) | Flujo de trabajo asistido por IA (por declaración) |
|---|---|---|
| Recibir y clasificar documentos | 2-3 minutos | 2-3 minutos (sin cambios: los documentos siguen llegando por los canales existentes) |
| Localizar y transcribir campos de datos | 3-5 minutos | 5-10 segundos (cargue todos los documentos; la IA extrae los datos estructurados) |
| Verificar la coherencia de los documentos | 2-4 minutos | 1-2 minutos (revise la tabla extraída por IA para detectar discrepancias marcadas) |
| Clasificar mercancías y aplicar programas comerciales | 2-5 minutos | 2-5 minutos (sin cambios: requiere experiencia aduanera) |
| Presentar, gestionar rechazos y obtener el MRN | 1-3 minutos | 1-3 minutos (sin cambios: la presentación electrónica es independiente del método de extracción) |
| Total por declaración | 10-20 minutos | 6-13 minutos |
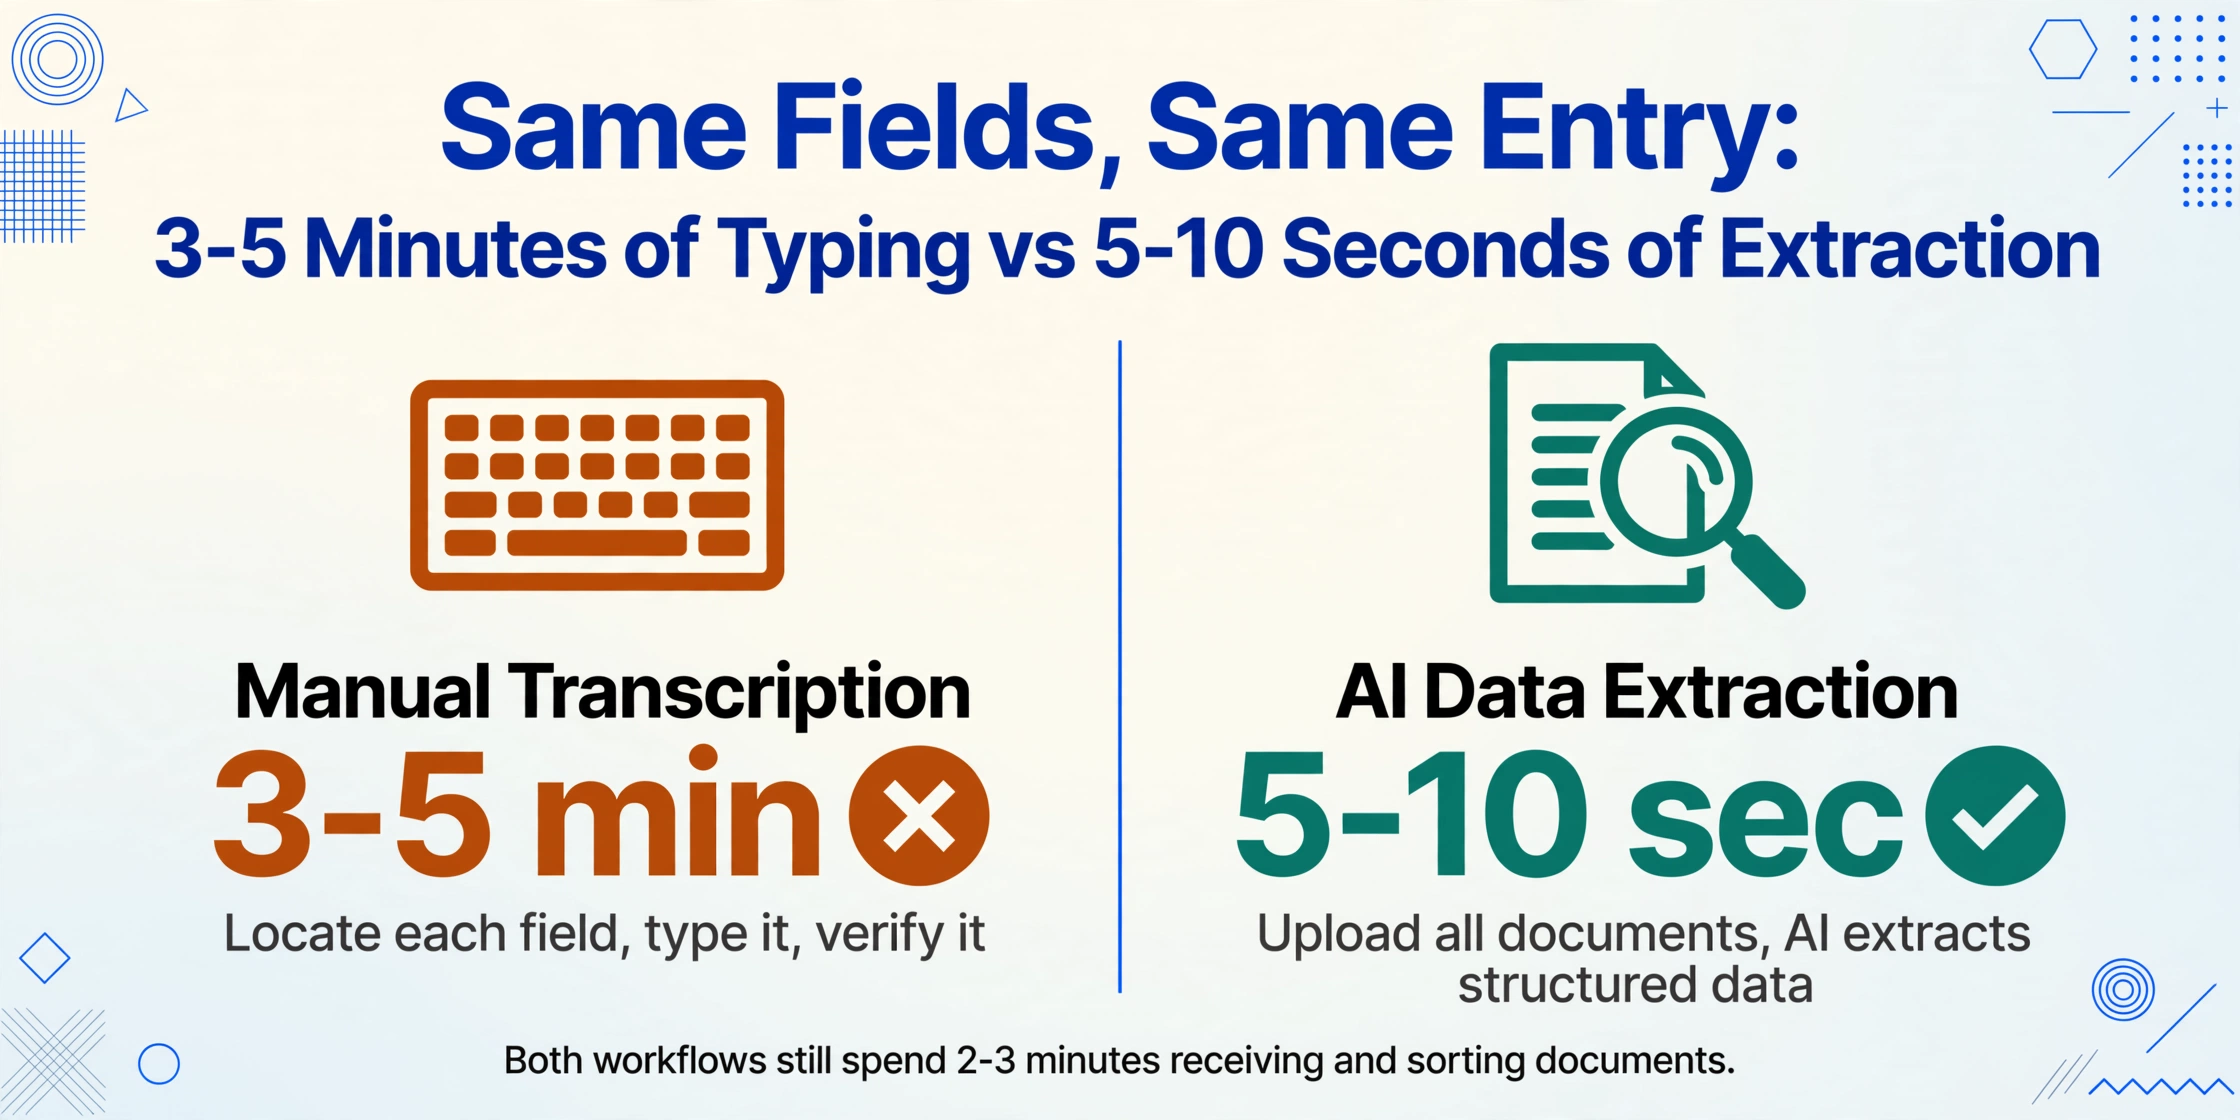
La extracción en sí se reduce de 3-5 minutos por declaración a 5-10 segundos. Con 20 declaraciones al día, se recuperan aproximadamente 1-1.5 horas — no de todo el proceso de preparación de la declaración, sino específicamente del trabajo mecánico de transcripción. Los pasos de clasificación, presentación y cumplimiento normativo no cambian ni en tiempo ni en calidad, porque no se benefician de una escritura más rápida. Se benefician de que el operador tenga más capacidad mental al llegar a ellos.
El mecanismo que produce esta velocidad es la extracción por nombre de columna: en lugar de leer cada documento y transcribir campo por campo, usted define los puntos de datos que desea — «código HS», «valor declarado», «país de origen», «nombre del consignatario» — y la IA localiza cada valor en cualquier parte de la página comprendiendo su significado semánticamente. Un campo etiquetado como «商品编码» en una declaración de exportación china, «HS Code» en un CBP 7501 y «Commodity Code» en un SAD de la UE se asignan todos a la misma columna en su salida, sin configuración de plantilla por formato. Para obtener una guía detallada de este enfoque en distintos formatos de declaración, consulte cómo extraer datos de formularios de declaración de aduanas a Excel.
Los archivos se procesan de forma segura y no se almacenan.
El tiempo de procesamiento de 5-10 segundos por página, en comparación con los aproximadamente 3 minutos por página de transcripción manual, significa que la ventaja de velocidad se acumula directamente con el volumen — pero solo en el paso de extracción. Los pasos de toma de decisiones mantienen el mismo ritmo porque la experiencia aduanera es el valor, no el cuello de botella. Un agente que gestiona 10 declaraciones al día ahorra aproximadamente 30-50 minutos. Uno que gestiona 50 ahorra 2.5-4 horas. El punto de inflexión donde el ahorro de tiempo cruza al territorio de «esto cambia cómo organizo mi día» se sitúa en torno a 20-25 declaraciones diarias.
Precisión: Tres tipos de errores en las declaraciones de aduanas — y cuáles elimina realmente la automatización
La palabra «precisión» se usa con ligereza en el marketing de automatización, pero los errores en las declaraciones de aduanas no son una sola categoría. Se dividen en tres tipos distintos, y la automatización aborda cada uno de manera diferente. Ser preciso sobre cuáles elimina y cuáles no es la diferencia entre una comparación honesta y un discurso de ventas.
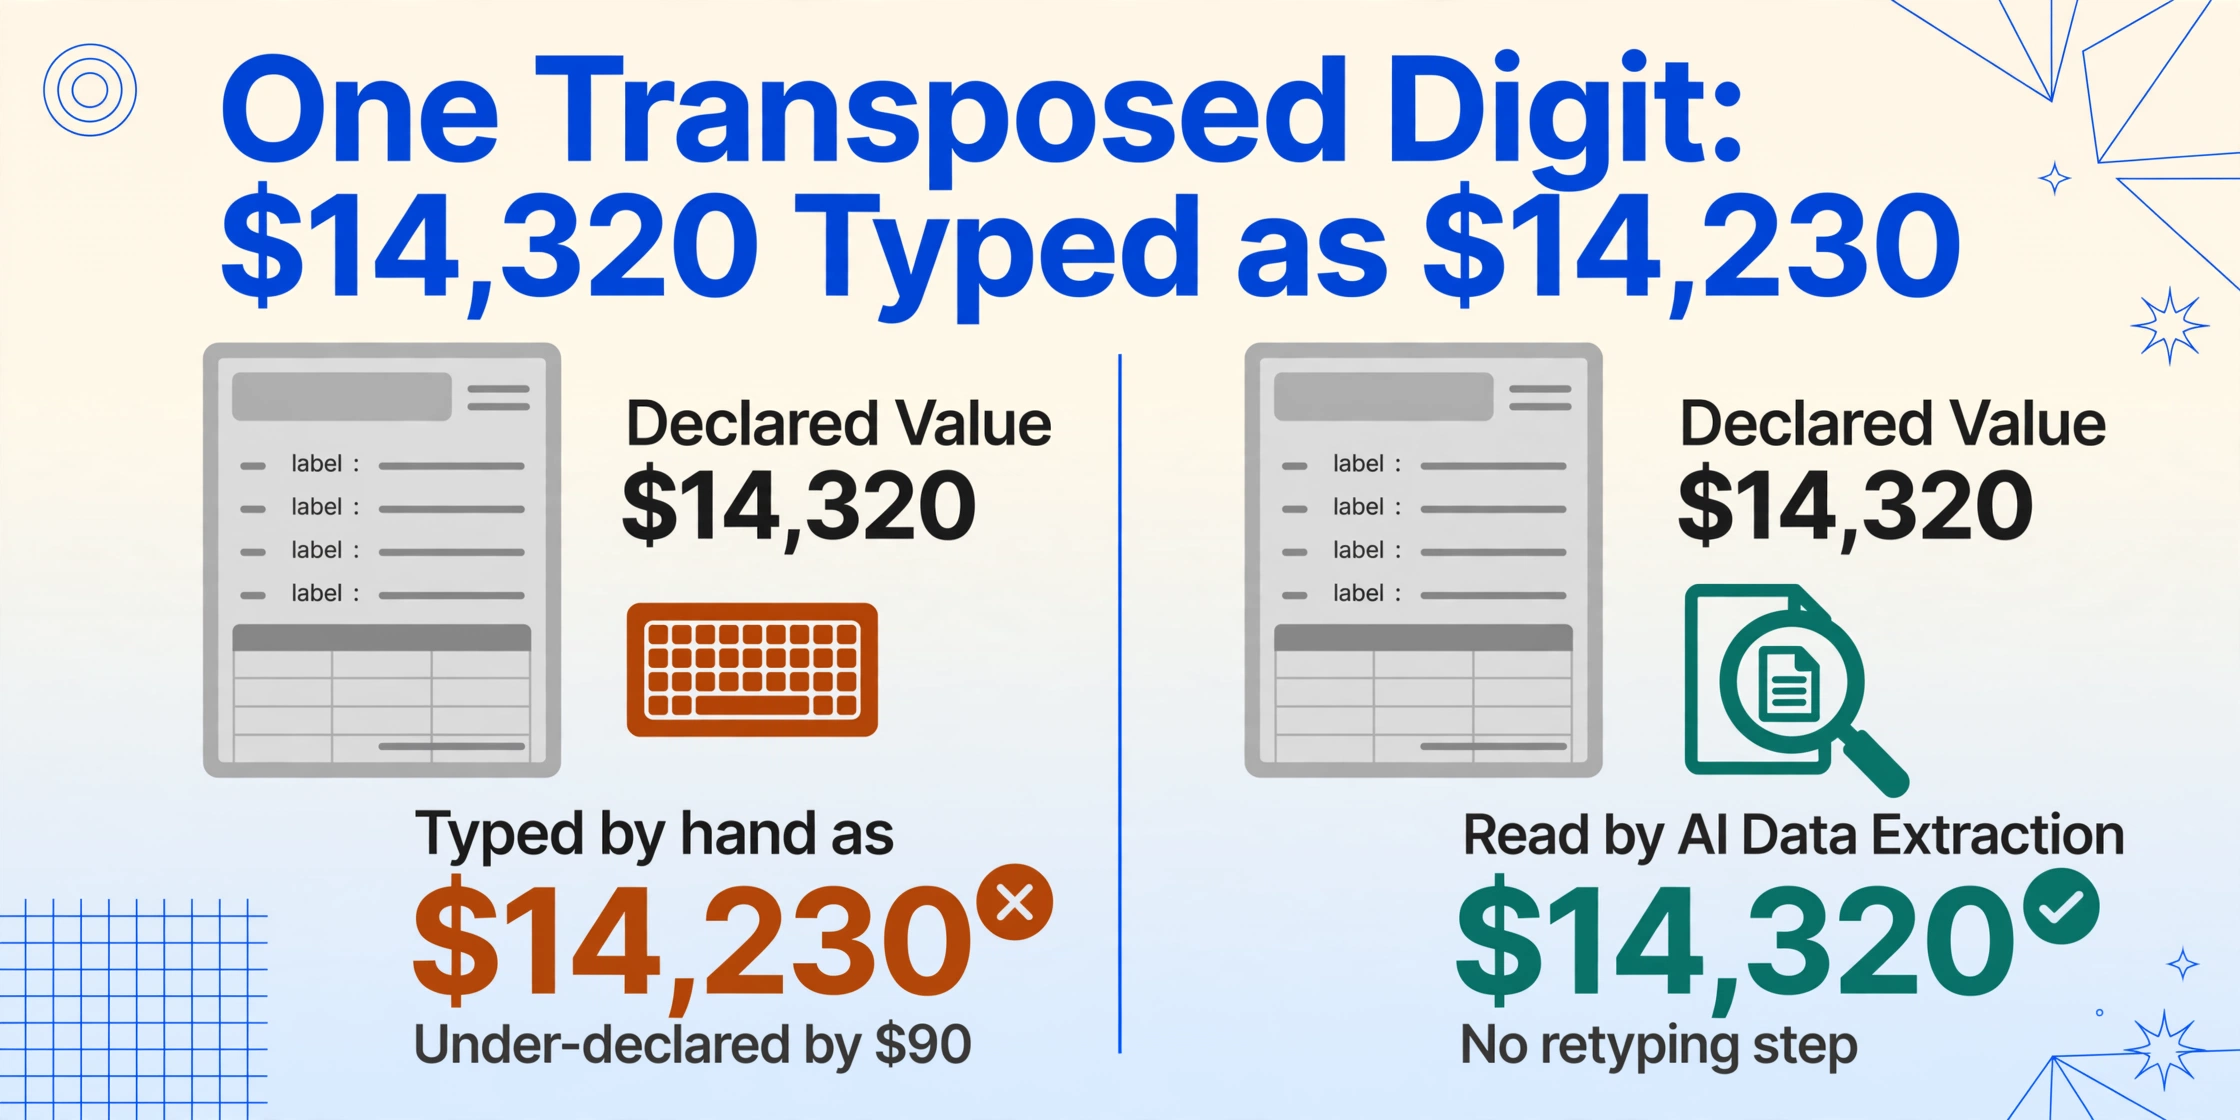
Errores de transcripción. La factura indica que el valor declarado es de $14,320. El operador escribe $14,230. Un dígito transpuesto. Si este error sobrevive hasta la presentación y la validación del CBP no lo detecta — lo cual ocurre cuando el valor se encuentra dentro de un rango plausible — el importador ha subdeclarado por $90, creando una responsabilidad en cada declaración posterior con el mismo patrón de error. Investigaciones a lo largo de décadas de estudios sobre entrada de datos sitúan las tasas de error de transcripción humana experta en 0.5-1% bajo condiciones controladas y 2-5% en condiciones del mundo real con formatos de documentos variados, presión de tiempo y fatiga al final del día. Para un agente que presenta 500 declaraciones al mes, una tasa de error del 1% significa que 5 declaraciones al mes contienen un error de transcripción — y esas 5 declaraciones, si se detectan en una evaluación enfocada del CBP, pueden desencadenar una revisión de cada declaración presentada en los últimos cinco años bajo los requisitos de mantenimiento de registros de 19 CFR Part 163. La extracción con IA elimina los errores de transcripción por completo — la IA lee el valor directamente del documento sin un paso de reescritura humana. Si la IA lo lee correctamente, el valor es correcto. Si el documento es un escaneo de baja calidad donde la IA podría leer mal, el operador revisa esa declaración específica en lugar de escribir manualmente cada declaración.
Errores de clasificación y código. El operador asigna el HTS 8471.30.0100 (máquinas automáticas para tratamiento o procesamiento de datos portátiles) a lo que cree que es una tableta — pero el producto es en realidad un dispositivo con capacidad celular que debería clasificarse bajo el 8517.12.0050. Este no es un error de transcripción; el operador escribió el código que pretendía. Es un error de juicio de clasificación, y es el tipo de error con las mayores implicaciones financieras. Las sanciones del CBP por negligencia en importaciones sujetas a aranceles varían de 0.5 a 2 veces la pérdida de aranceles; por negligencia grave, hasta 4 veces; por fraude, hasta 8 veces el arancel perdido. En artículos no sujetos a aranceles, las sanciones pueden alcanzar el 50-80% del valor de la mercancía por fraude. La extracción con IA no elimina los errores de clasificación. Lo que puede hacer es señalar inconsistencias — la IA lee la descripción de la carga de la factura y el código HS de la declaración, y si la descripción dice «paquete de baterías de iones de litio» y el código es 8507.60.0020 (baterías de almacenamiento de iones de litio), el operador recibe una señal de verificación cruzada en lugar de encontrar la discrepancia manualmente en tres documentos. Pero la decisión de clasificación en sí sigue siendo un juicio humano.
Errores de consistencia entre documentos. La factura comercial indica 1,200 unidades. La lista de empaque indica 1,150. El conocimiento de embarque indica 1,200. El operador ingresa 1,200 desde la factura y nunca coteja la lista de empaque porque va en su decimocuarto registro de la tarde. La declaración se presenta con una discrepancia de cantidades entre los documentos de origen — y el sistema de selección automatizada de CBP detecta la inconsistencia a nivel de manifiesto. Este es el tipo de error que un estudio de investigación sobre documentación de transporte de carga encontró que afecta al 40% de los envíos, siendo las discrepancias entre documentos el problema documental más común. La extracción con IA reduce esto al procesar todos los documentos de un envío en conjunto — la tabla de datos extraída muestra el campo de cantidad de la factura, la lista de empaque y el conocimiento de embarque lado a lado. Una fila de 1,200 / 1,150 / 1,200 es inmediatamente visible. El operador no tiene que abrir tres documentos separados y recordar compararlos.
| Tipo de error | Flujo de trabajo manual | Flujo de trabajo asistido por IA |
|---|---|---|
| Transcripción (errores tipográficos, transposición) | Presente — 0.5-5% por campo según las condiciones y la fatiga | Eliminado — la IA lee el documento directamente; sin paso de reescritura manual |
| Clasificación y código HS | Presente — error de juicio, no mecánico | No eliminado — pero verificado: la IA señala las discrepancias entre descripción y código para revisión |
| Consistencia entre documentos | Presente — verificación manual secuencial entre documentos, fácilmente omitida bajo presión de tiempo | Reducido — todos los documentos se procesan en conjunto; las discrepancias son visibles lado a lado en el resultado |
Las estadísticas comerciales de CBP para el año fiscal 2025 ponen lo que está en juego en términos concretos: 2,432 sanciones comerciales emitidas, 53,052 daños liquidados y $34.41 mil millones recuperados de las revisiones de resúmenes de declaraciones. Cada uno de esos hallazgos comenzó con un dato incorrecto en una declaración aduanera — un error de transcripción, una clasificación errónea, una inconsistencia de datos. No todos fueron causados por la entrada manual de datos, pero cada uno fue una falla en la calidad de los datos. La brecha entre una tasa de error del 1% con 500 declaraciones al mes y una precisión de extracción superior al 99% es la diferencia entre 5 errores al mes y potencialmente cero — y en un entorno regulatorio donde un solo error puede desencadenar una revisión retroactiva de cinco años, el efecto acumulativo es lo que importa, no la tasa por declaración.
Escalabilidad: con 20 declaraciones al día, la entrada manual no es un proceso, es un problema de contratación
La dimensión de la escalabilidad es donde el modo de fallo del flujo de trabajo manual se vuelve estructural en lugar de operativo. Por debajo de 5 entradas al día, la entrada manual de datos está bien: no es rápida, pero contratar a otra persona sería absurdo. Entre 5 y 15 entradas al día, la ineficiencia es visible pero manejable: el operador dedica de 1 a 2 horas diarias a la transcripción, lo cual es frustrante pero no limita la capacidad de la agencia de aduanas.
Con 20 entradas al día —el umbral en el que un solo operador que trabaja un día estándar dedica de 2 a 3 horas únicamente a la transcripción de datos— el flujo de trabajo manual se convierte en un techo de rendimiento. Añadir otro cliente o ruta comercial significa añadir otra persona, y el coste no es solo el salario. La operación de Savino Del Bene en Sudáfrica ofrece una calibración del mundo real: al procesar más de 50 000 facturas comerciales al año de más de 2 000 proveedores, la empresa dedicaba el 80 % de su tiempo a la entrada manual de datos. Tras implementar la automatización del procesamiento de documentos, el procesamiento de facturas se volvió 11 veces más rápido y los ahorros mensuales proyectados superaron los 100 000 $.
Esta es la aritmética de capacidad que importa para las agencias de aduanas a escala:
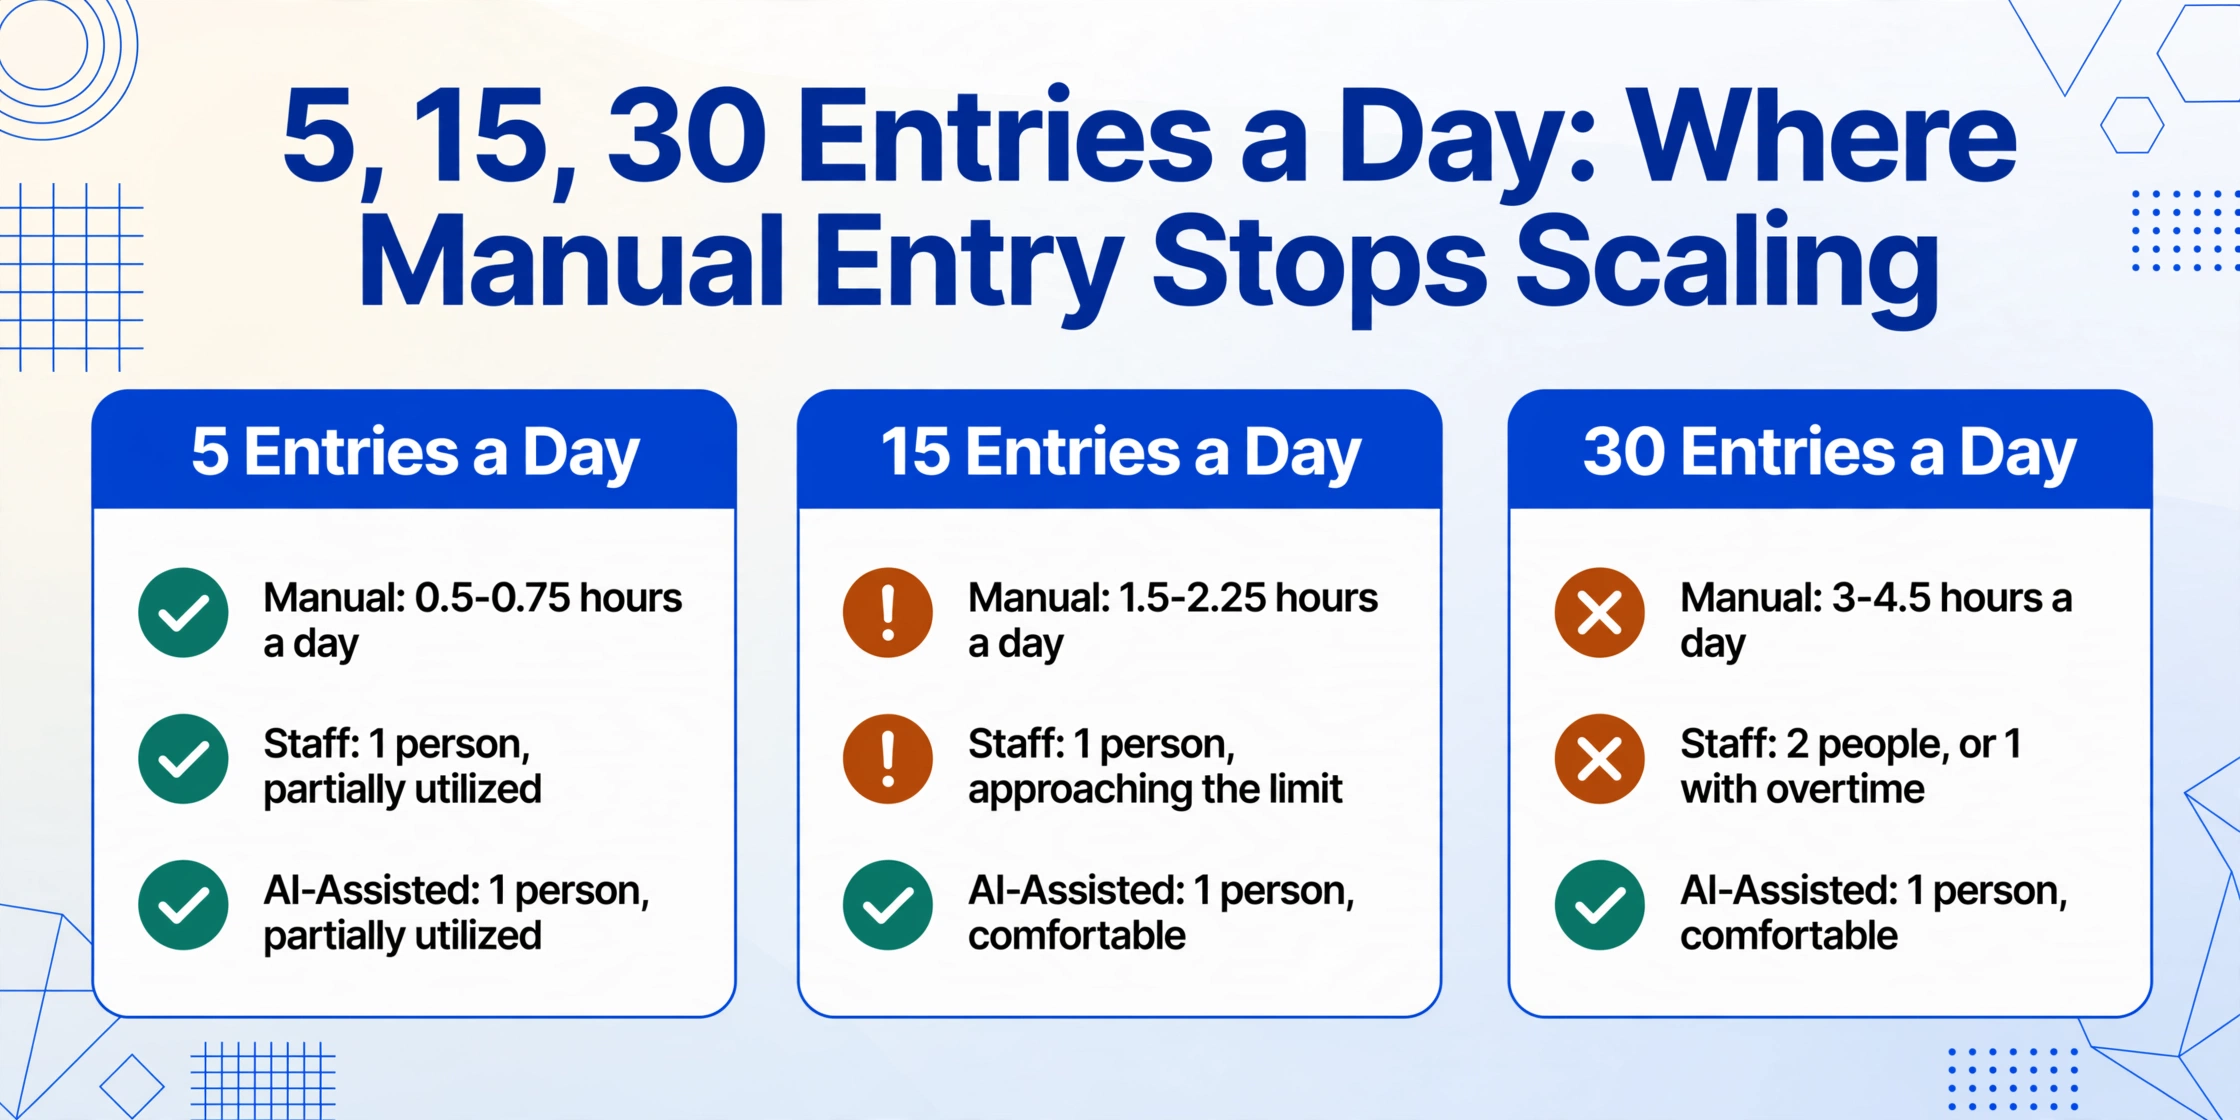
| Volumen diario de entradas | Horas de entrada manual de datos al día | Personal necesario | Personal necesario (con asistencia de IA) | Techo de capacidad |
|---|---|---|---|---|
| 5 entradas | 0,5-0,75 horas | 1 (parcialmente utilizado) | 1 (parcialmente utilizado) | No relevante |
| 15 entradas | 1,5-2,25 horas | 1 (cerca del límite) | 1 (cómodo) | ~20-25 entradas al día por persona |
| 30 entradas | 3-4,5 horas | 2 (o 1 con horas extra) | 1 (cómodo) | Tamaño de la fuerza laboral capacitada disponible |
| 50+ entradas | 5-7,5 horas | 2-3 (más cobertura) | 1-2 | El proceso de contratación limita el rendimiento |
Para una agencia de aduanas que gestiona declaraciones de múltiples líneas — envíos con 5 o más líneas de mercancías, cada una con su propio código HTS, valor, cantidad y país de origen — el tiempo por declaración se multiplica. Una declaración de 10 líneas con entrada manual de datos puede consumir de 30 a 45 minutos de transcripción en todas las líneas. Con la extracción por IA, las 10 líneas de mercancías se leen de los mismos documentos fuente en el mismo ciclo de procesamiento: de 5 a 10 segundos por página del documento fuente, no por línea de mercancía. Aquí es donde el procesamiento por lotes de declaraciones de aduanas de múltiples líneas en una sola hoja de cálculo transforma la aritmética: 50 declaraciones de múltiples líneas que requerirían de 25 a 37 horas de transcripción manual se convierten en una única sesión de carga y revisión que se mide en minutos.
Un estudio de Descartes Systems con más de 400 transitarios y agentes de aduanas encontró que el 67% considera la tecnología fundamental o muy importante para el crecimiento — sin embargo, el 61% citó la presión sobre los precios de los clientes como un desafío principal. La tensión es clara: las agencias necesitan aumentar el volumen para mantener los márgenes, pero el flujo de trabajo manual que funciona con 20 declaraciones al día no funciona con 50, y contratar profesionales de aduanas capacitados es una de las restricciones más citadas de la industria. La automatización no resuelve la escasez de personal — cambia la aritmética de personal para que los empleados existentes puedan manejar el crecimiento sin que cada nuevo cliente requiera un aumento proporcional de la plantilla.
La Inversión en Aprendizaje: Lo Que Realmente Cuesta Adoptar la Entrada de Datos de Aduanas Asistida por IA
El argumento más fuerte para el flujo de trabajo manual es que requiere cero adopción de tecnología. Un agente de aduanas recién licenciado que sepa leer una factura comercial y navegar por el portal ACE puede comenzar a preparar declaraciones desde el primer día. Todo agente de aduanas ya sabe qué datos necesita extraer, en qué formato deben estar y qué sucede si están mal. El proceso manual es lento, propenso a errores y limitado en volumen — pero es universalmente accesible. Cualquier flujo de trabajo alternativo tiene que ganarse su lugar frente a un proceso que no cuesta nada comenzar y no requiere capacitación.
La inversión en aprendizaje para la extracción asistida por IA se concentra en un único patrón nuevo: en lugar de abrir cada documento y escribir los valores en el software de declaración, usted carga todos los documentos fuente de un envío a la vez y define lo que desea extraer usando nombres de columna — «Nombre del Remitente», «Dirección del Destinatario», «Código HS», «País de Origen», «Valor Declarado», «Peso Neto». La IA lee cada campo comprendiendo su significado semántico, no por su posición en un formulario específico. Una vez definidos, estos conjuntos de columnas se pueden guardar y reutilizar — un importador que presenta los mismos tipos de declaraciones en los mismos corredores comerciales utiliza la misma plantilla de columnas cada vez. El esfuerzo por declaración se convierte en: cargar documentos, seleccionar la plantilla guardada, exportar la tabla de extracción, revisar.
Esto es fundamentalmente diferente de los sistemas tradicionales de plantillas OCR, que requieren configurar una plantilla separada para cada formato de documento — la plantilla CBP 7501, la plantilla SAD de la UE, la plantilla de declaración de exportación china, más el formato de factura de cada proveedor. La carga de mantenimiento de plantillas es lo que derrotó a las generaciones anteriores de automatización aduanera, especialmente en agencias que trabajan con proveedores de múltiples países cuyos formatos de documento cambian sin previo aviso. La extracción por IA evita esto porque lee por significado, no por posición en un diseño de formulario conocido.
Para comparar: una implementación de EDI que conecta una agencia de aduanas con el sistema ERP de un cliente puede llevar meses de mapeo, pruebas y certificación — y solo funciona con ese cliente. El despliegue completo de una plataforma de gestión aduanera puede llevar semanas, requiere la participación del departamento de TI y asume que todos los datos comerciales fluyen a través del mismo sistema. La extracción asistida por IA tiene una curva de aprendizaje que se mide en el tiempo que se tarda en subir un documento y escribir un nombre de columna. Con 20 declaraciones al día, la inversión de tiempo para aprender el nuevo patrón — aproximadamente 15-30 minutos probándolo con algunas declaraciones de muestra — se recupera durante el primer día de uso.
Las definiciones de columnas que cree para declaraciones de aduanas también pueden usarse para otros documentos comerciales — facturas comerciales, listas de empaque, certificados de origen — porque el motor de extracción no distingue entre tipos de documento. La misma plantilla guardada que extrae códigos HS y valores declarados de un formulario aduanero también extrae números de factura y totales de una factura comercial cuando se aplica a ese documento. Esta reutilización entre documentos significa que la biblioteca de plantillas crece con el uso, no con la cantidad de formatos de documento.
Donde la Entrada Manual Aún Gana — y Donde la Brecha Es Infranqueable
Una comparación dimensional solo es útil si es honesta sobre ambos lados. El flujo de trabajo manual tiene ventajas genuinas que la extracción asistida por IA no elimina, y reconocerlas le da peso al resto de la comparación:
- Costo marginal cero. La entrada manual requiere una persona capacitada y acceso al software de declaración — ambos ya disponibles en la agencia. Para operaciones que manejan menos de 5 declaraciones al día, el ahorro de tiempo de la automatización no recupera el costo de la herramienta. Por debajo de ese volumen, el flujo de trabajo manual es la opción económicamente racional.
- Criterio contextual ausente en los documentos. Un agente experimentado que lee una factura comercial puede notar que el valor declarado es sospechosamente bajo para las mercancías descritas — una señal de alerta de precios de transferencia que una extracción de IA no detecta porque solo lee lo que está en la página, no lo que falta. Este conocimiento institucional — «este proveedor subvalora sistemáticamente los productos electrónicos en sus facturas y es señalado por la CBP» — vive en la cabeza del agente, no en ningún documento, y surge durante la revisión manual de una manera que la extracción automatizada no replica.
- Comunicación entre múltiples partes. Cuando una declaración de aduanas activa una Solicitud de Información de la CBP (Formulario CBP 28) o un Aviso de Acción (Formulario CBP 29), la respuesta requiere comunicación con el importador, el proveedor y posiblemente un abogado comercial. Este flujo de trabajo es inherentemente humano — ninguna herramienta de extracción lo automatiza, y ninguna debería intentarlo. Las habilidades de gestión de relaciones y comunicación regulatoria del agente son el valor aquí, no el paso de entrada de datos que precedió a la consulta.
- Integración con la interfaz de presentación gubernamental. La extracción de IA produce una tabla de datos estructurados. Llevar esos datos al sistema ACE, CDS o ATLAS aún requiere reingreso manual en el sistema de presentación o una capa de integración de software. Algunas plataformas de gestión aduanera (Descartes, AEB, iCustoms) ofrecen conexiones API que aceptan datos estructurados directamente, pero las agencias que usan sistemas de presentación independientes o heredados aún tendrán un paso de transferencia manual desde la tabla de datos extraídos al software de declaración — a menos que usen el resultado de la extracción como fuente de verificación en lugar de entrada directa.
Las dimensiones en las que la entrada manual pierde — y pierde en proporción directa al volumen — son la velocidad, la precisión de transcripción y la escalabilidad. Estas dimensiones se acumulan: una agencia de aduanas que ahorra 1.5 horas al día en transcripción con 20 entradas puede gestionar más entradas sin contratar personal adicional, puede dedicar ese tiempo recuperado a la revisión de cumplimiento en lugar de teclear datos, y puede reducir la tasa de error que provoca los desencadenantes de penalizaciones de CBP más comunes. Los 7 errores más comunes en la entrada de datos aduaneros que causan demoras en el despacho son predominantemente errores de transcripción y de consistencia entre documentos — exactamente las categorías que aborda la extracción con IA.
La metodología del Estudio de Tiempo de Liberación de la Organización Mundial de Aduanas — ahora en su 4.ª versión — ha identificado repetidamente que el principal cuello de botella en el despacho de carga no es la inspección física, ni la congestión portuaria, sino el tiempo entre la llegada de los documentos y la presentación de la declaración. En los programas piloto de TRS del Banco Mundial, la automatización fronteriza redujo el despacho de un promedio de 3.6 días a menos de 1 día en países que adoptaron la preautorización digital y la coordinación de Ventanilla Única. El paso de preparación de la declaración — donde vive la entrada manual de datos — es la mayor oportunidad de compresión de tiempo en el proceso integral de despacho. Eso no es una afirmación comercial. Es lo que la propia metodología de medición de la OMA encuentra de manera consistente.
Preguntas Frecuentes Sobre la Entrada de Datos Aduaneros Manual vs. con IA
¿A qué volumen de entradas debería una agencia de aduanas pasar de la entrada de datos manual a la asistida por IA?
Alrededor de 10 a 15 entradas por día. Por debajo de eso, el ahorro de tiempo de la automatización puede no recuperar la inversión de aprendizaje con la rapidez suficiente para justificar el cambio — especialmente para agencias con una base de clientes estable que utilizan formatos de documentos conocidos donde el operador desarrolla velocidad mediante la repetición. Con 20 o más entradas por día, el flujo de trabajo manual consume de 2 a 3 horas de tiempo de transcripción que podrían recuperarse, y el costo de automatizar ese paso es menor que el costo de contratar personal adicional para manejar el mismo volumen. El punto de equilibrio depende de su costo laboral cargado por hora y de su volumen diario de entradas, pero para la mayoría de las agencias, se sitúa entre 10 y 20 entradas diarias.
¿En qué se diferencia la extracción con IA del EDI para las declaraciones aduaneras?
El EDI (Electronic Data Interchange) es un intercambio de datos estructurados de máquina a máquina entre sistemas que ya entienden el mismo formato — por ejemplo, el sistema ERP de un cliente que transmite datos de órdenes de compra directamente al sistema de presentación de un agente de aduanas en un formato de datos preacordado. El EDI funciona cuando ambas partes han invertido en la integración y mantienen estructuras de datos compatibles. La extracción con IA lee documentos no estructurados — PDF, escaneos, imágenes — que llegan de proveedores que nunca implementarán EDI porque son fábricas en Shenzhen, distribuidores en Mumbai o pequeños fabricantes en Vietnam que envían facturas comerciales como archivos adjuntos de correo electrónico. El EDI y la extracción con IA abordan diferentes partes de la cadena de suministro de documentos: el EDI para clientes grandes con sistemas integrados, la extracción con IA para la larga cola de proveedores y formatos que constituyen la mayoría de la documentación comercial.
¿La extracción con IA reemplaza a un agente de aduanas?
No. Reemplaza el paso de transcripción de datos — leer valores de documentos y escribirlos en el software. No reemplaza, y no puede reemplazar, la experiencia en clasificación, el conocimiento regulatorio, el análisis de programas comerciales, la consultoría al cliente o la comunicación con CBP que constituyen el servicio profesional real del agente de aduanas. La automatización analizada en esta comparación opera en el proceso de documento a datos, no en el criterio del agente. Un agente que usa extracción con IA sigue clasificando mercancías, sigue determinando la aplicabilidad de los acuerdos de libre comercio, sigue gestionando consultas de CBP y sigue asesorando a los clientes sobre estrategia de cumplimiento. La diferencia es que el agente dedica menos tiempo a transcribir datos de facturas y más tiempo a los pasos que requieren licencia y experiencia profesional.
¿Con qué formatos de documentos funciona la extracción con IA para las declaraciones aduaneras?
Se admiten archivos PDF (tanto generados digitalmente como escaneados), imágenes JPG/PNG, WebP y AVIF. Esto cubre el rango real de documentos comerciales: PDF generados por ERP, facturas comerciales escaneadas, fotos de listas de empaque en papel y capturas de pantalla de portales de proveedores. La escritura a mano en documentos escaneados es legible, aunque la precisión disminuye con la calidad del escaneo — un escaneo limpio a 300 DPI produce una extracción casi perfecta, mientras que una foto de baja resolución de una lista de empaque manuscrita en ángulo puede requerir verificación manual de campos específicos.
¿Puede la extracción con IA manejar documentos comerciales en varios idiomas?
Sí. El modelo de lenguaje visual subyacente lee texto en cualquier idioma. Una declaración de exportación china, una factura comercial alemana, una lista de empaque española y un certificado de origen coreano se procesan de la misma manera: los nombres de columnas definidos en inglés guían la extracción, y la IA localiza los valores correspondientes independientemente del idioma del documento fuente. Los campos numéricos (valores, pesos, cantidades, códigos HS) se extraen de manera limpia, sin depender del idioma. Para agencias que manejan comercio multidireccional en Asia, Europa y las Américas, esto elimina la fricción específica del idioma que de otro modo requiere personal bilingüe para la captura de datos.
¿Pueden reutilizarse las definiciones de columnas de extracción entre declaraciones y clientes?
Sí. Un conjunto estándar de columnas para declaraciones de importación — Importador de Registro, Consignatario, País de Origen, Código HS, Descripción de Mercancías, Cantidad, Unidad de Medida, Valor Declarado, Moneda, Tasa de Arancel, Peso Bruto, Número de Conocimiento de Embarque — puede definirse una vez, guardarse en su cuenta y aplicarse a cada declaración posterior con un solo clic. Para agencias que manejan diferentes tipos de declaraciones (declaraciones de consumo formal vs. declaraciones informales vs. fianzas de importación temporal), se pueden guardar múltiples plantillas de columnas para cada tipo de declaración. La biblioteca de plantillas crece con el uso, no con la cantidad de formatos de documentos que encuentre.
¿La extracción con IA asigna códigos HS automáticamente?
Algunas plataformas especializadas de IA aduanera (Digicust, iCustoms) ofrecen sugerencia de códigos HS y asistencia de clasificación como una función separada. La extracción de ImageToTable.ai lee el código HS si ya está impreso en el documento — por ejemplo, cuando un proveedor incluye el código HTS en su factura comercial. No clasifica productos sin codificar ni sugiere códigos HS para artículos sin una clasificación arancelaria impresa. El paso de clasificación sigue siendo una decisión humana informada por la experiencia del agente, las Reglas Generales de Interpretación y las bases de datos de resoluciones de CBP. Si necesita clasificación asistida por IA, busque plataformas específicas de aduanas que combinen extracción con clasificación. Si necesita extracción de documentos donde los códigos HS ya están presentes pero ocultos en formatos inconsistentes, la herramienta lo maneja directamente.
¿Los datos extraídos se integran directamente con el sistema ACE de CBP?
No — y esta es una distinción importante. La extracción produce datos estructurados en formato Excel, CSV o JSON. Para llevar esos datos al portal ACE, CDS o ATLAS, aún se requiere la introducción manual o una capa de integración de software. Las agencias de aduanas que utilizan plataformas de gestión aduanera con conectividad API (Descartes, AEB, CargoWise de WiseTech) pueden importar datos estructurados directamente. Las agencias que presentan declaraciones a través del Portal Seguro de Datos ACE directamente necesitarán transferir manualmente los datos extraídos al portal o utilizar un sistema de gestión de agencias con capacidad de importación de datos. La extracción elimina el paso de documento fuente a datos estructurados. No elimina el paso de datos estructurados a sistema de presentación, a menos que su software de presentación lo admita.
El corretaje de aduanas es una profesión de alto riesgo donde un código HTS mal clasificado puede desencadenar una auditoría retroactiva de cinco años. La pregunta que responde esta comparación no es si la IA hace obsoleta la entrada manual — no lo hace, y para corredurías que manejan menos de 10 entradas al día, la entrada manual sigue siendo la opción racional por defecto. La pregunta es a qué volumen la economía se invierte. A 20 entradas por día, el flujo de trabajo manual consume 2-3 horas de tiempo de transcripción que podrían recuperarse. A 50 entradas, consume el equivalente a un salario de tiempo completo en tipeo. La tecnología de extracción existe. La OMA, FIATA y las autoridades aduaneras nacionales se están moviendo hacia la documentación comercial digitalizada. La decisión para cada correduría es cuándo — no si — separar el paso de lectura de documentos del paso de experiencia aduanera, y dejar de pagar a profesionales licenciados para hacer un trabajo que una máquina puede hacer mejor.
Relacionado: Cómo extraer datos de formularios de declaración de aduanas a Excel · Procesamiento por lotes de declaraciones de aduanas de varios países en una sola hoja de cálculo · 7 errores de entrada de datos aduaneros que causan demoras en el despacho