Entrada de dados aduaneiros manual vs. IA:
Qual sobrevive a 20 entradas por dia?
No ano fiscal 2025, a U.S. Customs and Border Protection processou 50 milhões de resumos de entrada, emitiu 2.432 penalidades comerciais e recuperou US$ 34,41 bilhões em revisões de resumos de entrada. Cada uma dessas entradas começou como dados extraídos de uma fatura comercial, lista de embalagem ou conhecimento de embarque e transcritos em uma declaração — uma etapa que ainda é predominantemente manual na maioria das corretoras. Esta comparação mede o que essa etapa realmente custa em tempo, erro e produtividade, e em qual volume o fluxo de trabalho manual deixa de ser gerenciável.
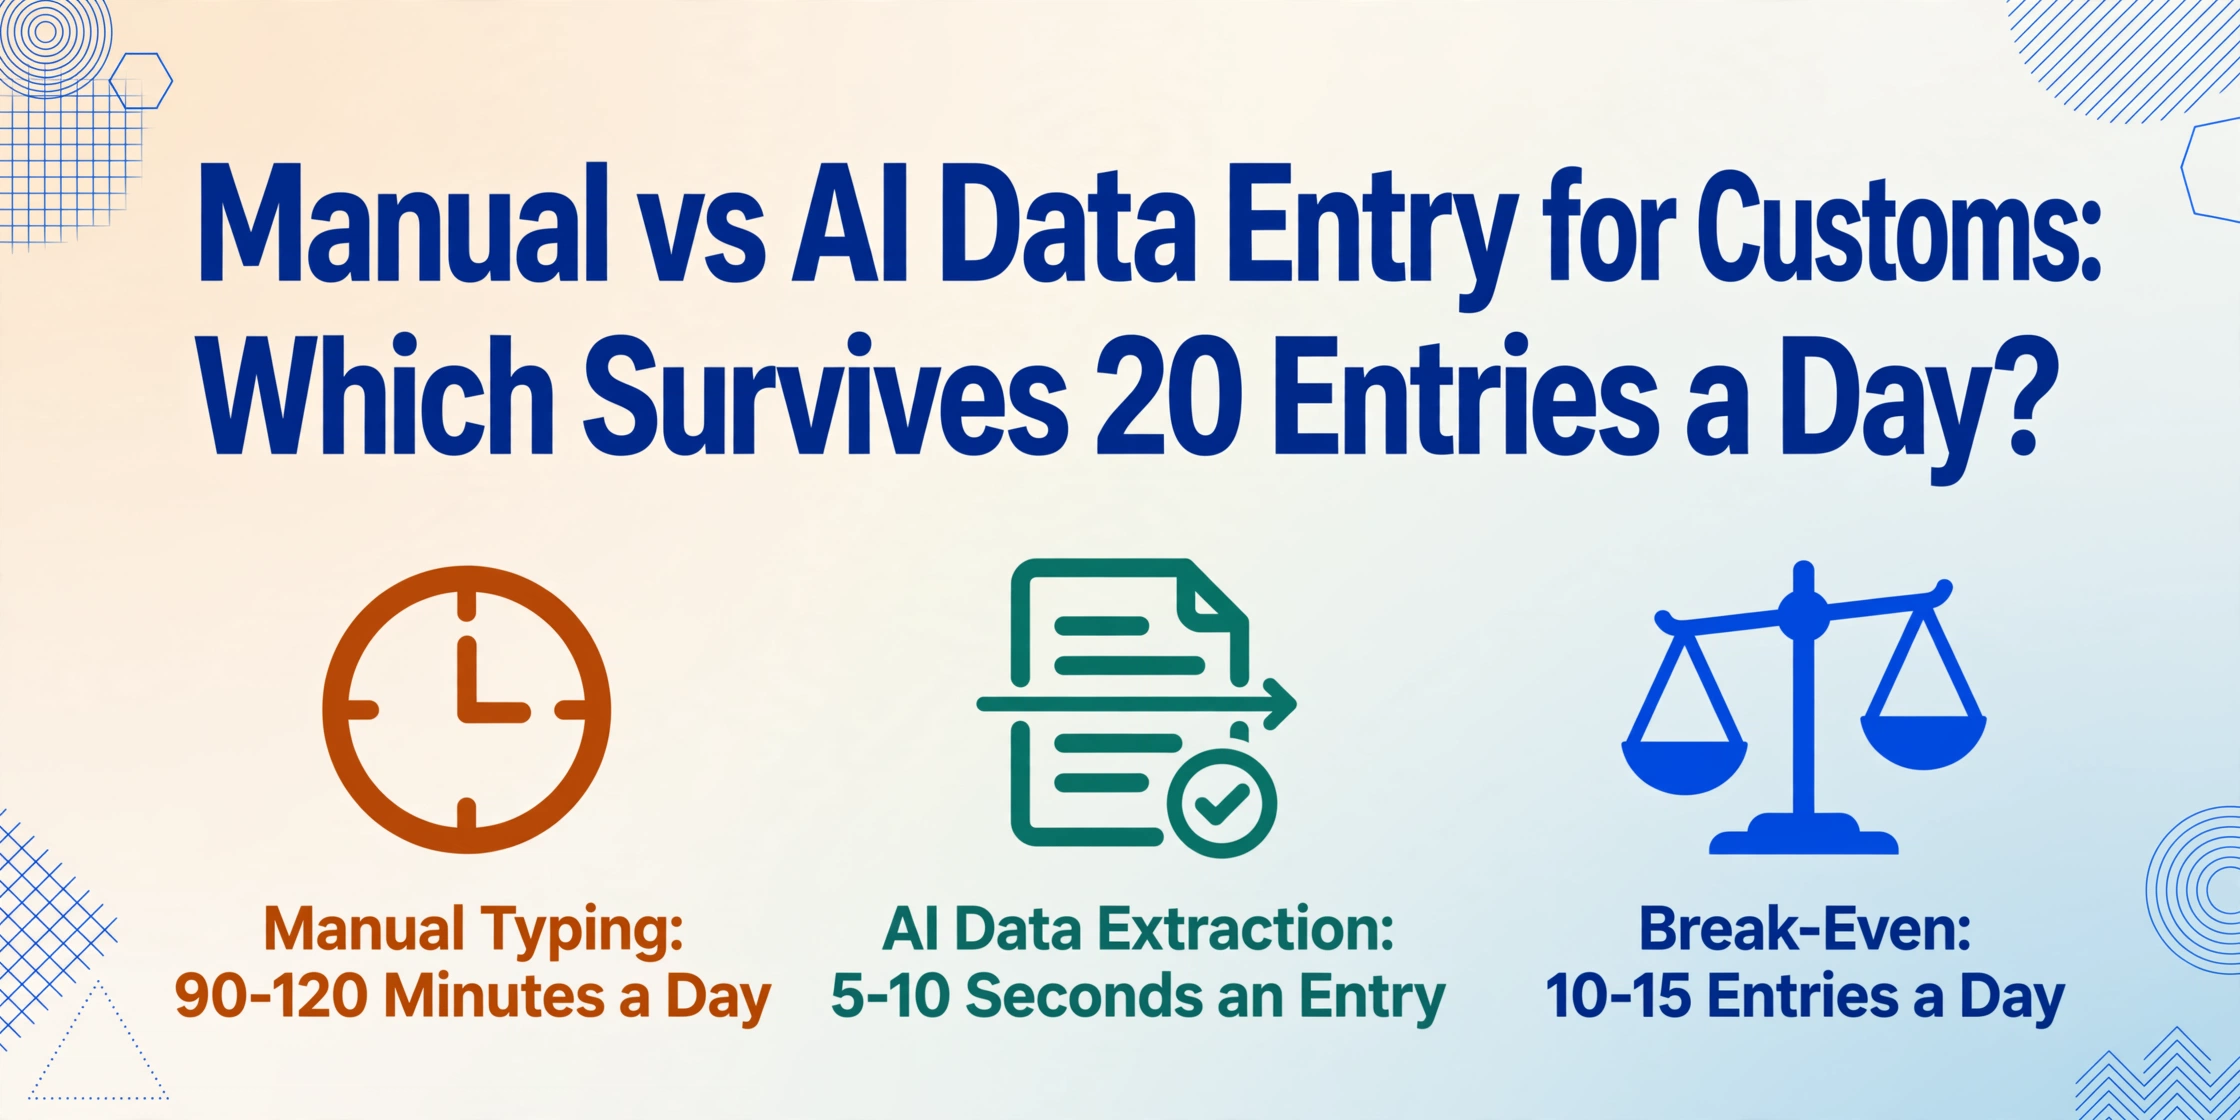
Principais Conclusões
- De 60 a 70 por cento do tempo de preparação de cada entrada aduaneira é consumido não pela classificação ou conformidade — o trabalho para o qual a licença de um corretor foi obtida — mas pela leitura de valores em faturas de fornecedores e pela redigitação manual deles.
- Com 20 entradas por dia, a etapa de transcrição manual consome de 7,5 a 10 horas semanais — um dia inteiro de trabalho — e cada hora dessa digitação corre o risco de um dígito errado que pode desencadear uma auditoria aduaneira que retroage cinco anos.
- Abaixo de 10 entradas por dia, a digitação manual é economicamente racional, mas acima de 20 os números se invertem — contratar para acompanhar o ritmo custa mais do que eliminar a etapa de transcrição, e o ImageToTable.ai extrai todos os campos de todos os documentos em menos de 10 segundos por página.
O Que Realmente Acontece Durante a Preparação Manual da Declaração Aduaneira
O processo de registro da declaração aduaneira — a submissão formal de dados ao sistema ACE da CBP, ao CDS da HMRC, às autoridades aduaneiras dos Estados-Membros da UE — já é digital. O que não é digital, na maioria das corretoras, é a etapa anterior ao registro: extrair os dados comerciais dos documentos de origem e digitá-los no software de declaração. Esta é a lacuna que a maioria das discussões sobre automação ignora. As conexões EDI e API lidam com a transferência máquina-a-máquina entre sistemas que já contêm dados estruturados. Elas não leem uma lista de embalagem digitalizada de uma fábrica em Shenzhen.
O fluxo de trabalho manual para preparar uma única entrada aduaneira se divide em cinco etapas:
Receber e classificar os documentos de origem
Fatura comercial, packing list, conhecimento de embarque ou conhecimento aéreo, certificado de origem — uma única remessa pode gerar mais de 10 documentos de diferentes partes, em diferentes formatos, recebidos por diferentes canais (e-mail, unidade compartilhada, download no portal). Um estudo com despachantes aduaneiros constatou que 40% dos atrasos alfandegários tiveram origem em discrepâncias entre esses documentos antes mesmo do início da preparação da declaração.
Localizar e transcrever os campos de dados no software de declaração
O operador lê a fatura comercial, localiza o nome do remetente, o endereço do consignatário, a descrição da carga, a quantidade, o peso, o valor declarado, a moeda, os Incoterms, o país de origem e o código HS — e digita cada um no campo correspondente do sistema de declaração. Somente o Formulário 7501 da CBP possui 47 blocos de dados. Para uma declaração com 5 linhas de mercadorias, o operador lida com aproximadamente 35 a 50 pontos de dados distintos por declaração, alternando entre janelas para cada um deles.
Cruzar os dados entre os documentos para verificar a consistência
A quantidade na fatura deve corresponder ao packing list. O valor declarado deve ser consistente com o total da fatura comercial. O código HS deve corresponder à descrição da carga. Essas verificações são manuais e sequenciais — o operador lê o documento A, lê o documento B e compara mentalmente. Às 16h de uma sexta-feira, com 8 declarações ainda na fila, a verificação de consistência é a primeira etapa a ser encurtada ou ignorada.
Classificar as mercadorias e aplicar a lógica dos programas comerciais
O operador determina o código HS correto, aplica as preferências de acordos de livre comércio, verifica a aplicabilidade de ADD/CVD e confirma os requisitos das PGA (FDA, USDA, EPA). Esta é a etapa em que o conhecimento aduaneiro é mais importante — e também é a etapa em que até despachantes experientes cometem erros de classificação que geram auditorias da CBP. Um código HTS classificado incorretamente pode resultar em pagamento a menor de tributos ao longo de meses de declarações antes de ser detectado em uma avaliação direcionada.
Enviar declaração, tratar rejeições e obter o MRN
A declaração é transmitida eletronicamente à autoridade aduaneira. Se for aprovada na validação, o Movement Reference Number (MRN) ou o número de entrada é retornado em segundos. Se falhar — por causa de um código HTS incompatível, um elemento de dados PGA ausente ou um EORI inválido — a mensagem de rejeição é devolvida e o operador inicia a solução de problemas. Uma única entrada rejeitada pode consumir tanto tempo quanto três entradas sem erros.
As etapas 2 e 3 — localizar dados em documentos e transcrevê-los — normalmente consomem 60-70% do tempo total de preparação da entrada. As etapas 4 e 5, que exigem conhecimento e julgamento aduaneiro, respondem pelos 30-40% restantes. Essa proporção é o que torna a comparação manual versus automatizado significativa: as etapas que consomem mais tempo são as mecânicas, não as que exigem conhecimento especializado. A pesquisa da DHL confirma que 80% dos atrasos aduaneiros se originam de documentação incorreta ou ausente — não de acúmulos de inspeção física ou congestionamento portuário — o que significa que a etapa de tradução do documento para o sistema é onde reside o gargalo estrutural.
Essa inversão de esforço — onde o trabalho mecânico consome mais tempo do que o trabalho especializado — é o padrão que define quando os fluxos de trabalho manuais falham. Também define onde a automação realmente ajuda: não em substituir o conhecimento aduaneiro, mas em remover a barreira de transcrição que consome o tempo antes que o conhecimento possa ser aplicado. Para uma análise mais aprofundada de por que esse padrão persiste na indústria, consulte nossa análise sobre as razões estruturais pelas quais o gerenciamento de dados aduaneiros continua sendo um gargalo nas operações de frete.
Velocidade: o que "3 minutos por documento" realmente significa em uma semana de 100 declarações
Uma única página de dados impressos leva cerca de 3 minutos para ser transcrita manualmente — localizar cada campo, digitar, verificar. Esta é a média entre operadores de entrada de dados experientes em condições normais de trabalho. Pesquisas com operadores qualificados de entrada de dados consistentemente encontram taxas de erro entre 0,5% e 1% mesmo sob condições controladas — e essas taxas aumentam ao longo do dia de trabalho. O mesmo operador que digita com 1% de precisão às 9h produz mais de 3% de erros no final da tarde, à medida que a fadiga cognitiva se instala.
Para um despachante aduaneiro que lida com 20 declarações por dia — um volume típico para uma corretora de pequeno a médio porte — a matemática é simples: 20 declarações × 3 minutos de extração de dados por declaração = 60 minutos. Na prática, com a triagem de documentos, verificação cruzada e tratamento de inconsistências de formato, o número real fica mais próximo de 90-120 minutos por dia gastos apenas na transcrição de dados. Ao longo de uma semana de cinco dias lidando com 100 declarações, isso representa 7,5-10 horas — essencialmente um dia inteiro de trabalho por semana consumido por uma etapa que não agrega conhecimento aduaneiro e gera a maioria dos erros.
Veja como o cronograma por declaração se divide em ambos os fluxos de trabalho para uma declaração padrão de linha única:
| Tarefa | Fluxo de trabalho manual (por declaração) | Fluxo de trabalho assistido por IA (por declaração) |
|---|---|---|
| Receber e classificar documentos | 2-3 minutos | 2-3 minutos (inalterado — os documentos ainda chegam pelos canais existentes) |
| Localizar e transcrever campos de dados | 3-5 minutos | 5-10 segundos (carregar todos os documentos, a IA extrai dados estruturados) |
| Verificar a consistência dos documentos | 2-4 minutos | 1-2 minutos (revisar a tabela extraída por IA para discrepâncias sinalizadas) |
| Classificar mercadorias, aplicar programas comerciais | 2-5 minutos | 2-5 minutos (inalterado — requer conhecimento aduaneiro) |
| Enviar, lidar com rejeições, obter MRN | 1-3 minutos | 1-3 minutos (inalterado — o envio eletrônico é independente do método de extração) |
| Total por declaração | 10-20 minutos | 6-13 minutos |
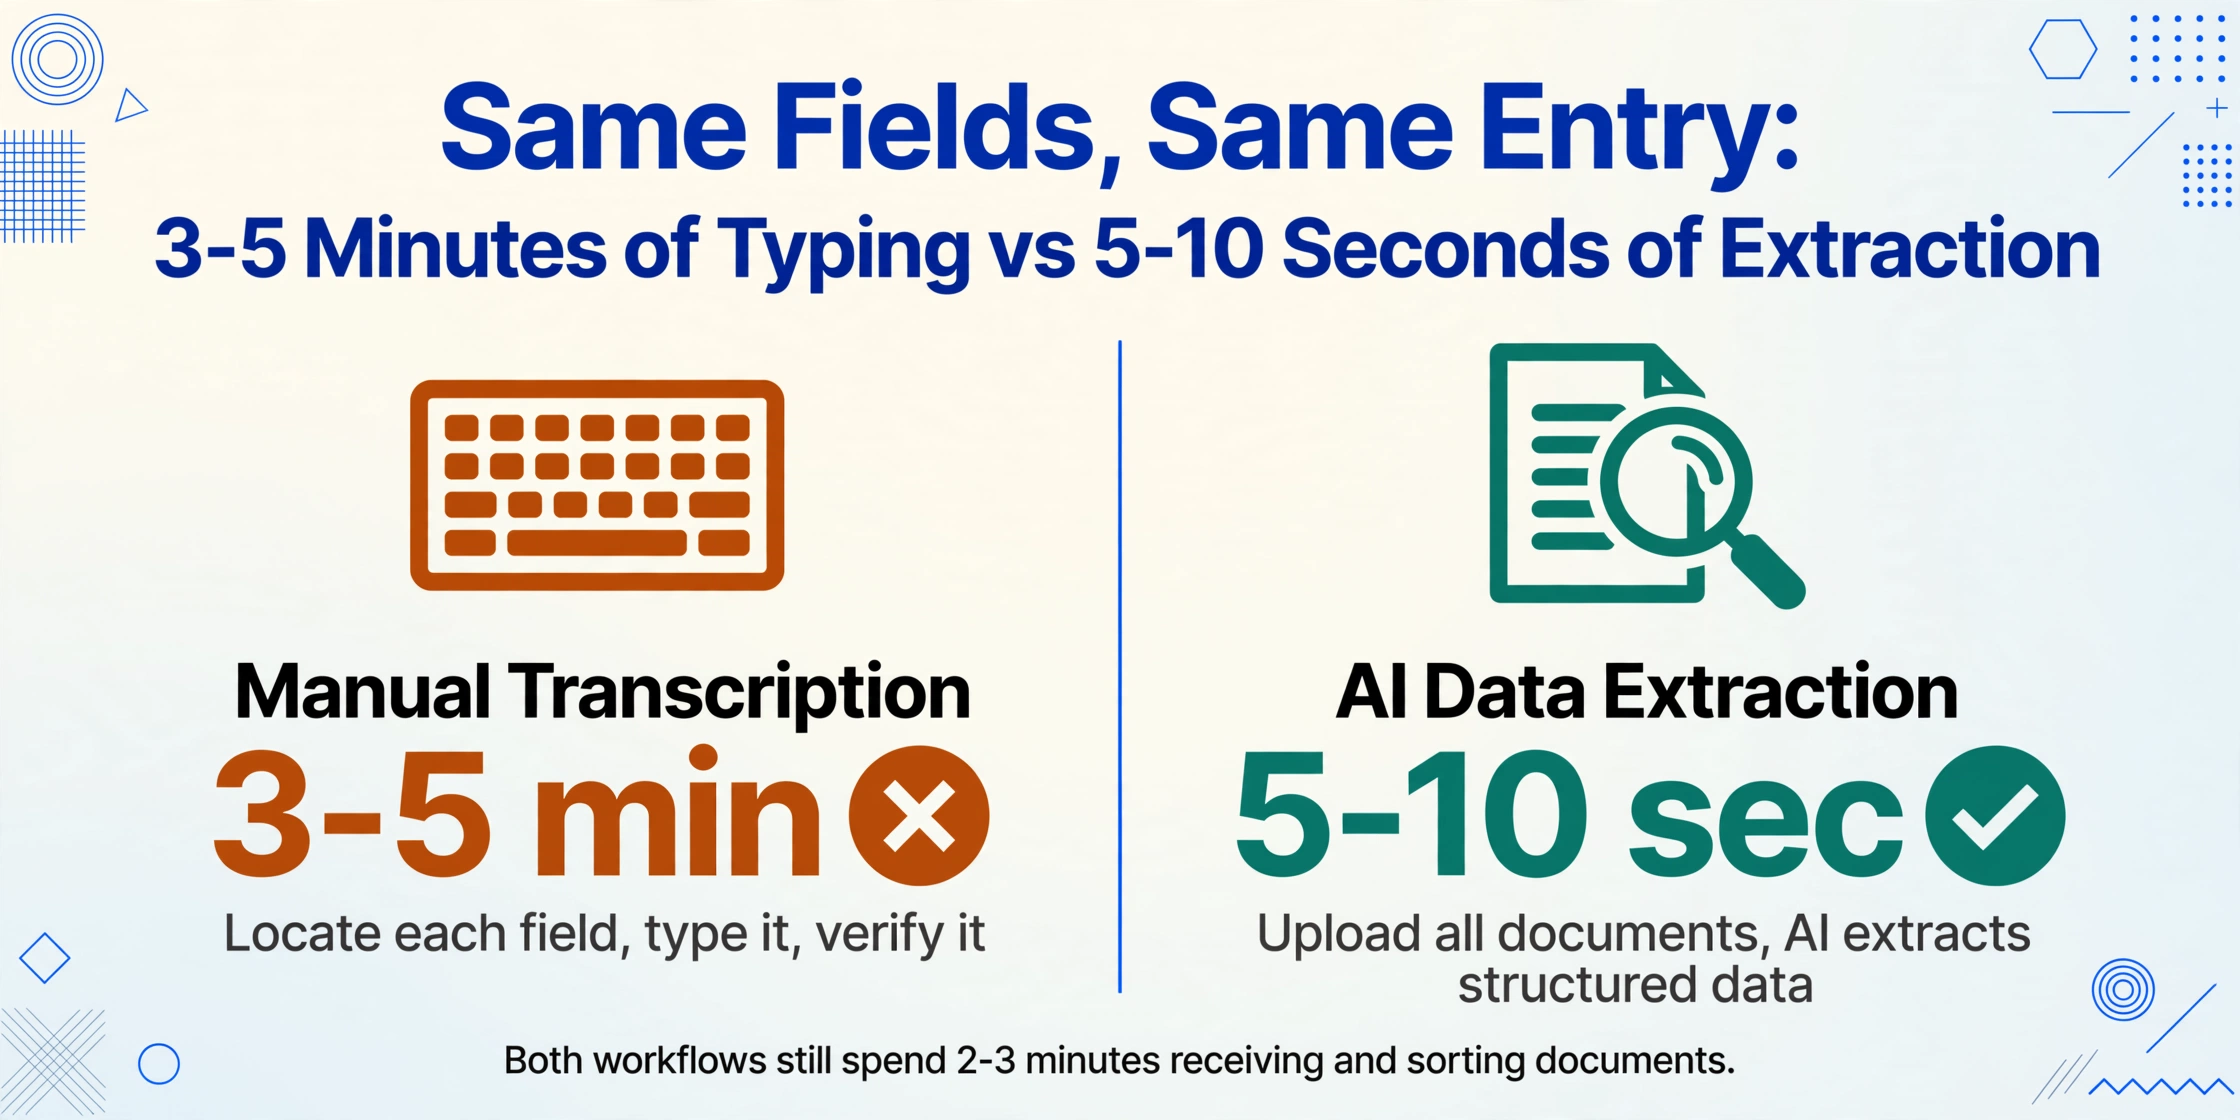
A etapa de extração, isoladamente, cai de 3-5 minutos por declaração para 5-10 segundos. Com 20 declarações por dia, isso recupera cerca de 1-1,5 horas — não do processo inteiro de preparação da declaração, mas especificamente do trabalho mecânico de transcrição. As etapas de classificação, arquivamento e conformidade permanecem inalteradas em tempo e qualidade, pois não se beneficiam de digitação mais rápida. Elas se beneficiam do operador ter mais capacidade mental ao chegar nelas.
O mecanismo que produz essa velocidade é a extração por nome de coluna: em vez de ler cada documento e transcrever campo por campo, você define os pontos de dados desejados — "Código HS", "Valor Declarado", "País de Origem", "Nome do Consignatário" — e a IA localiza cada valor em qualquer lugar da página ao compreender seu significado semanticamente. Um campo rotulado como "商品编码" em uma declaração de exportação chinesa, "HS Code" em um formulário CBP 7501 e "Commodity Code" em um SAD da UE são todos mapeados para a mesma coluna na sua saída, sem configuração de modelo por formato. Para um guia detalhado dessa abordagem em diferentes formatos de declaração, veja como extrair dados de formulários de declaração aduaneira para o Excel.
Os arquivos são processados com segurança e não são armazenados.
O tempo de processamento de 5-10 segundos por página, comparado a cerca de 3 minutos por página de transcrição manual, significa que a vantagem de velocidade se acumula diretamente com o volume — mas apenas para a etapa de extração. As etapas de tomada de decisão permanecem no mesmo ritmo, pois a expertise aduaneira é o valor, não o gargalo. Um despachante que lida com 10 declarações por dia economiza cerca de 30-50 minutos. Um que lida com 50 economiza 2,5-4 horas. O ponto de inflexão em que a economia de tempo cruza o território de "isso muda como eu estruturo meu dia" é em torno de 20-25 declarações diárias.
Precisão: três tipos de erros na declaração aduanera — e quais deles a automação realmente elimina
A palavra "precisão" é usada de forma genérica no marketing de automação, mas os erros na declaração aduanera não são uma única categoria. Eles se dividem em três tipos distintos, e a automação aborda cada um de forma diferente. Ser preciso sobre quais erros ela elimina e quais não elimina é o que diferencia uma comparação honesta de um discurso de vendas.
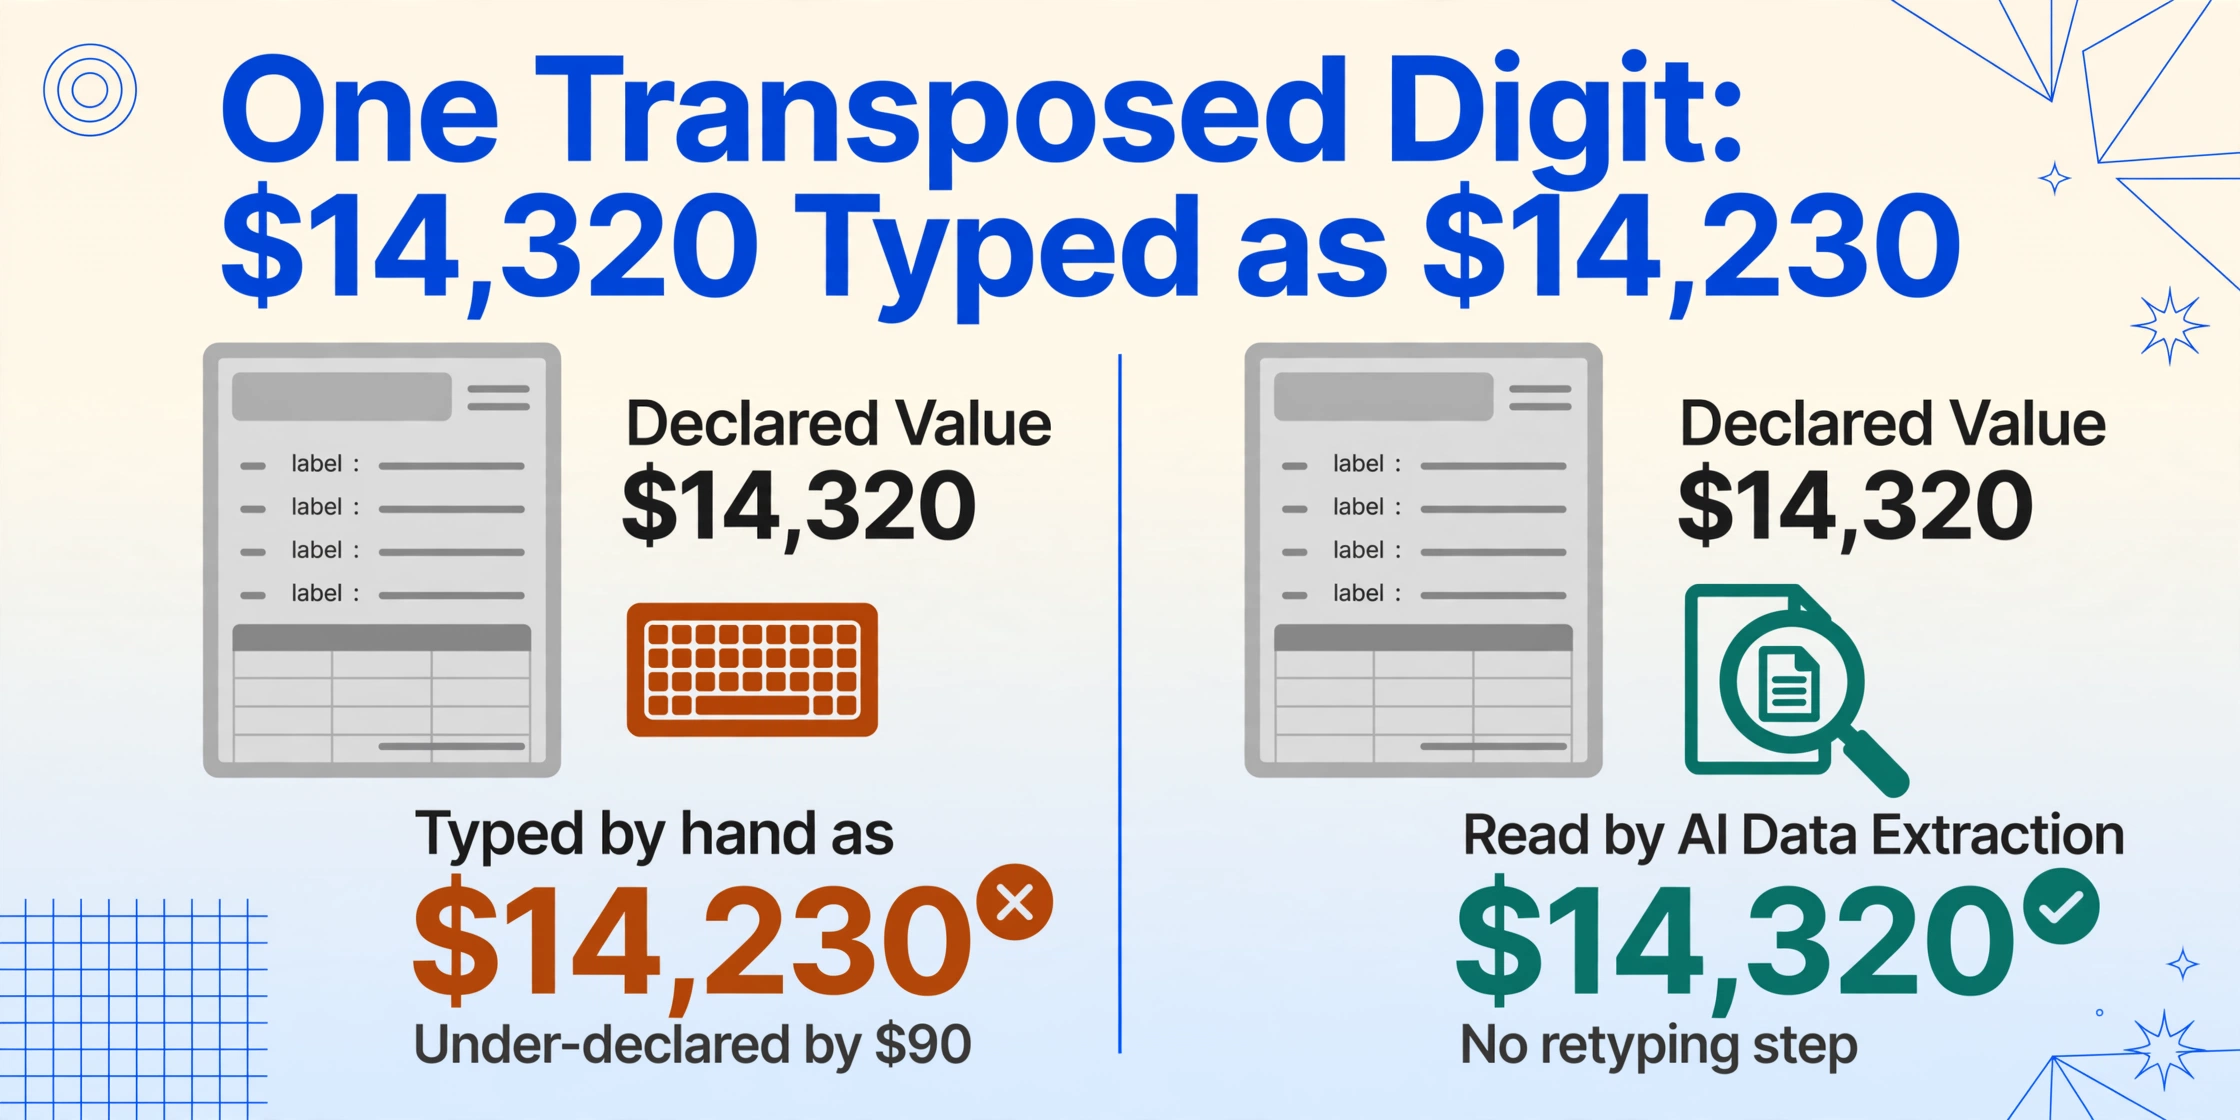
Erros de transcrição. A fatura indica que o valor declarado é $14.320. O operador digita $14.230. Um dígito transposto. Se este erro sobrevive até o arquivamento e a validação do CBP não o detecta — o que acontece quando o valor está dentro de um intervalo plausível —, o importador subdeclarou por $90, criando uma responsabilidade em cada entrada subsequente com o mesmo padrão de erro. Décadas de pesquisa em estudos de entrada de dados situam as taxas de erro humano de transcrição qualificado entre 0,5-1% em condições controladas e 2-5% em condições do mundo real, com formatos de documentos variados, pressão de tempo e fadiga de final de jornada. Para um despachante que arquiva 500 entradas por mês, uma taxa de erro de 1% significa que 5 entradas por mês contêm um erro de transcrição — e essas 5 entradas, se detectadas em uma avaliação focalizada do CBP, podem desencadenar uma revisão de cada entrada arquivada nos últimos cinco anos sob os requisitos de manutenção de registros da 19 CFR Part 163. A extração por IA elimina os erros de transcrição por completo — a IA lê o valor diretamente do documento sem uma etapa de redigitación humana. Se a IA o lê corretamente, o valor é correto. Se o documento é uma digitalização de baixa qualidade onde a IA pode ler mal, o operador revisa essa entrada específica em lugar de digitar manualmente cada entrada.
Erros de classificação e código. O operador atribuye o HTS 8471.30.0100 (máquinas automáticas portátiles de processamento de dados) ao que acredita ser um tablet — mas o produto é, na realidade, um dispositivo com capacidade celular que devería ser classificado sob 8517.12.0050. Este não é um erro de transcrição; o operador digitó o código que pretendía. É um erro de juzgamento de classificação, e é o tipo de erro com as maiores apostas financeiras. As penalidades do CBP por negligencia em importaciones sujetas a aranceles oscilan entre 0,5 e 2 veces la pérdida de derechos; por negligencia grave, hasta 4 veces; por fraude, hasta 8 veces los derechos perdidos. En artículos no sujetos a aranceles, las penalidades pueden alcanzar el 50-80% del valor de la mercancía por fraude. La extracción por IA no elimina los errores de clasificación. Lo que puede hacer es señalar inconsistencias — la IA lee la descripción de la carga de la factura y el código HS de la declaración, y si la descripción dice "paquete de baterías de iones de litio" y el código es 8507.60.0020 (baterías de almacenamiento de iones de litio), el operador recibe una señal de verificación cruzada en lugar de encontrar la discrepancia manualmente en tres documentos. Pero la decisión de clasificación en sí misma sigue siendo un juicio humano.
Erros de consistência entre documentos. A fatura comercial informa 1.200 unidades. A lista de embalagem informa 1.150. O conhecimento de embarque informa 1.200. O operador digita 1.200 da fatura e nunca confere a lista de embalagem porque está na 14ª entrada da tarde. A declaração é registrada com uma divergência de quantidade entre os documentos de origem — e o sistema de triagem automatizada do CBP sinaliza a inconsistência no nível do manifesto. Este é o tipo de erro que um estudo de pesquisa sobre documentação de despacho de cargas descobriu afetar 40% das remessas, sendo as discrepâncias entre documentos o problema documental mais comum. A extração por IA reduz isso processando todos os documentos de uma remessa em conjunto — a tabela de dados extraída mostra o campo de quantidade da fatura, da lista de embalagem e do conhecimento de embarque lado a lado. Uma linha 1.200 / 1.150 / 1.200 é imediatamente visível. O operador não precisa abrir três documentos separados e lembrar de comparar.
| Tipo de Erro | Fluxo de Trabalho Manual | Fluxo de Trabalho Assistido por IA |
|---|---|---|
| Transcrição (erros de digitação, transposição) | Presente — 0,5-5% por campo, dependendo das condições e do cansaço | Eliminado — a IA lê o documento diretamente; sem etapa de redigitação humana |
| Classificação e código HS | Presente — erro de julgamento, não mecânico | Não eliminado — mas verificado: a IA sinaliza divergências entre descrição e código para revisão |
| Consistência entre documentos | Presente — verificação manual sequencial entre documentos, facilmente ignorada sob pressão de tempo | Reduzido — todos os documentos processados em conjunto; divergências visíveis lado a lado na saída |
As estatísticas comerciais do CBP para o ano fiscal 2025 colocam o que está em jogo em termos concretos: 2.432 penalidades comerciais emitidas, 53.052 danos liquidados e US$ 34,41 bilhões recuperados em revisões de resumo de declaração. Cada uma dessas constatações começou com um dado incorreto em uma declaração aduaneira — um erro de transcrição, uma classificação incorreta, uma inconsistência de dados. Nem todas foram causadas por entrada manual de dados, mas cada uma delas foi uma falha de qualidade de dados. A diferença entre uma taxa de erro de 1% em 500 declarações por mês e uma precisão de extração acima de 99% é a diferença entre 5 erros por mês e potencialmente zero — e em um ambiente regulatório onde um único erro pode desencadear uma revisão retroativa de cinco anos, o efeito cumulativo é o que importa, não a taxa por declaração.
Escalabilidade: Com 20 Declarações por Dia, o Preenchimento Manual Não É um Processo — É um Problema de Contratação
A dimensão da escalabilidade é onde o modo de falha do fluxo de trabalho manual se torna estrutural, em vez de operacional. Abaixo de 5 declarações por dia, o preenchimento manual de dados é aceitável — não é rápido, mas contratar outra pessoa seria absurdo. Entre 5 e 15 declarações por dia, a ineficiência é visível, mas administrável: o operador gasta de 1 a 2 horas diárias em transcrição, o que é frustrante, mas não limita a capacidade da despachante.
Com 20 declarações por dia — o limite em que um único operador trabalhando um dia padrão gasta de 2 a 3 horas apenas com transcrição de dados — o fluxo de trabalho manual se torna um teto de produtividade. Adicionar outro cliente ou rota comercial significa adicionar outro funcionário, e o custo não é apenas o salário. A operação da Savino Del Bene na África do Sul fornece uma calibração do mundo real: processando mais de 50.000 faturas comerciais por ano para mais de 2.000 fornecedores, a empresa dedicava 80% do seu tempo à entrada manual de dados. Após implementar a automação do processamento de documentos, o processamento de faturas ficou 11 vezes mais rápido, e a economia mensal projetada excedeu US$ 100.000.
Esta é a aritmética de capacidade que importa para despachantes aduaneiros em escala:
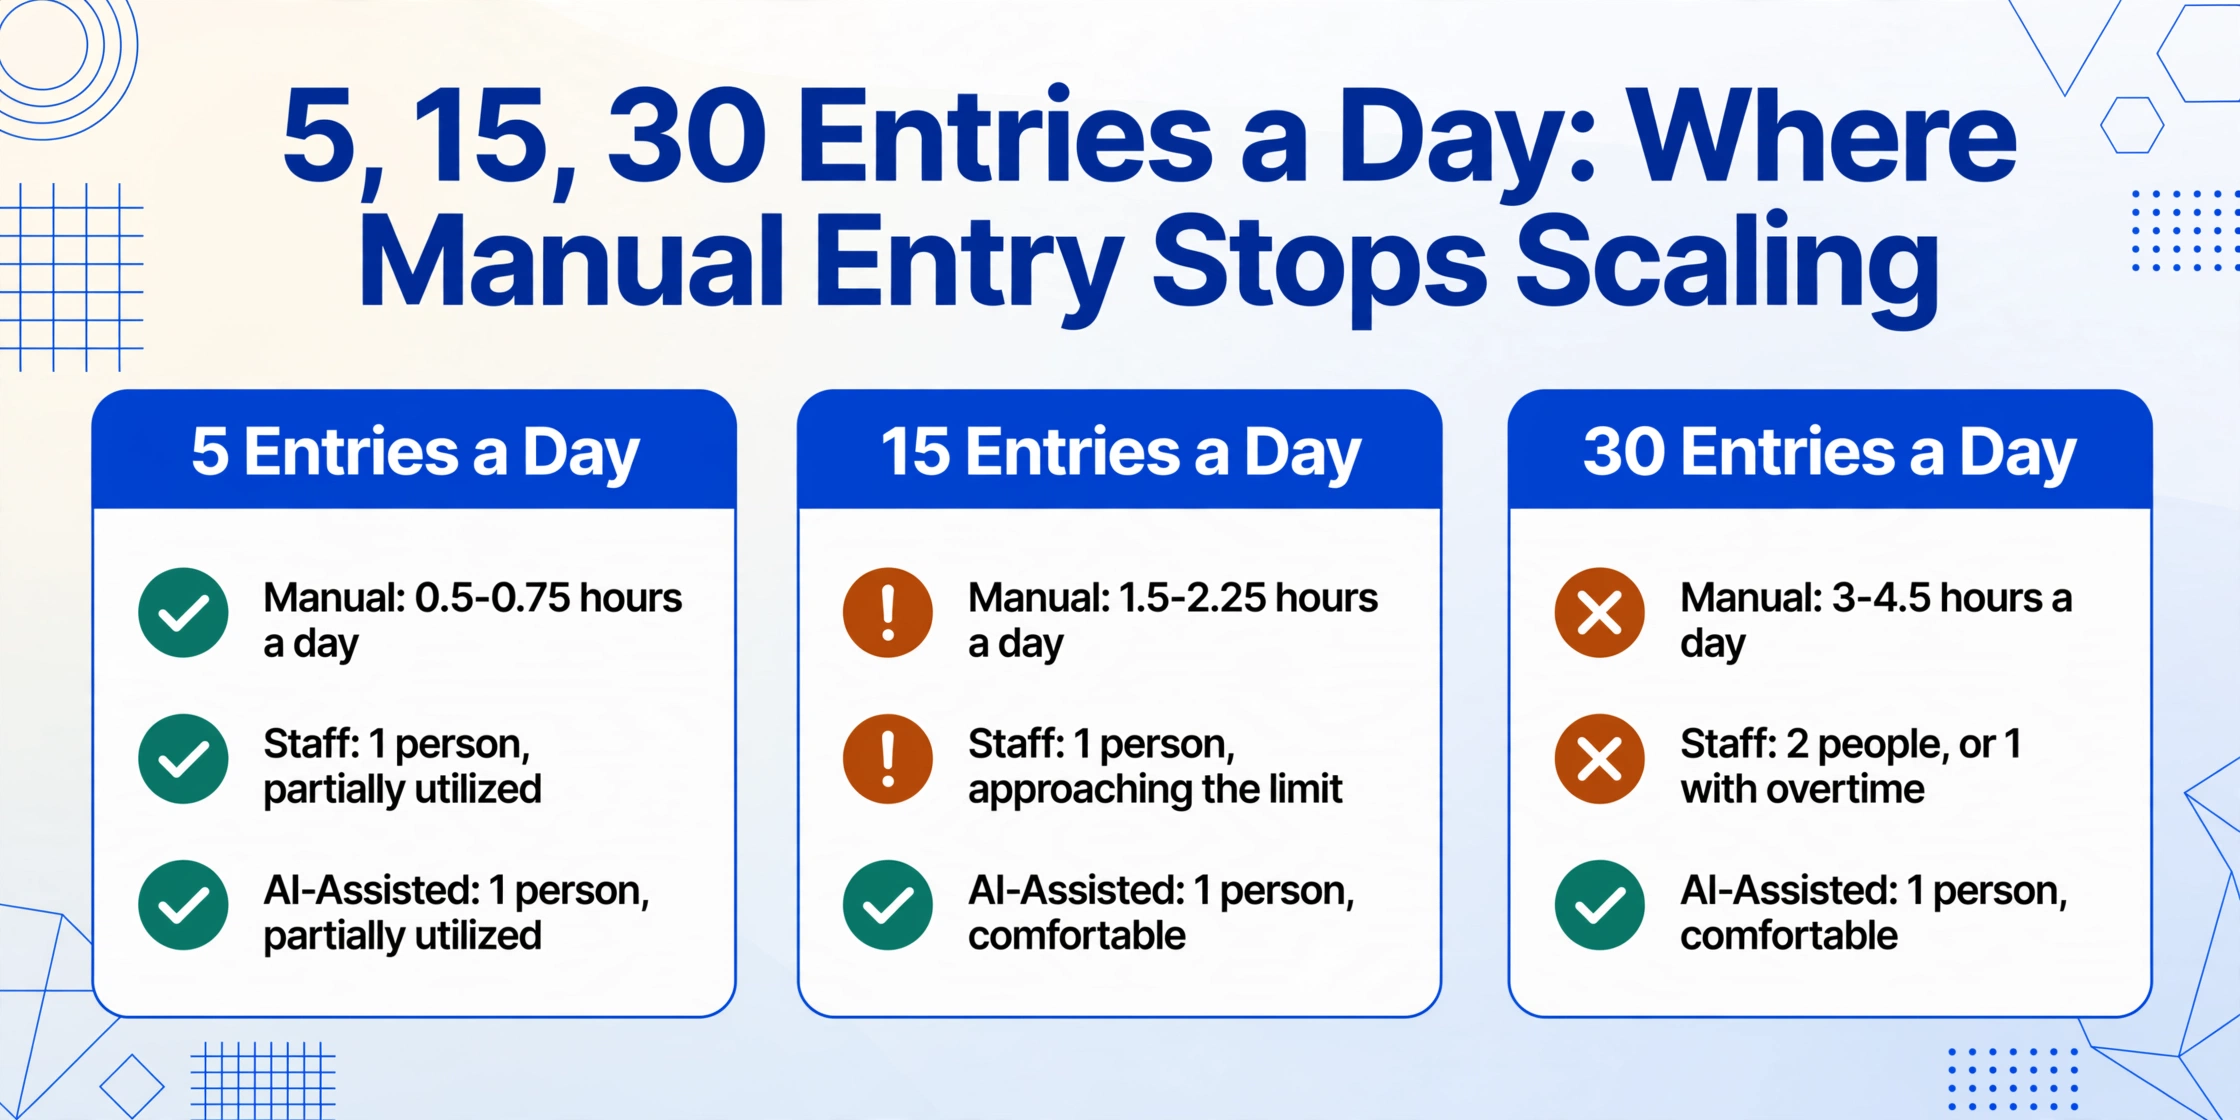
| Volume Diário de Declarações | Horas/Dia de Preenchimento Manual | Funcionários Necessários | Funcionários Necessários (Com IA) | Teto de Capacidade |
|---|---|---|---|---|
| 5 declarações | 0,5 a 0,75 horas | 1 (parcialmente utilizado) | 1 (parcialmente utilizado) | Não relevante |
| 15 declarações | 1,5 a 2,25 horas | 1 (próximo do limite) | 1 (confortável) | ~20 a 25 declarações/dia por pessoa |
| 30 declarações | 3 a 4,5 horas | 2 (ou 1 com horas extras) | 1 (confortável) | Tamanho da força de trabalho treinada disponível |
| 50+ declarações | 5 a 7,5 horas | 2 a 3 (mais cobertura) | 1 a 2 | O pipeline de contratação limita a produtividade |
Para uma corretora que lida com declarações de múltiplas linhas — embarques com 5 ou mais linhas de mercadoria, cada uma exigindo seu próprio código HS, valor, quantidade e país de origem — o tempo por declaração se multiplica. Uma declaração de 10 linhas com entrada manual de dados pode consumir de 30 a 45 minutos de transcrição em todas as linhas. Com a extração por IA, todas as 10 linhas de mercadoria são lidas dos mesmos documentos de origem no mesmo ciclo de processamento — de 5 a 10 segundos por página do documento de origem, não por linha de mercadoria. É aqui que o processamento em lote de declarações aduaneiras de múltiplas linhas em uma única planilha transforma a aritmética: 50 declarações de múltiplas linhas que exigiriam de 25 a 37 horas de transcrição manual tornam-se uma única sessão de upload e revisão medida em minutos.
Um estudo da Descartes Systems com mais de 400 despachantes de carga e corretores aduaneiros constatou que 67% veem a tecnologia como fundamental ou altamente importante para o crescimento — mas 61% citaram a pressão de preços dos clientes como um dos principais desafios. A tensão é clara: as corretoras precisam aumentar o volume para manter margens, mas o fluxo de trabalho manual que funciona com 20 declarações por dia não funciona com 50, e contratar profissionais aduaneiros treinados é uma das restrições mais citadas do setor. A automação não resolve a escassez de pessoal — ela muda a aritmética de pessoal para que os funcionários existentes possam lidar com o crescimento sem que cada novo cliente exija um aumento proporcional no quadro de funcionários.
O Investimento em Aprendizado: O Que Realmente Custa Adotar a Entrada de Dados Aduaneiros Assistida por IA
O argumento mais forte para o fluxo de trabalho manual é que ele exige zero adoção de tecnologia. Um corretor aduaneiro recém-licenciado que sabe ler uma fatura comercial e navegar no portal ACE pode começar a preparar declarações no primeiro dia. Todo corretor aduaneiro já sabe quais dados precisa extrair, em que formato eles precisam estar e o que acontece se estiverem errados. O processo manual é lento, propenso a erros e limitado em volume — mas é universalmente acessível. Qualquer fluxo de trabalho alternativo precisa conquistar seu lugar diante de um processo que não custa nada para começar e não exige treinamento.
O investimento em aprendizado para a extração assistida por IA está concentrado em um único novo padrão: em vez de abrir cada documento e digitar valores no software de declaração, você envia todos os documentos de origem de um embarque de uma só vez e define o que deseja extrair usando nomes de colunas — "Nome do Remetente", "Endereço do Consignatário", "Código HS", "País de Origem", "Valor Declarado", "Peso Líquido". A IA lê cada campo entendendo o que ele significa semanticamente, não pela posição em um formulário específico. Uma vez definidos, esses conjuntos de colunas podem ser salvos e reutilizados — um importador que registra os mesmos tipos de declarações nas mesmas rotas comerciais usa o mesmo modelo de colunas todas as vezes. O esforço por declaração se torna: enviar documentos, selecionar modelo salvo, exportar a tabela de extração, revisar.
Isso é fundamentalmente diferente dos sistemas tradicionais de template OCR, que exigem configurar um template separado para cada formato de documento — o template CBP 7501, o template SAD da UE, o template de declaração de exportação chinês, além do formato de fatura de cada fornecedor. O fardo da manutenção de templates foi o que derrotou as gerações anteriores de automação aduaneira, especialmente em corretoras que lidam com fornecedores de vários países cujos formatos de documento mudam sem aviso prévio. A extração por IA contorna isso porque lê pelo significado, não pela posição em um layout de formulário conhecido.
Para efeito de comparação: uma implementação de EDI conectando um despacho aduaneiro ao sistema ERP de um cliente pode levar meses de mapeamento, testes e certificação — e só funciona com aquele cliente específico. A implantação de uma plataforma completa de gestão aduaneira pode levar semanas, exige envolvimento de TI e pressupõe que todos os dados comerciais fluam pelo mesmo sistema. A extração assistida por IA tem uma curva de aprendizado medida pelo tempo necessário para enviar um documento e digitar um nome de coluna. Com 20 declarações por dia, o investimento de tempo para aprender o novo padrão — cerca de 15 a 30 minutos testando em algumas declarações de exemplo — é recuperado no primeiro dia de uso.
As definições de colunas criadas para declarações aduaneiras também podem ser usadas para outros documentos comerciais — faturas comerciais, listas de embalagem, certificados de origem — porque o mecanismo de extração não distingue entre tipos de documento. O mesmo modelo salvo que extrai códigos HS e valores declarados de um formulário aduaneiro também extrai números de fatura e totais de uma fatura comercial quando aplicado a esse documento. Essa reutilização entre documentos significa que a biblioteca de modelos cresce com o uso, e não com a quantidade de formatos de documentos.
Onde a Entrada Manual Ainda Vence — e Onde a Diferença é Intransponível
Uma comparação dimensional só é útil se for honesta em relação a ambos os lados. O fluxo de trabalho manual tem vantagens genuínas que a extração assistida por IA não elimina, e reconhecer isso dá peso ao restante da comparação:
- Custo marginal zero. A entrada manual exige uma pessoa treinada e acesso ao software de declaração — ambos já disponíveis no despacho. Para operações que lidam com menos de 5 declarações por dia, a economia de tempo da automação não recupera o custo da ferramenta. Abaixo desse volume, o fluxo de trabalho manual é a escolha economicamente racional.
- Julgamento contextual ausente nos documentos. Um despachante experiente ao ler uma fatura comercial pode notar que o valor declarado está suspeitamente baixo para as mercadorias descritas — um sinal de alerta de preços de transferência que a extração por IA não sinaliza porque ela apenas lê o que está na página, não o que está faltando. Esse conhecimento institucional — "este fornecedor subavalia consistentemente eletrônicos em suas faturas e é sinalizado na CBP" — vive na mente do despachante, não em nenhum documento, e surge durante a revisão manual de uma forma que a extração automatizada não reproduz.
- Comunicação entre múltiplas partes. Quando uma declaração aduaneira gera uma Solicitação de Informações da CBP (Formulário 28 da CBP) ou um Aviso de Ação (Formulário 29 da CBP), a resposta exige comunicação com o importador, o fornecedor e possivelmente um advogado especializado em comércio exterior. Esse fluxo de trabalho é inerentemente humano — nenhuma ferramenta de extração automatiza isso, e nenhuma deveria tentar. A gestão de relacionamento do despachante e as habilidades de comunicação regulatória são o valor aqui, não a etapa de entrada de dados que precedeu a consulta.
- Integração com a interface de envio governamental. A extração por IA produz uma tabela de dados estruturados. Levar esses dados para o sistema ACE, CDS ou ATLAS ainda exige reentrada manual no sistema de envio ou uma camada de integração de software. Algumas plataformas de gestão aduaneira (Descartes, AEB, iCustoms) oferecem conexões de API que aceitam dados estruturados diretamente, mas despachos que usam sistemas de envio independentes ou legados ainda terão uma etapa de transferência manual da tabela de dados extraída para o software de declaração — a menos que usem a saída da extração como fonte de verificação, em vez de entrada direta.
As dimensões em que a entrada manual perde — e perde em proporção direta ao volume — são velocidade, precisão de transcrição e escalabilidade. Estas dimensões se combinam: uma corretora que economiza 1,5 horas por dia em transcrição com 20 entradas pode lidar com mais entradas sem adicionar pessoal, pode dedicar esse tempo recuperado à revisão de conformidade em vez de digitação de dados, e pode reduzir a taxa de erro que desencadena os tipos mais comuns de penalidades da CBP. Os 7 erros mais comuns de entrada de dados aduaneros que causam atrasos no despacho são predominantemente erros de transcrição e de consistência entre documentos — exatamente as categorias que a extração por IA aborda.
A metodologia do Time Release Study da Organização Mundial das Alfândegas — agora em sua 4ª versão — identificou repetidamente que o principal gargalo no despacho de carga não é a inspeção física, nem o congestionamento portuário, mas o tempo entre a chegada do documento e a apresentação da declaração. Em programas piloto do Banco Mundial, a automação fronteiriza redujo o despacho de uma média de 3,6 dias a menos de 1 dia em países que adotaram a pré-autorização digital e a coordinação de Single Window. A etapa de preparação da declaração — onde vive a entrada manual de dados — é a maior oportunidade de compressão de tempo no processo de despacho de ponta a ponta. Isso não é uma afirmação de vendas. É o que a própria metodologia de medição da OMA constata consistentemente.
Preguntas Frecuentes Sobre Entrada de Datos Aduaneros Manual vs IA
¿A qué volumen de entradas debe una corretora aduanera pasar de la entrada manual a la asistida por IA?
Alrededor de 10-15 entradas por día. Por debajo de eso, el ahorro de tiempo de la automatización puede no recuperar la inversión de aprendizaje lo suficientemente rápido como para justificar el cambio — especialmente para corretoras con una base de clientes estable que usan formatos de documentos familiares donde el operador desarrolla velocidad mediante la repetición. A 20+ entradas por día, el flujo de trabajo manual consume 2-3 horas de transcripción que podrían recuperarse, y el costo de automatizar ese paso es menor que el costo de contratar personal adicional para manejar el mismo volumen. El punto de equilibrio depende de su costo laboral cargado por hora y su volumen diario de entradas, pero para la mayoría de las corretoras, se sitúa entre 10 y 20 entradas diarias.
Como a extração por IA é diferente do EDI para declarações aduaneiras?
EDI (Electronic Data Interchange) é uma troca máquina a máquina de dados estruturados entre sistemas que já entendem o mesmo formato — por exemplo, o sistema ERP de um cliente transmitindo dados de pedido de compra diretamente para o sistema de arquivamento do despachante aduaneiro em um formato de dados pré-acordado. O EDI funciona quando ambas as partes investiram na integração e mantêm estruturas de dados compatíveis. A extração por IA lê documentos não estruturados — PDFs, digitalizações, imagens — que chegam de fornecedores que nunca implementarão EDI porque são fábricas em Shenzhen, distribuidores em Mumbai ou pequenos fabricantes no Vietnã que enviam faturas comerciais como anexos de e-mail. O EDI e a extração por IA abordam diferentes partes da cadeia de fornecimento de documentos: EDI para grandes clientes com sistemas integrados, extração por IA para a longa cauda de fornecedores e formatos que compõem a maioria da documentação comercial.
A extração por IA substitui um despachante aduaneiro?
Não. Ela substitui a etapa de transcrição de dados — ler valores de documentos e digitá-los em software. Ela não substitui, e não pode substituir, a expertise em classificação, o conhecimento regulatório, a análise de programas comerciais, a consultoria ao cliente ou a comunicação com a CBP que constituem o serviço profissional real de despacho aduaneiro. A automação discutida nesta comparação opera no pipeline documento-para-dados, não no julgamento do despachante. Um despachante que usa extração por IA ainda classifica mercadorias, ainda determina a aplicabilidade de acordos de livre comércio, ainda lida com consultas da CBP e ainda aconselha clientes sobre estratégia de conformidade. A diferença é que o despachante gasta menos tempo transcrevendo dados de faturas e mais tempo nas etapas que exigem licença e expertise profissional.
Com quais formatos de documento a extração por IA funciona para entradas aduaneiras?
Arquivos PDF (tanto gerados digitalmente quanto digitalizados), imagens JPG/PNG, WebP e AVIF são todos suportados. Isso cobre a variedade real de documentos comerciais: PDFs gerados por ERP, faturas comerciais digitalizadas, fotos de listas de embalagem em papel e capturas de tela de portais de fornecedores. Escrita manual em documentos digitalizados é legível, embora a precisão diminua com a qualidade da digitalização — uma digitalização limpa a 300 DPI produz extração quase perfeita, enquanto uma foto de celular de baixa resolução de uma lista de embalagem manuscrita em ângulo pode exigir verificação manual de campos específicos.
A extração por IA consegue processar documentos comerciais em vários idiomas?
Sim. O modelo de linguagem visual subjacente lê texto em qualquer idioma. Uma declaração de exportação chinesa, uma fatura comercial alemã, uma lista de embalagem espanhola e um certificado de origem coreano são todos processados da mesma maneira — os nomes de colunas definidos em inglês guiam a extração, e a IA localiza os valores correspondentes independentemente do idioma do documento de origem. Os campos numéricos — valores, pesos, quantidades, códigos HS — são extraídos de forma limpa, independentemente do idioma. Para despachos que gerenciam tráfico multi-via na Ásia, Europa e Américas, isso elimina o atrito específico do idioma que, de outra forma, exigiria pessoal bilíngue para a entrada de dados.
As definições de colunas de extração podem ser reutilizadas entre entradas e clientes?
Sim. Um conjunto padrão de colunas para entrada de importação — Importador Registrado, Consignatário, País de Origem, Código HS, Descrição de Mercancías, Quantidade, Unidade de Medida, Valor Declarado, Moeda, Tasa de Derechos, Peso Bruto, Número de Conocimiento de Embarque — pode ser definido uma vez, salvo na sua conta e aplicado a cada entrada subsequente com um único clique. Para despachos que gerenciam diferentes tipos de entradas (entradas de consumo formal vs. entradas informales vs. bonos de importación temporal), vários modelos de columna podem ser salvos para cada tipo de entrada. A biblioteca de modelos cresce com o uso, não com o número de formatos de documentos que você encontra.
A extração por IA atribuye códigos HS automáticamente?
Algunas plataformas especializadas de IA aduanera (Digicust, iCustoms) ofrecen sugerencia de códigos HS y asistencia de clasificación como una función separada. La extracción de ImageToTable.ai lee el código HS si ya está impreso en el documento — por ejemplo, cuando un proveedor incluye el código HTS en su factura comercial. No clasifica productos sin código ni sugiere códigos HS para artículos sin una clasificación arancelaria impresa. El paso de clasificación sigue siendo una decisión humana informada por la experiencia del despachante, las Reglas Generales de Interpretación y las bases de datos de resoluciones de CBP. Si necesita clasificación asistida por IA, busque plataformas específicas de aduanas que combinen extracción con clasificación. Si necesita extracción de documentos donde los códigos HS ya están presentes pero enterrados en formatos inconsistentes, la herramienta maneja eso directamente.
Os dados extraídos são integrados diretamente ao sistema ACE da CBP?
Não — e essa é uma distinção importante. A extração produz dados estruturados em Excel, CSV ou JSON. Para inserir esses dados no portal ACE, CDS ou ATLAS, ainda é necessário reentrada manual ou uma camada de integração de software. Corretoras que utilizam plataformas de gestão aduaneira com conectividade via API (Descartes, AEB, CargoWise da WiseTech) podem importar dados estruturados diretamente. Corretoras que fazem declarações diretamente pelo ACE Secure Data Portal precisarão transferir manualmente os dados extraídos para o portal ou usar um sistema de gestão de corretagem com capacidade de importação de dados. A extração elimina a etapa de documento-fonte-para-dados-estruturados. Ela não elimina a etapa de dados-estruturados-para-sistema-de-declaração, a menos que seu software de declaração ofereça suporte a isso.
A intermediação aduaneira é uma profissão de alto risco, em que um único código HTS classificado incorretamente pode desencadear uma auditoria retroativa de cinco anos. A pergunta que esta comparação responde não é se a IA torna a entrada manual obsoleta — não torna, e para corretoras que lidam com menos de 10 entradas por dia, a entrada manual continua sendo o padrão racional. A questão é em que volume a economia se inverte. A 20 entradas por dia, o fluxo de trabalho manual consome 2 a 3 horas de transcrição que poderiam ser recuperadas. A 50 entradas, consome o equivalente ao salário de um funcionário em tempo integral em digitação. A tecnologia de extração existe. A WCO, a FIATA e as autoridades aduaneiras nacionais estão todas avançando em direção à documentação comercial digitalizada. A decisão para cada corretora é quando — não se — separar a etapa de leitura de documentos da etapa de expertise aduaneira, e parar de pagar profissionais licenciados para fazer um trabalho que uma máquina pode fazer melhor.
Relacionado: Como extrair dados de declarações aduaneiras para o Excel · Processamento em lote de declarações aduaneiras de vários países em uma única planilha · 7 erros de digitação de dados aduaneiros que causam atrasos no desembaraço