LINEチャットのスクリーンショットから
日本の住所と注文情報を抽出する
住所はLINEメッセージとして届きます。漢字、アラビア数字、そして正しい形式の日本の住所の先頭に付く特徴的な郵便記号(〒)を含むチャットバブルです。LINEで注文を受け付ける何千もの日本の中小企業にとって、これが配送情報がワークフローに入る方法です。スクリーンショットを1枚ずつ、配送ラベルや台帳に手作業で転記していくのです。
重要なポイント
- LINE内の日本の住所は〒郵便記号を起点とし、都道府県、市区町村、丁目番地、建物名、氏名、電話番号と続きます。すべて1つのチャットバブル内で漢字、カタカナ、数字が混在しています。
- 従来のOCRは「東京都渋谷区渋谷1-2-3」を文字として読み取れますが、どの部分が都道府県でどの部分が建物名かをラベル付けできません。テキストは見えても、住所の構造は見えないのです。
- 郵便番号、都道府県、市区町村、建物名、氏名、電話番号を列として定義します。LINEの注文スクリーンショットを一度に20枚アップロードすると、それぞれが1行になり、同じチャットメッセージからすべてのフィールドが入力されます。
LINEのチャットが日本で注文書になる理由
LINEは日本で最も広く使われているメッセージングプラットフォームで、人口1億2500万人のうち、月間アクティブユーザーは約9600万人に上ります。小売店、一人親方の職人、地域のパン屋、ハンドメイド作家にとって、LINEは顧客と話す手段であるだけでなく、注文を受ける手段でもあります。顧客が「Aを3つ、Bを2つください。住所はこれです」とメッセージを送り、メモを添付するか詳細を入力するだけで注文が成立します。ウェブサイトも、注文フォームも、ショッピングカートもありません。共同購入の規模になると、1つのスレッドに数十件のメッセージが並び、LINE共同購入チャットのスクリーンショットが注文台帳になります。
事業主はチャットのスクリーンショットから住所を読み取り、手作業で配送ラベルシステムや台帳に転記して注文を処理します。1日15〜20件の注文を扱う場合 — 花屋やパン屋のような個人経営ですぐに達する件数です — 手作業での住所転記がフルフィルメント業務のボトルネックになります。
日本の住所の構造も、さらに難易度を高めています。西洋の住所が通常2〜3行の短い行に収まるのに対し、日本の完全な住所は、1つのチャットメッセージに6〜7つの異なる構成要素が詰め込まれることがよくあります。それぞれが配送に重要で、一部でも欠けたり転記ミスがあれば、荷物は届きません。
LINEで送られる日本の住所の例
LINEで送られる典型的な住所は、次のようなものです:
〒150-0002 東京都渋谷区渋谷1-2-3
メゾン渋谷 101号室
山田太郎
090-XXXX-XXXX
このブロックの各構成要素には特定の配送情報が含まれており、従来の住所解析ツールはこれらが固定パターンで並んでいることを前提としています。各部分の意味は次のとおりです:
| 構成要素 | 例 | 役割 |
|---|---|---|
| 郵便番号 | 〒150-0002 | 〒マーク(郵便記号)に続く3桁+4桁の数字です。日本郵便の仕分けシステムへの入り口となります。 |
| 都道府県 | 東京都 | 47都道府県のいずれかです。漢字の接尾辞(都、道、府、県)が行政区分を示します。 |
| 市区町村 | 渋谷区 | 市区町村に続いて、その中の区や地区名が入ります。 |
| 丁目番地 | 渋谷1-2-3 | 丁目、番地、号の順に続きます。日本の住所は、通り名ではなくこの階層的な番号を使用します。 |
| 建物名 | メゾン渋谷 101号室 | アパートや建物の名前(多くの場合カタカナまたは漢字)と部屋番号です。 |
| 氏名 | 山田太郎 | 配達を受ける人のフルネームで、通常は姓が先に来ます。 |
| 電話番号 | 090-XXXX-XXXX | 携帯電話番号です。日本の配送業者が配達調整のために必要とします。 |
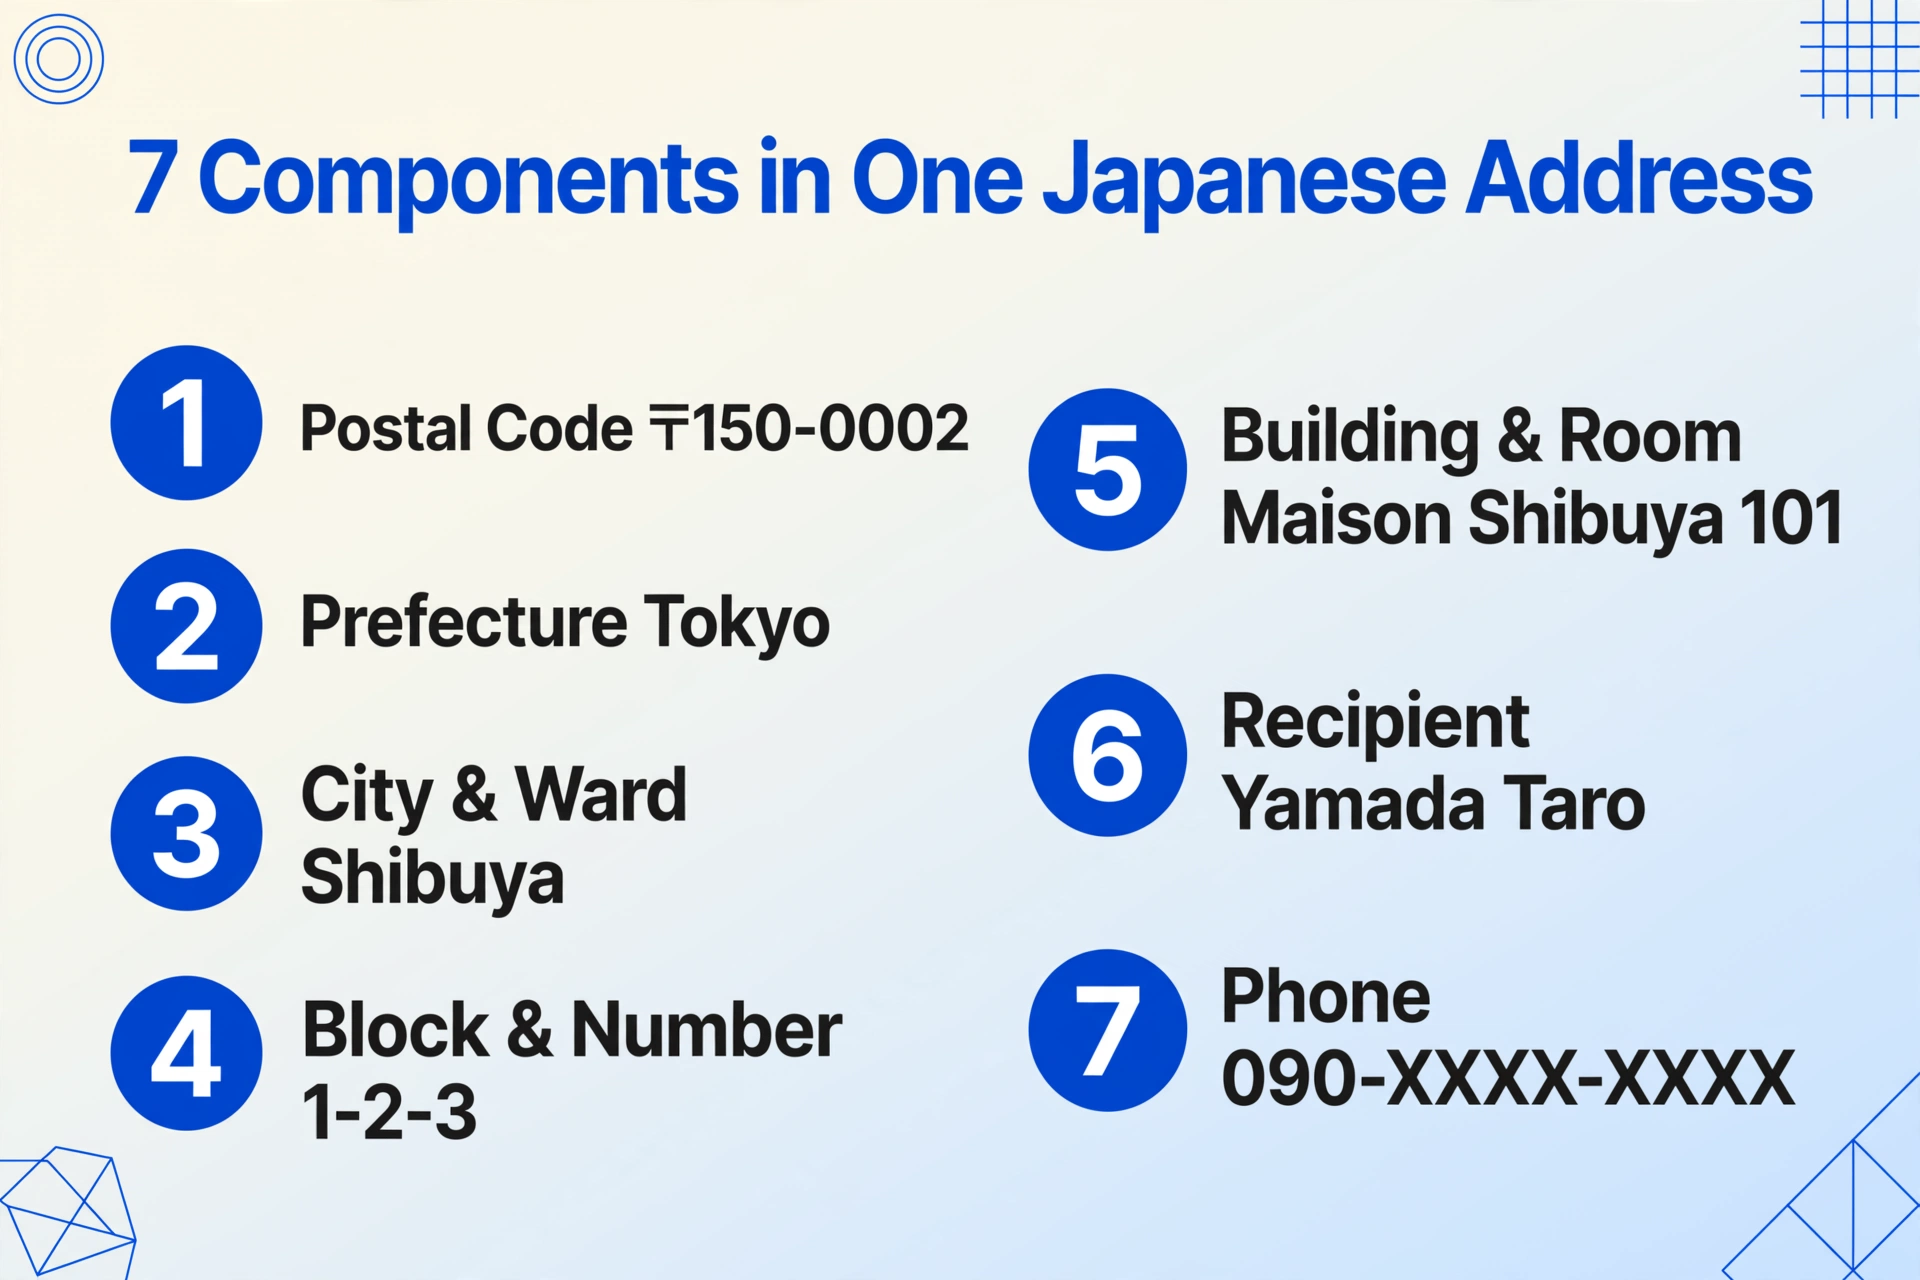
住所は、チャット内の1つのテキストブロックにまとまっていることも、複数行に分かれていることも、商品の個数や配送希望日時などの注文固有の詳細と混在していることもあります。フォームがないため、固定されたレイアウトはありません。顧客は単にチャットに入力しただけなのです。
この変動性こそが、従来のOCRが機能しない理由です。住所はラベル付きのフィールドや標準化された位置にあるわけではありません。配送情報がたまたま含まれている、複数の文字種が混在したテキストの段落なのです。
従来のOCRが見落としてしまう理由
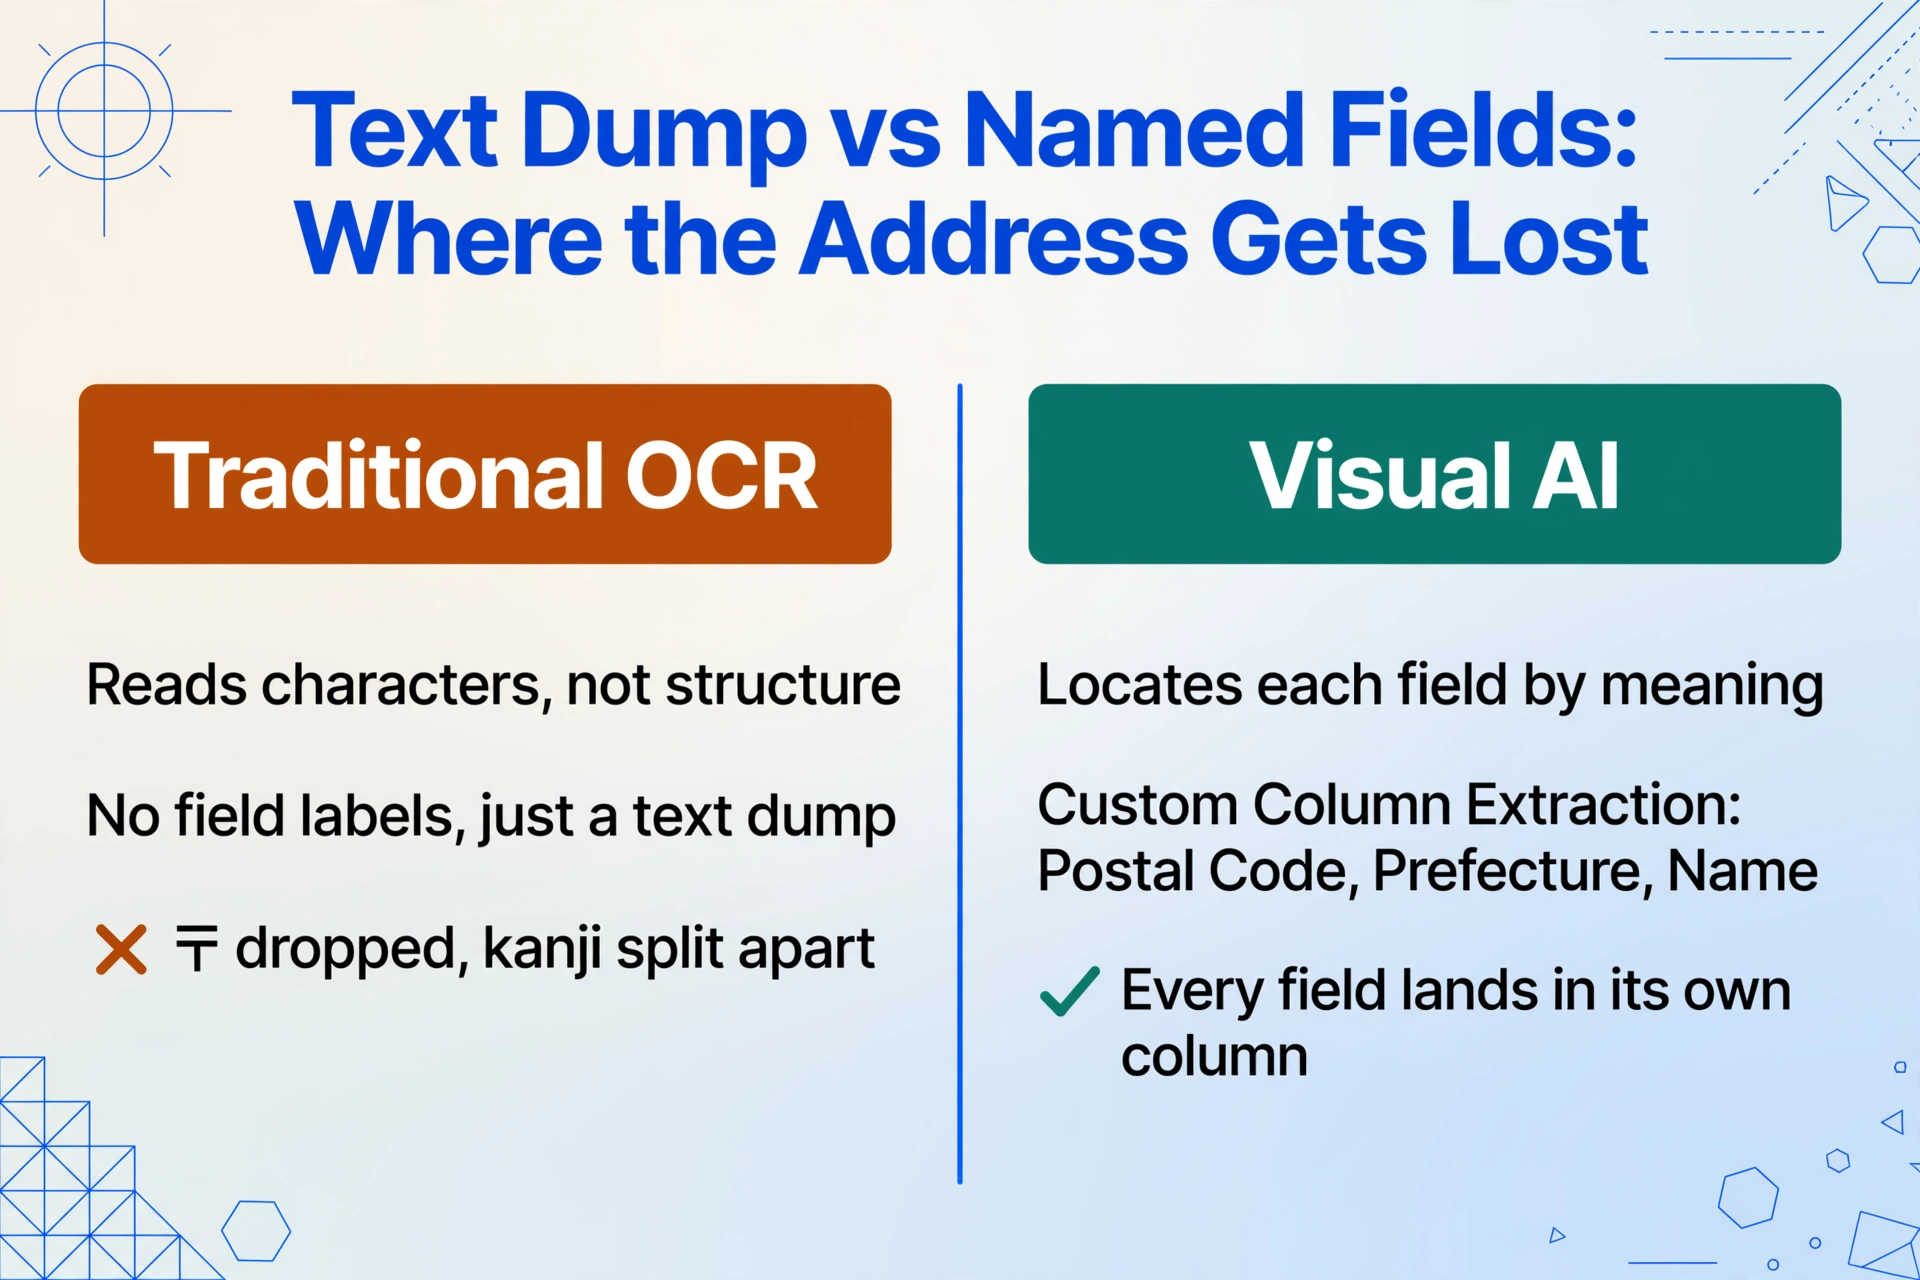
従来のOCRエンジン(Tesseract、クラウドOCR API、スキャナ内蔵ツールなど)は、文字を読むように設計されており、文書の構造を理解するようにはできていません。LINEのチャットスクリーンショットに含まれる日本語の住所を処理する際、3つの根本的な問題に直面します。
1つ目は、混在スクリプトの認識です。日本語の住所は、漢字(東京都、渋谷区)、ひらがな(建物名に使われることもあります)、カタカナ(メゾン)、アラビア数字(1-2-3、150-0002)を1つの文の中で組み合わせています。従来のOCRモデル、特に西洋の文書コーパスで訓練されたモデルは、これらのスクリプト間で認識精度にばらつきがあります。〒150-0002の数字は正しく読み取れても、郵便記号を落としたり壊したりすることがあり、画数の多い漢字(渋や藤など)は誤認識されたり、断片に分割されたりすることがよくあります。
2つ目は、固定されたフィールド位置がないことです。請求書や定型フォームでは、郵便番号は指定された欄に、都道府県名はラベル付きの行にあります。しかしLINEのチャットバブルでは、住所は顧客の注文リクエスト、挨拶、時には支払いのスクリーンショットと同じ視覚的スペースを共有しています。「画像の上部付近のテキスト」を探す位置ベースのOCRシステムでは、まったく別のコンテンツを拾ってしまうことになります。
3つ目は、フラットなテキスト出力です。従来のOCRは、認識された文字を改行付きの線形文字列として返します。「この漢字の並びは都道府県名である」と「この漢字の並びは建物名である」を区別することはできません。上記の住所の出力は、意味的なラベルのない単一のテキストブロックになり、事業主はOCR出力を手動で正しいフィールドに再解析する必要があり、自動化の目的が損なわれます。
Visual AIが住所を構造化フィールドとして読み取る仕組み
Visual AI — Custom Column Extractionを支える技術 — は、同じスクリーンショットを根本的に異なる方法で処理します。文字をスキャンしてテキストを出力する代わりに、画像全体を解釈し、意味のある領域を特定して、各領域で見つかったテキストに意味を割り当てます。
必要なフィールドを定義するだけで、AIは各要素が何であるかを理解してそれらを見つけ出します。ページ上の位置を推測するのではありません。
LINEの住所スクリーンショットの場合、次のような列を定義できます:
- 郵便番号 — AIが〒記号を見つけ、その後に続く数字コードを読み取ります
- 都道府県 — AIは都・道・府・県で終わる漢字を都道府県名として識別します
- 市区町村 — 都道府県に続く自治体名です
- 番地・建物名 — 丁目・番地の並びと建物名です
- 氏名 — 通常は単独の行または住所の後に表示される氏名です
- 電話番号 — 数字のパターンで認識される携帯電話番号です
AIが住所を正しく区分するのに役立つ視覚的な手がかりがいくつかあります。〒マークは住所ブロックの開始位置を示す信頼できる目印になります。漢字の接尾辞(都・道・府・県)は都道府県の境界を示します。ハイフン付きの数字パターン(1-2-3)は丁目・番地・建物の並びを示します。そして、住所の後に単独の行で表示される名前は、受取人として認識されます。
重要なのは、AIが日本の住所が最大の地理単位で始まり最小の単位で終わることを事前に教えられる必要がない点です。言語自体が構造的なマーカーを提供しており、AIはそれを読み取るよう訓練されているため、意味の階層を理解できます。
これは、支払いスクリーンショット、他の言語でのチャットメッセージ、固定レイアウトのないドキュメントからデータを抽出する場合にも適用される同じパラダイムです。出力列を定義すれば、AIは「LINEの日本語住所」用の事前構築テンプレートに一致させるのではなく、テキストの意味を理解して一致する値を見つけ出します。ハブ記事の非テーブルソースからのスクリーンショットデータ抽出で説明されているように、ソースが完全に非構造化されていても、データは画像内に存在します。違いは、意味的抽出がコンテンツを「どこに表示されているか」ではなく「何であるか」で読み取る点です。
同じアプローチは、注文が別のチャットアプリで届いた場合にも機能します。LINE用に設定した列定義 — 郵便番号、都道府県、市区町村、建物名、氏名、電話番号 — は、WhatsApp Businessチャット、iMessage、KakaoTalk、WeChatでの注文にも同様に適用できます。住所の形式は国やアプリによって変わりますが、読み取り方法は変わりません。
住所だけじゃない — スクリーンショットに含まれるその他の情報
LINEの注文スクリーンショットには、住所だけが含まれていることはほとんどありません。同じチャットの吹き出しや近くのメッセージには、通常、顧客の注文詳細も含まれており、住所と一緒にそれらを抽出することで、1枚のスクリーンショットが完全な注文記録になります。
バスクチーズケーキ ホール × 2
焼き菓子アソート × 1
合計 4,800円
配送希望: 7/12 午前中
LINEチャットメッセージで住所と一緒に表示される可能性のある注文テキストのサンプルです。
LINEの注文スクリーンショットから一般的に抽出できる項目は次のとおりです。
- 商品名と個数 — 顧客がリクエストしている商品
- 合計金額 — 顧客が合計を計算している場合、または支払いスクリーンショットが含まれている場合
- 配送希望日時 — 多くの場合、希望する時間帯として指定されます
- 備考 — ギフトラッピングのリクエストや代替品の希望などのメモ
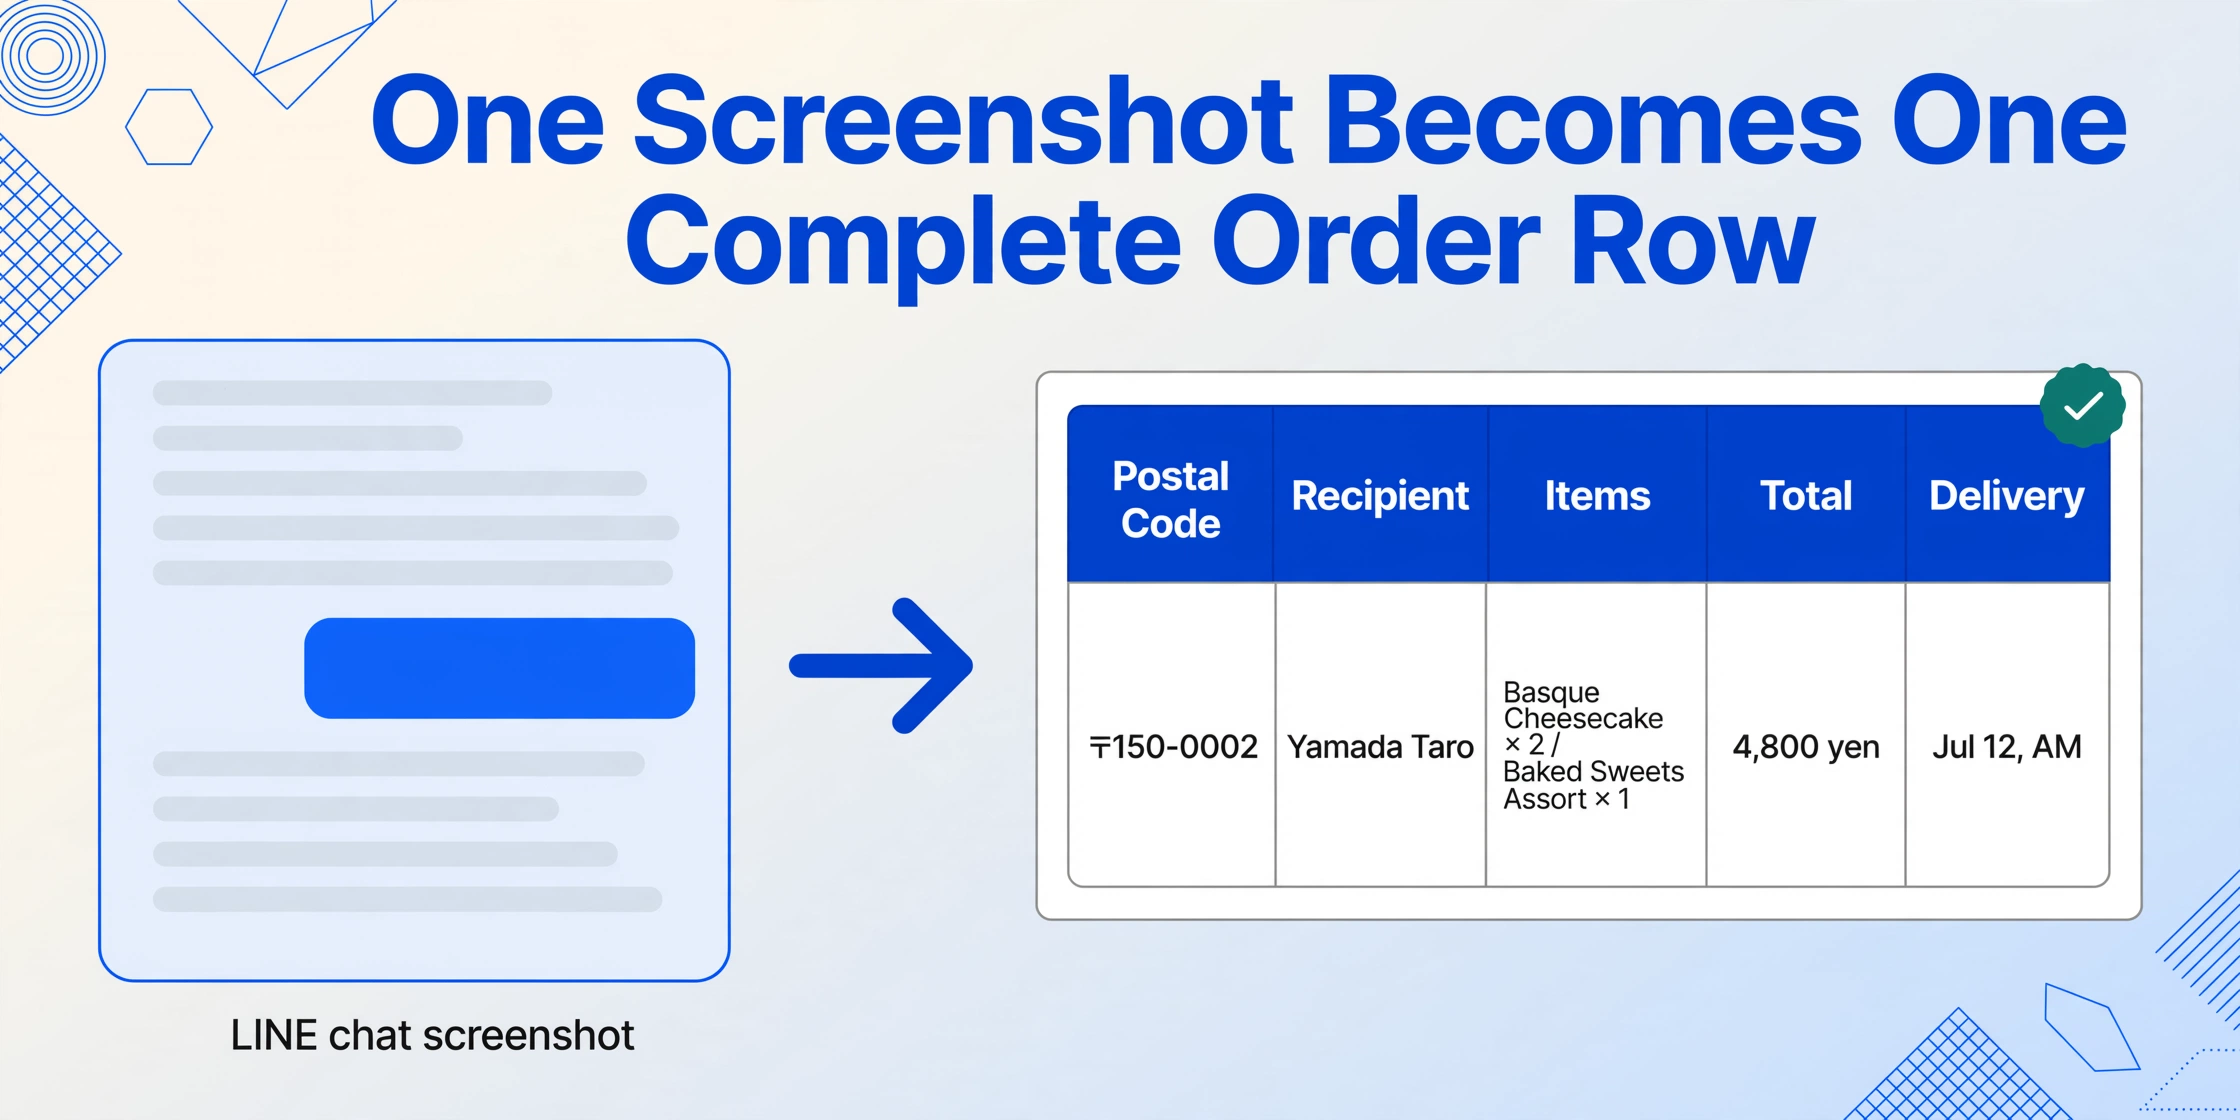
これらすべての情報が同じスクリーンショット — 同じチャットスレッド、同じ画像 — に含まれているため、住所を取得するのと同じ列定義を使用して、1回の処理で抽出できます。その結果、スプレッドシートの1行に完全な注文が含まれます:送り先、送るもの、送る時期。異なるスクリーンショットやメッセージ間で住所と注文商品を手動で照合する必要はありません。項目ごとの詳しい手順については、LINEチャットスクリーンショットの注文と住所の抽出ガイドをご覧ください。
よくある質問
手書きの漢字や、一部が不鮮明な漢字でも認識できますか?
Visual AIは、個々の画を単独で解読しようとするのではなく、文字全体の形状と文脈から漢字を読み取ります。多少ぼやけていたり、小さい漢字(例えば、低解像度のスクリーンショットに写った「渋」など)でも、周囲のテキストが意味的な手がかりを提供するため、正しく識別できることがよくあります。ただし、文字全体が判読できないほど著しく劣化した画像は、依然として限界があります。最良の結果を得るには、圧縮版ではなく、元の解像度でスクリーンショットを撮影してください。
LINE上の台湾住所と日本住所を区別できますか?
はい、可能です。台湾でもLINEは広く使われていますが、台湾の住所は異なる形式に従います。〒の郵便記号を使用せず、郵便番号は3+3桁(3+4桁ではありません)で、行政区分も異なります(都道府県や市区ではなく、県や郷鎮です)。AIはこれらの構造的な手がかりから国を識別し、それに応じて住所を解析します。同じCustom Column Extractionの設定で両方の形式を処理できます。なぜなら、取得したい列(郵便番号、市区町村、地区など)を定義すれば、住所体系に関係なく、AIが該当する内容を見つけ出すからです。
同じスクリーンショット内に、住所と他のチャットメッセージが混在している場合はどうなりますか?
AIはスクリーンショット全体を単一のビジュアルとして処理し、その構造的特性(〒の開始マーカー、複数セグメントの階層パターン、末尾の電話番号の存在)に基づいて住所ブロックを識別します。住所の前後に表示される他のチャットメッセージは、認識に影響を与えません。最良の結果を得るには、チャット履歴を大量に含めるのではなく、住所メッセージの周辺を切り取ってスクリーンショットを撮影することをお勧めします。ただし、ツールはどちらの場合でも処理できます。
複数のLINE注文スクリーンショットを一度にバッチ処理できますか?
はい、可能です。すべてのスクリーンショットを一度にアップロードし、同じ列定義(郵便番号、都道府県、市区町村、建物名、氏名、電話番号、商品名、個数、合計金額)を使用すれば、出力は1行が1スクリーンショットに対応する統合スプレッドシートになります。ここでその価値が明確になります。その日のチャット会話からの20件のLINE注文スクリーンショットが、メッセージごとの手作業を一切必要とせずに、20行の構造化データを生成します。
住所、注文された商品、配送希望日時 — これらはすべて、事業主がすでにスマートフォンで持っているスクリーンショットの中に存在しています。問題は、そのスクリーンショットがギャラリーの単なる画像のままになるのか、それとも今日のフルフィルメントワークフローの入力レコードになるのか、ということです。
日本では、LINE経由での注文処理がなくなることはありません。それは顧客にとっても企業にとっても、最も抵抗の少ない方法だからです。課題は、「顧客が送信した」状態と「住所が配送システムに登録された」状態のギャップを埋めることです。つまり、スクリーンショットを視覚的な参考資料から、フルフィルメントの次のステップを動かす構造化データへと変換し、一文字も再入力する必要をなくすことです。