Extraiga una dirección japonesa
y los detalles del pedido de una captura de pantalla de un chat de LINE
La dirección llega como un mensaje de LINE — una burbuja de chat que contiene un bloque de kanji, números arábigos y el distintivo símbolo postal (〒) que inicia toda dirección japonesa correctamente formateada. Para miles de pequeñas empresas japonesas que reciben pedidos a través de LINE, así es como la información de entrega entra en su flujo de trabajo: una captura de pantalla a la vez, copiada a mano en una etiqueta de envío o en un libro de registro.
Conclusiones clave
- Una dirección japonesa en LINE usa el símbolo postal 〒 como ancla, seguido de prefectura, ciudad, manzana, nombre del edificio, destinatario y teléfono — todo en kanji, katakana y números mezclados dentro de una sola burbuja de chat.
- El OCR tradicional lee 東京都渋谷区渋谷1-2-3 como caracteres, pero no puede etiquetar qué parte es la prefectura y cuál es el edificio — ve texto, no estructura de dirección.
- Defina Código Postal, Prefectura, Ciudad, Edificio, Destinatario y Teléfono como columnas — suba 20 capturas de pantalla de pedidos de LINE a la vez, y cada una se convierte en una fila con todos los campos completados desde el mismo mensaje de chat.
Por qué los chats de LINE se convierten en formularios de pedido en Japón
LINE es la plataforma de mensajería más utilizada en Japón, con aproximadamente 96 millones de usuarios activos mensuales en un país de 125 millones. Para pequeños minoristas, trabajadores autónomos (hitori oyakata), panaderías de barrio y vendedores de artesanías, LINE no es solo cómo hablan con los clientes — es cómo toman los pedidos. Un cliente envía un mensaje "Aを3つ、Bを2つください。住所はこれです" ("Tres de A, dos de B, por favor. Esta es mi dirección"), adjunta una nota o simplemente escribe los detalles, y el pedido queda realizado. Sin sitio web, sin formulario de pedido, sin carrito de compras. A escala de compra grupal, un hilo contiene docenas de esos mensajes, y las capturas de pantalla de chats de compra grupal de LINE se convierten en el registro de pedidos.
El dueño del negocio entonces lee la dirección de la captura de pantalla del chat, la copia manualmente en un sistema de etiquetas de envío o en un libro de registro, y procesa el pedido. Cuando una tienda maneja de 15 a 20 pedidos de este tipo al día — un volumen que una operación de una sola persona, como una floristería o una panadería, alcanza rápidamente — la copia manual de direcciones se convierte en el cuello de botella del proceso de cumplimiento.
La estructura de las direcciones japonesas añade otra capa de dificultad. A diferencia de las direcciones occidentales que normalmente caben en dos o tres líneas cortas, una dirección japonesa completa suele tener seis o siete componentes distintos comprimidos en un solo mensaje de chat. Cada uno es importante para la entrega, y si falta alguna parte o se copia mal, el paquete no llega.
Cómo se ve una dirección japonesa en LINE
Una dirección típica enviada a través de LINE se ve así:
〒150-0002 東京都渋谷区渋谷1-2-3
メゾン渋谷 101号室
山田太郎
090-XXXX-XXXX
Cada componente de este bloque contiene información de entrega específica, y los analizadores de direcciones tradicionales esperan que sigan un patrón fijo. Esto es lo que significa cada parte:
| Componente | Ejemplo | Función |
|---|---|---|
| Código postal (郵便番号) | 〒150-0002 | El símbolo 〒 (símbolo postal) seguido de un código de 3+4 dígitos. Este es el punto de entrada para el sistema de clasificación de Japan Post. |
| Prefectura (todōfuken) | 東京都 | Una de las 47 prefecturas. El sufijo kanji (都, 道, 府 o 県) marca el nivel administrativo. |
| Ciudad y distrito (shikuchōson) | 渋谷区 | El municipio seguido del nombre del distrito o barrio dentro de la ciudad. |
| Manzana y número (chōme banchi) | 渋谷1-2-3 | El chōme (丁目), la manzana (番地) y el número de edificio (号). Las direcciones japonesas usan esta numeración jerárquica en lugar de nombres de calles. |
| Nombre del edificio (tatemono-mei) | メゾン渋谷 101号室 | El nombre del apartamento o edificio (a menudo en katakana o kanji) y el número de habitación. |
| Nombre del destinatario (shimei) | 山田太郎 | El nombre completo de la persona que recibe la entrega, normalmente con el apellido primero. |
| Número de teléfono (denwa bangō) | 090-XXXX-XXXX | Un número de móvil, requerido por las empresas de mensajería japonesas para coordinar la entrega. |
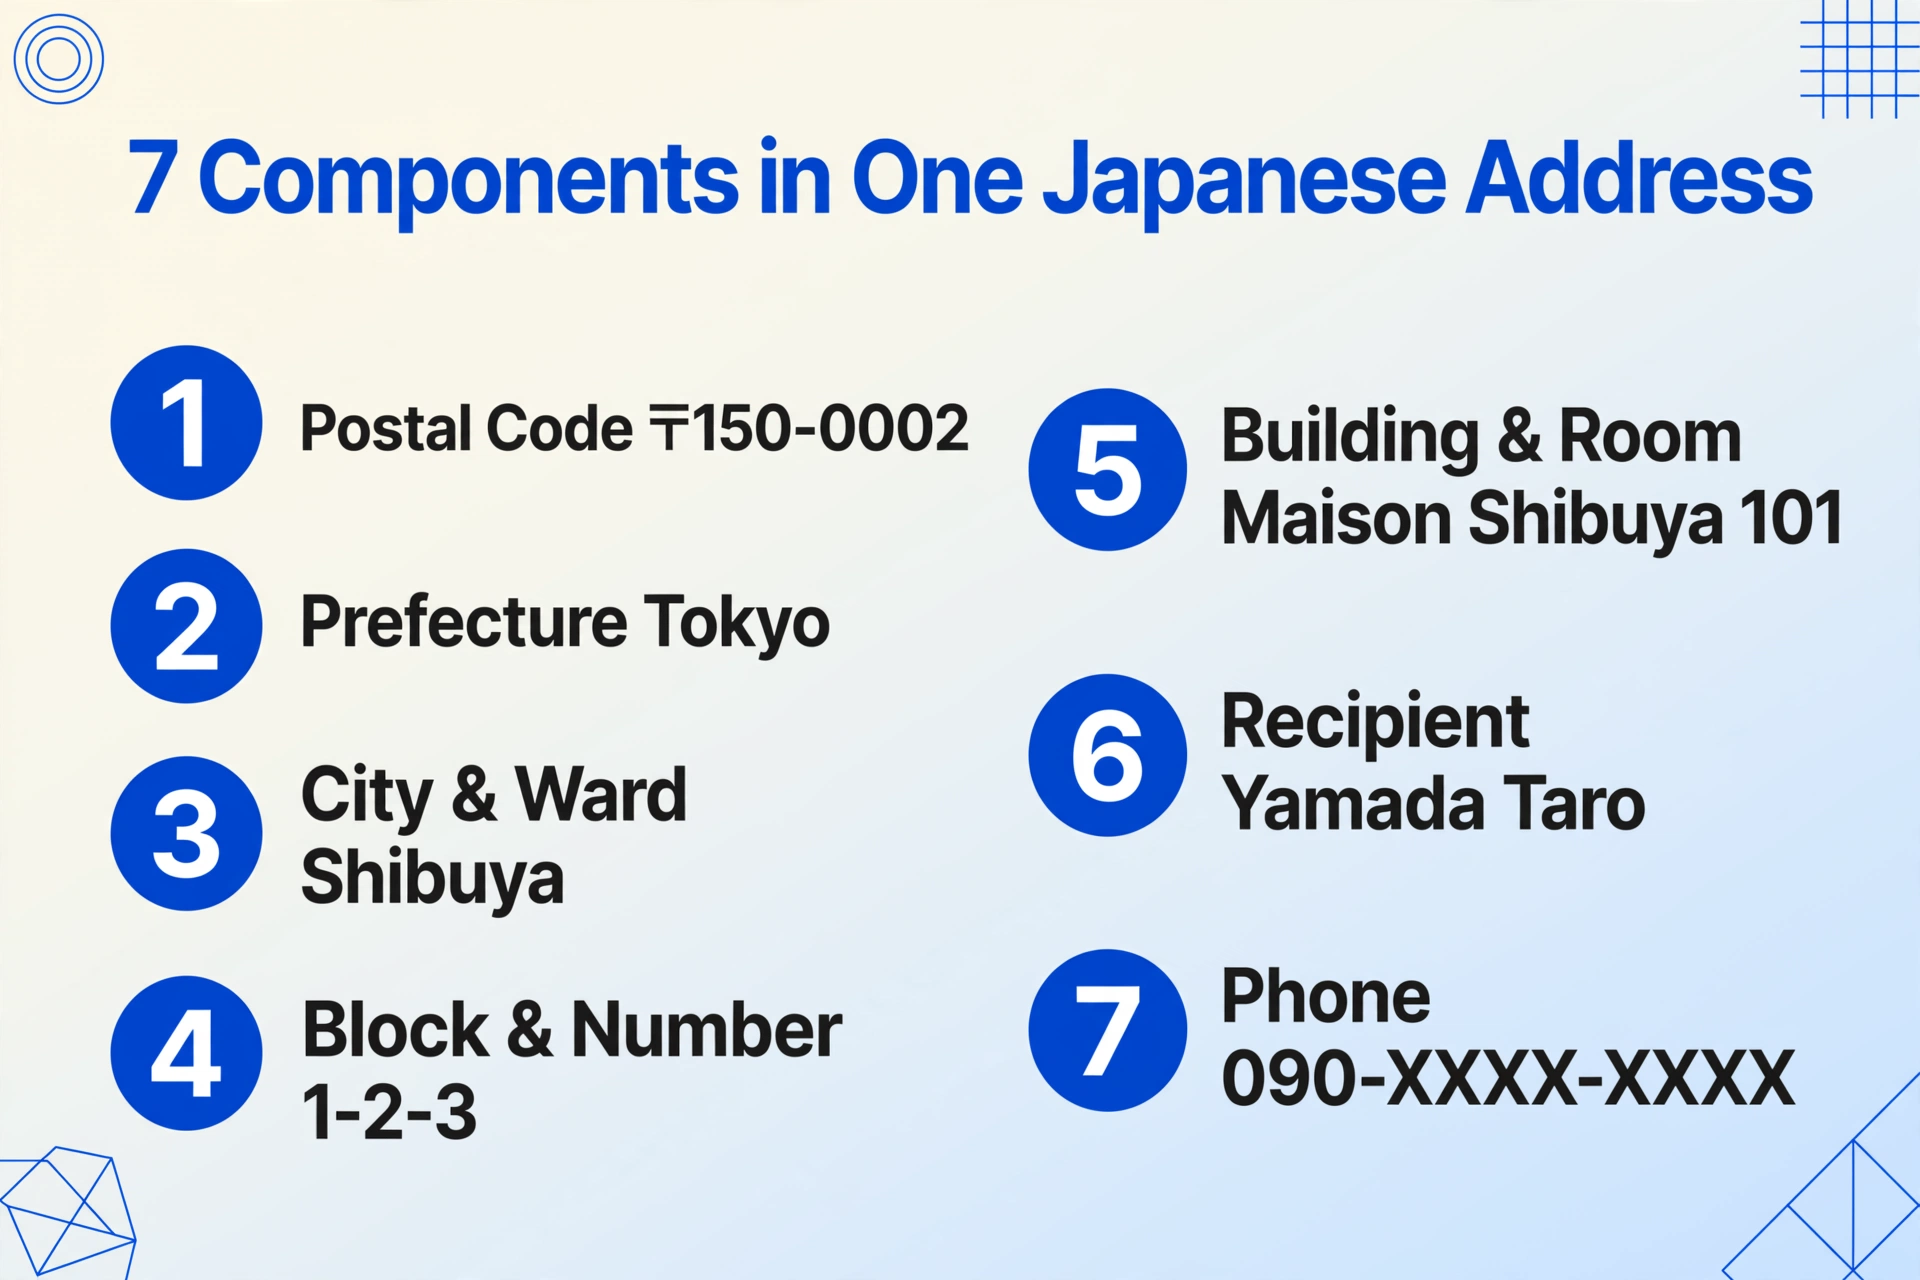
La dirección puede aparecer en un solo bloque de texto, dividida en varias líneas dentro de la burbuja de chat, o incluso mezclada con detalles específicos del pedido, como cantidades de artículos o preferencias de horario de entrega. No hay un formato fijo porque no hay un formulario — el cliente simplemente la escribió en el chat.
Esta variabilidad es precisamente donde los métodos tradicionales de OCR fallan. La dirección no está en un campo etiquetado ni en una posición estandarizada. Es un párrafo de texto con escritura mixta que resulta contener información de entrega.
Por qué el OCR tradicional se pierde la mayor parte
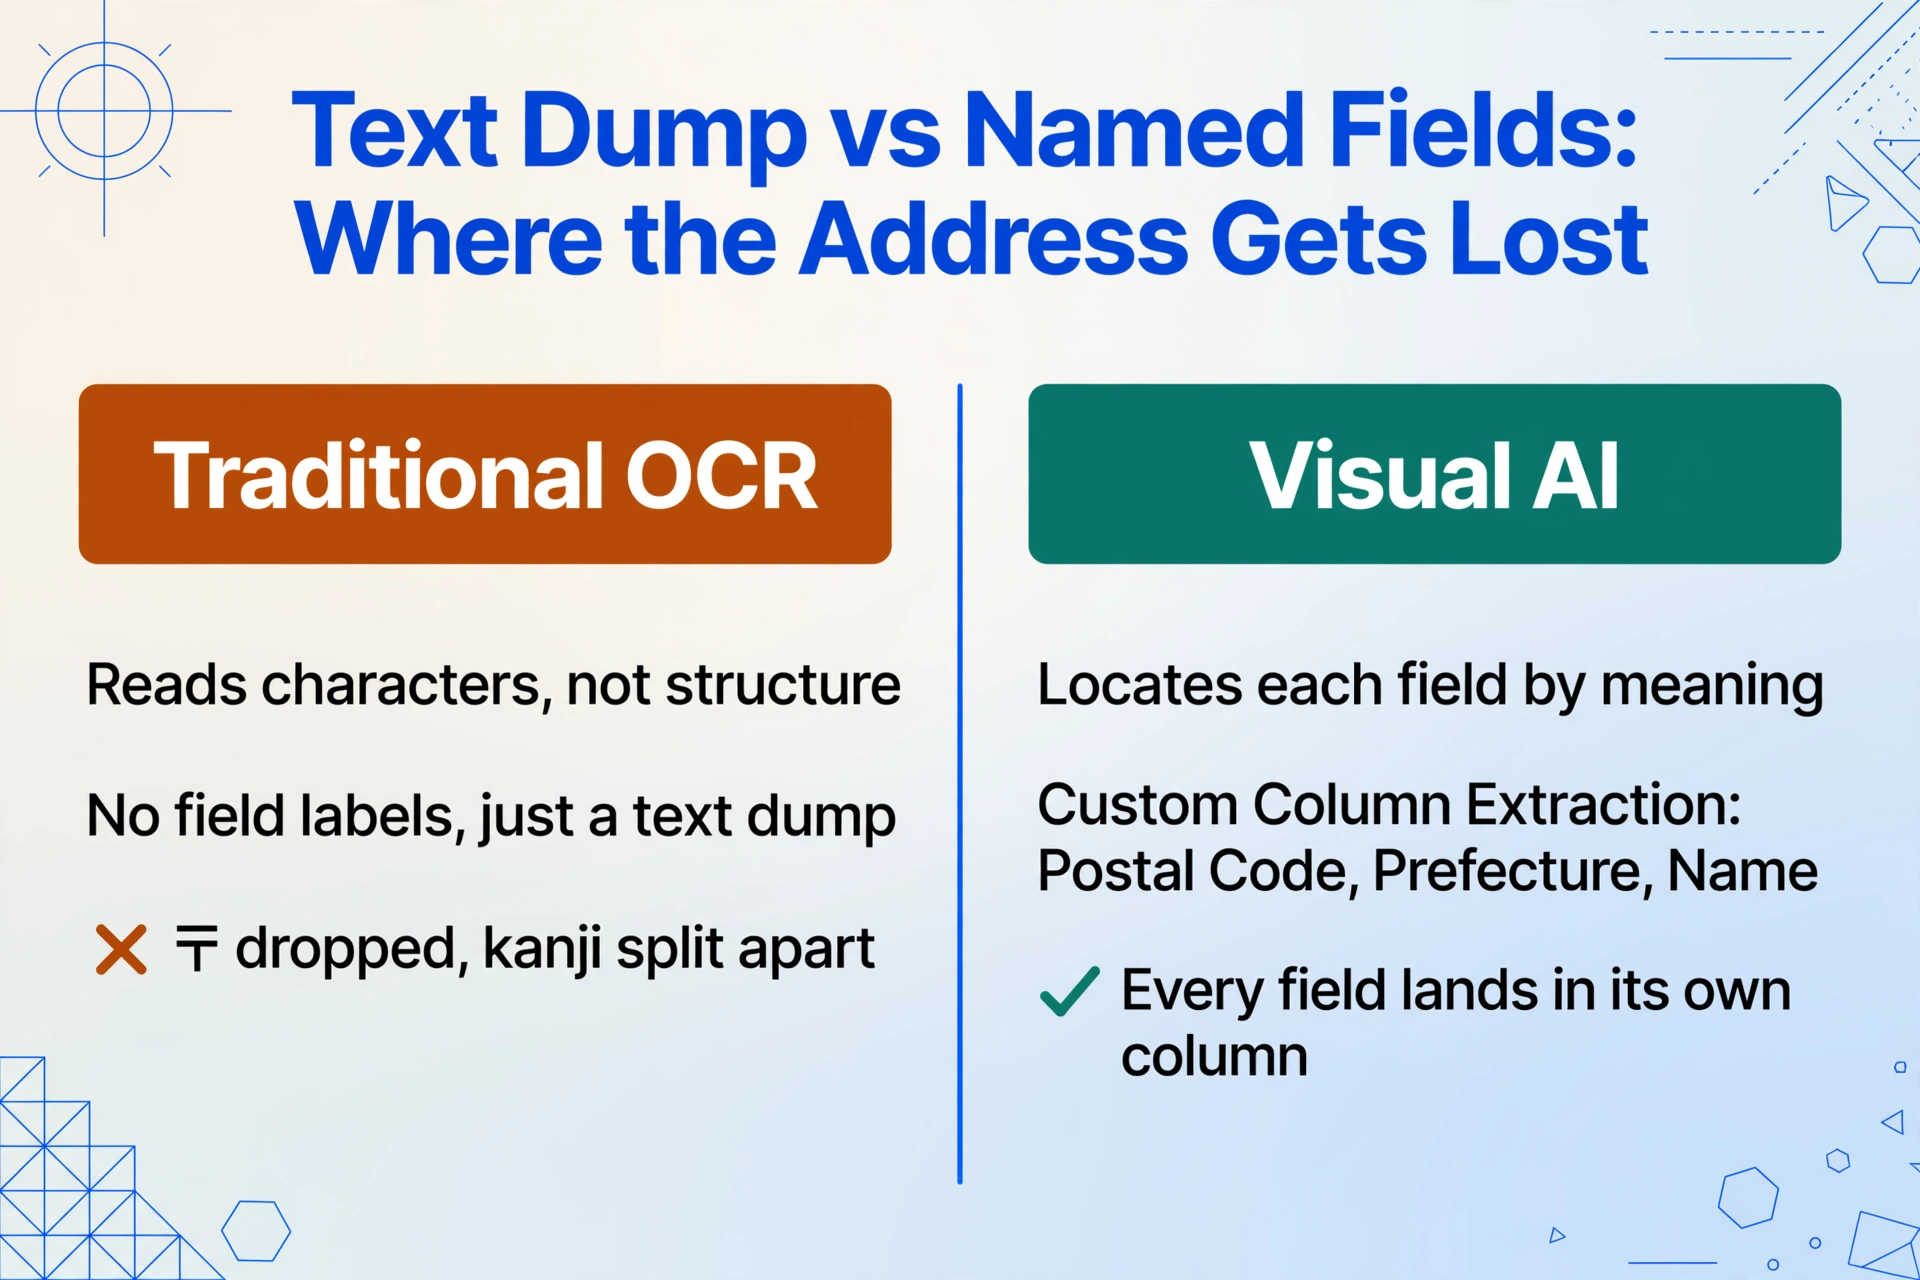
Los motores de OCR tradicionales — ya sea Tesseract, API de OCR en la nube o herramientas de escáner integradas — están diseñados para leer caracteres, no para comprender la estructura del documento. Cuando se enfrentan a una captura de pantalla de un chat de LINE que contiene una dirección japonesa, se encuentran con tres problemas fundamentales.
Primero, el reconocimiento de escritura mixta. Las direcciones japonesas combinan kanji (東京都, 渋谷区), hiragana (a veces usado para nombres de edificios), katakana (メゾン) y números arábigos (1-2-3, 150-0002) dentro de una sola frase. Los modelos de OCR tradicionales, especialmente los entrenados originalmente con corpus de documentos occidentales, tienen una precisión desigual entre estas escrituras. El número 〒150-0002 puede leer los dígitos correctamente pero omitir o corromper el símbolo postal, y los caracteres kanji con muchos trazos (como 渋 o 藤) se reconocen con frecuencia de forma incorrecta o se dividen en fragmentos.
Segundo, no hay ubicaciones de campos fijas. En una factura o un formulario estandarizado, el código postal vive en una casilla designada, el nombre de la prefectura está en una fila etiquetada. En una burbuja de chat de LINE, la dirección comparte el mismo espacio visual que la solicitud de pedido del cliente, un saludo y, a veces, una captura de pantalla de pago. Un sistema de OCR basado en la posición que busca "texto cerca de la parte superior de la imagen" captará contenido completamente incorrecto.
Tercero, salida de texto plano. El OCR tradicional devuelve una cadena lineal de caracteres reconocidos con saltos de línea. No puede distinguir "esta secuencia de kanji es el nombre de la prefectura" de "esta secuencia de kanji es el nombre del edificio". La salida para la dirección anterior sería un solo bloque de texto sin etiquetas semánticas — dejando al propietario del negocio la tarea de volver a analizar manualmente la salida del OCR en los campos correctos, lo que anula el propósito de la automatización.
Cómo lee Visual AI la dirección como un campo estructurado
Visual AI — la tecnología detrás de Custom Column Extraction — aborda la misma captura de pantalla desde una dirección fundamentalmente diferente. En lugar de escanear caracteres y generar un volcado de texto, interpreta la imagen en su conjunto, identificando regiones semánticas y asignando significado al texto que encuentra en cada región.
Usted define los campos que desea. La IA los localiza comprendiendo qué es cada componente, no adivinando dónde debería estar en la página.
Para una captura de pantalla de una dirección de LINE, podría definir columnas como:
- Código postal (郵便番号) — la IA encuentra el símbolo 〒 y lee el código numérico que lo sigue
- Prefectura (todōfuken) — la IA identifica los kanji que terminan en 都, 道, 府 o 県 como el nombre de la prefectura
- Ciudad y distrito (shikuchōson) — el nombre del municipio que sigue a la prefectura
- Manzana y número (chōme banchi) — la secuencia de chome/manzana y cualquier nombre de edificio
- Nombre del destinatario (shimei) — el nombre de la persona, normalmente en su propia línea o después de la dirección
- Número de teléfono (denwa bangō) — el número de móvil, reconocido por su patrón de dígitos
Varias señales visuales ayudan a la IA a segmentar correctamente la dirección. La marca 〒 actúa como un ancla fiable para el inicio del bloque de dirección. Los sufijos kanji (都・道・府・県) marcan el límite de la prefectura. El patrón numérico con guiones (1-2-3) señala la secuencia chome-manzana-edificio. Y el nombre, cuando aparece solo en su propia línea después de la dirección, se reconoce como el destinatario.
Lo que importa es que la IA no necesita que se le diga de antemano que una dirección japonesa comienza con la unidad geográfica más grande y termina con la más pequeña. Comprende la jerarquía semántica porque el propio idioma proporciona marcadores estructurales que la IA está entrenada para leer.
Este es el mismo paradigma que se aplica a la extracción de datos de capturas de pago, mensajes de chat en otros idiomas o cualquier documento que carezca de un diseño fijo. Usted define las columnas de salida, y la IA encuentra los valores coincidentes comprendiendo lo que significa el texto — no haciendo coincidir una plantilla predefinida para "dirección japonesa en LINE". Como explica el artículo central sobre extracción de datos de capturas de pantalla de fuentes sin tabla, los datos están presentes en la imagen incluso cuando la fuente es completamente no estructurada. La diferencia es que la extracción semántica lee el contenido por lo que es, no por dónde aparece.
El mismo enfoque funciona cuando el pedido llega en una aplicación de chat diferente. Las definiciones de columnas que configuró para LINE — Código postal, Prefectura, Ciudad, Edificio, Destinatario, Teléfono — se aplican igualmente a un pedido realizado en chats de WhatsApp Business, iMessage, KakaoTalk o WeChat. El formato de la dirección cambia según el país y la aplicación, pero el método de lectura sigue siendo el mismo.
Más allá de la dirección — ¿Qué más hay en esa captura de pantalla?
Una captura de pantalla de un pedido de LINE rara vez contiene solo la dirección. La misma burbuja de chat o un mensaje cercano suele incluir los detalles del pedido del cliente, y extraerlos junto con la dirección convierte una sola captura en un registro de pedido completo.
バスクチーズケーキ ホール × 2
焼き菓子アソート × 1
合計 4,800円
配送希望: 7/12 午前中
Ejemplo de texto de pedido que podría aparecer junto a una dirección en un mensaje de chat de LINE.
Los campos que se pueden extraer comúnmente de una captura de pantalla de pedido de LINE incluyen:
- Nombre del artículo (shōhinmei) y Cantidad (kosū) — los productos que el cliente solicita
- Importe total (gōkei kingaku) — si el cliente ha calculado el total o se incluye una captura de pago
- Fecha y hora de entrega (haisō kibō nichiji) — a menudo se especifica como una franja horaria preferida
- Instrucciones especiales (bikō) — notas como solicitudes de envoltura de regalo o preferencias de sustitución
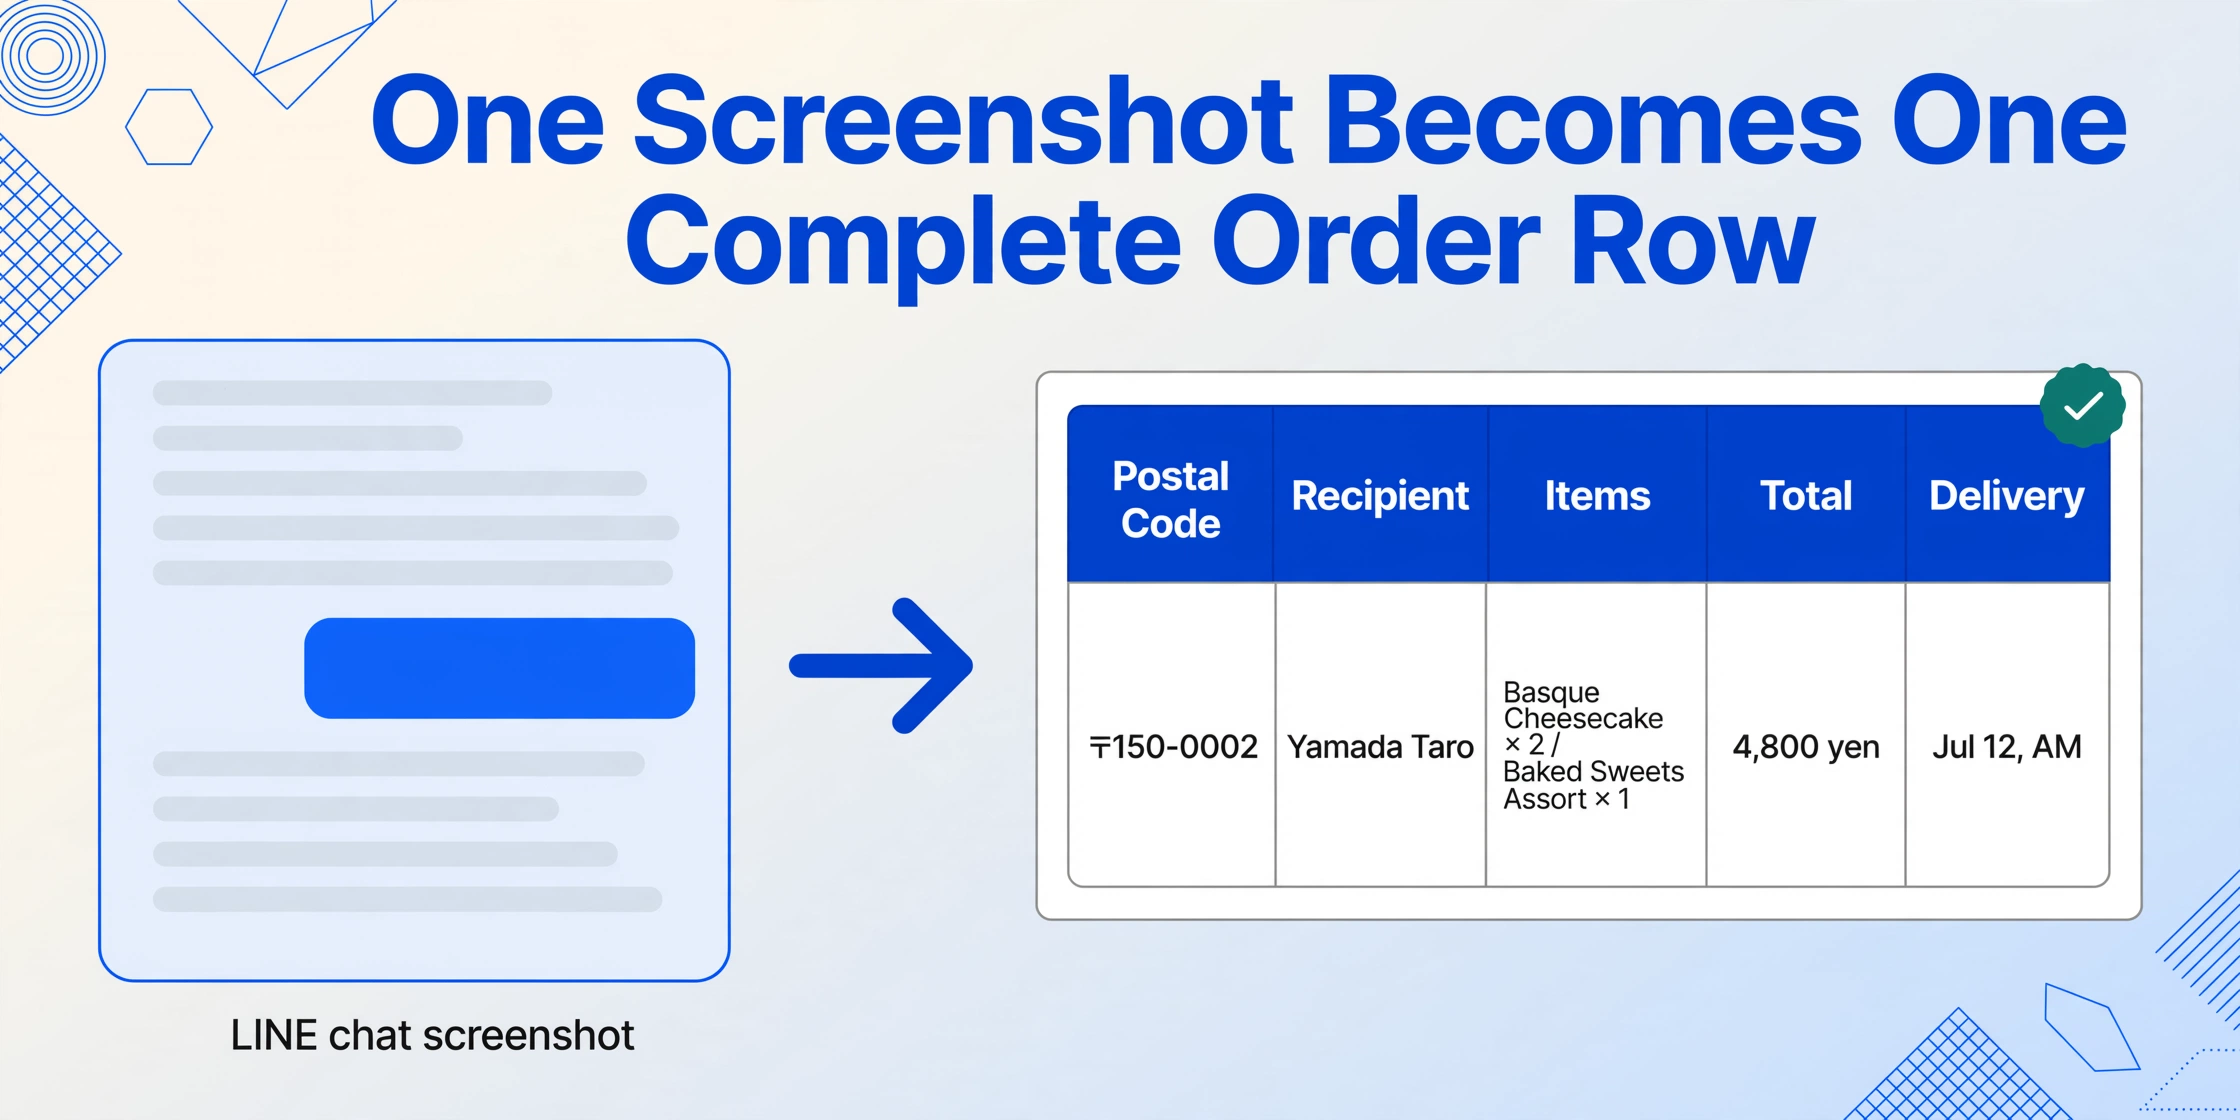
Debido a que toda esta información se encuentra en la misma captura de pantalla — mismo hilo de chat, misma imagen — puede extraerse en una sola pasada utilizando las mismas definiciones de columna que capturan la dirección. El resultado es una fila en una hoja de cálculo que contiene el pedido completo: dónde enviarlo, qué enviar y cuándo. Sin necesidad de emparejar manualmente direcciones con artículos del pedido en diferentes capturas o mensajes. Para un recorrido campo por campo, consulte la guía de extracción de dirección y pedido de capturas de chat de LINE.
Preguntas Frecuentes
¿Funciona si el kanji está escrito a mano o es parcialmente ilegible?
Visual AI lee kanji reconociendo la forma general del carácter y el contexto, no intentando decodificar trazos individuales de forma aislada. Los kanji parcialmente borrosos o pequeños (como 渋 en una captura de pantalla de baja resolución) a menudo pueden identificarse correctamente cuando el texto circundante proporciona pistas semánticas. Sin embargo, las imágenes muy degradadas donde caracteres enteros son ilegibles siguen siendo una limitación. Para obtener los mejores resultados, capture la captura de pantalla en la resolución original en lugar de una versión comprimida.
¿Puede distinguir entre direcciones de Taiwán y Japón en LINE?
Sí. Taiwán también usa LINE ampliamente, pero las direcciones taiwanesas siguen un formato diferente. No usan el símbolo postal 〒, usan un código postal de 3+3 dígitos (no 3+4), y la estructura administrativa es diferente (condados y municipios en lugar de prefecturas y distritos). La IA identifica el país mediante estas señales estructurales y analiza la dirección en consecuencia. La misma configuración de Custom Column Extraction maneja ambos formatos porque usted define las columnas por lo que desea (código postal, ciudad, distrito), y la IA encuentra el contenido correspondiente independientemente del sistema de direcciones.
¿Qué sucede si la dirección está mezclada con otros mensajes del chat en la misma captura de pantalla?
La IA procesa toda la captura de pantalla como una sola imagen visual e identifica el bloque de dirección por sus propiedades estructurales: el marcador de inicio 〒, el patrón jerárquico de múltiples segmentos y la presencia del número de teléfono al final. Otros mensajes del chat que aparecen antes o después de la dirección no interfieren con el reconocimiento. Para obtener los mejores resultados, capture la captura de pantalla cerca del mensaje de dirección en lugar de incluir un gran historial de chat, aunque la herramienta puede manejar ambos casos.
¿Puedo procesar por lotes múltiples capturas de pantalla de pedidos de LINE a la vez?
Sí. Suba todas las capturas de pantalla juntas en un solo lote, use las mismas definiciones de columna (Código Postal, Prefectura, Ciudad, Nombre del Edificio, Destinatario, Número de Teléfono, Nombre del Artículo, Cantidad, Importe Total), y la salida será una hoja de cálculo unificada con una fila por captura de pantalla. Aquí es donde el valor se vuelve claro: 20 capturas de pantalla de pedidos de LINE de las conversaciones del día producen 20 filas de datos estructurados sin ningún trabajo manual por mensaje.
La dirección, los artículos pedidos, la ventana de entrega — todo está presente en la captura de pantalla que el dueño del negocio ya tiene en su teléfono. La cuestión es si esa captura de pantalla se convierte en otra imagen en la galería o en el registro de entrada para el flujo de trabajo de cumplimiento de hoy.
Procesar pedidos a través de LINE no desaparecerá en Japón. Es el camino de menor resistencia tanto para el cliente como para la empresa. La oportunidad está en cerrar la brecha entre «el cliente lo envió» y «la dirección está en el sistema de envío» — convirtiendo la captura de pantalla de una referencia visual en datos estructurados que impulsan el siguiente paso en el cumplimiento, sin tener que reescribir ni un solo carácter.