Extraire une adresse japonaise
et les détails d'une commande à partir d'une capture d'écran de chat LINE
L'adresse arrive sous forme de message LINE — une bulle de chat contenant un bloc de kanji, de chiffres arabes et le symbole postal distinctif (〒) qui commence toute adresse japonaise correctement formatée. Pour des milliers de petites entreprises japonaises qui prennent des commandes via LINE, c'est ainsi que les informations de livraison entrent dans leur flux de travail : une capture d'écran à la fois, recopiée à la main sur une étiquette d'expédition ou dans un registre.
Points clés à retenir
- Une adresse japonaise dans LINE utilise le symbole postal 〒 comme point d'ancrage, suivi de la préfecture, de la ville, du bloc, du nom du bâtiment, du destinataire et du téléphone — le tout en kanji, katakana et chiffres mélangés dans une seule bulle de chat.
- L'OCR traditionnel lit 東京都渋谷区渋谷1-2-3 comme des caractères mais ne peut pas identifier quelle partie est la préfecture et laquelle est le bâtiment — il voit du texte, pas la structure de l'adresse.
- Définissez Code postal, Préfecture, Ville, Bâtiment, Destinataire et Téléphone comme colonnes — téléchargez 20 captures d'écran de commandes LINE à la fois, et chacune devient une ligne avec tous les champs remplis à partir du même message de chat.
Pourquoi les conversations LINE deviennent des formulaires de commande au Japon
LINE est la plateforme de messagerie la plus utilisée au Japon, avec environ 96 millions d'utilisateurs actifs mensuels dans un pays de 125 millions d'habitants. Pour les petits détaillants, les artisans indépendants (一人親方), les boulangeries de quartier et les vendeurs d'artisanat, LINE n'est pas seulement leur moyen de communiquer avec les clients — c'est aussi leur moyen de prendre les commandes. Un client envoie "Aを3つ、Bを2つください。住所はこれです" (« Trois de A, deux de B s'il vous plaît. Voici mon adresse »), joint une note ou tape simplement les détails, et la commande est passée. Pas de site web, pas de formulaire de commande, pas de panier d'achat. À l'échelle d'un achat groupé, un fil de discussion contient des dizaines de ces messages, et les captures d'écran de conversations LINE pour achats groupés deviennent le registre des commandes.
Le propriétaire de l'entreprise lit ensuite l'adresse dans la capture d'écran de la conversation, la recopie à la main dans un système d'étiquettes d'expédition ou un registre, et traite la commande. Lorsqu'un magasin traite 15 à 20 commandes de ce type par jour — un volume qu'une opération gérée par une seule personne, comme une fleuriste ou une boulangerie, atteint rapidement — la saisie manuelle des adresses devient le goulot d'étranglement du processus de traitement des commandes.
La structure des adresses japonaises ajoute une autre difficulté. Contrairement aux adresses occidentales qui tiennent généralement sur deux ou trois lignes courtes, une adresse japonaise complète comporte souvent six ou sept composants distincts regroupés dans un seul message de conversation. Chacun d'eux est essentiel à la livraison, et l'omission ou l'erreur de recopie d'une seule partie signifie que le colis n'arrivera pas.
À quoi ressemble une adresse japonaise dans LINE
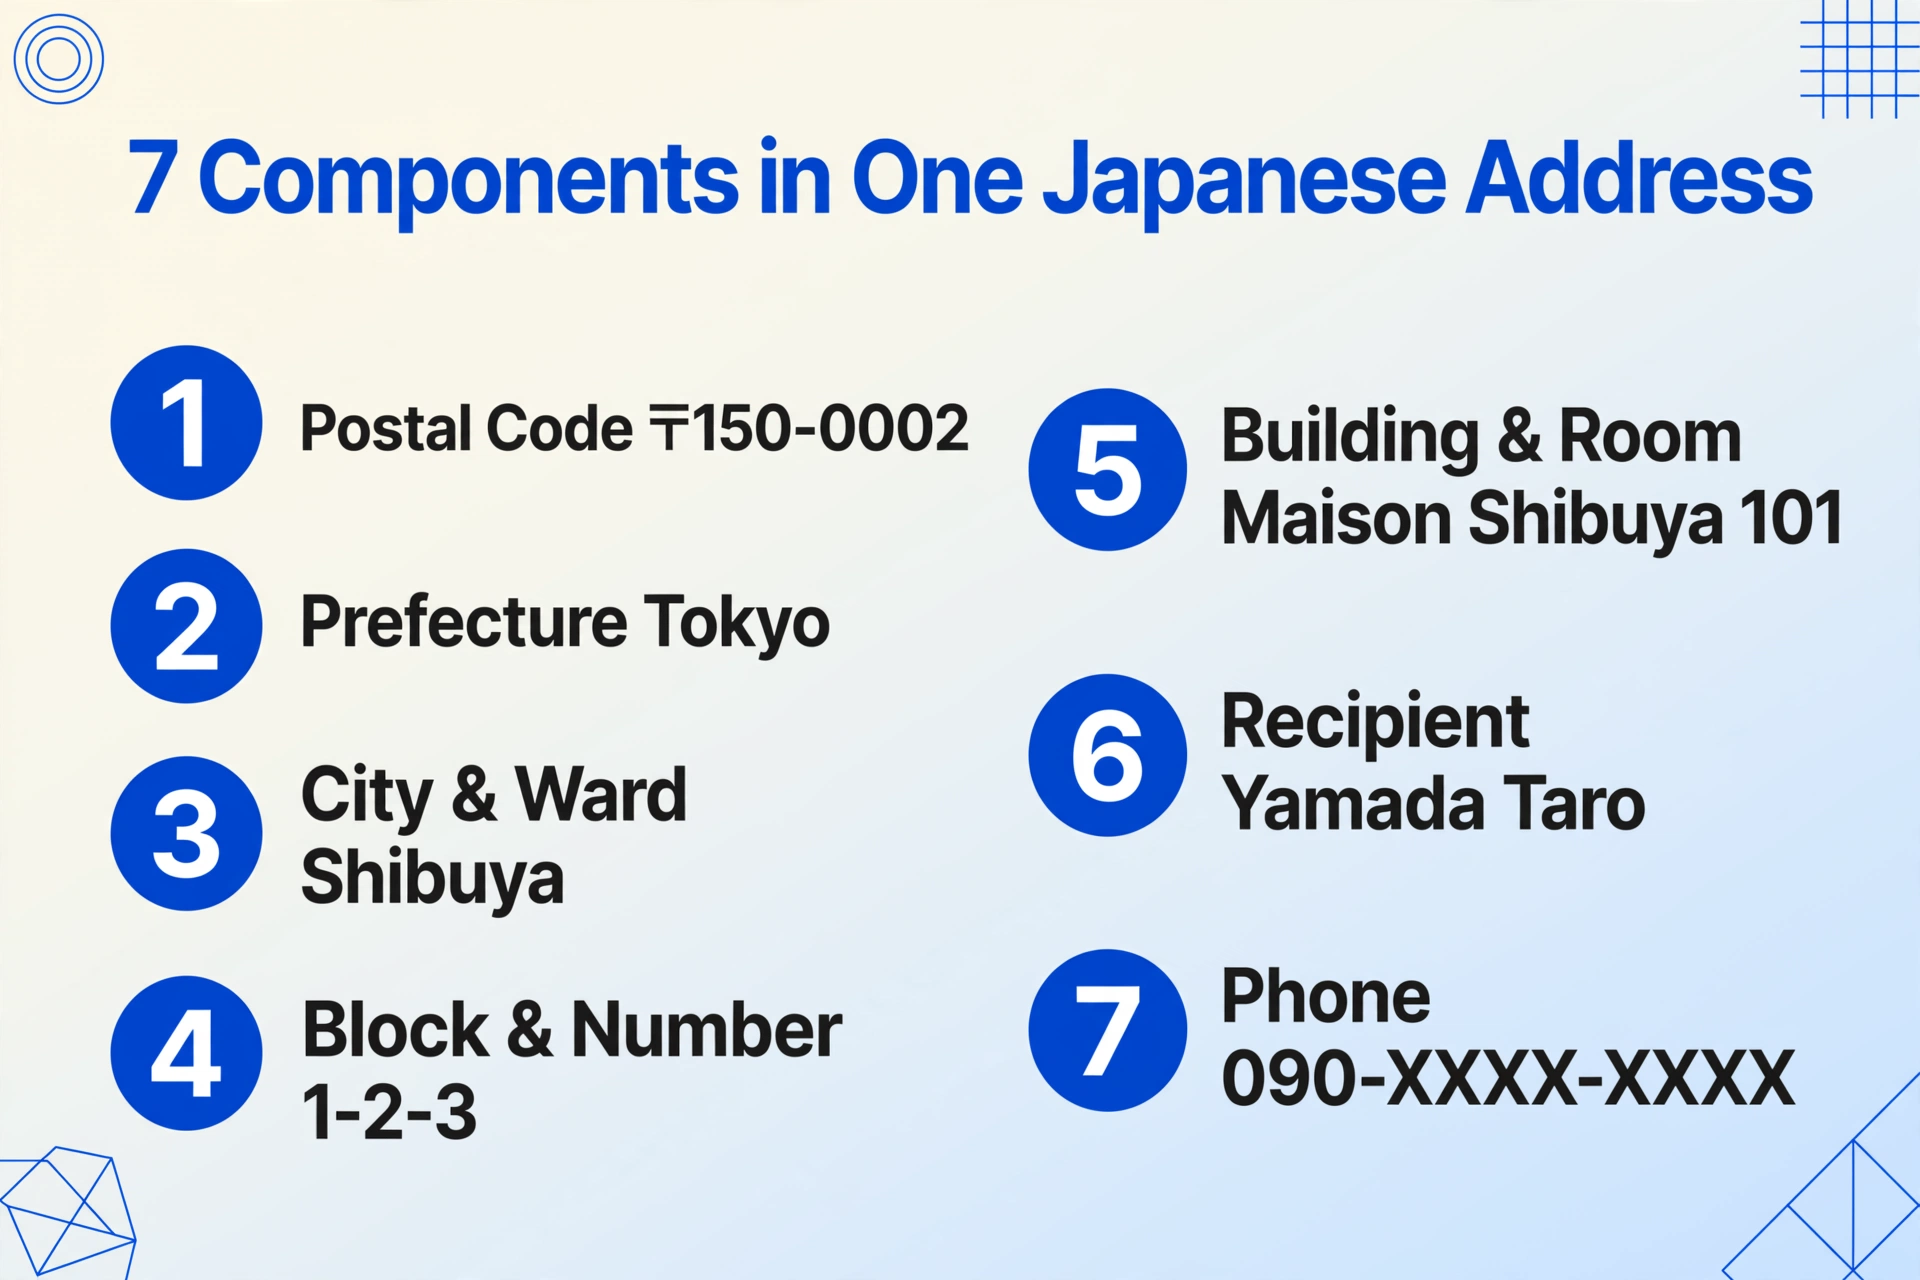
Une adresse typique envoyée via LINE ressemble à ceci :
〒150-0002 東京都渋谷区渋谷1-2-3
メゾン渋谷 101号室
山田太郎
090-XXXX-XXXX
Chaque composant de ce bloc contient des informations de livraison spécifiques, et les analyseurs d'adresses traditionnels les attendent selon un schéma fixe. Voici ce que signifie chaque partie :
| Composant | Exemple | Rôle |
|---|---|---|
| Code postal (郵便番号) | 〒150-0002 | Le symbole 〒 (symbole postal) suivi d'un code à 3+4 chiffres. C'est le point d'entrée du système de tri de Japan Post. |
| Préfecture (todōfuken) | 東京都 | L'une des 47 préfectures. Le suffixe en kanji (都, 道, 府 ou 県) marque le niveau administratif. |
| Ville et arrondissement (shikuchōson) | 渋谷区 | La municipalité suivie du nom de l'arrondissement ou du district au sein de la ville. |
| Îlot et numéro (chōme banchi) | 渋谷1-2-3 | Le chōme (丁目), l'îlot (番地) et le numéro de bâtiment (号). Les adresses japonaises utilisent cette numérotation hiérarchique au lieu des noms de rue. |
| Nom du bâtiment (tatemono-mei) | メゾン渋谷 101号室 | Le nom de l'immeuble ou du bâtiment (souvent en katakana ou en kanji) et le numéro de la pièce. |
| Nom du destinataire (shimei) | 山田太郎 | Le nom complet de la personne recevant la livraison, généralement le nom de famille en premier. |
| Numéro de téléphone (denwa bangō) | 090-XXXX-XXXX | Un numéro de mobile, requis par les transporteurs japonais pour la coordination des livraisons. |
L'adresse peut apparaître dans un seul bloc de texte, répartie sur plusieurs lignes dans la bulle de discussion, ou même mélangée à des détails spécifiques à la commande comme les quantités d'articles ou les préférences d'heure de livraison. Il n'y a pas de mise en page fixe car il n'y a pas de formulaire — le client l'a simplement tapée dans une discussion.
Cette variabilité est précisément le point où les méthodes OCR traditionnelles échouent. L'adresse ne se trouve pas dans un champ étiqueté ni à une position standardisée. C'est un paragraphe de texte à écritures mixtes qui contient par hasard des informations de livraison.
Pourquoi l'OCR traditionnel manque l'essentiel
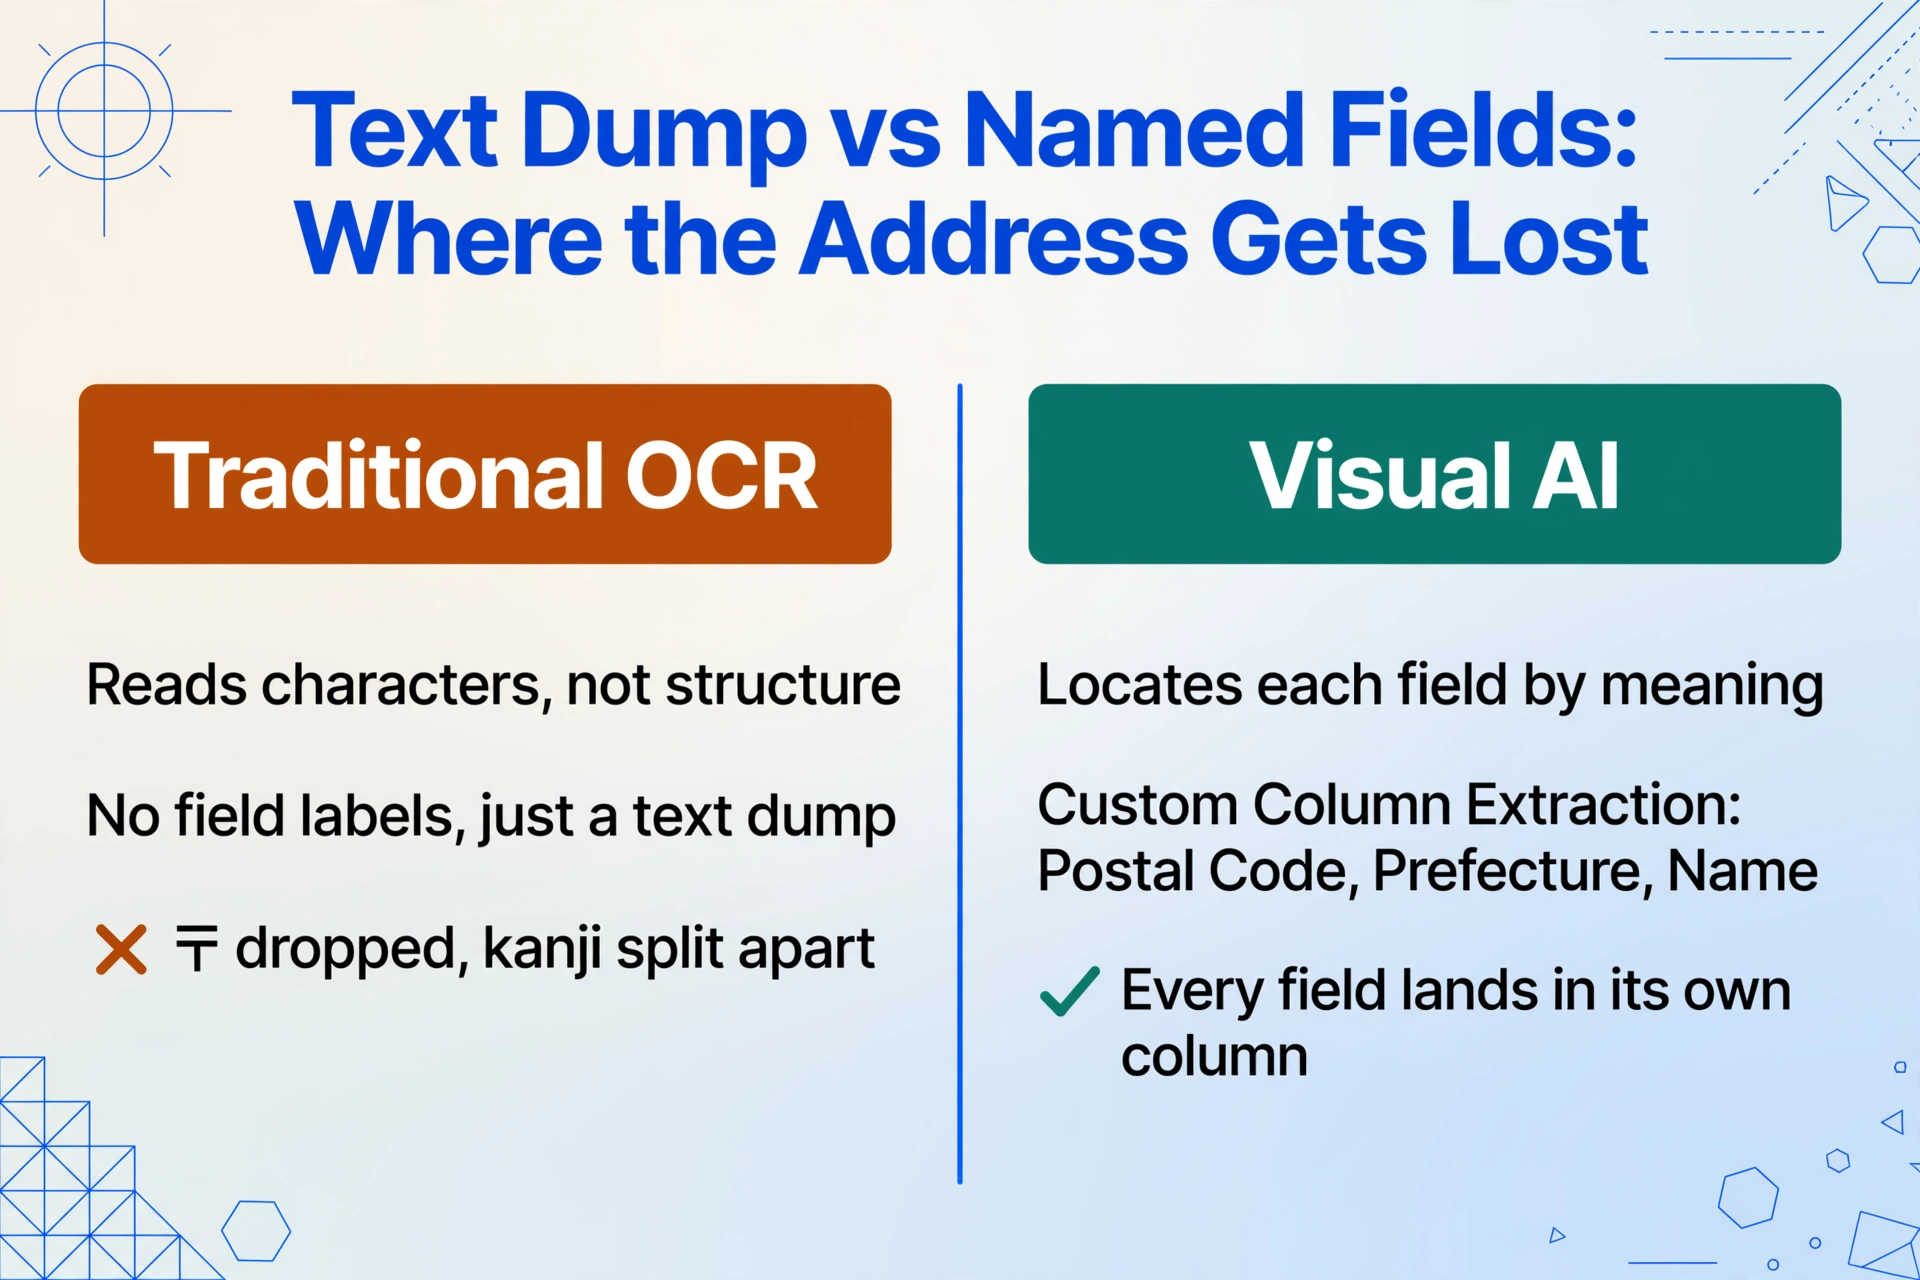
Les moteurs d'OCR traditionnels — qu'il s'agisse de Tesseract, d'API OCR cloud ou d'outils de numérisation intégrés — sont conçus pour lire des caractères, pas pour comprendre la structure d'un document. Face à une capture d'écran de chat LINE contenant une adresse japonaise, ils rencontrent trois problèmes fondamentaux.
Premièrement, la reconnaissance de scripts mixtes. Les adresses japonaises combinent kanji (東京都, 渋谷区), hiragana (parfois utilisés pour les noms de bâtiments), katakana (メゾン) et chiffres arabes (1-2-3, 150-0002) dans une même phrase. Les modèles d'OCR traditionnels, surtout ceux formés à l'origine sur des corpus de documents occidentaux, ont une précision inégale selon les scripts. Le numéro 〒150-0002 peut être lu correctement pour les chiffres mais le symbole postal peut être omis ou corrompu, et les kanji avec de nombreux traits (comme 渋 ou 藤) sont fréquemment mal reconnus ou fragmentés.
Deuxièmement, aucune position de champ fixe. Sur une facture ou un formulaire standardisé, le code postal se trouve dans une case dédiée, le nom de la préfecture dans une ligne étiquetée. Dans une bulle de chat LINE, l'adresse partage le même espace visuel que la demande de commande du client, un message de salutation et parfois une capture d'écran de paiement. Un système d'OCR basé sur la position qui cherche « du texte près du haut de l'image » sélectionnera un contenu totalement erroné.
Troisièmement, une sortie de texte plate. L'OCR traditionnel renvoie une chaîne linéaire de caractères reconnus avec des sauts de ligne. Il ne peut pas distinguer « cette séquence de kanji est le nom de la préfecture » de « cette séquence de kanji est le nom du bâtiment ». La sortie pour l'adresse ci-dessus serait un bloc de texte unique sans étiquettes sémantiques — laissant le propriétaire d'entreprise re-parser manuellement la sortie OCR dans les champs corrects, ce qui va à l'encontre de l'automatisation.
Comment l'IA visuelle lit l'adresse comme un champ structuré
L'IA visuelle — la technologie derrière Extraction de colonnes personnalisées — aborde la même capture d'écran sous un angle fondamentalement différent. Au lieu de scanner les caractères et de produire un texte brut, elle interprète l'image dans son ensemble, identifie les zones sémantiques et attribue un sens au texte trouvé dans chaque zone.
Vous définissez les champs souhaités. L'IA les localise en comprenant ce qu'est chaque composant, et non en devinant où il devrait se trouver sur la page.
Pour une capture d'écran d'adresse LINE, vous pourriez définir des colonnes comme :
- Code postal (郵便番号) — l'IA trouve le symbole 〒 et lit le code numérique qui le suit
- Préfecture (都道府県) — l'IA identifie les kanjis se terminant par 都, 道, 府 ou 県 comme nom de préfecture
- Ville / Arrondissement (市区町村) — le nom de la municipalité qui suit la préfecture
- Îlot et bâtiment (番地・建物名) — la séquence chome/îlot et tout nom de bâtiment
- Nom du destinataire (氏名) — le nom de la personne, généralement sur sa propre ligne ou après l'adresse
- Numéro de téléphone (電話番号) — le numéro de mobile, reconnu par son format de chiffres
Plusieurs indices visuels aident l'IA à segmenter correctement l'adresse. Le symbole 〒 sert d'ancre fiable pour le début du bloc d'adresse. Les suffixes kanji (都・道・府・県) délimitent la préfecture. Le format de numérotation avec traits d'union (1-2-3) signale la séquence chome-îlot-bâtiment. Et le nom, lorsqu'il apparaît seul sur sa propre ligne après l'adresse, est reconnu comme le destinataire.
Ce qui importe, c'est que l'IA n'a pas besoin qu'on lui dise à l'avance qu'une adresse japonaise commence par la plus grande unité géographique et se termine par la plus petite. Elle comprend la hiérarchie sémantique parce que la langue elle-même fournit des marqueurs structurels que l'IA est entraînée à lire.
C'est le même paradigme qui s'applique à l'extraction de données à partir de captures d'écran de paiement, de messages de chat dans d'autres langues ou de tout document sans mise en page fixe. Vous définissez les colonnes de sortie, et l'IA trouve les valeurs correspondantes en comprenant ce que le texte signifie — et non en faisant correspondre un modèle préétabli pour « adresse japonaise dans LINE ». Comme l'explique l'article du hub sur l'extraction de données à partir de captures d'écran de sources non tabulaires, les données sont présentes dans l'image même lorsque la source est entièrement non structurée. La différence est que l'extraction sémantique lit le contenu pour ce qu'il est, et non pour l'endroit où il apparaît.
La même approche fonctionne lorsque la commande arrive dans une autre application de messagerie. Les définitions de colonnes que vous configurez pour LINE — code postal, préfecture, ville, bâtiment, destinataire, téléphone — s'appliquent tout aussi bien à une commande passée dans les conversations WhatsApp Business, iMessage, KakaoTalk ou WeChat. Le format de l'adresse change selon le pays et l'application, mais la méthode de lecture reste la même.
Au-delà de l'adresse — qu'y a-t-il d'autre dans cette capture d'écran
Une capture d'écran de commande LINE contient rarement uniquement l'adresse. La même bulle de discussion ou un message voisin inclut généralement les détails de la commande du client, et les extraire en même temps que l'adresse transforme une simple capture d'écran en un enregistrement de commande complet.
バスクチーズケーキ ホール × 2
焼き菓子アソート × 1
合計 4,800円
配送希望: 7/12 午前中
Exemple de texte de commande pouvant apparaître à côté d'une adresse dans un message de discussion LINE.
Les champs couramment extractibles d'une capture d'écran de commande LINE incluent :
- Nom de l'article (shōhinmei) et Quantité (kosū) — les produits demandés par le client
- Montant total (gōkei kingaku) — si le client a calculé le total, ou si une capture d'écran de paiement est incluse
- Date et heure de livraison (haisō kibō nichiji) — souvent spécifiées comme une fenêtre préférée
- Instructions spéciales (bikō) — des notes telles que des demandes d'emballage cadeau ou des préférences de substitution
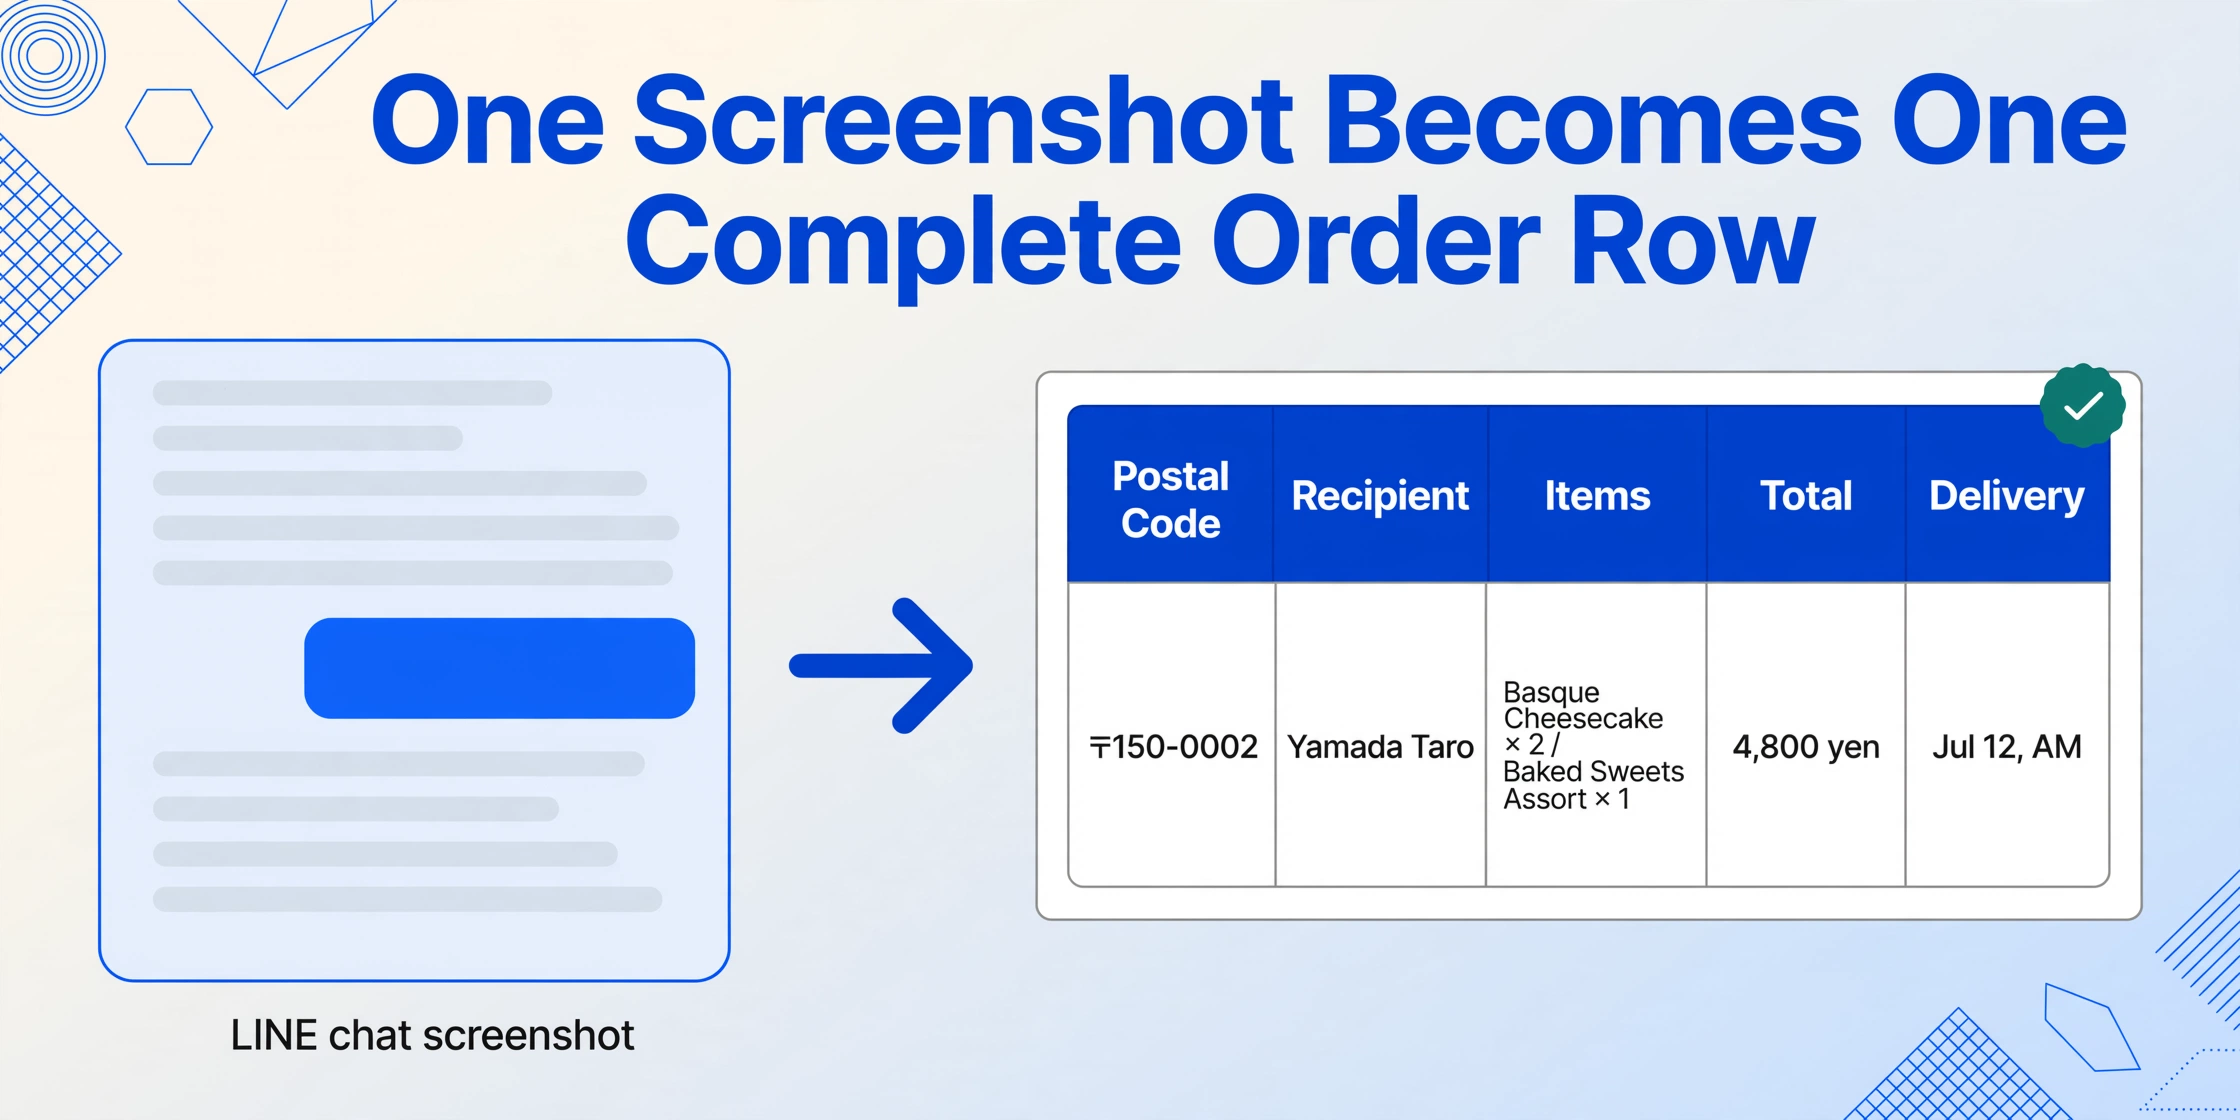
Comme toutes ces informations se trouvent dans la même capture d'écran — même fil de discussion, même image — elles peuvent être extraites en une seule passe en utilisant les mêmes définitions de colonnes qui capturent l'adresse. Le résultat est une ligne dans une feuille de calcul contenant la commande complète : où l'envoyer, quoi envoyer et quand. Aucune correspondance manuelle d'adresses avec les articles de commande entre différentes captures d'écran ou messages. Pour une présentation champ par champ, consultez le guide Extraction d'adresse et de commande à partir de captures d'écran de discussion LINE.
Questions fréquentes
Fonctionne-t-il avec des kanjis manuscrits ou partiellement illisibles ?
Visual AI lit les kanjis en reconnaissant la forme globale du caractère et le contexte, sans tenter de déchiffrer chaque trait isolément. Des kanjis partiellement flous ou petits (comme 渋 dans une capture d'écran basse résolution) peuvent souvent être identifiés correctement grâce aux indices sémantiques du texte environnant. Cependant, les images très dégradées où des caractères entiers sont illisibles restent une limite. Pour de meilleurs résultats, prenez la capture d'écran en résolution originale plutôt qu'une version compressée.
Peut-il distinguer les adresses de Taïwan et du Japon sur LINE ?
Oui. Taïwan utilise aussi LINE intensivement, mais les adresses taïwanaises suivent un format différent. Elles n'utilisent pas le symbole postal 〒, elles emploient un code postal à 3+3 chiffres (pas 3+4), et la structure administrative est différente (comtés et cantons plutôt que préfectures et arrondissements). L'IA identifie le pays grâce à ces signaux structurels et analyse l'adresse en conséquence. La même configuration d'Extraction de colonnes personnalisées gère les deux formats, car vous définissez les colonnes par ce que vous voulez (code postal, ville, district) et l'IA trouve le contenu correspondant, quel que soit le système d'adresse.
Que faire si l'adresse est mélangée à d'autres messages dans la même capture d'écran ?
L'IA traite l'intégralité de la capture d'écran comme un visuel unique et identifie le bloc d'adresse par ses propriétés structurelles : le marqueur de début 〒, le motif hiérarchique à plusieurs segments, et la présence du numéro de téléphone à la fin. Les autres messages qui apparaissent avant ou après l'adresse n'interfèrent pas avec la reconnaissance. Pour de meilleurs résultats, capturez l'écran en cadrant bien le message d'adresse plutôt qu'en incluant un long historique de discussion, bien que l'outil puisse gérer les deux cas.
Puis-je traiter par lots plusieurs captures d'écran de commandes LINE à la fois ?
Oui. Téléchargez toutes les captures d'écran ensemble en un seul lot, utilisez les mêmes définitions de colonnes (Code postal, Préfecture, Ville, Nom du bâtiment, Destinataire, Numéro de téléphone, Nom de l'article, Quantité, Montant total), et le résultat est un tableur unifié avec une ligne par capture d'écran. C'est là que la valeur devient évidente : 20 captures d'écran de commandes LINE issues des conversations de la journée produisent 20 lignes de données structurées, sans aucun travail manuel par message.
L'adresse, les articles commandés, le créneau de livraison — tout est présent dans la capture d'écran que le propriétaire de l'entreprise a déjà sur son téléphone. La question est de savoir si cette capture devient une image de plus dans la galerie ou l'enregistrement d'entrée pour le flux de traitement des commandes du jour.
Le traitement des commandes via LINE ne disparaît pas au Japon. C'est le chemin de moindre résistance pour le client comme pour l'entreprise. L'opportunité consiste à combler l'écart entre « le client a envoyé » et « l'adresse est dans le système d'expédition » — en transformant la capture d'écran d'une simple référence visuelle en données structurées qui alimentent l'étape suivante de la préparation de commande, sans avoir à retaper un seul caractère.