手書き受付フォームの一文字の誤りが
数週間後に請求却下を招く
Experian Health's State of Claims 2025 surveyは、不完全または不正確な患者登録データを、保険請求却下の原因の第3位に挙げています。そのランキングの背後にある仕組みは、ほとんど注目されません。フロントデスクの担当者は、手書きの受付フォームから患者の名前を入力するのに30秒費やしますが、誰も再確認しません。その結果、数週間後に保険請求が返ってくるのは、ファイル上の名前が保険者の記録と一致しないからです。入力した人は何も問題を感じません。見つけた人は誰を責めればよいのかわかりません。
重要なポイント
- 手書きの0がOと読まれただけで、数週間後に請求が却下されることがあります。
- 入力した担当者は何も問題を感じません。なぜなら、患者情報は保険者に請求が届いて初めて保険者の記録と比較されるからです。
- 解決策は、フロントデスクがより注意深くなることではなく、保険者が比較する3つの項目を入力直後に検証可能にすることです。
すべての請求は同じ経路をたどり、ある引き継ぎの時点で誤った数字が入力される
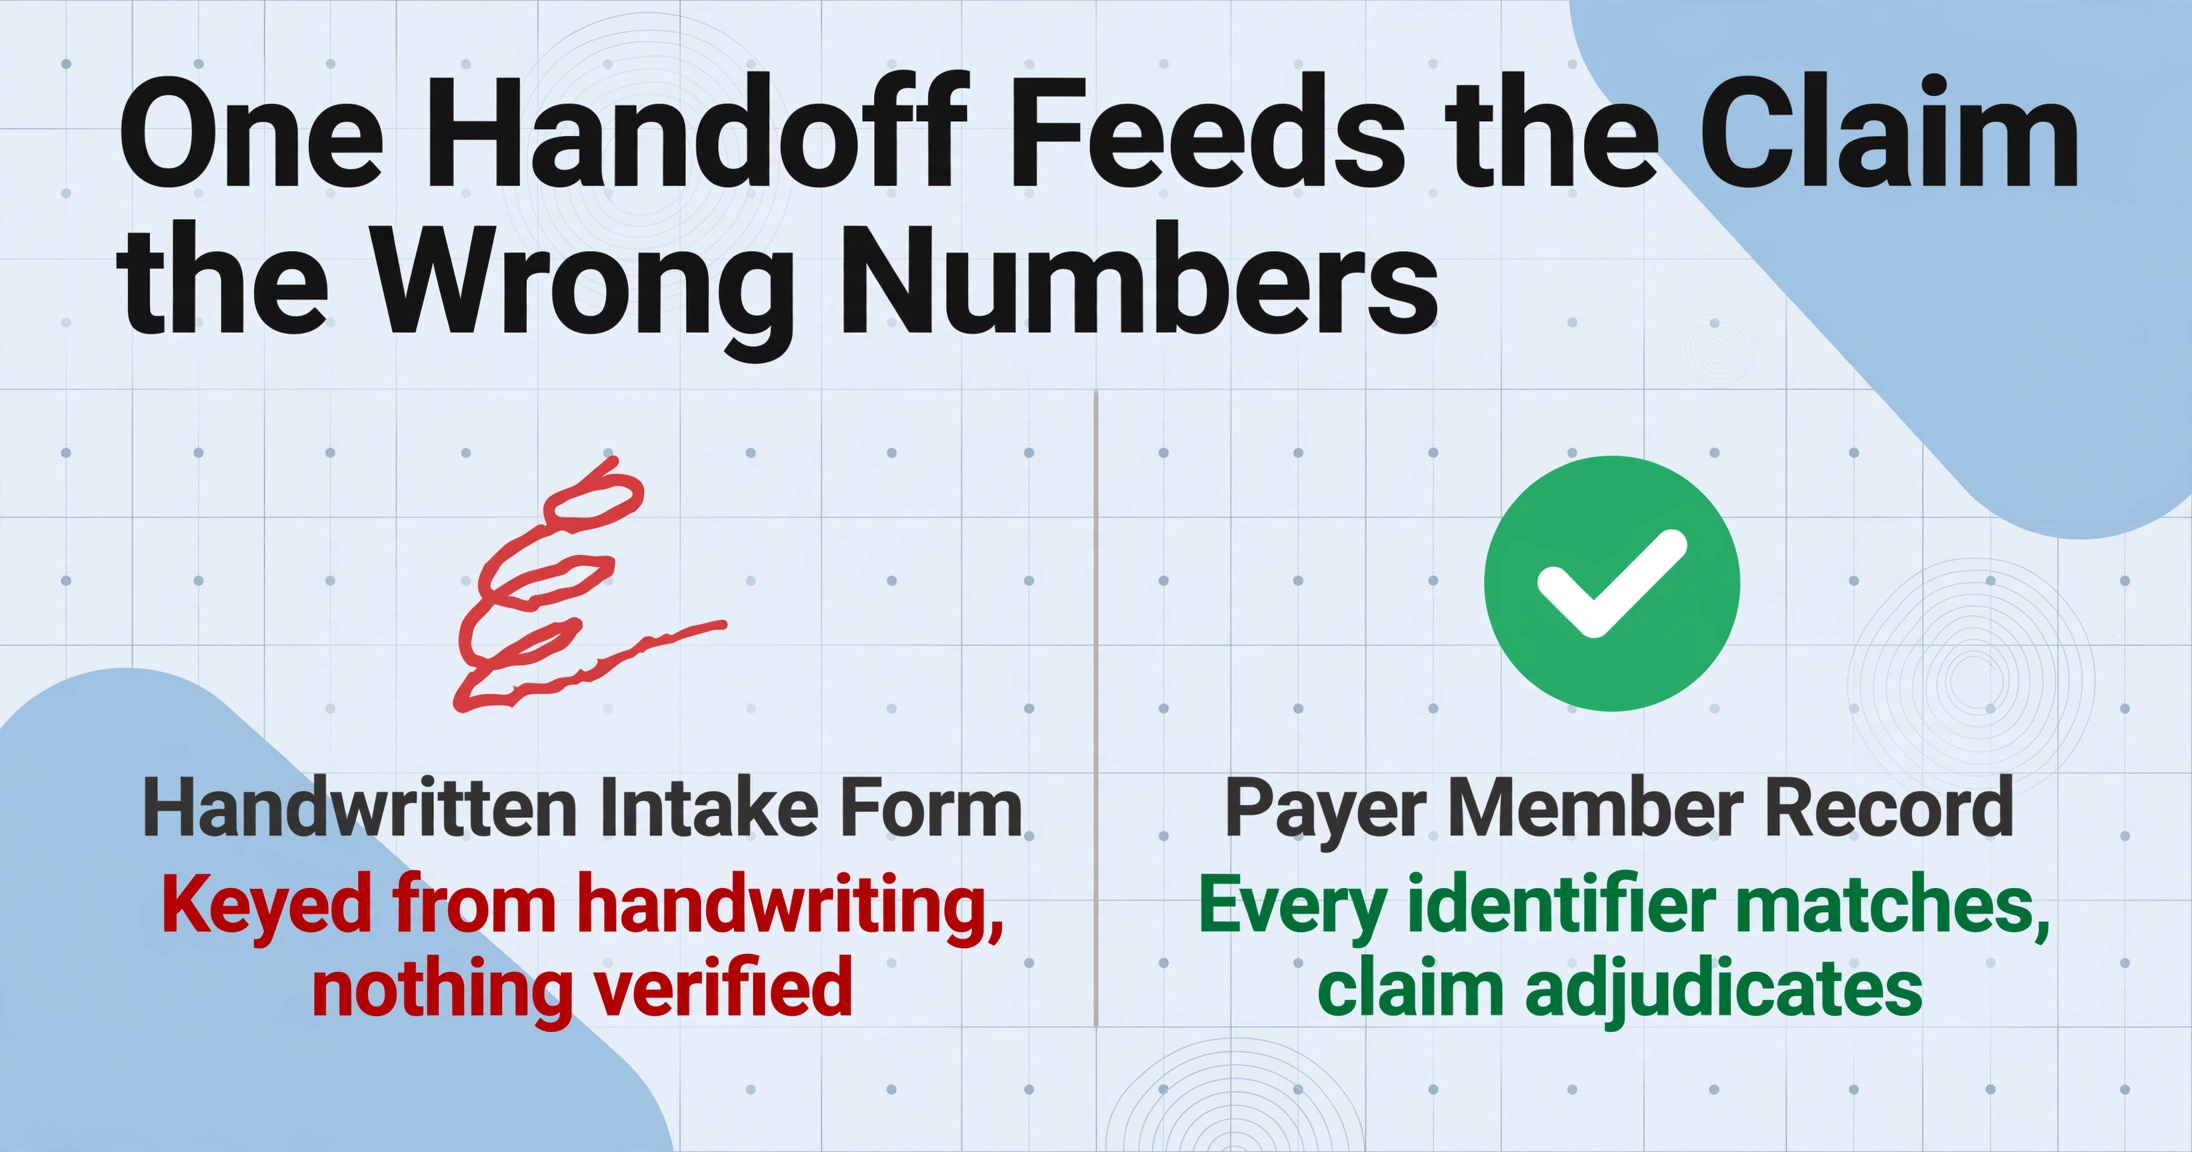
外来請求は、5つの役割が関わる固定された経路をたどる。患者は、予約の10分前に受付フォームに記入する。多くの場合、手書きで行われる。受付は、その基本情報を電子カルテまたは診療管理システムに入力する。米国のほとんどのクリニックでは、Epic、athenahealth、TebraのKareo、またはeClinicalWorksが使われる。請求担当者またはコーダーは、後日、請求書自体を作成する。専門サービスにはCMS-1500フォーム、施設請求にはUB-04が使われ、通常は837電子ファイルとして送信される。クリアリングハウス(Availity、Waystar、Change Healthcareなど)は、請求書の基本的な完全性をチェックし、保険者に転送する。保険者の請求編集システムは、請求書の基本情報を自社の会員記録と照合する。すべての識別子が一致すれば、請求は審査され、EOB(給付明細書)が返されて入力処理が行われる。識別子が一致しない場合、保険者の担当者が目にする前に、請求は拒否または却下されて戻ってくる。
これらの結果の多くを左右する引き継ぎは、提出前にビルドチェックが行われるコーディングではない。それは、患者の保険記録に対して誰も検証しないまま、手書き文字から入力される基本情報ブロックである。Healthcare Financial Management AssociationのPulse Surveyプログラムの下で実施された調査では、350人以上の病院CFOおよび収益サイクルリーダーを対象に、患者アクセスおよび登録時のエラーが初期請求拒否の最も一般的な理由であることが判明し、回答者の47%が拒否率が前年比で上昇したと報告した。
ほとんどの結果を左右するステップは、誰もチェックしないまま手書き文字から入力される基本情報ブロックである。
エラーは単語レベルより下で発生する:0/O、1/l、5/S、そして取り違えられた誕生日
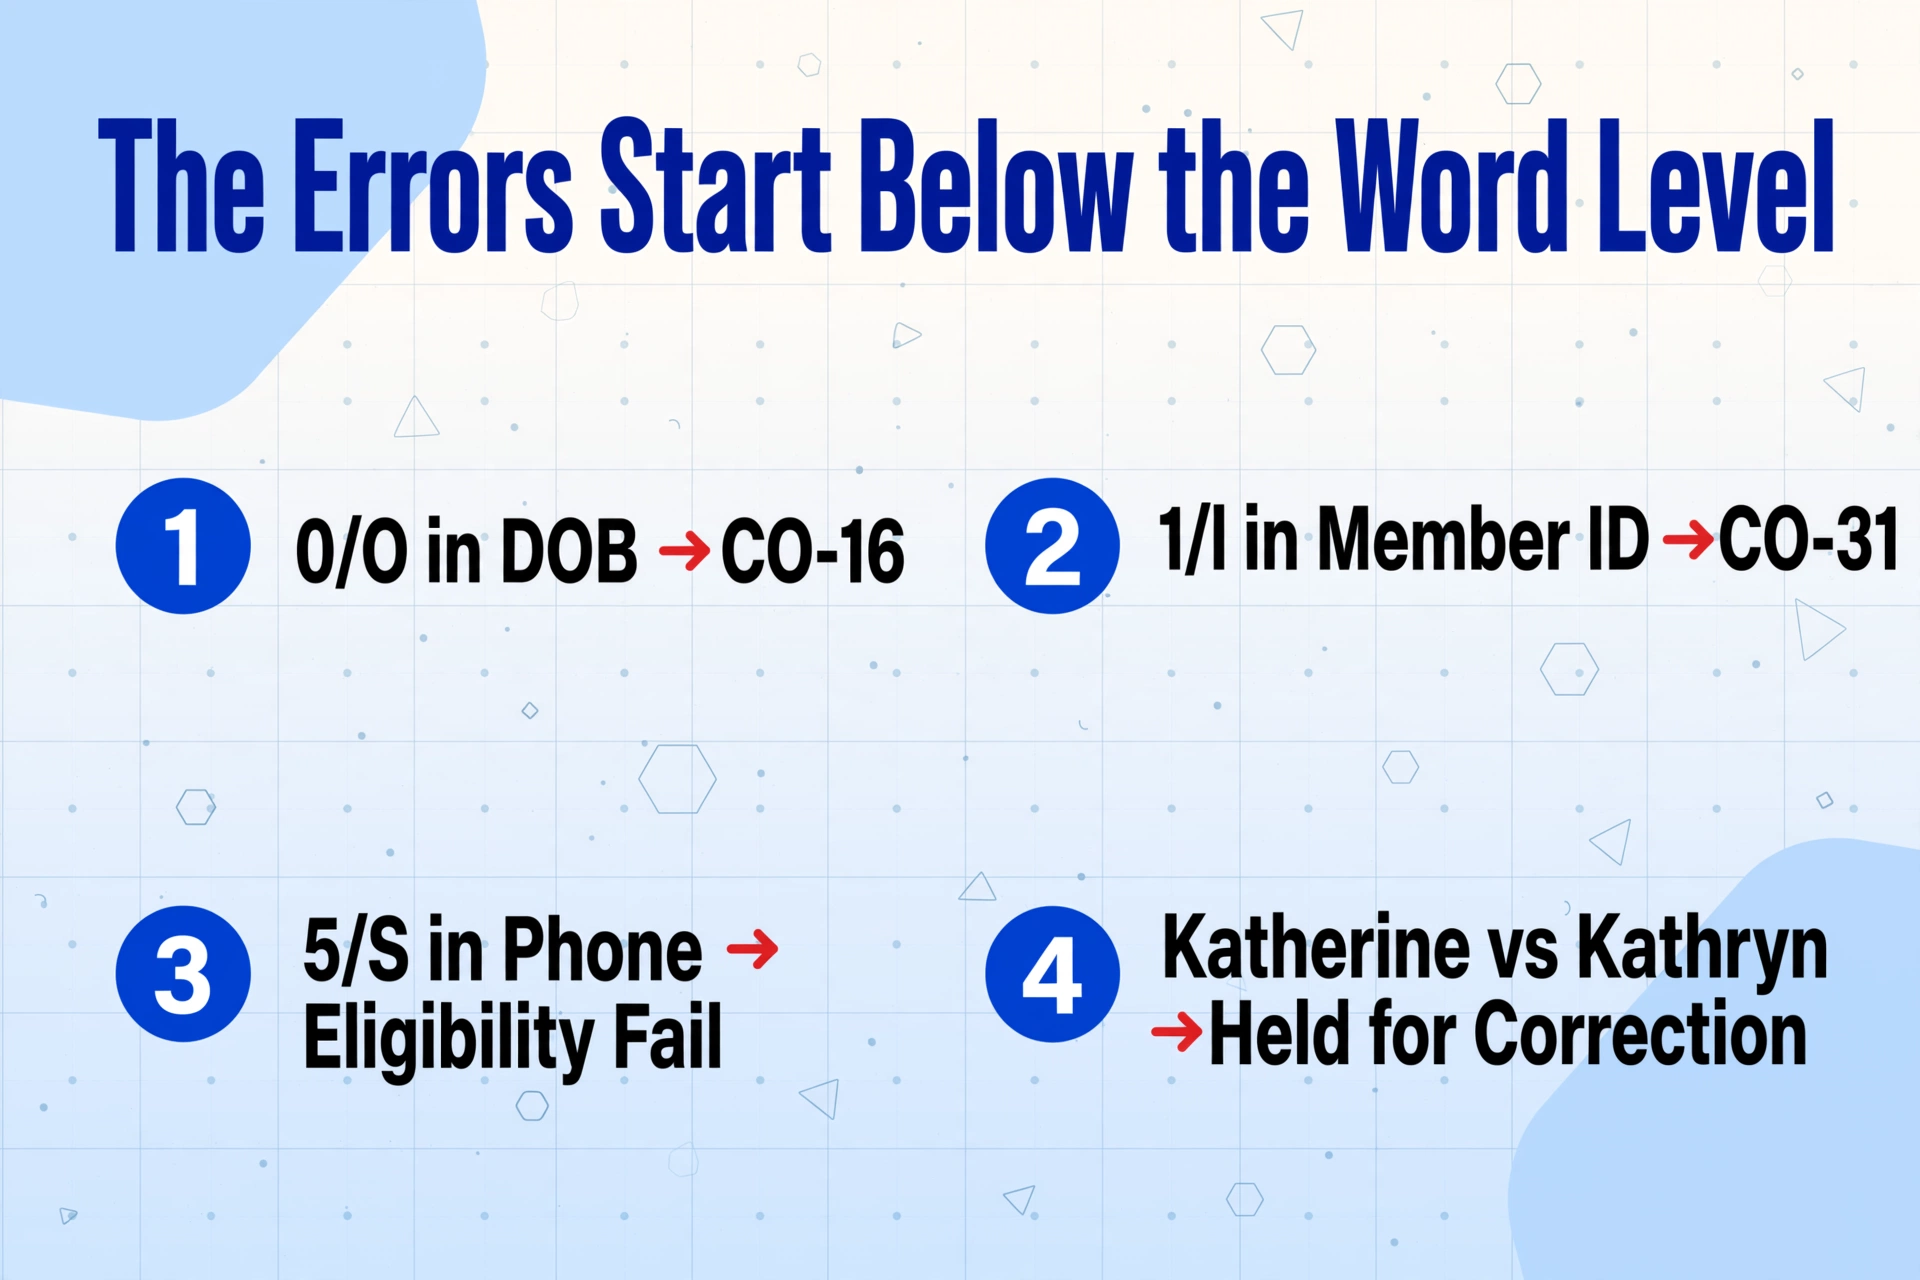
登録エラーは通常「タイプミス」と表現されるため、偶発的なものに聞こえる。しかし、実際には偶発的ではない。読みにくい手書き文字を、疲れた従業員が速読して解釈する際の特定のパターンに沿って発生する。それぞれの失敗モードは、特定の文字、日付、または書き写された文字列に関連している:
| 患者が記入した内容 | 入力された内容 | 影響箇所 |
|---|---|---|
| 生年月日の0 | O | 生年月日不一致、CO-16拒否 |
| 会員ID内の1 | l(小文字のL) | 加入者ID不一致、CO-31 |
| 電話番号の先頭の5 | S | 連絡先データ不一致、資格情報のクロスチェック失敗 |
| 明確な「th」付きのKatherine | Kathryn | 氏名不一致、訂正のため請求保留 |
| 03/12(月/日) | 3/17 | 生年月日不一致、会員検索に失敗 |
受付フォームのエラーがこれほど長く残存する理由は、診療所内では入力された患者情報を保険者の会員ファイルと入力時点で照合する仕組みがないためだ。その照合は後になって、保険者側のシステム内でのみ行われる。綴りのバリエーションはそれ自体が独立した問題のカテゴリーである。保険者の登録ファイルには、雇用主または保険会社が記録した名前のバージョンが保存されているため、請求に使用すべき正しい綴りは保険者が保持しているものになる。保険証券がKathryn名義であるにもかかわらず、患者がKatherineと書く場合、フォーム上の誰のミスでもなく不一致が生じる。そして、患者が書いた内容を入力する事務員は、問題を認識できない。なぜなら、重要な受け渡しはフォームとキーボードの間ではなく、保険者データベースと請求書の間で行われるからだ。
他のエラー原因は、タイピング以前に存在する。カーボンコピーや第二世代ファックスでは、手書き文字がループの欠けた灰色の筆跡になり、読者は文脈から欠落部分を補完し、誤った推測をしてしまう。保険証を忘れた患者は、受付で記憶、付箋メモ、または保険IDではないポイントカードから会員IDを書き写すことになる。MedicareのMBIは11文字で構成され、混乱を減らすためにS、L、O、I、B、Zの文字を意図的に除外しているが、それでも手書きのMBIはコピー品質が悪いとB/8やI/1の置き換えが発生する。これらのいずれにも、不注意な従業員は関与していない。必要なのは、紙を読む人が保険者の記録と照合できる立場にいるというプロセスだ。
支払者側システムが不一致をどう処理するか:CO-16とCO-31
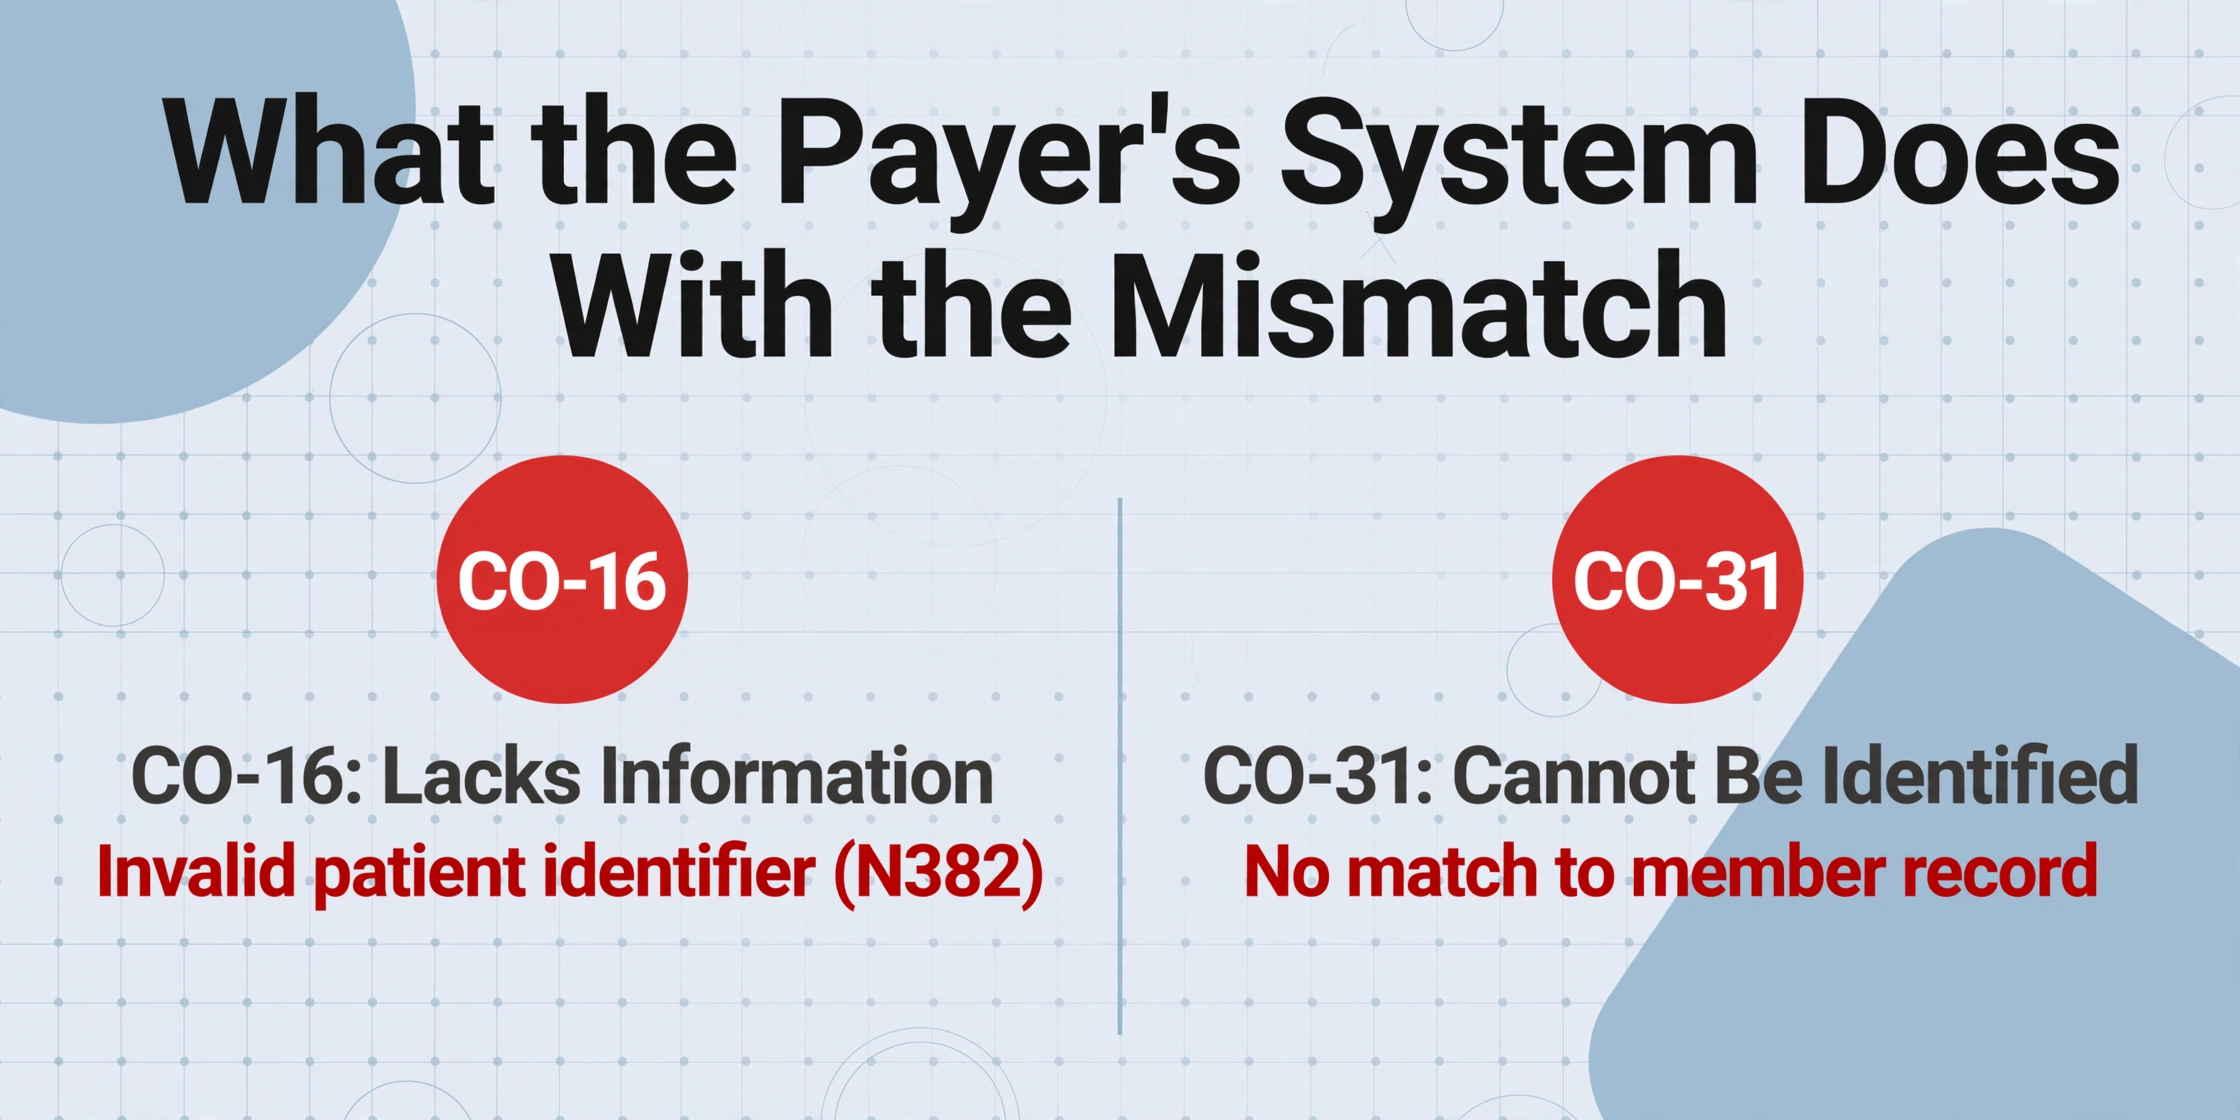
支払者の請求審査システムは、提出されたすべての請求を、氏名、生年月日、会員IDを登録データベースと自動照合する。1文字の不一致でも、標準的なHIPAA請求調整理由コードが発動する。これは、EOBまたは電子送信通知とともに返される定型文である。受付時に発生するケースの大半は、2つのコードでカバーされる。CO-16は「請求/サービスに情報が不足している、または不完全な状態で提出された」ことを意味し、人口統計情報の不一致で発動した場合、通常は無効な患者識別子を示すリマークコードN382と組み合わせて返される。CO-31は「患者を被保険者として特定できない」ことを意味し、提出された識別子が会員記録とまったく照合できない場合に使用されるコードである。
両方のコードは、特定の是正経路を示す。すなわち、不服申し立て(アピール)ではなく、修正請求(コレクテッド・クレーム)である。修正請求の再提出はアピールよりも低コストだが、取り戻せない資源、つまり提出期限を消費する。メディケアの期限はサービス提供日から12ヶ月、民間プランでは一般的に90日から180日とされている。拒否、調査、修正、再提出のサイクルを繰り返すたびに、その期限の1週間から1ヶ月が費やされ、さらに各往復で、支払いが見込める請求を処理できたはずのスタッフが再割り当てされる。アメリカ医療情報管理協会(American Health Information Management Association)は、その会員がこのプロセスの登録・記録管理側を担っているが、より広範な重要性を記録に残している。患者識別エラーは登録プロセス中に発生することが多く、エラーの連鎖を引き起こす可能性があり、最新のデータによれば、拒否された請求の約35%が不正確な患者識別に起因し、平均的な病院では年間推定250万ドル、米国の医療システム全体では60億ドル以上のコストがかかるとされている。業界関係者自身も、このパターンを他の人々と同じように、遅れて発見することで認識している。r/HealthInsuranceのスレッドで、ある患者は、4つの異なる医療機関で同じ請求ミスを発見した経験を次のように語っている。「受付が保険情報を正しく入力しておらず、プロバイダーが患者を助けているつもりで自分でコードを入力しようとして、実際には患者を傷つけていた」。
請求の1文字の不一致は、支払者側の人間が請求を確認する前に、自動的な拒否を引き起こす。修正は提出前に行う必要があり、そうでなければ提出期限を消費することになる。
入口で防ぐ:用紙の置き換えを必要としない2つの設定
この問題への一般的な答えは、デジタル受付プラットフォームで紙を廃止することであり、多くの診療所にとってそれは長期的には正しい選択です。しかし、紙の受付はほとんどのクリニックで存続しています。なぜなら、代替手段はシステム変更であり、その変更が検討されている間も、新しい患者はチェックイン時にフォームに手書きで記入するからです。今日機能する入口での対策は、クリップボードを撤去するものではありません。それは、受付パケット自体を読み取るデータ抽出を使用して、人口統計ブロックを入力時点で検証可能にするものです。
その仕組みはカスタム列抽出です。ImageToTable.aiでは、出力スプレッドシートに必要な列名(例:「患者法的姓」「患者法的名」「生年月日」「保険者会員ID」)を入力すると、AIはフィールドラベルの意味を理解して各値を特定します。固定位置やテンプレートの一致ではありません。これにより、異なるクリニックの受付フォーム間で1セットの列が機能します。フィールドは座標ではなく意味で見つかるからです。出力は患者ごとの行で、人口統計情報が個別のセルに配置され、請求作成前に支払者記録と比較できます。これは患者受付フォームページで詳述されている機能と同じであり、患者の氏名、生年月日、会員IDをフロントデスクが実際に確認できる場所に配置する部分です。
手書き文字がモデルティアの出番です。ImageToTable.aiでは、アカウントをStandard、Advanced、Premiumの処理ティアで実行でき、上位ティアは密集した手書き文字や複雑なレイアウトに調整されたより強力な視覚モデルを使用します。鉛筆で記入されたスキャン、第3世代ファックス、手書きの欄外メモがあるフォームなどの受付パケットには、上位ティアがそのバッチに適しており、文字の曖昧さが失敗モードとなるバッチでは追加コストに見合う価値があります。ティアはバッチ提出時に固定されるため、クリーンなデジタルフォームをStandardで、手書きスキャンをPremiumで処理する診療所は、各バッチを実際に必要としたティアで請求されます。
最強のティアでも認識は保証されないため、2つ目の設定は識別子列を対象とした検証パスです。bbox検証付きレビューモードでは、抽出された任意のセルにホバーすると元画像の正確な手書き領域がハイライト表示され、画像上の領域をクリックすると対応するセルにジャンプします。受付フォームでは自動注釈を有効にして全ファイルのハイライトを生成し、法的氏名、生年月日、保険者会員IDの正確に3列をスポットチェックします。これら3つの値は支払者システムが比較する値であり、請求を構築する前に人間の目で確認する必要があるのはこの3つだけです。投薬列の誤読は臨床記録の問題ですが、会員ID列の誤読は請求拒否です。このツールの請求側の現実は、EOBデータがこのチェーンの反対側にあり、数十年にわたり手動入力されてきたことです。したがって、受付側はこのワークフローで唯一の手動引き継ぎではありませんが、請求が支払可能かどうかを決定するのはそこです。識別子がクリーンになりEOBが返ってきたら、残りの作業はそれがどの患者記録に属するかを確認することであり、これはEOBを正しい患者に照合するで説明されている照合ワークフローです。
設定前に、ご自身の受付フォームで抽出機能をお試しください。
本ツールで解決できることと、人間または保険者の判断が依然として必要なこと
正直な境界線を示すことで、このワークフローは実用性を保てる。手書き文字の抽出精度は高いものの100パーセントではなく、だからこそ検証パスが存在し、人間による判断が本来あるべき場所に残っている。同じ氏名で生年が近い2人の患者がいる場合、どちらの記録がどちらかを判断するのは登録担当者の役割であり、スプレッドシートの行はその判断の根拠であって、判断そのものではない。また、本ツールは保険資格確認の代わりにはならない。受付時にクリアリングハウスの資格確認トランザクションを通じて保険者データベースと照合する作業は、転記ミスとは異なる失敗モードを防ぐための別のステップとして残る。
コンプライアンスに敏感な診療所にとって重要な2つの制限がある。ImageToTable.aiはEpic、athenahealth、その他のEHRとは連携しない。出力はチームがインポートするスプレッドシートであり、システムへのマッピングは引き続き自社のワークフローとなる。また、本サービスはHIPAAコンプライアンスの解決策ではない。Business Associate Agreementは提供されておらず、保護された健康情報を扱う診療所は、患者を特定できるフォームをアップロードする前に、本サービスが自社の義務とポリシーを満たしていることを確認する必要がある。このワークフローがもたらす価値は、検証可能な人口統計ブロックと、各値を生み出した正確な手書き文字に遡れる証跡であり、コンプライアンス層ではない。
最後に、入力時点でエラーを捕捉しても、チェーンの下流側は自動化されない。EOBが戻ってきたときに、支払額、患者自己負担額、拒否コードが請求内容と一致するかを検証する作業は、独自の失敗モードを持つ別の作業負荷であり、ここでEOB抽出精度と完全なEOB抽出ワークフローが登場する。受付時の修正により、そもそもそのステップに到達する請求の割合が増える。
よくある質問
AIは、受付フォームの読みにくい手書き文字を実際に読めるのでしょうか、それともチェックボックスと印刷テキストのみに対応しているのでしょうか?
ImageToTable.aiの認識機能は、ドキュメント全体の印刷テキスト、手書き文字、筆記体、チェックボックス、署名に対応しています。手書き文字が多い受付パケットの場合、より高い処理ティアでバッチを実行すると、0/Oや1/lのような曖昧な文字に対して顕著に良い結果が得られます。その後のbboxレビューパスで、患者名、生年月日、会員IDといった重要な値を、クレームがそれらに基づいて作成される前に、元の手書き文字と照合して確認できます。
これだけで、患者登録の拒否をすべて防げるのでしょうか?
いいえ。これは転記の部分、つまり手書きフォームから入力された人口統計情報を修正するものです。適格性のギャップ、保険適用の失効、承認の欠如、臨床的またはコーディング上の問題は、別のメカニズムを通じてクレームを拒否させるため、チェックイン時の適格性確認は引き続き必要です。フロントエンドの正確性は広く引用される手段であり、Experian Healthの拒否管理調査では組織の半数が重要な機会として挙げていますが、それは複数の手段のうちの1つにすぎません。
手書きの受付フォームをアップロードすると、保護された健康情報が診療所の外部に送信されることになりますか?
その可能性があり、その判断はお客様に委ねられています。ImageToTable.aiはHIPAAの適用対象事業体ではなく、ビジネスアソシエイト契約も提供していないため、HIPAAの適用を受ける診療所は、患者識別子を含むフォームをアップロードする前に、自社のコンプライアンス要件とポリシーに照らして本サービスを評価するか、ユースケースに合う場合は非識別化されたドキュメントで作業する必要があります。本ツール自体の立場として、HIPAAまたはBAAへの準拠を主張するものではなく、このワークフローは、コンプライアンスレビューがサポートする形式で使用されるべきです。
これは、登録時にクリアリングハウスが行う適格性チェックを置き換えるものですか?
いいえ、置き換えるべきではありません。適格性確認は、チェックイン時に支払者の保険適用データベースを照会し、患者がそのサービスに対して有効な保険に加入しているかという異なる質問に答えます。抽出とbboxレビューは、入力されている人口統計情報がフォーム上のものと一致しているかという異なる質問に答えます。チェックイン時には、引き続きクリアリングハウスの適格性トランザクション(Availity、Waystar、または既存のチャネル経由)を実行します。このワークフローは、受信する人口統計情報ブロックの信頼性を高めるだけです。
クレームがCO-16またはCO-31で返ってきた場合、標準的な対応は支払者側の問題として扱い、異議を申し立てることです。はるかに費用対効果の高い対応は、手書きフォームから取得した人口統計情報ブロックを確認することです。そのブロックは支払者が確認したバージョンであり、入力後30秒で検証可能にできるからです。3週間後ではなく、次の新規患者がフォームに記入する前に、自社の受付パケットで抽出をテストし、会員ID列が支払者の記録と一致するかどうかを確認してください。