Un seul caractère erroné sur un formulaire d'admission manuscrit
peut devenir une réclamation refusée des semaines plus tard
L'enquête State of Claims 2025 d'Experian Health classe les données d'enregistrement des patients incomplètes ou inexactes comme la troisième cause la plus courante de réclamations refusées. Le mécanisme qui explique ce classement reçoit rarement l'attention qu'il mérite : un agent d'accueil passe trente secondes à saisir le nom d'un patient à partir d'un formulaire d'admission manuscrit, personne ne le revérifie, et quelques semaines plus tard, la réclamation revient parce que le nom au dossier ne correspond pas aux registres du payeur. La personne qui l'a saisi n'a rien vu d'anormal. La personne qui a découvert le problème n'a aucune idée de qui blâmer.
À retenir
- Un 0 manuscrit lu comme un O suffit à faire refuser une réclamation des semaines plus tard.
- L'agent qui a saisi le nom n'a rien vu d'anormal, car les données démographiques ne sont comparées aux registres du payeur qu'une fois la réclamation arrivée chez le payeur.
- La solution n'est pas d'avoir un accueil plus vigilant, mais de rendre vérifiables les trois champs que le payeur compare, dans les secondes qui suivent leur saisie.
Chaque réclamation suit le même parcours, et une seule transmission alimente les mauvaises données
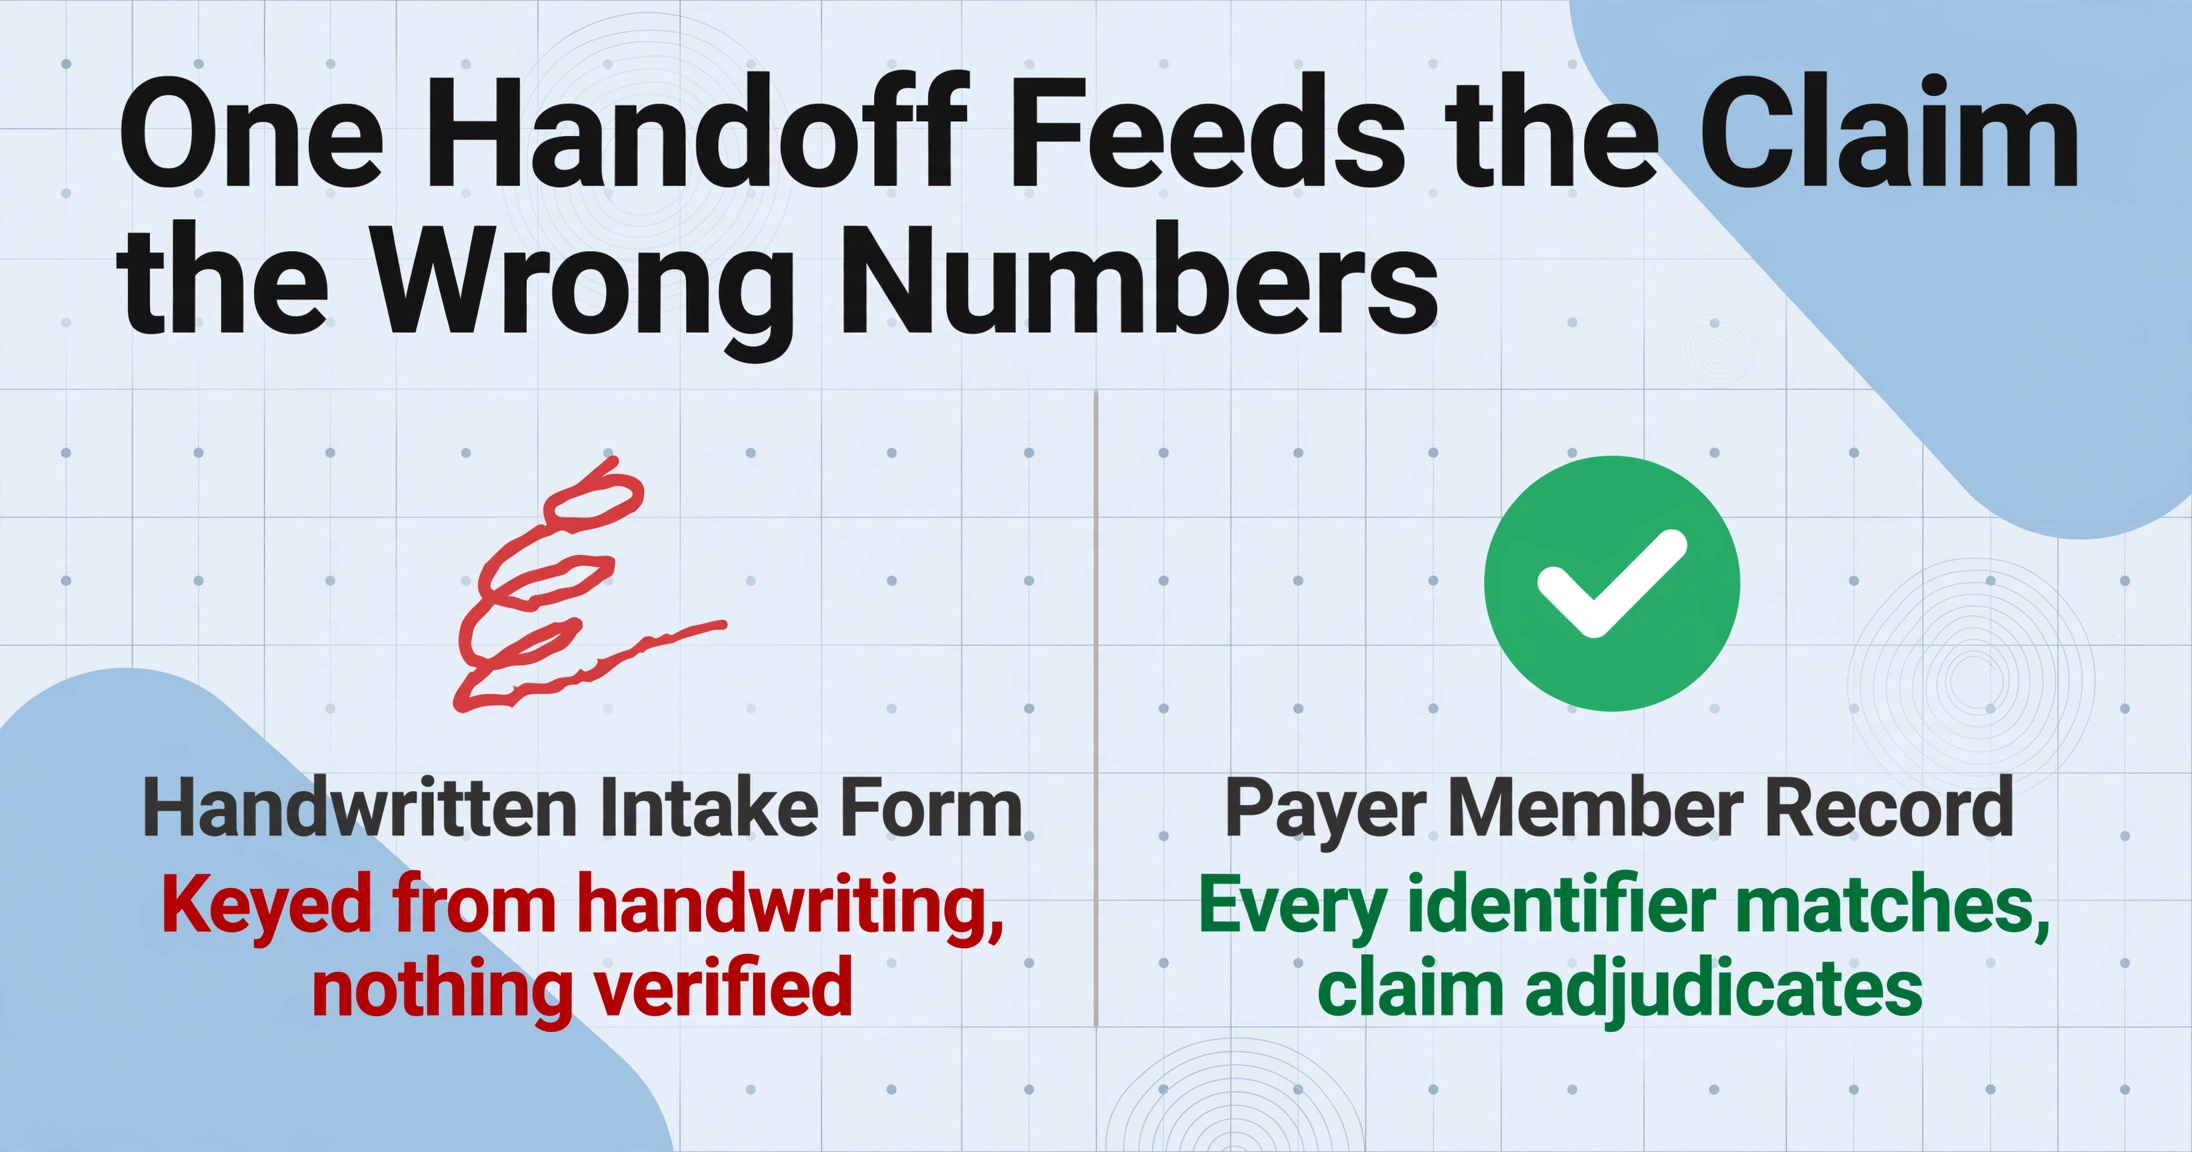
Une réclamation de soins ambulatoires suit un parcours fixe avec cinq acteurs nommés. Le patient remplit le formulaire d'admission, souvent à la main, dix minutes avant le rendez-vous. Le guichet d'accueil saisit les données démographiques dans le dossier de santé électronique ou le système de gestion de cabinet, ce qui dans la plupart des cliniques américaines signifie Epic, athenahealth, Tebra's Kareo ou eClinicalWorks. Le facturier ou codeur assemble ensuite la réclamation elle-même, le formulaire CMS-1500 pour les services professionnels ou le UB-04 pour les réclamations d'établissement, généralement transmis sous forme de fichier électronique 837. Un centre d'échange, tel qu'Availity, Waystar ou Change Healthcare, vérifie l'exhaustivité de base de la réclamation et la transmet au payeur, dont le système de contrôle des réclamations compare les données démographiques de la réclamation à ses propres dossiers de membres. Lorsque chaque identifiant correspond, la réclamation est traitée et un EOB (explication des prestations) revient pour saisie. Lorsqu'un identifiant ne correspond pas, la réclamation est renvoyée rejetée ou refusée avant qu'un humain chez le payeur ne la regarde.
La transmission qui décide de la plupart de ces résultats n'est pas le codage, qui passe par des contrôles de construction avant la soumission. C'est le bloc de données démographiques, saisi à partir d'une écriture manuscrite à un moment où personne ne vérifie quoi que ce soit par rapport au dossier d'assurance du patient. Une enquête menée dans le cadre du programme Pulse Survey de la Healthcare Financial Management Association, couvrant plus de 350 directeurs financiers d'hôpitaux et responsables du cycle de revenus, a constaté que les erreurs d'accès et d'inscription des patients étaient la raison la plus courante des refus initiaux de réclamations, avec 47 pour cent des répondants signalant que les taux de refus augmentaient d'une année sur l'autre.
L'étape qui décide de la plupart des résultats est un bloc de données démographiques saisi à partir d'une écriture manuscrite à un moment où personne ne le vérifie.
Les erreurs commencent sous le niveau du mot : 0/O, 1/l, 5/S et une date de naissance inversée
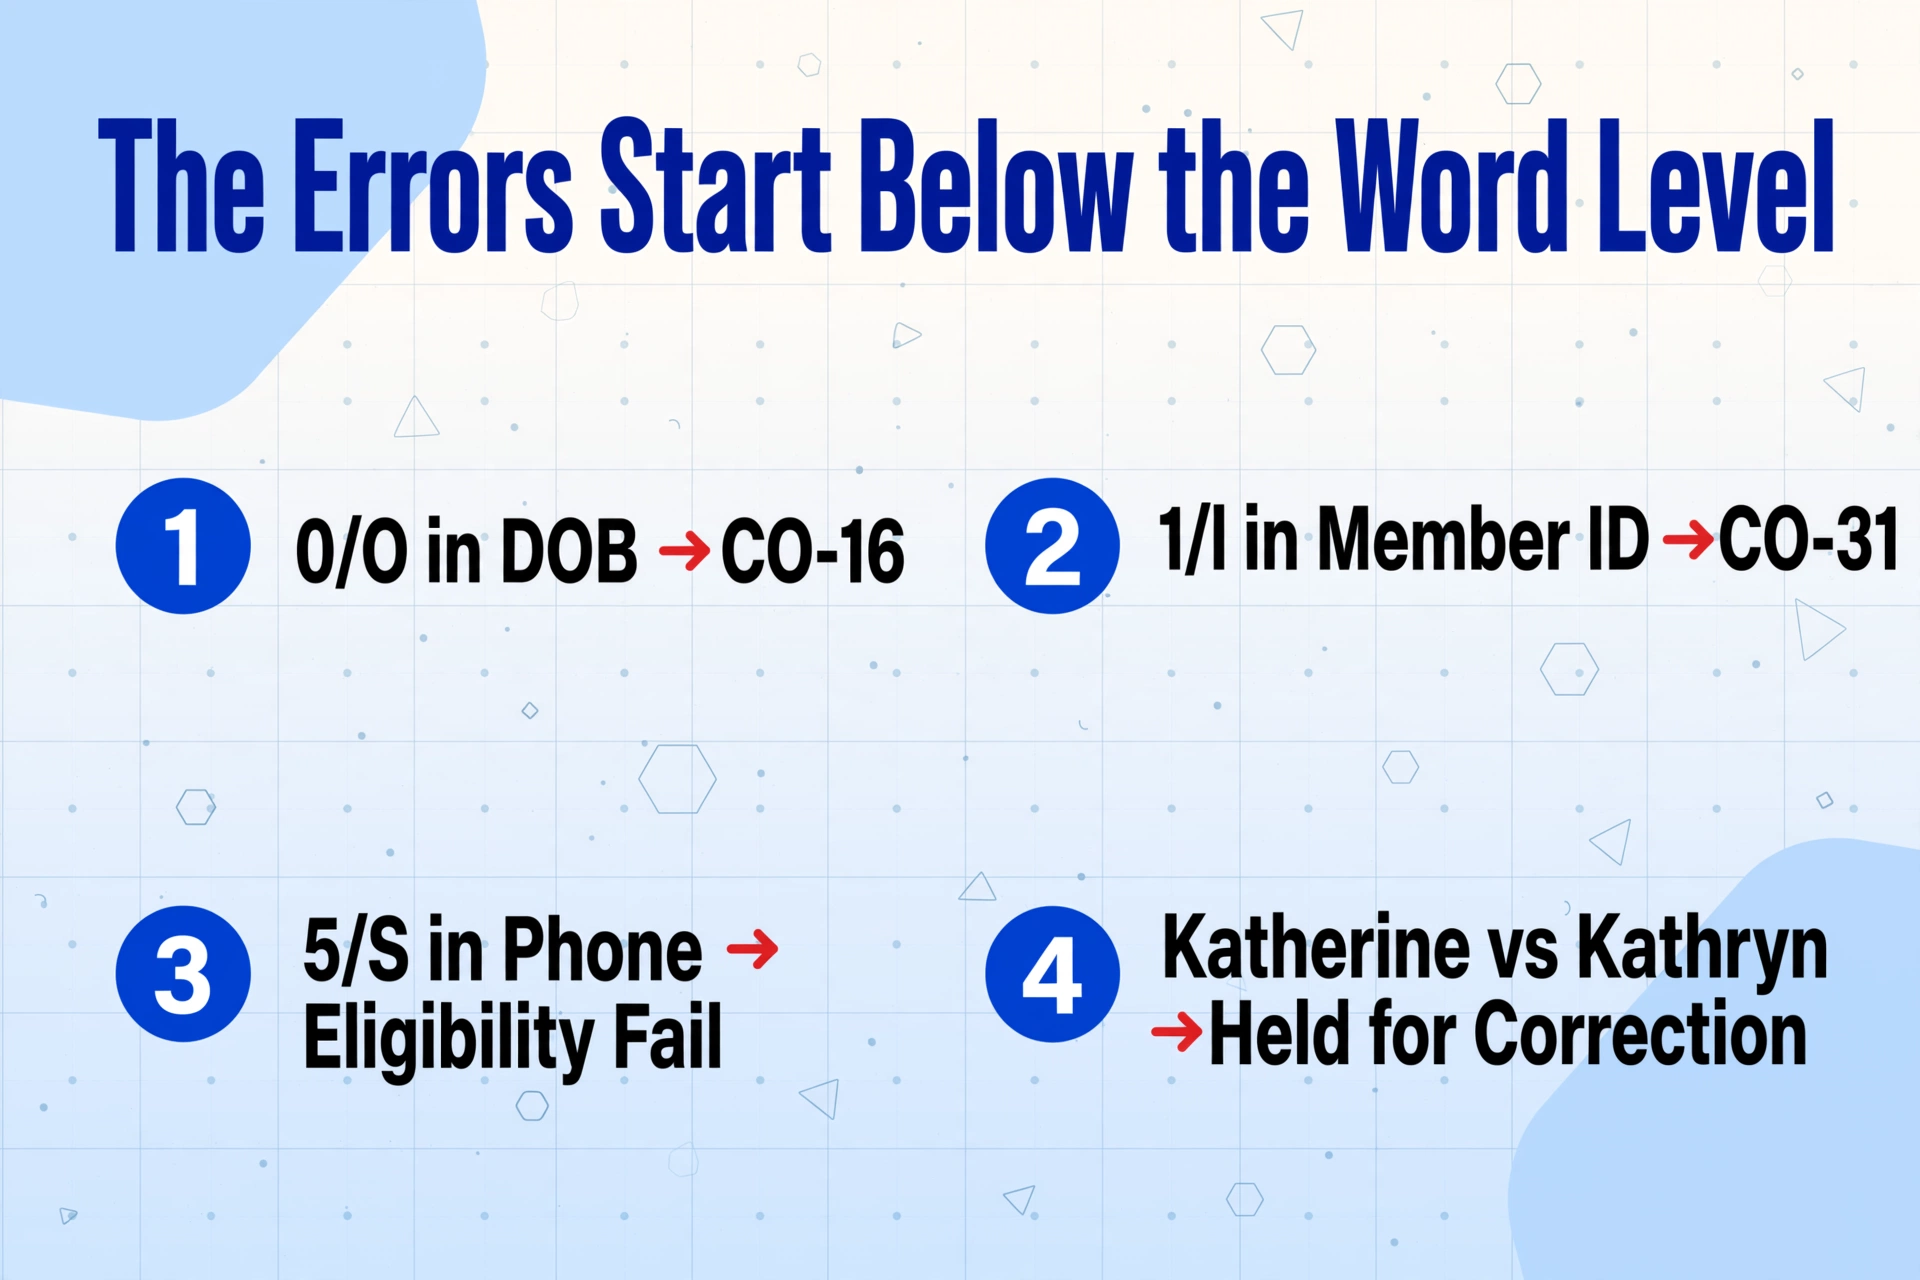
Les erreurs de saisie sont généralement décrites comme des « fautes de frappe », ce qui les fait paraître aléatoires. Elles ne le sont pas. Elles suivent les manières spécifiques dont une écriture illisible est interprétée par un employé fatigué qui lit rapidement. Chaque mode de défaillance est lié à un caractère, une date ou une chaîne copiée :
| Ce que le patient a écrit | Ce qui est saisi | Où cela aboutit |
|---|---|---|
| 0 dans une date de naissance | O | Incohérence de date de naissance, rejet CO-16 |
| 1 dans un identifiant membre | l (L minuscule) | Incohérence d'identifiant d'abonné, CO-31 |
| 5 au début d'un chiffre de téléphone | S | Incohérence des coordonnées, échec de la vérification croisée d'éligibilité |
| Katherine avec un « th » clair | Kathryn | Incohérence de nom, réclamation retenue pour correction |
| 03/12 (mois/jour) | 3/17 | Incohérence de date de naissance, recherche du membre impossible |
Si les erreurs des formulaires d'admission survivent si longtemps, c'est que rien dans le cabinet ne compare les données démographiques saisies au fichier des membres du payeur au moment de la saisie ; cette comparaison n'a lieu que plus tard, dans le système du payeur lui-même. Les variantes d'orthographe constituent une catégorie à part entière. Les fichiers d'inscription du payeur contiennent la version du nom enregistrée par l'employeur ou l'assureur, donc l'orthographe correcte pour la réclamation est celle que détient le payeur. Un patient qui écrit Katherine alors que la police est au nom de Kathryn crée une incohérence sans qu'aucune erreur ne soit commise sur un formulaire, et l'employé qui saisit ce que le patient a écrit ne peut pas voir le problème, car le transfert qui compte se produit entre la base de données du payeur et la réclamation, pas entre le formulaire et le clavier.
Les autres sources d'erreur précèdent entièrement la saisie. Les copies carbone et les télécopies de deuxième génération transforment l'écriture en traits gris aux boucles manquantes, si bien que le lecteur comble les lacunes à partir du contexte et se trompe. Un patient qui a oublié sa carte d'assurance laisse la réception copier un identifiant membre de mémoire, depuis un pense-bête ou depuis une carte de fidélité qui n'est pas l'identifiant d'assurance. Le MBI de Medicare comporte 11 caractères et exclut délibérément les lettres S, L, O, I, B et Z pour réduire la confusion, mais un MBI manuscrit subit quand même des substitutions B/8 et I/1 sur une copie de mauvaise qualité. Aucune de ces erreurs n'exige un employé négligent. Elles exigent un processus où la personne qui lit le papier n'est pas celle qui peut le vérifier auprès des dossiers du payeur.
Ce que fait le système du payeur face à l'inadéquation : CO-16 et CO-31
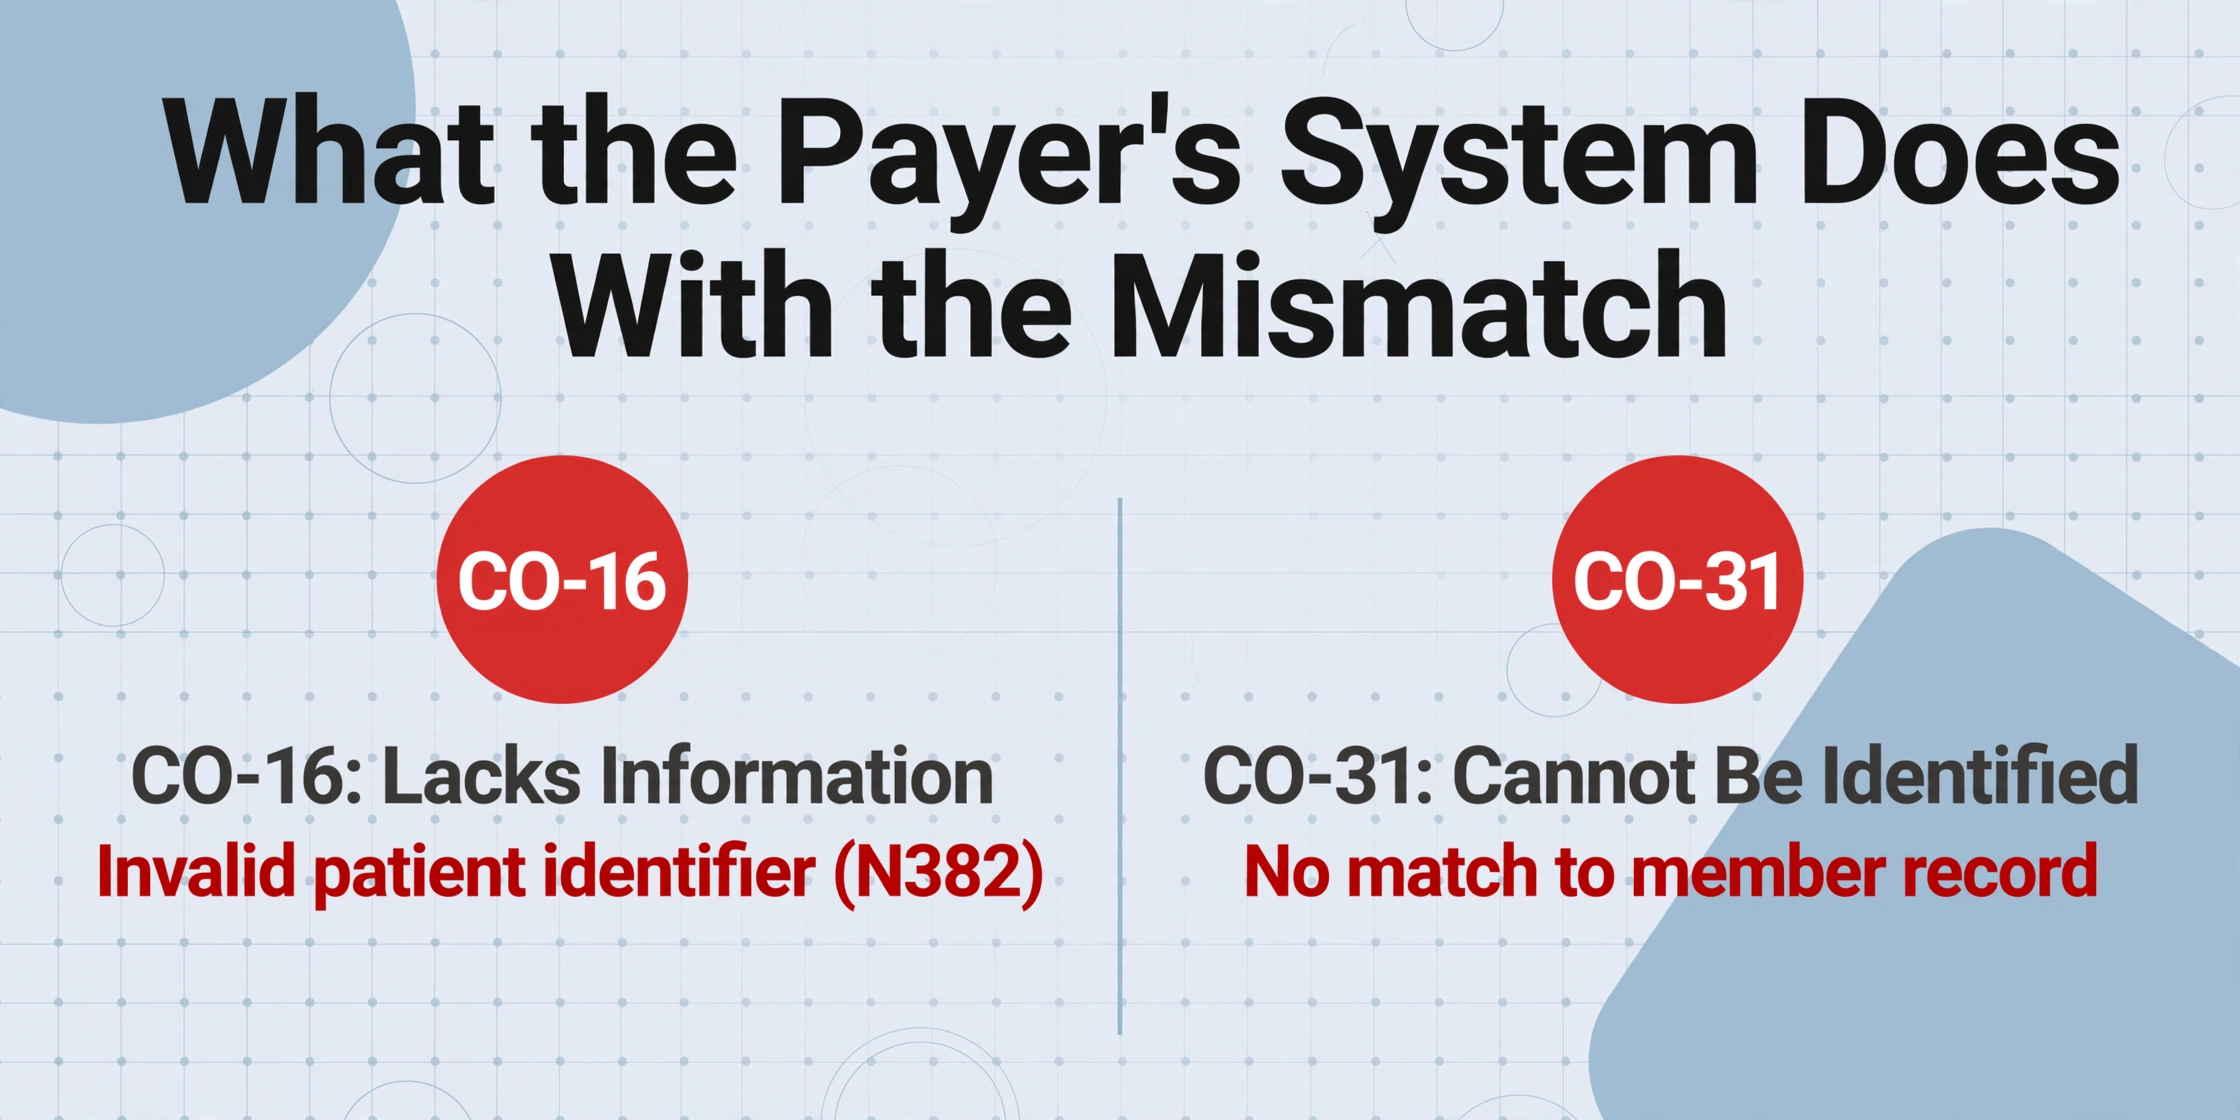
Les systèmes d'édition des réclamations des payeurs soumettent chaque réclamation déposée à une comparaison automatisée du nom, de la date de naissance et de l'identifiant du membre avec la base de données d'inscription. Une inadéquation d'un seul caractère déclenche un code de motif d'ajustement de réclamation HIPAA standard, qui est la formulation fixe qui revient avec l'EOB ou l'avis de remise électronique. Deux codes couvrent la plupart des cas qui commencent à l'admission. CO-16 signifie « la réclamation/service manque d'informations ou a été soumise incomplète », et lorsqu'il se déclenche pour une inadéquation démographique, il est généralement associé au code de remarque N382 pour un identifiant de patient invalide. CO-31 signifie « le patient ne peut pas être identifié comme notre assuré », le code utilisé lorsque l'identifiant soumis ne peut pas du tout être mis en correspondance avec un dossier de membre.
Les deux codes définissent une voie de correction spécifique : une réclamation corrigée, et non un appel. La soumission d'une réclamation corrigée est moins coûteuse qu'un appel, mais elle consomme la seule ressource qui ne peut pas être récupérée : la fenêtre de dépôt. La limite de Medicare est de 12 mois à compter de la date de service ; les régimes commerciaux autorisent généralement 90 à 180 jours. Chaque cycle de rejet, recherche, correction et nouvelle soumission consomme une semaine à un mois de cette fenêtre, et chaque aller-retour réaffecte également un membre du personnel qui aurait pu travailler sur une réclamation qui paie. L'American Health Information Management Association, dont les membres gèrent le volet inscription et dossiers de ce processus, a consigné les enjeux plus larges : les erreurs d'identification des patients commencent souvent pendant le processus d'inscription et peuvent déclencher une cascade d'erreurs, et selon les données les plus récentes disponibles, environ 35 pour cent des réclamations refusées ont été attribuées à une identification inexacte du patient, coûtant à l'hôpital moyen environ 2,5 millions de dollars par an et au système de santé américain plus de 6 milliards de dollars. Les propres acteurs du secteur découvrent ce schéma de la même manière que nous tous : en le constatant trop tard. Un patient dans un fil r/HealthInsurance a décrit avoir constaté la même défaillance de facturation chez quatre prestataires différents : « La réceptionniste ne saisit pas correctement l'assurance, le prestataire essaie de coder lui-même en pensant aider les patients mais leur nuit en réalité. »
Une inadéquation d'un seul caractère sur la réclamation déclenche un refus automatisé avant qu'un humain chez le payeur ne voie la réclamation. La correction doit avoir lieu avant la soumission, sinon elle coûte une fenêtre de dépôt.
Intercepter à l'entrée : deux réglages qui ne nécessitent pas de remplacer le papier
La réponse habituelle à ce problème consiste à éliminer le papier grâce à une plateforme d'admission numérique, et pour de nombreux cabinets, c'est la bonne décision à long terme. Mais l'admission sur papier subsiste dans la plupart des cliniques parce que l'alternative est un changement de système, et pendant que ce changement est envisagé, chaque nouveau patient remplit encore un formulaire à la main à l'accueil. L'interception qui fonctionne aujourd'hui ne supprime pas le presse-papiers. Elle rend le bloc de données démographiques vérifiable au moment où il est saisi, en utilisant l'extraction de données qui lit le dossier d'admission lui-même.
Le mécanisme est l'Extraction de colonnes personnalisées : dans ImageToTable.ai, vous saisissez les noms de colonnes souhaités dans la feuille de calcul de sortie, tels que « Prénom légal du patient », « Nom légal du patient », « Date de naissance » et « Identifiant membre de l'assurance », et l'IA localise chaque valeur en comprenant ce que signifie le libellé du champ, et non en correspondant à une position ou à un modèle fixe. C'est ce qui permet à un ensemble de colonnes de fonctionner avec des formulaires d'admission provenant de différentes cliniques, car le champ est trouvé par le sens plutôt que par les coordonnées. Le résultat est une ligne par patient où les données démographiques se trouvent dans des cellules distinctes qui peuvent être comparées au dossier du payeur avant qu'une réclamation ne soit constituée. Il s'agit de la même capacité décrite en détail sur la page du formulaire d'admission des patients, et c'est la partie qui place le nom du patient, sa date de naissance et son identifiant membre là où le personnel d'accueil peut réellement les voir.
L'écriture manuscrite est là où le niveau de modèle entre en jeu. ImageToTable.ai permet à un compte de fonctionner à un niveau de traitement, Standard, Avancé ou Premium, les niveaux supérieurs utilisant un modèle de vision plus puissant, adapté à l'écriture manuscrite dense et aux mises en page complexes. Pour les dossiers d'admission qui arrivent sous forme de scans remplis au crayon, de télécopies de troisième génération ou de formulaires avec des annotations manuscrites dans les marges, le niveau supérieur est le bon choix pour ce lot, et il vaut le coût supplémentaire précisément sur les lots où l'ambiguïté des caractères est le mode de défaillance. Le niveau est verrouillé lors de la soumission du lot, de sorte qu'un cabinet qui traite des formulaires numériques propres au niveau Standard et des scans manuscrits au niveau Premium facture chaque lot au niveau dont il avait réellement besoin.
La reconnaissance, même au niveau le plus fort, n'est pas une garantie, c'est pourquoi le deuxième réglage est une passe de vérification visant les colonnes d'identifiants. Le mode de révision avec vérification assistée par bbox vous permet de survoler n'importe quelle cellule extraite et de voir la région d'écriture manuscrite exacte sur l'image d'origine mise en surbrillance, ou de cliquer sur une région de l'image et de passer à sa cellule. Pour les formulaires d'admission, vous activeriez l'auto-annotation afin que les surlignages soient générés pour chaque fichier, et vous vérifieriez exactement trois colonnes : le nom légal, la date de naissance et l'identifiant membre de l'assurance. Ce sont les trois valeurs que le système du payeur compare, donc ce sont les seules trois qui nécessitent un œil humain avant que la réclamation ne soit construite sur elles. Une erreur de lecture dans la colonne des médicaments est un problème de dossier clinique ; une erreur de lecture dans la colonne de l'identifiant membre est une réclamation refusée. La propre réalité côté facturation de l'outil est que les données EOB se trouvent à l'autre extrémité de cette chaîne, saisies manuellement pendant des décennies, donc le côté admission n'est pas la seule étape manuelle de ce flux de travail, mais c'est celle qui détermine si la réclamation est payable du tout. Une fois les identifiants propres et l'EOB revenu, la tâche restante consiste à confirmer à quel dossier patient il appartient, ce qui est le flux de travail de rapprochement couvert dans la correspondance d'un EOB au bon patient.
Essayez l'extracteur sur votre propre formulaire d'admission avant toute configuration.
Ce que cela corrige, et ce qui nécessite encore un humain ou un payeur
Les limites honnêtes maintiennent ce flux de travail utilisable. La précision de l'extraction sur l'écriture manuscrite est élevée mais jamais de 100 pour cent, ce qui explique précisément pourquoi l'étape de vérification existe et pourquoi la décision humaine reste là où elle doit être. Deux patients portant le même nom légal et des années de naissance similaires nécessitent toujours qu'un registraire tranche quel dossier correspond à qui, car une ligne de feuille de calcul est une preuve pour cette décision, pas la décision elle-même. L'outil ne remplace pas non plus la vérification d'éligibilité : vérifier la couverture auprès d'une base de données de payeurs à l'arrivée, via la transaction d'éligibilité de votre clearinghouse, reste une étape distincte qui protège contre un mode de défaillance différent d'une erreur de transcription.
Deux limites importent pour les cabinets sensibles à la conformité. ImageToTable.ai ne s'intègre pas à Epic, athenahealth, ni à aucun DSE ; la sortie est une feuille de calcul que votre équipe importe, donc le mappage dans votre système reste votre flux de travail. Et le service n'est pas une solution de conformité HIPAA : il n'offre pas d'accord d'associé commercial, et les cabinets qui traitent des informations de santé protégées doivent confirmer que le service répond à leurs propres obligations et politiques avant de télécharger des formulaires identifiables de patients. La valeur ajoutée de ce flux de travail est un bloc de données démographiques vérifiable et une trace papier remontant à l'écriture exacte qui a produit chaque valeur, pas une couche de conformité.
Enfin, détecter l'erreur à la saisie n'automatise pas la moitié aval de la chaîne. Lorsque l'EOB revient, vérifier que les montants payés, la responsabilité du patient et les codes de refus correspondent à ce qui a été facturé est une charge de travail distincte avec ses propres modes de défaillance, c'est là qu'interviennent la précision de l'extraction EOB et le flux de travail complet d'extraction EOB. La correction à l'admission augmente la part des réclamations qui atteignent cette étape en premier lieu.
Questions fréquemment posées
L'IA peut-elle réellement lire une écriture manuscrite rapide sur les formulaires d'admission, ou ne gère-t-elle que les cases à cocher et le texte imprimé ?
La reconnaissance d'ImageToTable.ai couvre le texte imprimé, l'écriture manuscrite, la cursive, les cases à cocher et les signatures sur un document. Pour les dossiers d'admission denses en écriture manuscrite, l'exécution du lot au niveau de traitement supérieur donne des résultats nettement meilleurs sur les caractères ambigus comme 0/O et 1/l. La passe de révision bbox vous permet ensuite de confirmer les valeurs importantes, nom du patient, date de naissance et numéro d'adhérent, par rapport à l'écriture manuscrite d'origine avant qu'une réclamation ne soit construite sur celles-ci.
Cela mettra-t-il fin à tous les refus d'inscription de patients à lui seul ?
Non. Cela corrige la partie transcription : les données démographiques saisies à partir de formulaires manuscrits. Les lacunes d'éligibilité, les interruptions de couverture, les autorisations manquantes et les problèmes cliniques ou de codage refusent les réclamations par des mécanismes distincts, et la vérification d'éligibilité à l'enregistrement reste requise. La précision en amont est un levier largement cité, la moitié des organisations de l'enquête sur la gestion des refus d'Experian Health l'ont nommée comme une opportunité clé, mais ce n'est qu'un levier parmi plusieurs.
Le téléchargement de formulaires d'admission manuscrits signifie-t-il que des informations de santé protégées quittent mon cabinet ?
Cela peut être le cas, et cette décision vous appartient. ImageToTable.ai n'est pas une entité couverte par la HIPAA et ne propose pas d'accord d'associé commercial, les cabinets soumis à la HIPAA doivent donc évaluer le service par rapport à leurs propres exigences de conformité et politiques avant de télécharger des formulaires avec des identifiants de patients, ou travailler avec des documents dé-identifiés lorsque cela correspond au cas d'usage. La position de l'outil est qu'il ne revendique pas la conformité HIPAA ou BAA, et ce flux de travail doit être utilisé sous la forme que votre examen de conformité soutient.
Cela remplace-t-il la vérification d'éligibilité que mon clearinghouse effectue lors de l'inscription ?
Non, et cela ne devrait pas. La vérification d'éligibilité interroge la base de données de couverture du payeur à l'enregistrement et répond à une question différente, à savoir si le patient a une couverture active pour le service. L'extraction et la révision bbox répondent à une question différente, à savoir si les données démographiques saisies sont celles du formulaire. Vous exécutez toujours votre transaction d'éligibilité clearinghouse (via Availity, Waystar ou votre canal existant) à l'enregistrement ; ce flux de travail rend simplement le bloc de données démographiques qu'il reçoit plus fiable.
Lorsqu'une réclamation revient avec CO-16 ou CO-31, la réaction standard est de la traiter comme un problème de payeur et de riposter. La réaction bien moins coûteuse est d'examiner le bloc de données démographiques issu du formulaire manuscrit, car ce bloc est la version que le payeur a vérifiée, et il peut être rendu vérifiable dans les trente secondes après sa saisie plutôt que trois semaines plus tard. Testez l'extraction sur votre propre dossier d'admission et voyez si la colonne d'identifiant d'adhérent correspond à ce que votre payeur a en dossier, avant que le prochain nouveau patient n'en remplisse un.