Um Caractere Errado em um Formulário de Admissão Manuscrito
Pode se Tornar um Sinistro Negado Semanas Depois
A pesquisa State of Claims 2025 da Experian Health classifica dados de registro de pacientes incompletos ou incorretos como o terceiro gatilho mais comum de sinistros negados. O mecanismo por trás dessa classificação raramente recebe a atenção que merece: um funcionário da recepção gasta trinta segundos digitando o nome de um paciente a partir de um formulário de admissão manuscrito, ninguém confere, e algumas semanas depois o sinistro volta porque o nome no arquivo não corresponde aos registros da operadora. A pessoa que digitou não viu nada de errado. A pessoa que encontrou o problema não tem ideia de quem culpar.
Principais Conclusões
- Um 0 manuscrito lido como O é suficiente para enviar um sinistro de volta negado semanas depois.
- O funcionário que digitou não viu nada de errado, porque os dados demográficos só são comparados com os registros da operadora quando o sinistro chega à operadora.
- A solução não é uma recepção mais cuidadosa, é tornar os três campos que a operadora compara verificáveis nos segundos após serem digitados.
Toda Reivindicação Segue a Mesma Rota, e Uma Única Transferência Alimenta-a com os Números Errados
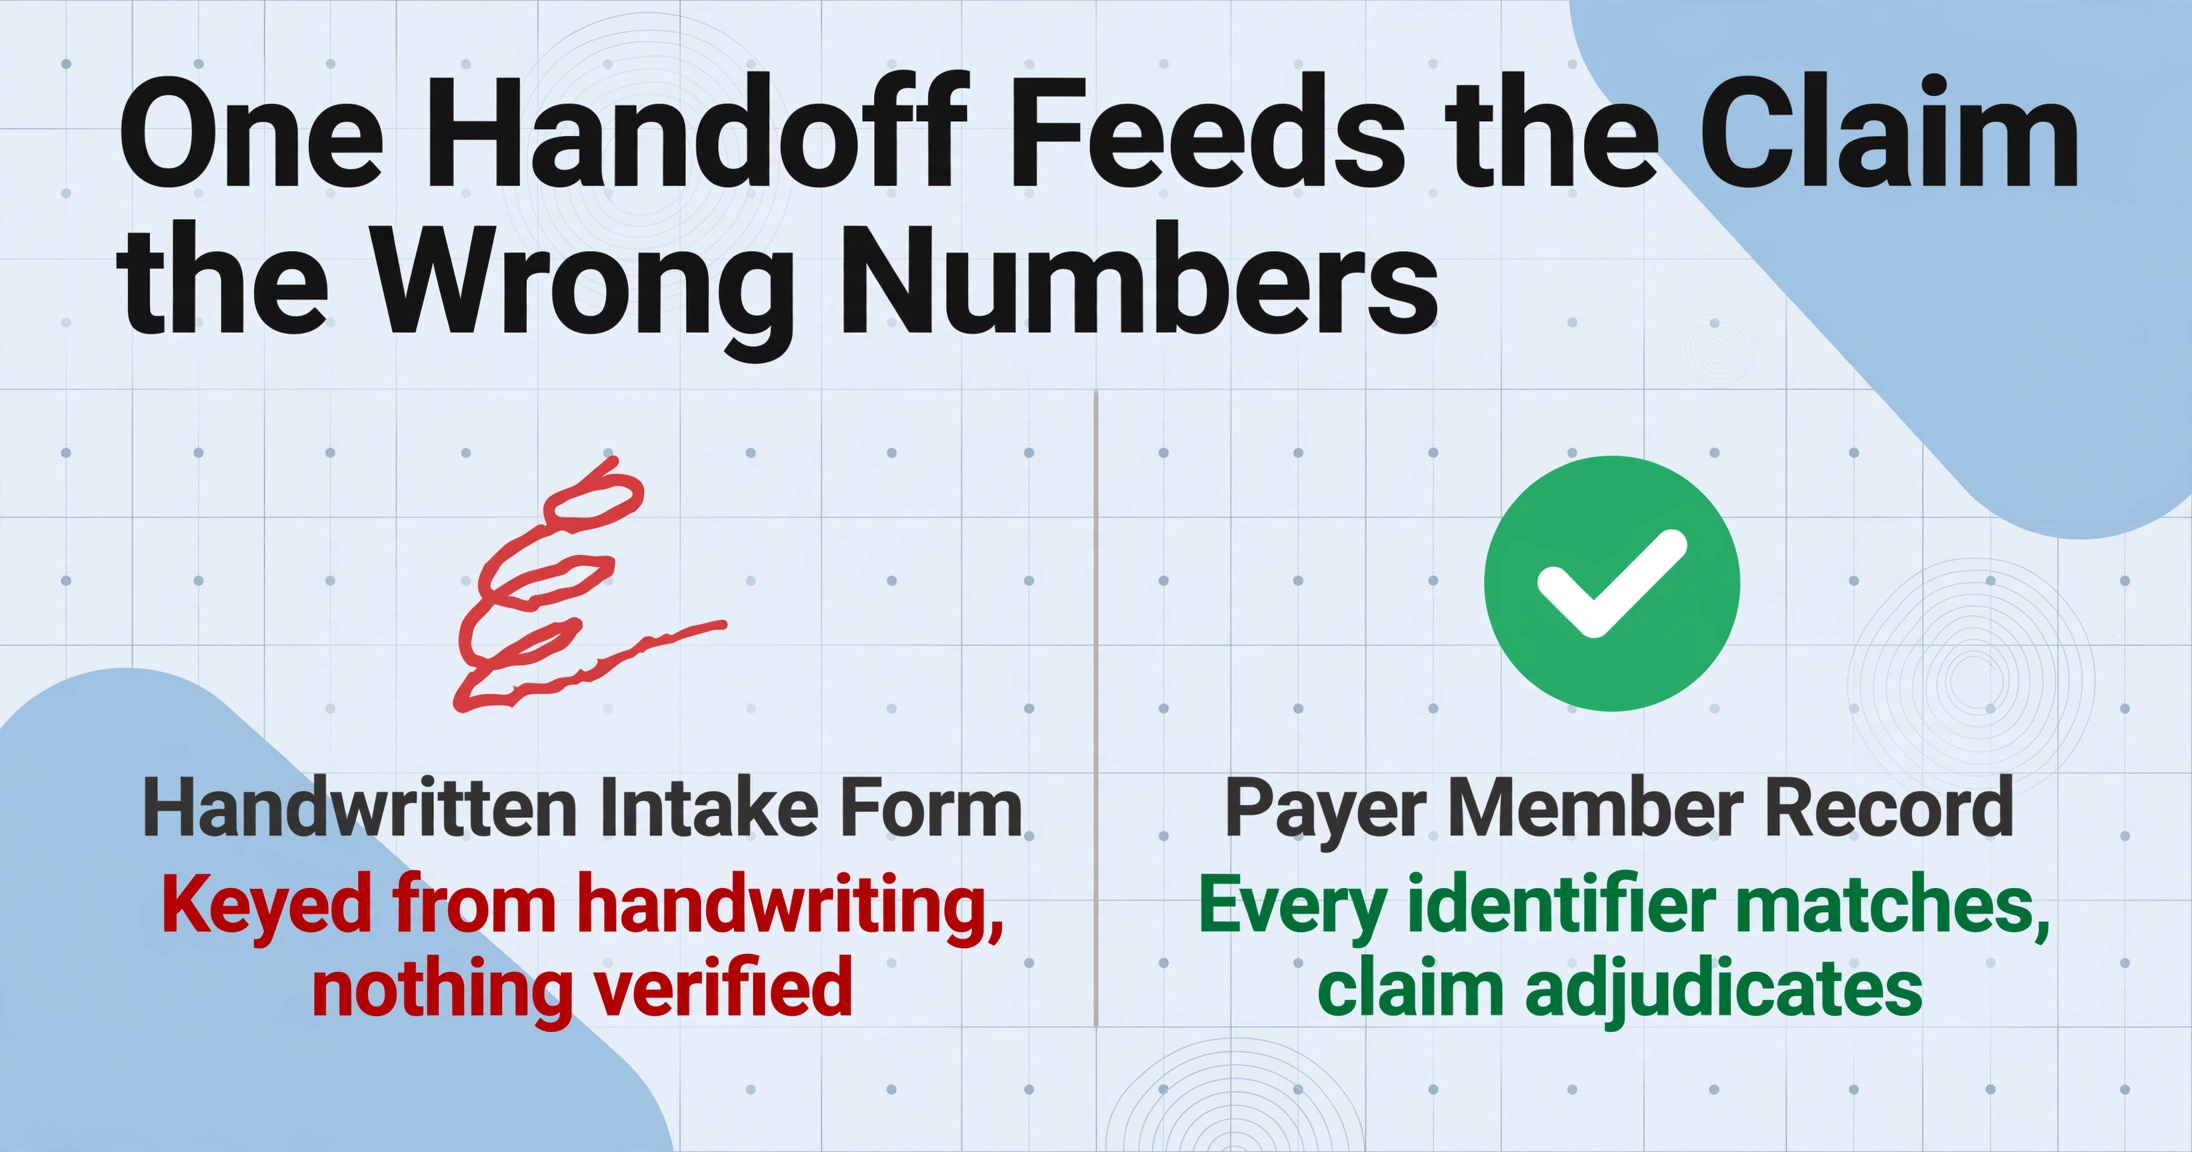
Uma reivindicação ambulatorial segue uma rota fixa com cinco participantes nomeados. O paciente preenche o formulário de admissão, muitas vezes à mão, dez minutos antes da consulta. A recepção digita os dados demográficos no prontuário eletrônico ou no sistema de gestão da prática, que na maioria das clínicas dos EUA significa Epic, athenahealth, Tebra's Kareo ou eClinicalWorks. O faturador ou codificador posteriormente monta a própria reivindicação, o formulário CMS-1500 para serviços profissionais ou o UB-04 para reivindicações de instalações, geralmente transmitido como um arquivo eletrônico 837. Uma clearinghouse, como Availity, Waystar ou Change Healthcare, verifica a completude básica da reivindicação e a encaminha ao pagador, cujo sistema de edição de reivindicações compara os dados demográficos na reivindicação com seus próprios registros de membros. Quando cada identificador corresponde, a reivindicação é adjudicada e um EOB (explicação de benefícios) retorna para lançamento. Quando um identificador não corresponde, a reivindicação volta rejeitada ou negada antes que qualquer humano no pagador a examine.
A transferência que decide a maioria desses resultados não é a codificação, que passa por verificações de construção antes do envio. É o bloco de dados demográficos, digitado a partir da caligrafia em um momento em que ninguém está verificando nada contra o registro de seguro do paciente. Uma pesquisa realizada sob o programa Pulse Survey da Healthcare Financial Management Association, cobrindo mais de 350 CFOs de hospitais e líderes de ciclo de receita, descobriu que erros no acesso e registro de pacientes eram o motivo mais comum para negações iniciais de reivindicações, com 47 por cento dos entrevistados relatando que as taxas de negação aumentaram ano após ano.
O passo que decide a maioria dos resultados é um bloco de dados demográficos digitado a partir da caligrafia em um momento em que ninguém o está verificando.
Os Erros Começam Abaixo do Nível da Palavra: 0/O, 1/l, 5/S e um Aniversário Transposto
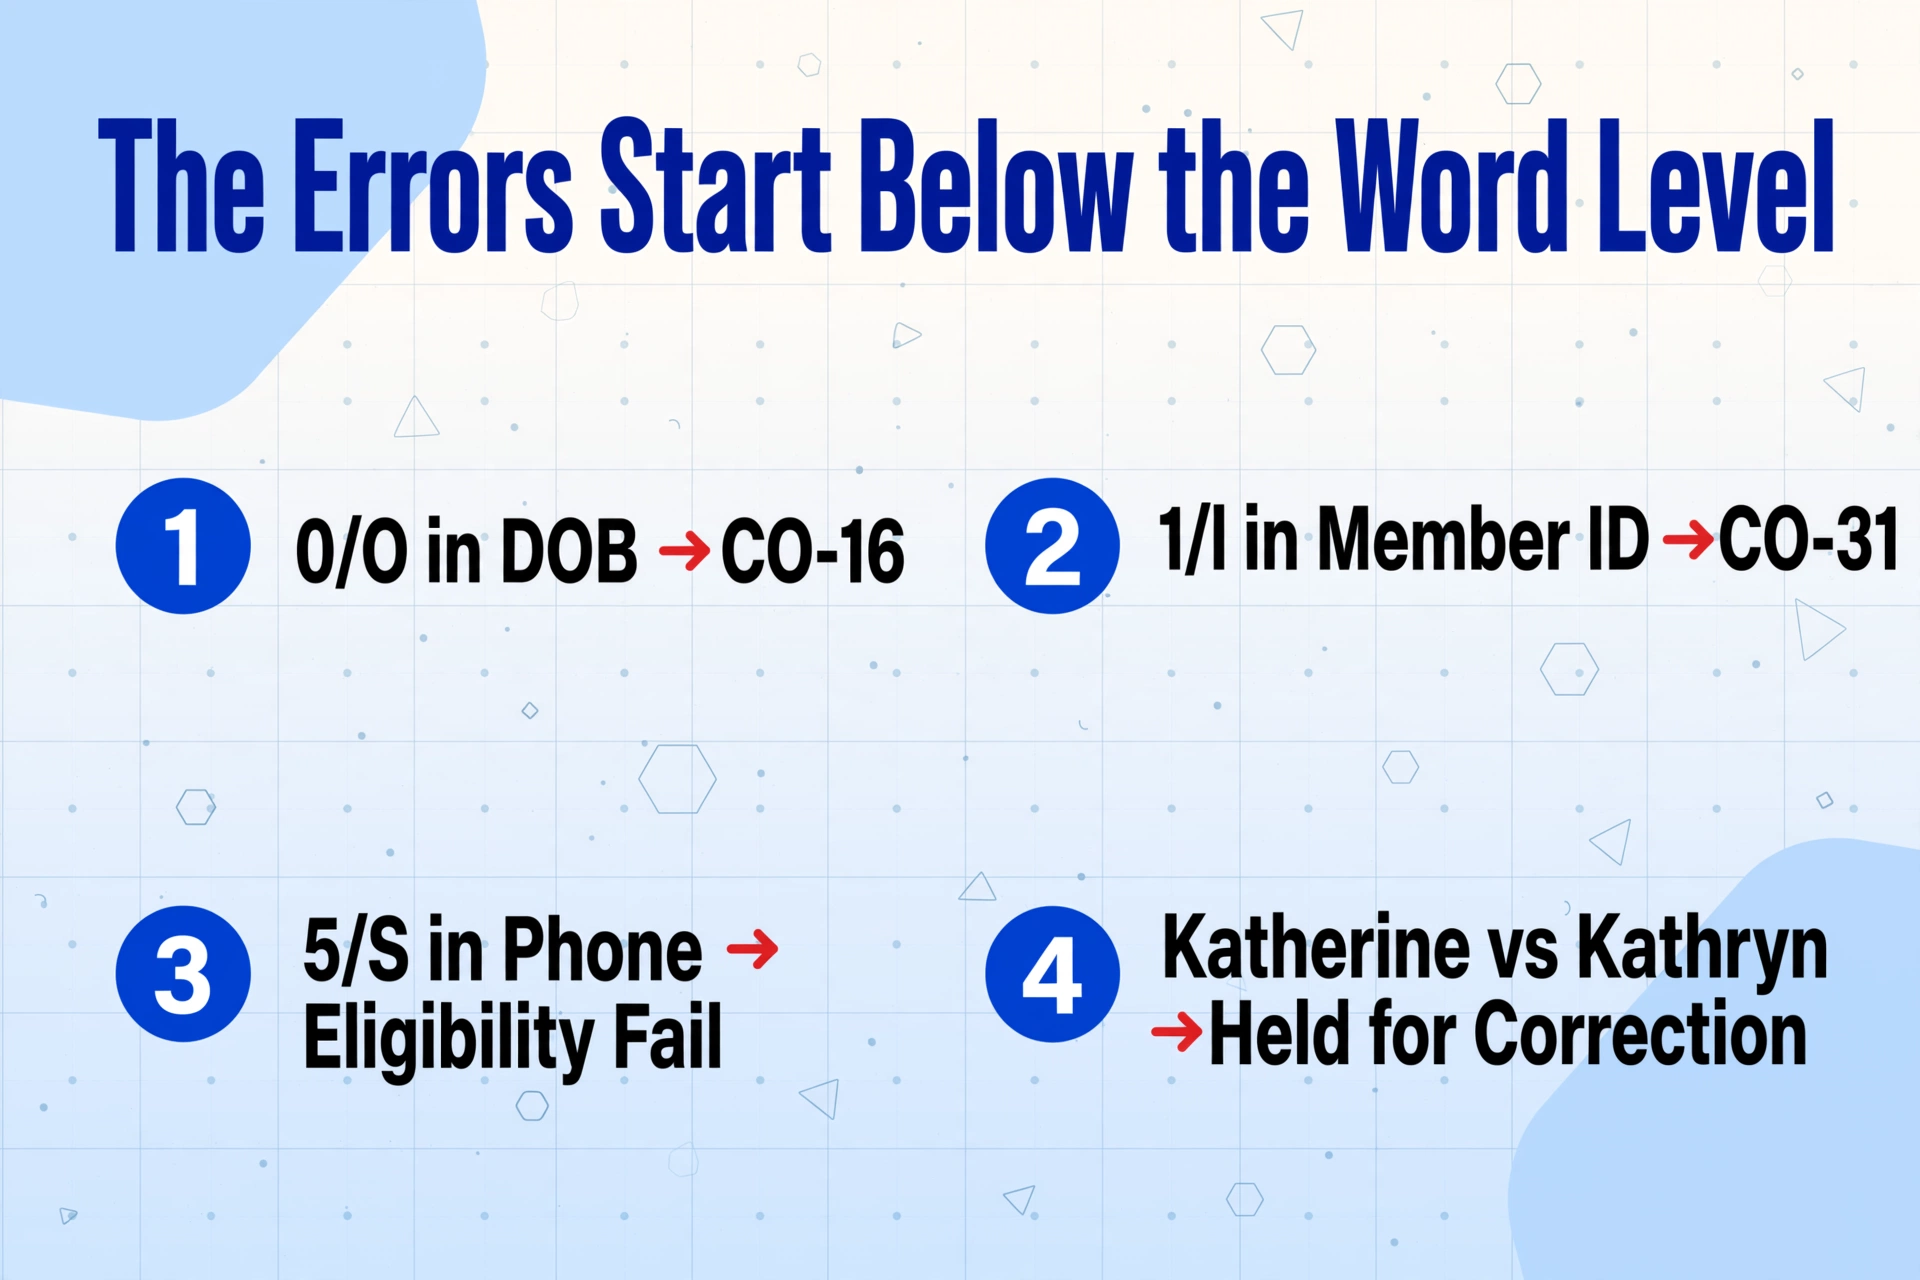
Erros de registro costumam ser descritos como "erros de digitação", o que os faz parecer aleatórios. Eles não são aleatórios. Eles seguem os modos específicos pelos quais a caligrafia ilegível é interpretada por um funcionário cansado que lê rapidamente. Cada modo de falha está ligado a um caractere, uma data ou uma sequência copiada:
| O que o paciente escreveu | O que é digitado | Onde isso incide |
|---|---|---|
| 0 em uma data de nascimento | O | Divergência na data de nascimento, rejeição CO-16 |
| 1 dentro de um ID de membro | l (L minúsculo) | Divergência no ID do assinante, CO-31 |
| 5 no início de um dígito de telefone | S | Divergência nos dados de contato, falha na verificação cruzada de elegibilidade |
| Katherine com um "th" claro | Kathryn | Divergência de nome, sinistro retido para correção |
| 03/12 (mês/dia) | 3/17 | Divergência na data de nascimento, busca do membro falha |
A razão pela qual os erros dos formulários de admissão sobrevivem por tanto tempo é que nada no consultório compara os dados demográficos digitados com o arquivo de membros da operadora no momento da entrada; essa comparação só acontece depois, dentro do sistema da própria operadora. As variações de grafia formam uma classe própria. Os arquivos de inscrição da operadora contêm a versão de um nome que o empregador ou a seguradora registrou, então a grafia correta para o sinistro é a que a operadora possui. Um paciente que escreve Katherine quando a apólice está em nome de Kathryn cria uma divergência sem que haja erro em nenhum formulário, e o atendente que digita o que o paciente escreveu não consegue ver o problema porque a transferência que importa acontece entre o banco de dados da operadora e o sinistro, não entre o formulário e o teclado.
As outras fontes de falha antecedem a digitação por completo. Cópias carbono e faxes de segunda geração transformam a caligrafia em traços cinzas com laços ausentes, então o leitor preenche as lacunas com base no contexto e adivinha errado. Um paciente que esqueceu o cartão do plano deixa a recepção copiando um ID de membro de memória, de um bilhete adesivo ou de um cartão de recompensas que não é o ID do seguro. O MBI do Medicare tem 11 caracteres e exclui deliberadamente as letras S, L, O, I, B e Z para reduzir confusão; ainda assim, um MBI manuscrito recebe substituições de B/8 e I/1 em uma cópia ruim. Nenhum desses casos exige um funcionário descuidado. Eles exigem um processo em que a pessoa que lê o papel não é a pessoa que pode verificá-lo contra os registros da operadora.
O que o Sistema do Pagador Faz com a Divergência: CO-16 e CO-31
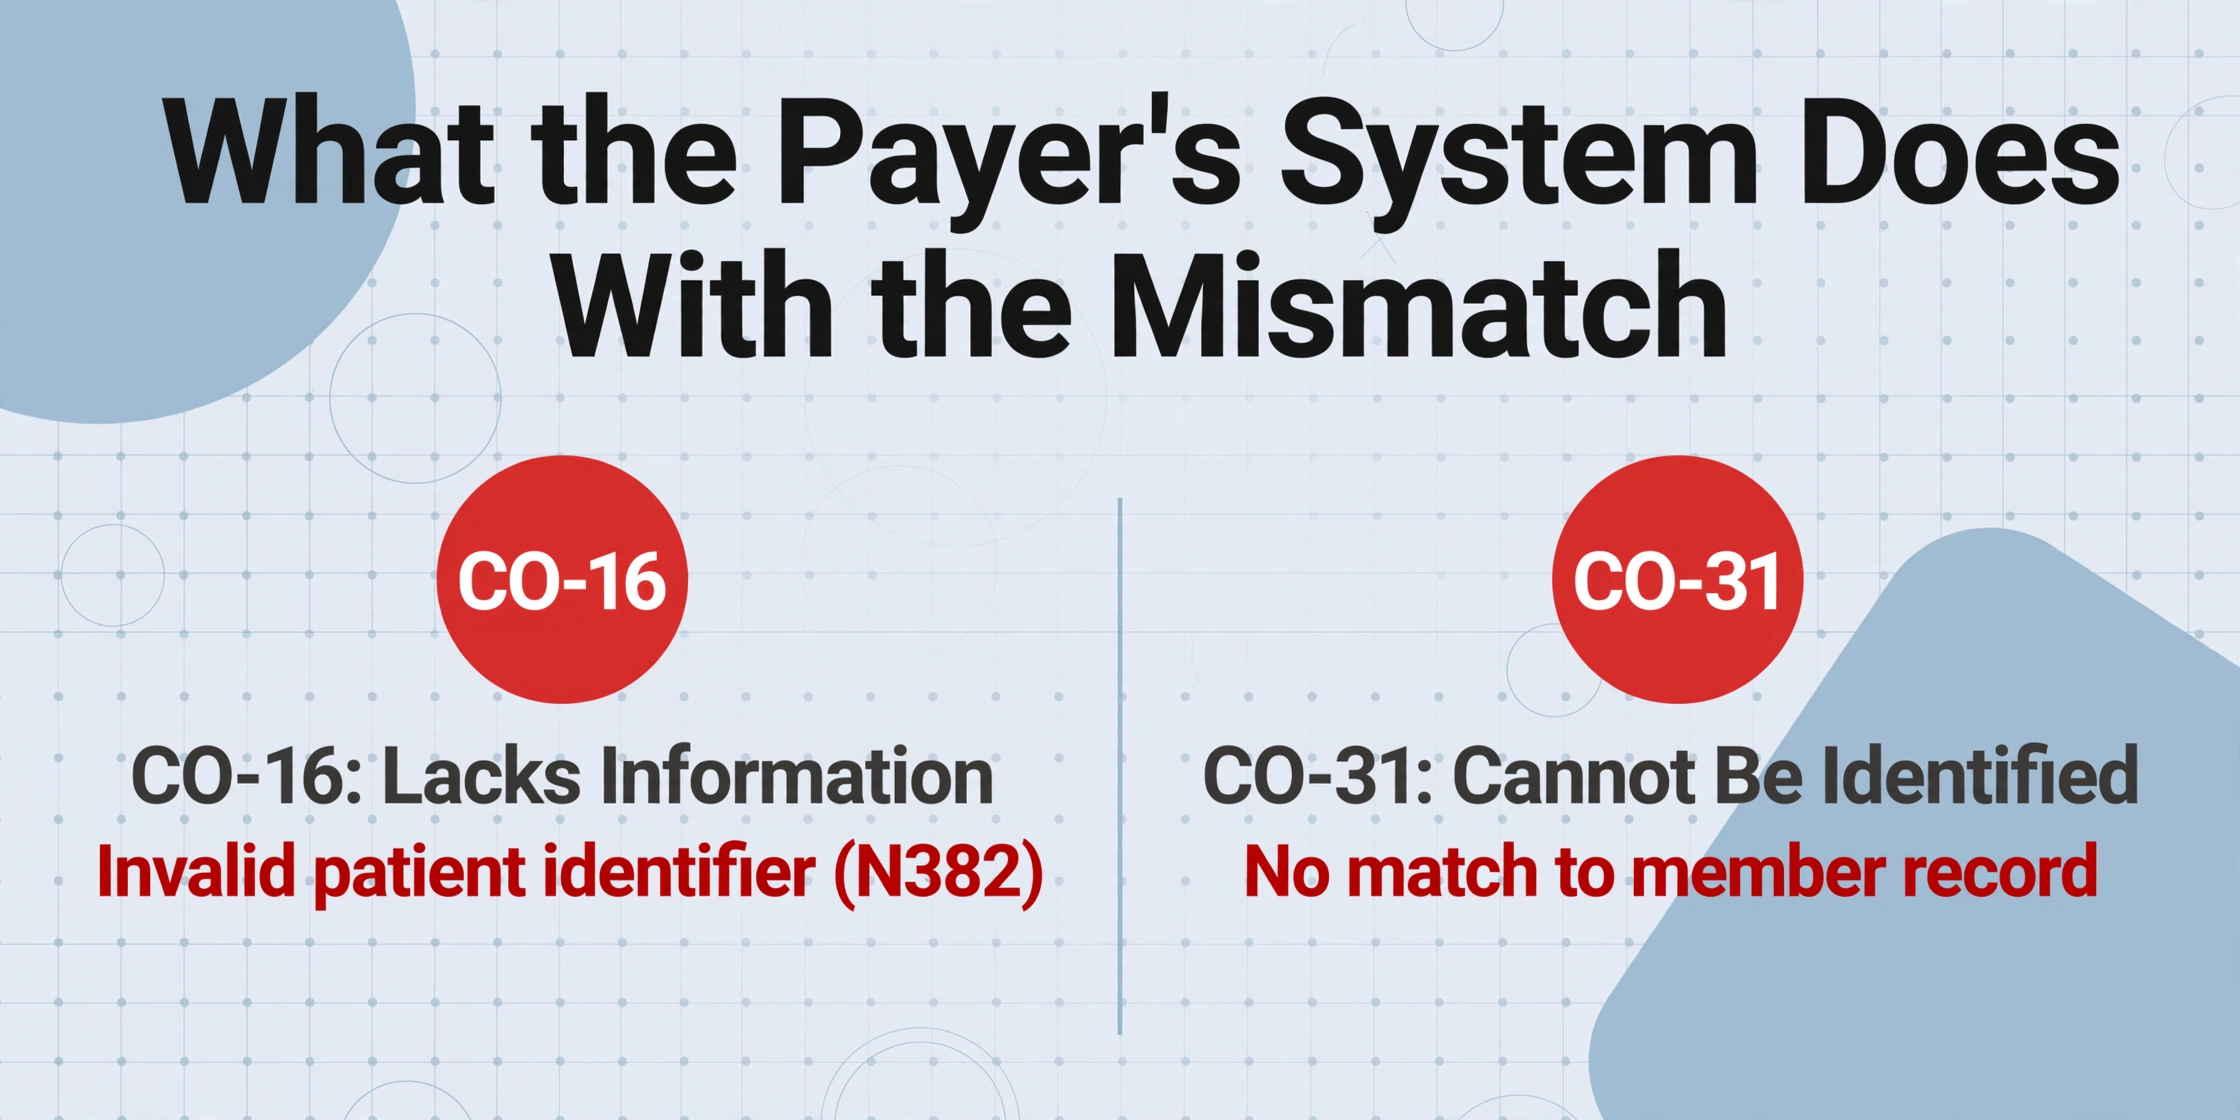
Os sistemas de edição de sinistros dos pagadores submetem cada sinistro a uma comparação automatizada de nome, data de nascimento e ID do membro com o banco de dados de inscrição. Uma única divergência de caractere aciona um código padrão de motivo de ajuste de sinistro da HIPAA, que é o texto fixo que retorna com o EOB ou o aviso eletrônico de remessa. Dois códigos cobrem a maioria dos casos que começam no registro. CO-16 significa "sinistro carece de informações ou foi enviado incompleto" e, quando acionado por uma divergência demográfica, normalmente é acompanhado do código de observação N382 para identificador de paciente inválido. CO-31 significa "paciente não pode ser identificado como nosso segurado", o código usado quando o identificador enviado não pode ser correspondido a nenhum registro de membro.
Ambos os códigos definem um caminho corretivo específico: um sinistro corrigido, não um recurso. O reenvio do sinistro corrigido é mais barato do que um recurso, mas consome o único recurso que não pode ser recuperado: a janela de arquivamento. O limite do Medicare é de 12 meses a partir da data do serviço; planos comerciais geralmente permitem de 90 a 180 dias. Cada ciclo de rejeição, pesquisa, correção e reenvio gasta de uma semana a um mês dessa janela, e cada ida e volta também realoca um membro da equipe que poderia estar trabalhando em um sinistro que paga. A American Health Information Management Association, cujos membros administram o lado de registro e prontuários desse processo, registrou os riscos mais amplos: erros de identificação de pacientes geralmente começam durante o processo de registro e podem iniciar uma cascata de erros e, pelos dados mais recentes disponíveis, aproximadamente 35% dos sinistros negados foram atribuídos à identificação incorreta de pacientes, custando ao hospital médio cerca de US$ 2,5 milhões anualmente e ao sistema de saúde dos EUA mais de US$ 6 bilhões. Os próprios profissionais do setor descobrem esse padrão da mesma forma que todos nós: tarde demais. Um paciente em um tópico do r/HealthInsurance descreveu como encontrou a mesma falha de cobrança em quatro prestadores diferentes: "A recepção não registrando o seguro corretamente, o prestador tentando codificar sozinho achando que está ajudando os pacientes, mas na verdade os prejudicando."
Uma única divergência de caractere no sinistro aciona uma negação automatizada antes que um humano no pagador veja o sinistro. A correção precisa acontecer antes do envio, ou custará uma janela de arquivamento.
Intercepte na Entrada: Duas Configurações Que Não Exigem Substituir Papel
A resposta usual a este problema é eliminar o papel com uma plataforma de admissão digital e, para muitos consultorios, essa é a medida correta a longo prazo. Mas a admissão em papel sobrevive na maioria das clínicas porque a alternativa é uma mudança de sistema e, enquanto essa mudança está sendo considerada, todo novo paciente ainda preenche um formulário à caneta no check-in. A interceptação que funciona hoje não remove a prancheta. Torna o bloco de dados demográficos verificável no momento em que é digitado, usando extração de dados que lê o próprio pacote de admissão.
O mecanismo é Extraction de Colunas Personalizadas: no ImageToTable.ai você digita os nomes das colunas que deseja na planilha de saída, como "Nome Legal do Paciente", "Sobrenome Legal do Paciente", "Data de Nascimento" e "ID de Membro do Seguro", e a IA localiza cada valor entendendo o que significa o rótulo do campo, não por correspondência de posição fixa ou modelo. É isso que permite que um conjunto de colunas funcione em formulários de admissão de diferentes clínicas, porque o campo é encontrado pelo significado, não por coordenadas. A saída é uma linha por paciente, onde os dados demográficos ficam em células discretas que podem ser comparadas com o registro do pagador antes de que uma reclamación seja construida. Esta é a mesma capacidade descrita em detalhe na página de formulário de admissão do paciente, e é a parte que coloca o nome do paciente, data de nascimento e ID de membro onde a recepção pode realmente vê-los.
A caligrafia é onde entra o Nível de Modelo. ImageToTable.ai permite que uma conta opere em um nível de processamento, Standard, Advanced ou Premium, com níveis superiores usando um modelo de visão mais forte, ajustado para caligrafia densa e layouts complexos. Para os pacotes de admissão que chegan como digitalizações preenchidas a lápiz, faxes de terceira generación ou formulários com notas manuscritas nas margens, o nível superior é a escolha certa para esse lote, e vale o custo extra precisamente nos lotes onde a ambigüedad de caracteres é o modo de falha. O nível é bloqueado quando o lote é enviado, portanto, uma prática que processa formulários digitais limpos em Standard e digitalizações manuscritas em Premium está faturando cada lote no nível que realmente necessitava.
O reconhecimento, mesmo no nível mais forte, não é uma garantía, por isso a segunda configuração é uma passada de verificação dirigida às colunas de identificador. Modo de Revisão com verificação assistida por bbox permite passar o cursor sobre qualquer célula extraída e ver a região exata de caligrafia na imagem original destacada, ou clicar em uma região da imagem e saltar à sua célula. Para formulários de admissão, você habilitaría auto-anotación para que os destaques sejam generados para cada arquivo, e verificaría exatamente três colunas: nome legal, data de nascimento e ID de membro do seguro. Esses são os três valores que o sistema do pagador compara, portanto, são os únicos três que precisam de um olho humano antes de que a reclamación seja construida sobre eles. Uma leitura incorreta na coluna de medicamentos é um problema de registros clínicos; uma leitura incorreta na coluna de ID de membro é uma reclamación negada. A realidade do lado de faturação da própria ferramenta é que os dados do EOB estão no outro extremo desta cadeia, digitados manualmente por décadas, portanto, o lado de admissão não é o único handoff manual neste fluxo de trabalho, mas é o que decide se a reclamación é pagável em absoluto. Uma vez que os identificadores estão limpos e o EOB retorna, o trabalho restante é confirmar a qual registro de paciente pertence, que é o fluxo de conciliación coberto em correspondência de um EOB de volta ao paciente correto.
Teste o extrator no seu próprio formulário de admissão antes de configurar qualquer coisa.
O que isso corrige e o que ainda exige um humano ou uma operadora
Os limites honestos mantêm este fluxo de trabalho utilizável. A precisão da extração em manuscritos é alta, mas nunca 100%, e é exatamente por isso que existe a etapa de verificação e que a decisão humana permanece onde deve estar. Dois pacientes com o mesmo nome legal e anos de nascimento semelhantes ainda precisam de um registrador para decidir qual registro é de quem, porque uma linha de planilha é evidência para essa decisão, não a decisão em si. A ferramenta também não substitui a verificação de elegibilidade: verificar a cobertura em um banco de dados da operadora no check-in, por meio da transação de elegibilidade do seu clearinghouse, continua sendo uma etapa separada que protege contra um modo de falha diferente do erro de transcrição.
Duas limitações importam para consultórios sensíveis a conformidade. O ImageToTable.ai não se integra ao Epic, athenahealth ou qualquer EHR; a saída é uma planilha que sua equipe importa, então o mapeamento para o seu sistema continua sendo seu fluxo de trabalho. E o serviço não é uma solução de conformidade com a HIPAA: ele não oferece um Contrato de Parceiro de Negócios, e consultórios que lidam com informações de saúde protegidas devem confirmar que o serviço atende às suas próprias obrigações e políticas antes de enviar formulários com identificação de pacientes. O valor que este fluxo de trabalho agrega é um bloco de dados demográficos verificável e uma trilha de auditoria de volta à caligrafia exata que produziu cada valor, não uma camada de conformidade.
Por fim, capturar o erro na entrada não automatiza a metade downstream da cadeia. Quando o EOB volta, verificar se os valores pagos, a responsabilidade do paciente e os códigos de negação estão alinhados com o que foi cobrado é uma carga de trabalho separada, com seus próprios modos de falha, e é aí que entram a precisão da extração de EOB e o fluxo completo de extração de EOB. A correção na admissão aumenta a parcela de sinistros que chegam a essa etapa em primeiro lugar.
Perguntas Frequentes
A IA realmente consegue ler letras ilegíveis em formulários de admissão, ou ela só processa caixas de seleção e texto impresso?
O reconhecimento do ImageToTable.ai cobre texto impresso, escrita à mão, cursiva, caixas de seleção e assinaturas em um documento. Para pacotes de admissão com muita escrita à mão, executar o lote no nível de processamento superior oferece resultados visivelmente melhores em caracteres ambíguos como 0/O e 1/l. A revisão de bbox permite então confirmar os valores que importam, nome do paciente, data de nascimento e ID do membro, comparando com a escrita original antes de uma reivindicação ser baseada neles.
Isso vai impedir todas as negativas de registro de pacientes por conta própria?
Não. Isso corrige a parte de transcrição: dados demográficos inseridos a partir de formulários manuscritos. Lacunas de elegibilidade, lapsos de cobertura, autorizações ausentes e problemas clínicos ou de codificação negam reivindicações por mecanismos separados, e a verificação de elegibilidade no check-in ainda é necessária. A precisão na linha de frente é uma alavanca amplamente citada; metade das organizações na pesquisa de gestão de negativas da Experian Health a nomeou como uma oportunidade-chave, mas é uma alavanca entre várias.
Enviar formulários de admissão manuscritos significa que informações de saúde protegidas saem do meu consultório?
Pode sair, e essa decisão é sua. O ImageToTable.ai não é uma entidade coberta pela HIPAA e não oferece um Contrato de Associado de Negócios (BAA), portanto consultórios sujeitos à HIPAA devem avaliar o serviço em relação aos seus próprios requisitos e políticas de conformidade antes de enviar formulários com identificadores de pacientes, ou trabalhar com documentos desidentificados quando isso se adequar ao caso de uso. A posição da própria ferramenta é que ela não declara conformidade com HIPAA ou BAA, e este fluxo de trabalho deve ser usado na forma que sua revisão de conformidade apoiar.
Isso substitui a verificação de elegibilidade que minha clearinghouse faz no registro?
Não, e não deveria. A verificação de elegibilidade consulta o banco de dados de cobertura do pagador no check-in e responde a uma pergunta diferente: se o paciente tem cobertura ativa para o serviço. A extração e a revisão de bbox respondem a outra pergunta: se os dados demográficos inseridos são os que estão no formulário. Você ainda executa sua transação de elegibilidade da clearinghouse (via Availity, Waystar ou seu canal existente) no check-in; este fluxo de trabalho apenas torna o bloco de dados demográficos que ela recebe mais confiável.
Quando uma reivindicação volta com CO-16 ou CO-31, a reação padrão é tratá-la como um problema do pagador e contestar. A reação muito mais barata é olhar o bloco de dados demográficos que saiu do formulário manuscrito, porque esse bloco é a versão que o pagador verificou, e ele pode ser tornado verificável nos trinta segundos após ser inserido, em vez de três semanas depois. Teste a extração no seu próprio pacote de admissão e veja se a coluna de ID do membro corresponde ao que seu pagador tem em arquivo, antes que o próximo paciente novo preencha um.