Ein falsches Zeichen auf einem handschriftlichen Aufnahmeformular
kann Wochen später zu einem abgelehnten Anspruch werden
Experian Healths State of Claims 2025-Umfrage stuft unvollständige oder falsche Patientendaten bei der Registrierung als dritthäufigsten Auslöser abgelehnter Ansprüche ein. Der Mechanismus hinter dieser Einstufung erhält selten die Aufmerksamkeit, die er verdient: Ein Empfangsmitarbeiter tippt dreißig Sekunden lang den Namen eines Patienten von einem handschriftlichen Aufnahmeformular ab, niemand überprüft es, und einige Wochen später kommt der Anspruch zurück, weil der Name in der Akte nicht mit den Aufzeichnungen des Zahlers übereinstimmt. Die Person, die ihn abgetippt hat, sah nichts Falsches. Die Person, die es entdeckt, hat keine Ahnung, wen sie beschuldigen soll.
Wichtigste Erkenntnisse
- Eine handschriftliche 0, die als O gelesen wird, genügt, um einen Anspruch Wochen später abgelehnt zurückzuschicken.
- Der Mitarbeiter, der sie abgetippt hat, sah nichts Falsches, weil die demografischen Daten erst mit den Aufzeichnungen des Zahlers verglichen werden, wenn der Anspruch den Zahler erreicht.
- Die Lösung ist kein vorsichtigerer Empfang, sondern die drei Felder, die der Zahler vergleicht, in den Sekunden nach der Erfassung überprüfbar zu machen.
Jeder Anspruch durchläuft denselben Weg – und eine Übergabe speist ihn mit den falschen Zahlen
Ein ambulanter Anspruch folgt einem festen Weg mit fünf benannten Beteiligten. Der Patient füllt das Aufnahmeformular aus, oft von Hand, zehn Minuten vor dem Termin. Die Rezeption tippt die demografischen Daten in das elektronische Gesundheitsdatensystem oder Praxisverwaltungssystem ein, was in den meisten US-Kliniken Epic, athenahealth, Tebra's Kareo oder eClinicalWorks bedeutet. Der Abrechner oder Kodierer stellt später den Anspruch selbst zusammen, das CMS-1500-Formular für ärztliche Leistungen oder das UB-04 für Einrichtungsansprüche, in der Regel als elektronische 837-Datei übermittelt. Eine Clearingstelle wie Availity, Waystar oder Change Healthcare prüft die grundlegende Vollständigkeit des Anspruchs und leitet ihn an den Zahler weiter, dessen Anspruchsprüfungssystem die demografischen Daten des Anspruchs mit seinen eigenen Mitgliedsdatensätzen vergleicht. Wenn alle Kennungen übereinstimmen, wird der Anspruch abgerechnet und eine EOB (Leistungserklärung) zur Buchung zurückgesendet. Wenn eine Kennung nicht übereinstimmt, wird der Anspruch abgelehnt oder verweigert zurückgesendet, bevor ein Mensch beim Zahler ihn überhaupt ansieht.
Die Übergabe, die über die meisten dieser Ergebnisse entscheidet, ist nicht die Kodierung, die vor der Einreichung Build-Prüfungen durchläuft. Es ist der Demografie-Block, der aus Handschrift in einem Moment abgetippt wird, in dem niemand etwas gegen die Versicherungsakte des Patienten prüft. Eine Umfrage im Rahmen des Pulse Survey-Programms der Healthcare Financial Management Association, die mehr als 350 Krankenhaus-CFOs und Führungskräfte im Erlöszyklus umfasste, ergab, dass Fehler bei Patientenzugang und -registrierung der häufigste Grund für anfängliche Anspruchsablehnungen waren, wobei 47 Prozent der Befragten berichteten, dass die Ablehnungsraten Jahr für Jahr stiegen.
Der Schritt, der über die meisten Ergebnisse entscheidet, ist ein Demografie-Block, der aus Handschrift in einem Moment abgetippt wird, in dem niemand ihn prüft.
Die Fehler beginnen unterhalb der Wortebene: 0/O, 1/l, 5/S und ein vertauschtes Geburtsdatum
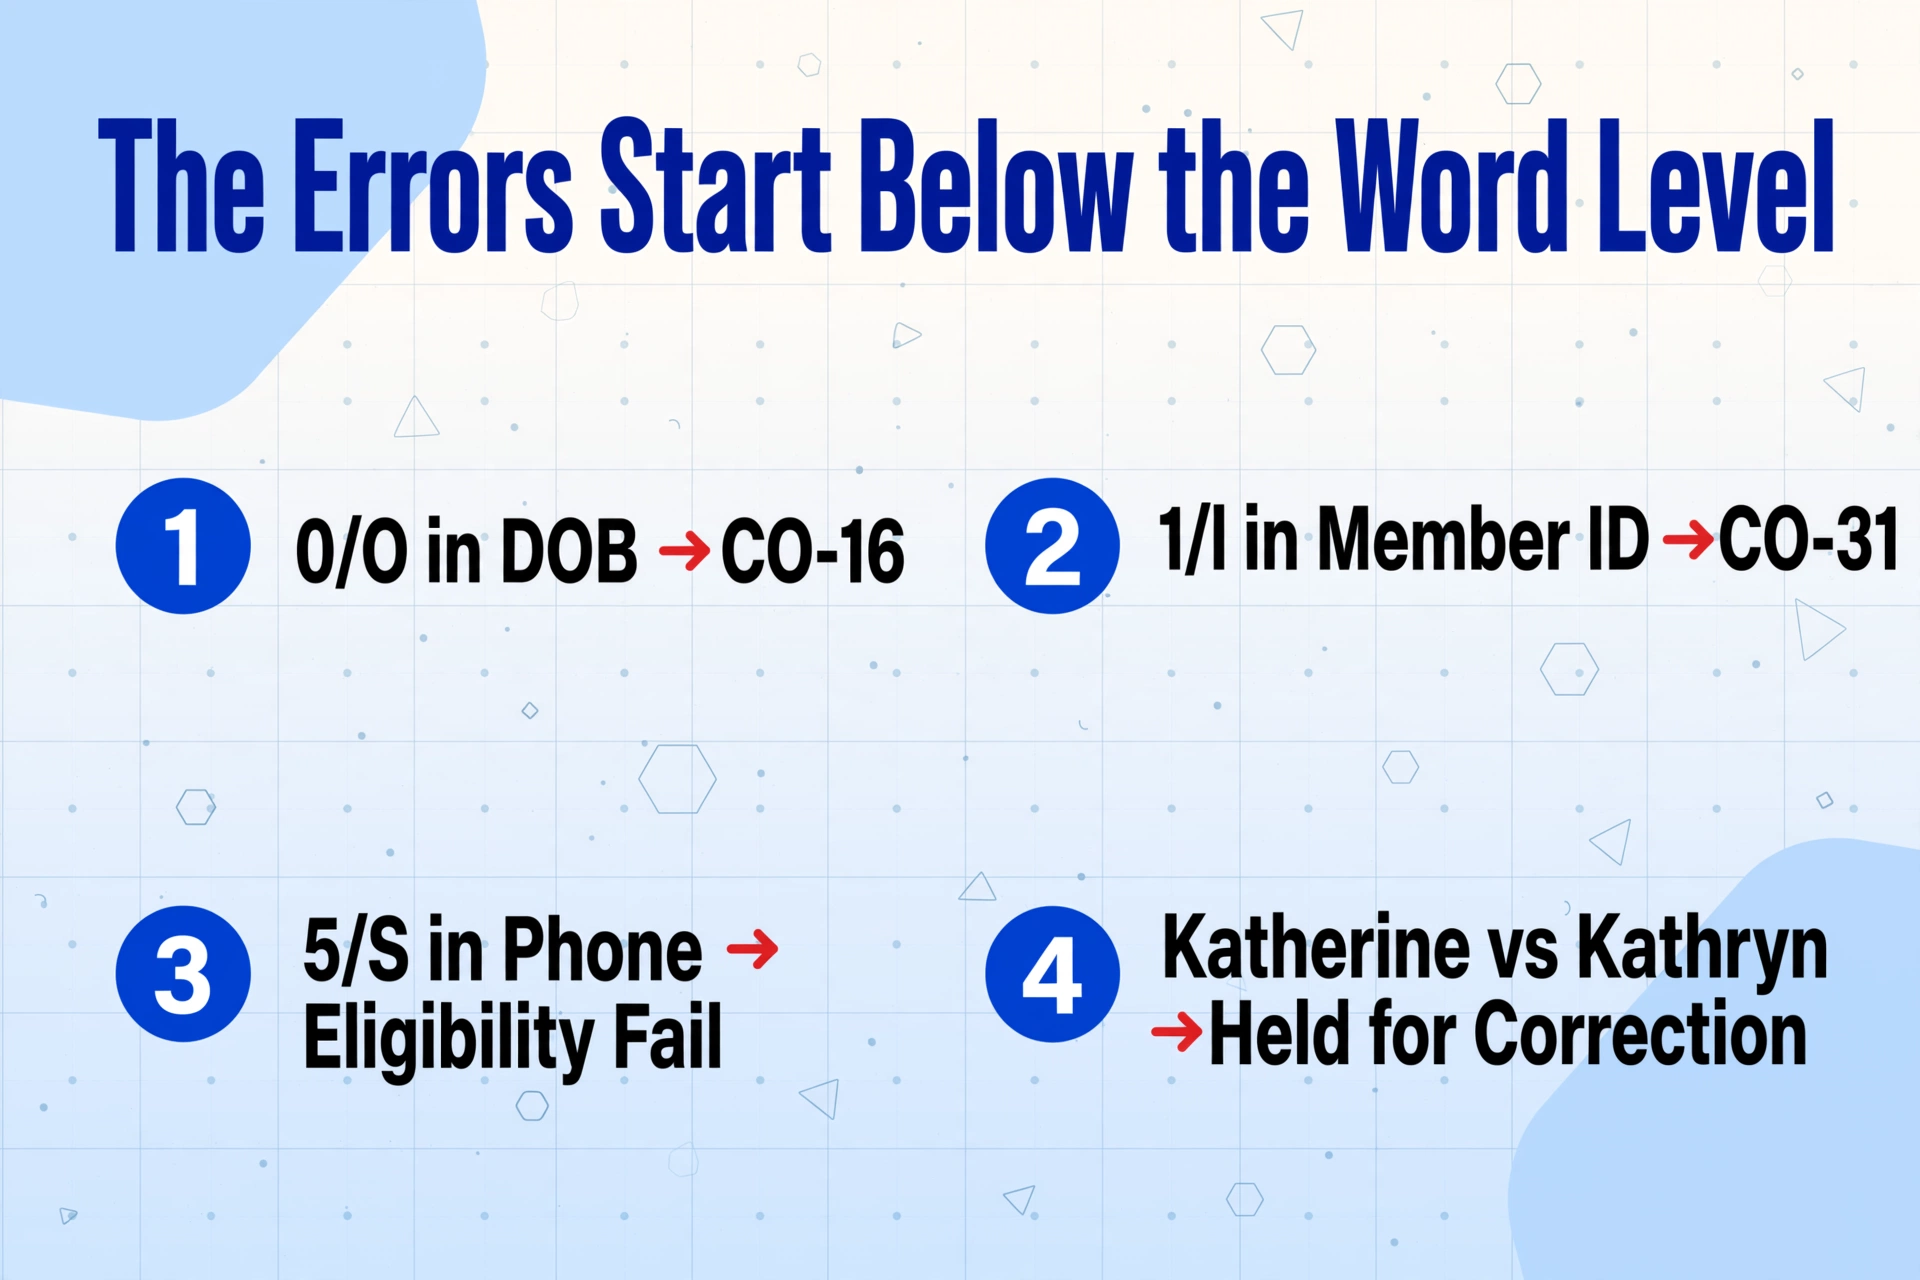
Registrierungsfehler werden meist als „Tippfehler" beschrieben, was sie zufällig erscheinen lässt. Das sind sie nicht. Sie folgen den spezifischen Wegen, auf denen unleserliche Handschrift von einem müden Mitarbeiter, der schnell liest, aufgelöst wird. Jede Fehlerart ist an ein Zeichen, ein Datum oder eine kopierte Zeichenfolge gebunden:
| Was der Patient schrieb | Was eingegeben wird | Wo es landet |
|---|---|---|
| 0 in einem Geburtsdatum | O | Geburtsdatum stimmt nicht überein, CO-16-Ablehnung |
| 1 in einer Mitglieds-ID | l (Kleinbuchstabe L) | Abonnenten-ID stimmt nicht überein, CO-31 |
| 5 am Anfang einer Telefonziffer | S | Kontaktdaten stimmen nicht überein, Berechtigungs-Cross-Check fehlgeschlagen |
| Katherine mit klarem „th" | Kathryn | Name stimmt nicht überein, Anspruch zur Korrektur zurückgehalten |
| 03/12 (Monat/Tag) | 3/17 | Geburtsdatum stimmt nicht überein, Mitgliedersuche schlägt fehl |
Der Grund, warum Aufnahmeformularfehler so lange überleben, ist, dass in der Praxis nichts die eingegebenen demografischen Daten mit der Mitgliederdatei des Zahlers zum Zeitpunkt der Eingabe vergleicht; dieser Vergleich findet erst später statt, im eigenen System des Zahlers. Schreibvarianten sind eine eigene Klasse für sich. Die Einschreibedateien des Zahlers enthalten die Version eines Namens, die der Arbeitgeber oder die Versicherung aufgezeichnet hat, sodass die korrekte Schreibweise für den Anspruch die ist, die der Zahler hat. Ein Patient, der Katherine schreibt, wenn die Police auf Kathryn läuft, erzeugt eine Diskrepanz ohne Fehler auf irgendeinem Formular, und der Angestellte, der eingibt, was der Patient schrieb, kann das Problem nicht sehen, weil die entscheidende Übergabe zwischen der Zahlerdatenbank und dem Anspruch stattfindet, nicht zwischen Formular und Tastatur.
Die anderen Fehlerquellen entstehen bereits vor der Eingabe. Durchschläge und Faxe der zweiten Generation verwandeln die Handschrift in graue Striche mit fehlenden Schleifen, sodass der Leser die Lücken aus dem Kontext füllt und falsch rät. Ein Patient, der seine Versicherungskarte vergessen hat, lässt die Rezeption eine Mitglieds-ID aus dem Gedächtnis, von einem Notizzettel oder von einer Prämienkarte kopieren, die nicht die Versicherungs-ID ist. Die MBI von Medicare besteht aus 11 Zeichen und schließt bewusst die Buchstaben S, L, O, I, B und Z aus, um Verwechslungen zu reduzieren, doch eine handschriftliche MBI erhält auf einer schlechten Kopie dennoch B/8- und I/1-Ersetzungen. Keiner dieser Fälle erfordert einen unachtsamen Mitarbeiter. Sie erfordern einen Prozess, bei dem die Person, die das Papier liest, nicht die Person ist, die es mit den Aufzeichnungen des Zahlers abgleichen kann.
Was das System des Zahlers mit der Abweichung macht: CO-16 und CO-31
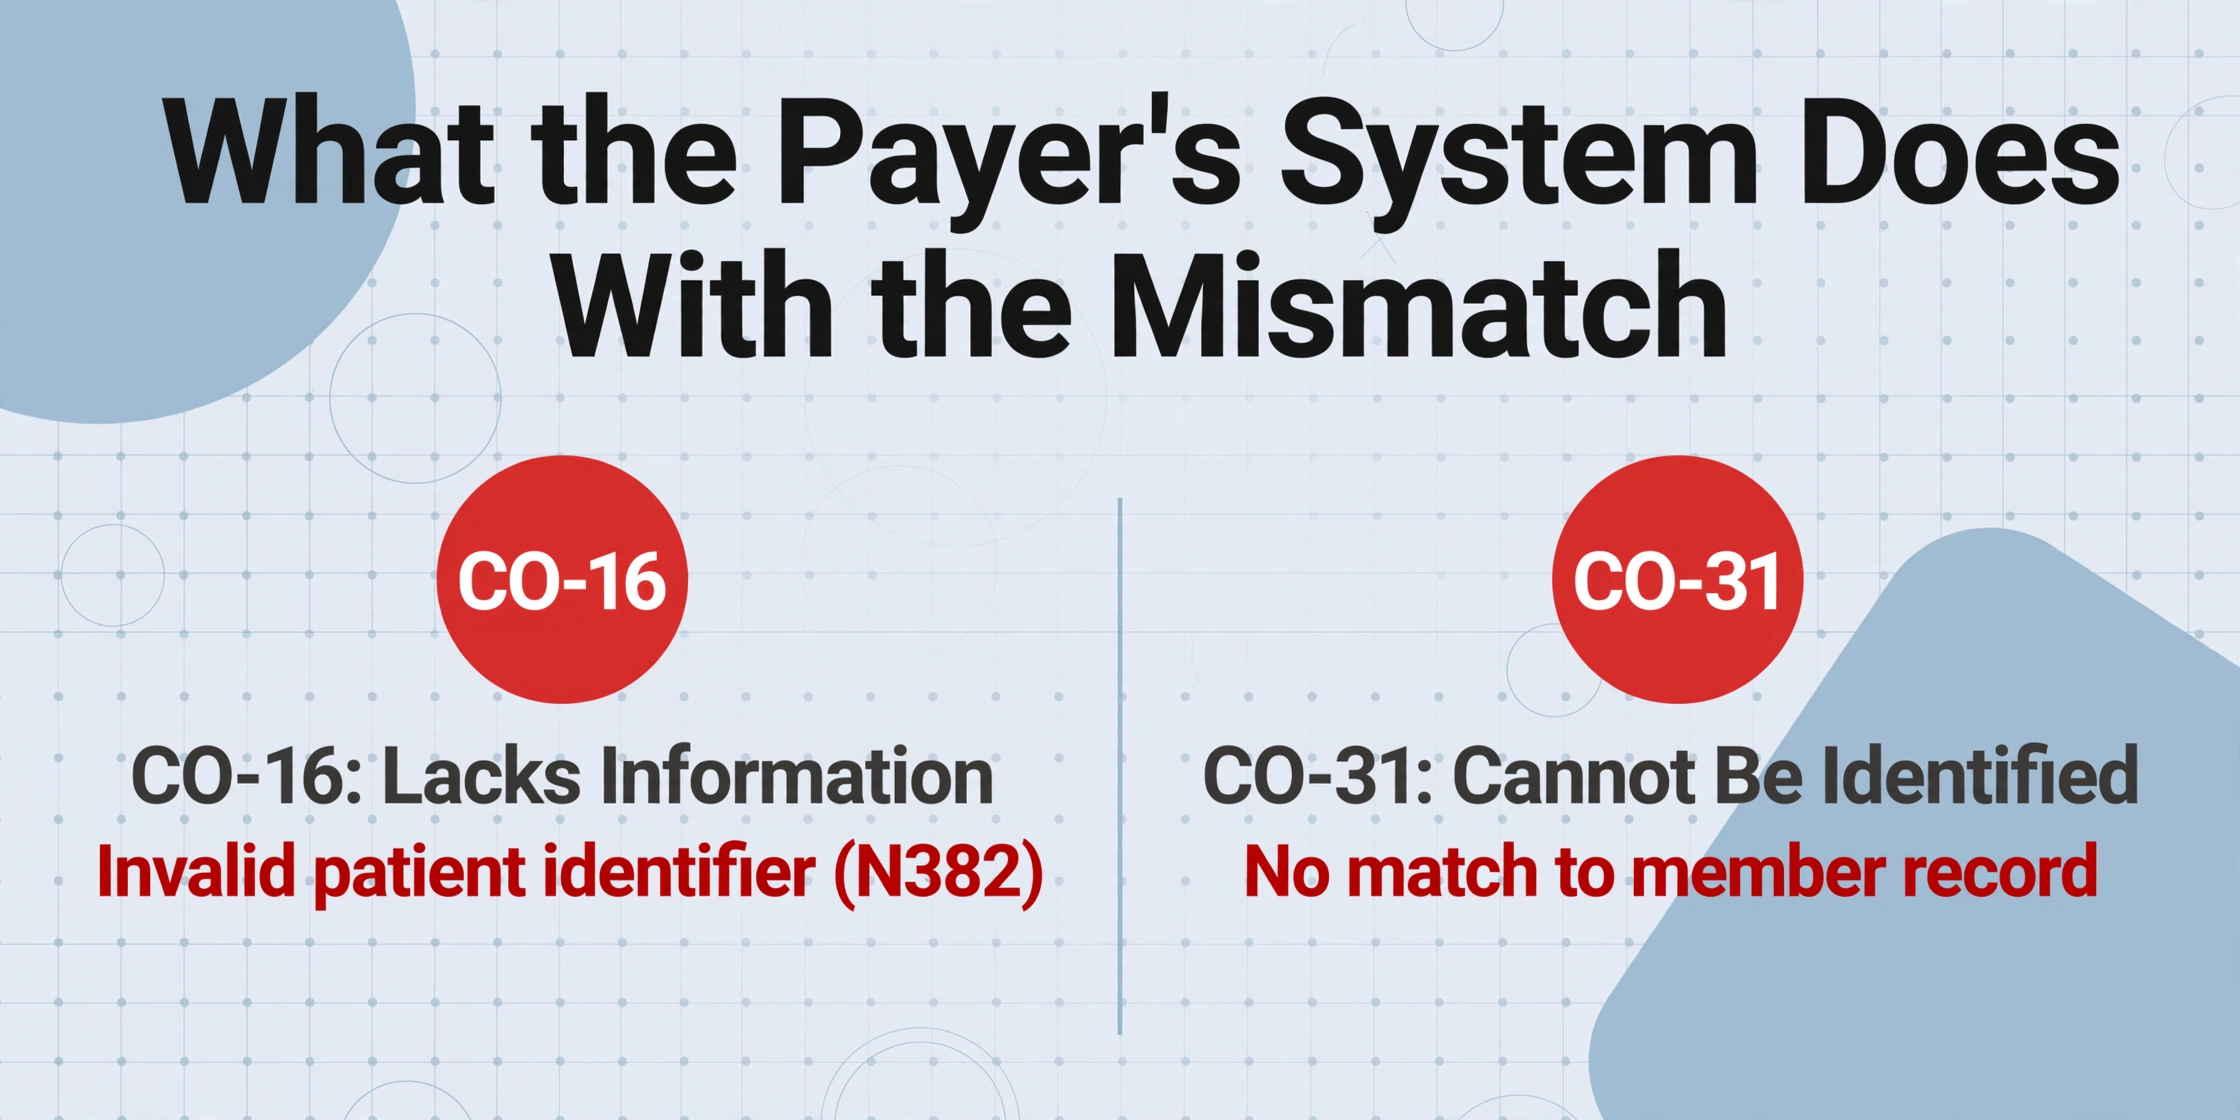
Die Bearbeitungssysteme der Zahler prüfen jeden eingereichten Anspruch automatisch anhand eines Abgleichs von Name, Geburtsdatum und Mitglieds-ID mit der Versichertendatenbank. Bereits eine einzelne abweichende Zeichenstelle löst einen standardisierten HIPAA-Ablehnungsbegründungscode aus – den festen Wortlaut, der mit der EOB oder dem elektronischen Zahlungshinweis zurückkommt. Zwei Codes decken die meisten Fälle ab, die bei der Erfassung beginnen. CO-16 bedeutet „dem Anspruch fehlen Informationen oder er wurde unvollständig eingereicht", und wenn er aufgrund einer demografischen Abweichung ausgelöst wird, ist er in der Regel mit dem Bemerkungscode N382 für eine ungültige Patienten-ID gekoppelt. CO-31 bedeutet „der Patient kann nicht als unser Versicherter identifiziert werden" – der Code, der verwendet wird, wenn die eingereichte ID keiner Mitgliederakte zugeordnet werden kann.
Beide Codes legen einen bestimmten Korrekturweg fest: einen korrigierten Anspruch, keinen Einspruch. Die erneute Einreichung eines korrigierten Anspruchs ist günstiger als ein Einspruch, verbraucht aber die eine Ressource, die nicht wiederhergestellt werden kann: das Einreichungsfenster. Die Frist von Medicare beträgt 12 Monate ab Leistungsdatum; kommerzielle Pläne erlauben üblicherweise 90 bis 180 Tage. Jeder Zyklus aus Ablehnung, Recherche, Korrektur und erneuter Einreichung kostet eine Woche bis einen Monat dieses Fensters, und jeder Durchlauf bindet zudem einen Mitarbeiter, der sonst an einem zahlenden Anspruch gearbeitet hätte. Die American Health Information Management Association, deren Mitglieder die Registrierungs- und Aktenseite dieses Prozesses verantworten, hat die größeren Auswirkungen festgehalten: Fehler bei der Patientenidentifikation entstehen oft während des Registrierungsprozesses und können eine Kaskade von Fehlern auslösen. Nach den aktuellsten verfügbaren Daten werden etwa 35 Prozent der abgelehnten Ansprüche auf eine ungenaue Patientenidentifikation zurückgeführt, was ein durchschnittliches Krankenhaus schätzungsweise 2,5 Millionen US-Dollar pro Jahr kostet und das US-Gesundheitssystem mehr als 6 Milliarden US-Dollar. Die Fachleute der Branche erkennen dieses Muster genauso wie alle anderen – nämlich erst, wenn es zu spät ist. Ein Patient in einem r/HealthInsurance-Thread beschrieb, wie er denselben Abrechnungsfehler bei vier verschiedenen Anbietern entdeckte: „Die Rezeption hat die Versicherung nicht richtig erfasst, der Anbieter versucht, selbst zu codieren, denkt, er hilft den Patienten, schadet ihnen aber tatsächlich."
Eine einzelne abweichende Zeichenstelle im Anspruch löst eine automatische Ablehnung aus, bevor ein Mensch beim Zahler den Anspruch überhaupt sieht. Die Korrektur muss vor der Einreichung erfolgen, sonst kostet sie ein Einreichungsfenster.
Schon beim Eingang abfangen: Zwei Einstellungen, die keinen Papierersatz erfordern
Die übliche Antwort auf dieses Problem ist, Papier durch eine digitale Aufnahmeplattform zu ersetzen – für viele Praxen ist das langfristig der richtige Schritt. Aber die Papieraufnahme überlebt in den meisten Kliniken, weil die Alternative ein Systemwechsel ist, und während über diesen Wechsel nachgedacht wird, füllt jeder neue Patient beim Check-in immer noch ein Formular von Hand aus. Der Abfangmechanismus, der heute funktioniert, entfernt das Klemmbrett nicht. Er macht den Demografie-Block in dem Moment verifizierbar, in dem er eingegeben wird, mithilfe von Datenextraktion, die das Aufnahmepaket selbst liest.
Der Mechanismus ist Benutzerdefinierte Spaltenextraktion: In ImageToTable.ai geben Sie die gewünschten Spaltennamen für die Ausgabetabelle ein, etwa „Patient Legal First Name", „Patient Legal Last Name", „Date of Birth" und „Insurance Member ID", und die KI findet jeden Wert, indem sie versteht, was das Feldlabel bedeutet – nicht durch Abgleich einer festen Position oder Vorlage. Genau das ermöglicht es, dass ein Satz Spalten über Aufnahmeformulare verschiedener Kliniken hinweg funktioniert, weil das Feld über die Bedeutung statt über Koordinaten gefunden wird. Die Ausgabe ist eine Zeile pro Patient, in der die Demografiedaten in einzelnen Zellen liegen, die vor der Erstellung eines Anspruchs mit dem Zahlergrundbuch verglichen werden können. Dies ist dieselbe Fähigkeit, die auf der Patientenaufnahmefomular-Seite detailliert beschrieben wird, und es ist der Teil, der den Namen, das Geburtsdatum und die Mitglieds-ID des Patienten an eine Stelle bringt, wo die Rezeption sie tatsächlich sehen kann.
Bei Handschrift kommt die Modellstufe ins Spiel. ImageToTable.ai erlaubt es einem Konto, auf einer Verarbeitungsstufe zu laufen – Standard, Advanced oder Premium – wobei höhere Stufen ein stärkeres Vision-Modell nutzen, das auf dichte Handschrift und komplexe Layouts abgestimmt ist. Für Aufnahmepakete, die als bleistiftausgefüllte Scans, Faxe der dritten Generation oder Formulare mit handschriftlichen Randnotizen eintreffen, ist die höhere Stufe die richtige Wahl für diesen Batch, und sie ist die zusätzlichen Kosten genau bei den Batches wert, bei denen Zeichenmehrdeutigkeit die Fehlerquelle ist. Die Stufe wird beim Absenden des Batches festgelegt, sodass eine Praxis, die saubere digitale Formulare auf Standard und handschriftliche Scans auf Premium verarbeitet, jeden Batch mit der Stufe abrechnet, die er tatsächlich benötigt hat.
Erkennung – selbst auf der stärksten Stufe – ist keine Garantie, weshalb die zweite Einstellung ein Verifizierungsdurchlauf ist, der auf die Kennungsspalten abzielt. Prüfmodus mit bbox-gestützter Verifizierung ermöglicht es Ihnen, über jede extrahierte Zelle zu fahren und die exakte Handschriftregion im Originalbild hervorgehoben zu sehen, oder auf eine Region im Bild zu klicken und zu ihrer Zelle zu springen. Für Aufnahmeformulare würden Sie Auto-annotate aktivieren, damit die Hervorhebungen für jede Datei generiert werden, und genau drei Spalten stichprobenartig prüfen: legaler Name, Geburtsdatum und Versicherungs-Mitglieds-ID. Das sind die drei Werte, die das Zahler-System vergleicht, also die einzigen drei, die vor der Erstellung des Anspruchs ein menschliches Auge brauchen. Eine Fehllesung in der Medikamentenspalte ist ein klinisches Aufzeichnungsproblem; eine Fehllesung in der Mitglieds-ID-Spalte ist ein abgelehnter Anspruch. Die eigene abrechnungsseitige Realität des Tools ist, dass die EOB-Daten am anderen Ende dieser Kette liegen, jahrzehntelang manuell erfasst – die Aufnahmeseite ist also nicht die einzige manuelle Übergabe in diesem Workflow, aber sie entscheidet, ob der Anspruch überhaupt zahlbar ist. Sobald die Kennungen sauber sind und die EOB zurückkommt, besteht die verbleibende Aufgabe darin, zu bestätigen, zu welchem Patientendatensatz sie gehört – das ist der Abgleich-Workflow, der unter Zuordnung einer EOB zum richtigen Patienten behandelt wird.
Testen Sie den Extraktor mit Ihrem eigenen Aufnahmeformular, bevor Sie etwas einrichten.
Was dieses Tool behebt – und was weiterhin einen Menschen oder einen Kostenträger benötigt
Die ehrlichen Grenzen halten diesen Workflow nutzbar. Die Extraktionsgenauigkeit bei Handschrift ist hoch, aber nie 100 Prozent – genau deshalb gibt es den Prüfschritt und genau deshalb bleibt die menschliche Entscheidung dort, wo sie hingehört. Zwei Patienten mit demselben gesetzlichen Namen und ähnlichen Geburtsjahren benötigen weiterhin einen Registrar, der entscheidet, welcher Datensatz zu welcher Person gehört, denn eine Tabellenzeile ist ein Beleg für diese Entscheidung, nicht die Entscheidung selbst. Das Tool ersetzt auch keine Anspruchsprüfung: Die Überprüfung des Versicherungsschutzes gegen eine Kostenträgerdatenbank beim Check-in über die Anspruchsprüfungstransaktion Ihres Clearinghouses bleibt ein separater Schritt, der vor einem anderen Fehlermodus schützt als ein Übertragungsfehler.
Zwei Einschränkungen sind für compliance-sensible Praxen relevant. ImageToTable.ai integriert sich nicht in Epic, athenahealth oder ein anderes EHR; die Ausgabe ist eine Tabelle, die Ihr Team importiert, sodass die Zuordnung in Ihr System Ihr Workflow bleibt. Und der Dienst ist keine HIPAA-Compliance-Lösung: Er bietet keine Business Associate Agreement an, und Praxen, die geschützte Gesundheitsinformationen verarbeiten, sollten bestätigen, dass der Dienst ihre eigenen Verpflichtungen und Richtlinien erfüllt, bevor sie patientenidentifizierbare Formulare hochladen. Der Mehrwert dieses Workflows ist ein prüfbarer Demografieblock und eine Papierspur zurück zur exakten Handschrift, die jeden Wert erzeugt hat – keine Compliance-Ebene.
Schließlich automatisiert das Erkennen des Fehlers bei der Erfassung nicht die nachgelagerte Hälfte der Kette. Wenn die EOB zurückkommt, ist die Überprüfung, ob die gezahlten Beträge, die Eigenanteile des Patienten und die Ablehnungscodes mit dem übereinstimmen, was abgerechnet wurde, ein separater Arbeitsaufwand mit eigenen Fehlermodi – hier kommen EOB-Extraktionsgenauigkeit und der vollständige EOB-Extraktionsworkflow ins Spiel. Die Aufnahmekorrektur erhöht den Anteil der Ansprüche, die diesen Schritt überhaupt erst erreichen.
Häufig gestellte Fragen
Kann die KI tatsächlich hastig geschriebene Handschrift auf Aufnahmeformularen lesen, oder verarbeitet sie nur Kontrollkästchen und gedruckten Text?
Die Erkennung von ImageToTable.ai umfasst gedruckten Text, Handschrift, Schreibschrift, Kontrollkästchen und Unterschriften in einem Dokument. Bei handschriftlich dichten Aufnahmepaketen liefert die Ausführung des Batches auf der höheren Verarbeitungsstufe deutlich bessere Ergebnisse bei mehrdeutigen Zeichen wie 0/O und 1/l. Der Bbox-Überprüfungsdurchlauf ermöglicht es Ihnen dann, die relevanten Werte – Patientenname, Geburtsdatum und Mitglieds-ID – anhand der ursprünglichen Handschrift zu bestätigen, bevor ein Anspruch darauf aufgebaut wird.
Wird dies von selbst alle Ablehnungen von Patientenregistrierungen stoppen?
Nein. Es behebt den Transkriptionsteil: demografische Daten, die aus handschriftlichen Formularen erfasst werden. Berechtigungslücken, Versicherungsunterbrechungen, fehlende Genehmigungen sowie klinische oder Kodierungsprobleme führen über separate Mechanismen zu Anspruchsablehnungen, und die Berechtigungsprüfung beim Check-in ist weiterhin erforderlich. Die Genauigkeit im Frontend ist ein häufig genannter Hebel – die Hälfte der Organisationen in der Umfrage zum Ablehnungsmanagement von Experian Health nannte sie als zentrale Chance –, aber sie ist nur einer von mehreren Hebeln.
Bedeutet das Hochladen handschriftlicher Aufnahmeformulare, dass geschützte Gesundheitsinformationen meine Praxis verlassen?
Das kann es, und diese Entscheidung liegt bei Ihnen. ImageToTable.ai ist keine HIPAA-unterliegende Einrichtung und bietet keine Geschäftspartnervereinbarung (BAA) an. Praxen, die HIPAA unterliegen, sollten den Dienst daher im Hinblick auf ihre eigenen Compliance-Anforderungen und Richtlinien bewerten, bevor sie Formulare mit Patientenidentifikatoren hochladen, oder mit de-identifizierten Dokumenten arbeiten, wo dies für den Anwendungsfall passt. Das Tool selbst vertritt die Position, dass es keine HIPAA- oder BAA-Konformität beansprucht, und dieser Workflow sollte in der Form verwendet werden, die Ihre Compliance-Prüfung unterstützt.
Ersetzt dies die Berechtigungsprüfung, die Ihre Clearingstelle bei der Registrierung durchführt?
Nein, und das sollte es auch nicht. Die Berechtigungsprüfung fragt die Deckungsdatenbank des Zahlers beim Check-in ab und beantwortet eine andere Frage: ob der Patient eine aktive Deckung für die Leistung hat. Extraktion und Bbox-Überprüfung beantworten eine andere Frage: ob die erfassten demografischen Daten die auf dem Formular sind. Sie führen Ihre Clearingstellen-Berechtigungstransaktion (über Availity, Waystar oder Ihren bestehenden Kanal) weiterhin beim Check-in durch; dieser Workflow macht lediglich den demografischen Block, den sie erhält, zuverlässiger.
Wenn ein Anspruch mit CO-16 oder CO-31 zurückkommt, ist die übliche Reaktion, ihn als Problem des Zahlers zu behandeln und Widerstand zu leisten. Die weitaus günstigere Reaktion ist, den demografischen Block zu betrachten, der vom handschriftlichen Formular stammt, denn dieser Block ist die Version, die der Zahlers geprüft hat, und er kann in den dreißig Sekunden nach der Erfassung überprüfbar gemacht werden, statt drei Wochen später. Testen Sie die Extraktion an Ihrem eigenen Aufnahmepaket und prüfen Sie, ob die Mitglieds-ID-Spalte mit dem übereinstimmt, was Ihr Zahler in den Akten hat, bevor der nächste neue Patient eines ausfüllt.