各EOBを正しい患者記録に照合する
誤ったアカウントに計上される前に
AHIMAジャーナルによると、拒否された請求の35%は患者特定の不備が原因であり、平均的な病院ではその修正に年間約250万ドルを費やしています(AHIMA, 2024)。その誤特定の多くは、並べて比較されることのない2つの書類から始まります。フロントデスクで記入される患者の受付フォームと、数週間後に支払者から送り返されるEOBです。それぞれに患者名が記載されていますが、その2つの名前は一致しないことがよくあります。
重要ポイント
- 誤ったアカウントに計上されたEOBは、通常、単純な読み間違いが原因とされますが、プロセス上のどの段階でも2つの名前を並べて比較することはありません。
- 患者の身元情報はあなたに届くまでに4回コピーされ、いずれかのコピーに不一致があっても、EOBが計上されるまで見えません。
- 両方のバッチで同じ6つの本人確認列を使用すれば、名前を探す作業ではなく、行のペアを確認する作業になります。
受付フォームに触れるのは誰か、そしてクリーンなサイクルとは
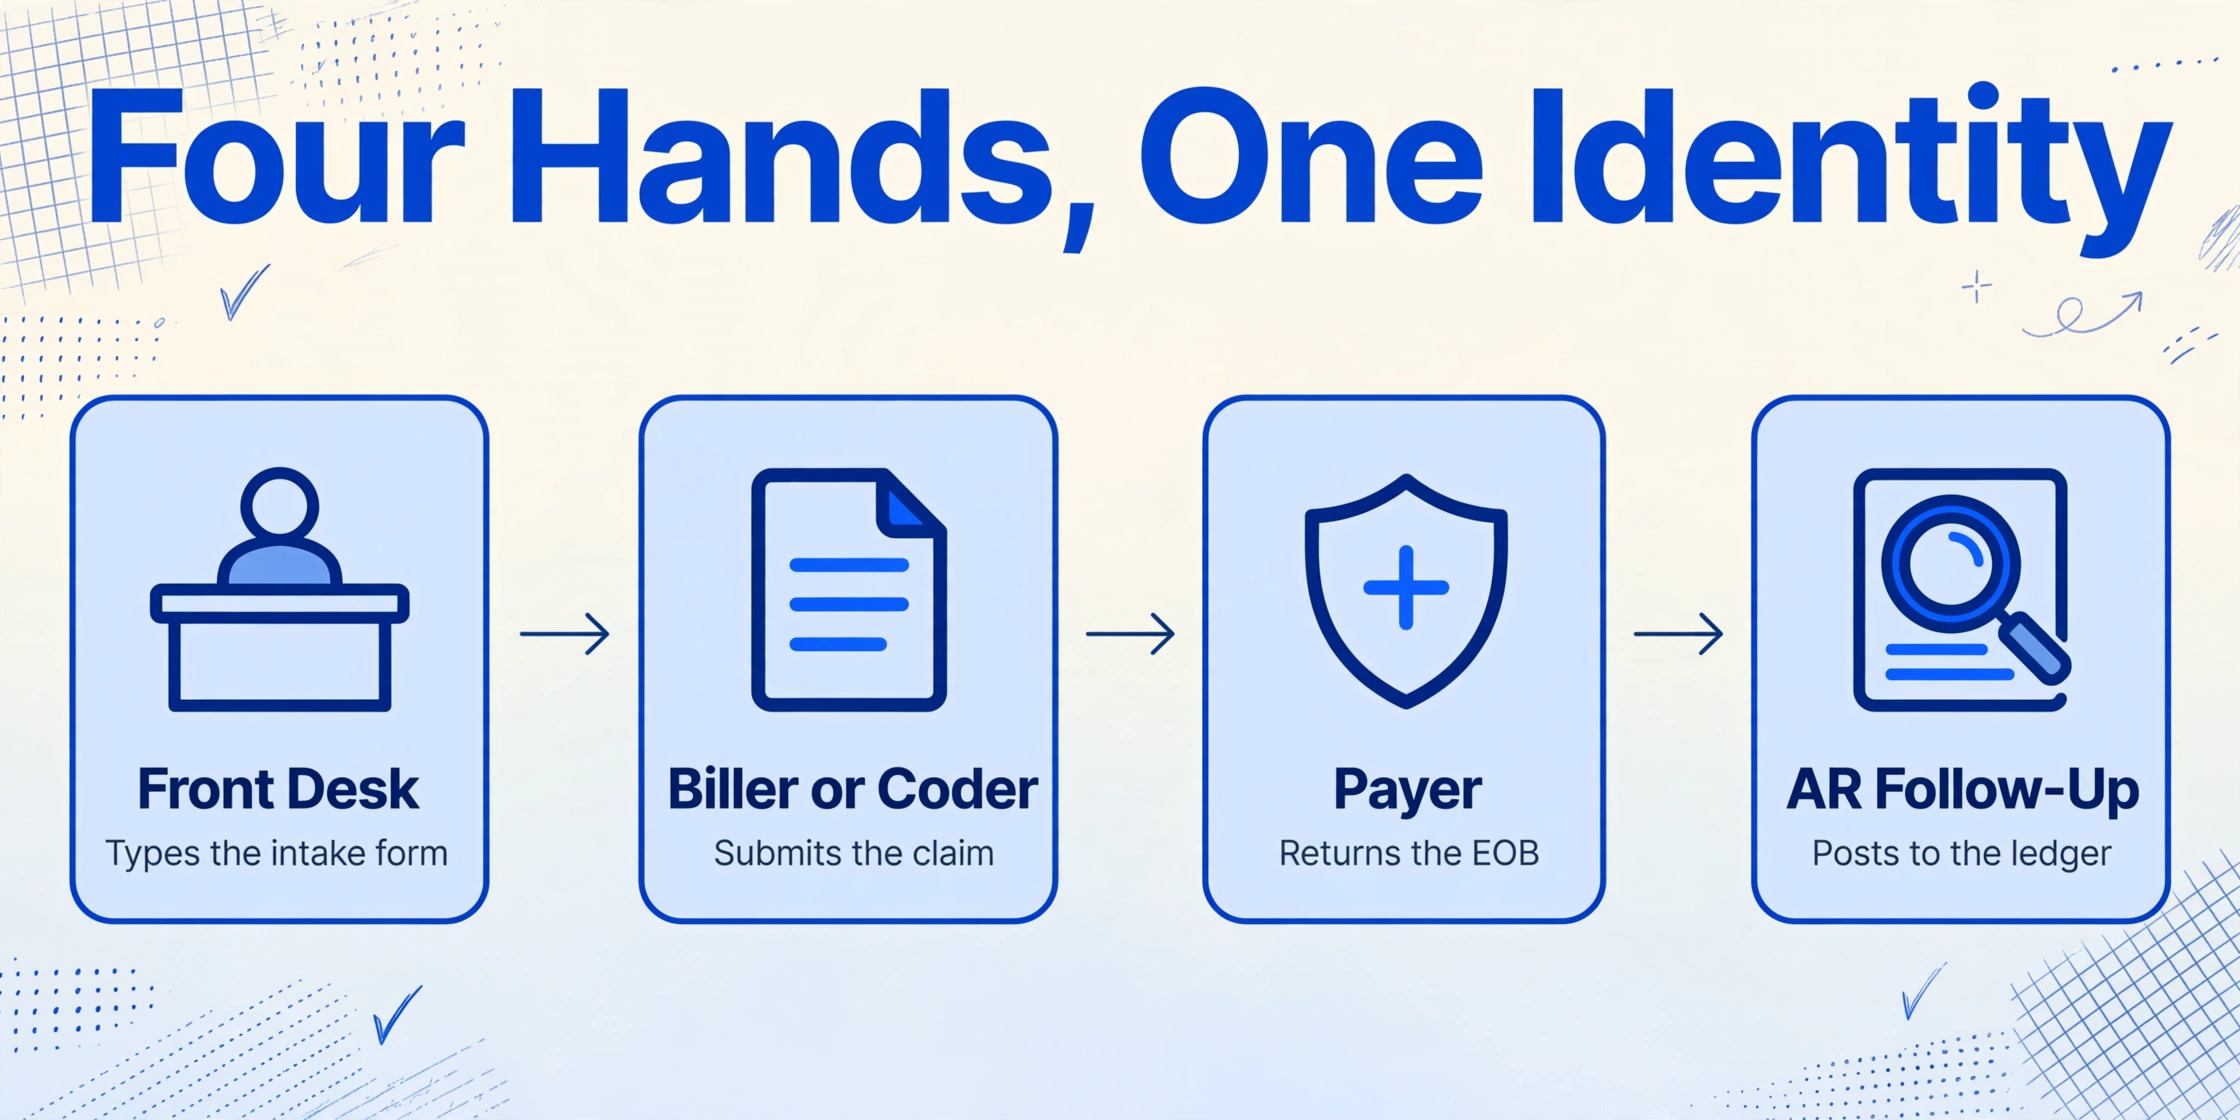
このワークフローは4つの担当者を経由し、それぞれが患者の身元情報を新しい場所にコピーします。
| 担当者 | 実際に決定すること | 患者の身元情報がコピーされる場所 |
|---|---|---|
| フロントデスクスタッフ | 紙またはポータルの受付フォームを、一字一句変えずに診療管理システムへ入力したかどうか | 受付フォームからPMシステムの患者記録へ |
| ビラーまたはコーダー | 請求がペイヤーの期待するsubscriber name、DOB、member IDを備えているかどうか | PM患者記録からCMS-1500またはUB-04請求へ |
| ペイヤー | 名前、生年月日、member IDが彼らの加入者ファイルと一致するかどうか、そして支払った金額 | 請求からEOBまたは電子送信通知へ |
| ARフォローアップスペシャリスト | EOBがどの患者アカウントに転記されるか、そして残高を誰が支払うのか | EOBから患者元帳へ |
クリーンなサイクルでは、患者が受付フォームに書いた名前は、フロントデスクが入力する名前であり、ビラーが提出する名前であり、ペイヤーがEOBで返す名前であり、ARスペシャリストがアカウントと照合する名前です。1つの身元情報の4つのコピーが、すべて同じでなければ意味がありません。これが仕事のすべてです。請求を成功させるか失敗させるかの照合は金額の問題ではなく、これら4つのコピーが同一人物を指しているかどうかの問題なのです。
EOBは患者アカウントに自動的には紐づきません。どの記録に属するかを人が判断する必要があり、その判断は、比較する文書に記載されている身元情報の列の正確さにのみ依存します。
患者照合が失敗する3つの箇所
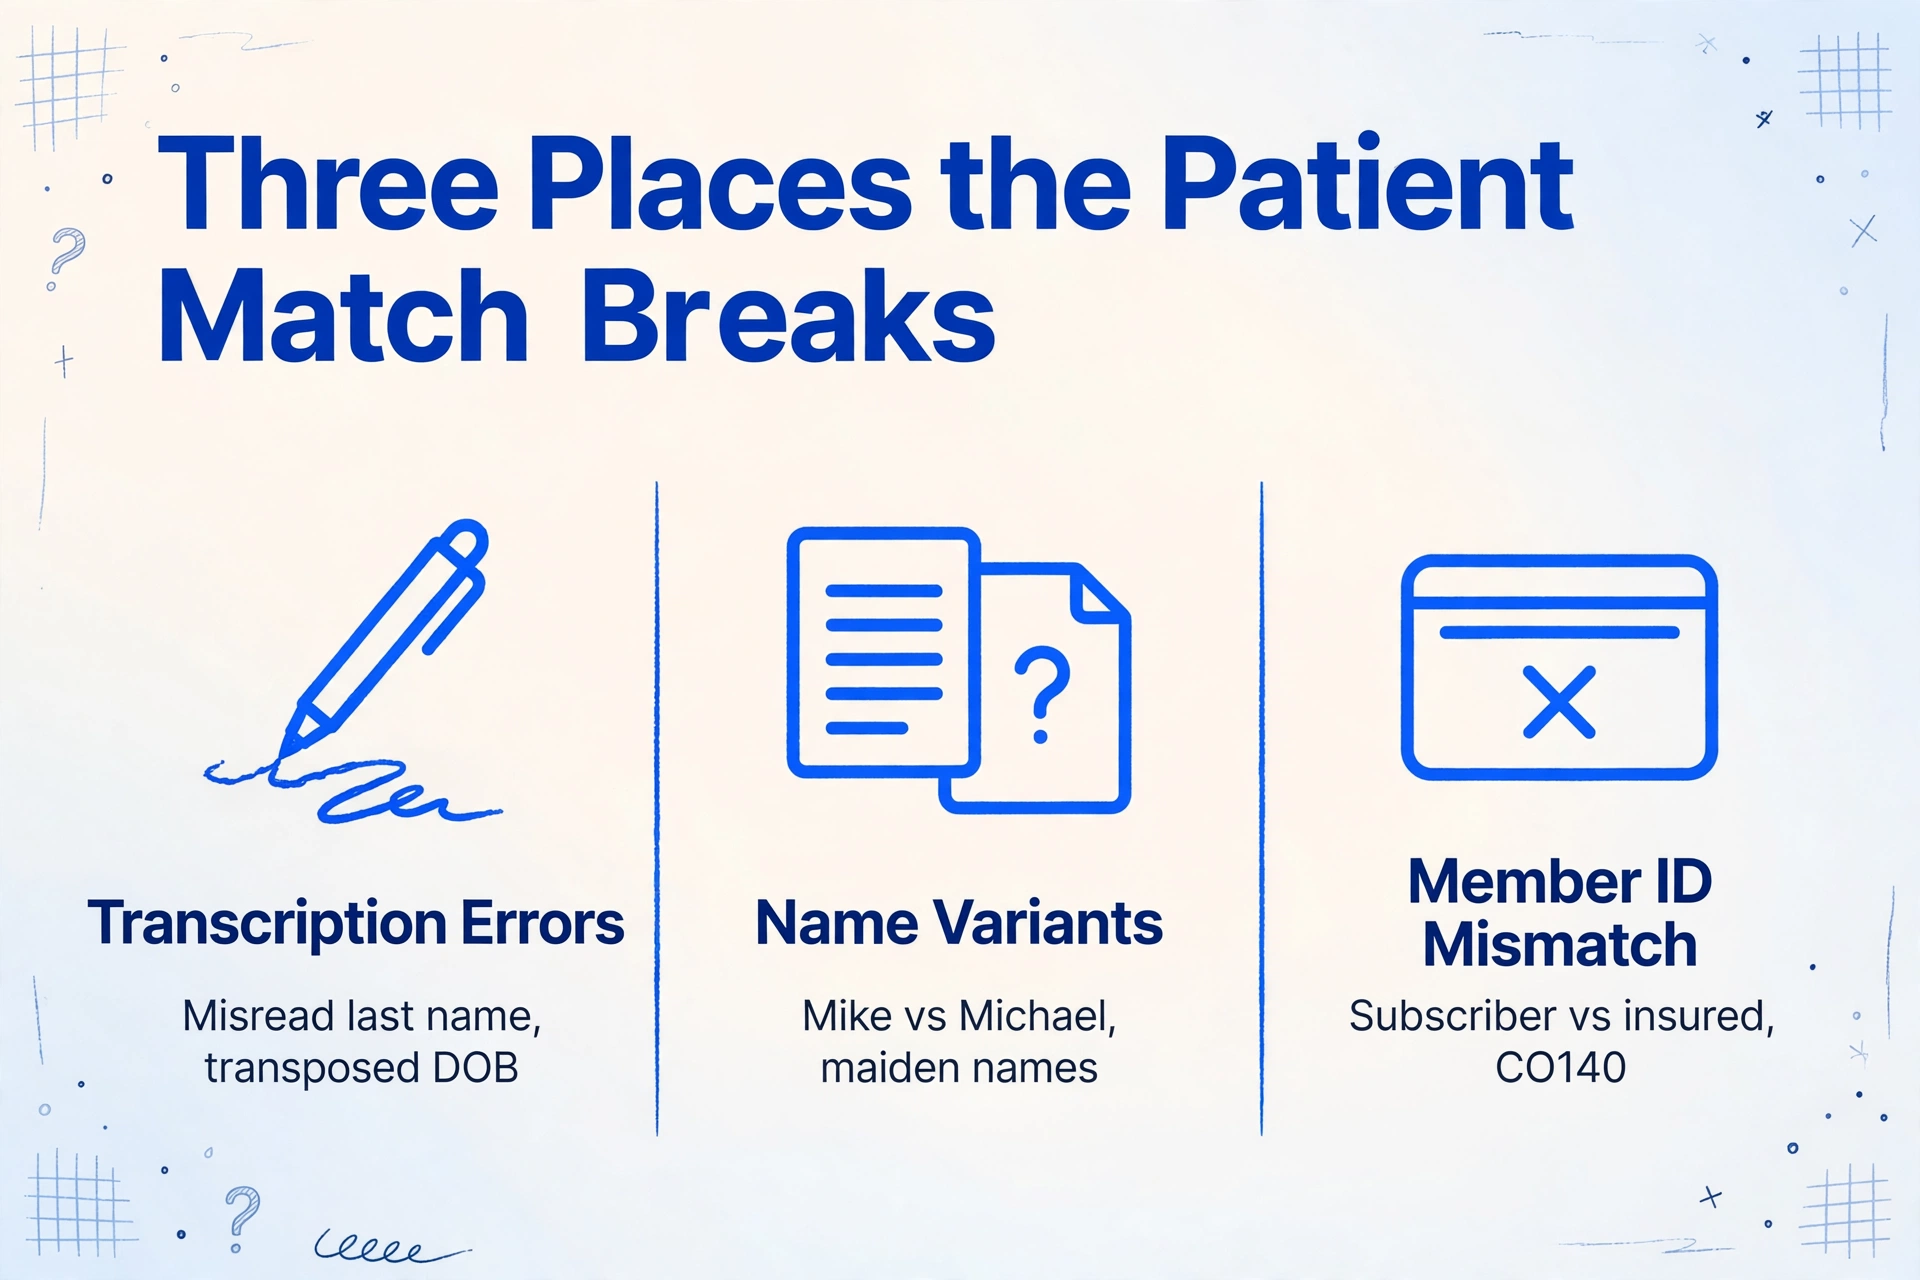
最初の失敗箇所は、受付での転記です。手書きの受付フォームを目で読み、診療所管理システムに入力する際に、苗字の読み間違い、DOBの桁の入れ違い、会員IDの数字の打ち間違いが患者記録に登録されてしまいます。紙のフォームには患者が書いた内容がそのまま残っているため、このミスはフォーム上では見えません。それが表面化するのは、後日、請求が戻ってきたときです。紙面上の1文字の読み間違いから、送金明細書上の特定の拒否コードに至るこの失敗の連鎖には、独自の仕組みがあり、受付フォームの1つの読み間違いがどのようにして請求拒否につながるかで詳しく説明しています。
2番目の失敗箇所は、文書間での名前の異形です。救急車の請求担当者は、r/CodingandBillingで日常的なこの問題を次のように説明しています:「私はHMOプランが持っている内容を正確に入力しました。つまり、Medicareは他の保険とは異なる名前を持っているということです。これは常に発生しており、女性の場合は旧姓やニックネームが使われることがよくありますが、通常は見つけることができます」(r/CodingandBilling、2024年)。再婚による3つ目の苗字、受付フォームのMikeと保険証のMichael、ファーストネームとして使われるミドルネーム、支払者がEOBで省略したJr.やIIIなどがあります。支払者は完全一致の名前照合を行うため、被保険者名の不一致は、請求調整コード内で文書化された拒否理由であり、コードCO140:「患者/被保険者の健康識別番号と名前が一致しません」となります(AAPC Knowledge Center)。
3番目の失敗箇所は、会員IDフィールド自体です。受付フォームでは、契約者を保険契約者として記録することがよくありますが、請求では、患者を被保険者として、さらに契約者IDを別途記録する必要があります。受付スタッフが契約者の名前を患者欄にコピーしたり、グループ番号を会員IDとして扱ったりすると、支払者が照合できない識別情報を含む請求が送信されます。この請求は拒否されて戻ってきて、最終的に届くEOBには、スタッフが期待していたアカウントと一致しない、修正または切り詰められた名前が記載されています。
EOBが投稿されるまで不一致が残る理由
これらの問題はいずれも受付時点では表面化しません。フロントデスクが見るのはフォームであり、エラーレポートではありません。請求担当者が見るのは提出済みの請求であり、将来の拒否ではありません。後になって表面化する数字は深刻です。HFMAは拒否の85%は回避可能であり、その大半は患者受付プロセスに起因すると報告しており、登録および適格性エラーはフロントエンドの拒否原因リストの上位に位置しています(HFMA)。言い換えれば、患者の身元に遡る拒否は、通常、数週間前の転記または照合エラーに対する代償なのです。
不一致が投稿ステップまで残るのは、ARスペシャリストが2つのドキュメントを渡され、目視で身元を比較するよう求められるためです。EOBには、支払い者がファイルに保持している患者名が記載されています。診療管理システムのアカウントには、フロントデスクが入力した患者名が記載されています。これらが一致しない場合、誰かが意図された患者を判断する必要があり、その判断は通常、時間的プレッシャーの下で静かに行われます。誤った選択によりEOBが誤ったアカウントに投稿され、患者は誤った残高の明細書を受け取り、修正作業は同じスペシャリストに戻ってきます。これが手動EOB処理が診療現場で続く理由です。読み取りステップは人間による比較であり、検索ではないからです。
比較は見た目よりも困難です。身元情報が各ドキュメントの異なる場所にあるためです。受付フォームは名前、DOB、保険情報を複数ページにわたって広げており、手書きの場合もあります。EOBはこれらを保険者ごとに変わる支払い者レイアウトに凝縮しています。これらを比較するには、ページをめくり、2つの異なる構造で同じ5つの値を探す必要があります。解決策はより速い目ではありません。両方のドキュメントに同じ身元列を配置し、比較を検索ではなく並べ替えにすることです。
両方のドキュメントに同じID列を構築する
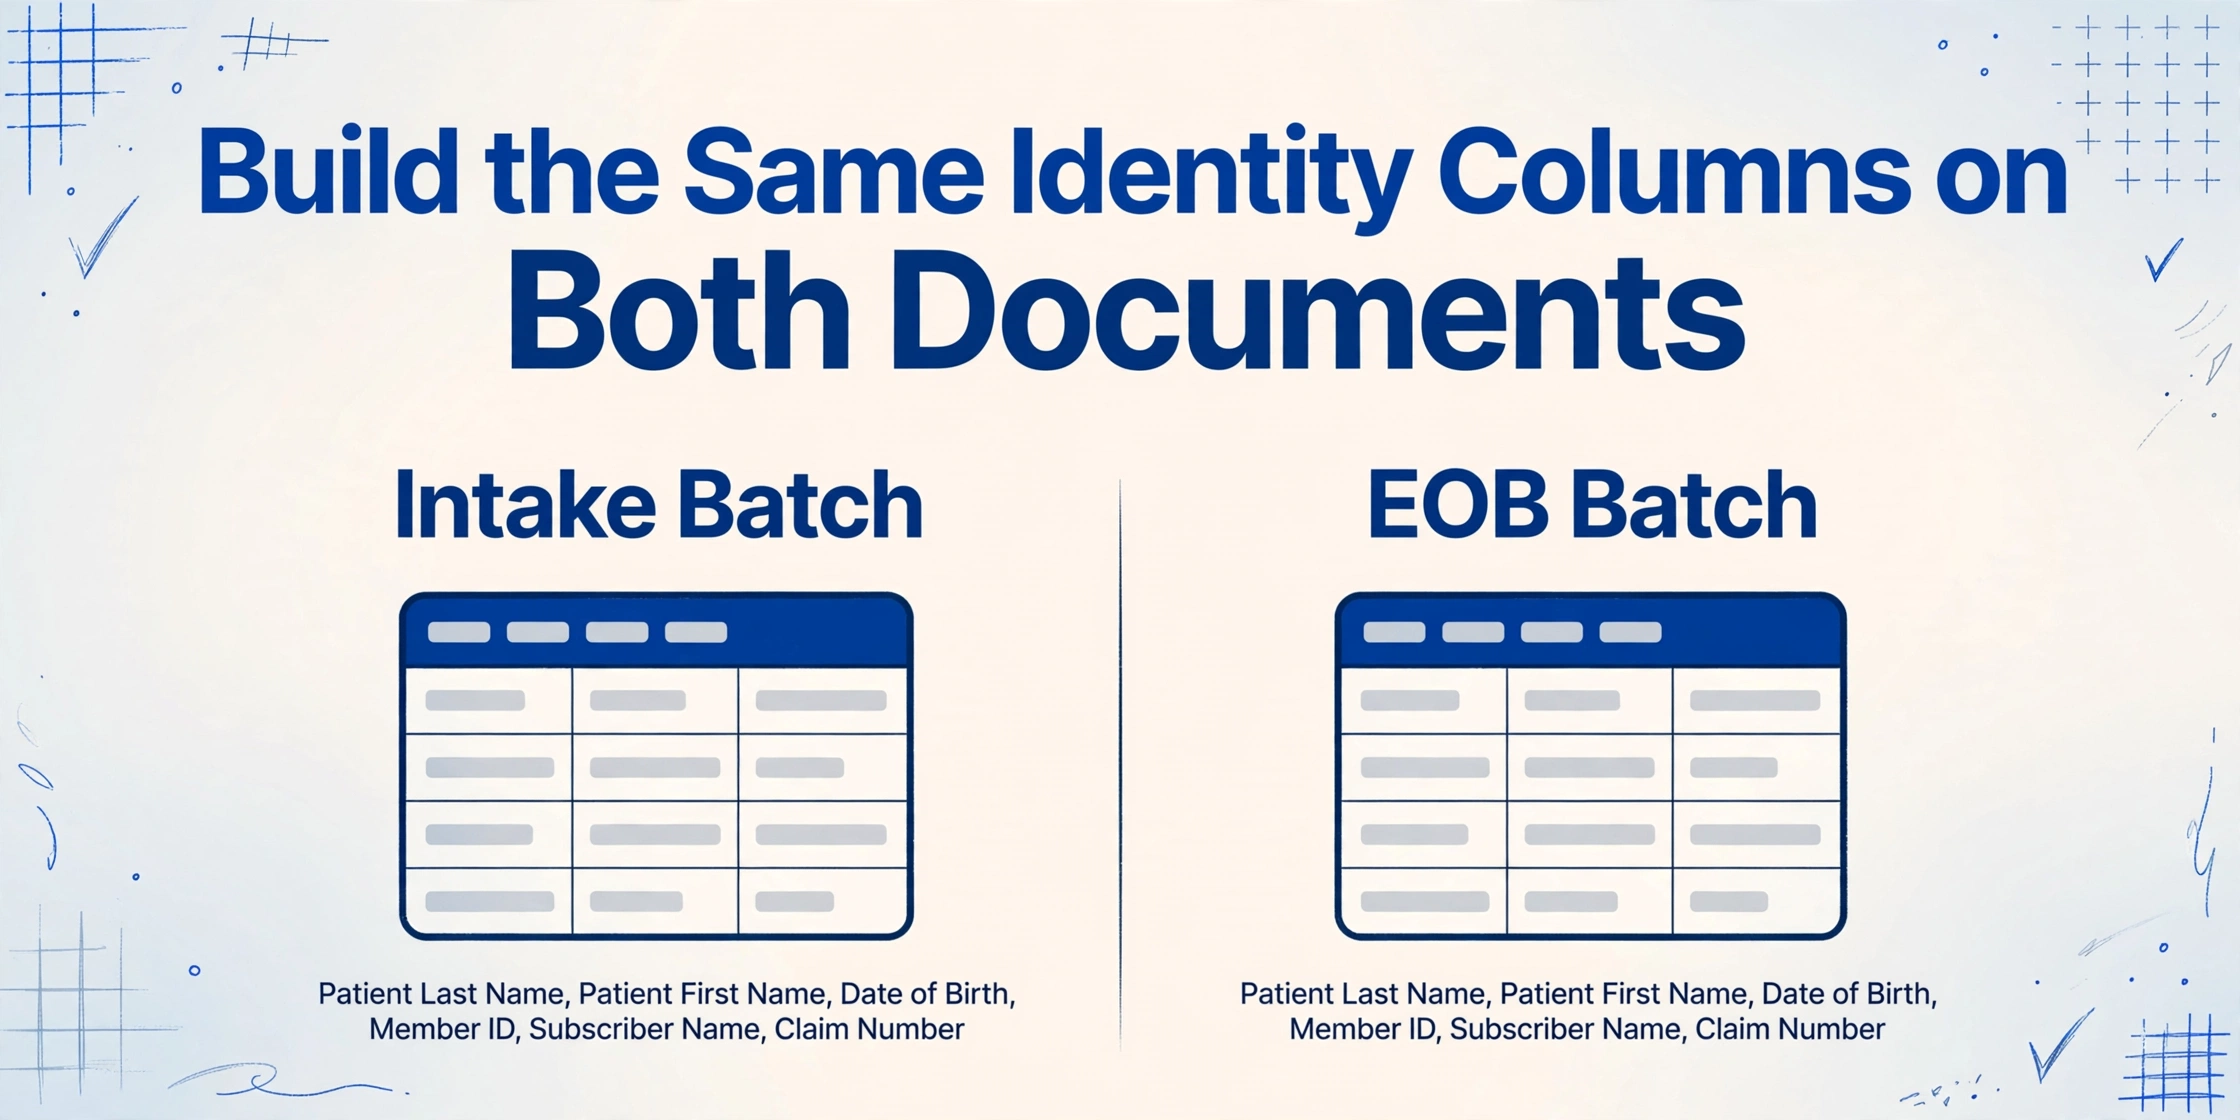
ImageToTable.aiはカスタム列抽出を使用します。列名を入力すると、AIが各ドキュメントを読み取り、フィールドラベルの意味を理解して各列の値を入力します。ページ上の位置に依存しません。入力した列名が出力スプレッドシートのヘッダーになります。AIが意味を理解して読み取るため、同じ列定義が手書き、異なるクリニックのフォームレイアウト、異なるペイヤーのEOBレイアウトでも機能します。
ここで重要な設定は列セットであり、照合の両側で同一である必要があります:
| 受付バッチのID列 | EOBバッチのID列 |
|---|---|
| 患者姓 | 患者姓 |
| 患者名 | 患者名 |
| 生年月日 | 生年月日 |
| メンバーID | メンバーID |
| 加入者名 | 加入者名 |
| 請求番号 | 請求番号 |
これらの列で受付フォームのバッチを抽出し、同じ列で対応するEOBのバッチを抽出して、両方のスプレッドシートを1つのシートにまとめます。メンバーIDで並べ替え、次に生年月日で並べ替えると、各EOB行が対応する受付行の隣に配置されます。07/04ではなく07/14と読まれる生年月日や、ペイヤーが切り詰めた姓があっても、紙の山を探す作業ではなくなり、1つの画面で確認できる行ペアになります。正直な注意点が2つあります。このツールはEOBの4行目が受付の4行目に属すると判断するわけではありません。2つの行を隣に配置するだけで、ARスペシャリストが照合を低コストで確認できるようにします。また、そもそもペイヤーのEOBからフィールドを抽出する必要がある場合は、EOB抽出の完全ガイドでその手順を説明しており、高EOBボリュームのバッチ処理は別途扱っています。
実際の受付パケットでこのワークフローを機能させる製品設定が2つあります。1つ目は処理ティアです。患者の受付パケットは手書きであることが多く、手書きは標準ティアが最適化されていない領域です。モデルティアは処理品質を選択するアカウント設定です。標準はほとんどの印刷された表形式ドキュメントをカバーし、アドバンストとプレミアムは、密集した手書き、筆記体、誤読が高コストなレイアウトを対象としたより強力なビジョンモデルを使用します。紙の受付フォームのバッチの場合は、送信前にティアをアドバンストまたはプレミアムに設定します。バッチ送信時にアクティブなティアがそのバッチの請求と返金の基準となるため、この設定はアカウント単位ではなくバッチ単位で決定されます。
2つ目の設定はMulti-Page Mergeです。これは、受付フォームが1ページであることはまれだという事実に対応します。人口統計情報は1ページ目、病歴のチェックボックスは2ページ目と3ページ目、保険と同意書はそれ以降のページにあります。マージルールがないと、AIは3ページを読み取って1人の患者に対して3行を生成し、照合に必要な識別情報が散らばってしまいます。テンプレート設定でMulti-Page Mergeをオンにして、グループ化ルールを選択します。フォームにアカウント番号や会員番号が記載されている場合は、バッチ全体で共有の参照値で照合するか、追跡対象の列の値が変わるたびに新しいグループを開始します(追跡対象の列は患者名フィールドに設定します)。これにより、1つのパケットのページが1行にまとまり、患者名がすべての行に引き継がれ、識別列はそれらを含むページから入力されます。1人の患者、1行、EOB側と照合する準備が整います。
ファイルは安全に処理され、保存されません。
同じ識別列のワークフローは、より広範な医療請求書類にも適用できます。複数の保険者と患者にまたがって照合を行う医療機関は、列セットを拡張して、1つの患者ビューで医療請求書類の残りをカバーできます。また、すでに受付側をデジタル化しているクリニックは、患者受付フォームからExcelへの抽出ルートから始めるべきです。
まだ人が必要な部分
このワークフローは両側の構造化を自動化しますが、中間の判断がゼロになるわけではありません。特定のEOBが特定の患者記録に属するかどうかを判断するものではありません。同じ名前と同じDOBを持つ2人の患者、または支払者(payer)がサフィックスを省略したEOBでは、どの行がどの患者かを確認する人が引き続き必要です。理想的には、残高が計上される前にチャートを一度確認します。変わるのは、その確認にかかるコストです。このツールにより、比較がデフォルトの表示となり、誰かが行うことを覚えておく必要がなくなります。
2つの境界を明確に述べておく価値があります。このツールはドキュメントを抽出・構造化しますが、診療管理システムやEHRへの転記、請求の提出、Epic、athenahealth、その他のプラットフォームへのデータ送信は行いません。生成されるスプレッドシートをインポートするか手動で確認することになり、既存のPMおよびクリアリングハウス環境内でワークフローを維持できます。また、資格の認定や給付の審査を行うものではないため、失効した保険証券からの一致するEOBは、依然として受付(front desk)が解決すべき資格の問題です。
最後の境界はコンプライアンスに関するものです。患者の受付フォームとEOBには保護医療情報(PHI)が含まれており、HIPAAのプライバシーおよびセキュリティ規則は、45 CFR Part 164に基づき、そのPHIの使用と開示を規定しています。ImageToTable.aiはHIPAA準拠ソリューションではなく、ビジネスアソシエイト契約(BAA)も提供していません。HIPAAの適用を受ける診療所は、PHIに触れる第三者サービスを自社のコンプライアンス要件に照らして評価し、ベンダーと保持期間や処理について協議し、実際の患者識別可能なドキュメントを処理する前に、匿名化されたサンプルフォームでワークフローをテストする必要があります。
患者受付とEOB照合:よくある質問
これは各EOBを患者記録に自動的に照合しますか?
いいえ。受付パケットとEOBを同じ本人特定列に抽出するため、両側が並び順に整列し、不一致が隣り合う行として見えるようになります。特定のEOBが特定の患者アカウントに属するかどうかの判断は人の確認に委ねられます。同名や同じDOBのケースでは、担当者がカルテを確認する必要があるためです。
手書きの受付フォームにはどのモデルティアを使うべきですか?
手書きの紙の受付フォームのバッチにはAdvancedまたはPremiumを使用してください。これらのティアは、密集した手書き文字や筆記体に対応したより強力なビジョンモデルを実行するためです。Standardは、印刷された表形式のドキュメントの大半を適切に処理します。バッチを送信した時点で有効なティアがそのバッチの課金対象となるため、クリーンなデジタルEOBにはStandardを維持し、手書きの多い受付バッチにはティアを切り替えることができます。
複数ページの受付パケットを1つの患者記録として保持するにはどうすればよいですか?
テンプレート設定でマルチページマージを有効にし、グループ化ルールを選択してください。フォームにアカウント番号やメンバー番号が記載されている場合は、共有参照による一致を使用します。それ以外の場合は、患者名の列を追跡し、変更があったときに新しいグループを開始します。ページは1つの行にまとめられ、各フィールドが記載されているページから本人特定情報が入力されます。
スキャンされた紙またはポータルPDFとして届くEOBも処理できますか?
はい。このツールはワークフローの両側でPDF、JPG、PNG、およびスキャン画像を受け付けます。劣化したFAXや淡いスキャンは一部のフィールドの信頼度を下げるため、転記前のレビューパスがそれらのドキュメントには重要です。レビュー画面のbbox視覚チェックで、各抽出値が元の画像のどこから取得されたかを確認できます。
このワークフローの要点は、受付フォームとEOBを記憶から照合する必要がないことです。両側に同じ本人特定列があれば、シートを並べ替えて不一致のある行を確認するだけで、EOBを正しい患者に照合できます。支払者ドキュメントの束を開いて名前を目視で比較する必要はありません。比較の構造を変えることで、フロントデスク、biller、ARデスク間の引き継ぎに隠れていた、拒否の35%を引き起こした不一致が姿を現します。