각 EOB를 올바른 환자 기록에 매칭하세요
잘못된 계정에 게시되기 전에
AHIMA 저널에 따르면 거부된 청구의 35%가 부정확한 환자 식별로 인해 발생하며, 이를 정리하는 데 평균 병원이 연간 약 $2.5 million을 지출합니다 (AHIMA, 2024). 대부분의 잘못된 식별은 서로 나란히 비교되지 않는 두 문서 사이에서 시작됩니다: 프런트 데스크에서 작성된 환자 접수 양식과, 몇 주 후 payer가 보내는 EOB입니다. 각 문서는 환자를 지칭하지만, 두 표기가 일치하지 않는 경우가 많습니다.
핵심 요점
- 잘못된 계정에 게시된 EOB는 대개 한 번의 잘못된 판독 탓으로 돌려지지만, 주기 어디에서도 두 표기를 나란히 비교하는 단계가 없습니다.
- 환자의 신원은 귀하에게 도달하기 전에 네 번 복사되며, 복사본의 불일치는 EOB가 게시될 때까지 보이지 않습니다.
- 두 배치에 동일한 여섯 개의 신원 열을 사용하면, 이름을 찾는 대신 행 쌍을 확인하는 작업이 됩니다.
접수 양식을 거치는 사람들과 깨끗한 처리 주기의 모습
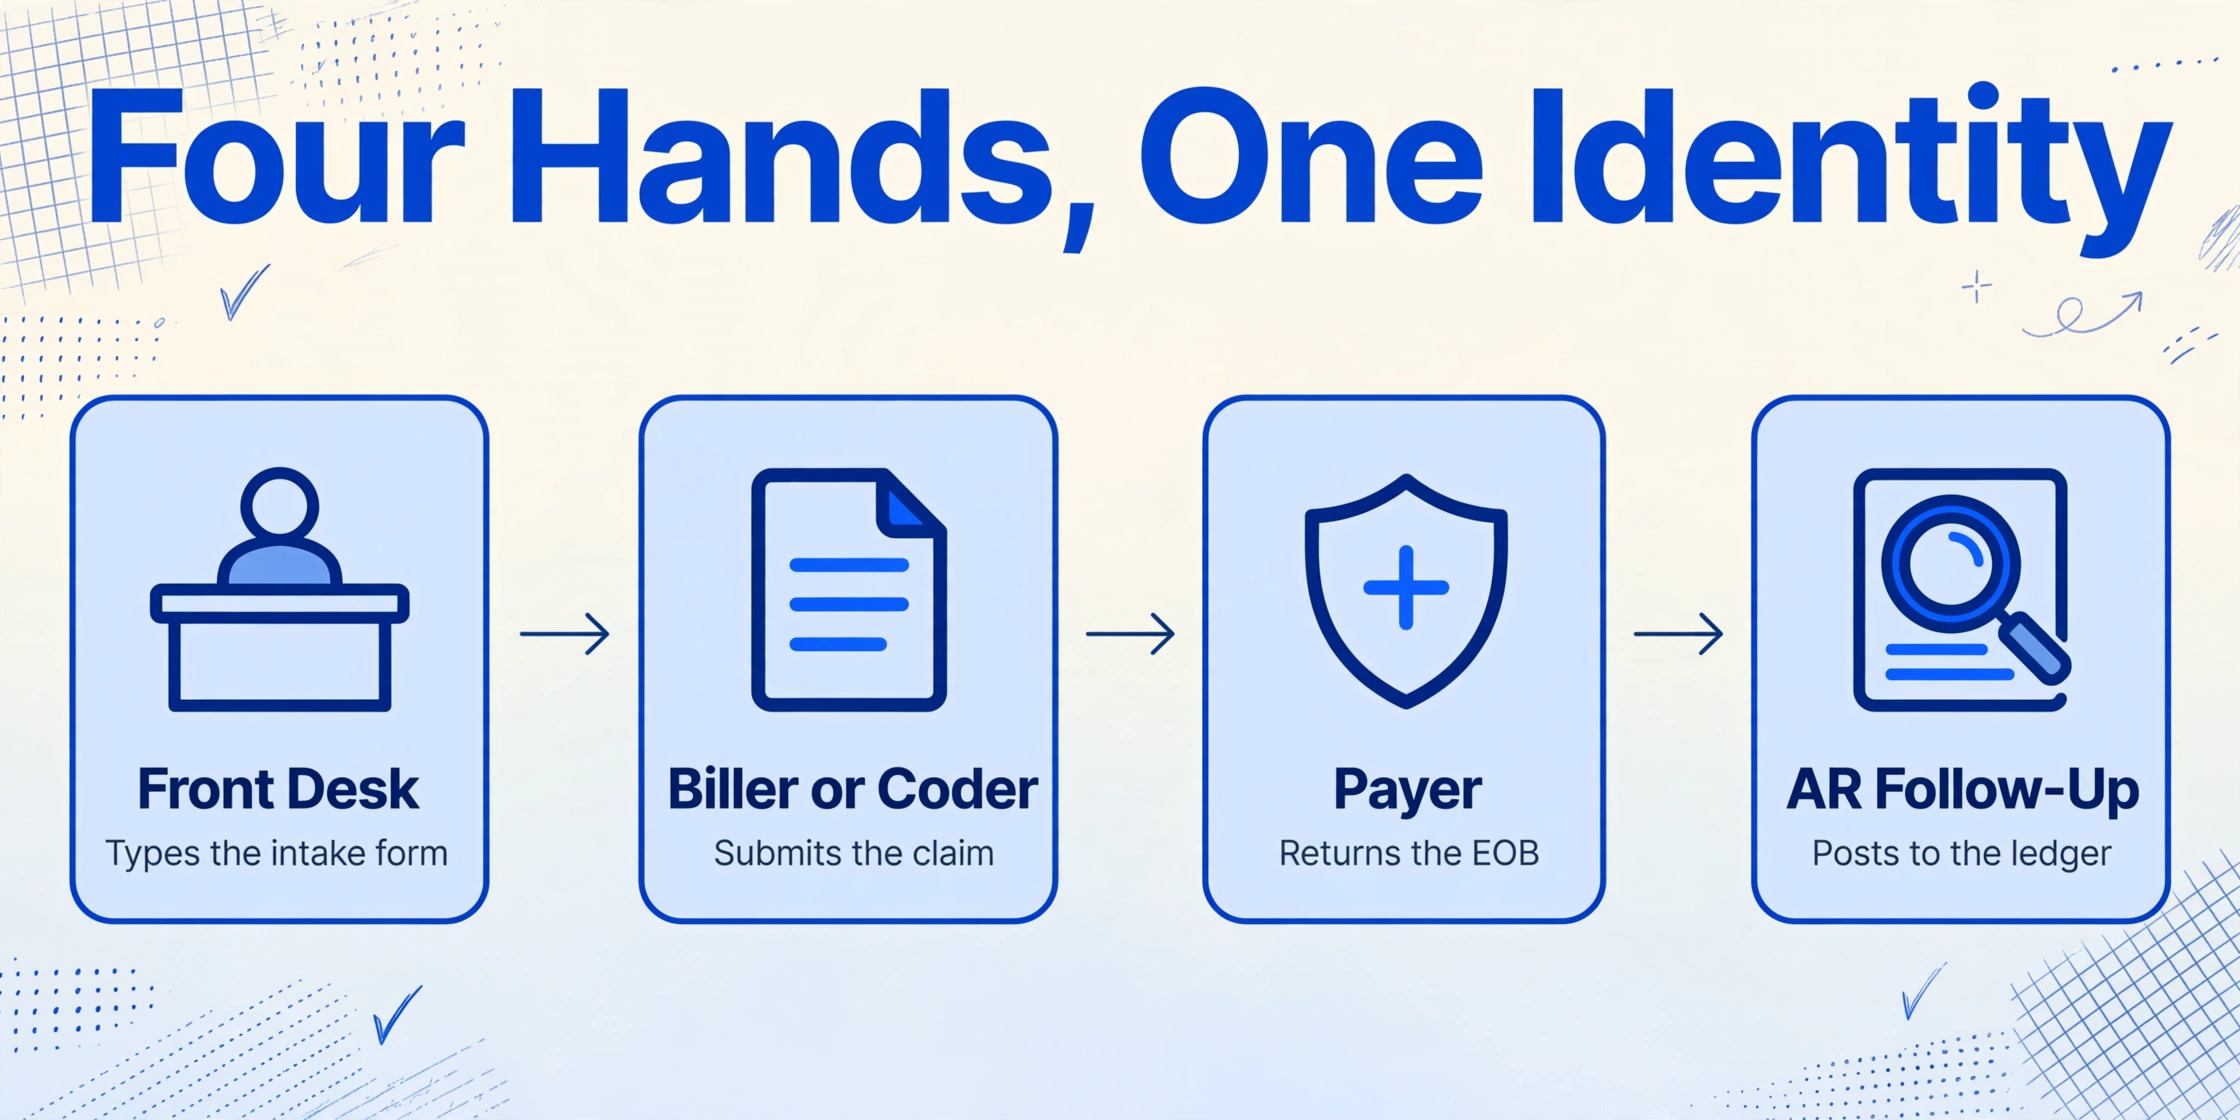
이 워크플로우는 네 명의 담당자를 거치며, 각 단계에서 환자의 신원 정보가 새로운 곳에 복사됩니다:
| 역할 | 실제로 결정하는 사항 | 환자 신원 정보가 복사되는 위치 |
|---|---|---|
| 프런트 데스크 직원 | 종이 또는 포털 접수 양식을 진료관리 시스템에 숫자 하나 틀리지 않고 입력했는지 여부 | 접수 양식에서 PM 시스템의 환자 기록으로 |
| 빌러 또는 코더 | 청구서에 페이어가 기대하는 subscriber name, DOB, member ID가 정확히 기재되었는지 여부 | PM 환자 기록에서 CMS-1500 또는 UB-04 청구서로 |
| 페이어 | 이름, 생년월일, member ID가 가입자 파일과 일치하는지, 그리고 지급 금액이 얼마인지 | 청구서에서 EOB 또는 전자 지급 내역서로 |
| AR 후속 조치 전문가 | EOB가 어떤 환자 계정에 게시되는지, 그리고 잔여 잔액을 누가 부담해야 하는지 | EOB에서 환자 원장으로 |
깨끗한 주기에서는 환자가 접수 양식에 적은 이름이 프런트 데스크가 입력하는 이름이고, 빌러가 제출하는 이름이며, 페이어가 EOB에 반환하는 이름이고, AR 전문가가 계정에 대사하는 이름입니다. 하나의 신원에 대한 네 개의 사본이 있으며, 모두 동일하게 읽혀야만 의미가 있습니다. 이것이 바로 전체 업무입니다. 청구의 성패를 좌우하는 대사는 금액에 관한 것이 아니라, 이 네 개의 사본이 동일한 사람을 가리키는지에 관한 것입니다.
EOB는 스스로 환자 계정에 연결되지 않습니다. 어떤 기록에 속하는지 사람이 결정해야 하며, 그 결정은 비교 대상 문서에 있는 신원 열 정보만큼만 정확할 수 있습니다.
환자 매칭이 깨지는 세 가지 지점
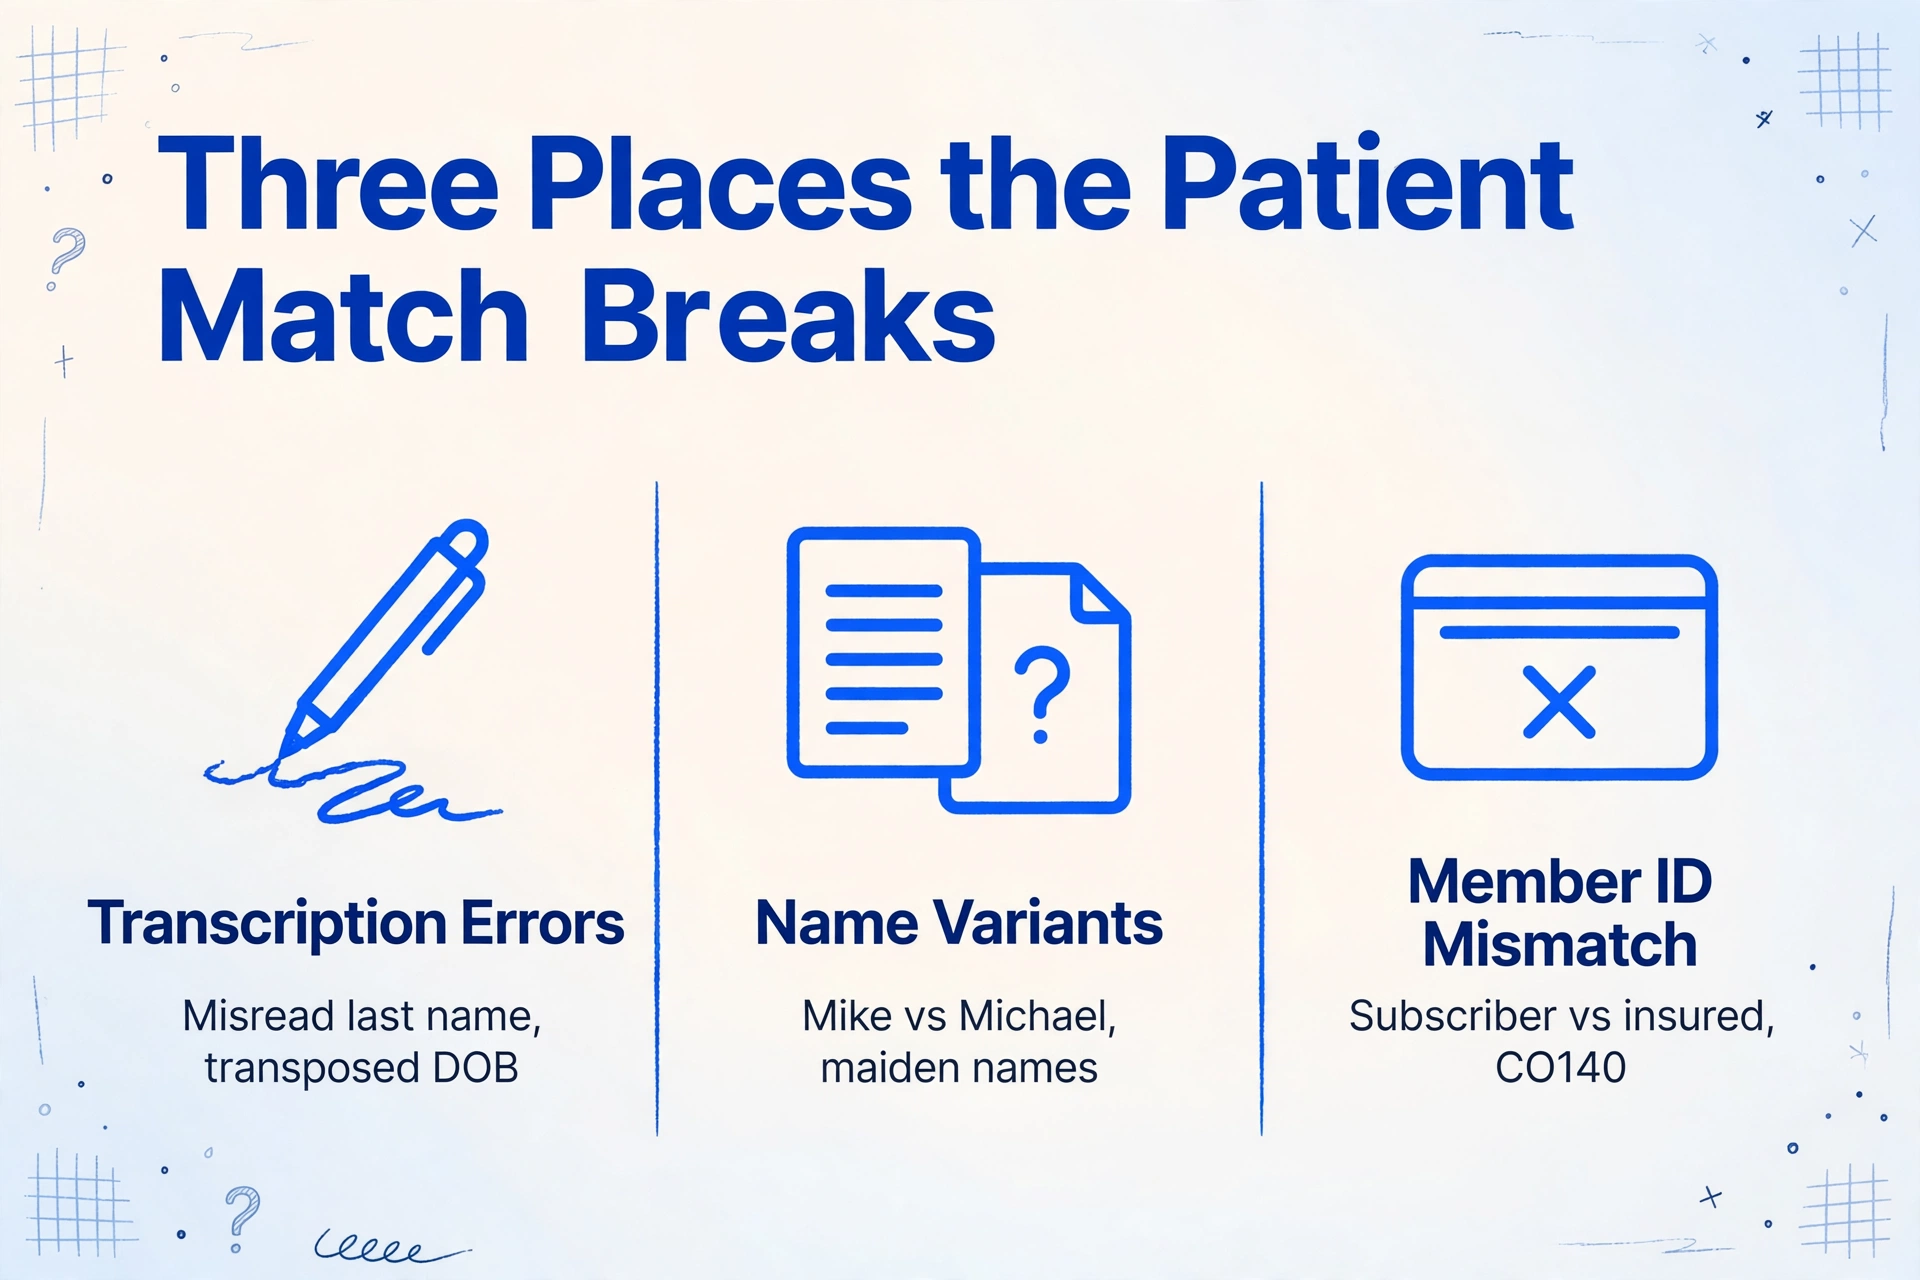
첫 번째 실패 지점은 접수 데스크에서의 필사입니다. 손으로 작성된 접수 양식을 육안으로 읽고 진료 관리 시스템에 입력하는 과정에서, 성씨를 조금 잘못 읽거나 DOB를 바꿔 적거나 회원 ID 숫자 하나를 다른 숫자로 잘못 입력하는 일이 환자 기록에 그대로 남습니다. 종이에는 환자가 쓴 내용이 그대로 있기 때문에 양식 자체에서는 오류가 보이지 않습니다. 이 오류는 나중에 청구가 반송될 때서야 드러납니다. 페이지의 한 글자 오독에서 명시된 거부 코드까지 이어지는 이 실패 사슬에는 고유한 메커니즘이 있으며, 이는 접수 필드 하나의 오독이 어떻게 거부된 청구가 되는지에서 다룹니다.
두 번째 실패 지점은 문서 간 이름 변형입니다. 한 구급차 청구 담당자는 r/CodingandBilling에서 일상적으로 겪는 이 문제를 이렇게 설명했습니다: "저는 HMO 플랜에 있는 그대로 입력했는데, Medicare는 다른 보험과 이름이 다르더군요. 이런 일은 항상 발생하고, 여성분들은 결혼 전 성씨나 별명을 쓰는 경우가 많지만, 보통 찾을 수는 있습니다" (r/CodingandBilling, 2024). 재혼으로 생긴 세 번째 성씨, 접수 양식의 Mike와 보험카드의 Michael, 이름 대신 쓰인 중간 이름, payer가 EOB에서 뺀 Jr. 또는 III 같은 경우가 있습니다. Payer는 정확한 이름 매칭을 실행하며, 피보험자 이름 불일치는 청구 조정 코드 내에서 문서화된 거부 사유이며, 코드 CO140: "환자/피보험자 건강 식별 번호와 이름이 일치하지 않음"입니다 (AAPC Knowledge Center).
세 번째 실패 지점은 회원 ID 필드 자체입니다. 접수 양식에는 정책 보유자를 피보험자로 기록하는 경우가 많지만, 청구에는 환자를 피보험자로, 그리고 보험 가입자 ID를 별도로 기재해야 합니다. 접수 직원이 보험 가입자의 이름을 환자란에 복사하거나 그룹 번호를 회원 ID로 취급하면, payer가 매칭할 수 없는 신원 정보가 담긴 청구가 발송됩니다. 이 청구는 거부되거나 반려되어 돌아오고, 결국 도착하는 EOB에는 직원이 기대했던 계정과 더 이상 일치하지 않는 수정되거나 잘린 이름이 포함되어 있습니다.
불일치가 EOB 게시까지 살아남는 이유
이러한 중단은 접수 시점에 스스로를 알리지 않습니다. 프런트 데스크는 오류 보고서가 아닌 양식을 봅니다. 빌러는 향후 거부가 아닌 제출된 청구를 봅니다. 나중에 표면화되는 숫자는 냉정합니다. HFMA는 거부의 85%는 피할 수 있으며 대부분이 환자 접근 프로세스에서 발생한다고 보고하며, 등록 및 자격 오류가 전면 거부 원인 목록의 상단에 있습니다 (HFMA). 즉, 환자 신원으로 추적되는 거부는 대개 몇 주 전에 발생한 전사 또는 일치 오류에 대한 대가입니다.
불일치는 AR 전문가가 두 문서를 받아 육안으로 신원을 비교하도록 요청받기 때문에 게시 단계까지 살아남습니다. EOB는 지불자가 파일에 보유한 대로 환자의 이름을 지정합니다. 진료 관리 시스템의 계정은 프런트 데스크가 입력한 대로 환자의 이름을 지정합니다. 이들이 일치하지 않으면 의도된 환자가 누구인지 결정해야 하며, 그 결정은 일반적으로 시간 압박 속에서 조용히 이루어집니다. 잘못된 선택은 EOB를 잘못된 계정에 게시하고, 환자는 잘못된 잔액에 대한 명세서를 받으며, 수정 작업은 같은 전문가에게 돌아갑니다. 이것이 수동 EOB 처리가 진료 전반에 걸쳐 지속되는 이유입니다. 읽기 단계는 조회가 아닌 인간의 비교이기 때문입니다.
신원이 각 문서의 다른 위치에 있기 때문에 비교는 보기보다 어렵습니다. 접수 양식은 이름, DOB 및 보험 세부 정보를 여러 페이지에 걸쳐, 때로는 손으로 작성하여 분산시킵니다. EOB는 보험사마다 변경되는 지불자 레이아웃으로 이를 압축합니다. 비교한다는 것은 페이지를 넘기며 두 개의 다른 구조에서 동일한 다섯 가지 값을 찾는 것을 의미합니다. 해결책은 더 빠른 눈이 아닙니다. 두 문서에 동일한 신원 열을 배치하여 비교가 검색이 아닌 정렬이 되도록 하는 것입니다.
두 문서에 동일한 식별 열 구성하기
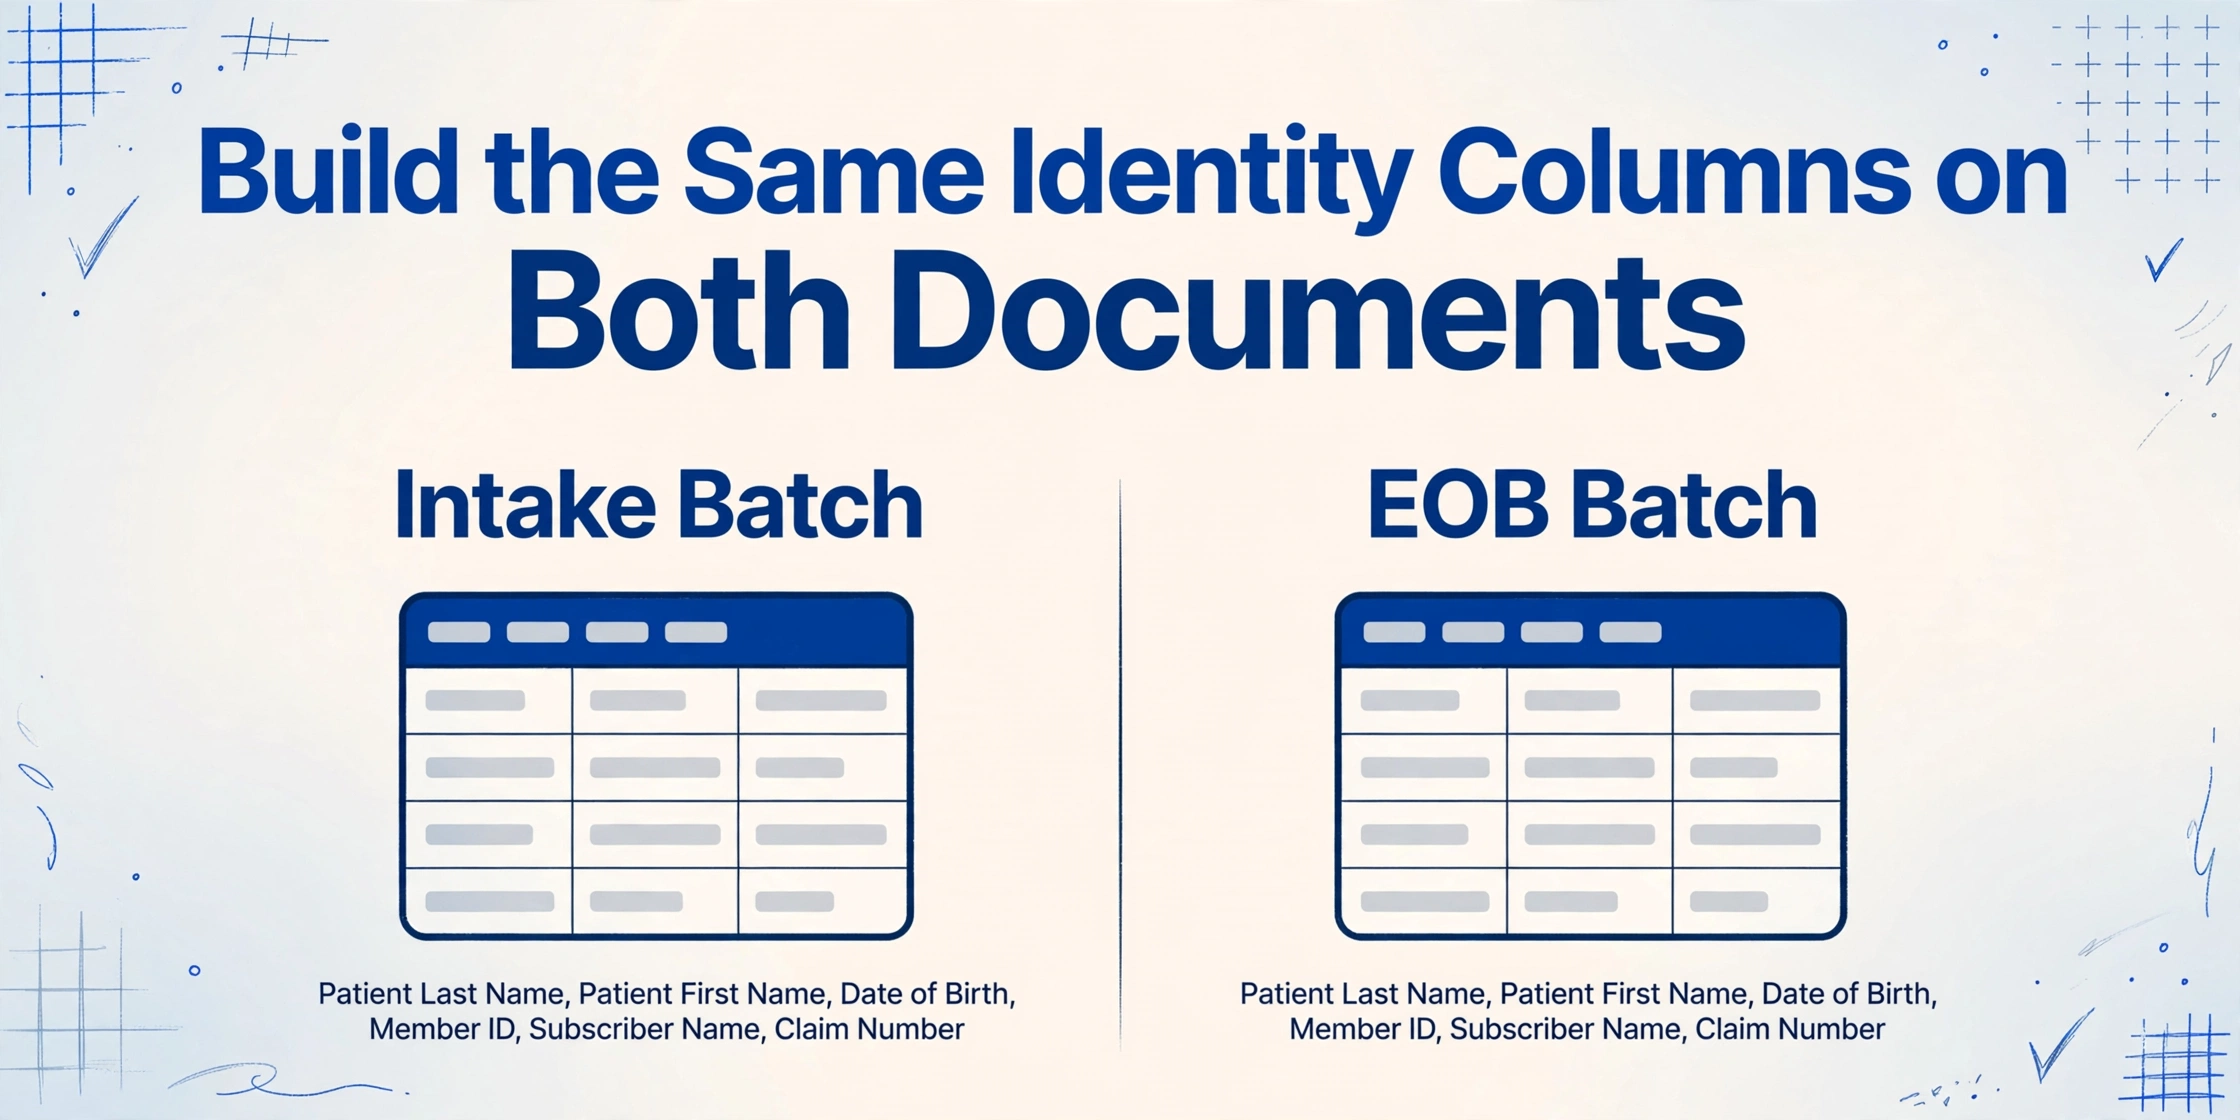
ImageToTable.ai는 맞춤 열 추출을 사용합니다. 원하는 열 이름을 입력하면 AI가 각 문서를 읽고, 필드 레이블의 의미를 파악하여 페이지 내 위치와 관계없이 각 열 아래에 값을 채웁니다. 입력한 열 이름이 출력 스프레드시트의 헤더가 됩니다. AI가 의미를 기준으로 읽기 때문에 동일한 열 정의가 필기체, 다양한 클리닉 양식 레이아웃, 다양한 보험사 EOB 레이아웃에서 모두 작동합니다.
여기서 중요한 구성은 열 세트이며, 대사의 양쪽에서 동일해야 합니다:
| 접수 배치의 식별 열 | EOB 배치의 식별 열 |
|---|---|
| 환자 성 | 환자 성 |
| 환자 이름 | 환자 이름 |
| 생년월일 | 생년월일 |
| 회원 ID | 회원 ID |
| 가입자 이름 | 가입자 이름 |
| 청구 번호 | 청구 번호 |
이러한 열로 접수 양식 배치를 추출하고, 동일한 열로 일치하는 EOB 배치를 추출한 다음 두 스프레드시트를 하나의 시트에 넣습니다. 회원 ID로 정렬한 다음 생년월일로 정렬하면 각 EOB 행이 해당 접수 행 옆에 놓입니다. 07/04 대신 07/14로 읽히는 생년월일이나 보험사가 잘라낸 성은 더 이상 서류를 뒤지는 일이 아니라 한 화면에서 볼 수 있는 행 쌍이 됩니다. 솔직한 참고 사항 두 가지: 이 도구는 EOB 4행이 접수 4행에 속한다고 판단하지 않습니다. 두 행을 나란히 배치하여 AR 전문가가 저렴하게 일치 여부를 확인할 수 있게 합니다. 그리고 보험사 EOB에서 필드를 추출해야 하는 경우가 아직 있다면, EOB 추출 전체 가이드에서 해당 단계를 다루며, 대량 EOB 처리를 위한 배치 처리는 별도로 다룹니다.
두 가지 제품 설정이 실제 접수 서류 묶음에서 이 워크플로우를 유지되게 합니다. 첫 번째는 처리 티어입니다. 환자 접수 양식은 종종 손으로 작성되며, 손글씨는 표준 티어가 최적화되지 않은 부분입니다. 모델 티어는 처리 품질을 선택하는 계정 설정입니다: 표준은 대부분의 인쇄된 표 형식 문서를 처리하며, 고급 및 프리미엄은 복잡한 손글씨, 필기체, 필드 오독 비용이 큰 레이아웃을 겨냥한 더 강력한 비전 모델을 사용합니다. 종이 접수 양식 배치의 경우 제출 전에 티어를 고급 또는 프리미엄으로 설정하십시오. 배치 제출 시 활성화된 티어가 해당 배치의 청구 및 환불 기준이 되므로 설정은 계정별이 아니라 배치별로 결정됩니다.
두 번째 설정은 다중 페이지 병합으로, 접수 서류 묶음이 한 페이지에 그치지 않는 경우를 처리합니다. 인적 사항은 1페이지, 병력 체크리스트는 2~3페이지, 보험 및 동의서는 이후 페이지에 있습니다. 병합 규칙이 없으면 AI가 세 페이지를 읽고 한 환자에 대해 세 개의 행을 생성하여, 대사에 필요한 신원 정보가 분산됩니다. 템플릿 설정에서 다중 페이지 병합을 켜고 그룹화 규칙을 선택합니다. 양식에 계정 또는 회원 번호가 있으면 배치 전체에서 공유 참조 값을 기준으로 일치시키거나, 추적 열의 값이 변경될 때마다 새 그룹을 시작하고 추적 열을 환자 이름 필드로 설정합니다. 그러면 한 서류 묶음의 페이지가 하나의 행으로 접히고, 환자 이름이 모든 줄에 적용되며 신원 열은 해당 정보가 있는 페이지에서 채워집니다. 환자 한 명, 행 하나로 EOB 쪽과 대사할 준비가 됩니다.
파일은 안전하게 처리되며 저장되지 않습니다.
동일한 신원 열 워크플로우는 더 넓은 의료 청구 문서 세트에도 적용됩니다. 여러 payer와 환자에 걸쳐 대사하는 의료 기관은 열 세트를 확장하여 한 환자 보기에 포함된 의료 청구 문서 전체를 다룰 수 있으며, 이미 접수 측면을 디지털화한 클리닉은 환자 접수 양식에서 Excel로 추출 경로에서 시작해야 합니다.
여전히 사람이 필요한 작업
이 워크플로는 양쪽의 구조화를 자동화하지만, 중간의 판단이 완전히 사라지지는 않습니다. 특정 EOB가 특정 환자 기록에 속한다고 결정하지 않습니다. 이름과 DOB가 동일한 두 환자, 또는 payer가 접미사를 누락한 EOB의 경우, 잔액이 게시되기 전에 차트를 한 번 확인하여 어떤 행이 어떤 것인지 확인하는 사람이 여전히 필요합니다. 달라지는 것은 그 확인의 비용입니다. 이 도구는 비교를 기본 보기로 만들어 누군가가 기억해야 하는 작업이 아니라 기본적으로 수행되는 작업으로 바꿉니다.
두 가지 경계를 분명히 밝힐 필요가 있습니다. 이 도구는 문서를 추출하고 구조화할 뿐, 진료 관리 시스템이나 EHR에 게시하지 않으며, 청구를 제출하지 않고, Epic, athenahealth 또는 기타 플랫폼에 데이터를 푸시하지 않습니다. 생성되는 스프레드시트는 직접 가져오거나 수동으로 검토하는 용도로, 기존 PM 및 clearinghouse 스택 내에서 워크플로를 유지합니다. 또한 자격을 증명하거나 혜택을 심사하지 않으므로, 만료된 보험의 일치하는 EOB는 여전히 프런트 데스크가 해결해야 할 자격 문제입니다.
마지막 경계는 규정 준수입니다. 환자 접수 양식과 EOB에는 보호 건강 정보가 포함되어 있으며, HIPAA의 프라이버시 및 보안 규칙은 45 CFR Part 164에 따라 해당 PHI의 사용 및 공개를 규율합니다. ImageToTable.ai는 HIPAA 규정 준수 솔루션이 아니며 Business Associate Agreement를 제공하지 않습니다. HIPAA 적용 대상 기관은 PHI를 다루는 모든 제3자 서비스를 자체 규정 준수 요구 사항에 따라 평가하고, 보존 및 처리에 대해 공급업체와 논의하며, 실제 환자 식별 문서를 처리하기 전에 비식별 샘플 양식으로 워크플로를 테스트해야 합니다.
환자 접수 및 EOB 대사: 자주 묻는 질문
각 EOB를 환자 기록에 자동으로 매칭하나요?
아니요. 접수 패킷과 EOB를 동일한 신원 열로 추출하여 양쪽이 정렬되고, 불일치가 나란히 놓인 행으로 보이게 합니다. 특정 EOB가 특정 환자 계정에 속하는지 결정하는 것은 사람의 확인으로 남습니다. 동명이인이나 동일 생년월일의 경우 차트를 확인할 사람이 필요하기 때문입니다.
손으로 작성된 접수 양식에는 어떤 Model Tier를 사용해야 하나요?
손으로 작성된 종이 접수 양식 배치에는 Advanced 또는 Premium을 사용하세요. 이 티어는 밀집된 필기와 필기체에 적합한 더 강력한 비전 모델을 실행합니다. Standard는 대부분의 인쇄된 표 형식 문서를 잘 처리합니다. 배치를 제출할 때 활성화된 티어가 해당 배치에 청구되므로, 깨끗한 디지털 EOB에는 Standard를 유지하고 필기가 많은 접수 배치에는 티어를 전환할 수 있습니다.
다중 페이지 접수 패킷을 하나의 환자 기록으로 유지하려면 어떻게 하나요?
템플릿 설정에서 Multi-Page Merge를 켜고 그룹화 규칙을 선택하세요. 양식에 계정 또는 회원 번호가 있으면 공유 참조 매칭을 사용하고, 그렇지 않으면 환자 이름 열을 추적하여 변경될 때 새 그룹을 시작하세요. 페이지는 각 필드가 있는 페이지에서 신원이 채워진 하나의 행으로 접힙니다.
스캔한 종이 또는 포털 PDF로 도착하는 EOB도 처리할 수 있나요?
네. 이 도구는 워크플로 양쪽에서 PDF, JPG, PNG 및 스캔 이미지를 허용합니다. 품질이 낮은 팩스나 희미한 스캔은 일부 필드의 신뢰도를 낮추므로, 게시 전 검토 단계가 그러한 문서에 중요하며, 검토 화면의 bbox 시각적 확인을 통해 원본 이미지에서 각 추출 값이 어디서 왔는지 확인할 수 있습니다.
이 워크플로의 핵심은 접수 양식과 EOB를 기억에 의존해 대사할 필요가 없다는 것입니다. 양쪽이 동일한 신원 열을 가지면, 시트를 정렬하고 불일치하는 행을 확인하여 EOB를 올바른 환자에 매칭할 수 있습니다. 지불자 문서 더미를 열고 이름을 눈으로 비교할 필요가 없습니다. 비교 구조를 재구성하여 거부의 35%를 유발한 불일치가 프런트 데스크, 빌러, AR 데스크 사이의 인수인계에 숨어 있지 않도록 합니다.