의료 청구 팀이
수백 건의 EOB에서 데이터를 일괄 추출하는 방법
대부분의 문서 추출 도구는 혜택 설명서(EOB)가 표준화된 문서라는 가정을 전제로 합니다. 하지만 실제로는 그렇지 않습니다. 플로리다의 Blue Cross EOB는 일리노이의 Blue Cross EOB와 전혀 다르게 생겼습니다. Aetna EOB는 Medicare 지급 명세서와 다른 열 머리글을 사용합니다. 여기에 15~20개 보험사를 곱하면, EOB 처리의 병목은 타이핑 속도가 아니라 형식 차이입니다. 매달 수백 건의 문서를 처리하는 청구 팀에게 핵심 질문은 AI가 EOB를 읽을 수 있느냐가 아닙니다. 단일 추출 구성으로 모든 문서를 한 번의 일괄 처리로 다룰 수 있느냐입니다.
EOB가 표준 양식에 적용되는 자동화를 거부하는 이유
대부분의 문서 추출 도구가 Explanation of Benefits(급여 명세서) 양식에서 실패하는 이유는 정확성이 아니라 형식의 파편화입니다. 미국에는 보험사별로 6,000개 이상의 서로 다른 EOB 레이아웃이 있습니다. UnitedHealthcare, Aetna, Cigna, Humana, Medicare, Medicaid, 산재 보험사 등 모든 보험사는 동일한 데이터 포인트를 서로 다른 방식으로 구성합니다. 어떤 곳은 가로 표를 사용하고, 다른 곳은 세로 섹션을 사용합니다. 어떤 곳은 환자 부담금을 네 개의 하위 열로 나누고, 다른 곳은 한 줄로 압축합니다. 일부 보험사는 단일 EOB 내에서도 레이아웃을 변경하여 같은 PDF에서 지급된 청구와 거부된 청구에 서로 다른 형식을 사용하기도 합니다.
이것이 중요한 이유는 템플릿 기반 추출 도구—문서 유형별로 고정 레이아웃을 정의해야 하는 도구—는 보험사 형식마다 별도의 템플릿을 요구하기 때문입니다. 보험사가 레이아웃을 업데이트하면(생각보다 자주 발생합니다) 템플릿이 깨집니다. 청구 팀은 결국 지급을 입력하는 대신 추출 템플릿을 유지 관리하게 됩니다.
EOB(Explanation of Benefits)는 보험사가 의료 청구를 처리한 후 보내는 문서입니다. 청구된 금액, 플랜이 보장한 금액, 보험사가 지급한 금액, 환자가 부담해야 할 금액을 세분화하여 보여줍니다. 모든 보험사에 전자 자문(ERA)을 등록하지 않은 제공자—또는 특정 보험사로부터 종이 EOB를 받는 제공자—는 각 EOB를 수동으로 검토하고, 진료 관리 시스템에 데이터를 입력하고, 청구 기록과 대조해야 합니다. ERA는 EOB의 전자 버전으로, HIPAA 표준에 따라 ASC X12 835 거래로 전송됩니다. 작동하면 자동으로 게시됩니다. 그러나 많은 보험사가 여전히 종이 또는 PDF EOB를 보내며, 주요 보험사에 ERA를 등록한 제공자도 2차 보험사, 산재 보험, 주별 Medicaid 프로그램에서 PDF EOB를 받는 경우가 많습니다.
핵심 통찰: EOB 처리의 병목 현상은 데이터 입력 속도가 아닙니다. 두 보험사가 동일한 형식을 사용하지 않는다는 사실—그리고 청구 팀이 지급을 올바르게 게시하려면 모든 형식의 모든 데이터 포인트가 필요하다는 사실입니다.
수동 EOB 입력의 실제 인건비
수동 EOB 데이터 입력은 청구 운영 데이터에 따르면 문서당 5~8분이 소요됩니다. 중간 규모 병원이나 소규모 청구 회사의 일반적인 월 500건의 EOB 기준으로, 이는 직원 노동 40~65시간에 해당합니다. 청구 직원 시간당 $25 기준으로 연간 인건비는 EOB 데이터 입력만으로 약 $12,000~$19,500에 달합니다.
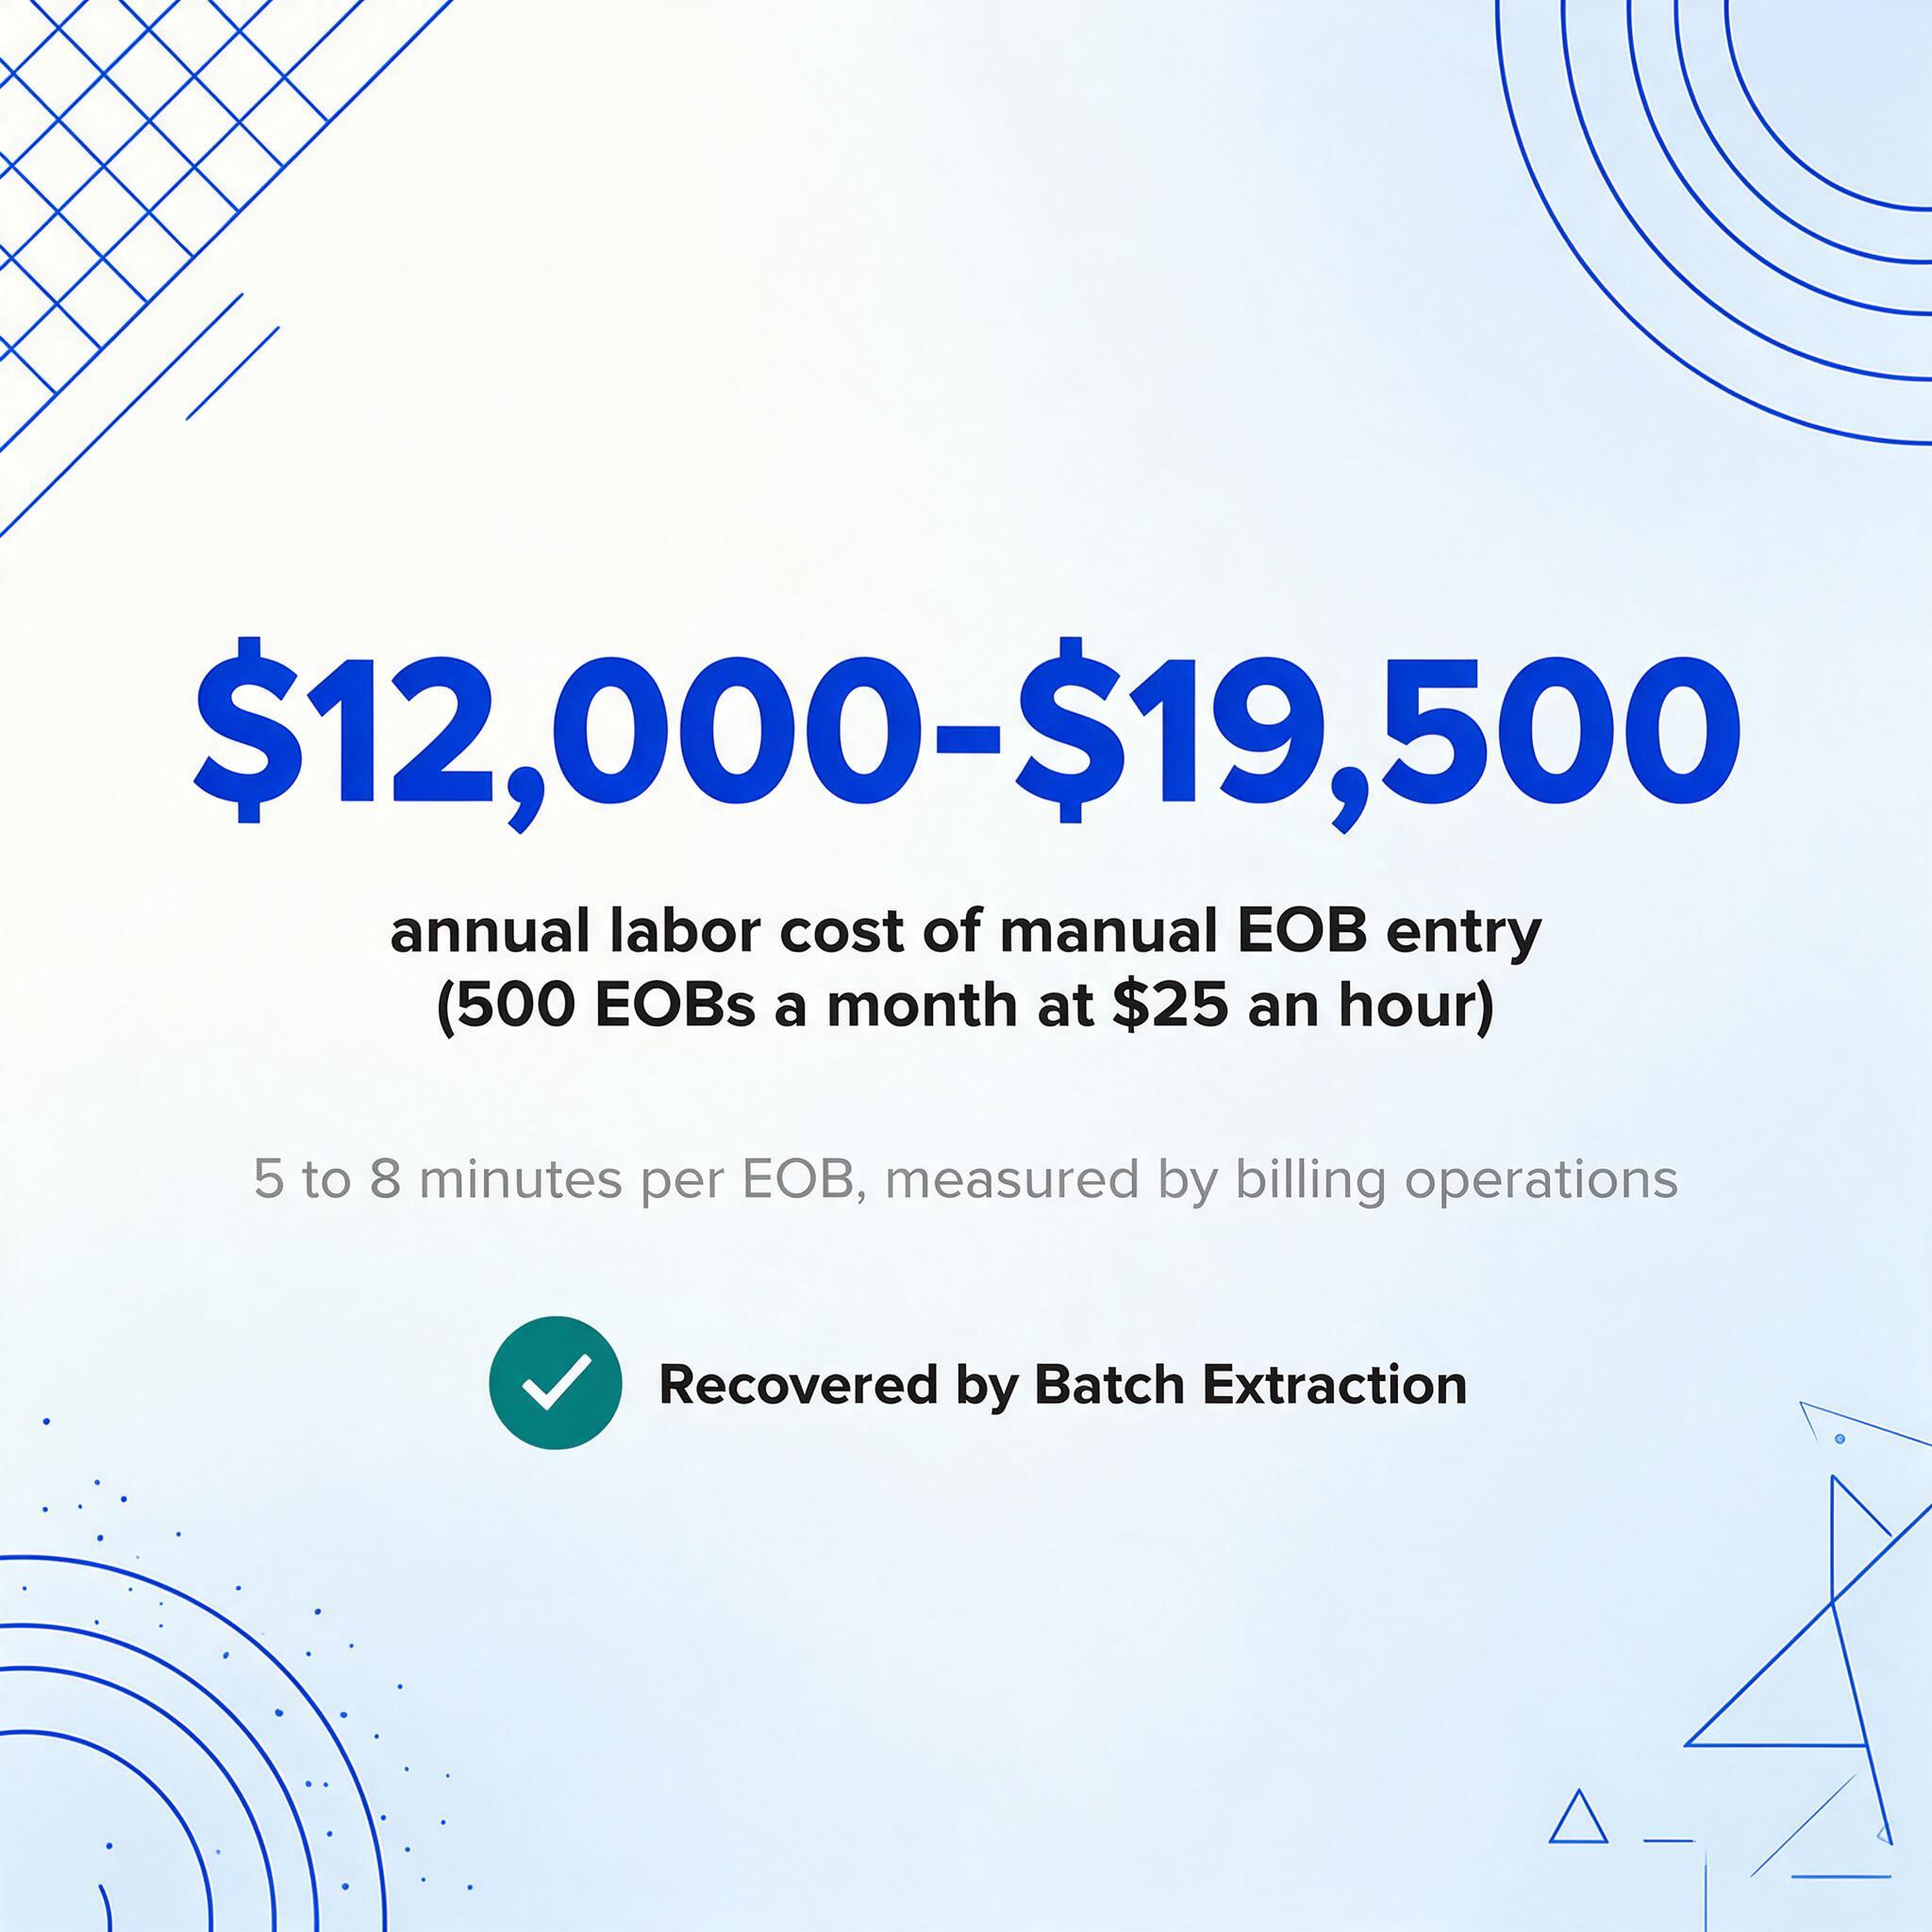
이 숫자에는 후속 비용이 포함되지 않습니다. 행정 거래 비용에 대한 업계의 권위 있는 벤치마크인 CAQH Index는 단순 수정의 경우 거부된 단일 클레임을 재처리하는 비용을 약 $25로 책정합니다. 임상 문서가 필요한 복잡한 이의 제기는 $100 이상 소요될 수 있습니다. 그리고 거부율은 상승하고 있습니다: 2025년 전국 평균은 업계 데이터에 따르면 10년 만에 최고치인 12.4%를 넘어섰습니다. MGMA의 2023 DataDive에 따르면 단일 전문 진료 기관의 첫 제출 시 거부율은 8%였으며, 2024년 3월 MGMA 설문 조사에서는 의료 그룹의 60%가 전년 대비 거부 건수가 증가했다고 보고했습니다.
EOB 데이터를 수동으로 입력할 때, 잘못 입력된 CPT 코드(미국 의학 협회가 관리하는 현재 의료 절차 용어 코드로, 청구서에 의료 서비스를 설명하는 데 사용됨), 잘못된 조정 금액, 또는 잘못 읽은 CARC 코드(클레임 조정 사유 코드—클레임이 청구된 것과 다르게 지급된 이유를 설명하는 표준화된 코드)는 후속 조정 작업을 발생시킵니다. CO-45 조정(요금이 수가표를 초과)을 CO-97(서비스가 다른 지급에 포함됨)로 잘못 입력하면 청구 팀이 잘못된 해결 경로로 빠지게 됩니다. 이는 이론적인 극단적인 경우가 아니라 수동 작업에서 매일 발생하는 일입니다.
Council for Affordable Quality Healthcare (CAQH)에 따르면, 의료비 1달러당 24센트가 행정 및 청구 비용에 사용됩니다. 업계는 수동 거래를 전자 거래로 전환함으로써 연간 약 $9.4억을 절약할 수 있습니다. 2025 CAQH Index에 따르면 미국 의료는 2024년 전자 거래를 통해 행정 비용 $2,580억을 절감했습니다—이는 PDF EOB 처리와 같이 수동으로 남아 있는 수익 주기 부분에 여전히 상당한 개선 여지가 있음을 의미합니다.
단일 EOB 추출 도구가 일괄 워크플로에서 놓치는 것
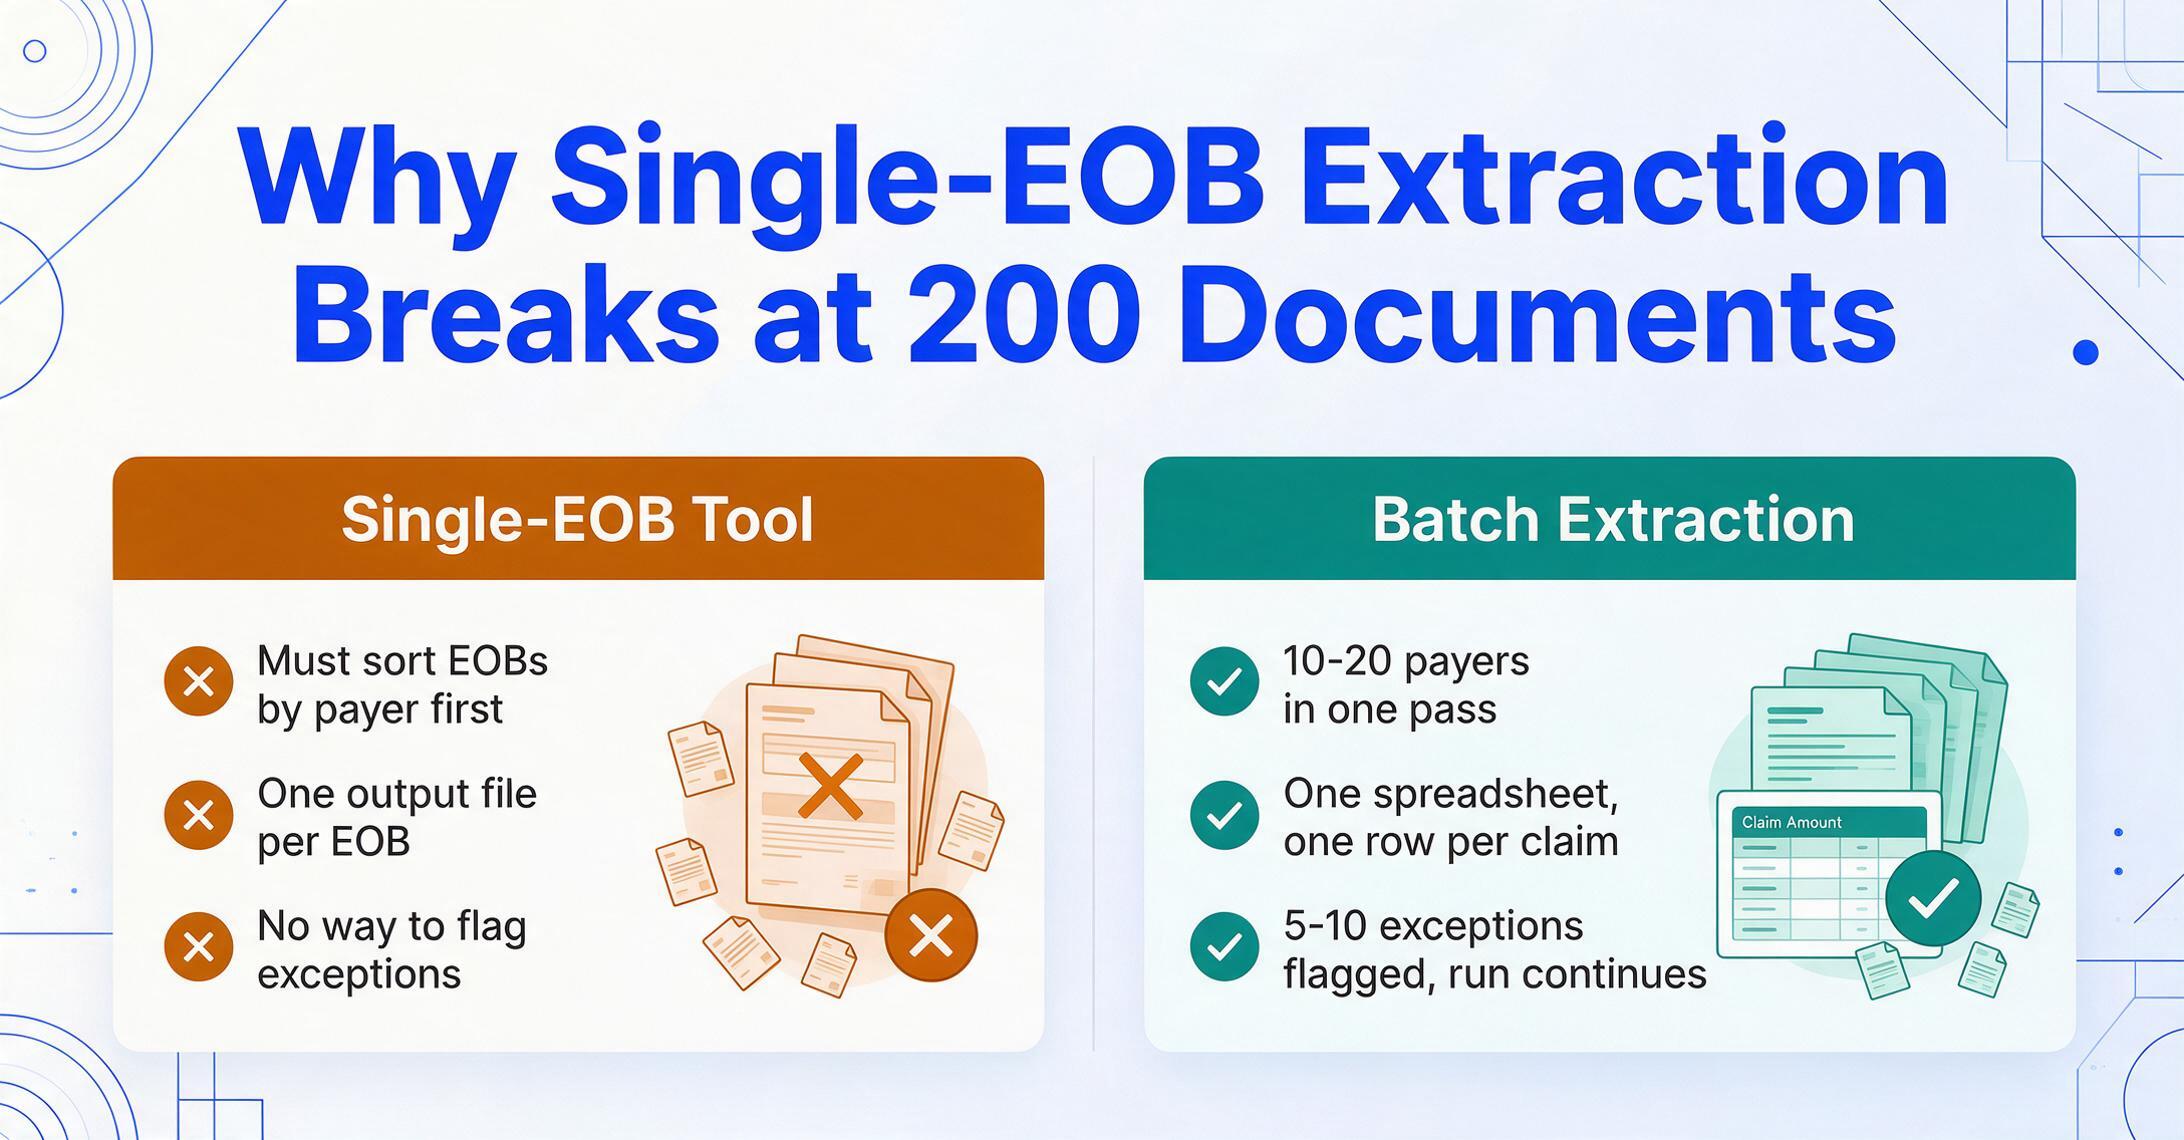
EOB 하나를 처리하는 것은 200개를 한 번에 처리하는 것과 근본적으로 다른 문제입니다. 단일 EOB 워크플로( PDF 열기, 데이터 추출, 시스템에 복사, 반복)는 추출 정확도와 무관한 방식으로 대량 처리에서 한계에 부딪힙니다.
혼합 보험사 스택. 200개의 EOB 배치에는 일반적으로 10~20개 서로 다른 보험사의 문서가 포함됩니다. Medicare EOB는 특정 보험금 지급 명세서 형식으로 CARC/RARC 코드 쌍을 사용합니다. UnitedHealthcare EOB는 Aetna EOB와 환자 책임 구조를 다르게 구성합니다. 일괄 추출 도구는 사용자가 먼저 보험사별로 EOB를 분류할 필요 없이 한 번에 모두 처리해야 합니다. 업로드 전에 분리해야 한다면 수작업을 한 단계 앞으로 옮긴 것에 불과합니다.
출력 병합. 도구가 EOB를 하나씩 처리하면 출력은 EOB당 파일 하나입니다. 일괄 추출은 200개의 모든 결과가 단일 스프레드시트(청구당 한 행, 모든 열 정렬)로 도착함을 의미합니다. 이것이 청구 관리자가 진료 관리 시스템으로 대량 가져오거나 월말 조정을 위해 필요한 형식입니다.
예외 처리. 200개의 EOB 배치에서 5~10개는 특이한 사항이 있습니다. 여백의 손으로 쓴 조정 메모, 계속 데이터가 있는 2페이지 EOB, 기록과 거의 일치하지만 정확히 일치하지 않는 환자 이름 등이 그것입니다. 일괄 워크플로는 전체 처리 실행을 중단하지 않고 이러한 예외를 사람의 검토를 위해 표시해야 합니다. 한 번에 하나의 EOB 추출을 기본으로 취급하는 도구는 이를 위한 메커니즘을 제공하지 않습니다.
파일 출처. 청구 팀은 여러 채널에서 EOB를 가져옵니다: 보험사 포털(Availity, UnitedHealthcare Provider Portal, 개별 보험사 사이트), 이메일 PDF, 팩스 사본, 스캔한 종이 원본. 일괄 워크플로는 각 출처에 대한 별도의 전처리 단계 없이 이러한 조합을 모두 수용해야 합니다.
EOB가 실제로 무엇이며 조정에 중요한 필드가 무엇인지 처음 접하는 경우, EOB 데이터 추출 개요에서 필드 수준 분석을 다루고, EOB 데이터 추출 완전 가이드에서 선택 기준과 내보내기 옵션을 처음부터 끝까지 안내합니다. 그리고 이러한 혼합 보험사 일괄 워크플로를 처리할 수 있는 도구를 나란히 비교하려면 의료 문서 추출 도구 정리를 참조하세요. 이 글은 40개의 실제 EOB, 청구 양식, 환자 문서로 7가지 도구를 테스트합니다.
AI가 보험사별 템플릿 없이 EOB 레이아웃을 읽는 방법
보험사별 형식 차이를 처리하는 기술적 접근 방식은 템플릿 기반 추출과 근본적으로 다릅니다. 템플릿 도구는 고정 좌표를 사용합니다—"허용 금액은 페이지의 X, Y 위치에 있습니다." 보험사가 레이아웃을 변경하면 좌표가 틀어집니다. 새로운 보험사가 첫 EOB를 보내면 템플릿 자체가 없습니다.
비전 언어 모델을 사용하는 AI 기반 추출은 다르게 작동합니다. 페이지 좌표를 매칭하는 대신 문서를 의미론적으로 읽습니다—각 섹션이 의미하는 바를 이해하는 것입니다. 단순히 위치만 보는 것이 아닙니다. 필요한 열을 정의하면 됩니다: 환자 이름, 서비스 날짜, CPT 코드, 청구 금액, 허용 금액, 공제액, 본인부담률, 환자 부담금, 조정 코드(CARC), 조정 금액, 거부 사유. AI는 문서 구조를 이해하여 페이지 어디서든 각 값을 찾습니다—사람 청구 담당자가 익숙하지 않은 EOB 레이아웃을 훑어보고, 상단 근처에서 환자 이름을 찾고, 열 헤더를 따라 허용 금액을 찾는 것과 같은 방식입니다.
ImageToTable.ai가 열 이름 추출이라고 부르는 이 접근 방식은, 원하는 필드 이름을 입력하면 AI가 각 보험사가 해당 필드를 어디에 배치하든 값을 매핑합니다. 하나의 설정으로 UnitedHealthcare EOB와 Aetna EOB를 수정 없이 동일한 배치에서 처리할 수 있습니다. 결과물은 원본 PDF를 생성한 보험사와 관계없이 모든 행이 동일한 열을 가진 통합 스프레드시트입니다.
파일은 안전하게 처리되며 저장되지 않습니다.
이것이 보험사별로 20개의 추출 템플릿을 만들고 유지하는 것과 출력 열을 한 번 정의하는 것의 차이입니다. 15개 이상의 보험사에서 EOB를 처리하는 청구 팀에게 템플릿 방식의 유지 관리 부담은 일회성 비용이 아닙니다. 이는 지속적인 운영 비용입니다.
일괄 EOB 추출 워크플로, 단계별 가이드
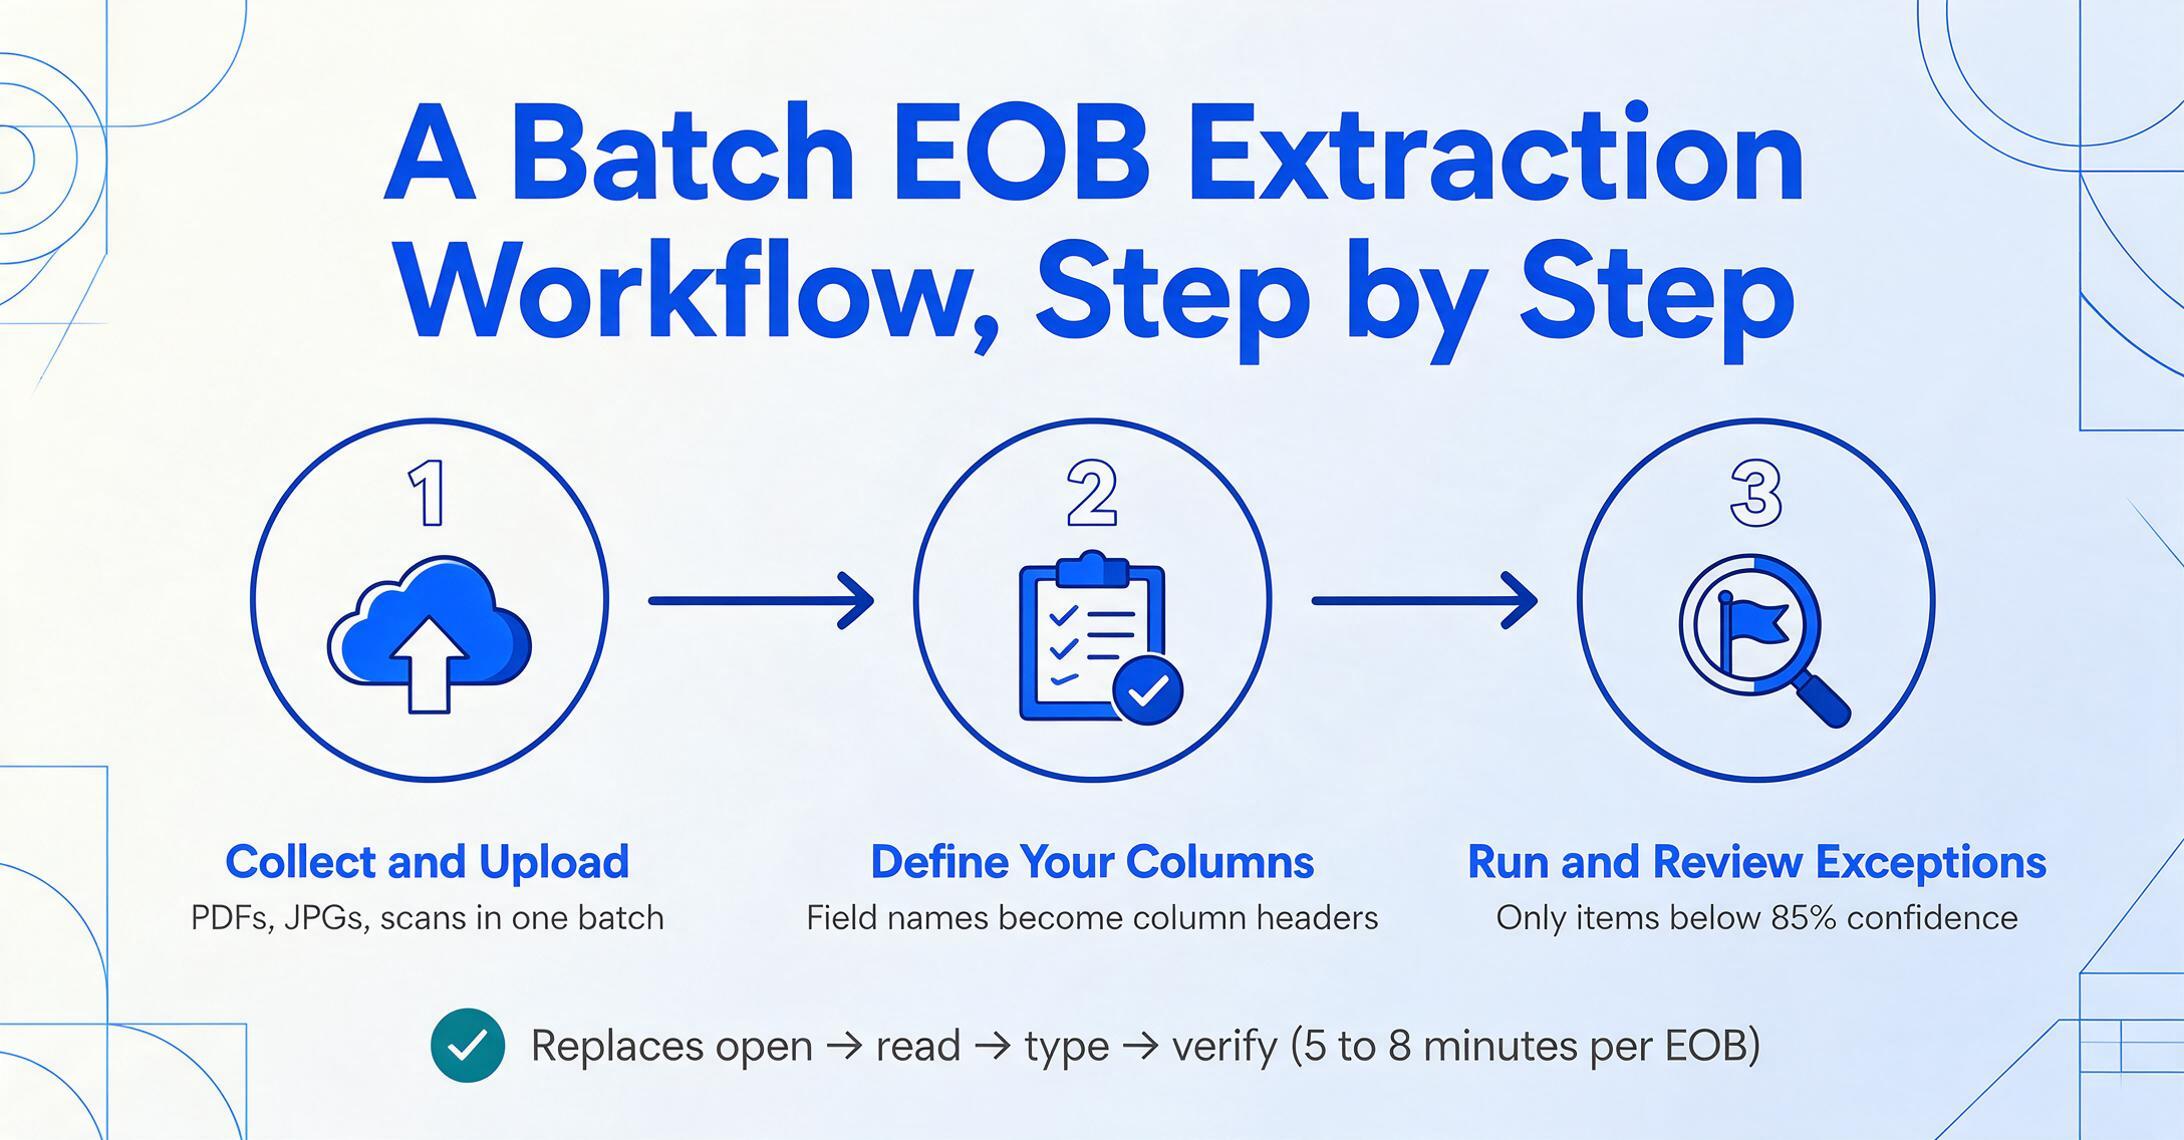
일괄 EOB 추출 워크플로는 단일 문서 워크플로와 준비, 처리, 예외 검토의 세 단계에서 다릅니다. 실제로 각 단계가 어떻게 작동하는지 살펴보겠습니다.
수집 및 업로드.
지불자 포털, 이메일, 스캔한 종이 문서에서 EOB를 한 폴더에 모으세요. 전체 배치를 업로드하세요—지불자별로 분류하거나 PDF와 스캔 파일을 분리할 필요가 없습니다. ImageToTable.ai는 단일 업로드로 PDF, JPG, PNG 파일을 지원합니다.
열 정의.
필요한 필드 이름을 입력하세요: 환자 이름, 서비스 날짜, CPT 코드, 청구 금액, 허용 금액, 공제액, 본인 부담금, 공동 보험, 환자 책임 금액, 지급 금액, 조정 코드, 조정 사유, 수표/EFT 번호, 수표 날짜. 이들은 출력 스프레드시트의 열 머리글이 됩니다.
실행 및 예외 검토.
AI가 모든 문서를 한 번에 처리합니다. 각 추출 값에는 신뢰도 점수가 포함됩니다. 임계값(예: 85% 미만)을 설정하여 검토가 필요한 항목을 표시하세요. 청구 담당 직원은 전체 데이터의 약 5%에 해당하는 표시된 항목만 확인하면 되며, 모든 EOB의 모든 필드를 검증할 필요가 없습니다.
이 3단계 워크플로는 문서당 5~8분이 소요되는 EOB별 열기 → 읽기 → 입력 → 검증 주기를 대체합니다. 월 500건의 EOB 기준으로 약 40시간의 직원 시간이 절약되며, 이 시간은 데이터 입력에서 거부 분석, 이의 제기 준비, 지불자 후속 조치로 전환됩니다. 업로드부터 스프레드시트 출력까지의 일괄 워크플로를 직접 체험하려면 EOB를 Excel로 변환 가이드를 참조하세요.
추출 데이터에서 청구 시스템까지: 누락된 단계
추출 데모를 본 후 청구 관리자들이 가장 많이 묻는 질문은 "이것이 우리 시스템에 어떻게 들어가나요?"입니다. 답은 사용 중인 진료 관리 소프트웨어에 따라 다르지만 패턴은 일관됩니다: 일괄 추출 출력물(일반적으로 Excel 스프레드시트 또는 CSV 파일)이 청구 플랫폼의 가져오기 인터페이스에 매핑됩니다.
Kareo는 등록된 지불자에 대한 ERA 자동 게시와 비-ERA EOB에 대한 수동 결제 입력을 지원합니다. 일괄 추출된 EOB 데이터는 결제 게시 워크플로 중에 검토 및 입력하거나, 진료가 Kareo의 일괄 가져오기 도구를 사용하는 경우 가져올 수 있습니다. AdvancedMD는 추출된 결제 데이터를 청구와 대조할 수 있는 eRemittance 검토 화면을 제공합니다. CollaborateMD는 Claim Control Center를 통해 청구를 라우팅합니다; 추출된 조정 데이터는 거부 관리 대기열에 공급됩니다.
추출 중 정의하는 열은 청구 시스템이 기대하는 필드와 일치해야 합니다. 시스템이 환자 계정 번호를 필요로 한다면 해당 열로 포함하세요. CARC 및 RARC 코드(Remittance Advice Remark Codes—CARC에 추가 컨텍스트를 제공하는 보조 코드, 예: "N130: 청구 처리에 추가 문서 필요")를 추적한다면 별도의 열로 포함하세요. 추출 출력은 수익 주기 워크플로에 직접 공급되는 구조화된 데이터셋이 됩니다. 한 단계 더 나아가려는 팀을 위해 ImageToTable.ai는 추론 열을 지원합니다: "거부 카테고리(옵션: 코딩 오류 / 자격 / 승인 / 의학적 필요성 / 적시 제출 / 기타)"와 같은 열을 정의하면 AI가 CARC 코드와 설명 텍스트를 기반으로 각 거부를 버킷으로 분류합니다—분류와 추출을 한 번에 처리합니다.
이것이 일괄 추출이 복합 가치를 창출하는 지점입니다. 단일 EOB 도구는 한 문서에서 5분을 절약합니다. 거부를 분류하고 청구 가져오기 필드에 매핑하는 일괄 도구는 EOB당 5분을 절약하며 직원이 추출 후 분류 및 범주화에 소비하는 배치당 15-20분도 제거합니다.
일괄 EOB 처리 및 HIPAA 규정 준수
EOB 데이터를 처리하는 모든 도구는 보호 건강 정보(PHI)를 다룹니다. HIPAA 규정 준수는 공급업체 평가 마지막에 확인하는 항목이 아니라 첫 번째 필터입니다. 일괄 EOB 추출 도구의 핵심 요구 사항은 전송 중 및 저장 중 암호화, 명시적으로 구성되지 않는 한 업로드된 문서의 영구 저장 금지, 그리고 적용 대상 기관을 위한 업무 제휴 계약(BAA) 제공입니다.
ImageToTable.ai는 추출 중에 파일을 처리하며 이후에는 보관하지 않습니다. 의료 기관의 경우 실무 워크플로 의미는 간단합니다. 보안 환경에서 EOB PDF를 업로드하고, 데이터를 추출하고, 구조화된 출력을 다운로드한 다음, 업로드 대기열에서 원본 파일을 삭제하면 됩니다. 데이터는 추출 환경을 떠나 기존 규정 준수 통제 하에 진료 관리 시스템으로 들어갑니다.
그럼에도 불구하고 청구 팀은 조직의 요구 사항에 맞춰 추출 도구의 특정 규정 준수 인증(SOC 2, HIPAA 증명)을 확인해야 합니다. 어떤 도구도 공급업체 실사 의무를 대체하지 않으며, 이 문서는 그 과정을 대신하지 않습니다.
실용적인 조언: 추출 도구를 통해 EOB를 일괄 처리하기 전에 공급업체가 BAA를 제공하는지 확인하고, 데이터 처리 및 보존 정책을 검증하며, 비식별화된 샘플 EOB로 먼저 테스트하여 워크플로가 규정 준수 요구 사항을 충족하는지 확인하세요.
자주 묻는 질문
일괄 EOB 추출이 전자 송장 지급 통지(ERA) 파일을 처리할 수 있나요?
ERA 파일(ASC X12 835 형식)은 이미 구조화된 데이터이므로 추출이 필요하지 않습니다. ERA 파일과 PDF EOB를 모두 받는 경우, 일괄 추출은 EOB 수집의 PDF/종이 부분을 처리합니다. 추출된 데이터는 ERA 게시 워크플로와 일치하도록 형식을 지정할 수 있으므로 모든 지급이 소스 형식과 관계없이 동일한 조정 프로세스로 유입됩니다.
일괄 추출 시 CPT 코드와 NPI 번호의 앞자리 0이 보존되나요?
네. 앞자리 0 보존은 출력 단계의 서식 문제입니다. ImageToTable.ai의 열 이름 추출은 문서에 표시된 원본 데이터를 그대로 보존합니다. Excel로 내보낼 때 CPT 코드, NPI, 계좌 번호 열에 텍스트 서식을 지정하면 스프레드시트 프로그램이 앞자리 0을 제거하지 않도록 할 수 있습니다.
혼합 보험사 EOB 일괄 처리에서 기대할 수 있는 정확도는 얼마인가요?
깨끗한 EOB PDF의 인쇄 텍스트는 일반적으로 필드 수준 정확도 95-99%로 추출됩니다. 스캔 또는 팩스로 전송된 문서, 손으로 쓴 여백 메모, 표준 EOB 레이아웃에서 크게 벗어난 비정형 보험사 형식에서는 정확도가 떨어집니다. 일괄 워크플로는 이러한 현실을 고려해 설계되었습니다. 신뢰도 점수가 불확실한 추출 항목을 사람의 검토로 표시하므로 청구 시스템에 반영되는 데이터의 100%가 AI 신뢰도 또는 직원 확인을 통해 검증되었습니다.
새 보험사의 EOB 형식에 맞게 설정하는 데 얼마나 걸리나요?
열 이름 추출을 사용하면 설정 시간이 전혀 필요 없습니다. UnitedHealthcare EOB에 대해 만든 열 정의가 새 보험사 형식에도 즉시 적용됩니다. AI는 저장된 템플릿을 매칭하는 대신 문서를 맥락적으로 읽기 때문입니다. 새 보험사의 EOB가 표준 데이터 항목에 익숙하지 않은 용어를 사용하는 경우(예: "Allowed Amount" 대신 "Plan Paid"), 첫 번째 일괄 처리에서 열 이름 조정이 필요할 수 있지만 구축하거나 학습할 템플릿은 없습니다.
일괄 추출이 EOB의 손글씨 메모를 처리할 수 있나요?
부분적으로 가능합니다. AI 기반 추출은 문서의 또렷한 손글씨를 읽을 수 있지만 인쇄된 텍스트보다 정확도가 낮습니다. 보험사가 거부 사유를 수동으로 메모하는 EOB에서 흔히 볼 수 있는 여백의 손글씨 조정 사항은 신뢰도 점수 시스템에서 사람의 검토로 표시될 가능성이 높습니다. 메모가 많은 EOB를 자주 받는 팀의 경우 일괄 추출은 인쇄된 데이터의 90%에 대한 시간을 절약하면서 손글씨 콘텐츠는 직원 확인으로 라우팅합니다.
배치에 단일 페이지 EOB와 다중 페이지 EOB가 함께 포함되면 어떻게 되나요?
다중 페이지 EOB의 각 페이지는 동일한 문서의 일부로 처리됩니다. 3페이지짜리 Aetna EOB를 별도의 파일 3개로 업로드하면 출력에 3개의 행으로 표시됩니다. 다중 페이지 EOB가 여러 파일로 분할된 배치 워크플로의 경우, 업로드 전에 EOB별로 단일 PDF로 결합하거나 추출 정의에 청구 번호 열을 포함하여 조정 중 관련 행을 그룹화하는 것이 좋습니다.
자체 EOB로 배치 추출 테스트하기
배치 EOB 추출의 핵심은 궁극적으로 정확도 비율이나 업계 벤치마크가 아니라, 월요일 아침 청구 팀이 대기열을 열었을 때 PDF 더미 대신 완성된 스프레드시트를 보게 되는 변화에 관한 것입니다. EOB당 5~8분은 이론적 추정치가 아니라 청구 관리자가 일반적인 배치에서 직원의 시간을 측정해 검증할 수 있는 수치입니다. 문제는 회수된 시간이 무엇을 가능하게 하느냐입니다: 더 많은 거절 항목 이의 제기, 더 빠른 환자 청구, 더 짧은 A/R 일수, 또는 수요일 대신 수요일 전에 지불 게시를 완료하는 팀입니다.
자체 EOB 배치로 테스트하세요. 청구 시스템에 필요한 열을 정의하세요. 업로드부터 구조화된 스프레드시트까지의 워크플로가 월간 주기에 맞는지 확인하세요. 열 이름 추출이 특정 지불자 구성을 처리하는지 평가하는 유일한 방법은 실제 문서에서 실행하는 것입니다.